
¡Última oportunidad! 50 % de descuento en todo
La oferta termina dentro de
La mayoría de anuncios de IA en 2026 han sido una carrera por liderar el chat y el razonamiento, como se ve con GPT-6 Astra de OpenAI y Fable 5.1 de Anthropic.
TypeSafe trae un enfoque distinto. El 15 de septiembre de 2026, la compañía presentó un modelo que no genera texto en absoluto.
El modelo se llama Jev y pertenece a una nueva categoría de modelos de IA que TypeSafe denomina modelos System One.
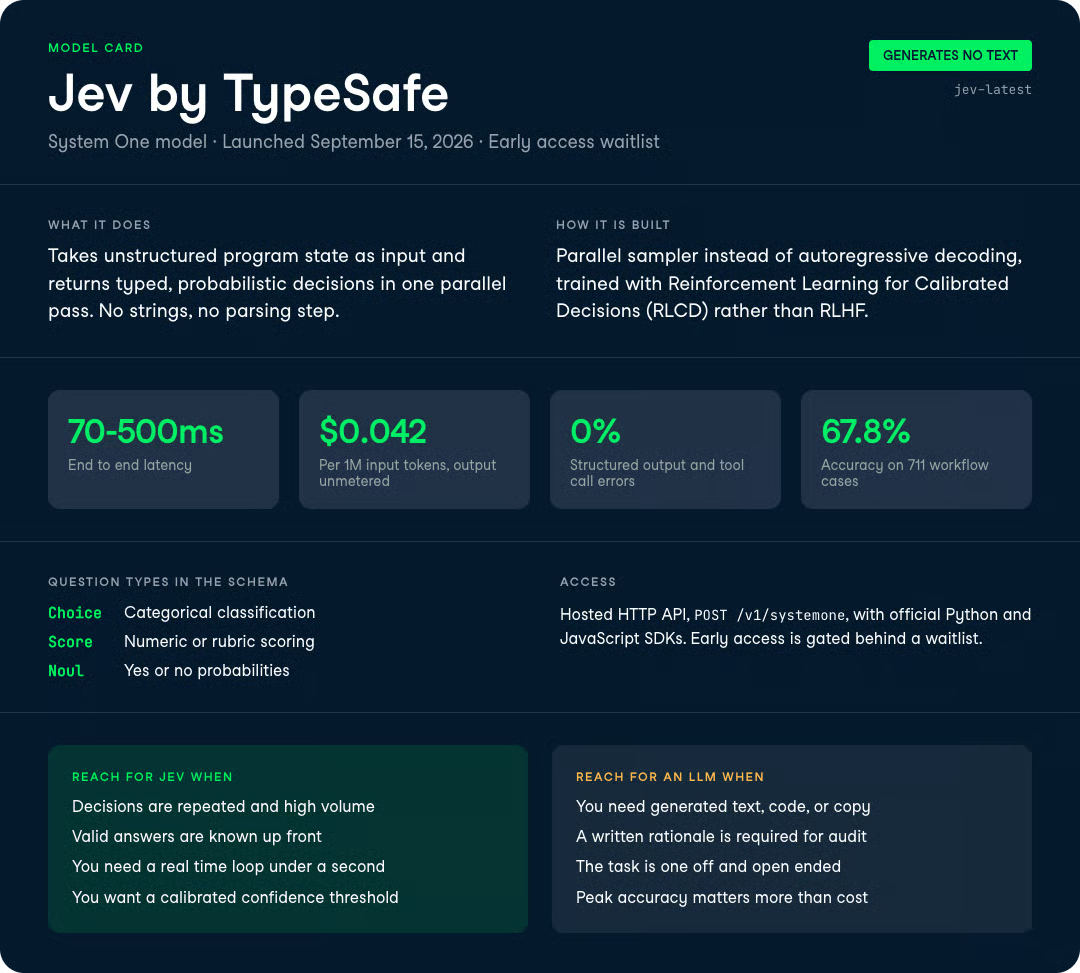
En lugar de producir cadenas token a token, Jev toma un estado de programa no estructurado como entrada y devuelve decisiones tipadas y probabilísticas en una única pasada paralela.
Los titulares de TypeSafe afirman que Jev funciona entre 40 y 200 veces más rápido que los LLMs punteros en tareas comparables, cuesta $0.042 por millón de tokens de entrada con salida gratuita y, por construcción, no puede alucinar ni producir errores de tipo.
En este artículo veremos qué es realmente un modelo System One, en qué se diferencia Jev de un LLM estándar, qué muestran los benchmarks de flujos de trabajo frente a otros modelos y dónde creo que encaja en un stack real.
Para profundizar en los modelos contra los que se compara Jev, consulta nuestras comparativas de Jev vs GPT-6 Astra, GPT-5.6 Terra vs Claude Sonnet 5 y Claude Opus 5 vs GPT-5.6 Sol. También te recomiendo nuestra guía de alternativas a Jev.
Un modelo System One es un modelo de IA puntero que devuelve decisiones probabilísticas tipadas en lugar de texto.
Le das un bloque de estado y un conjunto de preguntas tipadas; las evalúa en paralelo y devuelve respuestas estructuradas con niveles de confianza calibrados, sin generación de cadenas ni parsing. TypeSafe acuñó el nombre de la categoría con Jev, su primer lanzamiento público en septiembre de 2026.
Jev es un modelo puntero diseñado para tomar decisiones rápidas y estructuradas que el software puede consumir directamente, sin pasos de parsing o validación.
Es el primer lanzamiento público de la clase System One de TypeSafe, disponible en acceso anticipado desde septiembre de 2026 y bautizado en honor al economista William Stanley Jevons.
El nombre alude a Thinking, Fast and Slow de Daniel Kahneman.
El Sistema 1 de Kahneman es rápido e intuitivo; el Sistema 2 es lento y deliberado.
Los LLMs actuales, con su chain-of-thought y trazas de razonamiento de varios segundos, se sitúan claramente en el territorio del Sistema 2.
Diogo Almeida, fundador de TypeSafe y coinventor de ChatGPT en OpenAI, sostiene que la brecha en automatización viene de que todos construyen modelos del Sistema 2 cuando la mayoría de decisiones de software necesitan una respuesta rápida de Sistema 1.
A nivel arquitectónico, Jev se aleja mucho de un LLM transformer.
Usa una arquitectura nueva con un muestreador paralelo que genera todos los outputs en una sola consulta en lugar de hacerlo de forma autoregresiva, y un método de entrenamiento que TypeSafe denomina Reinforcement Learning for Calibrated Decisions (RLCD).
Mientras GPT-5.6 y Opus 5 se entrenan con RLHF y recompensas verificables para producir texto que prefieren las personas, RLCD optimiza por probabilidades calibradas en decisiones estructuradas.
El resultado, según las cifras de TypeSafe, es un 0% de errores en output estructurado y una latencia de extremo a extremo de 70-500 ms.
Un apunte sobre el método RLCD: TypeSafe lo posiciona directamente frente a RLHF y RLVR. Donde RLHF optimiza por respuestas de chat que gustan a evaluadores humanos y RLVR por outputs que un programa puede verificar, RLCD optimiza por probabilidades epistémicamente honestas en tareas de decisión. Por eso la calibración es una propiedad nativa de Jev y no algo añadido a base de prompts.
Aquí va el contraste arquitectónico clave en una tabla, porque en prosa se pierde fácil.
| Propiedad | LLM puntero (GPT-5.6, Opus 5) | Jev (modelo System One) |
|---|---|---|
| Salida | Cadenas generadas, requieren parsing | Valores tipados, garantizados por esquema |
| Muestreo | Secuencial, token a token | Paralelo, consulta única |
| Precio de entrada / 1M tokens | $0.20-$10 | $0.042 |
| Precio de salida | ~5x la entrada | Gratis |
| Latencia | 3-329 s | 70-500 ms |
| Alucinaciones / errores de tipo | Posibles | Imposibles por construcción |
| Confianza | Sobreconfiada, inconsistente | Calibrada por salida |
Todas las funciones derivan de una decisión de diseño: Jev renuncia por completo a generar cadenas de texto.
Esa renuncia es la que permite la velocidad, el precio y las garantías de tipos.
Jev devuelve valores estructurados y type-safe cuyos outputs posibles se definen en tu esquema antes de la llamada.
La API expone un conjunto pequeño de tipos de pregunta:
Piénsalo como una llamada a función con inteligencia puntera: entra un estado no estructurado, salen decisiones tipadas y probabilísticas.
Si estás ruteando un ticket de soporte, puedes definir un Choice sobre {billing, technical, sales, spam} y un Score de urgencia de 0 a 100, y Jev completa ambos en una sola pasada. No hay JSON que parsear ni riesgo de que el modelo se disperse y escriba un párrafo.
La advertencia obvia: esto solo funciona cuando el espacio de respuestas válidas está acotado y definido de antemano. Jev no sirve para generación abierta y no te escribe el esquema.
Cada salida de Jev incluye una probabilidad calibrada, lo que significa que una mayor confianza se corresponde realmente con mayor acierto.
Creo que esta será la función más útil en la práctica.
Los LLMs estándar son notoriamente sobreconfiados incluso cuando les pides explícitamente una probabilidad.
Si un modelo acierta el 95% pero no sabe decirte en qué 5% duda, no puedes automatizar con seguridad a su alrededor.
La calibración de Jev te permite fijar un umbral de confianza y actuar en automático por encima de él, enviando los casos dudosos a una persona o a un LLM más lento.
La limitación: Jev te da un número, no una justificación.
No hay una explicación en lenguaje natural de por qué puntuó un caso de cierta manera, lo cual importa para depurar y para auditorías en sectores regulados.
Como las salidas de Jev están restringidas por el esquema, es matemáticamente imposible que produzca un valor inválido o un error de tipo.
TypeSafe reporta un 0% de errores en output estructurado y 0% en llamadas a herramientas.
Por comparación, en la prueba de output estructurado de TypeSafe, luna y terra de OpenAI marcaron 0.58%, Opus 5 de Anthropic 5.73% y Claude Haiku 4.5 un 45.5%.
En llamadas a herramientas, GPT-5.6 Sol fue el peor con 17.0%.
Una llamada a herramienta alucinada es una molestia en un agente interactivo, pero un problema serio cuando está enterrada varias capas en una cadena de dependencias con garantías de latencia.
Jev genera toda su salida en una sola consulta paralela en lugar de emitir token a token.
De ahí vienen los 70-500 ms de latencia.
Esa velocidad habilita casos de uso que los LLMs token a token no alcanzan.
En el propio demo de TypeSafe, Jev juega a Doom reaccionando a un estado de juego estructurado (proporcionado como texto) unas 10 veces por segundo, por unos $7/hora de inferencia.
La idea no es que Jev juegue bien a Doom (un bot con script lo superaría), sino que puede tomar decisiones reactivas dentro de un bucle en tiempo real donde una llamada a un LLM de 3-30 segundos es inviable.
El coste por caso de Jev, alrededor de $0.0004, hace viable ejecutar una decisión sobre cada fila de un dataset grande, algo prohibitivo con un LLM puntero.
TypeSafe lo presenta como convertir petabytes de datos crudos en features e insights mediante decisiones tipo map-reduce.
Un ejemplo concreto: puntuar cada reseña de producto en una tabla de 50 millones de filas por sentimiento e infracción de políticas, lo que costaría unos $20 en llamadas de decisión con Jev al ritmo indicado, frente a miles con un LLM facturado por tokens.
En resumen, Jev queda más o menos donde están los LLMs punteros de gama media en precisión, mientras supera a todos en coste y latencia por uno o dos órdenes de magnitud.
Todos los números siguientes provienen de las tablas de evaluación de TypeSafe; aún no hay una reproducción independiente a gran escala, así que tómalo como datos del proveedor.
TypeSafe creó una evaluación propia en 4 flujos (respuesta a incidentes de seguridad, observabilidad de trazas de agentes, procesamiento de facturas y atención al cliente), puntuando cada modelo contra la media de predicciones de GPT-6 Astra y Fable de Anthropic.
Jev promedia un 67.8% de acuerdo con las respuestas de referencia.
Así queda frente a los LLMs punteros en los mismos flujos:
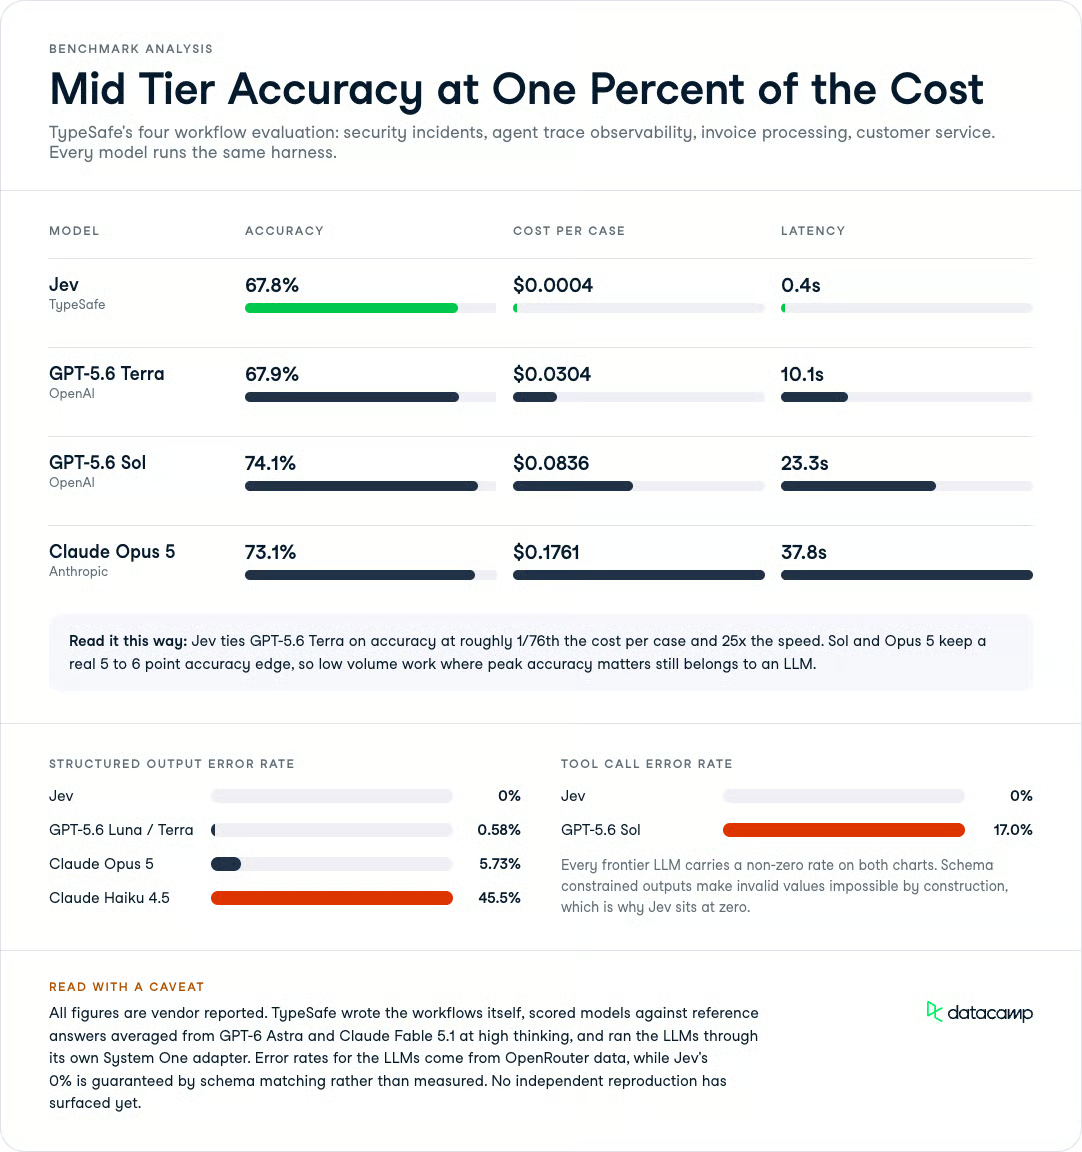
El patrón es consistente: Jev cede unos puntos de precisión frente a los mejores a cambio de enormes ahorros en coste y latencia.
| Modelo | Precisión | Coste por caso | Latencia |
|---|---|---|---|
| Jev (TypeSafe) | 67.8% | $0.0004 | 0.4 s |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1 s |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3 s |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8 s |
Jev empata en la práctica con Terra en precisión, costando alrededor de 1/76 por caso y funcionando 25 veces más rápido.
Los modelos con mayor precisión, Sol con 74.1% y Opus 5 con 73.1%, mantienen una ventaja real de 5-6 puntos, así que si necesitas el máximo acierto en tareas de bajo volumen, el LLM sigue ganando.
En los gráficos de fiabilidad, Jev marca 0% de error tanto en output estructurado como en llamadas a herramientas, que es precisamente la ventaja de un diseño restringido por esquema.
Todos los LLMs punteros arrastran alguna tasa de fallo aquí.
Dos cifras destacan: Claude Haiku 4.5 registra un 45.5% de error en output estructurado, y GPT-5.6 Sol un 17.0% en llamadas a herramientas.
No son casos raros; son fallos que rompen un pipeline desatendido en cuanto escala.
Jev devuelve probabilidades pero no una justificación en lenguaje natural, algo que los revisores señalan como una restricción real para depuración y auditorías en dominios regulados.
Si un equipo de compliance necesita saber por qué se puntuó así una solicitud de préstamo, un número de confianza no les bastará.
La solución práctica es reservar Jev para la capa de ruteo de alto volumen y escalar los casos marcados o de baja confianza a un modelo que sí pueda producir una explicación escrita.
Así mantienes el throughput y preservas una pista de auditoría donde es obligatoria.
TypeSafe es sorprendentemente claro sobre los sesgos de sus propias evaluaciones.
Los flujos los escribió su propio equipo de capacidades de modelo, así que podría haber sesgo, y las respuestas de referencia provienen de modelos de OpenAI y Anthropic, lo que probablemente infravalora el rendimiento relativo de Jev y el de los modelos de DeepSeek.
Los LLMs de estas pruebas pasan por el adaptador System One de código abierto de TypeSafe, que les fuerza a emitir decisiones estructuradas compatibles con la API.
TypeSafe afirma que esta es la forma más precisa de extraer decisiones de un LLM, aunque es más lenta y cara que dejar al modelo responder sin probabilidades.
Hasta que un conjunto independiente lo reproduzca con un arnés neutral, leería esta paridad de precisión como prometedora, no definitiva.
Jev no compite con GPT-5.6 u Opus 5 para los mismos trabajos, así que la pregunta útil es a qué clase de modelo recurrir.
La división depende de si tu tarea necesita una decisión acotada o una respuesta abierta.
| Caso de uso | Elige | Por qué |
|---|---|---|
| Clasificar o rutear millones de tickets | Jev | Outputs acotados; mandan el coste y el throughput |
| Evaluar o poner guardarraíles a salidas de LLM a escala | Jev | Probabilidades sí/no rápidas, sin riesgo de alucinación |
| Decisiones en tiempo real dentro de un bucle de app | Jev | 70-500 ms de latencia vs 3-30 s de un LLM |
| Redactar código, emails o resúmenes | LLM puntero | Jev no genera texto |
| Razonamiento multifase puntual con explicación | LLM puntero | Requiere una justificación y salida abierta |
En la práctica, se complementan bien: usa Jev como capa rápida de decisión que clasifica, puntúa y rutea, y deriva el pequeño porcentaje de casos difíciles o abiertos a un modelo como Terra u Opus 5. La calibración de Jev hace que el traspaso sea limpio, ya que puedes rutear por umbral de confianza.
El precio de Jev es donde el argumento se vuelve agresivo.
Los tokens de entrada cuestan $0.042 por millón ($42 por mil millones) y los tokens de salida no se facturan; TypeSafe los define como demasiado baratos para medir porque el modelo devuelve decisiones estructuradas y no texto largo.
Para ponerlo en escala, esa tarifa equivale a ~1/48 del precio de entrada de GPT-5.6 Terra ($2.00 por millón de tokens), y además Terra cobra $12.00 por millón de tokens de salida.
A nivel de flujo de trabajo, las evaluaciones internas de TypeSafe sitúan a Jev en unos $0.0004 por caso frente a $0.0304 para Terra y $0.0836 para Sol.
TypeSafe reconoce que no puede demostrar que el precio no esté subsidiado y dice que el tiempo dirá si es sostenible, aunque espera que los precios bajen, no suban.
Jev está en acceso anticipado desde el 15 de septiembre de 2026, tras una lista de espera a la que van incorporando desarrolladores progresivamente. No vi ningún programa explícito de créditos o prueba gratuita en los materiales de lanzamiento.
Jev es un modelo propietario, alojado y accesible vía la API HTTP de TypeSafe. Sin embargo, para acceder necesitarás unirte a la lista de espera y seguir la comunidad en el TypeSafe AI Blog.
El endpoint es POST https://api.typesafe.ai/v1/systemone, y la ruta del modelo en acceso anticipado es jev-latest.
TypeSafe ofrece SDKs oficiales para Python y JavaScript además de la API HTTP.
Defines tus tipos de pregunta (Choice, Score, Noul) en el esquema y pasas el estado de tu programa como entrada; la respuesta llega como valores tipados con probabilidades calibradas.
Este es el formato mínimo de una solicitud contra la ruta serverless:
import requests

response = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": "Bearer YOUR_KEY"},
    json={
        "model": "jev-latest",
        "state": "Customer emailed twice this week about a failed refund...",
        "questions": {
            "category": {"type": "choice", "options": ["billing", "technical", "sales"]},
            "urgency": {"type": "score", "min": 0, "max": 100},
        },
    },
)
print(response.json())
Para la referencia completa del esquema y la configuración de los SDKs, la documentación de TypeSafe es la fuente de verdad.
TypeSafe apuesta por que mucho de lo que hoy pedimos a los LLMs es, en realidad, toma de decisiones estructuradas disfrazada de chat.
Si eso es cierto, la ventaja de coste de 40-400x de Jev y su garantía de 0% de errores de tipo cambian la economía de la automatización a gran escala de una forma que GPT-5.6 y Opus 5 no pueden igualar en precio.
Mi lectura honesta es que Jev parece realmente útil como capa rápida de decisión y guardarraíl, y la parte de calibración es en torno a la que yo construiría.
Las dudas abiertas: si un benchmark independiente confirma la paridad de precisión y si los precios se mantienen cuando desaparezcan posibles subsidios.
Si quieres entender los problemas de decisión para los que se ha creado Jev, nuestro itinerario de aprendizaje AI Fundamentals cubre los conceptos de clasificación y calibración en los que se sustenta.
Los cursos destacados de DataCamp
Curso
Curso
Curso
blog
blog
Natassha Selvaraj
15 min
blog
Bhavishya Pandit
7 min
blog
Josep Ferrer
8 min
Tutorial
Zoumana Keita
12 min
Tutorial
Dimitri Didmanidze
8 min



