
基础类 Snowflake 面试题
先从 Snowflake 关键概念的基础面试题开始。
1. Snowflake 的核心特性有哪些?
Snowflake 是一款云端数据仓库平台,将计算与存储解耦,使用户可以分别独立扩展处理资源与数据存储。这种方式更具成本效益且性能更高。
其主要特性之一是自动伸缩,可根据工作负载需求调整资源,并支持多云环境。另一个关键特性是平台级数据共享,无需移动数据即可在组织内安全、便捷地访问数据。
2. 您能解释一下 Snowflake 的架构吗?
Snowflake 的架构是其独特卖点。它为云而生,具备多集群、共享数据架构以及强大的存储能力。Snowflake 架构分为三层:
- 数据库存储层:在这一层,结构化与半结构化数据被存储,并自动进行压缩、加密和组织成微分区,以充分优化存储并提升查询性能。
- 计算层:也称虚拟仓库,由一个或多个计算集群构成,负责执行所有数据处理任务。各集群彼此无关联,确保不同工作负载互不影响。
- 云服务层:包含基础设施管理、查询优化器、元数据管理与安全等多种服务。这些服务协调用户与系统之间的交互,提供全托管体验。
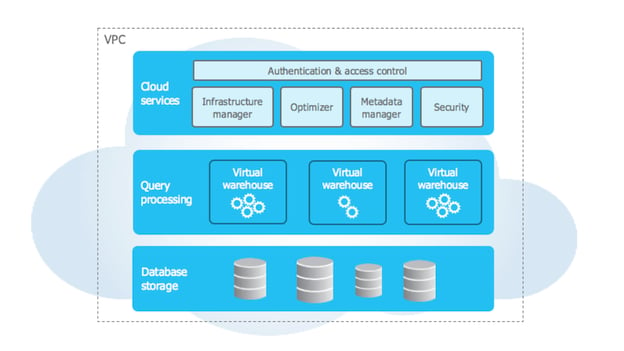
Snowflake 的高层架构。图片来源:Snowflake 文档。
3. 什么是 Snowflake 的微分区(micro-partitions)?它如何提升平台的数据存储效率?
微分区是 Snowflake 存储方式的基础。它是压缩、托管的列式存储单元,Snowflake 用其存放数据,单个大小约 50MB 到 150MB。列式格式有利于高效的数据压缩与编码方案。
微分区的压缩能力使海量数据得以高效管理,减少所需物理存储空间,从而降低存储成本。借助数据剪枝,查询仅访问相关微分区,从而提升查询性能。这种选择性访问方式对数据检索与分析尤为有利。
微分区由 Snowflake 自动管理,无需手动分区或建索引,即可实现优化存储,同时降低管理成本。
4. 虚拟仓库如何影响数据处理任务的可扩展性、性能与成本管理?
虚拟仓库负责执行所有数据处理任务,因此对可扩展性、性能与成本管理有深远影响。
其动态伸缩功能允许用户根据工作负载按需扩缩计算资源。当数据处理需求上升时,您可以在不影响现有操作的情况下增加计算资源。
各虚拟仓库之间互不影响,可在时间敏感分析等特定任务中保持高性能与一致性。计费按实际使用的计算资源进行,相比传统数据仓库方案,具备更好的成本管理能力。
下表比较了虚拟仓库与传统计算资源:
| 特性 | 虚拟仓库(Snowflake) | 传统计算资源 |
|---|---|---|
| 可扩展性 | 自动伸缩、多集群;可根据工作负载无中断地向上或向下调整规模。 | 通常为固定容量,扩容需人工升级。 |
| 隔离性 | 计算集群相互隔离,并发工作负载独立运行。 | 资源共享常导致任务间争用。 |
| 成本管理 | 仅为活跃时间付费,并可按需扩缩,最大限度减少空闲成本。 | 无论工作负载变化与否成本固定,空闲成本可能更高。 |
| 性能优化 | 可独立扩缩并为特定任务单独调优,保障时间敏感查询的高性能。 | 调优空间有限,扩缩会同等影响所有工作负载。 |
5. Snowflake 兼容 ANSI SQL 标准对查询与数据操作能力有何影响?
ANSI SQL 是美国国家标准协会制定的结构化查询语言标准,是关系型数据库管理系统的通用语言。
这意味着 Snowflake 用户可以使用熟悉的 SQL 语法与操作进行查询,如 JOIN,便于具备 SQL 经验的用户迁移到 Snowflake。兼容 ANSI SQL 的另一优势是可无缝集成多种数据类型,用户无需先将数据转换或载入预定义模式即可进行查询。
如果您想获得 Snowflake 平台相关认证,请参考 Which is the Best Snowflake Certification For 2026?
6. 什么是 Snowflake 的 Time Travel(时光回溯)功能?它如何惠及用户?
Snowflake 的 Time Travel 功能允许用户在指定期限内(通常最多 90 天,取决于账户类型)访问与查询历史数据。该功能有助于数据恢复、审计与数据对比。例如,用户可以恢复误删的表,或回溯查看先前的数据状态。
Time Travel 减少对外部备份的依赖并简化数据版本管理,提供内建的数据恢复与回溯分析能力。
7. Snowflake 的数据共享如何工作?其主要优势是什么?
Snowflake 的数据共享功能允许组织在不创建额外数据副本的情况下,与外部用户或合作伙伴安全、实时地共享实时数据。这通过 Snowflake 的安全数据共享(Secure Data Sharing)实现,利用其多集群共享数据架构直接提供数据访问。
数据共享的优势包括:
- 降低存储与 ETL 成本。
- 保持数据新鲜度。
- 增强跨部门或与外部合作伙伴的协作,无需导出或导入文件即可访问数据。
8. 什么是 Snowflake 的零拷贝克隆(zero-copy cloning)?其重要性何在?
零拷贝克隆允许在不复制底层存储的情况下创建数据库、模式或表的副本。创建克隆时,其指向原始数据,只有对克隆数据的更改才会单独存储,显著节省存储。这在创建开发与测试环境或生成历史快照时尤为有用,不会增加存储成本。该特性可快速且经济地为多种用例复制数据,提升数据管理效率。
进阶类 Snowflake 面试题
已经对基础题驾轻就熟了?我们来看看更进阶的问题。
9. 请说明 Snowflake 的数据安全方案,尤其是其始终开启的加密机制。
Snowflake 通过始终开启的加密机制,确保为用户提供最高级别的数据保护与安全。这是一种无需用户设置或配置即可自动加密数据的方式,确保从原始数据到元数据的所有类型数据都采用强加密算法加密。其加密基于分层密钥模型:主密钥用于加密其他密钥,且 Snowflake 会轮换这些密钥以增强安全性。
在数据传输过程中,Snowflake 使用 TLS(传输层安全协议)对客户端与 Snowflake 之间传输的数据进行加密。端到端加密确保数据在生命周期的任何阶段都处于加密状态,从而降低泄露与入侵风险。
10. Snowflake 如何同时支持 ETL 与 ELT 流程?
抽取-转换-加载(ETL)与 抽取-加载-转换(ELT)流程 因 Snowflake 的架构与能力而被广泛采用。该平台满足用户多样的数据集成与转换需求,使组织能更高效地优化数据处理工作流。
在 ETL 中,数据从多种来源抽取后,先转换为目标格式,再加载入数据仓库。Snowflake 具备强大的 SQL 引擎,可在数据加载后通过 SQL 查询进行复杂转换。
在 ELT 中,数据先以原始形态加载入数据仓库,再在仓库内进行转换。Snowflake 的计算与存储解耦使原始数据能快速装载到仓库中,随后利用虚拟仓库完成数据转换。Snowflake 还支持 JSON、XML 等半结构化数据格式,便于原始数据无需预先转换即可装载入仓库。
11. 请列举至少 5 款与 Snowflake 兼容的 ETL 工具。
Snowflake 支持多种 ETL 工具,组织可按偏好选择进行数据集成与转换。以下工具可在 Snowflake 云数据平台上使用,将数据处理并导入 Snowflake 以供分析:
- Informatica
- Talend
- Matillion
- Fivetran
- Stitch
- Apache Airflow
- dbt
- StreamSets
- Microsoft Azure Data Factory
- AWS Glue
12. 请解释高级功能 Snowpipe 如何用于持续数据摄取。
Snowpipe 是 Snowflake 提供的持续数据摄取服务,可在数分钟内加载文件。借助 Snowpipe,您可以以小批量(微批)加载数据,让全组织的用户可在数分钟内访问数据,便于快速分析。
用户需指定放置数据文件的云存储路径及 Snowflake 中的目标表。该过程是自动化数据加载:Snowpipe 会自动检测存储路径中新文件,一旦检测到新文件,便将数据摄取到 Snowflake 并加载至指定表。
这种准实时流程确保数据尽快可用。Snowpipe 采用无服务器架构,会自动管理数据摄取所需的计算资源。
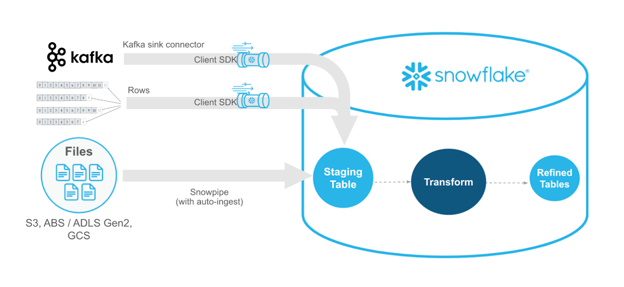
Snowpipe Streaming 的高层架构。图片来源: Snowflake 文档。
13. Snowflake 对 OLTP 与 OLAP 的定位是什么?
Snowflake 被设计为针对联机分析处理(OLAP)工作负载优化的数据仓库解决方案。OLAP 是用于从不同角度分析业务数据的软件技术。凭借其架构与功能,Snowflake 非常擅长支持大规模数据任务、复杂查询等。其 OLAP 方案的特性包括计算与存储分离、大规模并行处理(MPP)、支持多种数据结构以实现高效分析处理。
联机事务处理(OLTP)工作负载则并非 Snowflake 的传统设计目标。OLTP 指数据库同时接收数据请求与来自多用户的频繁更改,这些修改称为事务,特点是大量短事务(如插入与更新)。这类需求更偏向于操作型数据库,而非 Snowflake 这类数据仓库。
14. Snowflake 的聚簇机制如何工作?何时需要手动聚簇?
在 Snowflake 中,聚簇会在微分区内组织数据以优化查询性能。默认情况下,Snowflake 自动处理聚簇,但对于具有自然顺序(如时序数据)的超大表,手动聚簇可能更有利。
手动聚簇需要在查询中常用的列上创建聚簇键,使数据剪枝更高效,查询时可跳过无关分区。但手动聚簇应在性能收益大于对大数据集重聚簇的成本时才使用,因为它会影响存储与计算成本。
15. 解释 Snowflake 中的 fail-safe 概念,并说明其与 Time Travel 的区别。
Fail-safe 是 Snowflake 的数据恢复功能,用于在 Time Travel 保留期之外恢复被删除或修改的数据。Time Travel 允许在设定时长内(最多 90 天)访问历史数据;而 fail-safe 是 Time Travel 之后的 7 天时段,Snowflake 为灾难恢复目的保留数据。
与 Time Travel 不同,用户无法直接访问 fail-safe 数据,需要联系 Snowflake 支持介入。
Fail-safe 提供额外的数据保护层,但成本较高,应作为用尽 Time Travel 后的最后手段。
16. Snowflake 的物化视图如何工作?适用哪些场景?
Snowflake 的物化视图会将查询结果物理存储,可加速复杂或高频查询的检索。不同于每次查询都要重新计算的普通视图,物化视图会维护结果集,直至数据更新。这能显著改善涉及大型表的分析型查询性能。
物化视图的应用场景包括报表看板与聚合结果等数据变更不频繁的场合。但物化视图需要周期性维护,并会增加存储成本,因此更适合静态或变化缓慢的数据集。
下表比较了 Snowflake 中物化视图与普通视图的用例:
| 方面 | 普通视图 | 物化视图 |
|---|---|---|
| 数据存储 | 无物理存储;查询时计算 | 物理存储查询结果,提升查询速度 |
| 性能 | 适合小规模、低频查询 | 适合大型或复杂数据集的高频查询 |
| 维护成本 | 极低,无需存储 | 较高,需要存储与周期性刷新 |
| 用例 | 临时查询与数据探索 | 报表看板、预计算聚合 |
Snowflake 架构师面试题
基于 Snowflake 的独特架构,您需要彻底掌握其原理并检验自己的理解。
17. 共享磁盘(shared-disk)与共享无(shared-nothing)架构有何区别?
共享磁盘与共享无是两种不同的数据库与数据仓库设计方法。二者的主要差异在于如何在系统的多个节点间管理数据存储与处理。
在共享磁盘架构中,系统内的各节点都可访问磁盘存储,即任意节点都能读写系统中的任意磁盘。这带来高可用性,因为单个节点故障不会导致数据丢失或不可用。数据管理也更简单,因为无需在节点间对数据进行分区或复制。
而在共享无架构中,每个节点都拥有自己的私有存储,不与其他节点共享。数据在节点间被分区,每个节点负责一部分数据。这种方式具备可扩展性,可通过增加节点(各自带存储)来提升性能。
18. 在 Snowflake 中,如何定义“Staging”(暂存)?
当您将数据加载到 Snowflake 的 stage 中时,这称为“Staging(暂存)”。外部暂存指数据保存在其他云区域;内部暂存指数据保存在 Snowflake 内部。内部暂存与 Snowflake 环境集成,存放要加载到 Snowflake 表中的文件和数据。Snowflake 平台可使用 AWS、Google Cloud Platform、Azure 等外部存储提供商来存放需要加载或保存的数据。
19. Snowflake 有哪些类型的缓存?
Snowflake 包含三种缓存。下表对比它们并给出各自的应用场景:
| 缓存类型 | 描述 | 持续时间 | 用例 |
|---|---|---|---|
| 结果缓存(Result cache) | 在所有虚拟仓库间缓存查询结果,使重复查询可即时返回。 | 24 小时 | 加速结果相同的重复查询 |
| 本地磁盘缓存(Local disk cache) | 在每个虚拟仓库的本地磁盘上存储最近访问的数据,加快频繁访问数据的读取。 | 直至虚拟仓库被挂起 | 提升在同一仓库上重复查询的性能 |
| 远程缓存(Remote cache) | 在远程磁盘上长期存储数据以保证耐久性,即使服务中断也可访问数据。 | 永久,具备 99.999999999% 耐久性 | 在数据中心故障时确保数据可用与弹性 |
20. 定义 Snowflake 虚拟仓库的不同状态。
Snowflake 虚拟仓库有三种状态:
- 冷(Cold)虚拟仓库:当您在虚拟仓库未激活时运行查询,会启动一个“冷”虚拟仓库实例。
- 温(Warm)虚拟仓库:当当前虚拟仓库处于激活状态并已处理过查询,称为“温”虚拟仓库。
- 热(Hot)虚拟仓库:当虚拟仓库处于激活状态并已处理过查询,称为“热”虚拟仓库。
21. 不同虚拟仓库状态对查询性能有何影响?
- “冷”虚拟仓库的查询处理比“温”“热”更慢,因其使用远程磁盘,无法利用本地磁盘缓存与结果缓存。
- “温”虚拟仓库比“冷”更快,但仍慢于“热”。其使用本地磁盘,但不使用远程磁盘与结果缓存。
- “热”虚拟仓库相较“冷”“温”耗时最少。不使用远程磁盘与本地磁盘缓存,直接通过结果缓存返回结果,是获取查询结果的最高效方式。
22. Snowflake 在其架构中如何处理数据分布与分区?
Snowflake 通过微分区进行数据分布,微分区由 Snowflake 自动创建与管理。这些微分区是小型列式存储单元(每个 50–150 MB)。
Snowflake 的自动聚簇确保高效的数据分布,最大限度减少手动分区的需要。利用微分区可以进行数据剪枝,查询时仅访问相关分区,从而提升性能。与传统数据库不同,Snowflake 抽象了数据分区,用户无需手动管理数据分布,因而具备更好的可扩展性与易用性。
下表对这些机制进行对比:
| 机制 | 描述 | 收益 |
|---|---|---|
| 微分区 | 小型列式存储单元,用于组织与压缩数据。 | 实现数据剪枝,减少扫描数据量,加快查询。 |
| 自动聚簇 | Snowflake 自动维护微分区内的数据聚簇,并随数据变化进行调整。 | 简化数据管理,无需手动重聚簇 |
| 数据剪枝 | 基于元数据仅访问相关微分区,尽量减少不必要的扫描。 | 仅读取所需数据,提升查询性能 |
23. 请解释 Snowflake 中元数据服务(Metadata Service)的作用及其对性能的贡献。
元数据服务属于云服务层,在查询优化与数据管理中发挥关键作用。它跟踪表、列与分区的存储位置、访问模式与元数据。通过快速检索元数据,实现查询执行过程中的数据剪枝,减少扫描数据量并提升性能。
此外,元数据服务还管理与更新结果缓存,使短时间内相似查询可更快返回。总体而言,元数据服务提升了查询效率并降低资源消耗。
24. Snowflake 的自动挂起(auto-suspend)与自动恢复(auto-resume)如何工作?有何益处?
自动挂起与自动恢复有助于优化计算资源使用并降低成本。当虚拟仓库在设定时长内保持空闲,自动挂起会停止仓库,避免不必要的计算费用。
相反,自动恢复会在收到新查询时自动启动仓库,确保仅在仓库实际处理查询时产生计算费用。
这些功能对工作负载间歇性的环境尤其有利,既优化成本,又保障可用性。
Snowflake 编码面试题
25. 如何创建虚拟仓库?
可通过 Web 界面或使用 SQL 创建虚拟仓库,共有三种方式:
- Snowsight:选择 Admin > Warehouses > Warehouse
- Classic Console:选择 Warehouses > Create
- SQL:执行如下 CREATE WAREHOUSE 命令:
CREATE [ OR REPLACE ] WAREHOUSE [ IF NOT EXISTS ] <name>
[ [ WITH ] objectProperties ]
[ [ WITH ] TAG ( <tag_name> = '<tag_value>' [ , <tag_name> = '<tag_value>' , ... ] ) ]
[ objectParams ]26. 如何构建调用存储过程的 Snowflake 任务(Task)?
要创建 Snowflake 任务,需使用“CREATE TASK”。您需要在任务定义中指定 SQL 语句或存储过程,并确保具备创建任务的必要权限。步骤如下:
- 使用“
CREATE TASK”命令创建新任务,后接任务名称。 - 通过“
WAREHOUSE”指定执行该任务的虚拟仓库。 - 使用 cron 表达式在“
SCHEDULE”中定义任务执行时间,例如每天 UTC 1:00。 - 使用“
AS”引入任务要执行的 SQL 语句。 - 使用“
CALL”指定调用的存储过程作为任务动作。
例如:
CREATE TASK daily_sales_datacamp
WAREHOUSE = 'datacampwarehouse'
SCHEDULE = 'USING CRON 0 1 * * * UTC'
AS
CALL daily_sales_datacamp();27. 有一张表含 JSON 数据列,存放 DataCamp 客户反馈,包含键:“customer_id”“feedback_text”“timestamp”。写一条查询,提取并显示特定 customer_id 的反馈文本与时间戳。
以下查询演示如何在 Snowflake 中处理半结构化 JSON 数据:
SELECT
feedback_details:customer_id::INT AS customer_id,
feedback_details:feedback_text::STRING AS feedback_text,
feedback_details:timestamp::TIMESTAMP AS feedback_timestamp
FROM
customer_feedback
WHERE
feedback_details:customer_id::INT = 123; -- Replace 123 with the specific customer_id you're interested in28. 如何查看 Snowflake 任务的历史执行记录?
要查看任务历史,可使用 ‘TASK_HISTORY’ 表函数。这将为您提供指定时间范围内任务执行历史的详细信息。
SELECT *
FROM TABLE(INFORMATION_SCHEMA.TASK_HISTORY(
TASK_NAME => '<task_name>',
START_TIME => '<start_time>',
END_TIME => '<end_time>'
))
ORDER BY SCHEDULED_TIME DESC;29. 如何在 Snowflake 中创建临时表?
您需要使用 ‘CREATE TEMPORARY TABLE’ 语句。这将创建一个会话级的表,仅在用户设定的会话持续期间存在。
CREATE TEMPORARY TABLE table_name (
column_name1 data_type1,
column_name2 data_type2,
...
);30. 写一条查询,将时间戳列转换为另一个时区。
Snowflake 提供 CONVERT_TIMEZONE 函数在不同时区间转换时间戳。以下示例展示了如何将 UTC 转为美国东部标准时间(EST):
SELECT
customer_id,
CONVERT_TIMEZONE('UTC', 'America/New_York', order_timestamp) AS order_timestamp_est
FROM
orders;在该查询中,将 customer_id 与 order_timestamp 替换为您表中的具体列。该函数支持灵活的时区转换,适用于全球化报表。
31. 如何创建现有表的克隆?
您可以使用 CREATE TABLE ... CLONE 在 Snowflake 中创建零拷贝克隆。克隆与原表共享底层存储,从而节省成本与空间。
CREATE TABLE cloned_table_name CLONE original_table_name;例如,要克隆名为 sales_data 的表,语法如下:
CREATE TABLE sales_data_clone CLONE sales_data;该克隆表在创建时与原表的数据与模式一致。之后对克隆表的更改不会影响原表。
32. 写一条查询,列出某列中最常出现的前 5 个值。
可结合使用 GROUP BY、ORDER BY 与 LIMIT 获取某列最常出现的前 5 个值。比如,要在 product_id 列中查找最常见的 5 个产品:
SELECT
product_id,
COUNT(*) AS frequency
FROM
sales
GROUP BY
product_id
ORDER BY
frequency DESC
LIMIT 5;该查询按出现频次对 product_id 分组、降序排序,并限制结果为前 5 个,以显示最常售出的产品。
面试准备
准备任何面试时,以下事项很重要:
- 研究公司:了解公司的来龙去脉、成立时间与价值观。这能证明您做了功课,在踏入公司大门前就已对其有所了解。
- 阅读职位描述:职位描述能帮助您了解日常职责。描述中会列出所需工具与技能,您可在面试中提及,以展示能力。
- 具体说明您的成就:在应聘 Snowflake 岗位时,拥有认证与知识固然重要,但您还需用过往工作与项目的事实来支撑您的技能与经验。
- 广泛覆盖话题:务必为各类 Snowflake 概念的问题做好准备,从数据集成到编码。雇主希望候选人对软件了如指掌,能够胜任各类项目。
最后但同样重要的是,自信上阵,全力以赴!
结语
本文涵盖了四个层级的 Snowflake 面试题:
- 基础
- 进阶
- 架构师
- 编码
如果您想巩固或检验自己的 Snowflake 技能,请查看我们的教程 Introduction to Snowflake 与 Getting Started with Data Analysis in Snowflake using Python and SQL,以及我们的 Introduction to NoSQL 课程,学习如何使用 Snowflake 处理大数据。
此外,欢迎收听我们与前 Snowflake CEO Bob Muglia 的播客节目 “Why AI will Change Everything”。

勤于学习,期望运用我的数据科学技术背景与出色的人际沟通能力,提升并拓展我的技术认知与写作能力。
我从药理学转入数据科学领域,并在 Lambda School 完成了为期 9 个月的训练营。
我对在机器学习和人工智能领域实践并提升自己的编程与技术写作能力充满兴趣。
目前,我是一名数据科学家兼自由职业技术写作者。
Snowflake 改变了数据存储、处理与分析的世界,使企业更容易高效地管理和分析海量数据。
它可以在同一处存储并分析您的所有数据记录,并可根据需要自动弹性伸缩计算资源,以便加载、整合与分析数据。借助 Snowflake,您可以创建独立的虚拟仓库,让公司内不同团队在互不争用资源的情况下使用数据。想进一步了解,请查看 Introduction to Snowflake 课程。
本文将从四类主题讲解 Snowflake 面试题: