
Cursus
Generatieve AI-concepten
2 uur
121.1K
Oefen en volg je voortgang.
Ga Verder Met GoogleIn november 2022 lanceerde OpenAI ChatGPT. Het duurde slechts een paar dagen voordat het de wereld veroverde met zijn ongekende capaciteiten. De generatieve AI-revolutie was begonnen, en iedereen stelde dezelfde vraag: wat komt hierna?
Destijds waren ChatGPT en de vele andere generatieve AI-tools op basis van Large Language Models (LLM’s) ontworpen om tekstinvoer van gebruikers te verwerken en tekstuitvoer te genereren. Met andere woorden: het waren unimodale AI-tools.
Maar dat was nog maar het begin. We krabden slechts aan de oppervlakte van wat LLM’s kunnen. Slechts een jaar na de lancering van ChatGPT is de vooruitgang in de sector ronduit verbazingwekkend, waardoor het erg lastig is om de grenzen van het mogelijke te bepalen, zoals we analyseerden in ons aparte artikel over de langetermijneffecten van ChatGPT en generatieve AI.
Als we vandaag de vraag zouden beantwoorden wat komt hierna? is het beste antwoord waarschijnlijk multimodale learning. Dit is een van de meest veelbelovende trends in de voortdurende AI-revolutie. Multimodale generatieve AI-modellen kunnen verschillende soorten input combineren en een output creëren die ook meerdere soorten uitvoer kan omvatten.
In deze gids nemen we je mee door het concept van multimodale AI. We bekijken de definitie van multimodale AI, de kernconcepten, onderliggende technologieën en toepassingen, en hoe je ze in de praktijk kunt implementeren. Klaar voor multimodaliteit? Laten we beginnen!
Hoewel de meest geavanceerde generatieve AI-tools nog niet in staat zijn te denken als mensen, leveren ze baanbrekende resultaten die ons weer een stapje dichter bij de drempel van Artificial General Intelligence (AGI) brengen. Deze term verwijst naar een hypothetisch AI-systeem dat, net als een mens, kennis kan begrijpen, leren en toepassen over een breed scala aan taken.
In het debat over hoe we AGI bereiken, moeten we een centrale vraag beantwoorden: hoe leren mensen? En dat brengt ons bij hoe het menselijk brein werkt. Kort gezegd: ons brein vertrouwt op onze vijf zintuigen om allerlei informatie uit de omgeving te verzamelen. Die informatie wordt vervolgens in ons geheugen opgeslagen, verwerkt om nieuwe inzichten te leren en benut om beslissingen te nemen.
De eerste moderne generatieve AI-modellen, zoals ChatGPT, werden beschouwd als unimodaal; dat wil zeggen, ze konden slechts één type data als input nemen en hetzelfde type output genereren. De meeste van deze modellen waren specifiek ontworpen om tekstprompts te verwerken en een tekstantwoord te genereren.
Dat is logisch, want deze modellen hebben enorme hoeveelheden data nodig om te trainen, en tekst is niet alleen een datatype dat gemakkelijk kan worden opgeslagen en verwerkt, maar ook ruim voorhanden. Het is niet verrassend dat het grootste deel van de trainingsdata van tools zoals ChatGPT afkomstig is van verschillende bronnen op internet. We leggen al deze technische details uit in ons artikel What is ChatGPT, waarin we de vragen rechtstreeks aan ChatGPT stellen.
Lezen is echter slechts één van de manieren waarop mensen nieuwe dingen kunnen leren, en voor veel taken niet de meest effectieve.
Multimodale learning is een deelgebied van AI dat probeert het leervermogen van machines te vergroten door ze te trainen met grote hoeveelheden tekst, maar ook met andere datatypen, ook wel sensorische data genoemd, zoals afbeeldingen, video’s of audio-opnames. Dit stelt modellen in staat nieuwe patronen en correlaties te leren tussen tekstbeschrijvingen en de bijbehorende afbeeldingen, video’s of audio.
Multimodale learning ontsluit nieuwe mogelijkheden voor intelligente systemen. De combinatie van meerdere datatypen tijdens het trainingsproces maakt multimodale AI-modellen geschikt om meerdere modaliteiten als input te ontvangen en meerdere typen output te genereren. Zo kan GPT-4, het foundation model van ChatGPT, zowel beeld- als tekstinput accepteren en tekstuitvoer genereren, en is er het recent aangekondigde Sora text-to-video-model van OpenAI.
Multimodale generatieve AI-modellen voegen een nieuwe laag complexiteit toe aan state-of-the-art LLM’s. Deze modellen zijn gebaseerd op een type neurale architectuur dat een Transformer wordt genoemd. Ontwikkeld door Google-onderzoekers, bouwen transformers voort op de encoder-decoder-architectuur en het attention-mechanisme om efficiënte gegevensverwerking mogelijk te maken.
Dit is een behoorlijk complex proces dat lastig te doorgronden kan zijn. Als je meer details wilt over hoe LLM’s en transformers werken, raden we je sterk aan onze How Transformers Work-gids te lezen, of, als je zelf aan de slag wilt en stap voor stap wilt leren hoe je LLM’s maakt, bekijk dan onze Large Language Models (LLMs) Concepts-cursus.
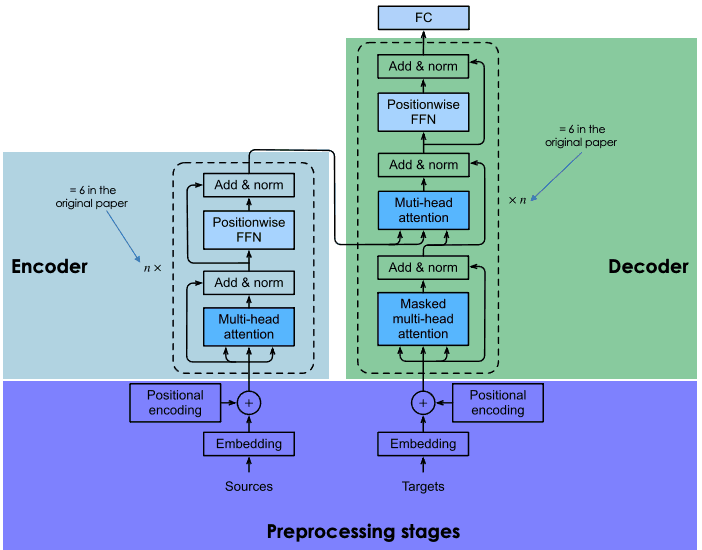
Bron: DataCamp
Multimodale AI steunt op datafusietechnieken om uiteenlopende datatypen te integreren en zo een completer en nauwkeuriger begrip van de onderliggende data op te bouwen. Het uiteindelijke doel is betere voorspellingen te doen door de aanvullende informatie te combineren die verschillende datamodaliteiten bieden.
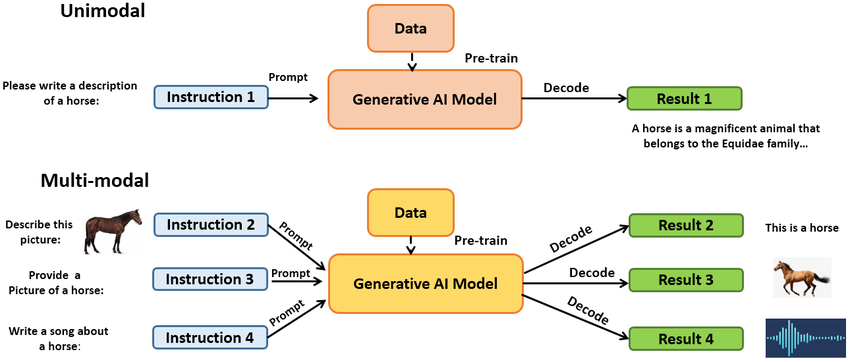
Unimodale vs multimodale AI. Bron: ResearchGate
Er kunnen verschillende datafusietechnieken worden ingezet om multimodale uitdagingen aan te pakken. Afhankelijk van het verwerkingsstadium waarop de fusie plaatsvindt, kunnen we datafusietechnieken indelen in drie categorieën:
Er is geen enkele datafusietechniek die in alle scenario’s het beste is. De gekozen techniek hangt af van de multimodale taak. Daarom is er waarschijnlijk een proces van trial-and-error nodig om de meest geschikte multimodale AI-pijplijn te vinden.
Multimodale AI is het resultaat van opgebouwde kennis in meerdere deelgebieden van AI. De afgelopen jaren hebben AI-practitioners en wetenschappers indrukwekkende vooruitgang geboekt in het opslaan en verwerken van data in meerdere formaten en modaliteiten.
Hieronder vind je een lijst met domeinen die de multimodale AI-hausse aanjagen:
Deep learning is een deelgebied van AI dat een type algoritme gebruikt dat een kunstmatig neuraal netwerk wordt genoemd om complexe taken aan te pakken. De huidige generatieve AI-revolutie wordt aangedreven door deep learning-modellen, met name transformers, een type neurale architectuur.
De toekomst van multimodale AI zal ook afhangen van nieuwe vooruitgang op dit gebied. Er is vooral veel onderzoek nodig naar manieren om de capaciteiten van transformers te vergroten, evenals naar nieuwe datafusietechnieken.
Bekijk onze Deep Learning in Python-track om je kennis in dit veelbelovende domein te verdiepen.
NLP is een cruciale technologie binnen kunstmatige intelligentie die de kloof overbrugt tussen menselijke communicatie en computerbegrip. Het is een multidisciplinair domein dat computers in staat stelt menselijke taal te interpreteren, analyseren en genereren, waardoor naadloze interactie tussen mens en machine mogelijk wordt.
Aangezien de primaire manier om met machines te communiceren tekst is, is het niet verrassend dat NLP essentieel is om de hoge prestaties van generatieve AI-modellen, inclusief multimodale, te waarborgen.
Geïnteresseerd in NLP? Bekijk onze Natural Language Processing in Python-track om de kernvaardigheden in NLP op te doen die nodig zijn om ongestructureerde data om te zetten in waardevolle inzichten.
Beeldanalyse, ook wel computer vision genoemd, omvat een set technieken waarmee computers een afbeelding kunnen “zien” en begrijpen. De vooruitgang in deze sector heeft de ontwikkeling mogelijk gemaakt van multimodale AI-modellen die afbeeldingen en video’s zowel als input én als output kunnen verwerken.
Als je dieper in dit fascinerende onderwerp wilt duiken, bekijk dan onze Image Processing with Python Skill Track om beeldverwerkingsvaardigheden toe te voegen aan je data science-gereedschapskist.
Sommige van de meest geavanceerde generatieve AI-modellen kunnen audiobestanden zowel als input als output verwerken. De mogelijkheden van audioprocessing variëren van het interpreteren van spraakberichten tot simultaanvertaling en het creëren van muziek.
Bekijk onze Spoken Language Processing in Python-cursus om te leren hoe je spraak uit ruwe audiobestanden in Python laadt, transformeert en transcribeert.
Multimodale learning geeft machines nieuwe “zintuigen”, waardoor hun nauwkeurigheid en interpretatievermogen toenemen. Deze krachten openen de deur naar talloze nieuwe toepassingen in sectoren en industrieën, waaronder:
De meeste generatieve AI-modellen van de eerste generatie waren text-to-text: ze konden tekstprompts van gebruikers verwerken en tekstantwoorden geven. Multimodale modellen, zoals GPT-4 Turbo, Google Gemini of DALL-E, bieden nieuwe mogelijkheden die de gebruikerservaring kunnen verbeteren aan zowel de input- als de outputkant. Of het nu gaat om het accepteren van prompts in meerdere modaliteiten of het genereren van content in diverse formaten, de mogelijkheden van multimodale AI-agents lijken onbegrensd.
Zelfrijdende auto’s leunen zwaar op multimodale AI. Deze auto’s zijn uitgerust met meerdere sensoren om informatie uit de omgeving in verschillende formaten te verwerken. Multimodale learning is cruciaal voor deze voertuigen om deze bronnen effectief en efficiënt te combineren en in real time intelligente beslissingen te nemen.
De toenemende beschikbaarheid van biomedische data uit biobanken, elektronische patiëntendossiers, klinische beeldvorming en medische sensoren, evenals genomische data, voedt de creatie van multimodale AI-modellen in de geneeskunde. Deze modellen kunnen deze uiteenlopende databronnen in meerdere modaliteiten verwerken om ons te helpen de mysteries van menselijke gezondheid en ziekte te ontrafelen en om intelligente klinische beslissingen te nemen.
De snelle uitbreiding van grondsensoren, drones, satellietdata en andere meettechnieken vergroot ons vermogen om de planeet te begrijpen. Multimodale AI is essentieel om deze informatie nauwkeurig te combineren en nieuwe toepassingen en tools te creëren die ons kunnen helpen bij verschillende taken, zoals het monitoren van broeikasgasemissies, het voorspellen van extreme klimaatgebeurtenissen en precisielandbouw.
De multimodale AI-hausse biedt eindeloze mogelijkheden voor bedrijven, overheden en individuen. Maar zoals met elke opkomende technologie kan het een uitdaging zijn om ze in je dagelijkse processen te implementeren.
Allereerst moet je use-cases vinden die aansluiten op jouw specifieke behoeften. Van concept naar uitrol gaan is niet altijd eenvoudig, zeker niet als je de mensen mist die de technische finesses achter multimodale AI echt begrijpen. Gezien de huidige kloof in datageletterdheid kan het vinden van de juiste mensen om je modellen in productie te brengen lastig en kostbaar zijn, omdat bedrijven bereid zijn hoge bedragen te betalen om zo’n schaars talent aan te trekken.
Tot slot, als we het over generatieve AI hebben, is betaalbaarheid onvermijdelijk onderwerp. Deze modellen, zeker multimodale, vereisen aanzienlijke rekenkracht om te werken, en dat kost geld. Daarom is het belangrijk om vóór de adoptie van een generatieve AI-oplossing in te schatten welke middelen je wilt investeren.
Zoals bij elke nieuwe technologie zijn er verschillende potentiële valkuilen waar we bij multimodale AI-modellen doorheen moeten navigeren:
Multimodale AI is zeker de volgende grens van de generatieve AI-revolutie. De snelle ontwikkeling van het vakgebied multimodale learning stimuleert de creatie van nieuwe modellen en toepassingen voor allerlei doeleinden. We staan pas aan het begin van deze revolutie. Naarmate er nieuwe technieken worden ontwikkeld om meer en nieuwe modaliteiten te combineren, zal de reikwijdte van multimodale AI toenemen.
Maar met grote macht komt grote verantwoordelijkheid. Multimodale AI brengt serieuze risico’s en uitdagingen met zich mee die moeten worden aangepakt om een eerlijke en duurzame toekomst te waarborgen.
Wil je beginnen met generatieve AI? DataCamp helpt je op weg. Bekijk onze speciale cursussen, blogs en materialen:
Begin vandaag nog met je AI-reis!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

