Kurs
Konzeptuelle Einführung in generative KI
2 Std.
117.1K
Im November 2022 brachte OpenAI ChatGPT auf den Markt. Nur wenige Tage genügten, und das Tool eroberte mit seinen einzigartigen Fähigkeiten die Welt. Die Revolution der Generativen KI war gestartet – und alle stellten dieselbe Frage: Was kommt als Nächstes?
Zu dieser Zeit waren ChatGPT und viele andere generative KI-Tools, die auf Large Language Models (LLMs) basierten, darauf ausgelegt, Texteingaben zu verarbeiten und Textausgaben zu erzeugen. Mit anderen Worten: Es handelte sich um unimodale KI-Tools.
Doch das war erst der Anfang. Wir kratzten gerade einmal an der Oberfläche dessen, was LLMs leisten können. Nur ein Jahr nach dem Start von ChatGPT ist der Fortschritt der Branche schlicht beeindruckend – die Grenzen des Möglichen lassen sich kaum noch abstecken, wie wir in unserem separaten Beitrag zu den langfristigen Auswirkungen von ChatGPT und Generativer KI analysiert haben.
Wenn wir heute die Frage beantworten müssten, was als Nächstes kommt, lautet die beste Antwort wohl: multimodales Lernen. Das ist einer der spannendsten Trends der laufenden KI-Revolution. Multimodale generative KI-Modelle können verschiedene Eingabetypen kombinieren und Ausgaben erzeugen, die ebenfalls mehrere Formate umfassen können.
In diesem Leitfaden führen wir dich in das Konzept der multimodalen KI ein. Wir schauen uns die Definition, die Kernkonzepte, die zugrunde liegenden Technologien und Anwendungen an – und wie sich das Ganze in realen Szenarien umsetzen lässt. Bereit für Multimodalität? Los geht’s!
Auch wenn die meisten fortgeschrittenen generativen KI-Tools noch nicht wie Menschen denken, liefern sie bahnbrechende Ergebnisse, die uns der Schwelle zur Allgemeinen Künstlichen Intelligenz (AGI) ein Stück näherbringen. Dieser Begriff bezeichnet ein hypothetisches KI-System, das Wissen wie ein Mensch über ein breites Spektrum von Aufgaben verstehen, erlernen und anwenden kann.
In der Debatte darüber, wie AGI zu erreichen ist, steht eine Frage im Zentrum: Wie lernen Menschen? Und damit sind wir bei der Funktionsweise des menschlichen Gehirns. Kurz gesagt: Unser Gehirn stützt sich auf die fünf Sinne, um Informationen aus der Umwelt aufzunehmen. Diese Informationen werden im Gedächtnis gespeichert, verarbeitet, um neue Erkenntnisse zu gewinnen, und für Entscheidungen genutzt.
Die ersten modernen generativen KI-Modelle wie ChatGPT galten als unimodal – sie konnten nur einen Datentyp als Eingabe verarbeiten und denselben Typ als Ausgabe erzeugen. Insbesondere waren die meisten dieser Modelle darauf ausgelegt, Text-Prompts zu verarbeiten und eine Textantwort zu liefern.
Das ist naheliegend, denn diese Modelle benötigen enorme Datenmengen zum Training; Text ist nicht nur leicht zu speichern und zu verarbeiten, sondern auch in großer Menge verfügbar. Es überrascht daher nicht, dass ein Großteil der Trainingsdaten von Tools wie ChatGPT aus unterschiedlichen Internetquellen stammt. Die technischen Hintergründe erklären wir im Detail in unserem What is ChatGPT-Artikel, in dem wir ChatGPT direkt befragen.
Allerdings ist Lesen nur eine von vielen Möglichkeiten, wie Menschen lernen – und für zahlreiche Aufgaben nicht die effektivste.
Multimodales Lernen ist ein Teilgebiet der KI, das die Lernfähigkeit von Maschinen erweitert, indem es sie nicht nur mit großen Mengen an Text, sondern auch mit anderen Datentypen – sogenannten Sensordaten – wie Bildern, Videos oder Audiodateien trainiert. So lernen Modelle neue Muster und Zusammenhänge zwischen Textbeschreibungen und den dazugehörigen Bildern, Videos oder Audiosequenzen.
Multimodales Lernen eröffnet intelligente Systeme für völlig neue Möglichkeiten. Die Kombination mehrerer Datentypen im Training macht multimodale KI-Modelle dafür geeignet, Eingaben in verschiedenen Modalitäten anzunehmen und Ausgaben in verschiedenen Formaten zu erzeugen. So kann etwa GPT-4, das Foundation Model von ChatGPT, sowohl Bild- als auch Texteingaben verarbeiten und Text ausgeben, ebenso wie das kürzlich angekündigte Sora Text-zu-Video-Modell von OpenAI.
Multimodale generative KI-Modelle fügen modernen LLMs eine zusätzliche Komplexitätsschicht hinzu. Diese Modelle basieren auf einer neuronalen Architektur namens Transformer. Von Google-Forschenden entwickelt, setzen Transformer auf eine Encoder-Decoder-Architektur und den Aufmerksamkeitsmechanismus, um Daten effizient zu verarbeiten.
Das ist ein recht komplexer Prozess, der nicht leicht zu durchschauen ist. Wenn du tiefer verstehen willst, wie LLMs und Transformer funktionieren, empfehlen wir dir unseren Leitfaden How Transformers Work. Oder wenn du praktisch einsteigen und Schritt für Schritt eigene LLMs bauen möchtest, sieh dir unseren Large Language Models (LLMs) Concepts Course an.
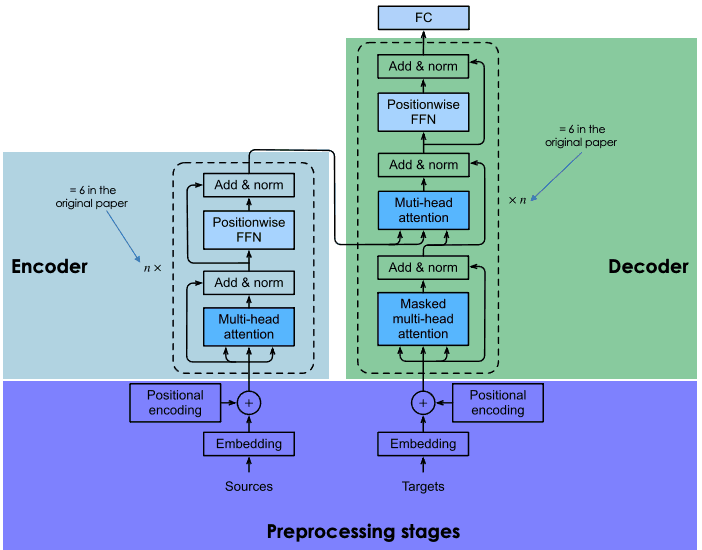
Quelle: DataCamp
Multimodale KI setzt auf Datenfusionstechniken, um unterschiedliche Datentypen zu integrieren und ein vollständigeres, präziseres Verständnis der zugrunde liegenden Daten aufzubauen. Das Ziel ist, bessere Vorhersagen zu treffen, indem die komplementären Informationen der verschiedenen Datenmodalitäten zusammengeführt werden.
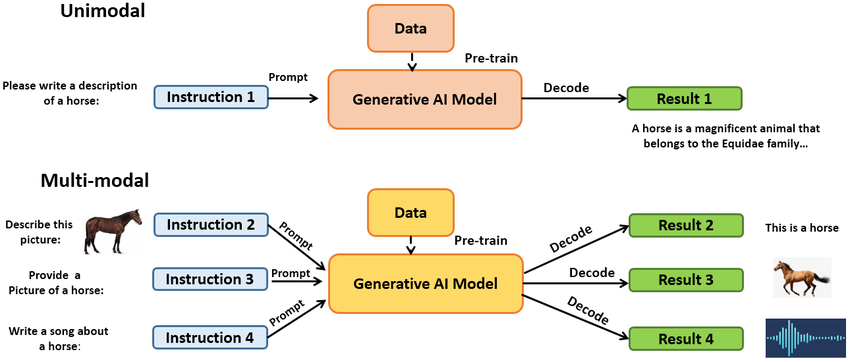
Unimodale vs. multimodale KI. Quelle: ResearchGate
Für multimodale Herausforderungen lassen sich verschiedene Datenfusionstechniken einsetzen. Je nachdem, in welcher Verarbeitungsphase die Fusion erfolgt, lassen sich drei Kategorien unterscheiden:
Es gibt keine eine Datenfusionstechnik, die in allen Szenarien am besten ist. Die Wahl hängt von der jeweiligen multimodalen Aufgabe ab. In der Praxis ist daher oft Ausprobieren nötig, um die passende Pipeline für multimodale KI zu finden.
Multimodale KI ist das Ergebnis kumulierten Wissens aus mehreren Teilbereichen der KI. In den letzten Jahren haben Fachleute und Forschende große Fortschritte darin gemacht, Daten in vielen Formaten und Modalitäten zu speichern und zu verarbeiten.
Hier sind die Bereiche, die den Boom multimodaler KI antreiben:
Deep Learning ist ein Teilgebiet der KI, das eine Klasse von Algorithmen namens künstliche neuronale Netze einsetzt, um komplexe Aufgaben zu lösen. Die aktuelle Revolution der Generativen KI wird von Deep-Learning-Modellen angetrieben, insbesondere von Transformern als spezieller Netzarchitektur.
Auch die Zukunft der multimodalen KI hängt von neuen Fortschritten in diesem Bereich ab. Insbesondere braucht es Forschung, um Transformer weiter zu stärken und neue Datenfusionstechniken zu entwickeln.
Sieh dir unseren Deep Learning in Python Track an, um in diesem vielversprechenden Feld weiterzukommen.
NLP ist eine Schlüsseltechnologie der Künstlichen Intelligenz, die die Lücke zwischen menschlicher Kommunikation und maschinellem Verständnis schließt. Das multidisziplinäre Feld befähigt Computer, menschliche Sprache zu interpretieren, zu analysieren und zu erzeugen – für eine reibungslose Interaktion zwischen Mensch und Maschine.
Da Text der primäre Kanal zur Kommunikation mit Maschinen ist, überrascht es nicht, dass NLP entscheidend für die Leistungsfähigkeit generativer KI-Modelle ist – auch bei multimodalen Modellen.
Interessiert an NLP? Dann wirf einen Blick auf unseren Natural Language Processing in Python Track und lerne die zentralen NLP-Kompetenzen, um unstrukturierte Daten in wertvolle Erkenntnisse zu verwandeln.
Die Bildanalyse, auch Computer Vision genannt, umfasst Techniken, mit denen Computer ein Bild „sehen“ und verstehen können. Der Fortschritt in diesem Bereich hat multimodale KI-Modelle ermöglicht, die Bilder und Videos sowohl als Eingaben als auch als Ausgaben verarbeiten.
Wenn du tiefer in dieses faszinierende Thema einsteigen willst, sieh dir unseren Image Processing with Python Skill Track an und erweitere deinen Data-Science-Werkzeugkasten um Bildverarbeitung.
Einige der fortschrittlichsten generativen KI-Modelle können Audiodateien sowohl als Eingaben als auch als Ausgaben verarbeiten. Die Möglichkeiten reichen vom Verstehen von Sprachnachrichten über Simultanübersetzung bis hin zur Musikproduktion.
Sieh dir unseren Spoken Language Processing in Python Course an und lerne, wie du Roh-Audiodateien in Python lädst, transformierst und transkribierst.
Multimodales Lernen verleiht Maschinen neue „Sinne“ und steigert Präzision und Interpretationsfähigkeit. Diese Stärken öffnen die Tür zu unzähligen Anwendungen quer durch Branchen und Sektoren, darunter:
Die erste Generation generativer KI-Modelle war meist Text-zu-Text: Sie verarbeiteten Text-Prompts und lieferten Textantworten. Multimodale Modelle wie GPT-4 Turbo, Google Gemini oder DALL-E bringen neue Möglichkeiten, die das Nutzererlebnis sowohl bei Eingaben als auch Ausgaben verbessern. Ob Prompts in mehreren Modalitäten oder Inhalte in verschiedenen Formaten – die Einsatzszenarien für multimodale KI-Agenten scheinen grenzenlos.
Selbstfahrende Autos setzen stark auf multimodale KI. Sie sind mit zahlreichen Sensoren ausgestattet, die Umgebungsinformationen in verschiedenen Formaten erfassen. Multimodales Lernen ist entscheidend, um diese Quellen effizient zu kombinieren und in Echtzeit intelligente Entscheidungen zu treffen.
Die wachsende Verfügbarkeit biomedizinischer Daten aus Biobanken, elektronischen Gesundheitsakten, bildgebender Diagnostik, medizinischen Sensoren sowie Genomdaten treibt multimodale KI-Modelle in der Medizin voran. Diese Modelle können vielfältige Datenquellen in unterschiedlichen Modalitäten verarbeiten, um die Geheimnisse von Gesundheit und Krankheit besser zu verstehen und fundierte klinische Entscheidungen zu unterstützen.
Die schnelle Verbreitung von Bodensensoren, Drohnen, Satellitendaten und anderen Messtechniken erweitert unser Verständnis des Planeten. Multimodale KI ist entscheidend, um diese Informationen präzise zu kombinieren und neue Anwendungen und Tools zu entwickeln – etwa für die Überwachung von Treibhausgasemissionen, die Vorhersage extremer Wetterereignisse und die Präzisionslandwirtschaft.
Der Boom multimodaler KI eröffnet enorme Chancen für Unternehmen, Behörden und Einzelpersonen. Doch wie bei jeder jungen Technologie ist die Implementierung im Alltag anspruchsvoll.
Zunächst gilt es, die Anwendungsfälle zu finden, die zu deinen spezifischen Bedürfnissen passen. Der Schritt vom Konzept zur Umsetzung ist nicht immer einfach – insbesondere, wenn dir die Leute fehlen, die die technischen Feinheiten multimodaler KI wirklich verstehen. Angesichts der aktuellen Kompetenzlücke bei der Datenkompetenz ist es zudem schwierig und teuer, die richtigen Fachkräfte zu finden, denn Unternehmen zahlen hohe Summen, um diese knappen Talente zu gewinnen.
Und schließlich kommt bei generativer KI immer die Kostenfrage ins Spiel. Diese Modelle – besonders multimodale – benötigen erhebliche Rechenressourcen, und das kostet. Bevor du also eine generative KI-Lösung einführst, solltest du die dafür vorgesehenen Ressourcen realistisch einschätzen.
Wie bei jeder neuen Technologie gibt es auch bei multimodalen KI-Modellen Risiken, die wir im Blick behalten müssen:
Multimodale KI ist zweifellos die nächste Ausbaustufe der Generativen-KI-Revolution. Die rasante Entwicklung des multimodalen Lernens treibt neue Modelle und Anwendungen für die unterschiedlichsten Zwecke voran. Wir stehen erst am Anfang. Mit neuen Techniken, die mehr und neue Modalitäten kombinieren, wird sich der Anwendungsbereich weiter ausdehnen.
Mit großer Macht kommt allerdings auch große Verantwortung. Multimodale KI bringt erhebliche Risiken und Herausforderungen mit sich, die wir adressieren müssen, um eine faire und nachhaltige Zukunft zu sichern.
Wenn du in die Generative KI einsteigen willst, bist du bei DataCamp richtig. Sieh dir unsere Kurse, Blogs und Materialien an:
Starte noch heute deine KI-Reise!
Kurs
Kurs
Kurs