偏差-方差权衡解释了为何模型表现不只是关于复杂度或准确率,而是要找到那个甜蜜点:既不过度简化问题、也不对训练集过拟合,同时能对未见数据实现良好泛化。
本文将解释在机器学习中偏差与方差的真正含义、它们如何相互制衡,以及理解这种权衡为何能帮助您构建更健壮的模型。
如果您是机器学习新手,我们的 2026 年如何学习机器学习一文将帮助您迅速上手。
什么是偏差?
偏差是因对数据作出过于简单的假设而产生的误差。在机器学习语境中,它与“偏见”无关。
当模型偏差很高时,意味着模型过于僵硬,无法捕捉数据中的真实模式。就像试图用一条直线去拟合明显呈曲线的数据:无论怎样调整,那条直线都无法贴合真实形状。
这被称为欠拟合。
高偏差模型把问题过度简化。它假设关系比实际更简单,从而错过了有助于做出准确预测的重要模式。
设想您根据面积、卧室数量、地段和房龄来预测房价。高偏差模型可能只使用面积,忽略其它因素。它假设仅凭面积就能决定价格,这就太过简单了。
结果是模型在训练数据和新数据上都表现不佳,因为它无法体现真实房价的复杂性。
使用少量特征的线性回归是典型的高偏差模型。深度受限的决策树也往往偏差较高,因为它们无法进行足够多的划分来发现细微的模式。
高偏差意味着您的模型从数据中学得不够,反而把问题简单化到难以获得良好准确度的程度。
什么是方差?
方差衡量您的模型对所用训练数据的敏感程度。
它与统计学中数据离散程度的度量不同。在机器学习中,方差描述的是模型行为,而非数据分布。
当模型方差很高时,训练数据的微小变化会导致预测发生巨大变化。换句话说,用两份略有不同的数据集训练同一模型,结果可能截然不同。
这被称为过拟合。
高方差模型过于灵活。它不仅学习数据中的真实模式,也会学习噪声和随机波动,这些无法泛化到新数据上。模型本质上是在记忆训练样本,而不是学习底层关系。
想象您仍在预测房价,但现在使用一个拥有数百个参数的复杂模型。它可能学到“橡树街上的房子总是以恰好 $427,350 售出”,因为这正是您的训练数据中发生的情况。
结果是模型在训练数据上表现极佳,但在新数据上很差,因为它学到的是训练集特有的怪癖。
深度神经网络和深度无限制的决策树是经典的高方差模型。它们的灵活性足以拟合几乎任何模式,包括毫无意义的模式。
高方差意味着您的模型从数据中学得太多。它把噪声也当作信号来拟合,导致在新样本上不稳定且不可靠。
偏差 vs. 方差:关键差异
偏差与方差是两种完全不同的预测误差来源。一旦理解它们的区别,您就能更快诊断出模型的问题所在。
- 偏差来自模型的假设。 它与您选择的算法、纳入的特征以及问题结构有关。线性回归假设关系是线性的,因此当真实关系是非线性时会产生偏差。这种误差在您查看训练数据之前就已存在。
- 方差来自对训练数据的敏感性。 它描述当您在同一总体的不同样本上训练时,模型会发生多大变化。高方差模型会从略有不同的训练集学习到不同的模式,使其预测不稳定。
以下是偏差与方差如何影响预测误差:
- 高偏差意味着模型在同一方向上持续犯错。它总是低估或高估某些模式,因为无法表示真实关系。这些错误具有系统性且可预测。
- 高方差意味着模型犯错不一致,随数据变化而变化。周一的数据训练会预测一种结果,周二的数据训练又是完全不同的结果。错误是随机且不可预测的。
问题在于,降低其中一个通常会提高另一个。
当您让模型更复杂以降低偏差时,它的灵活性会提高。这种灵活性会令其对训练数据更敏感,从而增加方差。当您简化模型以降低方差时,又会削弱其捕捉复杂模式的能力,从而增加偏差。
这种反向关系意味着您无法同时把两者都最小化。相反,您必须找到能带来最低总误差的平衡点。
什么是偏差-方差权衡?
偏差-方差权衡描述了这两种误差源之间的张力——当您降低一个时,几乎总会提高另一个。
可以这样想:您在瞄准一个目标,但有两种相互牵制的问题。您可以更精确地瞄准(降低偏差),但这会让您对风和手抖更敏感(增加方差)。或者您可以采用更简单、更稳定的射击姿势(降低方差),但这会限制精度(增加偏差)。
模型复杂度是这种权衡的核心。
当您使用参数较少的简单模型时,会得到高偏差、低方差。模型的假设一致,在不同训练数据下变化不大,但无法捕捉复杂模式。
当您使用参数众多的复杂模型时,会得到低偏差、高方差。模型能表示复杂关系,但会变得不稳定,对训练样本的具体取样过于敏感。
可以用一个概念曲线来解释:
- 左侧(简单模型):训练误差高,因为模型欠拟合。测试误差也高,因为模型错过了真实模式。
- 中间(平衡模型):训练与测试误差都低。模型捕捉到真实模式,同时未去记忆噪声。这就是甜蜜点。
- 右侧(复杂模型):训练误差极低,因为模型几乎能拟合一切。测试误差却很高,因为模型学到了噪声。
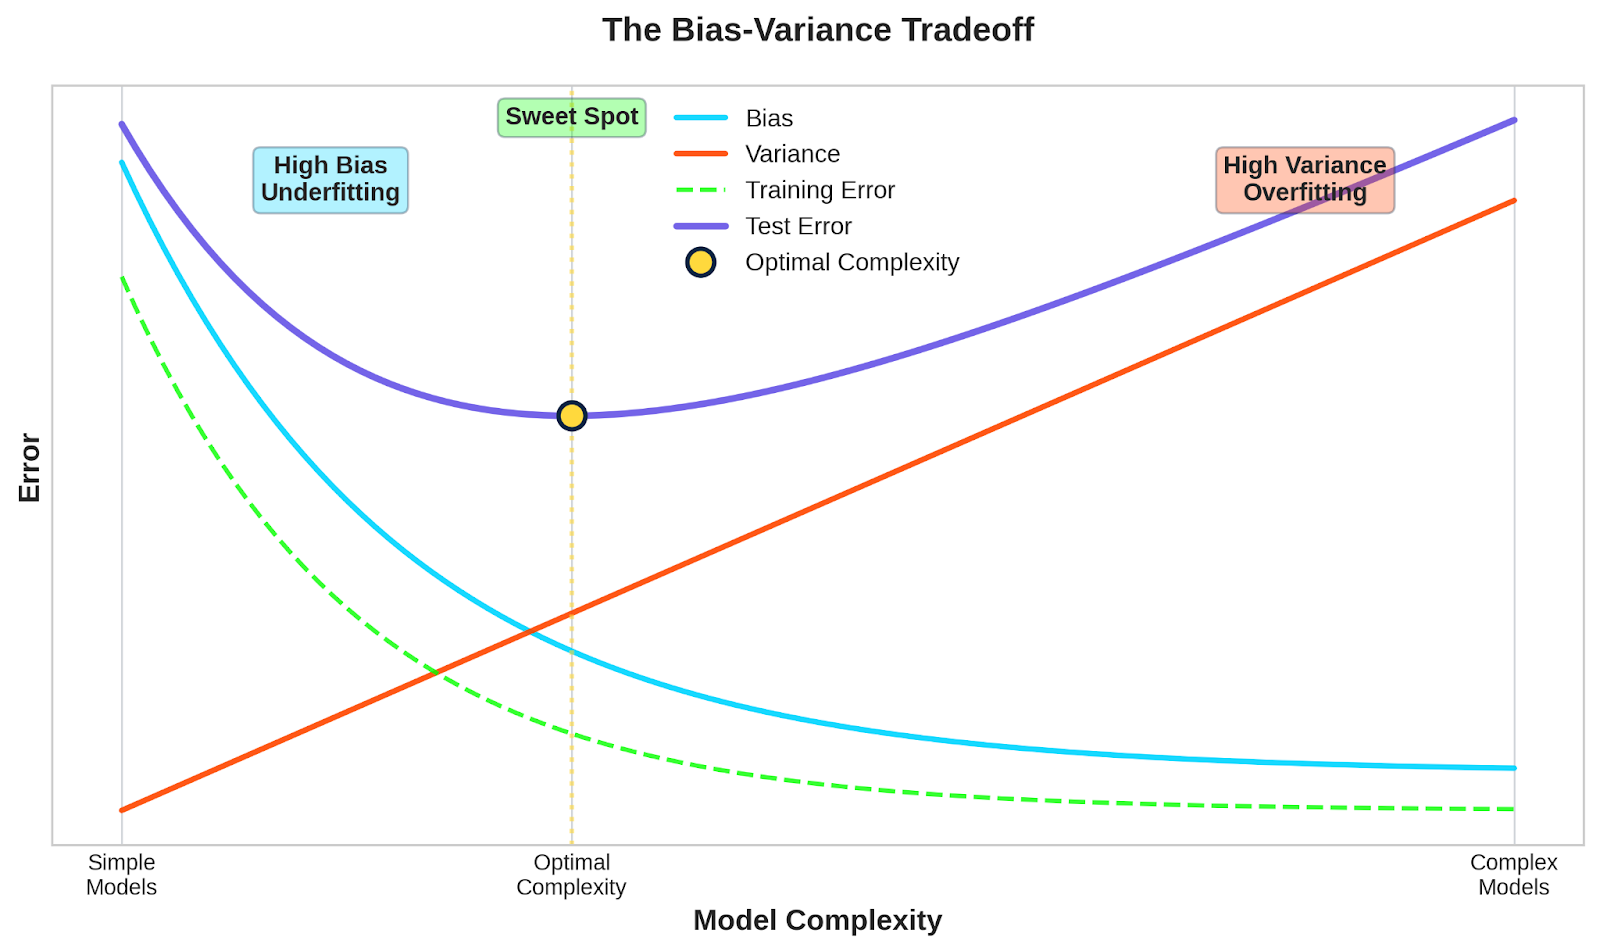
偏差-方差权衡曲线
您要寻找的是它们共同作用下测试误差最低的点。
不存在一个对所有问题都“完美”的模型。最优平衡取决于您的数据、问题复杂度以及训练数据量。更多的数据通常允许您使用更复杂的模型而不至于过拟合,从而将甜蜜点右移。
一个简单的偏差-方差权衡示例
下面用一个真实情境具体说明偏差和方差在实践中如何体现。
假设您要构建模型预测某城市的公寓租金。您拥有的特征包括面积、卧室数量、社区、与地铁的距离、建筑年限和配套设施等。
简单模型:单特征线性回归
您决定只用面积来通过简单线性回归预测价格。
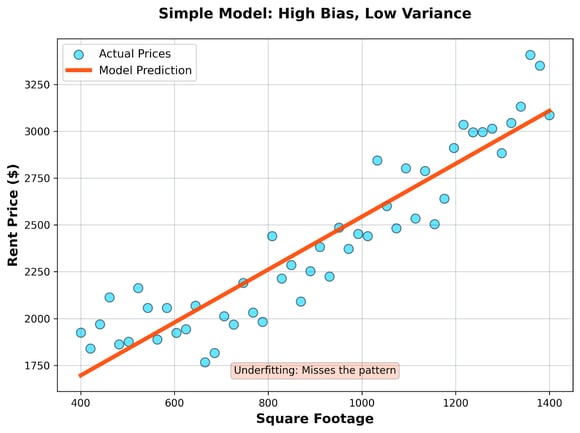
简单模型
- 会发生什么: 模型在数据点间画出一条直线。它预测每增加 100 平方英尺,租金就固定增加一定金额,而不考虑地段等其他因素。
- 结果: 该模型偏差高、方差低。它会持续低估豪华公寓、并高估开间,因为无法刻画不同社区中面积与价格之间的复杂关系。但若您用不同的公寓样本训练,它每次得到的直线大致相同——稳定但不准确。
复杂模型:使用全部特征的深度神经网络
现在您使用所有可用特征以及工程化特征(如社区犯罪率、步行便利度评分、与公园的距离),构建一个拥有多层隐藏层的深度神经网络。
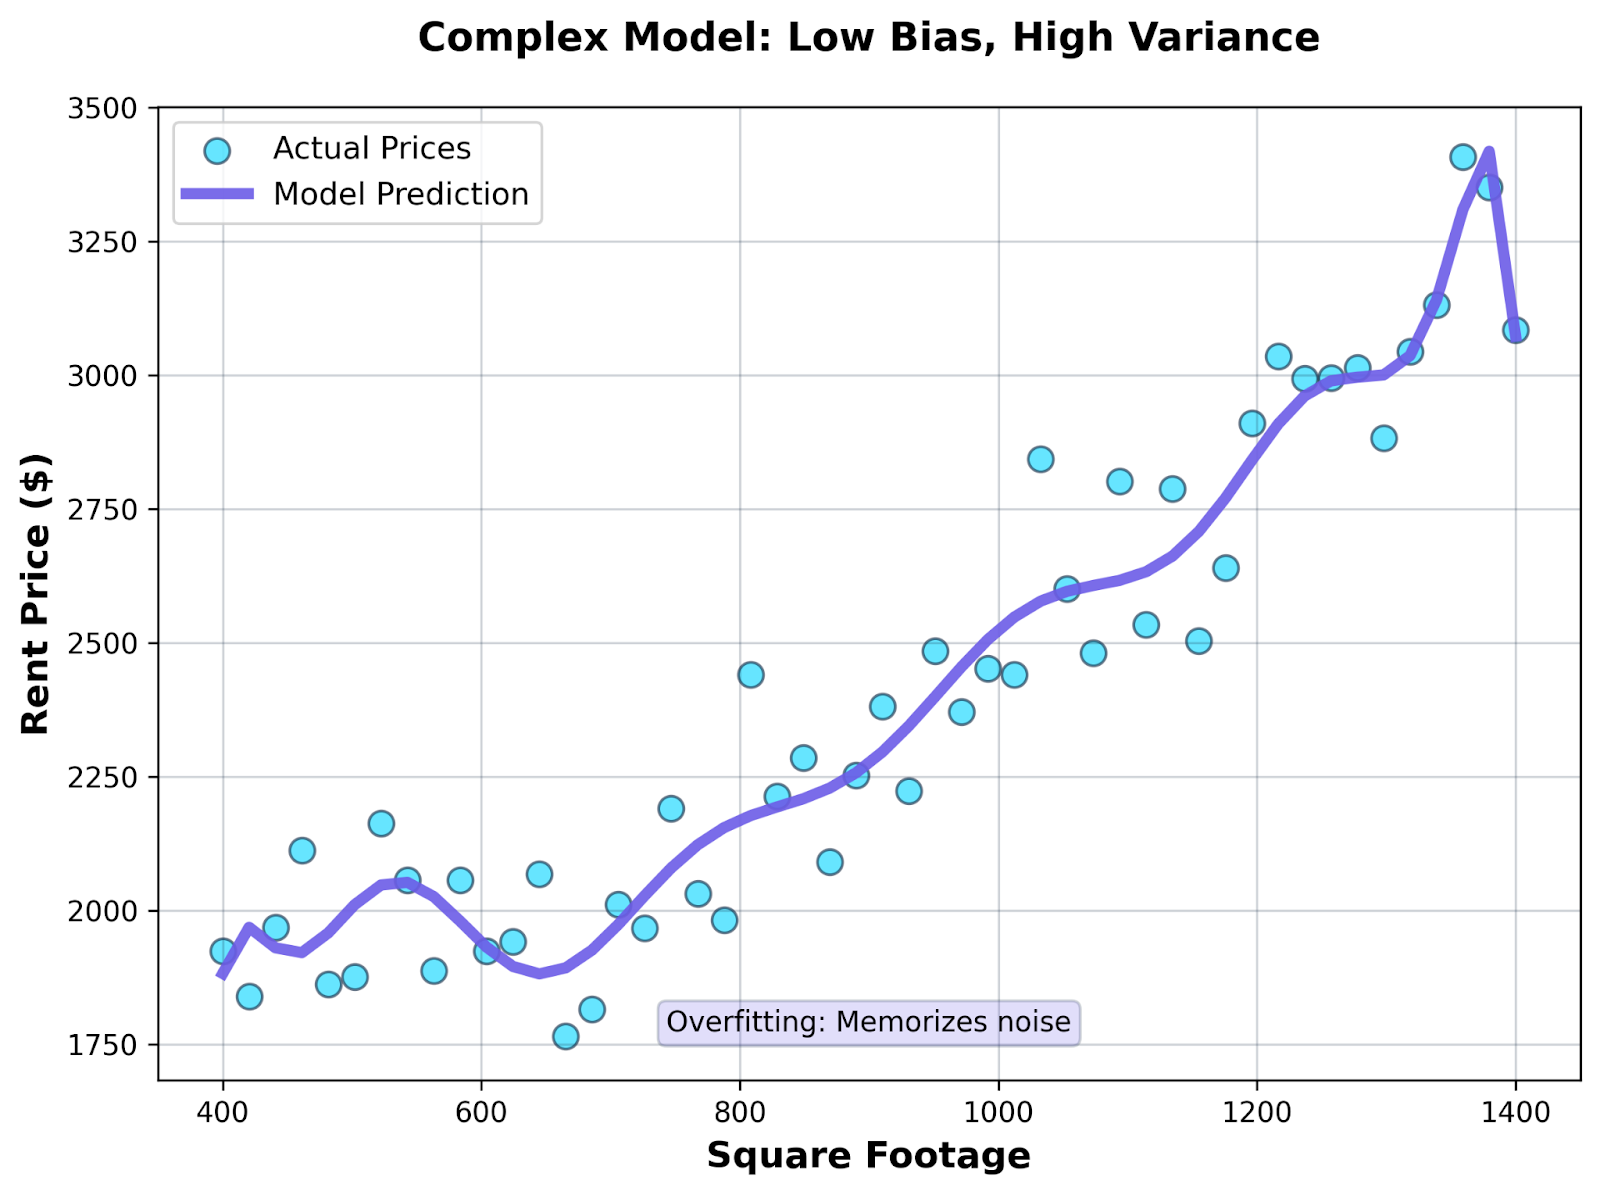
复杂模型
- 会发生什么: 网络学习到错综复杂的模式。它可能发现,在您的特定训练数据中,5 楼的公寓总是以恰好 $2,847 的价格出租,或橡树街朝北的房源比朝南的租金高 37%。
- 结果: 该模型偏差低、方差高。它几乎完美拟合训练数据,捕捉到每个细节与波动。但这些模式无法泛化——它们是特定样本的产物。换一批公寓训练,它又会学到完全不同的模式。预测在新数据上不稳定且不可靠。
平衡模型:关键特征的正则化回归
您使用正则化回归(如 Ridge 或 Lasso),并精挑细选部分特征:面积、卧室数量、社区类别以及与公共交通的距离。
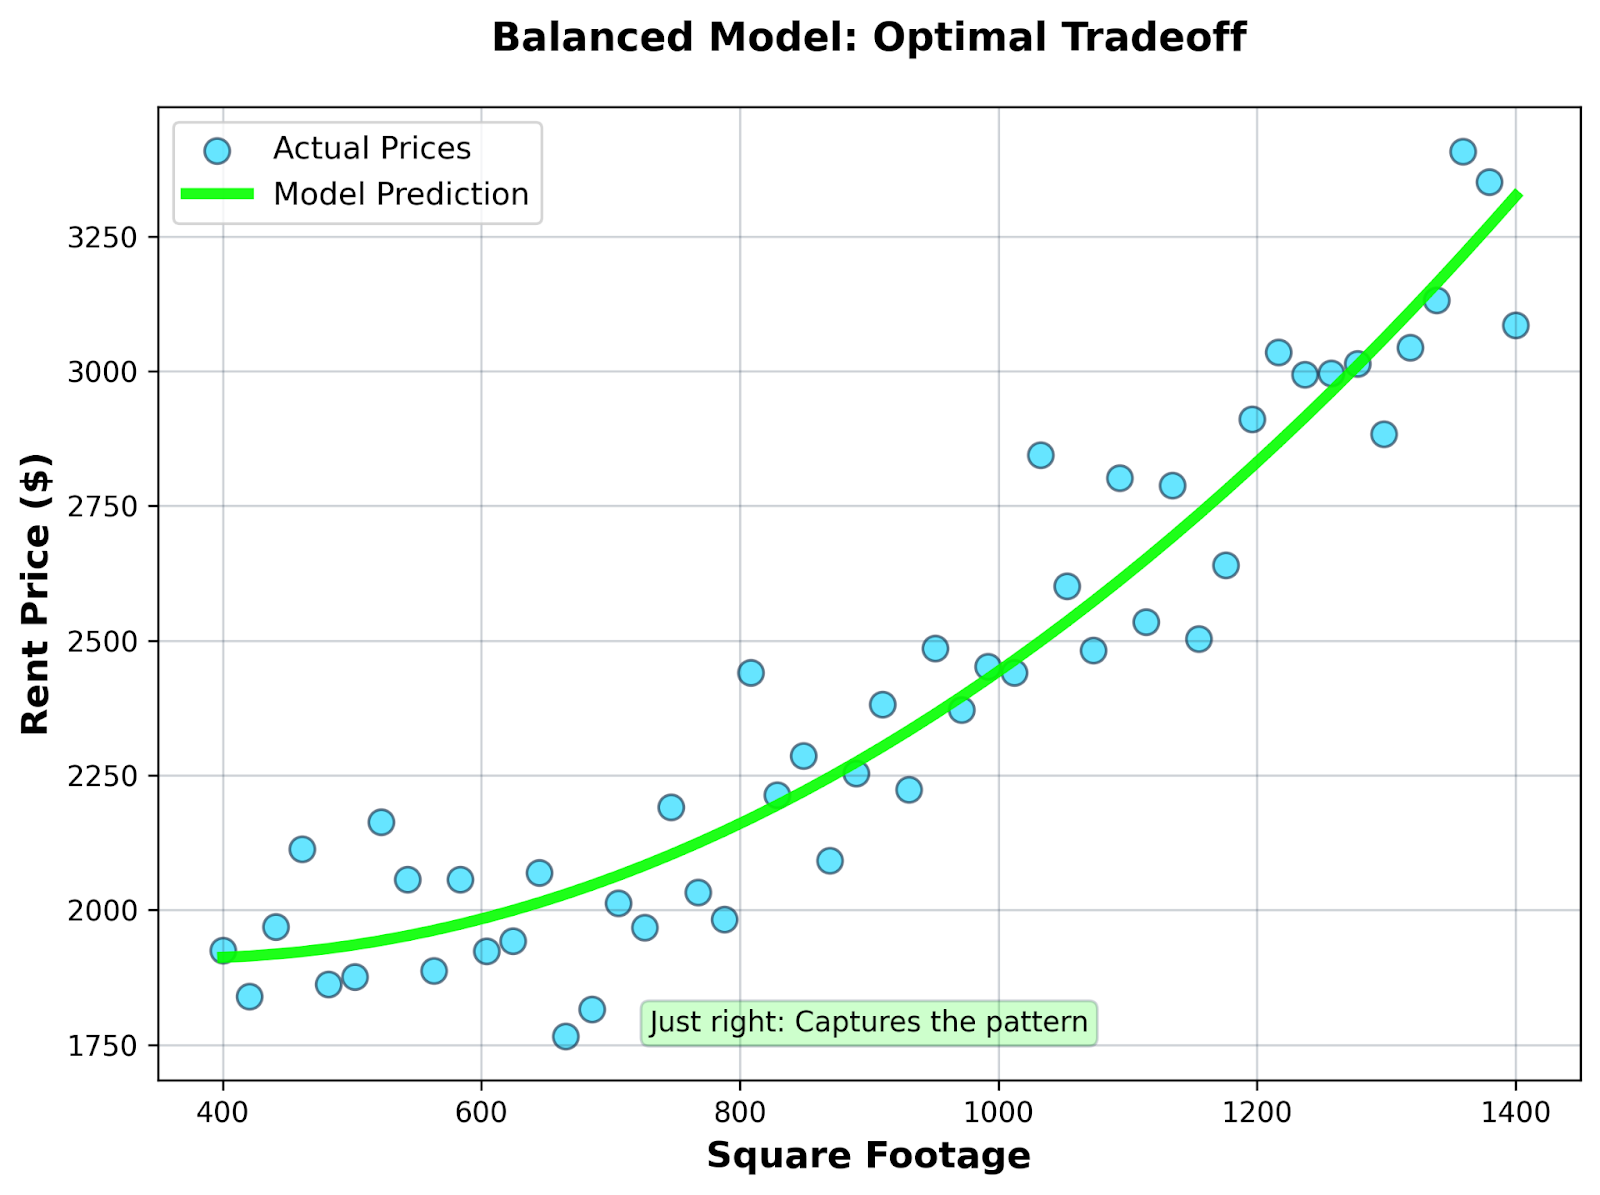
平衡模型
- 会发生什么: 模型能捕捉主要关系,而不会记忆噪声。它学到面积和地段很重要,但不会对训练数据中的每个微小波动耿耿于怀。
- 结果: 该模型在偏差与方差之间取得平衡。它足够灵活以捕捉真实模式,同时又受限以避免过拟合。训练误差适中,但测试误差较低——这才是对新公寓预测真正重要的。
平衡模型不会完美拟合训练数据,这正是要点所在。
机器学习模型中的偏差-方差权衡
不同的机器学习算法天然地倾向于高偏差或高方差。了解这些倾向有助于您为问题选择合适的工具。
线性模型
线性回归和逻辑回归位于高偏差的一端。
这些模型假设关系是线性的——某个特征变化,输出按固定幅度变化。当数据存在非线性模式、曲线关系或复杂的特征交互时,线性模型无法捕捉它们。
好处在于稳定性。用不同样本训练线性模型,您每次都会得到相似的系数。方差低,但若真实关系非线性,偏差可能很高。
决策树
决策树的表现取决于您的配置方式。
只有少量划分的浅层树像一个简单模型——高偏差、低方差。它做出宽泛概括,无法捕捉细粒度的模式。
没有深度限制的深层树会极其灵活。它不断划分,直到每个叶子只包含少量数据点,这意味着它会记住训练数据。偏差低,但方差极高——在不同训练样本下树结构会发生剧烈变化。
这也是随机森林效果良好的原因。它汇聚多棵树的预测,从而在保持低偏差的同时降低方差。
K 近邻
KNN 的偏差-方差平衡完全取决于您选择的 k。
当 k 很小(如 k=1 或 k=3)时,模型方差高。它仅基于极少数邻近点进行预测,因此对训练集中特定样本非常敏感。训练数据的小变化会导致完全不同的预测。
当 k 很大(如 k=50 或 k=100)时,模型偏差高。它平均了过多邻居,从而抹平了局部模式,错过数据中的重要细节。
最优的 k 值通常在中间,平衡这两种极端。
神经网络
神经网络天然是高方差模型,因为需要学习的参数非常多。
拥有多层和数百个神经元的网络可以表示极其复杂的函数。这种灵活性意味着偏差低——网络几乎能学到任何模式。但也意味着方差高——具体学到的权重高度依赖于您的训练数据、初始化和训练过程。
这就是神经网络需要大量数据才能表现良好的原因。更多训练数据有助于稳定学习过程、降低方差。这也解释了为何会有 dropout、批归一化和早停等技术——它们都旨在控制方差、防止过拟合。
较小的网络(更少层数和神经元)偏差更高但方差更低,而更大的网络偏差更低但方差更高。
模型复杂度如何影响偏差与方差
不幸的是,模型复杂度并非一个可直接度量的单一数字。它关乎模型在拟合不同模式时的灵活性。
复杂度来自多种来源,例如更多特征、神经网络的更多层、更深的决策树、回归中的多项式项,或 KNN 中更小的 k 值。共同点在于:它们赋予模型更多自由,以拟合数据中的复杂模式。
当您增加参数时,就是在给予模型更多方式来表示数据中的关系。只有 3 个特征的线性模型只能在数据中画出一个平面。若添加多项式项与交互特征,它就能弯曲变化,以贴合更复杂的模式。模型的假设变得不那么受限,也就意味着更低的偏差。
但这种灵活性是有代价的,即方差的上升。
更多参数意味着需要从训练数据中学习更多取值。每个参数都会被调整以拟合特定的训练样本,从而使模型更敏感于您恰好包含了哪些样本。当您改变少量训练样本时,这些参数都会随之调整以适应新数据,模型变得不稳定。
这就是为什么仅看训练误差既误导又危险。
随着复杂度增加,训练误差总会下降。您的模型越来越贴合训练数据,最终趋近于完美准确。这看起来不错,直到您意识到它在记忆噪声而非学习模式。
测试集上的误差才能告诉您模型究竟有多好。
起初,随着您增加复杂度,测试误差会降低,因为模型开始捕捉真实模式。但超过某个点后,即便训练误差继续下降,测试误差也会上升。模型发生了过拟合——它在学习训练集特有的怪癖,而非可泛化的规律。
训练与测试误差之间的差距很小,意味着模型泛化良好。差距很大,则说明您在过拟合,需要降低复杂度或增加训练数据。
管理偏差-方差权衡的技术
您无法消除偏差-方差权衡,但可以用合适的技术加以控制。下面介绍几种方法。
训练/测试集划分
切勿在与训练相同的数据上评估模型。
在做任何事之前先将数据划分为训练集与测试集。在一部分上训练,在另一部分上评估。这能如实反映模型在新数据上的泛化能力。
测试集相当于真实世界表现的代理。当训练误差低而测试误差高时,说明过拟合;当两者都高时,说明欠拟合。
交叉验证
训练/测试划分的弱点在于依赖于各自集合中包含了哪些具体样本。
交叉验证通过在数据的不同划分上多次训练与测试来解决这一问题。最常见的是 k 折交叉验证:将数据分为 k 份,用其中 k-1 份训练,在剩余 1 份上测试。重复 k 次,使每一份都恰好做一次测试集。
这能给出更可靠的性能估计,并帮助您在不对单一测试集过拟合的情况下调参。
正则化
正则化将对模型复杂度的惩罚直接加入损失函数。
如 L1(Lasso)和 L2(Ridge)等技术会抑制参数取值过大,迫使模型保持更简单、更稳定。这样会略微提高偏差,但能降低方差,往往提升整体测试表现。
神经网络中的 dropout 作用相似——训练时随机丢弃神经元,防止网络过度依赖特定参数并减少过拟合。
更多数据与更好模型之间的取舍
更多训练数据往往是解决高方差的最佳方案。
当您拥有更多样本时,模型能看到更广泛的可能模式。这使其更难对噪声过拟合,因为噪声会在更多数据点上被平均掉。方差在不牺牲复杂模型低偏差的前提下降低。
但收集更多数据并不总是可行或现实。
如果受限于数据量,请转而关注模型选择——选择更简单的模型、加入正则化,或使用集成方法将多个模型结合以降低方差。
特征选择
并非所有特征都能提升模型。有些只会引入噪声。
移除不相关或冗余特征,以在不丢失重要模式的前提下降低模型复杂度。更少的特征意味着更少的待学习参数,从而降低方差。您也能避免维度灾难:在高维空间且数据有限时模型的性能会受限。
可用的方法包括相关性分析、基于树模型的特征重要性评分,或能自动将不重要特征权重压为零的正则化方式。
目标是在捕捉信号而非噪声的前提下,找到最精简的特征集。
关于偏差-方差权衡的常见误解
下面澄清三种常见误区,避免由此做出糟糕的建模决策。
“偏差越低越好”
并非如此。较低的偏差意味着模型能表示复杂模式,但前提是这些模式确实存在于数据中且能泛化到新样本。
通过增加复杂度来降低偏差,往往会让方差上升速度快于偏差下降速度。最终模型在训练集上拟合完美,却在测试集上表现更差。目标是最小化总误差,而不只是偏差。
有时偏差更高的简单模型反而整体更好,因为它的方差足够低,能很好地泛化。
“过拟合说明模型很差”
不完全是。过拟合意味着您的模型相对于数据量来说过于复杂,但模型本身并非天生就差。
同样的神经网络结构,在 1,000 个训练样本上会过拟合,在 100,000 个样本上却可能表现完美。问题在于模型容量与数据规模的不匹配。
您可以通过增加数据、降低复杂度或应用正则化来修复过拟合。无需抛弃该模型、从头换成完全不同的东西。
“增加数据总能解决方差问题”
更多数据能降低方差,但并不能将其消除,而且其帮助是有上限的。
如果您的模型相对于问题而言极其复杂,即使大型数据集也未必能充分稳定它。拥有数百万参数的神经网络需要海量数据才能训练良好。
此外,新增数据只有在与测试数据同分布时才有帮助。收集更多有偏或嘈杂的数据不会减少方差——甚至可能因强化不可泛化的模式而让情况更糟。
偏差-方差权衡与过拟合、欠拟合
偏差-方差与过拟合-欠拟合描述的是同一问题的不同角度,但术语不可互换。
请记住以下几点:
- 高偏差导致欠拟合。 当模型的强假设与真实数据不匹配时,它会在训练与测试数据上系统性地错过模式。模型过于简单,无法表示真实关系,这就是欠拟合的含义。
- 高方差导致过拟合。 当模型对训练数据过于敏感时,它会学习噪声和无法泛化的模式。模型记住了训练样本,而非学习到底层规律,这就是过拟合的含义。
偏差与方差是模型的性质。
它们描述模型在不同训练集上的行为。您可以通过比较模型平均预测与真实值的偏离来衡量偏差;通过观察在不同训练数据下预测的变化幅度来衡量方差。
欠拟合与过拟合是您观察到的症状。
它们描述训练与测试模型时发生的情况。当训练与测试误差都高时,您看到的是欠拟合;当训练误差低但测试误差高时,您看到的是过拟合。
两者联系直接但非一一对应。高偏差通常导致欠拟合,高方差通常导致过拟合。但您也可能遇到偏差与方差都处于中等水平、既未欠拟合也未过拟合的模型——它只是因为特征不当或数据质量不足等其他原因而表现不佳。
解读模型表现的实用建议
以下是一些最后的提示,帮助您诊断偏差-方差问题并做出更好的建模决策。
同时查看训练与验证误差,而非单独看
仅凭训练误差无法说明泛化能力。一个训练误差 1% 的模型,若过拟合,测试误差可能高达 50%。
比较两者,才能理解真实情况。
- 两者都高,偏差高——模型过于简单
- 训练误差低但验证误差高,方差高——模型过拟合
- 两者都低,说明找到了合适的平衡
不要只优化训练准确率
完美的训练准确率是一个危险信号。它通常意味着您记住了训练集,而没有学习到可泛化的模式。
请关注验证集表现。目标是在保持两者都相对较低的同时,最小化训练与验证误差之间的差距。
使用交叉验证获得可靠估计
单次训练-测试划分可能具有误导性,因为它取决于各集合中包含了哪些样本。不走运的一次划分可能让好模型看起来很差,反之亦然。
交叉验证对多个划分的表现取平均,能更稳定地估计模型在新数据上的表现。在数据有限或需要调参时尤为重要。
根据数据规模在简单与灵活间取舍
当数据集较小时,倾向选择更简单的模型。样本不多时,它们更稳定、更不易过拟合。
当数据集较大时,可以使用更复杂的模型,因为额外数据能稳定学习过程、降低方差。但不要因为“能”而盲目加复杂度——只有在它能提升验证表现时才增加。
结语
您不可能构建出偏差与方差都为零的模型。您做出的每个建模决策都会改变这两种误差的平衡。增加复杂度会降低偏差却提高方差;简化模型会降低方差却提高偏差。
模型性能取决于找到合适的平衡。最佳模型是能针对您的特定问题与数据集,在偏差与方差之间取得平衡、从而最小化总误差的那个。理解这种权衡意味着您能诊断模型究竟是高偏差还是高方差,并采取正确的对策。
若您已准备好亲手实践机器学习,欢迎报名我们的 Python 机器学习基础学习路径。包含 16 小时视频课程,助您斩获第一份工作。


偏差-方差权衡解释了为何模型表现不只是关于复杂度或准确率,而是要找到那个甜蜜点:既不过度简化问题、也不对训练集过拟合,同时能对未见数据实现良好泛化。
本文将解释在机器学习中偏差与方差的真正含义、它们如何相互制衡,以及理解这种权衡为何能帮助您构建更健壮的模型。
如果您是机器学习新手,我们的 2026 年如何学习机器学习一文将帮助您迅速上手。
什么是偏差?
偏差是因对数据作出过于简单的假设而产生的误差。在机器学习语境中,它与“偏见”无关。
当模型偏差很高时,意味着模型过于僵硬,无法捕捉数据中的真实模式。就像试图用一条直线去拟合明显呈曲线的数据:无论怎样调整,那条直线都无法贴合真实形状。
这被称为欠拟合。
高偏差模型把问题过度简化。它假设关系比实际更简单,从而错过了有助于做出准确预测的重要模式。
设想您根据面积、卧室数量、地段和房龄来预测房价。高偏差模型可能只使用面积,忽略其它因素。它假设仅凭面积就能决定价格,这就太过简单了。
结果是模型在训练数据和新数据上都表现不佳,因为它无法体现真实房价的复杂性。
使用少量特征的线性回归是典型的高偏差模型。深度受限的决策树也往往偏差较高,因为它们无法进行足够多的划分来发现细微的模式。
高偏差意味着您的模型从数据中学得不够,反而把问题简单化到难以获得良好准确度的程度。
什么是方差?
方差衡量您的模型对所用训练数据的敏感程度。
它与统计学中数据离散程度的度量不同。在机器学习中,方差描述的是模型行为,而非数据分布。
当模型方差很高时,训练数据的微小变化会导致预测发生巨大变化。换句话说,用两份略有不同的数据集训练同一模型,结果可能截然不同。
这被称为过拟合。
高方差模型过于灵活。它不仅学习数据中的真实模式,也会学习噪声和随机波动,这些无法泛化到新数据上。模型本质上是在记忆训练样本,而不是学习底层关系。
想象您仍在预测房价,但现在使用一个拥有数百个参数的复杂模型。它可能学到“橡树街上的房子总是以恰好 $427,350 售出”,因为这正是您的训练数据中发生的情况。
结果是模型在训练数据上表现极佳,但在新数据上很差,因为它学到的是训练集特有的怪癖。
深度神经网络和深度无限制的决策树是经典的高方差模型。它们的灵活性足以拟合几乎任何模式,包括毫无意义的模式。
高方差意味着您的模型从数据中学得太多。它把噪声也当作信号来拟合,导致在新样本上不稳定且不可靠。
偏差 vs. 方差:关键差异
偏差与方差是两种完全不同的预测误差来源。一旦理解它们的区别,您就能更快诊断出模型的问题所在。
以下是偏差与方差如何影响预测误差:
问题在于,降低其中一个通常会提高另一个。
当您让模型更复杂以降低偏差时,它的灵活性会提高。这种灵活性会令其对训练数据更敏感,从而增加方差。当您简化模型以降低方差时,又会削弱其捕捉复杂模式的能力,从而增加偏差。
这种反向关系意味着您无法同时把两者都最小化。相反,您必须找到能带来最低总误差的平衡点。
什么是偏差-方差权衡?
偏差-方差权衡描述了这两种误差源之间的张力——当您降低一个时,几乎总会提高另一个。
可以这样想:您在瞄准一个目标,但有两种相互牵制的问题。您可以更精确地瞄准(降低偏差),但这会让您对风和手抖更敏感(增加方差)。或者您可以采用更简单、更稳定的射击姿势(降低方差),但这会限制精度(增加偏差)。
模型复杂度是这种权衡的核心。
当您使用参数较少的简单模型时,会得到高偏差、低方差。模型的假设一致,在不同训练数据下变化不大,但无法捕捉复杂模式。
当您使用参数众多的复杂模型时,会得到低偏差、高方差。模型能表示复杂关系,但会变得不稳定,对训练样本的具体取样过于敏感。
可以用一个概念曲线来解释:
偏差-方差权衡曲线
您要寻找的是它们共同作用下测试误差最低的点。
不存在一个对所有问题都“完美”的模型。最优平衡取决于您的数据、问题复杂度以及训练数据量。更多的数据通常允许您使用更复杂的模型而不至于过拟合,从而将甜蜜点右移。
一个简单的偏差-方差权衡示例
下面用一个真实情境具体说明偏差和方差在实践中如何体现。
假设您要构建模型预测某城市的公寓租金。您拥有的特征包括面积、卧室数量、社区、与地铁的距离、建筑年限和配套设施等。
简单模型:单特征线性回归
您决定只用面积来通过简单线性回归预测价格。
简单模型
复杂模型:使用全部特征的深度神经网络
现在您使用所有可用特征以及工程化特征(如社区犯罪率、步行便利度评分、与公园的距离),构建一个拥有多层隐藏层的深度神经网络。
复杂模型
平衡模型:关键特征的正则化回归
您使用正则化回归(如 Ridge 或 Lasso),并精挑细选部分特征:面积、卧室数量、社区类别以及与公共交通的距离。
平衡模型
平衡模型不会完美拟合训练数据,这正是要点所在。
机器学习模型中的偏差-方差权衡
不同的机器学习算法天然地倾向于高偏差或高方差。了解这些倾向有助于您为问题选择合适的工具。
线性模型
线性回归和逻辑回归位于高偏差的一端。
这些模型假设关系是线性的——某个特征变化,输出按固定幅度变化。当数据存在非线性模式、曲线关系或复杂的特征交互时,线性模型无法捕捉它们。
好处在于稳定性。用不同样本训练线性模型,您每次都会得到相似的系数。方差低,但若真实关系非线性,偏差可能很高。
决策树
决策树的表现取决于您的配置方式。
只有少量划分的浅层树像一个简单模型——高偏差、低方差。它做出宽泛概括,无法捕捉细粒度的模式。
没有深度限制的深层树会极其灵活。它不断划分,直到每个叶子只包含少量数据点,这意味着它会记住训练数据。偏差低,但方差极高——在不同训练样本下树结构会发生剧烈变化。
这也是随机森林效果良好的原因。它汇聚多棵树的预测,从而在保持低偏差的同时降低方差。
K 近邻
KNN 的偏差-方差平衡完全取决于您选择的 k。
当 k 很小(如 k=1 或 k=3)时,模型方差高。它仅基于极少数邻近点进行预测,因此对训练集中特定样本非常敏感。训练数据的小变化会导致完全不同的预测。
当 k 很大(如 k=50 或 k=100)时,模型偏差高。它平均了过多邻居,从而抹平了局部模式,错过数据中的重要细节。
最优的 k 值通常在中间,平衡这两种极端。
神经网络
神经网络天然是高方差模型,因为需要学习的参数非常多。
拥有多层和数百个神经元的网络可以表示极其复杂的函数。这种灵活性意味着偏差低——网络几乎能学到任何模式。但也意味着方差高——具体学到的权重高度依赖于您的训练数据、初始化和训练过程。
这就是神经网络需要大量数据才能表现良好的原因。更多训练数据有助于稳定学习过程、降低方差。这也解释了为何会有 dropout、批归一化和早停等技术——它们都旨在控制方差、防止过拟合。
较小的网络(更少层数和神经元)偏差更高但方差更低,而更大的网络偏差更低但方差更高。
模型复杂度如何影响偏差与方差
不幸的是,模型复杂度并非一个可直接度量的单一数字。它关乎模型在拟合不同模式时的灵活性。
复杂度来自多种来源,例如更多特征、神经网络的更多层、更深的决策树、回归中的多项式项,或 KNN 中更小的 k 值。共同点在于:它们赋予模型更多自由,以拟合数据中的复杂模式。
当您增加参数时,就是在给予模型更多方式来表示数据中的关系。只有 3 个特征的线性模型只能在数据中画出一个平面。若添加多项式项与交互特征,它就能弯曲变化,以贴合更复杂的模式。模型的假设变得不那么受限,也就意味着更低的偏差。
但这种灵活性是有代价的,即方差的上升。
更多参数意味着需要从训练数据中学习更多取值。每个参数都会被调整以拟合特定的训练样本,从而使模型更敏感于您恰好包含了哪些样本。当您改变少量训练样本时,这些参数都会随之调整以适应新数据,模型变得不稳定。
这就是为什么仅看训练误差既误导又危险。
随着复杂度增加,训练误差总会下降。您的模型越来越贴合训练数据,最终趋近于完美准确。这看起来不错,直到您意识到它在记忆噪声而非学习模式。
测试集上的误差才能告诉您模型究竟有多好。
起初,随着您增加复杂度,测试误差会降低,因为模型开始捕捉真实模式。但超过某个点后,即便训练误差继续下降,测试误差也会上升。模型发生了过拟合——它在学习训练集特有的怪癖,而非可泛化的规律。
训练与测试误差之间的差距很小,意味着模型泛化良好。差距很大,则说明您在过拟合,需要降低复杂度或增加训练数据。
管理偏差-方差权衡的技术
您无法消除偏差-方差权衡,但可以用合适的技术加以控制。下面介绍几种方法。
训练/测试集划分
切勿在与训练相同的数据上评估模型。
在做任何事之前先将数据划分为训练集与测试集。在一部分上训练,在另一部分上评估。这能如实反映模型在新数据上的泛化能力。
测试集相当于真实世界表现的代理。当训练误差低而测试误差高时,说明过拟合;当两者都高时,说明欠拟合。
交叉验证
训练/测试划分的弱点在于依赖于各自集合中包含了哪些具体样本。
交叉验证通过在数据的不同划分上多次训练与测试来解决这一问题。最常见的是 k 折交叉验证:将数据分为 k 份,用其中 k-1 份训练,在剩余 1 份上测试。重复 k 次,使每一份都恰好做一次测试集。
这能给出更可靠的性能估计,并帮助您在不对单一测试集过拟合的情况下调参。
正则化
正则化将对模型复杂度的惩罚直接加入损失函数。
如 L1(Lasso)和 L2(Ridge)等技术会抑制参数取值过大,迫使模型保持更简单、更稳定。这样会略微提高偏差,但能降低方差,往往提升整体测试表现。
神经网络中的 dropout 作用相似——训练时随机丢弃神经元,防止网络过度依赖特定参数并减少过拟合。
更多数据与更好模型之间的取舍
更多训练数据往往是解决高方差的最佳方案。
当您拥有更多样本时,模型能看到更广泛的可能模式。这使其更难对噪声过拟合,因为噪声会在更多数据点上被平均掉。方差在不牺牲复杂模型低偏差的前提下降低。
但收集更多数据并不总是可行或现实。
如果受限于数据量,请转而关注模型选择——选择更简单的模型、加入正则化,或使用集成方法将多个模型结合以降低方差。
特征选择
并非所有特征都能提升模型。有些只会引入噪声。
移除不相关或冗余特征,以在不丢失重要模式的前提下降低模型复杂度。更少的特征意味着更少的待学习参数,从而降低方差。您也能避免维度灾难:在高维空间且数据有限时模型的性能会受限。
可用的方法包括相关性分析、基于树模型的特征重要性评分,或能自动将不重要特征权重压为零的正则化方式。
目标是在捕捉信号而非噪声的前提下,找到最精简的特征集。
关于偏差-方差权衡的常见误解
下面澄清三种常见误区,避免由此做出糟糕的建模决策。
“偏差越低越好”
并非如此。较低的偏差意味着模型能表示复杂模式,但前提是这些模式确实存在于数据中且能泛化到新样本。
通过增加复杂度来降低偏差,往往会让方差上升速度快于偏差下降速度。最终模型在训练集上拟合完美,却在测试集上表现更差。目标是最小化总误差,而不只是偏差。
有时偏差更高的简单模型反而整体更好,因为它的方差足够低,能很好地泛化。
“过拟合说明模型很差”
不完全是。过拟合意味着您的模型相对于数据量来说过于复杂,但模型本身并非天生就差。
同样的神经网络结构,在 1,000 个训练样本上会过拟合,在 100,000 个样本上却可能表现完美。问题在于模型容量与数据规模的不匹配。
您可以通过增加数据、降低复杂度或应用正则化来修复过拟合。无需抛弃该模型、从头换成完全不同的东西。
“增加数据总能解决方差问题”
更多数据能降低方差,但并不能将其消除,而且其帮助是有上限的。
如果您的模型相对于问题而言极其复杂,即使大型数据集也未必能充分稳定它。拥有数百万参数的神经网络需要海量数据才能训练良好。
此外,新增数据只有在与测试数据同分布时才有帮助。收集更多有偏或嘈杂的数据不会减少方差——甚至可能因强化不可泛化的模式而让情况更糟。
偏差-方差权衡与过拟合、欠拟合
偏差-方差与过拟合-欠拟合描述的是同一问题的不同角度,但术语不可互换。
请记住以下几点:
偏差与方差是模型的性质。
它们描述模型在不同训练集上的行为。您可以通过比较模型平均预测与真实值的偏离来衡量偏差;通过观察在不同训练数据下预测的变化幅度来衡量方差。
欠拟合与过拟合是您观察到的症状。
它们描述训练与测试模型时发生的情况。当训练与测试误差都高时,您看到的是欠拟合;当训练误差低但测试误差高时,您看到的是过拟合。
两者联系直接但非一一对应。高偏差通常导致欠拟合,高方差通常导致过拟合。但您也可能遇到偏差与方差都处于中等水平、既未欠拟合也未过拟合的模型——它只是因为特征不当或数据质量不足等其他原因而表现不佳。
解读模型表现的实用建议
以下是一些最后的提示,帮助您诊断偏差-方差问题并做出更好的建模决策。
同时查看训练与验证误差,而非单独看
仅凭训练误差无法说明泛化能力。一个训练误差 1% 的模型,若过拟合,测试误差可能高达 50%。
比较两者,才能理解真实情况。
不要只优化训练准确率
完美的训练准确率是一个危险信号。它通常意味着您记住了训练集,而没有学习到可泛化的模式。
请关注验证集表现。目标是在保持两者都相对较低的同时,最小化训练与验证误差之间的差距。
使用交叉验证获得可靠估计
单次训练-测试划分可能具有误导性,因为它取决于各集合中包含了哪些样本。不走运的一次划分可能让好模型看起来很差,反之亦然。
交叉验证对多个划分的表现取平均,能更稳定地估计模型在新数据上的表现。在数据有限或需要调参时尤为重要。
根据数据规模在简单与灵活间取舍
当数据集较小时,倾向选择更简单的模型。样本不多时,它们更稳定、更不易过拟合。
当数据集较大时,可以使用更复杂的模型,因为额外数据能稳定学习过程、降低方差。但不要因为“能”而盲目加复杂度——只有在它能提升验证表现时才增加。
结语
您不可能构建出偏差与方差都为零的模型。您做出的每个建模决策都会改变这两种误差的平衡。增加复杂度会降低偏差却提高方差;简化模型会降低方差却提高偏差。
模型性能取决于找到合适的平衡。最佳模型是能针对您的特定问题与数据集,在偏差与方差之间取得平衡、从而最小化总误差的那个。理解这种权衡意味着您能诊断模型究竟是高偏差还是高方差,并采取正确的对策。
若您已准备好亲手实践机器学习,欢迎报名我们的 Python 机器学习基础学习路径。包含 16 小时视频课程,助您斩获第一份工作。