Pertukaran bias-varians menjelaskan mengapa kinerja model bukan hanya soal kompleksitas atau akurasi, tetapi tentang menemukan titik keseimbangan di mana model Anda dapat menggeneralisasi dengan baik ke data yang belum pernah dilihat tanpa menyederhanakan masalah secara berlebihan atau overfitting pada set pelatihan.
Dalam artikel ini, saya akan menjelaskan apa sebenarnya yang dimaksud dengan bias dan varians dalam machine learning, bagaimana keduanya saling bertukar, dan mengapa memahami pertukaran ini membantu Anda membangun model yang lebih andal.
Jika Anda baru dalam machine learning, artikel Cara Belajar Machine Learning pada 2026 kami akan membantu Anda mahir dalam waktu singkat.
Apa Itu Bias?
Bias adalah kesalahan yang muncul akibat membuat asumsi yang terlalu sederhana tentang data Anda. Ini tidak ada hubungannya dengan prasangka, setidaknya bukan dalam konteks machine learning.
Ketika model memiliki bias tinggi, artinya model terlalu kaku untuk menangkap pola sebenarnya dalam data Anda. Bayangkan mencoba memasangkan garis lurus pada data yang jelas melengkung: Apa pun penyesuaian garis itu, garis tersebut tidak akan pernah cocok dengan bentuk yang sesungguhnya.
Ini disebut underfitting.
Model dengan bias tinggi menyederhanakan masalah secara berlebihan. Ia mengasumsikan hubungan lebih sederhana daripada kenyataannya, sehingga melewatkan pola penting yang akan membantunya membuat prediksi yang akurat.
Bayangkan Anda memprediksi harga rumah berdasarkan luas bangunan, jumlah kamar, lokasi, dan usia rumah. Model bias tinggi mungkin hanya menggunakan luas bangunan dan mengabaikan yang lain. Ia mengasumsikan luas bangunan saja menentukan harga, yang jelas terlalu sederhana.
Hasilnya adalah model yang berkinerja buruk pada data pelatihan maupun data baru karena tidak dapat menangkap kompleksitas harga rumah yang sebenarnya.
Regresi linier dengan sedikit fitur adalah contoh klasik model dengan bias tinggi. Pohon keputusan dengan kedalaman yang sangat terbatas juga cenderung memiliki bias tinggi karena tidak dapat membagi data cukup banyak untuk menemukan pola yang halus.
Bias tinggi berarti model Anda tidak cukup belajar dari data, melainkan membuat masalah menjadi terlalu sederhana untuk diselesaikan dengan tingkat akurasi yang baik.
Apa Itu Varians?
Varians mengukur seberapa sensitif model Anda terhadap data pelatihan spesifik yang Anda gunakan.
Ini tidak ada hubungannya dengan ukuran statistik sebaran data. Dalam machine learning, varians menggambarkan perilaku model, bukan distribusi data.
Ketika model memiliki varians tinggi, perubahan kecil pada data pelatihan memicu perubahan besar pada prediksinya. Dengan kata lain, saat Anda melatih model yang sama pada dua dataset yang sedikit berbeda, Anda akan mendapatkan hasil yang sangat berbeda.
Ini disebut overfitting.
Model dengan varians tinggi terlalu fleksibel. Ia mempelajari bukan hanya pola nyata dalam data Anda tetapi juga noise dan fluktuasi acak yang tidak dapat digeneralisasi ke data baru. Model pada dasarnya menghafal contoh pelatihan alih-alih mempelajari hubungan yang mendasarinya.
Bayangkan Anda masih memprediksi harga rumah, tetapi kini menggunakan model kompleks dengan ratusan parameter. Ia bisa saja mempelajari bahwa rumah di Oak Street selalu terjual tepat $427.350 karena itulah yang terjadi di data pelatihan Anda.
Hasilnya adalah model yang berkinerja sangat baik pada data pelatihan tetapi buruk pada data baru karena ia mempelajari keanehan spesifik dari set pelatihan.
Deep neural networks dan pohon keputusan tanpa batasan kedalaman adalah contoh klasik model dengan varians tinggi. Mereka cukup fleksibel untuk menyesuaikan hampir semua pola, termasuk yang tidak bermakna.
Varians tinggi berarti model Anda terlalu banyak belajar dari data. Ia menyesuaikan noise bersama sinyal, yang membuatnya tidak stabil dan tidak andal pada contoh baru.
Bias vs. Varians: Perbedaan Utama
Bias dan varians adalah dua sumber kesalahan prediksi yang sepenuhnya berbeda. Setelah Anda memahami perbedaannya, Anda akan lebih cepat mendiagnosis apa yang salah pada model Anda.
- Bias berasal dari asumsi model Anda. Ini terkait algoritma yang Anda pilih, fitur yang Anda sertakan, dan bagaimana Anda menyusun masalah. Model regresi linier mengasumsikan hubungan linier, sehingga muncul bias ketika hubungan sebenarnya tidak linier. Kesalahan ini sudah ada bahkan sebelum Anda melihat data pelatihan.
- Varians berasal dari sensitivitas terhadap data pelatihan. Ini menyangkut seberapa banyak model Anda berubah saat dilatih pada sampel berbeda dari populasi yang sama. Model dengan varians tinggi mempelajari pola berbeda dari set pelatihan yang sedikit berbeda, yang membuat prediksinya tidak stabil.
Berikut cara bias dan varians memengaruhi kesalahan prediksi:
- Bias tinggi berarti model Anda membuat kesalahan yang konsisten ke arah yang sama. Selalu underpredict atau selalu overpredict pola tertentu karena tidak dapat merepresentasikan hubungan yang sebenarnya. Kesalahannya sistematis dan dapat diprediksi.
- Varians tinggi berarti model Anda membuat kesalahan yang tidak konsisten dan berubah mengikuti data. Dilatih pada data hari Senin memprediksi satu hal. Dilatih pada data hari Selasa memprediksi hal yang sepenuhnya berbeda. Kesalahannya acak dan tidak dapat diprediksi.
Masalahnya, mengurangi yang satu biasanya meningkatkan yang lain.
Saat Anda membuat model lebih kompleks untuk mengurangi bias, Anda meningkatkan fleksibilitasnya. Fleksibilitas itu membuat model lebih sensitif terhadap data pelatihan, yang meningkatkan varians. Saat Anda menyederhanakan model untuk mengurangi varians, Anda mengurangi kemampuannya menangkap pola kompleks, yang meningkatkan bias.
Hubungan berlawanan ini membuat Anda tidak bisa sekaligus meminimalkan keduanya. Alih-alih, Anda harus menemukan keseimbangan yang memberi total kesalahan terendah.
Apa Itu Pertukaran Bias-Varians?
Pertukaran bias-varians menggambarkan tarik-ulur antara dua sumber kesalahan ini - ketika Anda menurunkan yang satu, hampir selalu menaikkan yang lain.
Bayangkan seperti ini: Anda mencoba mengenai target, namun ada dua masalah yang saling berlawanan. Anda bisa membidik lebih saksama (mengurangi bias), tetapi itu membuat Anda lebih sensitif terhadap angin dan getaran tangan (meningkatkan varians). Atau Anda bisa menggunakan posisi menembak yang lebih sederhana dan stabil (mengurangi varians), tetapi itu membatasi ketelitian Anda (meningkatkan bias).
Kompleksitas model berada di pusat pertukaran ini.
Saat Anda menggunakan model sederhana dengan sedikit parameter, Anda mendapatkan bias tinggi dan varians rendah. Model membuat asumsi yang konsisten dan tidak banyak berubah dengan data pelatihan berbeda, tetapi tidak dapat menangkap pola yang kompleks.
Saat Anda menggunakan model kompleks dengan banyak parameter, Anda mendapatkan bias rendah dan varians tinggi. Model dapat merepresentasikan hubungan yang rumit, tetapi menjadi tidak stabil dan terlalu sensitif terhadap contoh spesifik yang digunakan untuk melatihnya.
Berikut kurva konseptual yang menjelaskannya:
- Di sisi kiri (model sederhana): Kesalahan pelatihan tinggi karena model underfit. Kesalahan uji juga tinggi karena model melewatkan pola nyata.
- Di tengah (model seimbang): Baik kesalahan pelatihan maupun uji rendah. Model menangkap pola nyata tanpa menghafal noise. Inilah titik manis Anda.
- Di sisi kanan (model kompleks): Kesalahan pelatihan sangat rendah karena model menyesuaikan semuanya. Kesalahan uji tinggi karena model mempelajari noise.
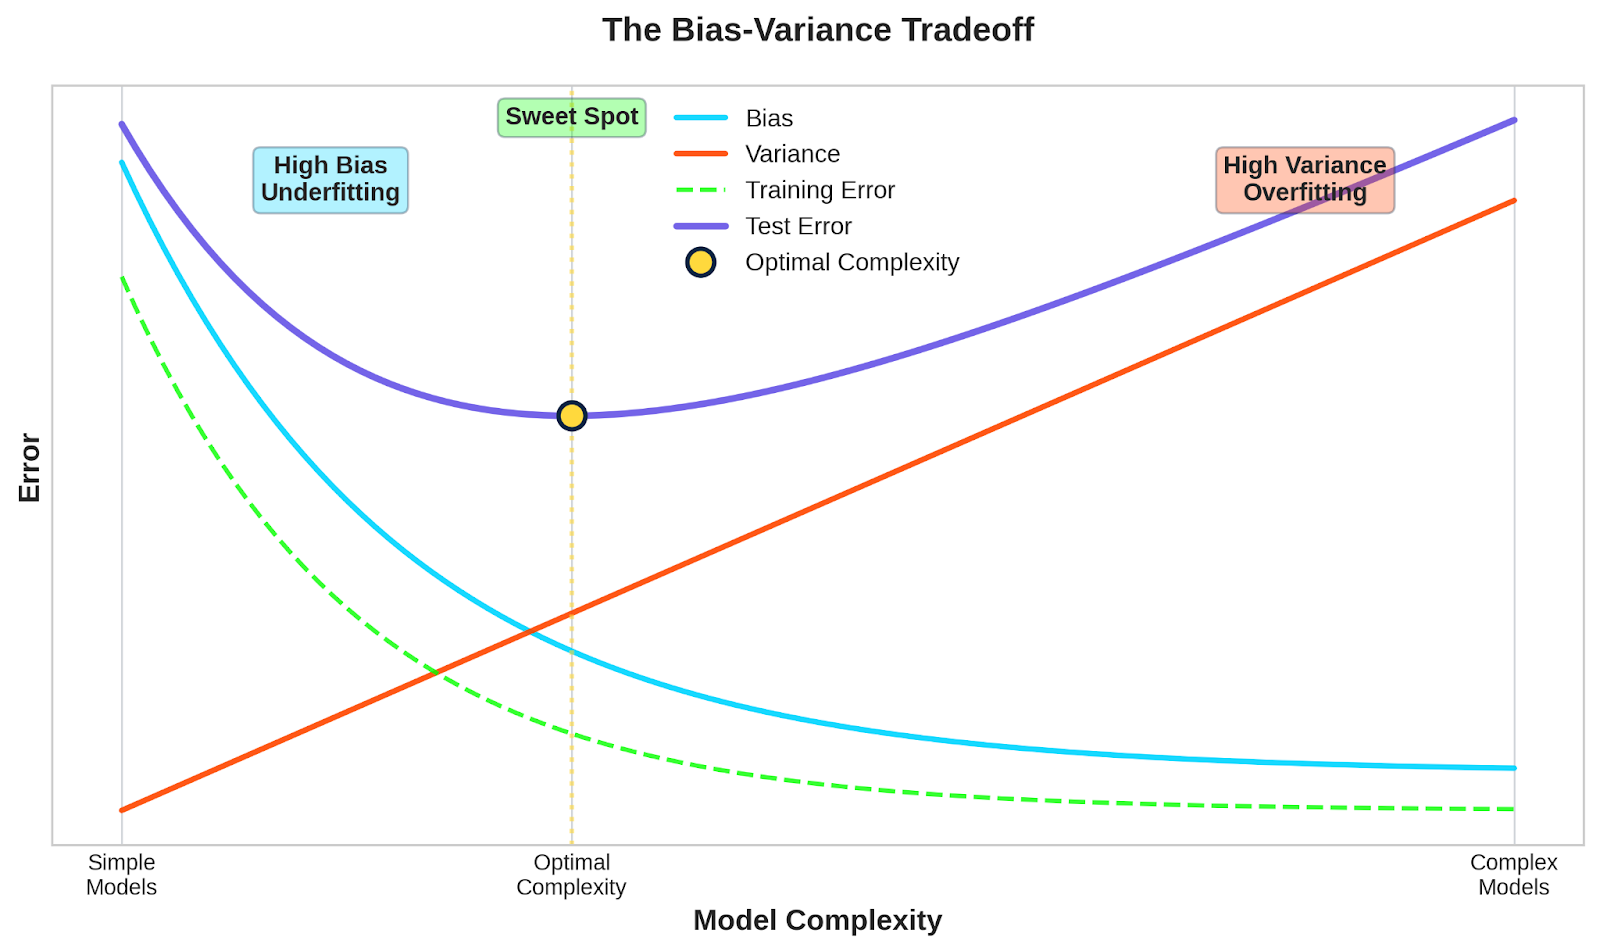
Kurva pertukaran bias-varians
Anda mencari titik di mana gabungan efek keduanya menghasilkan kesalahan uji terendah.
Tidak ada satu model "sempurna" yang cocok untuk setiap masalah. Keseimbangan optimal bergantung pada data Anda, kompleksitas masalah, dan seberapa banyak data pelatihan yang Anda miliki. Lebih banyak data umumnya memungkinkan Anda menggunakan model yang lebih kompleks tanpa overfitting, menggeser titik manis ke kanan.
Contoh Sederhana Pertukaran Bias-Varians
Mari saya buat konsep ini konkret dengan skenario nyata yang menunjukkan bagaimana bias dan varians terjadi dalam praktik.
Bayangkan Anda membangun model untuk memprediksi harga sewa apartemen di sebuah kota. Anda memiliki fitur seperti luas, jumlah kamar tidur, lingkungan, jarak ke stasiun metro, usia bangunan, dan fasilitas.
Model sederhana: Regresi linier dengan satu fitur
Anda memutuskan hanya menggunakan luas untuk memprediksi harga dengan regresi linier sederhana.
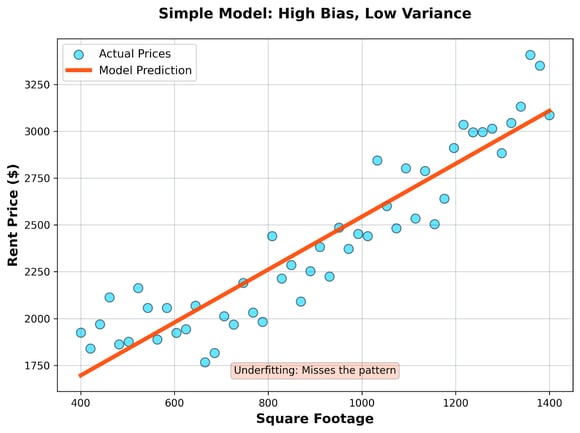
Model sederhana
- Apa yang terjadi: Model menggambar garis lurus melalui titik data Anda. Ia memprediksi setiap 100 kaki persegi menambah sejumlah dolar tetap pada sewa, apa pun lokasi atau faktor lainnya.
- Hasilnya: Model ini memiliki bias tinggi dan varians rendah. Ia secara konsisten meremehkan apartemen mewah dan melebihkan apartemen studio karena tidak dapat menangkap hubungan kompleks antara ukuran dan harga di lingkungan berbeda. Namun jika Anda melatihnya pada sampel apartemen yang berbeda, Anda akan mendapatkan garis yang kurang-lebih sama setiap kali - stabil tetapi tidak akurat.
Model kompleks: Deep neural network dengan semua fitur
Sekarang Anda membangun deep neural network dengan beberapa lapisan tersembunyi menggunakan semua fitur yang tersedia, ditambah fitur rekayasa seperti tingkat kejahatan lingkungan, skor walkability, dan kedekatan ke taman.
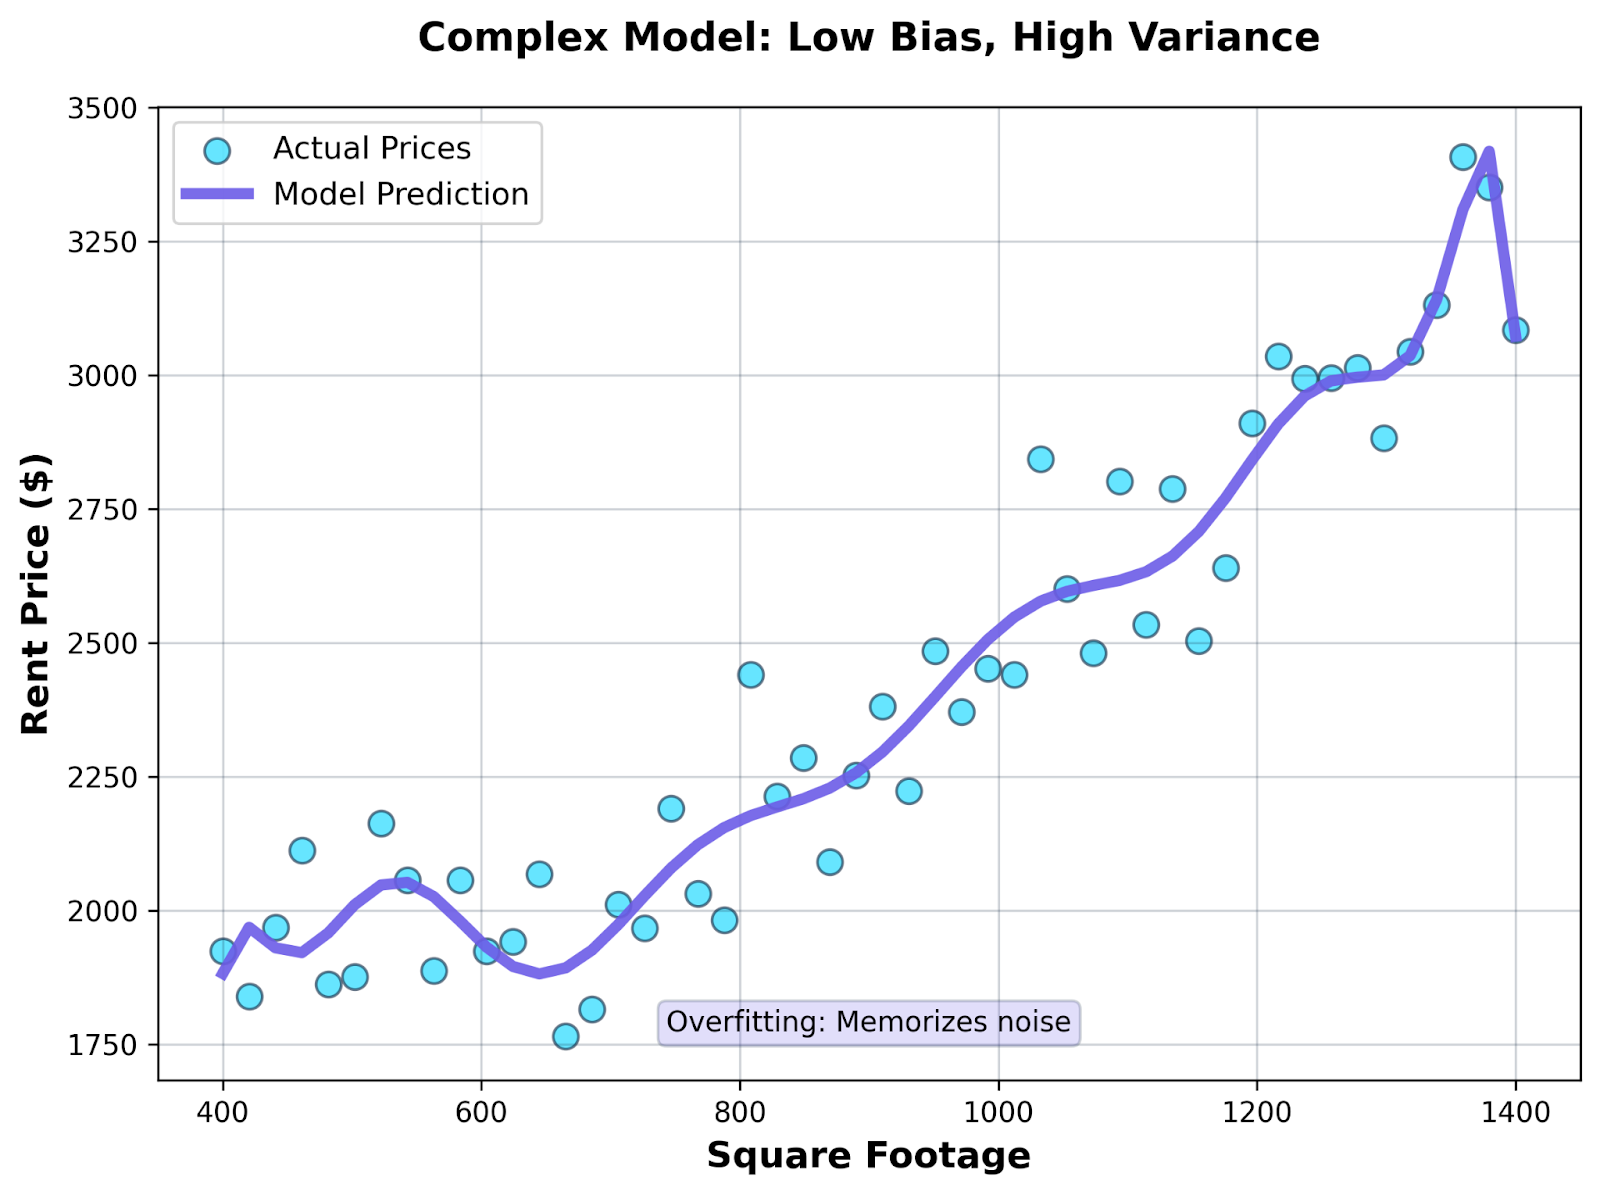
Model kompleks
- Apa yang terjadi: Jaringan mempelajari pola rumit. Ia bisa menemukan bahwa apartemen di lantai 5 pada data pelatihan spesifik Anda selalu disewa tepat $2.847, atau unit yang menghadap utara di Oak Street memiliki sewa 37% lebih tinggi daripada yang menghadap selatan.
- Hasilnya: Model ini memiliki bias rendah dan varians tinggi. Ia menyesuaikan data pelatihan hampir sempurna dan menangkap setiap detail dan fluktuasi. Namun pola-pola itu tidak menggeneralisasi - itu adalah artefak dari sampel spesifik Anda. Dilatih pada set apartemen yang berbeda, ia mempelajari pola yang benar-benar berbeda. Prediksi menjadi tidak stabil dan tidak andal pada data baru.
Model seimbang: Regresi teratur dengan fitur kunci
Anda menggunakan regresi teratur (seperti Ridge atau Lasso) dengan subset fitur yang dipilih secara cermat: luas, kamar tidur, kategori lingkungan, dan jarak ke transportasi.
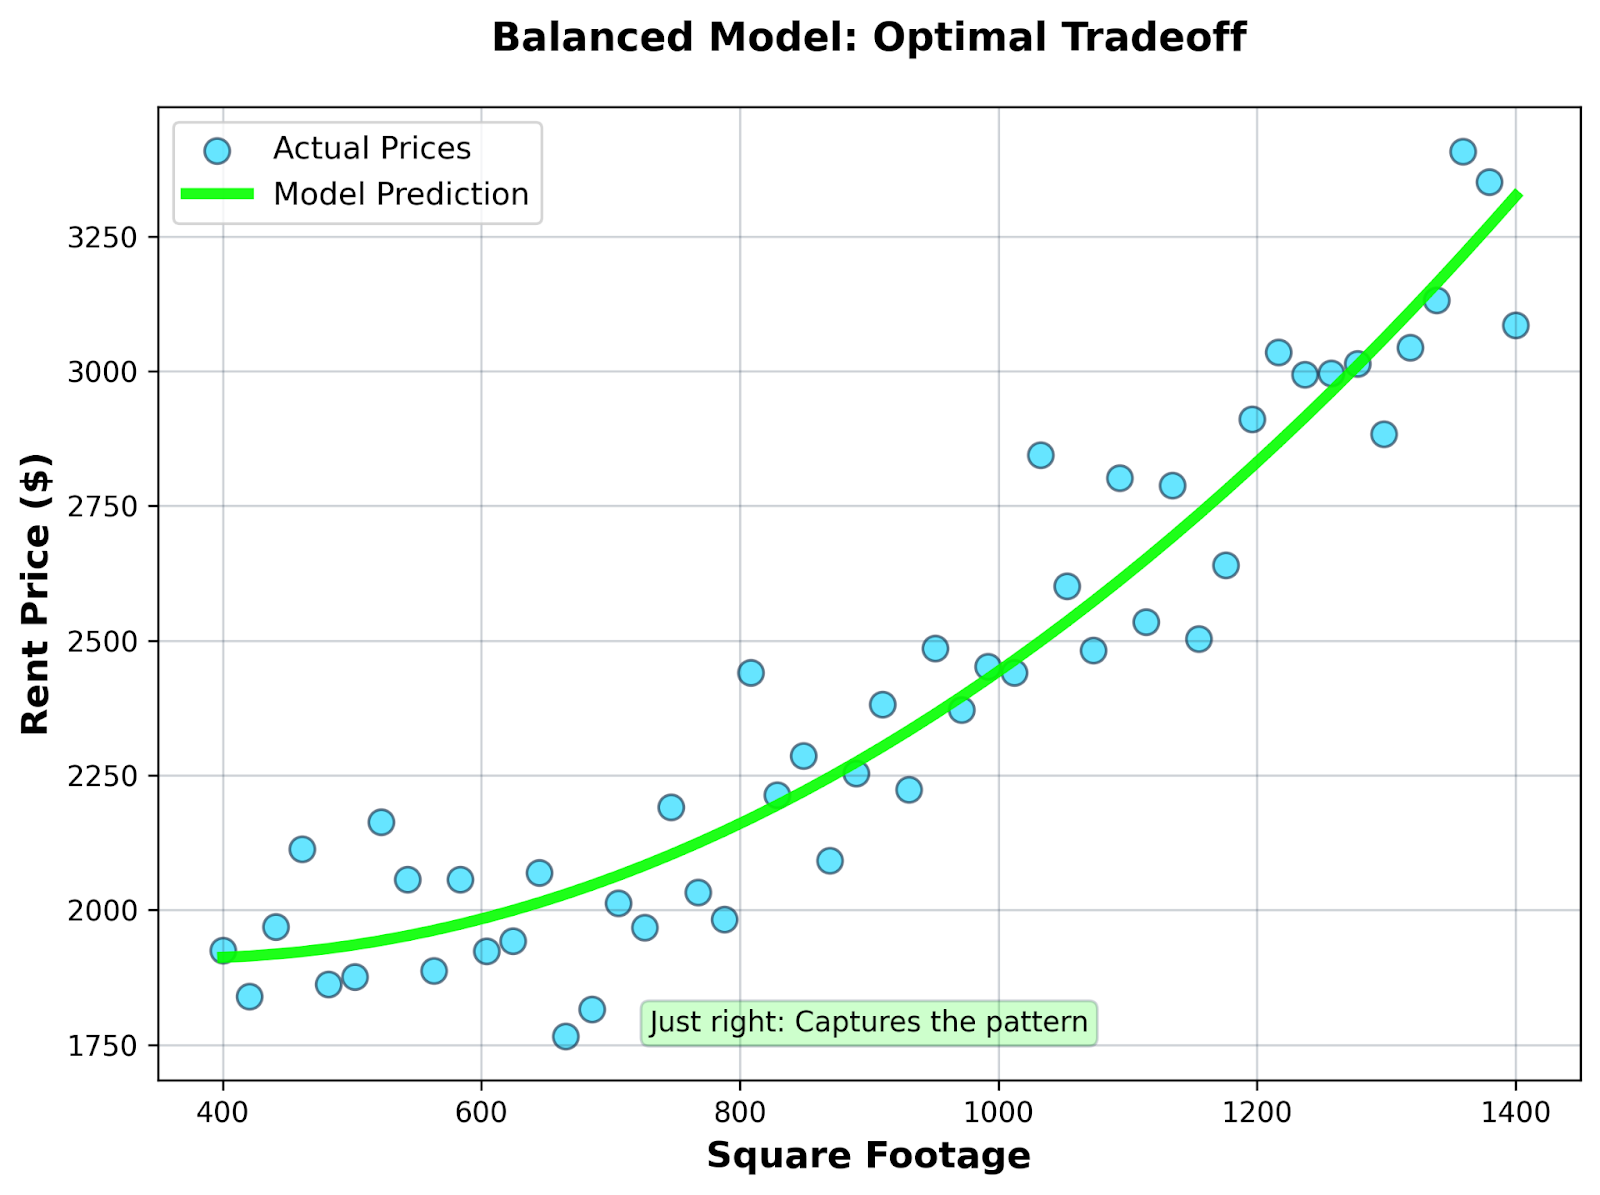
Model seimbang
- Apa yang terjadi: Model menangkap hubungan utama tanpa menghafal noise. Ia mempelajari bahwa ukuran dan lokasi penting, tetapi tidak terobsesi pada setiap fluktuasi kecil dalam data pelatihan.
- Hasilnya: Model ini menyeimbangkan bias dan varians. Cukup fleksibel untuk menangkap pola nyata, namun cukup dibatasi untuk menghindari overfitting. Kesalahan pelatihan sedang, tetapi kesalahan uji rendah - yang sebenarnya penting untuk prediksi pada apartemen baru.
Model seimbang tidak akan menyesuaikan data pelatihan Anda secara sempurna, dan memang itulah tujuannya.
Pertukaran Bias-Varians dalam Model Machine Learning
Algoritma machine learning yang berbeda secara alami cenderung ke bias tinggi atau varians tinggi. Anda perlu memahami kecenderungan ini untuk memilih alat yang tepat bagi masalah Anda.
Model linier
Regresi linier dan regresi logistik berada di ujung spektrum bias tinggi.
Model-model ini mengasumsikan hubungan bersifat linier - satu fitur berubah, keluaran berubah dengan jumlah tetap. Ketika data Anda memiliki pola nonlinier, hubungan melengkung, atau interaksi kompleks antar fitur, model linier tidak dapat menangkapnya.
Keuntungannya adalah stabilitas. Latih model linier pada sampel data Anda yang berbeda, dan Anda akan mendapatkan koefisien yang serupa setiap kali. Varians rendah, tetapi berpotensi bias tinggi jika hubungan sebenarnya tidak linier.
Pohon keputusan
Pohon keputusan dapat berperilaku berbeda tergantung bagaimana Anda mengonfigurasinya.
Pohon dangkal dengan hanya beberapa pemisahan bertindak seperti model sederhana - bias tinggi, varians rendah. Ia membuat generalisasi luas dan tidak dapat menangkap pola yang rinci.
Pohon yang dalam tanpa batasan kedalaman menjadi sangat fleksibel. Ia terus membelah hingga setiap daun hanya berisi beberapa titik data, yang berarti ia menghafal data pelatihan Anda. Bias rendah, tetapi varians sangat tinggi - struktur pohon berubah drastis dengan sampel pelatihan yang berbeda.
Inilah mengapa random forest bekerja sangat baik. Mereka merata-ratakan prediksi dari banyak pohon, yang mengurangi masalah varians sambil tetap menjaga bias rendah.
K-nearest neighbors
Keseimbangan bias-varians KNN sepenuhnya bergantung pada pilihan k Anda.
Saat k kecil (seperti k=1 atau k=3), model memiliki varians tinggi. Ia mendasarkan prediksi pada hanya beberapa titik terdekat, sehingga sangat sensitif terhadap contoh spesifik dalam set pelatihan Anda. Perubahan kecil pada data pelatihan menghasilkan prediksi yang sepenuhnya berbeda.
Saat k besar (seperti k=50 atau k=100), model memiliki bias tinggi. Ia merata-ratakan terlalu banyak tetangga sehingga menghaluskan pola lokal dan melewatkan detail penting dalam data.
Nilai k yang optimal berada di tengah, menyeimbangkan dua ekstrem ini.
Neural network
Neural network secara alami merupakan model dengan varians tinggi karena memiliki begitu banyak parameter yang harus dipelajari.
Jaringan dengan banyak lapisan dan ratusan neuron dapat merepresentasikan fungsi yang sangat kompleks. Fleksibilitas ini berarti bias rendah - jaringan dapat mempelajari hampir semua pola. Namun juga berarti varians tinggi - bobot persis yang Anda pelajari sangat bergantung pada data pelatihan spesifik, inisialisasi, dan proses pelatihan.
Inilah alasan neural network membutuhkan dataset besar agar bekerja dengan baik. Lebih banyak data pelatihan membantu menstabilkan proses pembelajaran dan mengurangi varians. Ini juga alasan teknik seperti dropout, batch normalization, dan early stopping ada - semuanya dirancang untuk mengendalikan varians dan mencegah overfitting.
Jaringan yang lebih kecil dengan lebih sedikit lapisan dan neuron memiliki bias lebih tinggi tetapi varians lebih rendah, sementara jaringan yang lebih besar memiliki bias lebih rendah tetapi varians lebih tinggi.
Bagaimana Kompleksitas Model Mempengaruhi Bias dan Varians
Sayangnya, kompleksitas model bukan satu angka yang dapat Anda ukur. Ini tentang seberapa fleksibel model Anda dalam menyesuaikan berbagai pola.
Kompleksitas berasal dari berbagai sumber, seperti lebih banyak fitur, lebih banyak lapisan dalam neural network, pohon keputusan yang lebih dalam, istilah polinomial dalam regresi, atau nilai k yang lebih rendah dalam KNN. Benang merahnya adalah semuanya memberi model Anda lebih banyak kebebasan untuk menyesuaikan pola yang rumit dalam data.
Saat Anda menambah parameter, Anda memberi model lebih banyak cara untuk merepresentasikan hubungan dalam data Anda. Model linier dengan 3 fitur hanya bisa menarik sebuah bidang datar melalui data Anda. Jika Anda menambahkan istilah polinomial dan fitur interaksi, model bisa membengkok dan melengkung untuk menyesuaikan pola yang lebih kompleks. Asumsi model menjadi kurang membatasi, yang berarti bias lebih rendah.
Namun fleksibilitas ini datang dengan biaya, yakni peningkatan varians.
Lebih banyak parameter berarti lebih banyak nilai yang harus dipelajari dari data pelatihan Anda. Setiap parameter disetel untuk menyesuaikan contoh pelatihan spesifik Anda, yang membuat model lebih sensitif terhadap contoh mana yang kebetulan Anda sertakan. Ketika Anda mengubah beberapa sampel pelatihan, semua parameter itu bergeser untuk mengakomodasi data baru. Model menjadi tidak stabil.
Inilah mengapa kesalahan pelatihan saja menyesatkan dan berbahaya.
Saat Anda meningkatkan kompleksitas, kesalahan pelatihan akan selalu menurun. Model Anda menyesuaikan data pelatihan semakin baik, akhirnya mendekati akurasi sempurna. Ini tampak bagus hingga Anda menyadari bahwa model menghafal noise alih-alih mempelajari pola.
Kesalahan pada set uji akan memberi tahu seberapa baik model Anda sebenarnya.
Awalnya, saat Anda menambah kompleksitas, kesalahan uji menurun karena model mulai menangkap pola nyata. Namun setelah titik tertentu, kesalahan uji meningkat meski kesalahan pelatihan terus turun. Model mengalami overfitting - mempelajari keanehan spesifik dari set pelatihan yang tidak menggeneralisasi.
Kesenjangan kecil antara kesalahan pelatihan dan uji berarti model Anda menggeneralisasi dengan baik. Kesenjangan besar berarti Anda overfitting dan perlu mengurangi kompleksitas atau menambah lebih banyak data pelatihan.
Teknik untuk Mengelola Pertukaran Bias-Varians
Anda tidak bisa menghilangkan pertukaran bias-varians, tetapi Anda bisa mengendalikannya dengan teknik yang tepat. Berikut beberapa di antaranya.
Pembagian train/test
Jangan pernah mengevaluasi model pada data yang sama dengan data pelatihannya.
Bagi data Anda menjadi set pelatihan dan uji sebelum melakukan apa pun. Latih pada satu bagian, evaluasi pada bagian lainnya. Ini memberi ukuran yang jujur tentang seberapa baik model Anda menggeneralisasi ke data baru.
Set uji bertindak sebagai proksi kinerja di dunia nyata. Ketika kesalahan pelatihan rendah tetapi kesalahan uji tinggi, Anda tahu Anda mengalami overfitting. Ketika keduanya tinggi, Anda mengalami underfitting.
Cross-validation
Pembagian train/test memiliki kelemahan - bergantung pada contoh spesifik mana yang masuk ke masing-masing set.
Cross-validation mengatasinya dengan melatih dan menguji beberapa kali pada pembagian data yang berbeda. Pendekatan paling umum adalah k-fold cross-validation, di mana Anda membagi data menjadi k bagian, melatih pada k-1 bagian, dan menguji pada bagian yang tersisa. Ulangi k kali sehingga setiap bagian berperan sebagai set uji sekali.
Ini memberi perkiraan kinerja model yang lebih andal dan membantu Anda menyetel hiperparameter tanpa overfitting pada satu set uji.
Regularisasi
Regularisasi menambahkan penalti untuk kompleksitas model langsung ke dalam fungsi loss Anda.
Teknik seperti regularisasi L1 (Lasso) dan L2 (Ridge) mencegah nilai parameter menjadi besar, yang memaksa model tetap lebih sederhana dan stabil. Ini sedikit meningkatkan bias tetapi menurunkan varians, sering kali meningkatkan kinerja uji secara keseluruhan.
Dropout pada neural network bekerja serupa - secara acak menjatuhkan neuron saat pelatihan, yang mencegah jaringan terlalu bergantung pada parameter tertentu dan mengurangi overfitting.
Data lebih banyak vs. model yang lebih baik
Lebih banyak data pelatihan sering menjadi solusi terbaik untuk varians tinggi.
Ketika Anda memiliki lebih banyak contoh, model Anda melihat sampel pola yang lebih luas untuk dipelajari. Ini menyulitkan overfitting pada noise karena noise dirata-ratakan di lebih banyak titik data. Varians menurun tanpa mengorbankan bias rendah dari model yang kompleks.
Namun mengumpulkan lebih banyak data tidak selalu praktis atau memungkinkan.
Jika Anda terjebak dengan data terbatas, fokus pada pemilihan model - pilih model yang lebih sederhana, tambahkan regularisasi, atau gunakan metode ensemble yang menggabungkan beberapa model untuk mengurangi varians.
Seleksi fitur
Tidak semua fitur meningkatkan model Anda. Sebagian hanya akan menambah noise.
Hapus fitur yang tidak relevan atau redundan untuk mengurangi kompleksitas model tanpa kehilangan pola penting. Lebih sedikit fitur berarti lebih sedikit parameter yang harus dipelajari, yang menurunkan varians. Anda juga menghindari kutukan dimensi di mana model kesulitan dalam ruang berdimensi tinggi dengan data terbatas.
Gunakan teknik seperti analisis korelasi, skor pentingnya fitur dari model berbasis pohon, atau metode regularisasi yang secara otomatis meniadakan fitur yang tidak penting.
Tujuannya adalah menemukan set fitur minimal yang menangkap sinyal tanpa noise.
Kesalahpahaman Umum tentang Pertukaran Bias-Varians
Mari saya luruskan tiga kesalahan umum yang membuat orang mengambil keputusan pemodelan yang buruk.
"Bias yang lebih rendah selalu lebih baik"
Salah. Bias yang lebih rendah berarti model Anda dapat merepresentasikan pola yang kompleks, tetapi itu hanya berguna jika pola tersebut benar-benar ada dalam data Anda dan menggeneralisasi ke contoh baru.
Mengurangi bias dengan menambah kompleksitas sering kali meningkatkan varians lebih cepat daripada menurunkan bias. Anda berakhir dengan model yang menyesuaikan data pelatihan dengan sempurna tetapi berkinerja lebih buruk pada data uji. Tujuannya adalah meminimalkan total kesalahan, bukan hanya bias.
Terkadang model yang lebih sederhana dengan bias lebih tinggi berkinerja lebih baik secara keseluruhan karena memiliki varians yang cukup rendah untuk menggeneralisasi dengan baik.
"Overfitting berarti modelnya buruk"
Tidak sepenuhnya. Overfitting berarti model Anda terlalu kompleks untuk jumlah data yang Anda miliki, tetapi model itu sendiri tidak serta-merta buruk.
Arsitektur neural network yang sama yang overfit pada 1.000 contoh pelatihan mungkin berkinerja sempurna pada 100.000 contoh. Masalahnya adalah ketidakcocokan antara kapasitas dan ukuran data.
Anda dapat memperbaiki overfitting dengan menambah data, mengurangi kompleksitas, atau menerapkan regularisasi. Anda tidak perlu membuang model dan mulai dari awal dengan sesuatu yang benar-benar berbeda.
"Lebih banyak data selalu memperbaiki varians"
Lebih banyak data mengurangi varians, tetapi tidak menghilangkannya, dan ada batas seberapa besar manfaatnya.
Jika model Anda sangat kompleks relatif terhadap masalah Anda, bahkan dataset besar mungkin tidak cukup menstabilkannya. Neural network dengan jutaan parameter memerlukan data dalam jumlah masif agar dapat dilatih dengan baik.
Selain itu, menambah data hanya membantu jika data baru merepresentasikan distribusi yang sama dengan data uji Anda. Mengumpulkan lebih banyak data yang bias atau berkualitas rendah tidak akan mengurangi varians - bahkan dapat memperburuk keadaan dengan memperkuat pola yang tidak menggeneralisasi.
Pertukaran Bias-Varians vs. Overfitting dan Underfitting
Bias-varians dan overfitting-underfitting menggambarkan masalah yang sama dari sudut berbeda, tetapi bukan istilah yang dapat dipertukarkan.
Berikut yang perlu Anda ingat:
- Bias tinggi menyebabkan underfitting. Ketika model Anda memiliki asumsi kuat yang tidak sesuai dengan data nyata, ia secara sistematis melewatkan pola dalam data pelatihan dan uji. Model terlalu sederhana untuk merepresentasikan hubungan yang sebenarnya, yang merupakan arti underfitting.
- Varians tinggi menyebabkan overfitting. Ketika model Anda terlalu sensitif terhadap data pelatihan, ia mempelajari noise dan pola yang tidak menggeneralisasi. Model menghafal contoh pelatihan alih-alih mempelajari pola yang mendasari, yang merupakan arti overfitting.
Bias dan varians adalah sifat dari model Anda.
Keduanya menggambarkan bagaimana model Anda berperilaku pada berbagai set pelatihan. Anda dapat mengukur bias dengan melihat seberapa jauh rata-rata prediksi model dari kebenaran. Anda dapat mengukur varians dengan melihat seberapa banyak prediksi berubah dengan data pelatihan yang berbeda.
Underfitting dan overfitting adalah gejala yang Anda amati.
Keduanya menggambarkan apa yang terjadi saat Anda melatih dan menguji model. Anda melihat underfitting ketika kesalahan pelatihan dan uji sama-sama tinggi. Anda melihat overfitting ketika kesalahan pelatihan rendah tetapi kesalahan uji tinggi.
Koneksinya langsung tetapi tidak satu banding satu. Bias tinggi biasanya mengarah ke underfitting, dan varians tinggi biasanya mengarah ke overfitting. Namun Anda bisa saja memiliki model dengan bias moderat dan varians moderat yang tidak underfit maupun overfit - hanya berkinerja buruk karena alasan lain, seperti fitur yang salah atau kualitas data yang tidak memadai.
Tips Praktis untuk Menafsirkan Kinerja Model
Berikut beberapa tips terakhir tentang cara mendiagnosis masalah bias-varians dan membuat keputusan pemodelan yang lebih baik.
Lihat kesalahan pelatihan dan validasi bersama-sama, bukan secara terpisah
Kesalahan pelatihan saja tidak memberi tahu Anda tentang generalisasi. Model dengan kesalahan pelatihan 1% bisa saja memiliki kesalahan uji 50% jika overfitting.
Bandingkan kedua kesalahan untuk memahami apa yang terjadi.
- Ketika keduanya tinggi, Anda memiliki bias tinggi - model terlalu sederhana
- Ketika kesalahan pelatihan rendah tetapi kesalahan validasi tinggi, Anda memiliki varians tinggi - model overfitting
- Ketika keduanya rendah, Anda telah menemukan keseimbangan yang tepat
Jangan mengoptimalkan akurasi pelatihan saja
Akurasi pelatihan sempurna adalah tanda bahaya. Ini biasanya berarti Anda menghafal set pelatihan tanpa mempelajari pola yang menggeneralisasi.
Fokuslah pada kinerja validasi. Tujuan Anda adalah meminimalkan kesenjangan antara kesalahan pelatihan dan validasi sambil menjaga keduanya tetap cukup rendah.
Gunakan cross-validation untuk mendapatkan perkiraan yang andal
Satu pembagian train-test bisa menyesatkan karena bergantung pada contoh mana yang masuk ke masing-masing set. Satu pembagian yang tidak beruntung dapat membuat model yang baik terlihat buruk atau model yang buruk terlihat baik.
Cross-validation merata-ratakan kinerja di beberapa pembagian, yang memberi Anda perkiraan yang lebih stabil tentang bagaimana model Anda akan berkinerja pada data baru. Ini sangat penting saat Anda memiliki data terbatas atau saat Anda menyetel hiperparameter.
Seimbangkan kesederhanaan dan fleksibilitas berdasarkan ukuran data Anda
Dengan dataset kecil, condonglah ke model yang lebih sederhana. Mereka lebih stabil dan cenderung tidak overfit saat Anda tidak memiliki banyak contoh untuk dipelajari.
Dengan dataset besar, Anda bisa menggunakan model yang lebih kompleks karena data tambahan menstabilkan proses pembelajaran dan mengurangi varians. Namun jangan menambah kompleksitas hanya karena bisa - tambahkan hanya jika meningkatkan kinerja validasi.
Kesimpulan
Anda tidak bisa membangun model dengan bias nol dan varians nol. Setiap keputusan pemodelan yang Anda buat mengubah keseimbangan antara dua sumber kesalahan ini. Tambahkan kompleksitas dan Anda menurunkan bias namun meningkatkan varians. Sederhanakan dan Anda menurunkan varians namun meningkatkan bias.
Kinerja model bergantung pada menemukan keseimbangan yang tepat. Model terbaik adalah yang meminimalkan total kesalahan dengan menyeimbangkan bias dan varians untuk masalah dan dataset spesifik Anda. Memahami pertukaran ini berarti Anda dapat mendiagnosis apakah model Anda menderita bias tinggi atau varians tinggi dan menerapkan solusi yang tepat.
Jika Anda siap mendapatkan pengalaman langsung dengan machine learning, daftarlah ke jalur Fundamentals Machine Learning di Python kami. Tersedia 16 jam materi video yang akan membantu Anda mendapatkan pekerjaan pertama.




Pertukaran bias-varians menjelaskan mengapa kinerja model bukan hanya soal kompleksitas atau akurasi, tetapi tentang menemukan titik keseimbangan di mana model Anda dapat menggeneralisasi dengan baik ke data yang belum pernah dilihat tanpa menyederhanakan masalah secara berlebihan atau overfitting pada set pelatihan.
Dalam artikel ini, saya akan menjelaskan apa sebenarnya yang dimaksud dengan bias dan varians dalam machine learning, bagaimana keduanya saling bertukar, dan mengapa memahami pertukaran ini membantu Anda membangun model yang lebih andal.
Jika Anda baru dalam machine learning, artikel Cara Belajar Machine Learning pada 2026 kami akan membantu Anda mahir dalam waktu singkat.
Apa Itu Bias?
Bias adalah kesalahan yang muncul akibat membuat asumsi yang terlalu sederhana tentang data Anda. Ini tidak ada hubungannya dengan prasangka, setidaknya bukan dalam konteks machine learning.
Ketika model memiliki bias tinggi, artinya model terlalu kaku untuk menangkap pola sebenarnya dalam data Anda. Bayangkan mencoba memasangkan garis lurus pada data yang jelas melengkung: Apa pun penyesuaian garis itu, garis tersebut tidak akan pernah cocok dengan bentuk yang sesungguhnya.
Ini disebut underfitting.
Model dengan bias tinggi menyederhanakan masalah secara berlebihan. Ia mengasumsikan hubungan lebih sederhana daripada kenyataannya, sehingga melewatkan pola penting yang akan membantunya membuat prediksi yang akurat.
Bayangkan Anda memprediksi harga rumah berdasarkan luas bangunan, jumlah kamar, lokasi, dan usia rumah. Model bias tinggi mungkin hanya menggunakan luas bangunan dan mengabaikan yang lain. Ia mengasumsikan luas bangunan saja menentukan harga, yang jelas terlalu sederhana.
Hasilnya adalah model yang berkinerja buruk pada data pelatihan maupun data baru karena tidak dapat menangkap kompleksitas harga rumah yang sebenarnya.
Regresi linier dengan sedikit fitur adalah contoh klasik model dengan bias tinggi. Pohon keputusan dengan kedalaman yang sangat terbatas juga cenderung memiliki bias tinggi karena tidak dapat membagi data cukup banyak untuk menemukan pola yang halus.
Bias tinggi berarti model Anda tidak cukup belajar dari data, melainkan membuat masalah menjadi terlalu sederhana untuk diselesaikan dengan tingkat akurasi yang baik.
Apa Itu Varians?
Varians mengukur seberapa sensitif model Anda terhadap data pelatihan spesifik yang Anda gunakan.
Ini tidak ada hubungannya dengan ukuran statistik sebaran data. Dalam machine learning, varians menggambarkan perilaku model, bukan distribusi data.
Ketika model memiliki varians tinggi, perubahan kecil pada data pelatihan memicu perubahan besar pada prediksinya. Dengan kata lain, saat Anda melatih model yang sama pada dua dataset yang sedikit berbeda, Anda akan mendapatkan hasil yang sangat berbeda.
Ini disebut overfitting.
Model dengan varians tinggi terlalu fleksibel. Ia mempelajari bukan hanya pola nyata dalam data Anda tetapi juga noise dan fluktuasi acak yang tidak dapat digeneralisasi ke data baru. Model pada dasarnya menghafal contoh pelatihan alih-alih mempelajari hubungan yang mendasarinya.
Bayangkan Anda masih memprediksi harga rumah, tetapi kini menggunakan model kompleks dengan ratusan parameter. Ia bisa saja mempelajari bahwa rumah di Oak Street selalu terjual tepat $427.350 karena itulah yang terjadi di data pelatihan Anda.
Hasilnya adalah model yang berkinerja sangat baik pada data pelatihan tetapi buruk pada data baru karena ia mempelajari keanehan spesifik dari set pelatihan.
Deep neural networks dan pohon keputusan tanpa batasan kedalaman adalah contoh klasik model dengan varians tinggi. Mereka cukup fleksibel untuk menyesuaikan hampir semua pola, termasuk yang tidak bermakna.
Varians tinggi berarti model Anda terlalu banyak belajar dari data. Ia menyesuaikan noise bersama sinyal, yang membuatnya tidak stabil dan tidak andal pada contoh baru.
Bias vs. Varians: Perbedaan Utama
Bias dan varians adalah dua sumber kesalahan prediksi yang sepenuhnya berbeda. Setelah Anda memahami perbedaannya, Anda akan lebih cepat mendiagnosis apa yang salah pada model Anda.
Berikut cara bias dan varians memengaruhi kesalahan prediksi:
Masalahnya, mengurangi yang satu biasanya meningkatkan yang lain.
Saat Anda membuat model lebih kompleks untuk mengurangi bias, Anda meningkatkan fleksibilitasnya. Fleksibilitas itu membuat model lebih sensitif terhadap data pelatihan, yang meningkatkan varians. Saat Anda menyederhanakan model untuk mengurangi varians, Anda mengurangi kemampuannya menangkap pola kompleks, yang meningkatkan bias.
Hubungan berlawanan ini membuat Anda tidak bisa sekaligus meminimalkan keduanya. Alih-alih, Anda harus menemukan keseimbangan yang memberi total kesalahan terendah.
Apa Itu Pertukaran Bias-Varians?
Pertukaran bias-varians menggambarkan tarik-ulur antara dua sumber kesalahan ini - ketika Anda menurunkan yang satu, hampir selalu menaikkan yang lain.
Bayangkan seperti ini: Anda mencoba mengenai target, namun ada dua masalah yang saling berlawanan. Anda bisa membidik lebih saksama (mengurangi bias), tetapi itu membuat Anda lebih sensitif terhadap angin dan getaran tangan (meningkatkan varians). Atau Anda bisa menggunakan posisi menembak yang lebih sederhana dan stabil (mengurangi varians), tetapi itu membatasi ketelitian Anda (meningkatkan bias).
Kompleksitas model berada di pusat pertukaran ini.
Saat Anda menggunakan model sederhana dengan sedikit parameter, Anda mendapatkan bias tinggi dan varians rendah. Model membuat asumsi yang konsisten dan tidak banyak berubah dengan data pelatihan berbeda, tetapi tidak dapat menangkap pola yang kompleks.
Saat Anda menggunakan model kompleks dengan banyak parameter, Anda mendapatkan bias rendah dan varians tinggi. Model dapat merepresentasikan hubungan yang rumit, tetapi menjadi tidak stabil dan terlalu sensitif terhadap contoh spesifik yang digunakan untuk melatihnya.
Berikut kurva konseptual yang menjelaskannya:
Kurva pertukaran bias-varians
Anda mencari titik di mana gabungan efek keduanya menghasilkan kesalahan uji terendah.
Tidak ada satu model "sempurna" yang cocok untuk setiap masalah. Keseimbangan optimal bergantung pada data Anda, kompleksitas masalah, dan seberapa banyak data pelatihan yang Anda miliki. Lebih banyak data umumnya memungkinkan Anda menggunakan model yang lebih kompleks tanpa overfitting, menggeser titik manis ke kanan.
Contoh Sederhana Pertukaran Bias-Varians
Mari saya buat konsep ini konkret dengan skenario nyata yang menunjukkan bagaimana bias dan varians terjadi dalam praktik.
Bayangkan Anda membangun model untuk memprediksi harga sewa apartemen di sebuah kota. Anda memiliki fitur seperti luas, jumlah kamar tidur, lingkungan, jarak ke stasiun metro, usia bangunan, dan fasilitas.
Model sederhana: Regresi linier dengan satu fitur
Anda memutuskan hanya menggunakan luas untuk memprediksi harga dengan regresi linier sederhana.
Model sederhana
Model kompleks: Deep neural network dengan semua fitur
Sekarang Anda membangun deep neural network dengan beberapa lapisan tersembunyi menggunakan semua fitur yang tersedia, ditambah fitur rekayasa seperti tingkat kejahatan lingkungan, skor walkability, dan kedekatan ke taman.
Model kompleks
Model seimbang: Regresi teratur dengan fitur kunci
Anda menggunakan regresi teratur (seperti Ridge atau Lasso) dengan subset fitur yang dipilih secara cermat: luas, kamar tidur, kategori lingkungan, dan jarak ke transportasi.
Model seimbang
Model seimbang tidak akan menyesuaikan data pelatihan Anda secara sempurna, dan memang itulah tujuannya.
Pertukaran Bias-Varians dalam Model Machine Learning
Algoritma machine learning yang berbeda secara alami cenderung ke bias tinggi atau varians tinggi. Anda perlu memahami kecenderungan ini untuk memilih alat yang tepat bagi masalah Anda.
Model linier
Regresi linier dan regresi logistik berada di ujung spektrum bias tinggi.
Model-model ini mengasumsikan hubungan bersifat linier - satu fitur berubah, keluaran berubah dengan jumlah tetap. Ketika data Anda memiliki pola nonlinier, hubungan melengkung, atau interaksi kompleks antar fitur, model linier tidak dapat menangkapnya.
Keuntungannya adalah stabilitas. Latih model linier pada sampel data Anda yang berbeda, dan Anda akan mendapatkan koefisien yang serupa setiap kali. Varians rendah, tetapi berpotensi bias tinggi jika hubungan sebenarnya tidak linier.
Pohon keputusan
Pohon keputusan dapat berperilaku berbeda tergantung bagaimana Anda mengonfigurasinya.
Pohon dangkal dengan hanya beberapa pemisahan bertindak seperti model sederhana - bias tinggi, varians rendah. Ia membuat generalisasi luas dan tidak dapat menangkap pola yang rinci.
Pohon yang dalam tanpa batasan kedalaman menjadi sangat fleksibel. Ia terus membelah hingga setiap daun hanya berisi beberapa titik data, yang berarti ia menghafal data pelatihan Anda. Bias rendah, tetapi varians sangat tinggi - struktur pohon berubah drastis dengan sampel pelatihan yang berbeda.
Inilah mengapa random forest bekerja sangat baik. Mereka merata-ratakan prediksi dari banyak pohon, yang mengurangi masalah varians sambil tetap menjaga bias rendah.
K-nearest neighbors
Keseimbangan bias-varians KNN sepenuhnya bergantung pada pilihan k Anda.
Saat k kecil (seperti k=1 atau k=3), model memiliki varians tinggi. Ia mendasarkan prediksi pada hanya beberapa titik terdekat, sehingga sangat sensitif terhadap contoh spesifik dalam set pelatihan Anda. Perubahan kecil pada data pelatihan menghasilkan prediksi yang sepenuhnya berbeda.
Saat k besar (seperti k=50 atau k=100), model memiliki bias tinggi. Ia merata-ratakan terlalu banyak tetangga sehingga menghaluskan pola lokal dan melewatkan detail penting dalam data.
Nilai k yang optimal berada di tengah, menyeimbangkan dua ekstrem ini.
Neural network
Neural network secara alami merupakan model dengan varians tinggi karena memiliki begitu banyak parameter yang harus dipelajari.
Jaringan dengan banyak lapisan dan ratusan neuron dapat merepresentasikan fungsi yang sangat kompleks. Fleksibilitas ini berarti bias rendah - jaringan dapat mempelajari hampir semua pola. Namun juga berarti varians tinggi - bobot persis yang Anda pelajari sangat bergantung pada data pelatihan spesifik, inisialisasi, dan proses pelatihan.
Inilah alasan neural network membutuhkan dataset besar agar bekerja dengan baik. Lebih banyak data pelatihan membantu menstabilkan proses pembelajaran dan mengurangi varians. Ini juga alasan teknik seperti dropout, batch normalization, dan early stopping ada - semuanya dirancang untuk mengendalikan varians dan mencegah overfitting.
Jaringan yang lebih kecil dengan lebih sedikit lapisan dan neuron memiliki bias lebih tinggi tetapi varians lebih rendah, sementara jaringan yang lebih besar memiliki bias lebih rendah tetapi varians lebih tinggi.
Bagaimana Kompleksitas Model Mempengaruhi Bias dan Varians
Sayangnya, kompleksitas model bukan satu angka yang dapat Anda ukur. Ini tentang seberapa fleksibel model Anda dalam menyesuaikan berbagai pola.
Kompleksitas berasal dari berbagai sumber, seperti lebih banyak fitur, lebih banyak lapisan dalam neural network, pohon keputusan yang lebih dalam, istilah polinomial dalam regresi, atau nilai k yang lebih rendah dalam KNN. Benang merahnya adalah semuanya memberi model Anda lebih banyak kebebasan untuk menyesuaikan pola yang rumit dalam data.
Saat Anda menambah parameter, Anda memberi model lebih banyak cara untuk merepresentasikan hubungan dalam data Anda. Model linier dengan 3 fitur hanya bisa menarik sebuah bidang datar melalui data Anda. Jika Anda menambahkan istilah polinomial dan fitur interaksi, model bisa membengkok dan melengkung untuk menyesuaikan pola yang lebih kompleks. Asumsi model menjadi kurang membatasi, yang berarti bias lebih rendah.
Namun fleksibilitas ini datang dengan biaya, yakni peningkatan varians.
Lebih banyak parameter berarti lebih banyak nilai yang harus dipelajari dari data pelatihan Anda. Setiap parameter disetel untuk menyesuaikan contoh pelatihan spesifik Anda, yang membuat model lebih sensitif terhadap contoh mana yang kebetulan Anda sertakan. Ketika Anda mengubah beberapa sampel pelatihan, semua parameter itu bergeser untuk mengakomodasi data baru. Model menjadi tidak stabil.
Inilah mengapa kesalahan pelatihan saja menyesatkan dan berbahaya.
Saat Anda meningkatkan kompleksitas, kesalahan pelatihan akan selalu menurun. Model Anda menyesuaikan data pelatihan semakin baik, akhirnya mendekati akurasi sempurna. Ini tampak bagus hingga Anda menyadari bahwa model menghafal noise alih-alih mempelajari pola.
Kesalahan pada set uji akan memberi tahu seberapa baik model Anda sebenarnya.
Awalnya, saat Anda menambah kompleksitas, kesalahan uji menurun karena model mulai menangkap pola nyata. Namun setelah titik tertentu, kesalahan uji meningkat meski kesalahan pelatihan terus turun. Model mengalami overfitting - mempelajari keanehan spesifik dari set pelatihan yang tidak menggeneralisasi.
Kesenjangan kecil antara kesalahan pelatihan dan uji berarti model Anda menggeneralisasi dengan baik. Kesenjangan besar berarti Anda overfitting dan perlu mengurangi kompleksitas atau menambah lebih banyak data pelatihan.
Teknik untuk Mengelola Pertukaran Bias-Varians
Anda tidak bisa menghilangkan pertukaran bias-varians, tetapi Anda bisa mengendalikannya dengan teknik yang tepat. Berikut beberapa di antaranya.
Pembagian train/test
Jangan pernah mengevaluasi model pada data yang sama dengan data pelatihannya.
Bagi data Anda menjadi set pelatihan dan uji sebelum melakukan apa pun. Latih pada satu bagian, evaluasi pada bagian lainnya. Ini memberi ukuran yang jujur tentang seberapa baik model Anda menggeneralisasi ke data baru.
Set uji bertindak sebagai proksi kinerja di dunia nyata. Ketika kesalahan pelatihan rendah tetapi kesalahan uji tinggi, Anda tahu Anda mengalami overfitting. Ketika keduanya tinggi, Anda mengalami underfitting.
Cross-validation
Pembagian train/test memiliki kelemahan - bergantung pada contoh spesifik mana yang masuk ke masing-masing set.
Cross-validation mengatasinya dengan melatih dan menguji beberapa kali pada pembagian data yang berbeda. Pendekatan paling umum adalah k-fold cross-validation, di mana Anda membagi data menjadi k bagian, melatih pada k-1 bagian, dan menguji pada bagian yang tersisa. Ulangi k kali sehingga setiap bagian berperan sebagai set uji sekali.
Ini memberi perkiraan kinerja model yang lebih andal dan membantu Anda menyetel hiperparameter tanpa overfitting pada satu set uji.
Regularisasi
Regularisasi menambahkan penalti untuk kompleksitas model langsung ke dalam fungsi loss Anda.
Teknik seperti regularisasi L1 (Lasso) dan L2 (Ridge) mencegah nilai parameter menjadi besar, yang memaksa model tetap lebih sederhana dan stabil. Ini sedikit meningkatkan bias tetapi menurunkan varians, sering kali meningkatkan kinerja uji secara keseluruhan.
Dropout pada neural network bekerja serupa - secara acak menjatuhkan neuron saat pelatihan, yang mencegah jaringan terlalu bergantung pada parameter tertentu dan mengurangi overfitting.
Data lebih banyak vs. model yang lebih baik
Lebih banyak data pelatihan sering menjadi solusi terbaik untuk varians tinggi.
Ketika Anda memiliki lebih banyak contoh, model Anda melihat sampel pola yang lebih luas untuk dipelajari. Ini menyulitkan overfitting pada noise karena noise dirata-ratakan di lebih banyak titik data. Varians menurun tanpa mengorbankan bias rendah dari model yang kompleks.
Namun mengumpulkan lebih banyak data tidak selalu praktis atau memungkinkan.
Jika Anda terjebak dengan data terbatas, fokus pada pemilihan model - pilih model yang lebih sederhana, tambahkan regularisasi, atau gunakan metode ensemble yang menggabungkan beberapa model untuk mengurangi varians.
Seleksi fitur
Tidak semua fitur meningkatkan model Anda. Sebagian hanya akan menambah noise.
Hapus fitur yang tidak relevan atau redundan untuk mengurangi kompleksitas model tanpa kehilangan pola penting. Lebih sedikit fitur berarti lebih sedikit parameter yang harus dipelajari, yang menurunkan varians. Anda juga menghindari kutukan dimensi di mana model kesulitan dalam ruang berdimensi tinggi dengan data terbatas.
Gunakan teknik seperti analisis korelasi, skor pentingnya fitur dari model berbasis pohon, atau metode regularisasi yang secara otomatis meniadakan fitur yang tidak penting.
Tujuannya adalah menemukan set fitur minimal yang menangkap sinyal tanpa noise.
Kesalahpahaman Umum tentang Pertukaran Bias-Varians
Mari saya luruskan tiga kesalahan umum yang membuat orang mengambil keputusan pemodelan yang buruk.
"Bias yang lebih rendah selalu lebih baik"
Salah. Bias yang lebih rendah berarti model Anda dapat merepresentasikan pola yang kompleks, tetapi itu hanya berguna jika pola tersebut benar-benar ada dalam data Anda dan menggeneralisasi ke contoh baru.
Mengurangi bias dengan menambah kompleksitas sering kali meningkatkan varians lebih cepat daripada menurunkan bias. Anda berakhir dengan model yang menyesuaikan data pelatihan dengan sempurna tetapi berkinerja lebih buruk pada data uji. Tujuannya adalah meminimalkan total kesalahan, bukan hanya bias.
Terkadang model yang lebih sederhana dengan bias lebih tinggi berkinerja lebih baik secara keseluruhan karena memiliki varians yang cukup rendah untuk menggeneralisasi dengan baik.
"Overfitting berarti modelnya buruk"
Tidak sepenuhnya. Overfitting berarti model Anda terlalu kompleks untuk jumlah data yang Anda miliki, tetapi model itu sendiri tidak serta-merta buruk.
Arsitektur neural network yang sama yang overfit pada 1.000 contoh pelatihan mungkin berkinerja sempurna pada 100.000 contoh. Masalahnya adalah ketidakcocokan antara kapasitas dan ukuran data.
Anda dapat memperbaiki overfitting dengan menambah data, mengurangi kompleksitas, atau menerapkan regularisasi. Anda tidak perlu membuang model dan mulai dari awal dengan sesuatu yang benar-benar berbeda.
"Lebih banyak data selalu memperbaiki varians"
Lebih banyak data mengurangi varians, tetapi tidak menghilangkannya, dan ada batas seberapa besar manfaatnya.
Jika model Anda sangat kompleks relatif terhadap masalah Anda, bahkan dataset besar mungkin tidak cukup menstabilkannya. Neural network dengan jutaan parameter memerlukan data dalam jumlah masif agar dapat dilatih dengan baik.
Selain itu, menambah data hanya membantu jika data baru merepresentasikan distribusi yang sama dengan data uji Anda. Mengumpulkan lebih banyak data yang bias atau berkualitas rendah tidak akan mengurangi varians - bahkan dapat memperburuk keadaan dengan memperkuat pola yang tidak menggeneralisasi.
Pertukaran Bias-Varians vs. Overfitting dan Underfitting
Bias-varians dan overfitting-underfitting menggambarkan masalah yang sama dari sudut berbeda, tetapi bukan istilah yang dapat dipertukarkan.
Berikut yang perlu Anda ingat:
Bias dan varians adalah sifat dari model Anda.
Keduanya menggambarkan bagaimana model Anda berperilaku pada berbagai set pelatihan. Anda dapat mengukur bias dengan melihat seberapa jauh rata-rata prediksi model dari kebenaran. Anda dapat mengukur varians dengan melihat seberapa banyak prediksi berubah dengan data pelatihan yang berbeda.
Underfitting dan overfitting adalah gejala yang Anda amati.
Keduanya menggambarkan apa yang terjadi saat Anda melatih dan menguji model. Anda melihat underfitting ketika kesalahan pelatihan dan uji sama-sama tinggi. Anda melihat overfitting ketika kesalahan pelatihan rendah tetapi kesalahan uji tinggi.
Koneksinya langsung tetapi tidak satu banding satu. Bias tinggi biasanya mengarah ke underfitting, dan varians tinggi biasanya mengarah ke overfitting. Namun Anda bisa saja memiliki model dengan bias moderat dan varians moderat yang tidak underfit maupun overfit - hanya berkinerja buruk karena alasan lain, seperti fitur yang salah atau kualitas data yang tidak memadai.
Tips Praktis untuk Menafsirkan Kinerja Model
Berikut beberapa tips terakhir tentang cara mendiagnosis masalah bias-varians dan membuat keputusan pemodelan yang lebih baik.
Lihat kesalahan pelatihan dan validasi bersama-sama, bukan secara terpisah
Kesalahan pelatihan saja tidak memberi tahu Anda tentang generalisasi. Model dengan kesalahan pelatihan 1% bisa saja memiliki kesalahan uji 50% jika overfitting.
Bandingkan kedua kesalahan untuk memahami apa yang terjadi.
Jangan mengoptimalkan akurasi pelatihan saja
Akurasi pelatihan sempurna adalah tanda bahaya. Ini biasanya berarti Anda menghafal set pelatihan tanpa mempelajari pola yang menggeneralisasi.
Fokuslah pada kinerja validasi. Tujuan Anda adalah meminimalkan kesenjangan antara kesalahan pelatihan dan validasi sambil menjaga keduanya tetap cukup rendah.
Gunakan cross-validation untuk mendapatkan perkiraan yang andal
Satu pembagian train-test bisa menyesatkan karena bergantung pada contoh mana yang masuk ke masing-masing set. Satu pembagian yang tidak beruntung dapat membuat model yang baik terlihat buruk atau model yang buruk terlihat baik.
Cross-validation merata-ratakan kinerja di beberapa pembagian, yang memberi Anda perkiraan yang lebih stabil tentang bagaimana model Anda akan berkinerja pada data baru. Ini sangat penting saat Anda memiliki data terbatas atau saat Anda menyetel hiperparameter.
Seimbangkan kesederhanaan dan fleksibilitas berdasarkan ukuran data Anda
Dengan dataset kecil, condonglah ke model yang lebih sederhana. Mereka lebih stabil dan cenderung tidak overfit saat Anda tidak memiliki banyak contoh untuk dipelajari.
Dengan dataset besar, Anda bisa menggunakan model yang lebih kompleks karena data tambahan menstabilkan proses pembelajaran dan mengurangi varians. Namun jangan menambah kompleksitas hanya karena bisa - tambahkan hanya jika meningkatkan kinerja validasi.
Kesimpulan
Anda tidak bisa membangun model dengan bias nol dan varians nol. Setiap keputusan pemodelan yang Anda buat mengubah keseimbangan antara dua sumber kesalahan ini. Tambahkan kompleksitas dan Anda menurunkan bias namun meningkatkan varians. Sederhanakan dan Anda menurunkan varians namun meningkatkan bias.
Kinerja model bergantung pada menemukan keseimbangan yang tepat. Model terbaik adalah yang meminimalkan total kesalahan dengan menyeimbangkan bias dan varians untuk masalah dan dataset spesifik Anda. Memahami pertukaran ini berarti Anda dapat mendiagnosis apakah model Anda menderita bias tinggi atau varians tinggi dan menerapkan solusi yang tepat.
Jika Anda siap mendapatkan pengalaman langsung dengan machine learning, daftarlah ke jalur Fundamentals Machine Learning di Python kami. Tersedia 16 jam materi video yang akan membantu Anda mendapatkan pekerjaan pertama.