De bias-variance trade-off verklaart waarom modelprestaties niet alleen draaien om complexiteit of nauwkeurigheid, maar om het vinden van de sweet spot waar je model goed generaliseert naar onbekende data, zonder het probleem te simplificeren of te overfitten op je trainingsset.
In dit artikel leg ik uit wat bias en variantie in machine learning nu echt betekenen, hoe ze elkaar in balans houden en waarom inzicht in deze trade-off je helpt robuustere modellen te bouwen.
Als je nieuw bent met machine learning, helpt ons How to Learn Machine Learning in 2026-artikel je om dit snel onder de knie te krijgen.
Wat is bias?
Bias is de fout die ontstaat door te simpele aannames over je data. Het heeft niets met vooringenomenheid te maken, in elk geval niet binnen machine learning.
Als een model hoge bias heeft, is het te star om de echte patronen in je data te vangen. Denk aan proberen een rechte lijn te passen door data die duidelijk kromt: hoe je die lijn ook aanpast, hij zal nooit de echte vorm volgen.
Dit heet underfitting.
Een model met hoge bias versimpelt het probleem te veel. Het gaat uit van relaties die eenvoudiger zijn dan in werkelijkheid, waardoor het belangrijke patronen mist die voor nauwkeurige voorspellingen zouden zorgen.
Stel dat je huizenprijzen voorspelt op basis van woonoppervlak, aantal slaapkamers, locatie en bouwjaar. Een model met hoge bias zou misschien alleen het woonoppervlak gebruiken en de rest negeren. Het gaat er dan van uit dat alleen oppervlakte de prijs bepaalt, wat veel te simpel is.
Het resultaat is een model dat slecht presteert op zowel trainingsdata als nieuwe data, omdat het de complexiteit van echte huizenprijzen niet kan vatten.
Lineaire regressie met weinig features is een klassiek model met hoge bias. Beslisbomen met zeer beperkte diepte hebben ook vaak hoge bias, omdat ze de data niet vaak genoeg kunnen splitsen om subtiele patronen te vinden.
Hoge bias betekent dat je model niet genoeg leert van de data, maar het probleem te eenvoudig maakt om het met goede nauwkeurigheid op te lossen.
Wat is variantie?
Variantie meet hoe gevoelig je model is voor de specifieke trainingsdata die je gebruikt.
Het heeft niets te maken met de statistische maat voor spreiding van data. In machine learning beschrijft variantie het gedrag van het model, niet de data-verdeling.
Als een model hoge variantie heeft, leiden kleine veranderingen in je trainingsdata tot grote verschillen in de voorspellingen van het model. Met andere woorden: train je hetzelfde model op twee licht verschillende datasets, dan krijg je totaal andere resultaten.
Dit heet overfitting.
Een model met hoge variantie is te flexibel. Het leert niet alleen de echte patronen in je data, maar ook de ruis en willekeurige fluctuaties die niet generaliseren naar nieuwe data. Het model onthoudt in feite de trainingsvoorbeelden in plaats van de onderliggende relaties te leren.
Stel dat je nog steeds huizenprijzen voorspelt, maar nu met een complex model met honderden parameters. Het kan leren dat huizen in Oak Street altijd precies $427.350 kosten, omdat dat in je trainingsdata zo was.
Het resultaat is een model dat geweldig presteert op trainingsdata, maar slecht op nieuwe data, omdat het eigenaardigheden heeft geleerd die specifiek zijn voor de trainingsset.
Diepe neurale netwerken en beslisbomen zonder dieptebeperking zijn klassieke modellen met hoge variantie. Ze zijn flexibel genoeg om bijna elk patroon te passen, inclusief betekenisloze.
Hoge variantie betekent dat je model te veel leert van de data. Het past de ruis samen met het signaal, waardoor het onstabiel en onbetrouwbaar wordt op nieuwe voorbeelden.
Bias vs. variantie: belangrijkste verschillen
Bias en variantie zijn twee totaal verschillende bronnen van voorspellingsfouten. Als je het onderscheid begrijpt, kun je sneller diagnosticeren wat er mis is met je model.
- Bias komt voort uit de aannames van je model. Het gaat om het algoritme dat je koos, de features die je opnam en hoe je het probleem structureerde. Een lineair regressiemodel gaat uit van lineaire relaties en heeft dus bias als de echte relatie niet-lineair is. Deze fout bestaat al voordat je naar je trainingsdata kijkt.
- Variantie komt door gevoeligheid voor trainingsdata. Het gaat erom hoeveel je model verandert als je het traint op andere steekproeven uit dezelfde populatie. Een model met hoge variantie leert verschillende patronen uit licht verschillende trainingssets, wat de voorspellingen onstabiel maakt.
Zo beïnvloeden bias en variantie de voorspellingsfout:
- Hoge bias betekent dat je model consistente fouten maakt in dezelfde richting. Het onderschat of overschat steeds bepaalde patronen, omdat het de ware relatie niet kan representeren. De fouten zijn systematisch en voorspelbaar.
- Hoge variantie betekent dat je model inconsistente fouten maakt die met de data veranderen. Train het op data van maandag en het voorspelt het één; train het op data van dinsdag en het voorspelt iets totaal anders. De fouten zijn willekeurig en onvoorspelbaar.
Het probleem is dat het verlagen van de ene de andere meestal verhoogt.
Als je je model complexer maakt om bias te verlagen, vergroot je de flexibiliteit. Die flexibiliteit maakt het gevoeliger voor trainingsdata, wat de variantie verhoogt. Als je je model vereenvoudigt om variantie te verminderen, neem je het vermogen weg om complexe patronen te vangen, wat de bias verhoogt.
Deze omgekeerde relatie betekent dat je ze niet allebei tegelijk kunt minimaliseren. Je moet in plaats daarvan het evenwicht vinden dat de laagste totale fout geeft.
Wat is de bias-variance trade-off?
De bias-variance trade-off beschrijft de spanning tussen deze twee foutbronnen - als je de ene verlaagt, verhoog je bijna altijd de andere.
Zie het zo: je probeert een doel te raken, maar twee problemen werken tegen je. Je kunt zorgvuldiger mikken (bias verminderen), maar dan word je gevoeliger voor wind en trillende handen (variantie verhogen). Of je neemt een eenvoudigere, stabielere schiethouding (variantie verminderen), maar dat beperkt je precisie (bias verhogen).
Modelcomplexiteit staat centraal in deze trade-off.
Gebruik je een simpel model met weinig parameters, dan krijg je hoge bias en lage variantie. Het model maakt consistente aannames en verandert weinig met andere trainingsdata, maar kan geen complexe patronen vangen.
Gebruik je een complex model met veel parameters, dan krijg je lage bias en hoge variantie. Het model kan ingewikkelde relaties representeren, maar wordt onstabiel en overgevoelig voor de specifieke voorbeelden waarop je het traint.
Dit is de conceptuele curve die dit uitlegt:
- Aan de linkerkant (simpele modellen): de trainingsfout is hoog omdat het model underfit. De testfout is ook hoog omdat het model echte patronen mist.
- In het midden (gebalanceerde modellen): zowel trainings- als testfout zijn laag. Het model vangt echte patronen zonder ruis te memoriseren. Dit is je sweet spot.
- Aan de rechterkant (complexe modellen): de trainingsfout is zeer laag omdat het model alles past. De testfout is hoog omdat het model ruis heeft geleerd.
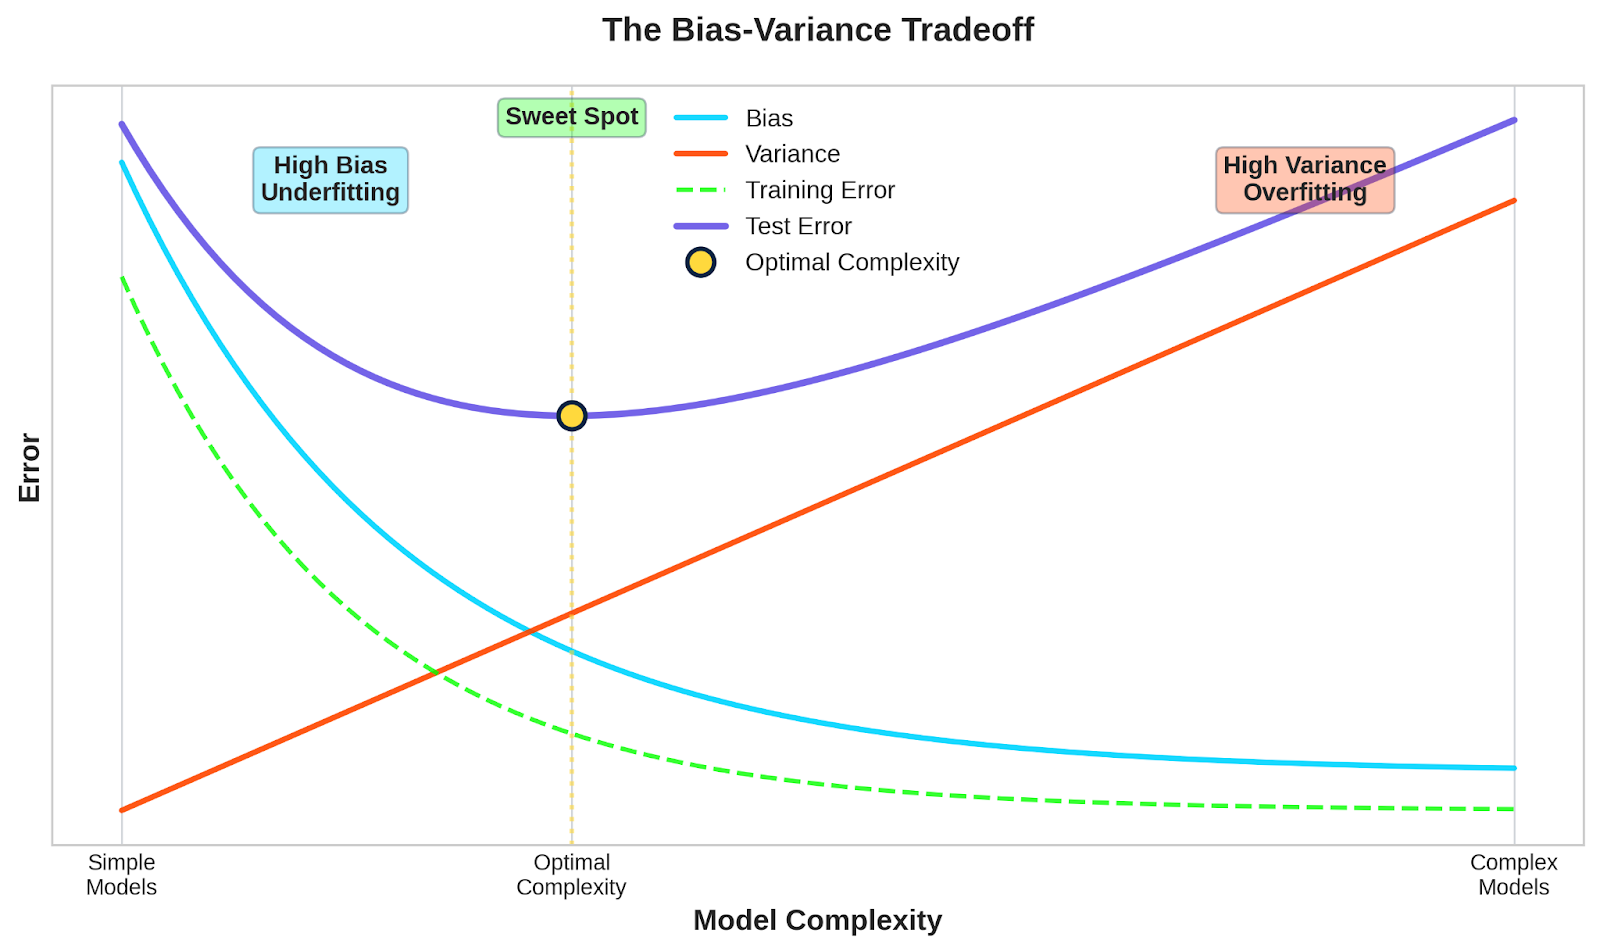
Bias-variance trade-off-curve
Je zoekt het punt waarop hun gecombineerde effect je de laagste testfout geeft.
Er is geen enkel "perfect" model dat voor elk probleem werkt. De optimale balans hangt af van je data, de complexiteit van je probleem en hoeveel trainingsdata je hebt. Meer data stelt je doorgaans in staat om complexere modellen te gebruiken zonder te overfitten, waardoor de sweet spot naar rechts opschuift.
Een eenvoudig voorbeeld van de bias-variance trade-off
Ik maak dit concept concreet met een scenario dat laat zien hoe bias en variantie in de praktijk uitpakken.
Stel dat je een model bouwt om huurprijzen van appartementen in een stad te voorspellen. Je hebt features zoals woonoppervlak, aantal slaapkamers, buurt, afstand tot de metro, bouwjaar en voorzieningen.
Simpel model: lineaire regressie met één feature
Je besluit alleen het woonoppervlak te gebruiken om de prijs te voorspellen met een eenvoudige lineaire regressie.
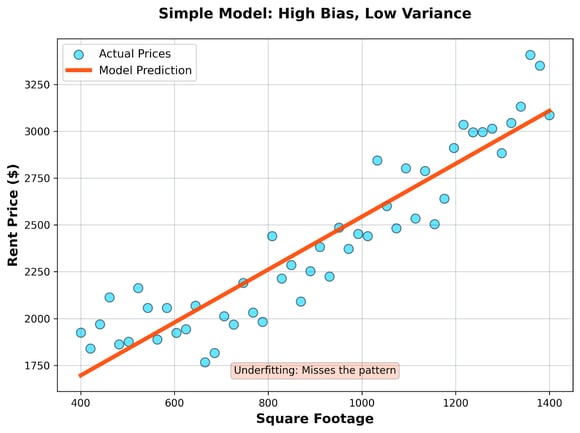
Simpel model
- Wat er gebeurt: Het model trekt een rechte lijn door je datapunten. Het voorspelt dat elke 100 square feet een vast dollarbedrag aan de huur toevoegt, ongeacht locatie of andere factoren.
- Het resultaat: Dit model heeft hoge bias en lage variantie. Het onderschat consequent luxe appartementen en overschat studio’s, omdat het de complexe relatie tussen grootte en prijs per buurt niet kan vangen. Maar train je het op verschillende steekproeven van appartementen, dan krijg je ongeveer steeds dezelfde lijn - het is stabiel maar onnauwkeurig.
Complex model: deep neural network met alle features
Nu bouw je een deep neural network met meerdere verborgen lagen met alle beschikbare features, plus engineered features zoals criminaliteitscijfers per buurt, walkability-scores en nabijheid van parken.
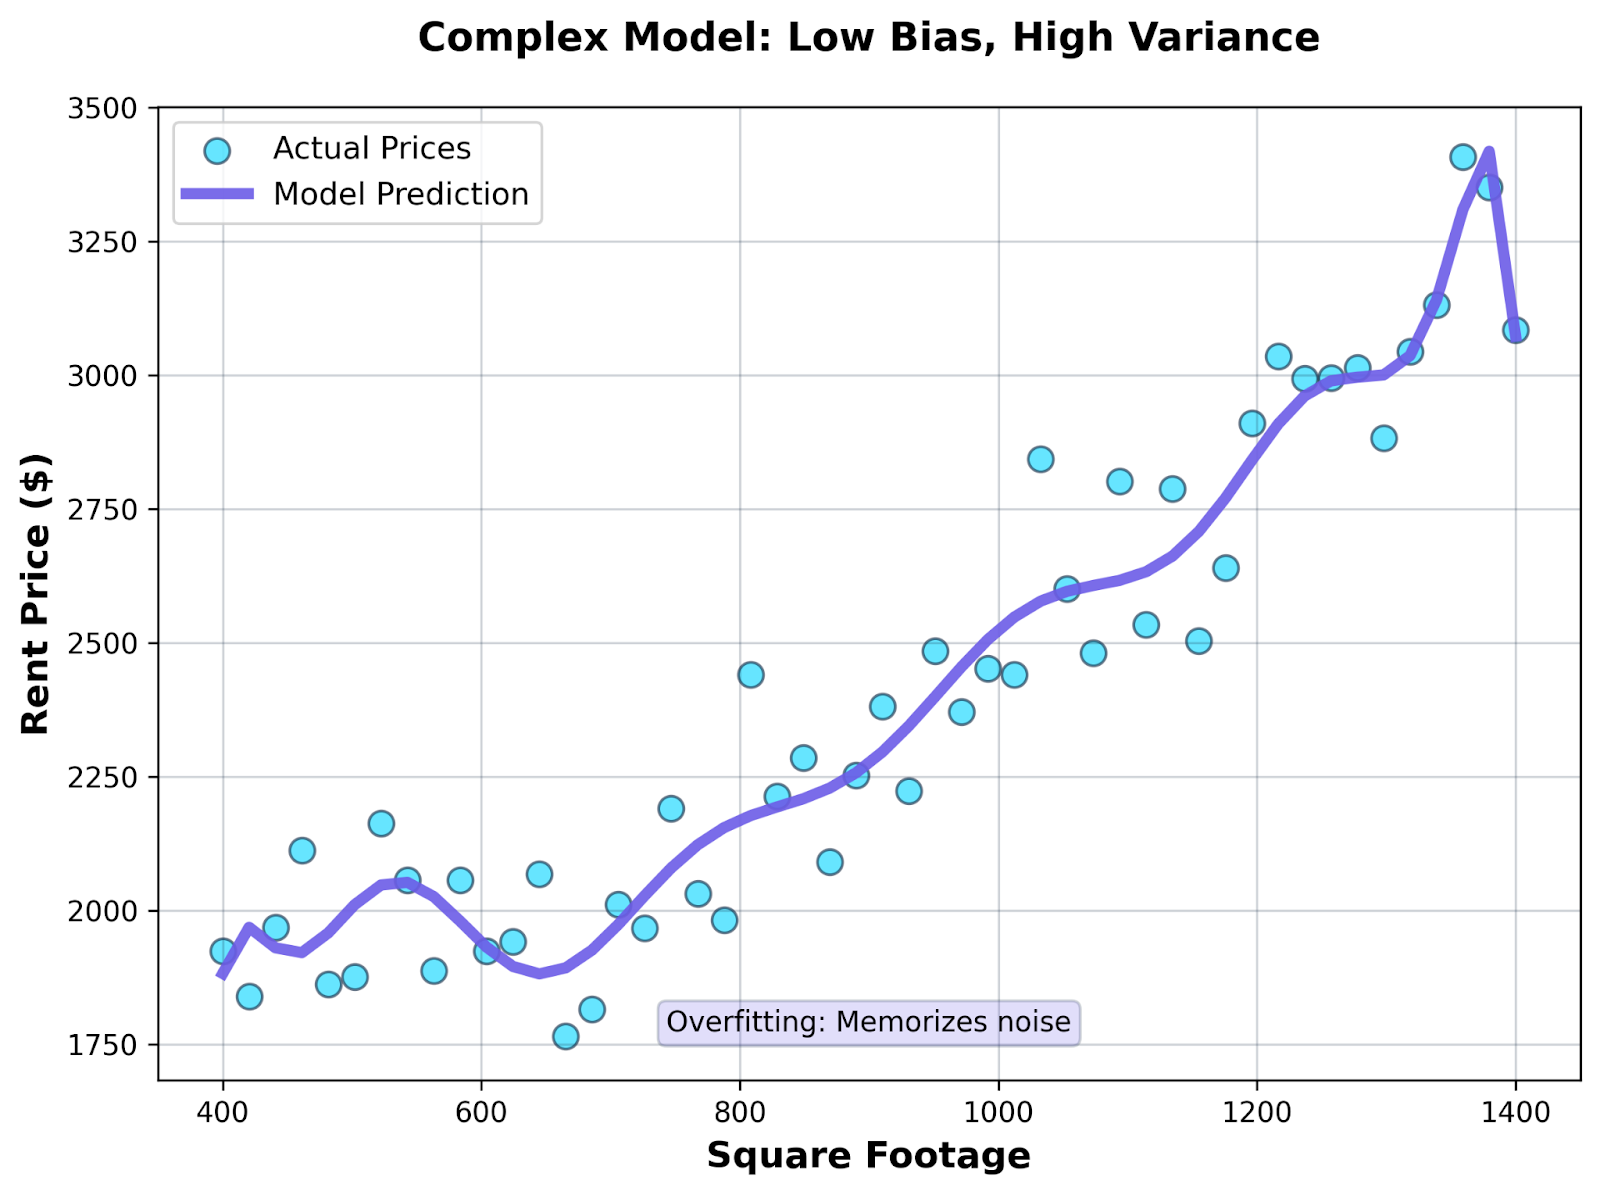
Complex model
- Wat er gebeurt: Het netwerk leert verfijnde patronen. Het kan ontdekken dat appartementen op de 5e verdieping in jouw specifieke trainingsdata altijd precies $2.847 kosten, of dat units op Oak Street die naar het noorden liggen 37% meer huur opbrengen dan die naar het zuiden.
- Het resultaat: Dit model heeft lage bias en hoge variantie. Het past je trainingsdata bijna perfect en vangt elk detail en elke fluctuatie. Maar die patronen generaliseren niet - het zijn artefacten van je specifieke steekproef. Train je het op een andere set appartementen, dan leert het totaal andere patronen. De voorspellingen zijn onstabiel en onbetrouwbaar op nieuwe data.
Gebalanceerd model: geregulariseerde regressie met kernfeatures
Je gebruikt geregulariseerde regressie (zoals Ridge of Lasso) met een zorgvuldig geselecteerde subset van features: woonoppervlak, slaapkamers, buurtcategorie en afstand tot ov.
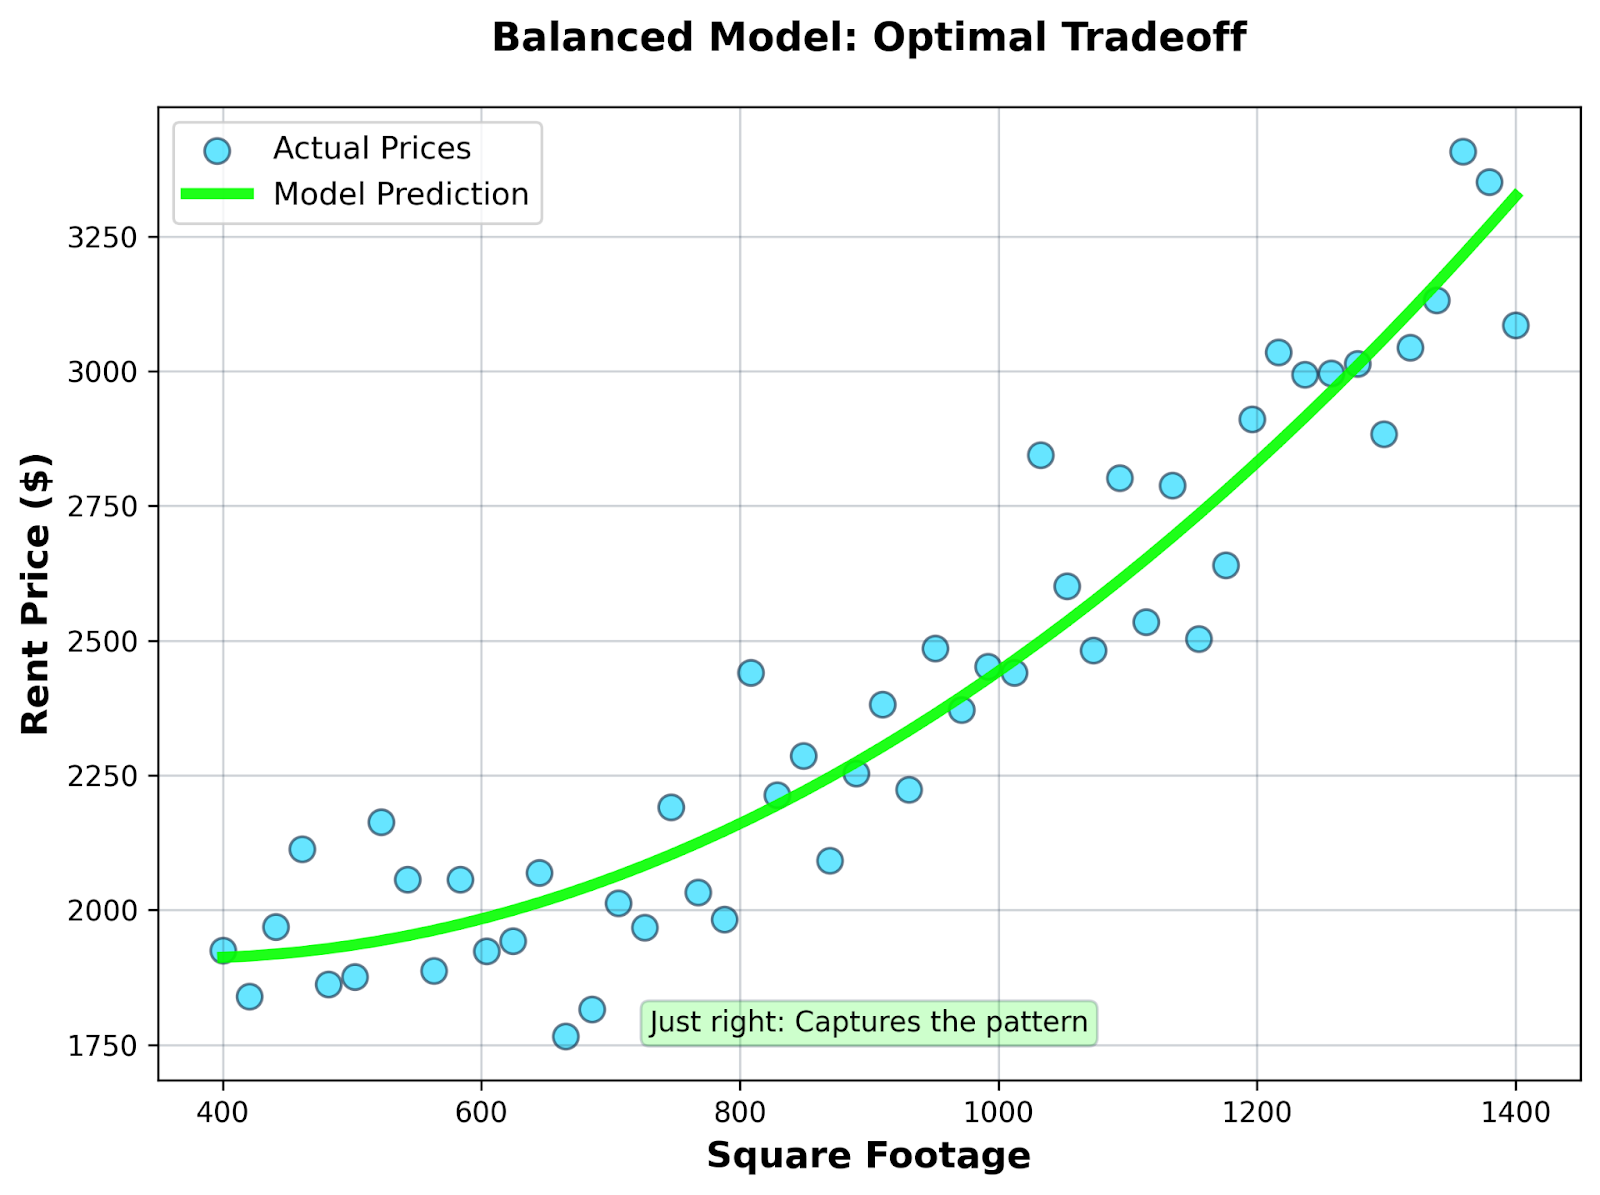
Gebalanceerd model
- Wat er gebeurt: Het model vangt de hoofdrelaties zonder ruis te memoriseren. Het leert dat grootte en locatie ertoe doen, maar raakt niet geobsedeerd door elke minieme fluctuatie in de trainingsdata.
- Het resultaat: Dit model balanceert bias en variantie. Het is flexibel genoeg om echte patronen te vangen, maar genoeg begrensd om overfitting te vermijden. De trainingsfout is gemiddeld, maar de testfout is laag - en dat is wat telt voor voorspellingen op nieuwe appartementen.
Het gebalanceerde model past je trainingsdata niet perfect - en dat is precies de bedoeling.
Bias-variance trade-off in machine learning-modellen
Verschillende machine learning-algoritmen neigen van nature naar óf hoge bias óf hoge variantie. Je moet die neigingen begrijpen om het juiste gereedschap voor je probleem te kiezen.
Lineaire modellen
Lineaire regressie en logistische regressie zitten aan de kant van hoge bias.
Deze modellen gaan uit van lineaire relaties - één feature verandert en de output verandert met een vast bedrag. Als je data niet-lineaire patronen, kromme relaties of complexe interacties tussen features heeft, kunnen lineaire modellen die niet vangen.
Het voordeel is stabiliteit. Train een lineair model op verschillende steekproeven van je data en je krijgt elke keer vergelijkbare coëfficiënten. Lage variantie, maar mogelijk hoge bias als de echte relatie niet lineair is.
Beslisbomen
Beslisbomen kunnen zich verschillend gedragen, afhankelijk van hoe je ze configureert.
Een ondiepe boom met slechts enkele splitsingen gedraagt zich als een simpel model - hoge bias, lage variantie. Hij maakt grove generalisaties en kan geen fijnmazige patronen vangen.
Een diepe boom zonder dieptelimiet wordt extreem flexibel. Hij blijft splitsen tot elk blad slechts enkele punten bevat, wat neerkomt op het memoriseren van je trainingsdata. Lage bias, maar torenhoge variantie - de boomstructuur verandert drastisch met andere trainingssteekproeven.
Dit is waarom random forests zo goed werken. Ze middelen voorspellingen van veel bomen, wat de variantie vermindert terwijl de bias laag blijft.
K-nearest neighbors
De bias-variantie-balans van KNN hangt volledig af van je keuze van k.
Als k klein is (zoals k=1 of k=3), heeft het model hoge variantie. Het baseert voorspellingen op slechts een paar nabije punten, dus het is extreem gevoelig voor welke specifieke voorbeelden in je trainingsset zitten. Kleine wijzigingen in trainingsdata leiden tot totaal andere voorspellingen.
Als k groot is (zoals k=50 of k=100), heeft het model hoge bias. Het neemt zo veel buren mee dat lokale patronen worden gladgestreken en belangrijke details in de data verloren gaan.
De optimale k-waarde ligt ergens in het midden, als balans tussen deze twee uitersten.
Neurale netwerken
Neurale netwerken zijn van nature modellen met hoge variantie omdat ze zo veel parameters hebben om te leren.
Een netwerk met meerdere lagen en honderden neuronen kan ongelooflijk complexe functies representeren. Die flexibiliteit betekent lage bias - het netwerk kan vrijwel elk patroon leren. Maar het betekent ook hoge variantie - de exacte gewichten die je leert, hangen sterk af van je specifieke trainingsdata, initialisatie en trainingsproces.
Daarom hebben neurale netwerken veel data nodig om goed te werken. Meer trainingsdata stabiliseert het leerproces en verlaagt de variantie. Het is ook waarom technieken als dropout, batchnormalisatie en early stopping bestaan - ze zijn ontworpen om variantie te beheersen en overfitting te voorkomen.
Kleinere netwerken met minder lagen en neuronen hebben hogere bias maar lagere variantie, terwijl grotere netwerken lagere bias maar hogere variantie hebben.
Hoe modelcomplexiteit bias en variantie beïnvloedt
Helaas is modelcomplexiteit geen enkel getal dat je kunt meten. Het gaat erom hoe flexibel je model is in het passen van verschillende patronen.
Complexiteit komt uit meerdere bronnen, zoals meer features, meer lagen in een neuraal netwerk, diepere beslisbomen, polynoomtermen in regressie of lagere k-waarden in KNN. De gemene deler is dat ze je model meer vrijheid geven om verfijnde patronen in de data te passen.
Als je parameters toevoegt, geef je je model meer manieren om relaties in je data te representeren. Een lineair model met 3 features kan slechts een vlakke hypervlak door je data trekken. Voeg je polynoomtermen en interacties toe, dan kan het buigen en krommen om complexere patronen te volgen. De aannames van het model worden minder restrictief, wat lagere bias betekent.
Maar die flexibiliteit heeft een prijs, namelijk een toename in variantie.
Meer parameters betekenen meer waarden die uit je trainingsdata geleerd moeten worden. Elke parameter wordt bijgesteld om je specifieke trainingsvoorbeelden te passen, waardoor het model gevoeliger wordt voor welke voorbeelden je toevallig hebt opgenomen. Verander je enkele trainingssamples, dan verschuiven al die parameters om de nieuwe data te accommoderen. Het model wordt onstabiel.
Daarom is alleen naar trainingsfout kijken misleidend en riskant.
Als je de complexiteit vergroot, zal de trainingsfout altijd dalen. Je model past de trainingsdata steeds beter en bereikt uiteindelijk bijna perfecte nauwkeurigheid. Dat lijkt geweldig, totdat je beseft dat het ruis memoriseert in plaats van patronen te leren.
Fout op de testset vertelt je hoe goed je model echt is.
In het begin, als je complexiteit toevoegt, daalt de testfout omdat het model echte patronen gaat vangen. Maar voorbij een bepaald punt stijgt de testfout, ook al blijft de trainingsfout dalen. Het model overfit - het leert eigenaardigheden die specifiek zijn voor de trainingsset en niet generaliseren.
Een kleine kloof tussen train- en testfout betekent dat je model goed generaliseert. Een grote kloof betekent dat je overfit en de complexiteit moet verlagen of meer trainingsdata moet toevoegen.
Technieken om de bias-variance trade-off te beheren
Je kunt de bias-variance trade-off niet elimineren, maar wel sturen met de juiste technieken. Ik laat er een paar zien.
Train/test-splits
Evalueer je model nooit op dezelfde data waarop je het hebt getraind.
Splits je data in trainings- en testsets voordat je iets anders doet. Train op het ene deel, evalueer op het andere. Dit geeft je een eerlijke maat voor hoe goed je model generaliseert naar nieuwe data.
De testset fungeert als proxy voor prestaties in de echte wereld. Als de trainingsfout laag is maar de testfout hoog, weet je dat je overfit. Als beide hoog zijn, underfit je.
Cross-validatie
Train/test-splits hebben een zwakte - ze hangen af van welke specifieke voorbeelden in elke set belanden.
Cross-validatie lost dit op door meerdere keren te trainen en testen op verschillende splits van je data. De meest gebruikte aanpak is k-fold cross-validatie, waarbij je je data in k delen verdeelt, op k-1 delen traint en op het resterende deel test. Herhaal dit k keer zodat elk deel één keer als testset dient.
Dit geeft je een betrouwbaardere schatting van modelprestaties en helpt je hyperparameters af te stemmen zonder te overfitten op één enkele testset.
Regularisatie
Regularisatie voegt een straf voor modelcomplexiteit direct toe aan je verliesfunctie.
Technieken zoals L1 (Lasso) en L2 (Ridge) regularisatie ontmoedigen grote parameterwaarden, waardoor het model eenvoudiger en stabieler blijft. Dit verhoogt de bias iets, maar verlaagt de variantie, wat vaak de testprestaties verbetert.
Dropout in neurale netwerken werkt vergelijkbaar - het laat tijdens training willekeurig neuronen weg, waardoor het netwerk niet te veel kan steunen op specifieke parameters en overfitting afneemt.
Meer data versus betere modellen
Meer trainingsdata is vaak de beste oplossing voor hoge variantie.
Met meer voorbeelden ziet je model een bredere steekproef van mogelijke patronen. Dit maakt overfitten op ruis lastiger omdat de ruis uitmiddelt over meer punten. De variantie daalt zonder de lage bias van een complex model op te offeren.
Maar meer data verzamelen is niet altijd haalbaar of mogelijk.
Als je vastzit met beperkte data, focus dan op modelkeuze - kies eenvoudigere modellen, voeg regularisatie toe of gebruik ensemblemethoden die meerdere modellen combineren om de variantie te verlagen.
Featureselectie
Niet alle features verbeteren je model. Sommige voegen alleen ruis toe.
Verwijder irrelevante of redundante features om de modelcomplexiteit te verlagen zonder belangrijke patronen te verliezen. Minder features betekent minder parameters om te leren, wat de variantie verlaagt. Je vermijdt ook de vloek van dimensionaliteit, waarbij modellen worstelen in hoog-dimensionale ruimtes met beperkte data.
Gebruik technieken zoals correlatieanalyse, feature-importance-scores uit boommodellen of regularisatiemethoden die onbelangrijke features automatisch op nul zetten.
Het doel is het minimale aantal features vinden dat het signaal vangt zonder de ruis.
Veelvoorkomende misvattingen over de bias-variance trade-off
Ik ruim drie veelgemaakte fouten op die tot slechte modelleerbeslissingen leiden.
"Lagere bias is altijd beter"
Onjuist. Lagere bias betekent dat je model complexe patronen kan representeren, maar dat is alleen nuttig als die patronen daadwerkelijk in je data bestaan en generaliseren naar nieuwe voorbeelden.
Bias verlagen door complexiteit toe te voegen verhoogt vaak de variantie sneller dan de bias daalt. Je eindigt met een model dat trainingsdata perfect past, maar slechter presteert op testdata. Het doel is het minimaliseren van de totale fout, niet alleen van bias.
Soms presteert een eenvoudiger model met hogere bias overall beter, omdat het lage variantie heeft en goed generaliseert.
"Overfitting betekent dat het model slecht is"
Niet helemaal. Overfitting betekent dat je model te complex is voor de hoeveelheid data die je hebt, maar het model zelf is niet per se slecht.
Ditzelfde neurale netwerk dat overfit op 1.000 trainingsvoorbeelden kan uitstekend presteren op 100.000 voorbeelden. Het probleem is de mismatch tussen capaciteit en datagrootte.
Je kunt overfitting oplossen door meer data toe te voegen, de complexiteit te verlagen of regularisatie toe te passen. Je hoeft het model niet weg te gooien en helemaal opnieuw te beginnen met iets totaal anders.
"Meer data lost variantie altijd op"
Meer data verlaagt variantie, maar het elimineert het niet en er zitten grenzen aan hoeveel het helpt.
Als je model extreem complex is in verhouding tot je probleem, stabiliseren zelfs grote datasets het misschien niet genoeg. Een neuraal netwerk met miljoenen parameters heeft enorme hoeveelheden data nodig om goed te trainen.
Bovendien helpt meer data alleen als de nieuwe data dezelfde verdeling heeft als je testdata. Meer bevooroordeelde of lawaaierige data verzamelen verlaagt de variantie niet - het kan het zelfs erger maken door patronen te versterken die niet generaliseren.
Bias-variance trade-off vs. overfitting en underfitting
Bias-variance en overfitting-underfitting beschrijven dezelfde problemen vanuit verschillende invalshoeken, maar het zijn geen uitwisselbare termen.
Onthoud dit:
- Hoge bias veroorzaakt underfitting. Wanneer je model sterke aannames heeft die niet overeenkomen met echte data, mist het systematisch patronen in zowel train- als testdata. Het model is te simpel om de werkelijke relatie te representeren - dat is underfitting.
- Hoge variantie veroorzaakt overfitting. Wanneer je model te gevoelig is voor trainingsdata, leert het ruis en patronen die niet generaliseren. Het model onthoudt trainingsvoorbeelden in plaats van het onderliggende patroon te leren - dat is overfitting.
Bias en variantie zijn eigenschappen van je model.
Ze beschrijven hoe je model zich gedraagt over verschillende trainingssets. Je kunt bias meten door te kijken hoe ver de gemiddelde voorspellingen van je model van de waarheid afliggen. Je kunt variantie meten door te kijken hoeveel voorspellingen veranderen met andere trainingsdata.
Underfitting en overfitting zijn symptomen die je observeert.
Ze beschrijven wat er gebeurt wanneer je je model traint en test. Je ziet underfitting wanneer zowel de train- als testfout hoog zijn. Je ziet overfitting wanneer de trainingsfout laag is maar de testfout hoog.
De connectie is direct maar niet één-op-één. Hoge bias leidt meestal tot underfitting, en hoge variantie leidt meestal tot overfitting. Maar je kunt ook een model hebben met matige bias en matige variantie dat noch underfit noch overfit - het presteert gewoon slecht om andere redenen, zoals verkeerde features of onvoldoende datakwaliteit.
Praktische tips om modelprestaties te interpreteren
Hier zijn nog wat laatste tips om bias-variance-problemen te diagnosticeren en betere modelleerbeslissingen te nemen.
Kijk naar trainings- en validatiefouten samen, niet los
Alleen trainingsfout zegt niets over generalisatie. Een model met 1% trainingsfout kan 50% testfout hebben als het overfit.
Vergelijk de twee fouten om te begrijpen wat er gebeurt.
- Als beide hoog zijn, heb je hoge bias - het model is te simpel
- Als de trainingsfout laag is maar de validatiefout hoog, heb je hoge variantie - het model overfit
- Als beide laag zijn, heb je de juiste balans gevonden
Optimaliseer niet alleen voor trainingsnauwkeurigheid
Perfecte trainingsnauwkeurigheid is een alarmsignaal. Het betekent meestal dat je de trainingsset hebt gememoriseerd zonder patronen te leren die generaliseren.
Focus in plaats daarvan op validatieprestaties. Je doel is de kloof tussen train- en validatiefout te minimaliseren terwijl je beide redelijk laag houdt.
Gebruik cross-validatie voor betrouwbare schattingen
Eén enkele train-test-split kan misleidend zijn, omdat het afhangt van welke voorbeelden in welke set terechtkomen. Eén ongelukkige split kan een goed model slecht doen lijken of een slecht model goed.
Cross-validatie middelen prestaties over meerdere splits, wat je een stabielere schatting geeft van hoe je model op nieuwe data zal presteren. Dit is extra belangrijk bij beperkte data of wanneer je hyperparameters afstemt.
Balans tussen eenvoud en flexibiliteit op basis van je datagrootte
Met kleine datasets kun je beter neigen naar simpelere modellen. Die zijn stabieler en hebben minder kans op overfitting als je niet veel voorbeelden hebt om van te leren.
Met grote datasets kun je je meer complexe modellen permitteren, omdat de extra data het leerproces stabiliseert en de variantie verlaagt. Maar voeg geen complexiteit toe omdat het kan - alleen als het de validatieprestaties verbetert.
Conclusie
Je kunt geen model bouwen met nul bias en nul variantie. Elke modelleerbeslissing die je neemt, verschuift het evenwicht tussen deze twee foutbronnen. Voeg complexiteit toe en je verlaagt bias maar verhoogt variantie. Vereenvoudig en je verlaagt variantie maar verhoogt bias.
Modelprestaties hangen af van het vinden van de juiste balans. Het beste model is het model dat de totale fout minimaliseert door bias en variantie in balans te brengen voor jouw specifieke probleem en dataset. Begrip van deze trade-off betekent dat je kunt diagnosticeren of je model last heeft van hoge bias of hoge variantie en de juiste oplossing toepassen.
Als je klaar bent om praktisch met machine learning aan de slag te gaan, schrijf je dan in voor onze Machine Learning Fundamentals in Python-track. Deze bevat 16 uur aan videomateriaal dat je helpt je eerste baan te bemachtigen.


De bias-variance trade-off verklaart waarom modelprestaties niet alleen draaien om complexiteit of nauwkeurigheid, maar om het vinden van de sweet spot waar je model goed generaliseert naar onbekende data, zonder het probleem te simplificeren of te overfitten op je trainingsset.
In dit artikel leg ik uit wat bias en variantie in machine learning nu echt betekenen, hoe ze elkaar in balans houden en waarom inzicht in deze trade-off je helpt robuustere modellen te bouwen.
Als je nieuw bent met machine learning, helpt ons How to Learn Machine Learning in 2026-artikel je om dit snel onder de knie te krijgen.
Wat is bias?
Bias is de fout die ontstaat door te simpele aannames over je data. Het heeft niets met vooringenomenheid te maken, in elk geval niet binnen machine learning.
Als een model hoge bias heeft, is het te star om de echte patronen in je data te vangen. Denk aan proberen een rechte lijn te passen door data die duidelijk kromt: hoe je die lijn ook aanpast, hij zal nooit de echte vorm volgen.
Dit heet underfitting.
Een model met hoge bias versimpelt het probleem te veel. Het gaat uit van relaties die eenvoudiger zijn dan in werkelijkheid, waardoor het belangrijke patronen mist die voor nauwkeurige voorspellingen zouden zorgen.
Stel dat je huizenprijzen voorspelt op basis van woonoppervlak, aantal slaapkamers, locatie en bouwjaar. Een model met hoge bias zou misschien alleen het woonoppervlak gebruiken en de rest negeren. Het gaat er dan van uit dat alleen oppervlakte de prijs bepaalt, wat veel te simpel is.
Het resultaat is een model dat slecht presteert op zowel trainingsdata als nieuwe data, omdat het de complexiteit van echte huizenprijzen niet kan vatten.
Lineaire regressie met weinig features is een klassiek model met hoge bias. Beslisbomen met zeer beperkte diepte hebben ook vaak hoge bias, omdat ze de data niet vaak genoeg kunnen splitsen om subtiele patronen te vinden.
Hoge bias betekent dat je model niet genoeg leert van de data, maar het probleem te eenvoudig maakt om het met goede nauwkeurigheid op te lossen.
Wat is variantie?
Variantie meet hoe gevoelig je model is voor de specifieke trainingsdata die je gebruikt.
Het heeft niets te maken met de statistische maat voor spreiding van data. In machine learning beschrijft variantie het gedrag van het model, niet de data-verdeling.
Als een model hoge variantie heeft, leiden kleine veranderingen in je trainingsdata tot grote verschillen in de voorspellingen van het model. Met andere woorden: train je hetzelfde model op twee licht verschillende datasets, dan krijg je totaal andere resultaten.
Dit heet overfitting.
Een model met hoge variantie is te flexibel. Het leert niet alleen de echte patronen in je data, maar ook de ruis en willekeurige fluctuaties die niet generaliseren naar nieuwe data. Het model onthoudt in feite de trainingsvoorbeelden in plaats van de onderliggende relaties te leren.
Stel dat je nog steeds huizenprijzen voorspelt, maar nu met een complex model met honderden parameters. Het kan leren dat huizen in Oak Street altijd precies $427.350 kosten, omdat dat in je trainingsdata zo was.
Het resultaat is een model dat geweldig presteert op trainingsdata, maar slecht op nieuwe data, omdat het eigenaardigheden heeft geleerd die specifiek zijn voor de trainingsset.
Diepe neurale netwerken en beslisbomen zonder dieptebeperking zijn klassieke modellen met hoge variantie. Ze zijn flexibel genoeg om bijna elk patroon te passen, inclusief betekenisloze.
Hoge variantie betekent dat je model te veel leert van de data. Het past de ruis samen met het signaal, waardoor het onstabiel en onbetrouwbaar wordt op nieuwe voorbeelden.
Bias vs. variantie: belangrijkste verschillen
Bias en variantie zijn twee totaal verschillende bronnen van voorspellingsfouten. Als je het onderscheid begrijpt, kun je sneller diagnosticeren wat er mis is met je model.
Zo beïnvloeden bias en variantie de voorspellingsfout:
Het probleem is dat het verlagen van de ene de andere meestal verhoogt.
Als je je model complexer maakt om bias te verlagen, vergroot je de flexibiliteit. Die flexibiliteit maakt het gevoeliger voor trainingsdata, wat de variantie verhoogt. Als je je model vereenvoudigt om variantie te verminderen, neem je het vermogen weg om complexe patronen te vangen, wat de bias verhoogt.
Deze omgekeerde relatie betekent dat je ze niet allebei tegelijk kunt minimaliseren. Je moet in plaats daarvan het evenwicht vinden dat de laagste totale fout geeft.
Wat is de bias-variance trade-off?
De bias-variance trade-off beschrijft de spanning tussen deze twee foutbronnen - als je de ene verlaagt, verhoog je bijna altijd de andere.
Zie het zo: je probeert een doel te raken, maar twee problemen werken tegen je. Je kunt zorgvuldiger mikken (bias verminderen), maar dan word je gevoeliger voor wind en trillende handen (variantie verhogen). Of je neemt een eenvoudigere, stabielere schiethouding (variantie verminderen), maar dat beperkt je precisie (bias verhogen).
Modelcomplexiteit staat centraal in deze trade-off.
Gebruik je een simpel model met weinig parameters, dan krijg je hoge bias en lage variantie. Het model maakt consistente aannames en verandert weinig met andere trainingsdata, maar kan geen complexe patronen vangen.
Gebruik je een complex model met veel parameters, dan krijg je lage bias en hoge variantie. Het model kan ingewikkelde relaties representeren, maar wordt onstabiel en overgevoelig voor de specifieke voorbeelden waarop je het traint.
Dit is de conceptuele curve die dit uitlegt:
Bias-variance trade-off-curve
Je zoekt het punt waarop hun gecombineerde effect je de laagste testfout geeft.
Er is geen enkel "perfect" model dat voor elk probleem werkt. De optimale balans hangt af van je data, de complexiteit van je probleem en hoeveel trainingsdata je hebt. Meer data stelt je doorgaans in staat om complexere modellen te gebruiken zonder te overfitten, waardoor de sweet spot naar rechts opschuift.
Een eenvoudig voorbeeld van de bias-variance trade-off
Ik maak dit concept concreet met een scenario dat laat zien hoe bias en variantie in de praktijk uitpakken.
Stel dat je een model bouwt om huurprijzen van appartementen in een stad te voorspellen. Je hebt features zoals woonoppervlak, aantal slaapkamers, buurt, afstand tot de metro, bouwjaar en voorzieningen.
Simpel model: lineaire regressie met één feature
Je besluit alleen het woonoppervlak te gebruiken om de prijs te voorspellen met een eenvoudige lineaire regressie.
Simpel model
Complex model: deep neural network met alle features
Nu bouw je een deep neural network met meerdere verborgen lagen met alle beschikbare features, plus engineered features zoals criminaliteitscijfers per buurt, walkability-scores en nabijheid van parken.
Complex model
Gebalanceerd model: geregulariseerde regressie met kernfeatures
Je gebruikt geregulariseerde regressie (zoals Ridge of Lasso) met een zorgvuldig geselecteerde subset van features: woonoppervlak, slaapkamers, buurtcategorie en afstand tot ov.
Gebalanceerd model
Het gebalanceerde model past je trainingsdata niet perfect - en dat is precies de bedoeling.
Bias-variance trade-off in machine learning-modellen
Verschillende machine learning-algoritmen neigen van nature naar óf hoge bias óf hoge variantie. Je moet die neigingen begrijpen om het juiste gereedschap voor je probleem te kiezen.
Lineaire modellen
Lineaire regressie en logistische regressie zitten aan de kant van hoge bias.
Deze modellen gaan uit van lineaire relaties - één feature verandert en de output verandert met een vast bedrag. Als je data niet-lineaire patronen, kromme relaties of complexe interacties tussen features heeft, kunnen lineaire modellen die niet vangen.
Het voordeel is stabiliteit. Train een lineair model op verschillende steekproeven van je data en je krijgt elke keer vergelijkbare coëfficiënten. Lage variantie, maar mogelijk hoge bias als de echte relatie niet lineair is.
Beslisbomen
Beslisbomen kunnen zich verschillend gedragen, afhankelijk van hoe je ze configureert.
Een ondiepe boom met slechts enkele splitsingen gedraagt zich als een simpel model - hoge bias, lage variantie. Hij maakt grove generalisaties en kan geen fijnmazige patronen vangen.
Een diepe boom zonder dieptelimiet wordt extreem flexibel. Hij blijft splitsen tot elk blad slechts enkele punten bevat, wat neerkomt op het memoriseren van je trainingsdata. Lage bias, maar torenhoge variantie - de boomstructuur verandert drastisch met andere trainingssteekproeven.
Dit is waarom random forests zo goed werken. Ze middelen voorspellingen van veel bomen, wat de variantie vermindert terwijl de bias laag blijft.
K-nearest neighbors
De bias-variantie-balans van KNN hangt volledig af van je keuze van k.
Als k klein is (zoals k=1 of k=3), heeft het model hoge variantie. Het baseert voorspellingen op slechts een paar nabije punten, dus het is extreem gevoelig voor welke specifieke voorbeelden in je trainingsset zitten. Kleine wijzigingen in trainingsdata leiden tot totaal andere voorspellingen.
Als k groot is (zoals k=50 of k=100), heeft het model hoge bias. Het neemt zo veel buren mee dat lokale patronen worden gladgestreken en belangrijke details in de data verloren gaan.
De optimale k-waarde ligt ergens in het midden, als balans tussen deze twee uitersten.
Neurale netwerken
Neurale netwerken zijn van nature modellen met hoge variantie omdat ze zo veel parameters hebben om te leren.
Een netwerk met meerdere lagen en honderden neuronen kan ongelooflijk complexe functies representeren. Die flexibiliteit betekent lage bias - het netwerk kan vrijwel elk patroon leren. Maar het betekent ook hoge variantie - de exacte gewichten die je leert, hangen sterk af van je specifieke trainingsdata, initialisatie en trainingsproces.
Daarom hebben neurale netwerken veel data nodig om goed te werken. Meer trainingsdata stabiliseert het leerproces en verlaagt de variantie. Het is ook waarom technieken als dropout, batchnormalisatie en early stopping bestaan - ze zijn ontworpen om variantie te beheersen en overfitting te voorkomen.
Kleinere netwerken met minder lagen en neuronen hebben hogere bias maar lagere variantie, terwijl grotere netwerken lagere bias maar hogere variantie hebben.
Hoe modelcomplexiteit bias en variantie beïnvloedt
Helaas is modelcomplexiteit geen enkel getal dat je kunt meten. Het gaat erom hoe flexibel je model is in het passen van verschillende patronen.
Complexiteit komt uit meerdere bronnen, zoals meer features, meer lagen in een neuraal netwerk, diepere beslisbomen, polynoomtermen in regressie of lagere k-waarden in KNN. De gemene deler is dat ze je model meer vrijheid geven om verfijnde patronen in de data te passen.
Als je parameters toevoegt, geef je je model meer manieren om relaties in je data te representeren. Een lineair model met 3 features kan slechts een vlakke hypervlak door je data trekken. Voeg je polynoomtermen en interacties toe, dan kan het buigen en krommen om complexere patronen te volgen. De aannames van het model worden minder restrictief, wat lagere bias betekent.
Maar die flexibiliteit heeft een prijs, namelijk een toename in variantie.
Meer parameters betekenen meer waarden die uit je trainingsdata geleerd moeten worden. Elke parameter wordt bijgesteld om je specifieke trainingsvoorbeelden te passen, waardoor het model gevoeliger wordt voor welke voorbeelden je toevallig hebt opgenomen. Verander je enkele trainingssamples, dan verschuiven al die parameters om de nieuwe data te accommoderen. Het model wordt onstabiel.
Daarom is alleen naar trainingsfout kijken misleidend en riskant.
Als je de complexiteit vergroot, zal de trainingsfout altijd dalen. Je model past de trainingsdata steeds beter en bereikt uiteindelijk bijna perfecte nauwkeurigheid. Dat lijkt geweldig, totdat je beseft dat het ruis memoriseert in plaats van patronen te leren.
Fout op de testset vertelt je hoe goed je model echt is.
In het begin, als je complexiteit toevoegt, daalt de testfout omdat het model echte patronen gaat vangen. Maar voorbij een bepaald punt stijgt de testfout, ook al blijft de trainingsfout dalen. Het model overfit - het leert eigenaardigheden die specifiek zijn voor de trainingsset en niet generaliseren.
Een kleine kloof tussen train- en testfout betekent dat je model goed generaliseert. Een grote kloof betekent dat je overfit en de complexiteit moet verlagen of meer trainingsdata moet toevoegen.
Technieken om de bias-variance trade-off te beheren
Je kunt de bias-variance trade-off niet elimineren, maar wel sturen met de juiste technieken. Ik laat er een paar zien.
Train/test-splits
Evalueer je model nooit op dezelfde data waarop je het hebt getraind.
Splits je data in trainings- en testsets voordat je iets anders doet. Train op het ene deel, evalueer op het andere. Dit geeft je een eerlijke maat voor hoe goed je model generaliseert naar nieuwe data.
De testset fungeert als proxy voor prestaties in de echte wereld. Als de trainingsfout laag is maar de testfout hoog, weet je dat je overfit. Als beide hoog zijn, underfit je.
Cross-validatie
Train/test-splits hebben een zwakte - ze hangen af van welke specifieke voorbeelden in elke set belanden.
Cross-validatie lost dit op door meerdere keren te trainen en testen op verschillende splits van je data. De meest gebruikte aanpak is k-fold cross-validatie, waarbij je je data in k delen verdeelt, op k-1 delen traint en op het resterende deel test. Herhaal dit k keer zodat elk deel één keer als testset dient.
Dit geeft je een betrouwbaardere schatting van modelprestaties en helpt je hyperparameters af te stemmen zonder te overfitten op één enkele testset.
Regularisatie
Regularisatie voegt een straf voor modelcomplexiteit direct toe aan je verliesfunctie.
Technieken zoals L1 (Lasso) en L2 (Ridge) regularisatie ontmoedigen grote parameterwaarden, waardoor het model eenvoudiger en stabieler blijft. Dit verhoogt de bias iets, maar verlaagt de variantie, wat vaak de testprestaties verbetert.
Dropout in neurale netwerken werkt vergelijkbaar - het laat tijdens training willekeurig neuronen weg, waardoor het netwerk niet te veel kan steunen op specifieke parameters en overfitting afneemt.
Meer data versus betere modellen
Meer trainingsdata is vaak de beste oplossing voor hoge variantie.
Met meer voorbeelden ziet je model een bredere steekproef van mogelijke patronen. Dit maakt overfitten op ruis lastiger omdat de ruis uitmiddelt over meer punten. De variantie daalt zonder de lage bias van een complex model op te offeren.
Maar meer data verzamelen is niet altijd haalbaar of mogelijk.
Als je vastzit met beperkte data, focus dan op modelkeuze - kies eenvoudigere modellen, voeg regularisatie toe of gebruik ensemblemethoden die meerdere modellen combineren om de variantie te verlagen.
Featureselectie
Niet alle features verbeteren je model. Sommige voegen alleen ruis toe.
Verwijder irrelevante of redundante features om de modelcomplexiteit te verlagen zonder belangrijke patronen te verliezen. Minder features betekent minder parameters om te leren, wat de variantie verlaagt. Je vermijdt ook de vloek van dimensionaliteit, waarbij modellen worstelen in hoog-dimensionale ruimtes met beperkte data.
Gebruik technieken zoals correlatieanalyse, feature-importance-scores uit boommodellen of regularisatiemethoden die onbelangrijke features automatisch op nul zetten.
Het doel is het minimale aantal features vinden dat het signaal vangt zonder de ruis.
Veelvoorkomende misvattingen over de bias-variance trade-off
Ik ruim drie veelgemaakte fouten op die tot slechte modelleerbeslissingen leiden.
"Lagere bias is altijd beter"
Onjuist. Lagere bias betekent dat je model complexe patronen kan representeren, maar dat is alleen nuttig als die patronen daadwerkelijk in je data bestaan en generaliseren naar nieuwe voorbeelden.
Bias verlagen door complexiteit toe te voegen verhoogt vaak de variantie sneller dan de bias daalt. Je eindigt met een model dat trainingsdata perfect past, maar slechter presteert op testdata. Het doel is het minimaliseren van de totale fout, niet alleen van bias.
Soms presteert een eenvoudiger model met hogere bias overall beter, omdat het lage variantie heeft en goed generaliseert.
"Overfitting betekent dat het model slecht is"
Niet helemaal. Overfitting betekent dat je model te complex is voor de hoeveelheid data die je hebt, maar het model zelf is niet per se slecht.
Ditzelfde neurale netwerk dat overfit op 1.000 trainingsvoorbeelden kan uitstekend presteren op 100.000 voorbeelden. Het probleem is de mismatch tussen capaciteit en datagrootte.
Je kunt overfitting oplossen door meer data toe te voegen, de complexiteit te verlagen of regularisatie toe te passen. Je hoeft het model niet weg te gooien en helemaal opnieuw te beginnen met iets totaal anders.
"Meer data lost variantie altijd op"
Meer data verlaagt variantie, maar het elimineert het niet en er zitten grenzen aan hoeveel het helpt.
Als je model extreem complex is in verhouding tot je probleem, stabiliseren zelfs grote datasets het misschien niet genoeg. Een neuraal netwerk met miljoenen parameters heeft enorme hoeveelheden data nodig om goed te trainen.
Bovendien helpt meer data alleen als de nieuwe data dezelfde verdeling heeft als je testdata. Meer bevooroordeelde of lawaaierige data verzamelen verlaagt de variantie niet - het kan het zelfs erger maken door patronen te versterken die niet generaliseren.
Bias-variance trade-off vs. overfitting en underfitting
Bias-variance en overfitting-underfitting beschrijven dezelfde problemen vanuit verschillende invalshoeken, maar het zijn geen uitwisselbare termen.
Onthoud dit:
Bias en variantie zijn eigenschappen van je model.
Ze beschrijven hoe je model zich gedraagt over verschillende trainingssets. Je kunt bias meten door te kijken hoe ver de gemiddelde voorspellingen van je model van de waarheid afliggen. Je kunt variantie meten door te kijken hoeveel voorspellingen veranderen met andere trainingsdata.
Underfitting en overfitting zijn symptomen die je observeert.
Ze beschrijven wat er gebeurt wanneer je je model traint en test. Je ziet underfitting wanneer zowel de train- als testfout hoog zijn. Je ziet overfitting wanneer de trainingsfout laag is maar de testfout hoog.
De connectie is direct maar niet één-op-één. Hoge bias leidt meestal tot underfitting, en hoge variantie leidt meestal tot overfitting. Maar je kunt ook een model hebben met matige bias en matige variantie dat noch underfit noch overfit - het presteert gewoon slecht om andere redenen, zoals verkeerde features of onvoldoende datakwaliteit.
Praktische tips om modelprestaties te interpreteren
Hier zijn nog wat laatste tips om bias-variance-problemen te diagnosticeren en betere modelleerbeslissingen te nemen.
Kijk naar trainings- en validatiefouten samen, niet los
Alleen trainingsfout zegt niets over generalisatie. Een model met 1% trainingsfout kan 50% testfout hebben als het overfit.
Vergelijk de twee fouten om te begrijpen wat er gebeurt.
Optimaliseer niet alleen voor trainingsnauwkeurigheid
Perfecte trainingsnauwkeurigheid is een alarmsignaal. Het betekent meestal dat je de trainingsset hebt gememoriseerd zonder patronen te leren die generaliseren.
Focus in plaats daarvan op validatieprestaties. Je doel is de kloof tussen train- en validatiefout te minimaliseren terwijl je beide redelijk laag houdt.
Gebruik cross-validatie voor betrouwbare schattingen
Eén enkele train-test-split kan misleidend zijn, omdat het afhangt van welke voorbeelden in welke set terechtkomen. Eén ongelukkige split kan een goed model slecht doen lijken of een slecht model goed.
Cross-validatie middelen prestaties over meerdere splits, wat je een stabielere schatting geeft van hoe je model op nieuwe data zal presteren. Dit is extra belangrijk bij beperkte data of wanneer je hyperparameters afstemt.
Balans tussen eenvoud en flexibiliteit op basis van je datagrootte
Met kleine datasets kun je beter neigen naar simpelere modellen. Die zijn stabieler en hebben minder kans op overfitting als je niet veel voorbeelden hebt om van te leren.
Met grote datasets kun je je meer complexe modellen permitteren, omdat de extra data het leerproces stabiliseert en de variantie verlaagt. Maar voeg geen complexiteit toe omdat het kan - alleen als het de validatieprestaties verbetert.
Conclusie
Je kunt geen model bouwen met nul bias en nul variantie. Elke modelleerbeslissing die je neemt, verschuift het evenwicht tussen deze twee foutbronnen. Voeg complexiteit toe en je verlaagt bias maar verhoogt variantie. Vereenvoudig en je verlaagt variantie maar verhoogt bias.
Modelprestaties hangen af van het vinden van de juiste balans. Het beste model is het model dat de totale fout minimaliseert door bias en variantie in balans te brengen voor jouw specifieke probleem en dataset. Begrip van deze trade-off betekent dat je kunt diagnosticeren of je model last heeft van hoge bias of hoge variantie en de juiste oplossing toepassen.
Als je klaar bent om praktisch met machine learning aan de slag te gaan, schrijf je dan in voor onze Machine Learning Fundamentals in Python-track. Deze bevat 16 uur aan videomateriaal dat je helpt je eerste baan te bemachtigen.