Kurs
Dimensionsreduktion in Python
4 Std.
37.1K
Der Bias-Variance-Trade-off erklärt, warum Modellleistung nicht nur mit Komplexität oder Genauigkeit zu tun hat, sondern damit, den Sweet Spot zu finden: Ein Modell, das auf unbekannte Daten gut überträgt, ohne das Problem zu stark zu vereinfachen oder sich an den Trainingsdaten festzufahren.
In diesem Artikel erkläre ich, was Bias und Varianz im Machine Learning wirklich bedeuten, wie sie gegeneinander abgewogen werden und warum dieses Verständnis dir hilft, robustere Modelle zu bauen.
Wenn du neu im Machine Learning bist, hilft dir unser How to Learn Machine Learning in 2026 Artikel, in kürzester Zeit sattelfest zu werden.
Bias ist der Fehler, der durch zu einfache Annahmen über deine Daten entsteht. Er hat nichts mit Voreingenommenheit im gesellschaftlichen Sinn zu tun, zumindest nicht im Machine Learning.
Hat ein Modell hohen Bias, ist es zu starr, um die tatsächlichen Muster in deinen Daten zu erfassen. Stell dir vor, du willst eine Gerade durch Daten legen, die klar gekrümmt sind: Egal wie du die Linie drehst, sie wird die wahre Form nie treffen.
Das nennt man Underfitting.
Ein Modell mit hohem Bias vereinfacht das Problem übermäßig. Es unterstellt zu einfache Zusammenhänge und übersieht dadurch wichtige Muster, die für präzise Vorhersagen nötig wären.
Stell dir vor, du sagst Wohnungspreise anhand von Quadratmeterzahl, Anzahl der Zimmer, Lage und Baujahr voraus. Ein Modell mit hohem Bias würde vielleicht nur die Quadratmeterzahl nutzen und alles andere ignorieren. Es unterstellt, dass allein die Größe den Preis bestimmt – viel zu simpel.
Das Ergebnis ist ein Modell, das sowohl auf Trainings- als auch auf neuen Daten schlecht abschneidet, weil es die Komplexität echter Preise nicht erfasst.
Lineare Regression mit wenigen Merkmalen ist ein klassisches High-Bias-Modell. Entscheidungsbäume mit sehr geringer Tiefe neigen ebenfalls zu hohem Bias, weil sie die Daten nicht oft genug teilen können, um feine Muster zu finden.
Hoher Bias bedeutet, dein Modell lernt zu wenig aus den Daten und macht das Problem so einfach, dass keine gute Genauigkeit möglich ist.
Varianz misst, wie empfindlich dein Modell auf die konkreten Trainingsdaten reagiert.
Sie hat nichts mit der statistischen Streuung von Daten zu tun. Im Machine Learning beschreibt Varianz das Verhalten des Modells, nicht die Datenverteilung.
Bei hoher Varianz führen kleine Änderungen in den Trainingsdaten zu großen Änderungen in den Vorhersagen. Trainierst du dasselbe Modell auf zwei leicht unterschiedlichen Datensätzen, erhältst du stark abweichende Ergebnisse.
Das nennt man Overfitting.
Ein Modell mit hoher Varianz ist zu flexibel. Es lernt nicht nur die echten Muster, sondern auch Rauschen und Zufallsschwankungen, die auf neue Daten nicht übertragbar sind. Es merkt sich im Grunde die Trainingsbeispiele, statt die zugrunde liegenden Zusammenhänge zu lernen.
Bleiben wir bei Wohnungspreisen, jetzt mit einem komplexen Modell mit Hunderten Parametern. Es lernt vielleicht, dass Wohnungen in der Oak Street immer genau $427.350 kosten, weil das im Trainingsdatensatz so war.
Das Ergebnis: Top-Leistung auf Trainingsdaten, aber schwach auf neuen Daten, weil das Modell datensatzspezifische Eigenheiten gelernt hat.
Tiefe neuronale Netze und Entscheidungsbäume ohne Tiefenlimit sind klassische High-Variance-Modelle. Sie sind so flexibel, dass sie fast jedes Muster – auch sinnlose – abbilden können.
Hohe Varianz bedeutet, dein Modell lernt zu viel aus den Daten. Es passt das Rauschen gleich mit an und wird dadurch instabil und auf neuen Beispielen unzuverlässig.
Bias und Varianz sind zwei grundverschiedene Fehlerquellen. Verstehst du den Unterschied, findest du schneller heraus, was mit deinem Modell nicht stimmt.
So wirken sich Bias und Varianz auf den Vorhersagefehler aus:
Das Problem: Senkst du das eine, steigt meist das andere.
Machst du dein Modell komplexer, sinkt der Bias – aber die Flexibilität steigt und damit die Empfindlichkeit gegenüber Trainingsdaten, also die Varianz. Vereinfachst du das Modell, sinkt die Varianz – aber die Fähigkeit, komplexe Muster zu erfassen, nimmt ab und der Bias steigt.
Diese inverse Beziehung verhindert, beides gleichzeitig zu minimieren. Du musst die Balance finden, die den Gesamtfehler minimiert.
Der Bias-Variance-Trade-off beschreibt die Spannung zwischen diesen beiden Fehlerquellen – reduzierst du die eine, steigt fast immer die andere.
Stell es dir so vor: Du willst ein Ziel treffen, hast aber zwei gegenläufige Probleme. Du kannst sorgfältiger zielen (Bias reduzieren), wirst dann aber anfälliger für Wind und Zittern (Varianz steigt). Oder du nimmst eine einfachere, stabilere Haltung (Varianz senken), verlierst dafür an Präzision (Bias steigt).
Die Modellkomplexität steht im Zentrum dieses Trade-offs.
Bei einfachen Modellen mit wenigen Parametern hast du hohen Bias und niedrige Varianz. Das Modell trifft konsistente Annahmen und ändert sich wenig bei verschiedenen Trainingsdaten, kann aber komplexe Muster nicht erfassen.
Bei komplexen Modellen mit vielen Parametern hast du niedrigen Bias und hohe Varianz. Das Modell kann komplexe Beziehungen abbilden, wird aber instabil und übermäßig empfindlich gegenüber konkreten Trainingsbeispielen.
So lässt sich die Kurve dahinter begreifen:
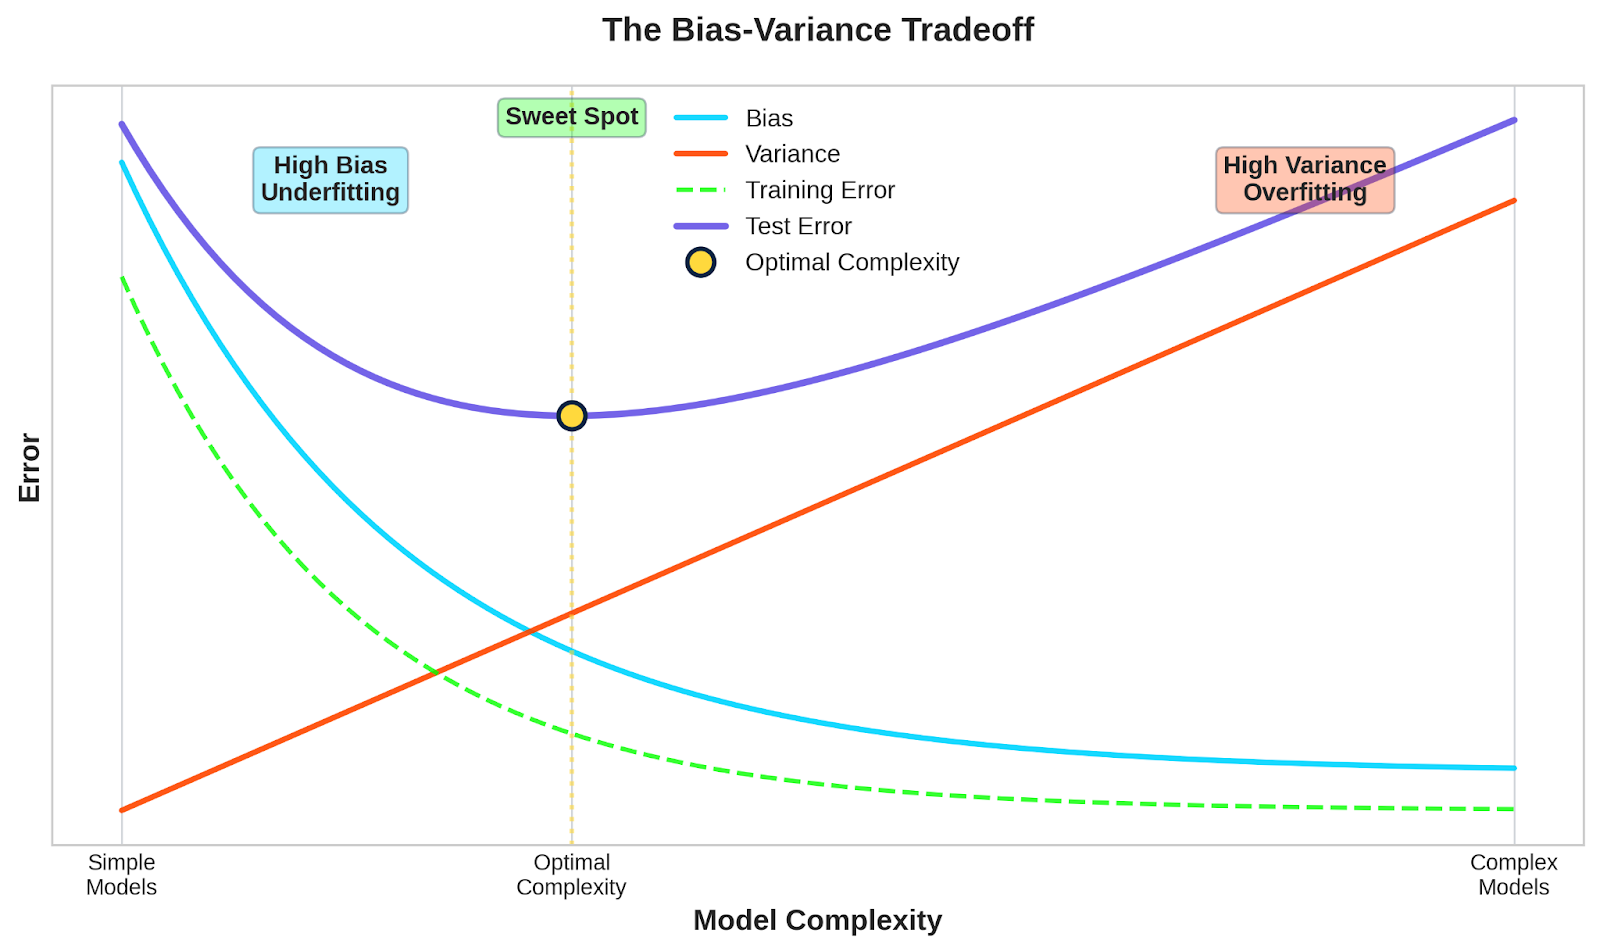
Bias-Variance-Trade-off-Kurve
Du suchst den Punkt, an dem beide Effekte zusammen den niedrigsten Testfehler ergeben.
Es gibt kein einziges „perfektes“ Modell für alle Probleme. Die optimale Balance hängt von deinen Daten, der Problemkomplexität und der Menge an Trainingsdaten ab. Mehr Daten erlauben in der Regel komplexere Modelle ohne Overfitting und verschieben den Sweet Spot nach rechts.
Machen wir das Konzept greifbar mit einem Szenario aus der Praxis, das zeigt, wie Bias und Varianz wirken.
Du baust ein Modell, das Mietpreise in einer Stadt vorhersagt. Du hast Merkmale wie Quadratmeter, Zimmer, Viertel, Entfernung zur U-Bahn, Baujahr und Ausstattung.
Du nutzt nur die Quadratmeterzahl, um den Preis mit einer einfachen linearen Regression zu schätzen.
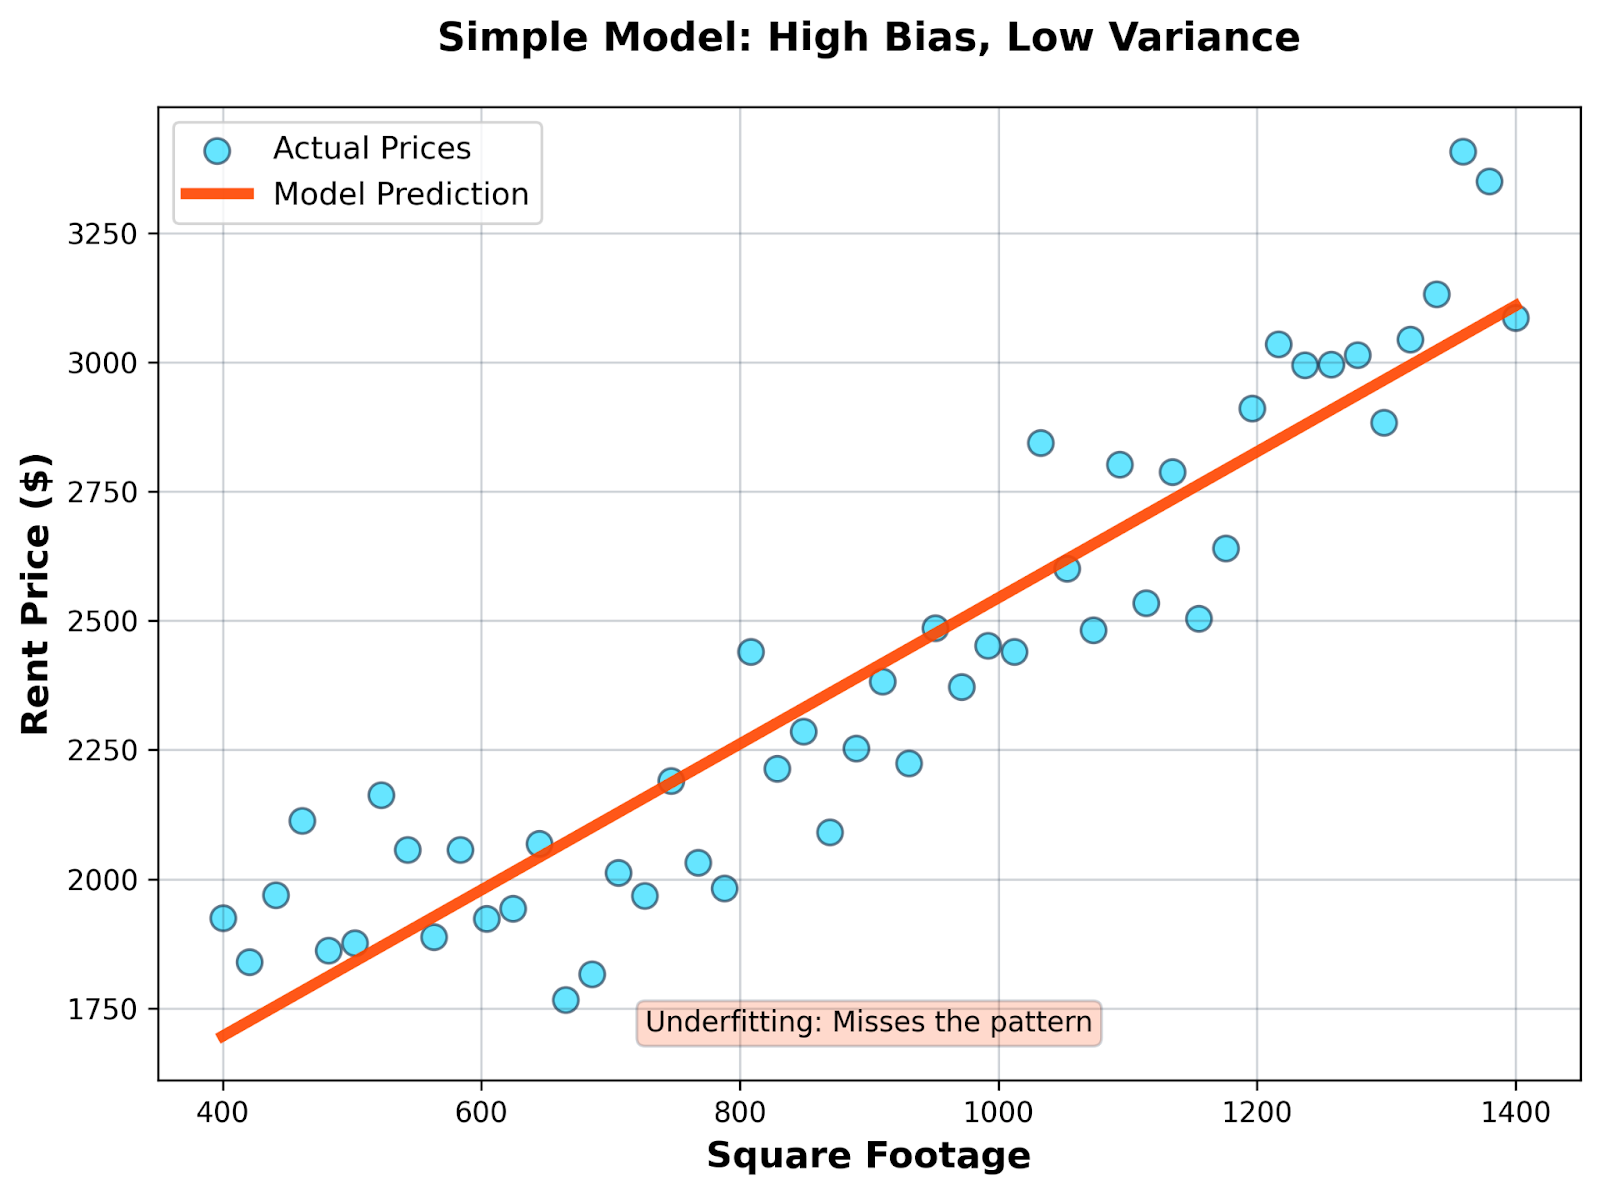
Einfaches Modell
Nun baust du ein tiefes neuronales Netz mit mehreren Hidden Layers und allen verfügbaren Features, plus konstruierten Merkmalen wie Kriminalitätsraten im Viertel, Walkability-Scores und Nähe zu Parks.
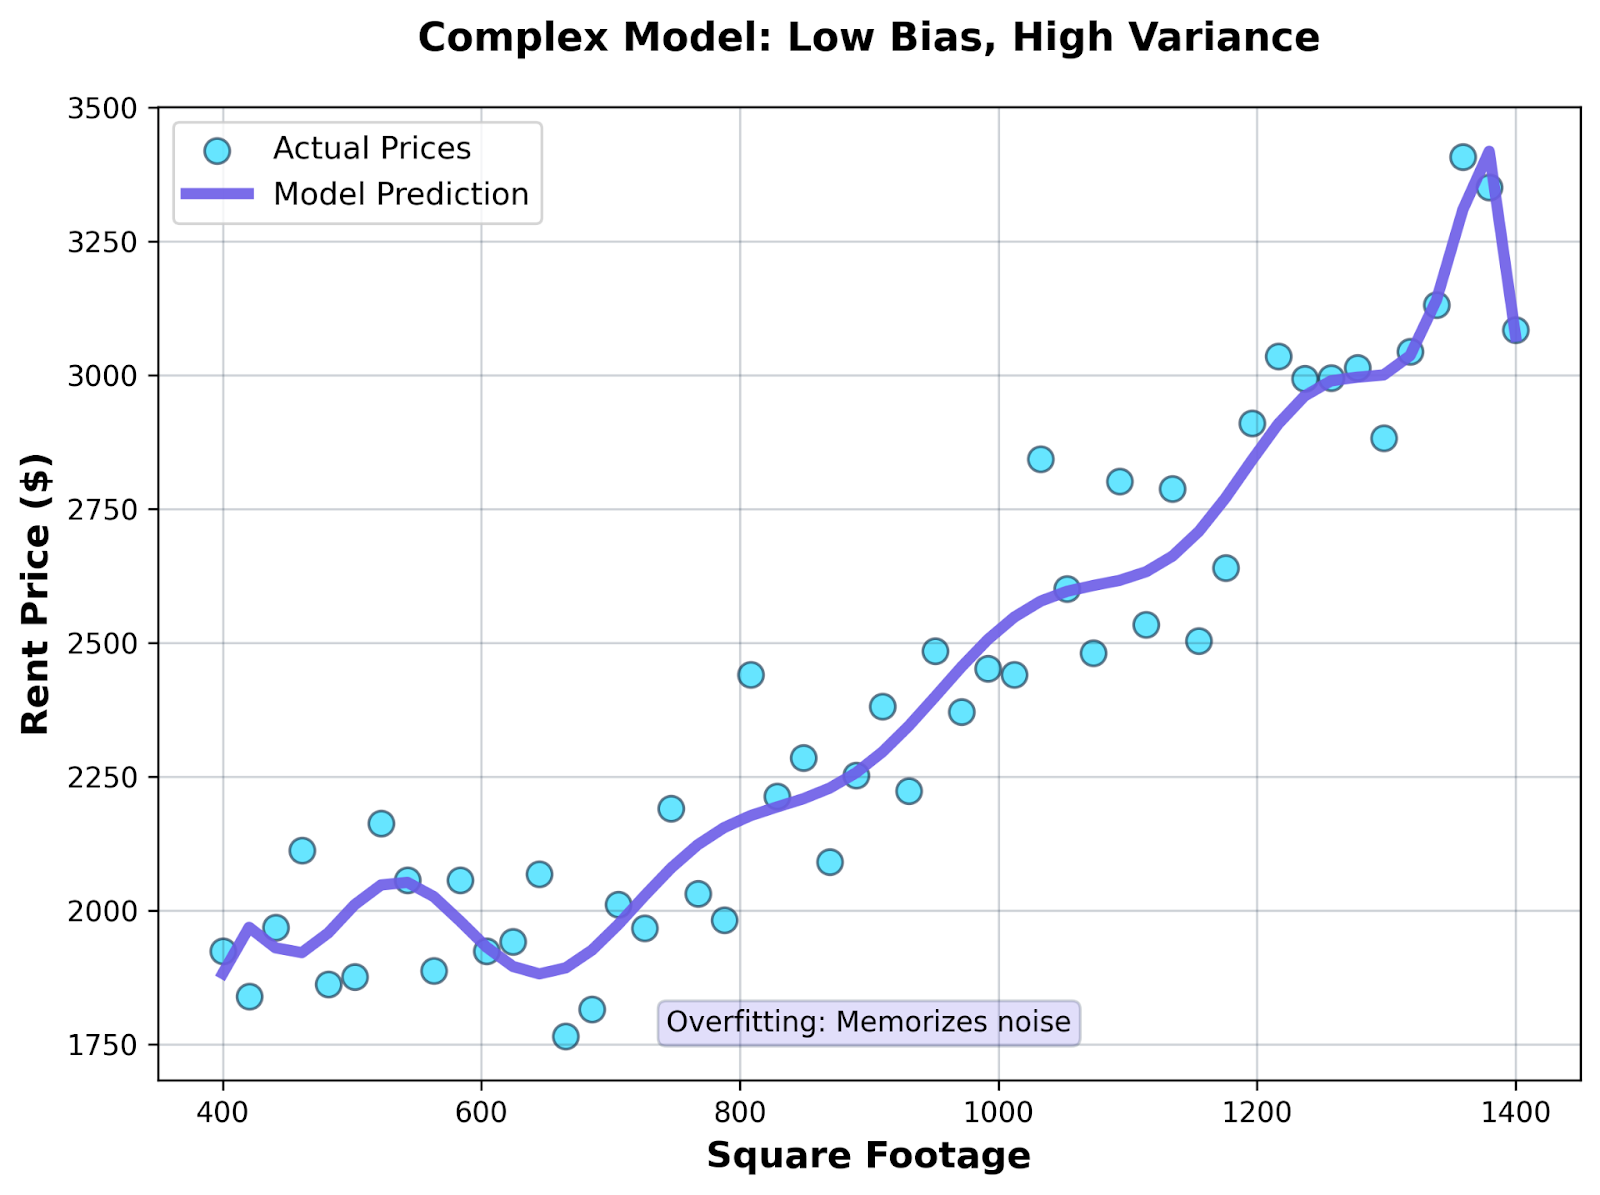
Komplexes Modell
Du nutzt eine regularisierte Regression (z. B. Ridge oder Lasso) mit einer gezielt ausgewählten Feature-Menge: Quadratmeter, Zimmer, Viertelkategorie und Entfernung zum ÖPNV.
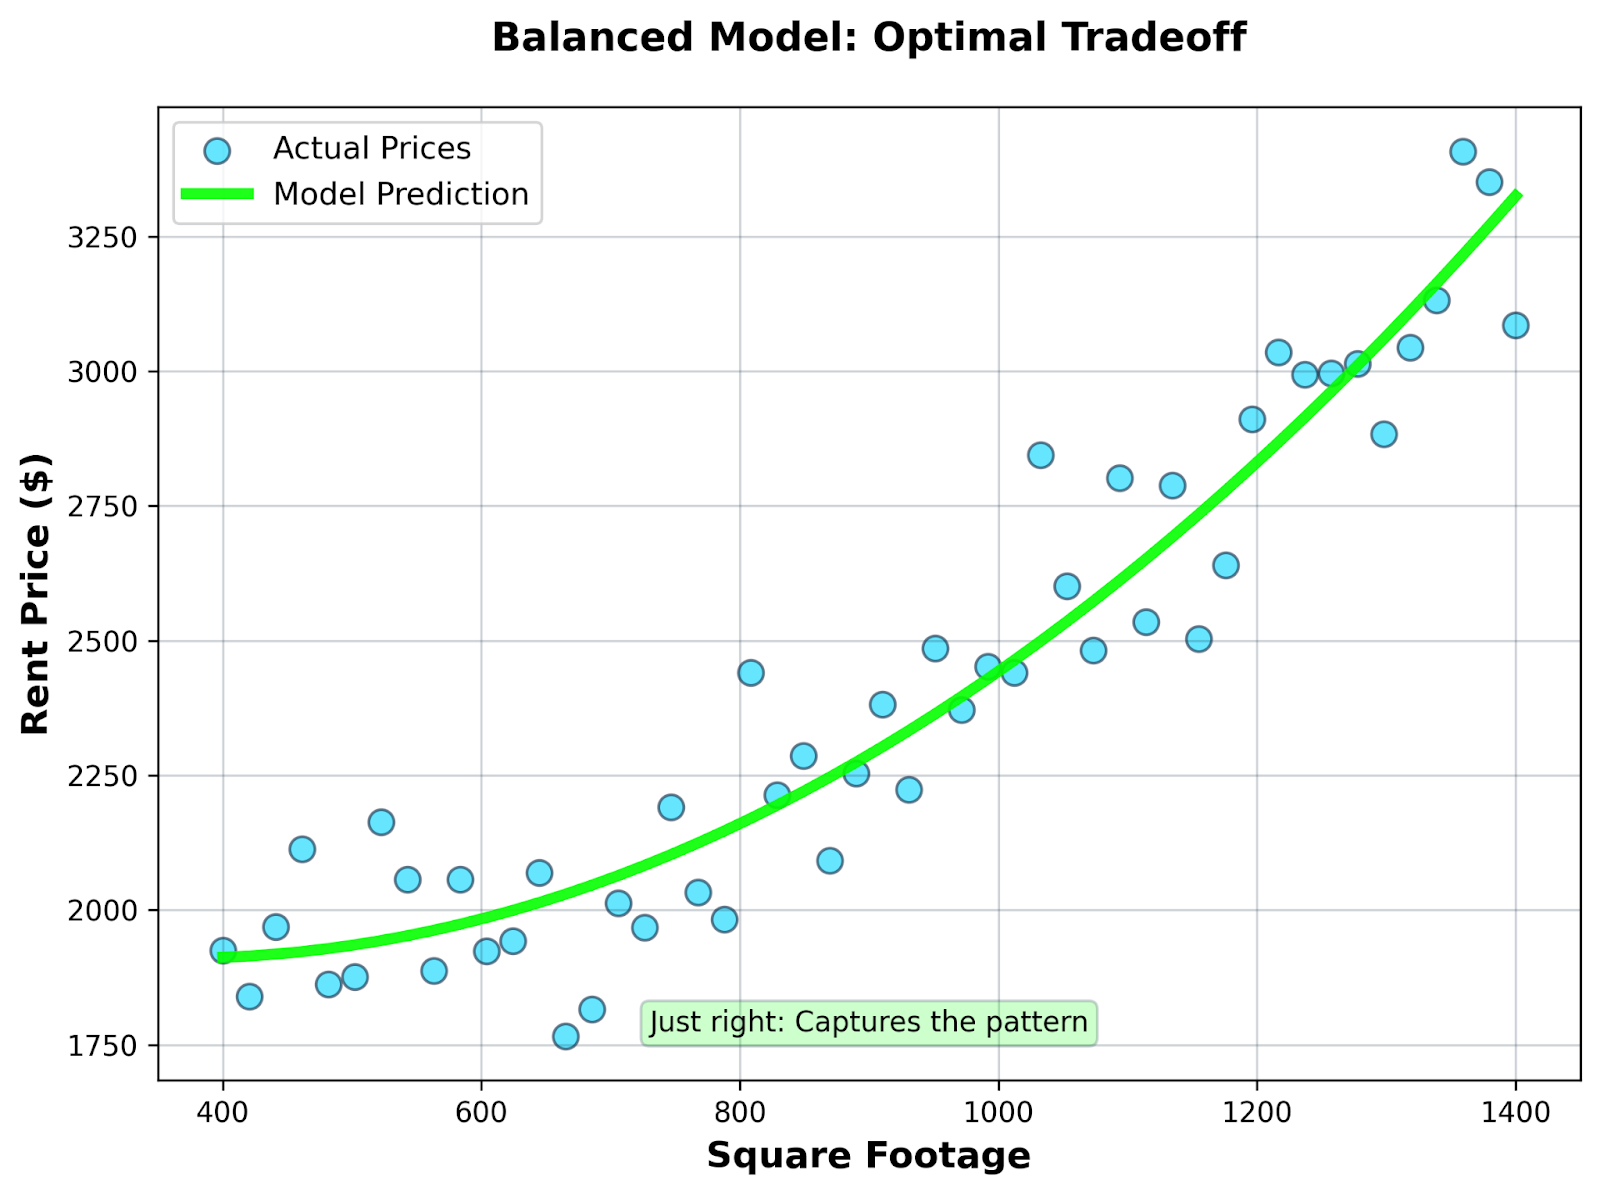
Ausgewogenes Modell
Das ausgewogene Modell passt die Trainingsdaten nicht perfekt an – und genau das ist der Punkt.
Verschiedene Algorithmen tendieren von Natur aus eher zu hohem Bias oder hoher Varianz. Diese Tendenzen solltest du kennen, um das richtige Werkzeug zu wählen.
Lineare Regression und logistische Regression liegen am High-Bias-Ende des Spektrums.
Diese Modelle unterstellen lineare Beziehungen – ändert sich ein Merkmal, ändert sich das Ergebnis um einen festen Betrag. Bei nichtlinearen Mustern, gekrümmten Beziehungen oder komplexen Interaktionen können lineare Modelle das nicht erfassen.
Der Vorteil ist Stabilität. Trainierst du ein lineares Modell auf verschiedenen Stichproben, erhältst du ähnliche Koeffizienten. Niedrige Varianz, aber möglicherweise hoher Bias, wenn die wahre Beziehung nicht linear ist.
Entscheidungsbäume verhalten sich je nach Konfiguration unterschiedlich.
Ein flacher Baum mit wenigen Splits wirkt wie ein einfaches Modell – hoher Bias, niedrige Varianz. Er verallgemeinert grob und verpasst feine Muster.
Ein tiefer Baum ohne Tiefenlimit wird extrem flexibel. Er splittet weiter, bis Blätter nur wenige Punkte enthalten – er merkt sich die Trainingsdaten. Niedriger Bias, aber sehr hohe Varianz – die Baumstruktur ändert sich stark mit anderen Trainingsstichproben.
Deshalb funktionieren Random Forests so gut: Viele Bäume werden gemittelt, das senkt die Varianz bei niedrigem Bias.
Bei KNN hängt die Balance komplett von deiner Wahl von k ab.
Ist k klein (z. B. k=1 oder k=3), ist die Varianz hoch. Vorhersagen basieren auf sehr wenigen Nachbarn und sind extrem empfindlich gegenüber den konkreten Trainingsbeispielen. Kleine Datenänderungen führen zu ganz anderen Vorhersagen.
Ist k groß (z. B. k=50 oder k=100), steigt der Bias. Es wird über so viele Nachbarn gemittelt, dass lokale Muster geglättet und wichtige Details verpasst werden.
Das optimale k liegt in der Mitte und balanciert die Extreme.
Neuronale Netze sind von Natur aus High-Variance-Modelle, weil sie sehr viele Parameter lernen.
Ein Netz mit mehreren Schichten und Hunderten Neuronen kann extrem komplexe Funktionen darstellen. Das bedeutet geringen Bias – fast jedes Muster ist lernbar. Aber auch hohe Varianz – die gelernten Gewichte hängen stark von Trainingsdaten, Initialisierung und Training ab.
Darum brauchen Netze große Datensätze. Mehr Daten stabilisieren das Lernen und senken die Varianz. Daher gibt es auch Techniken wie Dropout, Batch-Normalisierung und Early Stopping – alle zielen darauf, Varianz zu kontrollieren und Overfitting zu vermeiden.
Kleinere Netze mit weniger Schichten/Neuronen haben höheren Bias und niedrigere Varianz, größere Netze umgekehrt.
Leider ist Komplexität keine einzelne Zahl. Es geht darum, wie flexibel dein Modell verschiedene Muster abbilden kann.
Komplexität entsteht u. a. durch mehr Features, mehr Schichten in Netzen, tiefere Bäume, Polynomterme in Regressionsmodellen oder kleinere k-Werte bei KNN. Gemeinsam ist, dass sie dem Modell mehr Freiheit geben, komplexe Muster zu fitten.
Mit mehr Parametern erhöhst du die Möglichkeiten, Beziehungen darzustellen. Ein lineares Modell mit 3 Features kann nur eine Ebene legen. Mit Polynom- und Interaktionstermen kann es sich „biegen“ und komplexere Muster treffen. Die Annahmen werden weniger restriktiv – der Bias sinkt.
Diese Flexibilität hat einen Preis, nämlich steigende Varianz.
Mehr Parameter bedeuten mehr zu lernende Werte. Jeder Parameter wird auf deine Trainingsbeispiele abgestimmt und macht das Modell empfindlicher für die konkrete Stichprobe. Änderst du wenige Trainingspunkte, verschieben sich viele Parameter – das Modell wird instabil.
Darum ist der reine Trainingsfehler irreführend und gefährlich.
Mit steigender Komplexität sinkt der Trainingsfehler immer. Dein Modell passt die Trainingsdaten besser an, bis fast perfekte Genauigkeit erreicht ist. Das sieht gut aus, bis klar wird: Es lernt Rauschen statt Muster.
Der Fehler auf dem Testset zeigt dir die wahre Qualität deines Modells.
Anfangs sinkt der Testfehler mit steigender Komplexität, weil echte Muster erfasst werden. Ab einem Punkt steigt er, obwohl der Trainingsfehler weiter fällt. Das Modell überpasst – es lernt Eigenheiten des Trainingssets, die nicht generalisieren.
Ein kleiner Abstand zwischen Train- und Testfehler bedeutet gute Generalisierung. Ein großer Abstand bedeutet Overfitting – du solltest die Komplexität reduzieren oder mehr Daten hinzufügen.
Du kannst den Bias-Variance-Trade-off nicht eliminieren, aber mit den richtigen Techniken steuern. Hier sind ein paar Ansätze.
Bewerte dein Modell nie auf denselben Daten, auf denen du es trainiert hast.
Teile deine Daten vorab in Trainings- und Testmenge. Trainiere auf dem einen Teil, bewerte auf dem anderen. So erhältst du eine ehrliche Schätzung der Generalisierung.
Das Testset wirkt als Proxy für die Realwelt. Ist der Trainingsfehler niedrig, der Testfehler hoch, hast du Overfitting. Sind beide hoch, ist es Underfitting.
Train/Test-Splits hängen davon ab, welche Beispiele in welchen Teil fallen.
Cross-Validation löst das, indem mehrfach auf verschiedenen Splits trainiert und getestet wird. Gängig ist k-fold-CV: Daten in k Teile teilen, auf k-1 Teilen trainieren, auf dem verbleibenden testen, k-mal wiederholen.
So erhältst du zuverlässigere Leistungswerte und kannst Hyperparameter abstimmen, ohne dich auf ein einziges Testset zu überfitten.
Regularisierung fügt deiner Verlustfunktion direkt eine Strafe für Komplexität hinzu.
Methoden wie L1 (Lasso) und L2 (Ridge) dämpfen große Parameterwerte und zwingen das Modell, einfacher und stabiler zu bleiben. Das erhöht den Bias leicht, senkt aber die Varianz und verbessert oft die Testleistung.
Dropout in neuronalen Netzen wirkt ähnlich: Es schaltet während des Trainings zufällig Neuronen ab, damit sich das Netz nicht zu stark auf einzelne Parameter verlässt – Overfitting wird reduziert.
Mehr Trainingsdaten sind oft die beste Lösung bei hoher Varianz.
Mit mehr Beispielen sieht dein Modell eine breitere Palette möglicher Muster. Rauschen mittelt sich über viele Punkte heraus, die Varianz sinkt, ohne den niedrigen Bias eines komplexen Modells aufzugeben.
Aber: Mehr Daten sammeln ist nicht immer praktikabel oder möglich.
Wenn du auf wenig Daten festgelegt bist, setze auf Modellwahl: einfachere Modelle, Regularisierung oder Ensembles, die mehrere Modelle kombinieren, um Varianz zu reduzieren.
Nicht jedes Feature verbessert dein Modell. Manche bringen nur Rauschen ein.
Entferne irrelevante oder redundante Merkmale, um die Komplexität zu senken, ohne wichtige Muster zu verlieren. Weniger Features bedeuten weniger zu lernende Parameter und damit geringere Varianz. Du umgehst auch den Fluch der Dimensionalität bei wenigen Daten.
Nutze z. B. Korrelationsanalysen, Feature-Importance aus baumbasierten Modellen oder Regularisierung, die unwichtige Merkmale automatisch auf null setzt.
Ziel ist die minimale Feature-Menge, die das Signal ohne Rauschen trägt.
Hier sind drei typische Missverständnisse, die zu schlechten Modellentscheidungen führen.
Falsch. Niedriger Bias heißt, dein Modell kann komplexe Muster darstellen – das bringt nur etwas, wenn diese Muster tatsächlich existieren und auf neue Beispiele übertragen.
Bias durch mehr Komplexität zu reduzieren, lässt die Varianz oft schneller steigen, als der Bias fällt. Am Ende passt das Modell die Trainingsdaten perfekt an, performt aber schlechter auf Testdaten. Ziel ist die Minimierung des Gesamtfehlers, nicht nur des Bias.
Manchmal ist ein einfacheres Modell mit höherem Bias insgesamt besser, weil die Varianz niedrig genug ist, um gut zu generalisieren.
Nicht ganz. Overfitting bedeutet, dein Modell ist für die Datenmenge zu komplex, aber das Modell an sich ist nicht per se schlecht.
Dasselbe Netz, das bei 1.000 Beispielen überpasst, kann bei 100.000 Beispielen perfekt arbeiten. Das Problem ist das Missverhältnis zwischen Kapazität und Datenmenge.
Overfitting lässt sich mit mehr Daten, weniger Komplexität oder Regularisierung beheben. Du musst nicht alles verwerfen und komplett neu anfangen.
Mehr Daten senken die Varianz, aber sie beseitigen sie nicht und helfen nur bis zu einem gewissen Punkt.
Ist dein Modell extrem komplex für das Problem, können selbst große Datensätze es nicht ausreichend stabilisieren. Ein Netz mit Millionen Parametern braucht gewaltige Datenmengen.
Außerdem hilft mehr Datenmaterial nur, wenn es derselben Verteilung entspricht wie deine Testdaten. Mehr verzerrte oder rauschbehaftete Daten senken die Varianz nicht – sie können sie sogar durch falsche Muster verstärken.
Bias/Varianz und Overfitting/Underfitting beschreiben dieselben Probleme aus unterschiedlichen Blickwinkeln, sind aber keine Synonyme.
Merke dir Folgendes:
Bias und Varianz sind Eigenschaften deines Modells.
Du misst Bias, indem du schaust, wie weit die durchschnittlichen Vorhersagen von der Wahrheit entfernt sind. Varianz misst du daran, wie stark sich Vorhersagen bei anderen Trainingsdaten ändern.
Underfitting und Overfitting sind beobachtbare Symptome.
Du erkennst Underfitting, wenn Trainings- und Testfehler hoch sind. Overfitting siehst du, wenn der Trainingsfehler niedrig, der Testfehler hoch ist.
Der Zusammenhang ist direkt, aber nicht 1:1. Hoher Bias führt meist zu Underfitting, hohe Varianz zu Overfitting. Es kann aber auch mittleren Bias und mittlere Varianz geben, ohne dass über- oder unterpasst wird – dann liegt die Schwäche z. B. an falschen Features oder schlechter Datenqualität.
Zum Schluss ein paar Tipps, wie du Bias-Variance-Probleme diagnostizierst und bessere Modellentscheidungen triffst.
Der Trainingsfehler allein sagt nichts über Generalisierung. Ein Modell mit 1% Trainingsfehler kann 50% Testfehler haben, wenn es überpasst.
Vergleiche beide, um zu verstehen, was los ist.
Perfekte Trainingsgenauigkeit ist ein Warnsignal. Meist heißt das: Trainingsset auswendig gelernt, ohne generalisierbare Muster.
Fokussiere dich auf die Validierungsleistung. Ziel ist, die Lücke zwischen Training und Validierung klein zu halten und beide Fehler möglichst niedrig.
Ein einzelner Train-Test-Split kann täuschen, je nach Verteilung der Beispiele. Ein unglücklicher Split lässt ein gutes Modell schlecht aussehen – oder umgekehrt.
Cross-Validation mittelt die Performance über mehrere Splits und liefert eine stabilere Schätzung für neue Daten. Das ist besonders wichtig bei wenig Daten oder beim Tuning von Hyperparametern.
Bei kleinen Datensätzen lieber einfachere Modelle. Sie sind stabiler und überpassen seltener, wenn wenige Beispiele vorliegen.
Bei großen Datensätzen kannst du komplexer werden, weil mehr Daten das Lernen stabilisieren und Varianz senken. Aber erhöhe die Komplexität nur, wenn die Validierungsleistung davon profitiert.
Ein Modell mit null Bias und null Varianz gibt es nicht. Jede Modellentscheidung verschiebt die Balance zwischen diesen beiden Fehlerquellen. Mehr Komplexität senkt den Bias und erhöht die Varianz. Vereinfachen senkt die Varianz und erhöht den Bias.
Die Performance hängt davon ab, die richtige Balance zu finden. Das beste Modell ist das, das den Gesamtfehler minimiert, indem es Bias und Varianz für dein konkretes Problem und deinen Datensatz ausgleicht. Verstehst du diesen Trade-off, kannst du erkennen, ob dein Modell unter hohem Bias oder hoher Varianz leidet – und gezielt gegensteuern.
Wenn du bereit für praktische Machine-Learning-Erfahrung bist, melde dich für unseren Machine Learning Fundamentals in Python Lernpfad an. Dich erwarten 16 Stunden Video-Material, das dir den Einstieg in deinen ersten Job erleichtert.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Blog
Blog
Matt Crabtree
14 Min.
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Josef Waples
3 Min.
Tutorial
Matt Crabtree
5 Min.


