Il compromesso bias-varianza spiega perché le prestazioni di un modello non dipendono solo da complessità o accuratezza, ma dal trovare il punto di equilibrio in cui il tuo modello generalizza bene a dati mai visti senza semplificare troppo il problema o andare in overfitting sul training set.
In questo articolo, ti spiego cosa significano davvero bias e varianza nel machine learning, come si bilanciano tra loro e perché comprendere questo compromesso ti aiuta a costruire modelli più robusti.
Se sei alle prime armi con il machine learning, il nostro How to Learn Machine Learning in 2026 ti aiuterà a diventare operativo in poco tempo.
Che cos'è il bias?
Il bias è l'errore che deriva dal fare assunzioni troppo semplicistiche sui tuoi dati. Non ha nulla a che vedere con i pregiudizi, almeno non nel contesto del machine learning.
Quando un modello ha alto bias, significa che è troppo rigido per catturare i pattern reali nei tuoi dati. È come provare a fittare una linea retta su dati che chiaramente curvano: per quanto tu la aggiusti, non seguirà mai la forma reale.
Questo si chiama underfitting.
Un modello con alto bias semplifica eccessivamente il problema. Presume che le relazioni siano più semplici di quanto siano in realtà, perdendo pattern importanti che aiuterebbero a fare previsioni accurate.
Immagina di prevedere i prezzi delle case in base ai metri quadrati, al numero di camere, alla posizione e all'età dell'immobile. Un modello con alto bias potrebbe usare solo i metri quadrati e ignorare tutto il resto. Suppone che la sola superficie determini il prezzo, il che è fin troppo semplice.
Il risultato è un modello che va male sia sui dati di training sia su quelli nuovi, perché non riesce a cogliere la complessità dei prezzi reali delle case.
La regressione lineare con poche feature è un classico modello ad alto bias. Anche gli alberi decisionali con profondità molto limitata tendono ad avere alto bias perché non possono dividere i dati abbastanza volte da trovare pattern sfumati.
Alto bias significa che il tuo modello non sta imparando abbastanza dai dati, ma sta rendendo il problema troppo semplice per essere risolto con buona accuratezza.
Che cos'è la varianza?
La varianza misura quanto il tuo modello è sensibile ai dati di training specifici che utilizzi.
Non ha nulla a che vedere con la misura statistica della dispersione dei dati. Nel machine learning, la varianza descrive il comportamento del modello, non la distribuzione dei dati.
Quando un modello ha alta varianza, piccole variazioni nei dati di training portano a grandi cambiamenti nelle sue previsioni. In altre parole, se alleni lo stesso modello su due dataset leggermente diversi, otterrai risultati molto diversi.
Questo si chiama overfitting.
Un modello con alta varianza è troppo flessibile. Impara non solo i pattern reali nei tuoi dati, ma anche il rumore e le fluttuazioni casuali che non generalizzano ai dati nuovi. In pratica, memorizza gli esempi di training invece di apprendere le relazioni sottostanti.
Immagina di prevedere ancora i prezzi delle case, ma ora con un modello complesso con centinaia di parametri. Potrebbe imparare che le case su Oak Street si vendono sempre esattamente a $427.350 perché così è successo nel tuo training set.
Il risultato è un modello che va benissimo sui dati di training ma malissimo su quelli nuovi, perché ha imparato particolarità specifiche del training set.
Le reti neurali profonde e gli alberi decisionali con profondità illimitata sono classici modelli ad alta varianza. Hanno abbastanza flessibilità da fittare quasi qualsiasi pattern, inclusi quelli privi di significato.
Alta varianza significa che il tuo modello sta imparando troppo dai dati. Sta fittando il rumore insieme al segnale, diventando instabile e inaffidabile su nuovi esempi.
Bias vs. Varianza: differenze chiave
Bias e varianza sono due fonti di errore di previsione completamente diverse. Una volta capita la distinzione, saprai diagnosticare più velocemente cosa non va nel tuo modello.
- Il bias deriva dalle assunzioni del tuo modello. Riguarda l'algoritmo che hai scelto, le feature incluse e come hai strutturato il problema. Un modello di regressione lineare assume relazioni lineari, quindi ha bias quando la relazione reale è non lineare. Questo errore esiste prima ancora di guardare i dati di training.
- La varianza deriva dalla sensibilità ai dati di training. Riguarda quanto il tuo modello cambia quando lo alleni su campioni diversi della stessa popolazione. Un modello con alta varianza apprende pattern diversi da set di training leggermente diversi, rendendo instabili le sue previsioni.
Ecco come bias e varianza influenzano l'errore di previsione:
- Alto bias significa che il tuo modello commette errori coerenti nella stessa direzione. Sottostima o sovrastima sempre certi pattern perché non riesce a rappresentare la relazione vera. Gli errori sono sistematici e prevedibili.
- Alta varianza significa che il tuo modello commette errori incoerenti che cambiano con i dati. Lo alleni con i dati di lunedì e predice una cosa. Con quelli di martedì e predice tutt'altro. Gli errori sono casuali e imprevedibili.
Il problema è che ridurre l'uno di solito aumenta l'altra.
Quando rendi il modello più complesso per ridurre il bias, ne aumenti la flessibilità. Questa flessibilità lo rende più sensibile ai dati di training, aumentando la varianza. Quando lo semplifichi per ridurre la varianza, gli togli la capacità di catturare pattern complessi, aumentando il bias.
Questa relazione inversa spiega perché non puoi minimizzare entrambi contemporaneamente. Devi invece trovare l'equilibrio che ti dà l'errore totale più basso.
Che cos'è il compromesso bias-varianza?
Il compromesso bias-varianza descrive la tensione tra queste due fonti di errore: quando ne diminuisci una, quasi sempre aumenti l'altra.
Pensala così: stai cercando di colpire un bersaglio, ma hai due problemi che agiscono in direzioni opposte. Puoi mirare più accuratamente (ridurre il bias), ma questo ti rende più sensibile al vento e al tremolio delle mani (aumentare la varianza). Oppure puoi usare una posizione di tiro più semplice e stabile (ridurre la varianza), ma questo limita la tua precisione (aumentare il bias).
La complessità del modello è al centro di questo compromesso.
Con un modello semplice con pochi parametri ottieni alto bias e bassa varianza. Il modello fa assunzioni coerenti e cambia poco con dati di training diversi, ma non riesce a catturare pattern complessi.
Con un modello complesso con molti parametri ottieni basso bias e alta varianza. Il modello può rappresentare relazioni intricate, ma diventa instabile e troppo sensibile agli esempi specifici su cui lo alleni.
Ecco la curva concettuale che lo spiega:
- A sinistra (modelli semplici): l'errore di training è alto perché il modello è in underfitting. L'errore di test è anch'esso alto perché il modello perde pattern reali.
- Al centro (modelli bilanciati): sia l'errore di training sia quello di test sono bassi. Il modello cattura i pattern reali senza memorizzare il rumore. Questo è il tuo sweet spot.
- A destra (modelli complessi): l'errore di training è molto basso perché il modello fitta tutto. L'errore di test è alto perché il modello ha imparato il rumore.
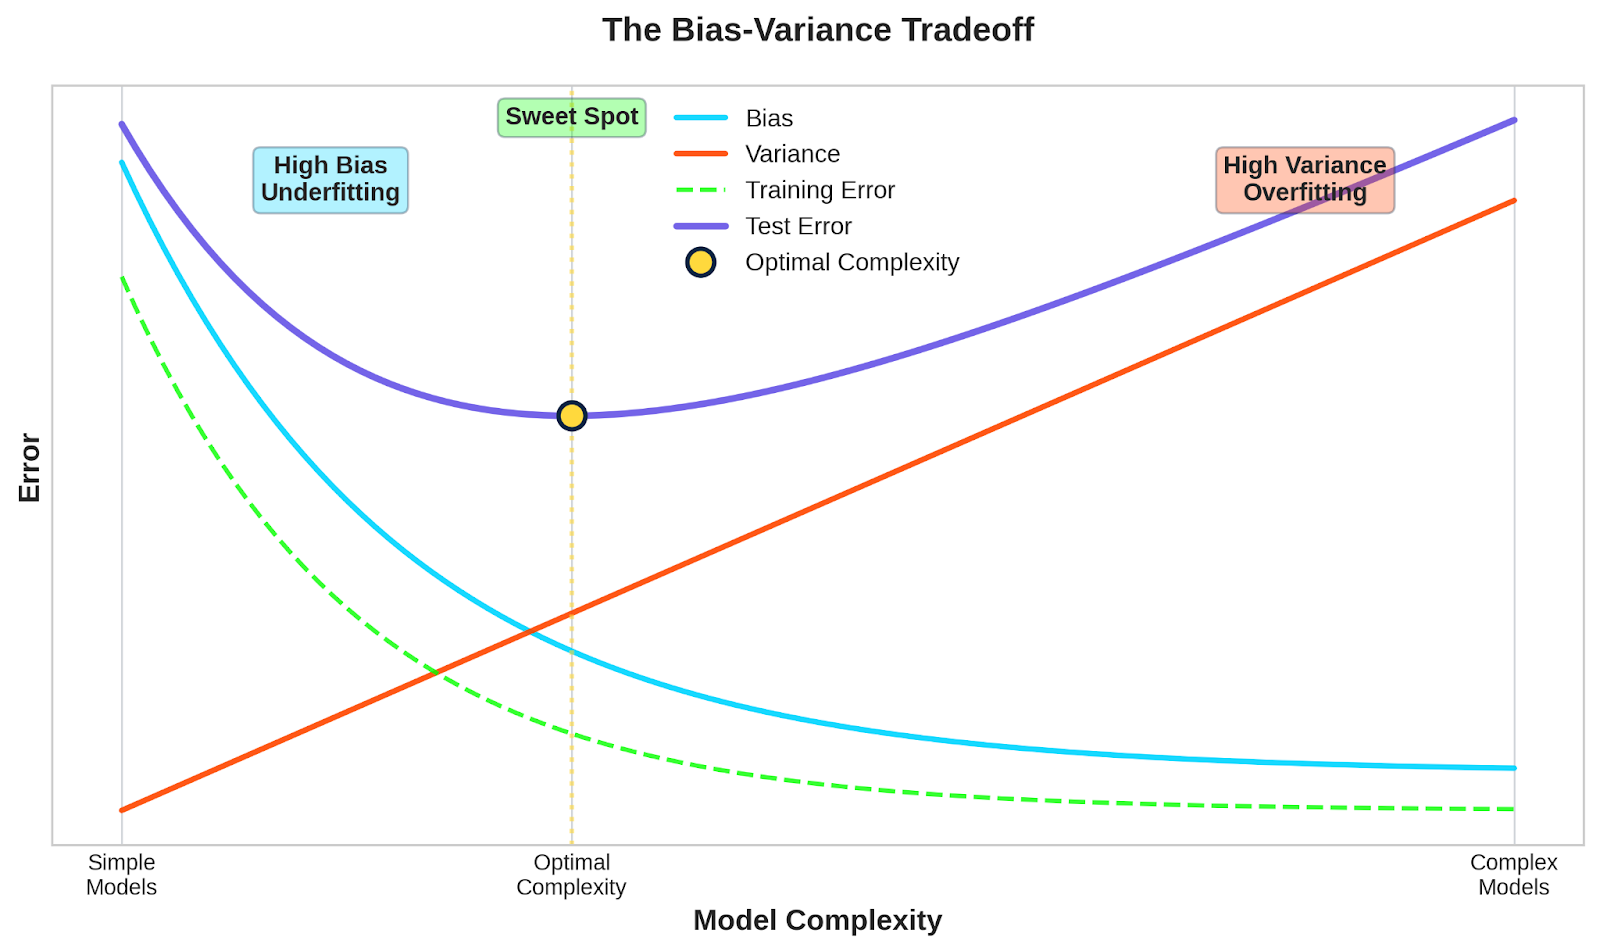
Curva del compromesso bias-varianza
Stai cercando il punto in cui il loro effetto combinato ti dà l'errore di test più basso.
Non esiste un singolo modello "perfetto" che funzioni per ogni problema. L'equilibrio ottimale dipende dai tuoi dati, dalla complessità del problema e da quanta base di training hai. Più dati in genere ti consentono di usare modelli più complessi senza overfitting, spostando lo sweet spot verso destra.
Un semplice esempio di compromesso bias-varianza
Rendo il concetto concreto con uno scenario reale che mostra come bias e varianza si manifestano nella pratica.
Immagina di costruire un modello per prevedere i canoni d'affitto degli appartamenti in una città. Hai feature come metri quadrati, numero di camere, quartiere, distanza dalla metro, età dell'edificio e servizi.
Modello semplice: regressione lineare con una feature
Decidi di usare solo i metri quadrati per prevedere il prezzo con una regressione lineare semplice.
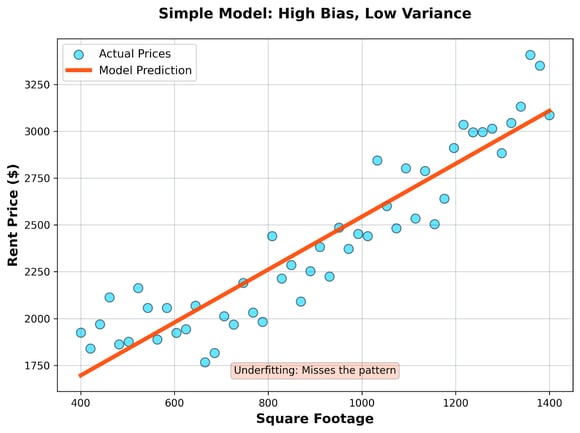
Modello semplice
- Cosa succede: Il modello traccia una linea retta tra i punti. Predice che ogni 100 piedi quadrati aggiungano un importo fisso all'affitto, indipendentemente dalla posizione o da altri fattori.
- Risultato: Questo modello ha alto bias e bassa varianza. Sottostima sistematicamente gli appartamenti di lusso e sovrastima i monolocali perché non cattura la relazione complessa tra dimensione e prezzo nei diversi quartieri. Ma se lo alleni su campioni diversi di appartamenti, otterrai più o meno la stessa linea ogni volta: è stabile ma impreciso.
Modello complesso: rete neurale profonda con tutte le feature
Ora costruisci una rete neurale profonda con più layer nascosti usando tutte le feature disponibili, più feature ingegnerizzate come tassi di criminalità del quartiere, indici di camminabilità e vicinanza ai parchi.
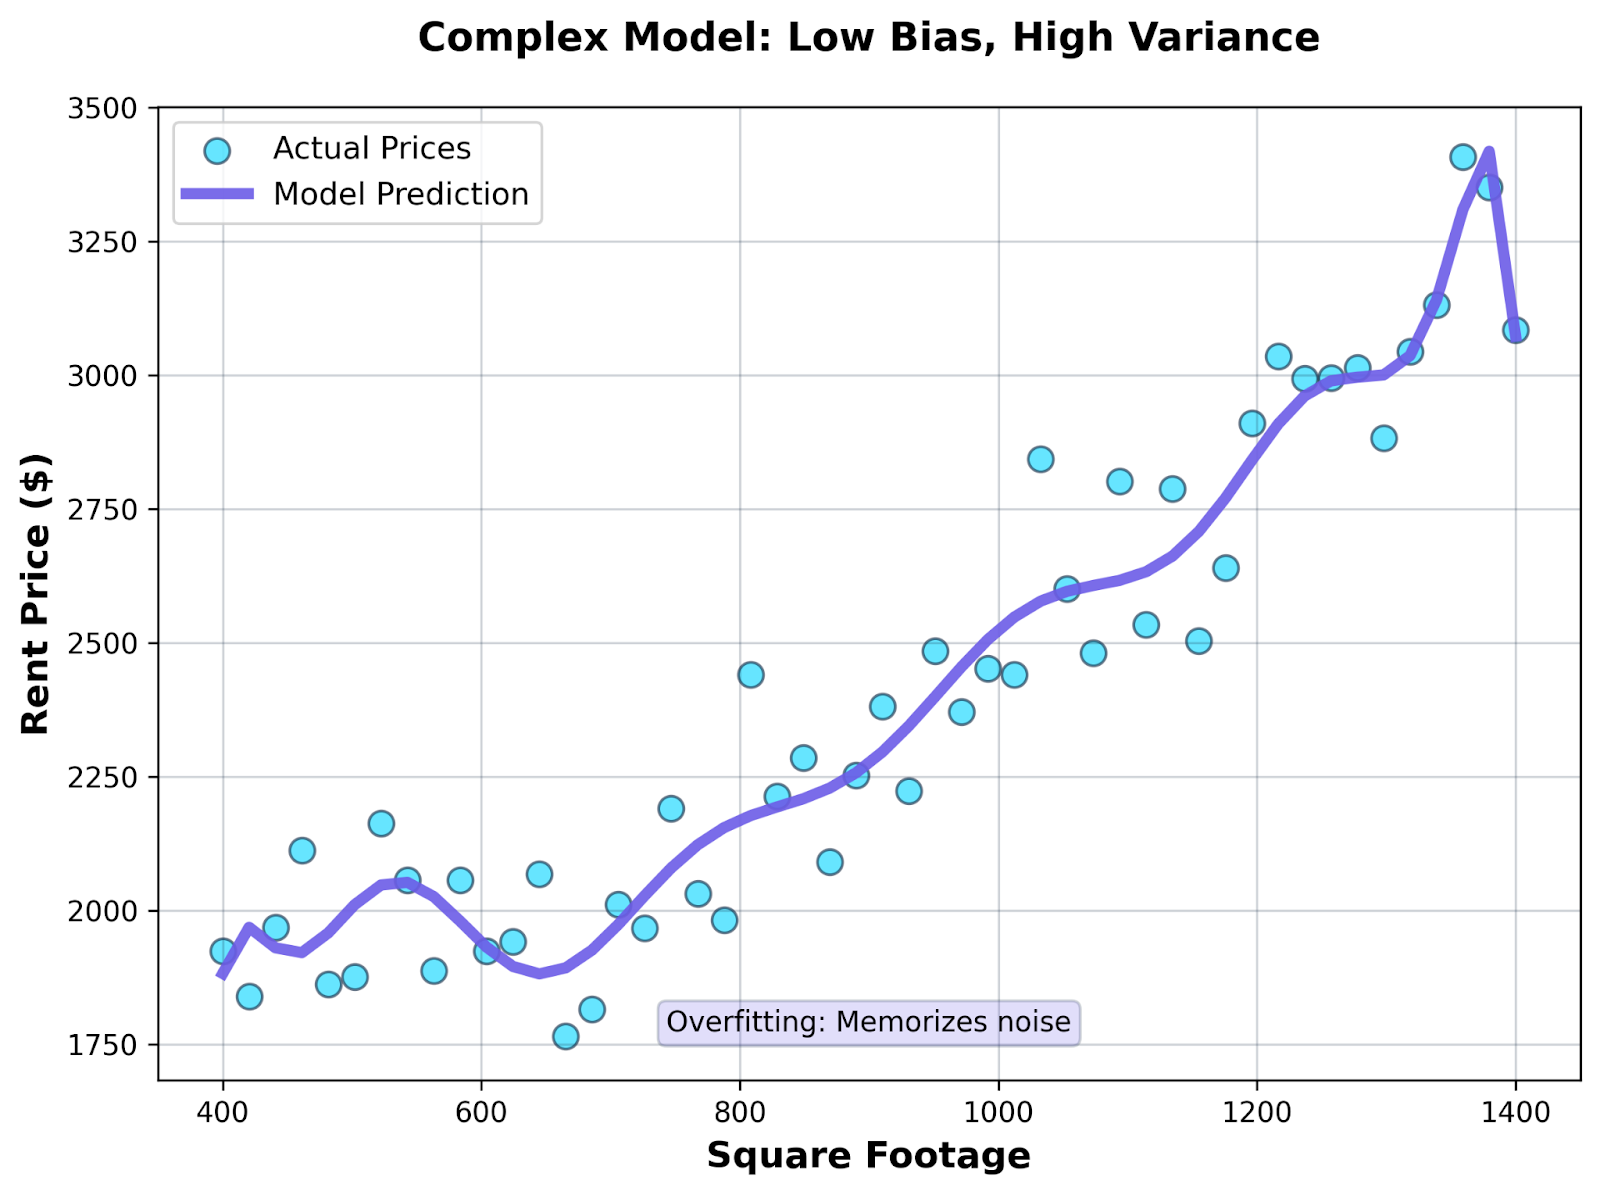
Modello complesso
- Cosa succede: La rete apprende pattern intricati. Potrebbe scoprire che gli appartamenti al 5° piano nei tuoi dati di training si affittano sempre esattamente a $2.847, o che le unità esposte a nord su Oak Street costano il 37% in più di quelle esposte a sud.
- Risultato: Questo modello ha basso bias e alta varianza. Fitta quasi perfettamente i dati di training e cattura ogni dettaglio e fluttuazione. Ma quei pattern non generalizzano: sono artefatti del tuo campione specifico. Se lo alleni su un set diverso di appartamenti, apprende pattern completamente diversi. Le previsioni sono instabili e inaffidabili sui dati nuovi.
Modello bilanciato: regressione regolarizzata con feature chiave
Usi una regressione regolarizzata (come Ridge o Lasso) con un sottoinsieme selezionato con cura di feature: metri quadrati, camere, categoria del quartiere e distanza dai mezzi.
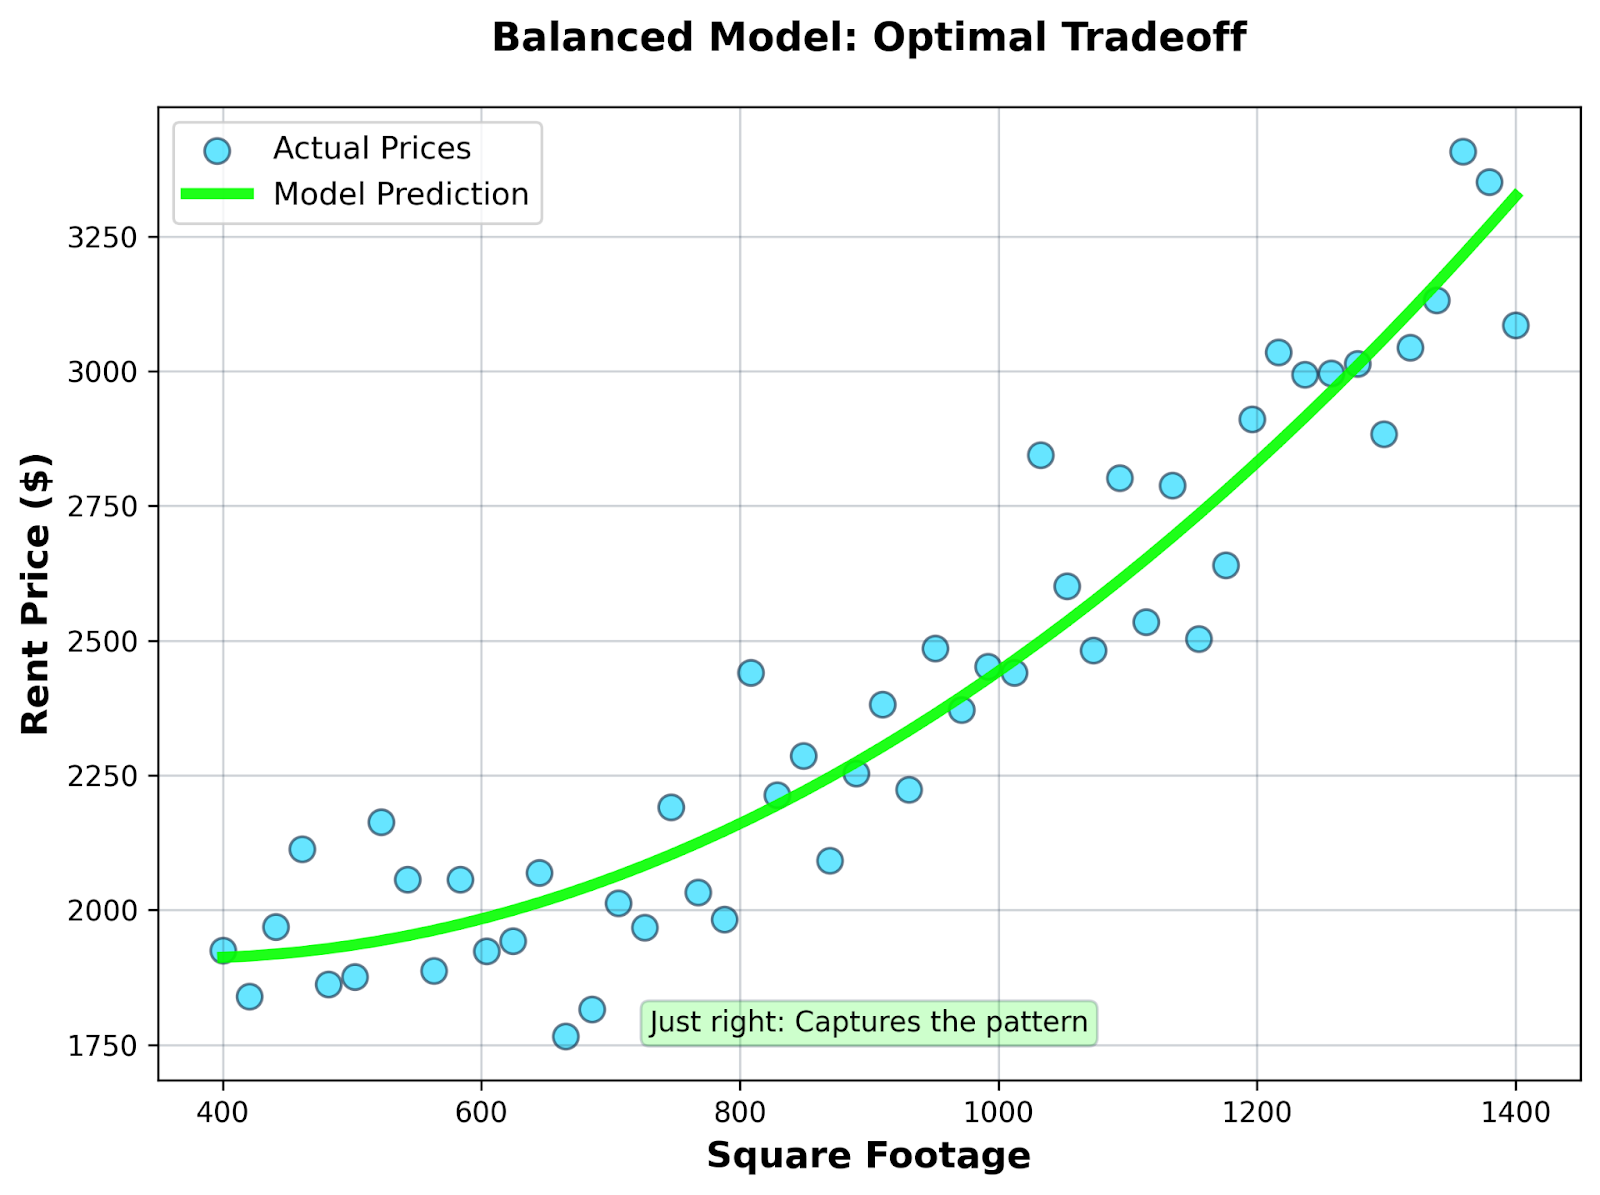
Modello bilanciato
- Cosa succede: Il modello cattura le relazioni principali senza memorizzare il rumore. Impara che dimensione e posizione contano, ma non si fissa su ogni minuscola fluttuazione nei dati di training.
- Risultato: Questo modello bilancia bias e varianza. È abbastanza flessibile da catturare pattern reali ma abbastanza vincolato da evitare l'overfitting. L'errore di training è moderato, ma l'errore di test è basso, che è ciò che conta davvero per prevedere nuovi appartamenti.
Il modello bilanciato non fitterà perfettamente i tuoi dati di training, ed è proprio questo il punto.
Compromesso bias-varianza nei modelli di machine learning
Algoritmi di machine learning diversi tendono naturalmente verso alto bias o alta varianza. Devi conoscere queste tendenze per scegliere lo strumento giusto per il tuo problema.
Modelli lineari
La regressione lineare e la regressione logistica si collocano dal lato dell'alto bias.
Questi modelli assumono relazioni lineari: una feature cambia e l'output cambia di una quantità fissa. Quando i tuoi dati hanno pattern non lineari, relazioni curve o interazioni complesse tra feature, i modelli lineari non riescono a catturarli.
Il lato positivo è la stabilità. Allena un modello lineare su campioni diversi dei tuoi dati e otterrai coefficienti simili ogni volta. Bassa varianza, ma potenzialmente alto bias se la relazione reale non è lineare.
Alberi decisionali
Gli alberi decisionali possono comportarsi in modo diverso a seconda di come li configuri.
Un albero poco profondo con pochi split si comporta come un modello semplice: alto bias, bassa varianza. Fa generalizzazioni ampie e non cattura pattern di dettaglio.
Un albero profondo senza limite di profondità diventa estremamente flessibile. Continua a dividere finché ogni foglia contiene pochi punti, cioè memorizza i dati di training. Basso bias, ma varianza altissima: la struttura dell'albero cambia drasticamente con campioni di training diversi.
Ecco perché le random forest funzionano così bene. Mediano le previsioni di molti alberi, riducendo il problema della varianza mantenendo basso il bias.
K-nearest neighbors
Il bilanciamento bias-varianza di KNN dipende interamente dalla scelta di k.
Quando k è piccolo (tipo k=1 o k=3), il modello ha alta varianza. Basa le previsioni su pochi punti vicini, quindi è estremamente sensibile agli esempi specifici presenti nel training set. Piccoli cambiamenti nei dati di training portano a previsioni completamente diverse.
Quando k è grande (tipo k=50 o k=100), il modello ha alto bias. Media su così tanti vicini da appiattire i pattern locali e perdere dettagli importanti nei dati.
Il valore ottimale di k è da qualche parte nel mezzo, bilanciando questi due estremi.
Reti neurali
Le reti neurali sono naturalmente modelli ad alta varianza perché hanno tantissimi parametri da apprendere.
Una rete con più layer e centinaia di neuroni può rappresentare funzioni incredibilmente complesse. Questa flessibilità significa basso bias: la rete può imparare quasi qualsiasi pattern. Ma significa anche alta varianza: i pesi appresi dipendono molto dai dati di training specifici, dall'inizializzazione e dal processo di training.
Ecco perché le reti neurali necessitano di dataset grandi per funzionare bene. Più dati di training aiutano a stabilizzare l'apprendimento e riducono la varianza. È anche il motivo per cui esistono tecniche come dropout, batch normalization ed early stopping: sono tutte progettate per controllare la varianza e prevenire l'overfitting.
Reti più piccole con meno layer e neuroni hanno bias più alto ma varianza più bassa, mentre reti più grandi hanno bias più basso ma varianza più alta.
Come la complessità del modello influisce su bias e varianza
Purtroppo, la complessità del modello non è un singolo numero che puoi misurare. Riguarda quanto il tuo modello è flessibile nell'adattarsi a pattern diversi.
La complessità deriva da più fattori, come più feature, più layer in una rete neurale, alberi decisionali più profondi, termini polinomiali nella regressione o valori di k più bassi in KNN. Il filo conduttore è che danno al modello più libertà di fittare pattern intricati nei dati.
Quando aggiungi parametri, dai al tuo modello più modi per rappresentare le relazioni nei dati. Un modello lineare con 3 feature può solo tracciare un piano piatto attraverso i dati. Se aggiungi termini polinomiali e interazioni, può piegarsi e curvare per seguire pattern più complessi. Le assunzioni del modello diventano meno restrittive, quindi il bias diminuisce.
Ma questa flessibilità ha un costo, cioè un aumento della varianza.
Più parametri significano più valori da apprendere dai dati di training. Ogni parametro viene tarato per adattarsi ai tuoi esempi specifici, rendendo il modello più sensibile a quali esempi hai incluso. Quando cambi alcuni campioni di training, tutti quei parametri si spostano per accomodare i nuovi dati. Il modello diventa instabile.
Ecco perché l'errore di training da solo è fuorviante e pericoloso.
All'aumentare della complessità, l'errore di training diminuirà sempre. Il modello fitta sempre meglio i dati di training, arrivando infine a un'accuratezza quasi perfetta. Sembra ottimo finché non ti rendi conto che sta memorizzando il rumore invece di imparare i pattern.
L'errore sul set di test ti dirà quanto è davvero buono il tuo modello.
Inizialmente, aggiungendo complessità, l'errore di test diminuisce perché il modello inizia a catturare pattern reali. Ma oltre un certo punto, l'errore di test aumenta anche se quello di training continua a scendere. Il modello è in overfitting: impara particolarità specifiche del training set che non generalizzano.
Un piccolo divario tra errore di training e di test significa che il modello generalizza bene. Un grande divario indica overfitting e la necessità di ridurre la complessità o aggiungere più dati di training.
Tecniche per gestire il compromesso bias-varianza
Non puoi eliminare il compromesso bias-varianza, ma puoi controllarlo con le tecniche giuste. Eccone alcune.
Train/test split
Non valutare mai il modello sugli stessi dati su cui l'hai addestrato.
Dividi i tuoi dati in training e test prima di fare qualsiasi altra cosa. Allena su una parte, valuta sull'altra. Questo ti dà una misura onesta di quanto il modello generalizza a dati nuovi.
Il set di test funge da proxy delle prestazioni nel mondo reale. Quando l'errore di training è basso ma quello di test è alto, sai che sei in overfitting. Quando entrambi sono alti, sei in underfitting.
Cross-validation
I train/test split hanno una debolezza: dipendono dagli esempi che finiscono in ciascun set.
La cross-validation risolve allenando e testando più volte su split diversi dei dati. L'approccio più comune è la k-fold cross-validation, in cui dividi i dati in k parti, alleni su k-1 parti e testi sulla parte rimanente. Ripeti k volte così che ogni parte faccia da test set una volta.
Questo ti dà una stima più affidabile delle prestazioni del modello e ti aiuta a sintonizzare gli iperparametri senza fare overfitting su un singolo test set.
Regolarizzazione
La regolarizzazione aggiunge una penalità per la complessità del modello direttamente nella tua funzione di loss.
Tecniche come L1 (Lasso) e L2 (Ridge) scoraggiano valori di parametro grandi, costringendo il modello a restare più semplice e stabile. Questo aumenta leggermente il bias ma riduce la varianza, spesso migliorando le prestazioni di test complessive.
Il dropout nelle reti neurali funziona in modo simile: disattiva casualmente neuroni durante il training, impedendo alla rete di fare troppo affidamento su parametri specifici e riducendo l'overfitting.
Più dati vs. modelli migliori
Più dati di training sono spesso la soluzione migliore all'alta varianza.
Quando hai più esempi, il modello vede un campione più ampio di possibili pattern. Diventa più difficile fare overfit al rumore perché il rumore si annulla mediando su più punti. La varianza diminuisce senza sacrificare il basso bias di un modello complesso.
Ma raccogliere più dati non è sempre pratico o possibile.
Se sei a corto di dati, concentrati sulla selezione del modello: scegli modelli più semplici, aggiungi regolarizzazione o usa metodi di ensemble che combinano più modelli per ridurre la varianza.
Selezione delle feature
Non tutte le feature migliorano il tuo modello. Alcune aggiungono solo rumore.
Rimuovi feature irrilevanti o ridondanti per ridurre la complessità del modello senza perdere pattern importanti. Meno feature significa meno parametri da apprendere, il che diminuisce la varianza. Eviti anche la maledizione della dimensionalità, dove i modelli faticano in spazi ad alta dimensione con pochi dati.
Usa tecniche come l'analisi di correlazione, gli score di importanza delle feature da modelli a base di alberi o metodi di regolarizzazione che azzerano automaticamente le feature poco importanti.
L'obiettivo è trovare il set minimo di feature che cattura il segnale senza il rumore.
Falsi miti comuni sul compromesso bias-varianza
Chiarisco tre errori comuni che portano a decisioni di modellazione sbagliate.
"Bias più basso è sempre meglio"
Sbagliato. Un bias più basso significa che il tuo modello può rappresentare pattern complessi, ma questo è utile solo se quei pattern esistono davvero nei tuoi dati e generalizzano a nuovi esempi.
Ridurre il bias aumentando la complessità spesso fa crescere la varianza più velocemente di quanto diminuisca il bias. Finisci con un modello che fitta perfettamente i dati di training ma va peggio su quelli di test. L'obiettivo è minimizzare l'errore totale, non solo il bias.
A volte un modello più semplice con bias più alto funziona meglio nel complesso perché ha una varianza abbastanza bassa da generalizzare bene.
"L'overfitting significa che il modello è scarso"
Non proprio. L'overfitting significa che il tuo modello è troppo complesso rispetto alla quantità di dati che hai, ma il modello in sé non è intrinsecamente scarso.
La stessa architettura di rete neurale che va in overfitting con 1.000 esempi di training potrebbe funzionare perfettamente con 100.000 esempi. Il problema è il disallineamento tra capacità e dimensione dei dati.
Puoi correggere l'overfitting aggiungendo più dati, riducendo la complessità o applicando regolarizzazione. Non devi buttare il modello e ripartire da zero con qualcosa di completamente diverso.
"Più dati risolvono sempre la varianza"
Più dati riducono la varianza, ma non la eliminano, e ci sono limiti a quanto possono aiutare.
Se il tuo modello è estremamente complesso rispetto al problema, anche dataset grandi potrebbero non stabilizzarlo a sufficienza. Una rete neurale con milioni di parametri richiede enormi quantità di dati per essere addestrata bene.
Inoltre, aggiungere più dati aiuta solo se i nuovi dati rappresentano la stessa distribuzione dei dati di test. Raccogliere più dati distorti o rumorosi non ridurrà la varianza, potrebbe anzi peggiorare le cose rafforzando pattern che non generalizzano.
Compromesso bias-varianza vs. overfitting e underfitting
Bias-varianza e overfitting-underfitting descrivono gli stessi problemi da angolazioni diverse, ma non sono termini intercambiabili.
Ecco cosa ricordare:
- Alto bias causa underfitting. Quando il modello ha forti assunzioni che non corrispondono ai dati reali, manca sistematicamente i pattern sia su training sia su test. Il modello è troppo semplice per rappresentare la relazione vera, cioè underfitting.
- Alta varianza causa overfitting. Quando il modello è troppo sensibile ai dati di training, impara rumore e pattern che non generalizzano. Memorizza gli esempi invece di apprendere il pattern sottostante, cioè overfitting.
Bias e varianza sono proprietà del tuo modello.
Descrivono come il modello si comporta su diversi training set. Puoi misurare il bias osservando quanto le previsioni medie del modello si discostano dalla verità. Puoi misurare la varianza osservando quanto cambiano le previsioni con dati di training diversi.
Underfitting e overfitting sono sintomi che osservi.
Descrivono cosa accade quando alleni e testi il modello. Vedi underfitting quando gli errori di training e test sono entrambi alti. Vedi overfitting quando l'errore di training è basso ma quello di test è alto.
La connessione è diretta ma non uno-a-uno. Alto bias porta di solito a underfitting, alta varianza porta di solito a overfitting. Ma puoi avere un modello con bias e varianza moderati che non è né in underfitting né in overfitting: semplicemente va male per altri motivi, come feature sbagliate o bassa qualità dei dati.
Consigli pratici per interpretare le prestazioni del modello
Ecco alcuni ultimi consigli su come diagnosticare problemi di bias-varianza e prendere decisioni di modellazione migliori.
Guarda insieme errori di training e di validazione, non separatamente
L'errore di training da solo non dice nulla sulla generalizzazione. Un modello con 1% di errore di training potrebbe avere 50% di errore di test se è in overfitting.
Confronta i due errori per capire cosa sta succedendo.
- Quando entrambi sono alti, hai alto bias: il modello è troppo semplice
- Quando l'errore di training è basso ma quello di validazione è alto, hai alta varianza: il modello è in overfitting
- Quando entrambi sono bassi, hai trovato il giusto equilibrio
Non ottimizzare solo per l'accuratezza di training
Un'accuratezza perfetta sul training è un campanello d'allarme. Di solito significa che hai memorizzato il training set senza imparare pattern che generalizzano.
Concentrati invece sulle prestazioni in validazione. L'obiettivo è minimizzare il divario tra errore di training e di validazione mantenendo entrambi ragionevolmente bassi.
Usa la cross-validation per stime affidabili
Un singolo train-test split può essere fuorviante perché dipende dagli esempi finiti in ciascun set. Uno split sfortunato può far sembrare scarso un buon modello o valido un modello scarso.
La cross-validation media le prestazioni su più split, dandoti una stima più stabile di come il modello si comporterà su dati nuovi. È particolarmente importante quando hai pochi dati o quando stai sintonizzando iperparametri.
Bilancia semplicità e flessibilità in base alla dimensione dei dati
Con dataset piccoli, prediligi modelli più semplici. Sono più stabili e meno inclini all'overfitting quando non hai molti esempi da cui imparare.
Con dataset grandi, puoi permetterti modelli più complessi perché i dati extra stabilizzano l'apprendimento e riducono la varianza. Ma non aggiungere complessità solo perché puoi: aggiungila solo se migliora le prestazioni in validazione.
Conclusione
Non puoi costruire un modello con bias e varianza pari a zero. Ogni decisione di modellazione cambia l'equilibrio tra queste due fonti di errore. Aggiungi complessità e riduci il bias ma aumenti la varianza. Semplifica e riduci la varianza ma aumenti il bias.
Le prestazioni del modello dipendono dal trovare il giusto equilibrio. Il miglior modello è quello che minimizza l'errore totale bilanciando bias e varianza per il tuo problema e dataset specifici. Capire questo compromesso significa saper diagnosticare se il tuo modello soffre di alto bias o alta varianza e applicare la soluzione giusta.
Se sei pronto per fare pratica con il machine learning, iscriviti al nostro Machine Learning Fundamentals in Python. Ha 16 ore di video che ti aiuteranno a ottenere il tuo primo lavoro.






Il compromesso bias-varianza spiega perché le prestazioni di un modello non dipendono solo da complessità o accuratezza, ma dal trovare il punto di equilibrio in cui il tuo modello generalizza bene a dati mai visti senza semplificare troppo il problema o andare in overfitting sul training set.
In questo articolo, ti spiego cosa significano davvero bias e varianza nel machine learning, come si bilanciano tra loro e perché comprendere questo compromesso ti aiuta a costruire modelli più robusti.
Se sei alle prime armi con il machine learning, il nostro How to Learn Machine Learning in 2026 ti aiuterà a diventare operativo in poco tempo.
Che cos'è il bias?
Il bias è l'errore che deriva dal fare assunzioni troppo semplicistiche sui tuoi dati. Non ha nulla a che vedere con i pregiudizi, almeno non nel contesto del machine learning.
Quando un modello ha alto bias, significa che è troppo rigido per catturare i pattern reali nei tuoi dati. È come provare a fittare una linea retta su dati che chiaramente curvano: per quanto tu la aggiusti, non seguirà mai la forma reale.
Questo si chiama underfitting.
Un modello con alto bias semplifica eccessivamente il problema. Presume che le relazioni siano più semplici di quanto siano in realtà, perdendo pattern importanti che aiuterebbero a fare previsioni accurate.
Immagina di prevedere i prezzi delle case in base ai metri quadrati, al numero di camere, alla posizione e all'età dell'immobile. Un modello con alto bias potrebbe usare solo i metri quadrati e ignorare tutto il resto. Suppone che la sola superficie determini il prezzo, il che è fin troppo semplice.
Il risultato è un modello che va male sia sui dati di training sia su quelli nuovi, perché non riesce a cogliere la complessità dei prezzi reali delle case.
La regressione lineare con poche feature è un classico modello ad alto bias. Anche gli alberi decisionali con profondità molto limitata tendono ad avere alto bias perché non possono dividere i dati abbastanza volte da trovare pattern sfumati.
Alto bias significa che il tuo modello non sta imparando abbastanza dai dati, ma sta rendendo il problema troppo semplice per essere risolto con buona accuratezza.
Che cos'è la varianza?
La varianza misura quanto il tuo modello è sensibile ai dati di training specifici che utilizzi.
Non ha nulla a che vedere con la misura statistica della dispersione dei dati. Nel machine learning, la varianza descrive il comportamento del modello, non la distribuzione dei dati.
Quando un modello ha alta varianza, piccole variazioni nei dati di training portano a grandi cambiamenti nelle sue previsioni. In altre parole, se alleni lo stesso modello su due dataset leggermente diversi, otterrai risultati molto diversi.
Questo si chiama overfitting.
Un modello con alta varianza è troppo flessibile. Impara non solo i pattern reali nei tuoi dati, ma anche il rumore e le fluttuazioni casuali che non generalizzano ai dati nuovi. In pratica, memorizza gli esempi di training invece di apprendere le relazioni sottostanti.
Immagina di prevedere ancora i prezzi delle case, ma ora con un modello complesso con centinaia di parametri. Potrebbe imparare che le case su Oak Street si vendono sempre esattamente a $427.350 perché così è successo nel tuo training set.
Il risultato è un modello che va benissimo sui dati di training ma malissimo su quelli nuovi, perché ha imparato particolarità specifiche del training set.
Le reti neurali profonde e gli alberi decisionali con profondità illimitata sono classici modelli ad alta varianza. Hanno abbastanza flessibilità da fittare quasi qualsiasi pattern, inclusi quelli privi di significato.
Alta varianza significa che il tuo modello sta imparando troppo dai dati. Sta fittando il rumore insieme al segnale, diventando instabile e inaffidabile su nuovi esempi.
Bias vs. Varianza: differenze chiave
Bias e varianza sono due fonti di errore di previsione completamente diverse. Una volta capita la distinzione, saprai diagnosticare più velocemente cosa non va nel tuo modello.
Ecco come bias e varianza influenzano l'errore di previsione:
Il problema è che ridurre l'uno di solito aumenta l'altra.
Quando rendi il modello più complesso per ridurre il bias, ne aumenti la flessibilità. Questa flessibilità lo rende più sensibile ai dati di training, aumentando la varianza. Quando lo semplifichi per ridurre la varianza, gli togli la capacità di catturare pattern complessi, aumentando il bias.
Questa relazione inversa spiega perché non puoi minimizzare entrambi contemporaneamente. Devi invece trovare l'equilibrio che ti dà l'errore totale più basso.
Che cos'è il compromesso bias-varianza?
Il compromesso bias-varianza descrive la tensione tra queste due fonti di errore: quando ne diminuisci una, quasi sempre aumenti l'altra.
Pensala così: stai cercando di colpire un bersaglio, ma hai due problemi che agiscono in direzioni opposte. Puoi mirare più accuratamente (ridurre il bias), ma questo ti rende più sensibile al vento e al tremolio delle mani (aumentare la varianza). Oppure puoi usare una posizione di tiro più semplice e stabile (ridurre la varianza), ma questo limita la tua precisione (aumentare il bias).
La complessità del modello è al centro di questo compromesso.
Con un modello semplice con pochi parametri ottieni alto bias e bassa varianza. Il modello fa assunzioni coerenti e cambia poco con dati di training diversi, ma non riesce a catturare pattern complessi.
Con un modello complesso con molti parametri ottieni basso bias e alta varianza. Il modello può rappresentare relazioni intricate, ma diventa instabile e troppo sensibile agli esempi specifici su cui lo alleni.
Ecco la curva concettuale che lo spiega:
Curva del compromesso bias-varianza
Stai cercando il punto in cui il loro effetto combinato ti dà l'errore di test più basso.
Non esiste un singolo modello "perfetto" che funzioni per ogni problema. L'equilibrio ottimale dipende dai tuoi dati, dalla complessità del problema e da quanta base di training hai. Più dati in genere ti consentono di usare modelli più complessi senza overfitting, spostando lo sweet spot verso destra.
Un semplice esempio di compromesso bias-varianza
Rendo il concetto concreto con uno scenario reale che mostra come bias e varianza si manifestano nella pratica.
Immagina di costruire un modello per prevedere i canoni d'affitto degli appartamenti in una città. Hai feature come metri quadrati, numero di camere, quartiere, distanza dalla metro, età dell'edificio e servizi.
Modello semplice: regressione lineare con una feature
Decidi di usare solo i metri quadrati per prevedere il prezzo con una regressione lineare semplice.
Modello semplice
Modello complesso: rete neurale profonda con tutte le feature
Ora costruisci una rete neurale profonda con più layer nascosti usando tutte le feature disponibili, più feature ingegnerizzate come tassi di criminalità del quartiere, indici di camminabilità e vicinanza ai parchi.
Modello complesso
Modello bilanciato: regressione regolarizzata con feature chiave
Usi una regressione regolarizzata (come Ridge o Lasso) con un sottoinsieme selezionato con cura di feature: metri quadrati, camere, categoria del quartiere e distanza dai mezzi.
Modello bilanciato
Il modello bilanciato non fitterà perfettamente i tuoi dati di training, ed è proprio questo il punto.
Compromesso bias-varianza nei modelli di machine learning
Algoritmi di machine learning diversi tendono naturalmente verso alto bias o alta varianza. Devi conoscere queste tendenze per scegliere lo strumento giusto per il tuo problema.
Modelli lineari
La regressione lineare e la regressione logistica si collocano dal lato dell'alto bias.
Questi modelli assumono relazioni lineari: una feature cambia e l'output cambia di una quantità fissa. Quando i tuoi dati hanno pattern non lineari, relazioni curve o interazioni complesse tra feature, i modelli lineari non riescono a catturarli.
Il lato positivo è la stabilità. Allena un modello lineare su campioni diversi dei tuoi dati e otterrai coefficienti simili ogni volta. Bassa varianza, ma potenzialmente alto bias se la relazione reale non è lineare.
Alberi decisionali
Gli alberi decisionali possono comportarsi in modo diverso a seconda di come li configuri.
Un albero poco profondo con pochi split si comporta come un modello semplice: alto bias, bassa varianza. Fa generalizzazioni ampie e non cattura pattern di dettaglio.
Un albero profondo senza limite di profondità diventa estremamente flessibile. Continua a dividere finché ogni foglia contiene pochi punti, cioè memorizza i dati di training. Basso bias, ma varianza altissima: la struttura dell'albero cambia drasticamente con campioni di training diversi.
Ecco perché le random forest funzionano così bene. Mediano le previsioni di molti alberi, riducendo il problema della varianza mantenendo basso il bias.
K-nearest neighbors
Il bilanciamento bias-varianza di KNN dipende interamente dalla scelta di k.
Quando k è piccolo (tipo k=1 o k=3), il modello ha alta varianza. Basa le previsioni su pochi punti vicini, quindi è estremamente sensibile agli esempi specifici presenti nel training set. Piccoli cambiamenti nei dati di training portano a previsioni completamente diverse.
Quando k è grande (tipo k=50 o k=100), il modello ha alto bias. Media su così tanti vicini da appiattire i pattern locali e perdere dettagli importanti nei dati.
Il valore ottimale di k è da qualche parte nel mezzo, bilanciando questi due estremi.
Reti neurali
Le reti neurali sono naturalmente modelli ad alta varianza perché hanno tantissimi parametri da apprendere.
Una rete con più layer e centinaia di neuroni può rappresentare funzioni incredibilmente complesse. Questa flessibilità significa basso bias: la rete può imparare quasi qualsiasi pattern. Ma significa anche alta varianza: i pesi appresi dipendono molto dai dati di training specifici, dall'inizializzazione e dal processo di training.
Ecco perché le reti neurali necessitano di dataset grandi per funzionare bene. Più dati di training aiutano a stabilizzare l'apprendimento e riducono la varianza. È anche il motivo per cui esistono tecniche come dropout, batch normalization ed early stopping: sono tutte progettate per controllare la varianza e prevenire l'overfitting.
Reti più piccole con meno layer e neuroni hanno bias più alto ma varianza più bassa, mentre reti più grandi hanno bias più basso ma varianza più alta.
Come la complessità del modello influisce su bias e varianza
Purtroppo, la complessità del modello non è un singolo numero che puoi misurare. Riguarda quanto il tuo modello è flessibile nell'adattarsi a pattern diversi.
La complessità deriva da più fattori, come più feature, più layer in una rete neurale, alberi decisionali più profondi, termini polinomiali nella regressione o valori di k più bassi in KNN. Il filo conduttore è che danno al modello più libertà di fittare pattern intricati nei dati.
Quando aggiungi parametri, dai al tuo modello più modi per rappresentare le relazioni nei dati. Un modello lineare con 3 feature può solo tracciare un piano piatto attraverso i dati. Se aggiungi termini polinomiali e interazioni, può piegarsi e curvare per seguire pattern più complessi. Le assunzioni del modello diventano meno restrittive, quindi il bias diminuisce.
Ma questa flessibilità ha un costo, cioè un aumento della varianza.
Più parametri significano più valori da apprendere dai dati di training. Ogni parametro viene tarato per adattarsi ai tuoi esempi specifici, rendendo il modello più sensibile a quali esempi hai incluso. Quando cambi alcuni campioni di training, tutti quei parametri si spostano per accomodare i nuovi dati. Il modello diventa instabile.
Ecco perché l'errore di training da solo è fuorviante e pericoloso.
All'aumentare della complessità, l'errore di training diminuirà sempre. Il modello fitta sempre meglio i dati di training, arrivando infine a un'accuratezza quasi perfetta. Sembra ottimo finché non ti rendi conto che sta memorizzando il rumore invece di imparare i pattern.
L'errore sul set di test ti dirà quanto è davvero buono il tuo modello.
Inizialmente, aggiungendo complessità, l'errore di test diminuisce perché il modello inizia a catturare pattern reali. Ma oltre un certo punto, l'errore di test aumenta anche se quello di training continua a scendere. Il modello è in overfitting: impara particolarità specifiche del training set che non generalizzano.
Un piccolo divario tra errore di training e di test significa che il modello generalizza bene. Un grande divario indica overfitting e la necessità di ridurre la complessità o aggiungere più dati di training.
Tecniche per gestire il compromesso bias-varianza
Non puoi eliminare il compromesso bias-varianza, ma puoi controllarlo con le tecniche giuste. Eccone alcune.
Train/test split
Non valutare mai il modello sugli stessi dati su cui l'hai addestrato.
Dividi i tuoi dati in training e test prima di fare qualsiasi altra cosa. Allena su una parte, valuta sull'altra. Questo ti dà una misura onesta di quanto il modello generalizza a dati nuovi.
Il set di test funge da proxy delle prestazioni nel mondo reale. Quando l'errore di training è basso ma quello di test è alto, sai che sei in overfitting. Quando entrambi sono alti, sei in underfitting.
Cross-validation
I train/test split hanno una debolezza: dipendono dagli esempi che finiscono in ciascun set.
La cross-validation risolve allenando e testando più volte su split diversi dei dati. L'approccio più comune è la k-fold cross-validation, in cui dividi i dati in k parti, alleni su k-1 parti e testi sulla parte rimanente. Ripeti k volte così che ogni parte faccia da test set una volta.
Questo ti dà una stima più affidabile delle prestazioni del modello e ti aiuta a sintonizzare gli iperparametri senza fare overfitting su un singolo test set.
Regolarizzazione
La regolarizzazione aggiunge una penalità per la complessità del modello direttamente nella tua funzione di loss.
Tecniche come L1 (Lasso) e L2 (Ridge) scoraggiano valori di parametro grandi, costringendo il modello a restare più semplice e stabile. Questo aumenta leggermente il bias ma riduce la varianza, spesso migliorando le prestazioni di test complessive.
Il dropout nelle reti neurali funziona in modo simile: disattiva casualmente neuroni durante il training, impedendo alla rete di fare troppo affidamento su parametri specifici e riducendo l'overfitting.
Più dati vs. modelli migliori
Più dati di training sono spesso la soluzione migliore all'alta varianza.
Quando hai più esempi, il modello vede un campione più ampio di possibili pattern. Diventa più difficile fare overfit al rumore perché il rumore si annulla mediando su più punti. La varianza diminuisce senza sacrificare il basso bias di un modello complesso.
Ma raccogliere più dati non è sempre pratico o possibile.
Se sei a corto di dati, concentrati sulla selezione del modello: scegli modelli più semplici, aggiungi regolarizzazione o usa metodi di ensemble che combinano più modelli per ridurre la varianza.
Selezione delle feature
Non tutte le feature migliorano il tuo modello. Alcune aggiungono solo rumore.
Rimuovi feature irrilevanti o ridondanti per ridurre la complessità del modello senza perdere pattern importanti. Meno feature significa meno parametri da apprendere, il che diminuisce la varianza. Eviti anche la maledizione della dimensionalità, dove i modelli faticano in spazi ad alta dimensione con pochi dati.
Usa tecniche come l'analisi di correlazione, gli score di importanza delle feature da modelli a base di alberi o metodi di regolarizzazione che azzerano automaticamente le feature poco importanti.
L'obiettivo è trovare il set minimo di feature che cattura il segnale senza il rumore.
Falsi miti comuni sul compromesso bias-varianza
Chiarisco tre errori comuni che portano a decisioni di modellazione sbagliate.
"Bias più basso è sempre meglio"
Sbagliato. Un bias più basso significa che il tuo modello può rappresentare pattern complessi, ma questo è utile solo se quei pattern esistono davvero nei tuoi dati e generalizzano a nuovi esempi.
Ridurre il bias aumentando la complessità spesso fa crescere la varianza più velocemente di quanto diminuisca il bias. Finisci con un modello che fitta perfettamente i dati di training ma va peggio su quelli di test. L'obiettivo è minimizzare l'errore totale, non solo il bias.
A volte un modello più semplice con bias più alto funziona meglio nel complesso perché ha una varianza abbastanza bassa da generalizzare bene.
"L'overfitting significa che il modello è scarso"
Non proprio. L'overfitting significa che il tuo modello è troppo complesso rispetto alla quantità di dati che hai, ma il modello in sé non è intrinsecamente scarso.
La stessa architettura di rete neurale che va in overfitting con 1.000 esempi di training potrebbe funzionare perfettamente con 100.000 esempi. Il problema è il disallineamento tra capacità e dimensione dei dati.
Puoi correggere l'overfitting aggiungendo più dati, riducendo la complessità o applicando regolarizzazione. Non devi buttare il modello e ripartire da zero con qualcosa di completamente diverso.
"Più dati risolvono sempre la varianza"
Più dati riducono la varianza, ma non la eliminano, e ci sono limiti a quanto possono aiutare.
Se il tuo modello è estremamente complesso rispetto al problema, anche dataset grandi potrebbero non stabilizzarlo a sufficienza. Una rete neurale con milioni di parametri richiede enormi quantità di dati per essere addestrata bene.
Inoltre, aggiungere più dati aiuta solo se i nuovi dati rappresentano la stessa distribuzione dei dati di test. Raccogliere più dati distorti o rumorosi non ridurrà la varianza, potrebbe anzi peggiorare le cose rafforzando pattern che non generalizzano.
Compromesso bias-varianza vs. overfitting e underfitting
Bias-varianza e overfitting-underfitting descrivono gli stessi problemi da angolazioni diverse, ma non sono termini intercambiabili.
Ecco cosa ricordare:
Bias e varianza sono proprietà del tuo modello.
Descrivono come il modello si comporta su diversi training set. Puoi misurare il bias osservando quanto le previsioni medie del modello si discostano dalla verità. Puoi misurare la varianza osservando quanto cambiano le previsioni con dati di training diversi.
Underfitting e overfitting sono sintomi che osservi.
Descrivono cosa accade quando alleni e testi il modello. Vedi underfitting quando gli errori di training e test sono entrambi alti. Vedi overfitting quando l'errore di training è basso ma quello di test è alto.
La connessione è diretta ma non uno-a-uno. Alto bias porta di solito a underfitting, alta varianza porta di solito a overfitting. Ma puoi avere un modello con bias e varianza moderati che non è né in underfitting né in overfitting: semplicemente va male per altri motivi, come feature sbagliate o bassa qualità dei dati.
Consigli pratici per interpretare le prestazioni del modello
Ecco alcuni ultimi consigli su come diagnosticare problemi di bias-varianza e prendere decisioni di modellazione migliori.
Guarda insieme errori di training e di validazione, non separatamente
L'errore di training da solo non dice nulla sulla generalizzazione. Un modello con 1% di errore di training potrebbe avere 50% di errore di test se è in overfitting.
Confronta i due errori per capire cosa sta succedendo.
Non ottimizzare solo per l'accuratezza di training
Un'accuratezza perfetta sul training è un campanello d'allarme. Di solito significa che hai memorizzato il training set senza imparare pattern che generalizzano.
Concentrati invece sulle prestazioni in validazione. L'obiettivo è minimizzare il divario tra errore di training e di validazione mantenendo entrambi ragionevolmente bassi.
Usa la cross-validation per stime affidabili
Un singolo train-test split può essere fuorviante perché dipende dagli esempi finiti in ciascun set. Uno split sfortunato può far sembrare scarso un buon modello o valido un modello scarso.
La cross-validation media le prestazioni su più split, dandoti una stima più stabile di come il modello si comporterà su dati nuovi. È particolarmente importante quando hai pochi dati o quando stai sintonizzando iperparametri.
Bilancia semplicità e flessibilità in base alla dimensione dei dati
Con dataset piccoli, prediligi modelli più semplici. Sono più stabili e meno inclini all'overfitting quando non hai molti esempi da cui imparare.
Con dataset grandi, puoi permetterti modelli più complessi perché i dati extra stabilizzano l'apprendimento e riducono la varianza. Ma non aggiungere complessità solo perché puoi: aggiungila solo se migliora le prestazioni in validazione.
Conclusione
Non puoi costruire un modello con bias e varianza pari a zero. Ogni decisione di modellazione cambia l'equilibrio tra queste due fonti di errore. Aggiungi complessità e riduci il bias ma aumenti la varianza. Semplifica e riduci la varianza ma aumenti il bias.
Le prestazioni del modello dipendono dal trovare il giusto equilibrio. Il miglior modello è quello che minimizza l'errore totale bilanciando bias e varianza per il tuo problema e dataset specifici. Capire questo compromesso significa saper diagnosticare se il tuo modello soffre di alto bias o alta varianza e applicare la soluzione giusta.
Se sei pronto per fare pratica con il machine learning, iscriviti al nostro Machine Learning Fundamentals in Python. Ha 16 ore di video che ti aiuteranno a ottenere il tuo primo lavoro.