Önyargı-varyans dengesi, model performansının sadece karmaşıklık veya doğrulukla ilgili olmadığını açıklar; asıl mesele, modeli ne problemi aşırı basitleştirecek ne de eğitim setinize aşırı uyum sağlayacak şekilde, görülmemiş veriye iyi genelleyecek tatlı noktayı bulmaktır.
Bu yazıda, makine öğreniminde önyargı ve varyansın gerçekte ne anlama geldiğini, birbirlerine nasıl karşıtlık oluşturduklarını ve bu dengeyi anlamanın neden daha sağlam modeller kurmanıza yardımcı olduğunu açıklayacağım.
Makine öğrenimine yeni başladıysanız, 2026'da Makine Öğrenimini Nasıl Öğrenirsiniz başlıklı makalemiz kısa sürede yetkinleşmenize yardımcı olacaktır.
Önyargı Nedir?
Önyargı, verileriniz hakkında gereğinden basit varsayımlar yapmaktan kaynaklanan hatadır. Makine öğrenimi bağlamında, önyargının önyargıcılıkla (prejudice) ilgisi yoktur.
Bir model yüksek önyargıya sahipse, verilerinizdeki gerçek kalıpları yakalamak için fazla katıdır demektir. Bunu, belirgin şekilde eğri olan verilere düz bir çizgi uydurmaya çalışmak gibi düşünün: O çizgiyi nasıl ayarlarsanız ayarlayın, asıl şekle asla uymaz.
Buna yetersiz uyum denir.
Yüksek önyargılı bir model problemi aşırı basitleştirir. İlişkilerin gerçekte olduğundan daha basit olduğunu varsayar ve bu da doğru tahminler yapmasına yardımcı olacak önemli kalıpları kaçırmasına yol açar.
Metrekare, yatak odası sayısı, konum ve evin yaşı gibi değişkenlere göre konut fiyatlarını tahmin ettiğinizi düşünün. Yüksek önyargılı bir model yalnızca metrekareyi kullanıp diğer her şeyi yok sayabilir. Fiyatı yalnızca metrekarenin belirlediğini varsayar ki bu fazlasıyla basittir.
Sonuç olarak hem eğitim verilerinde hem de yeni verilerde kötü performans gösteren bir model elde edersiniz, çünkü gerçek konut fiyatlarının karmaşıklığını yakalayamaz.
Az sayıda özellikli doğrusal regresyon, klasik bir yüksek önyargılı modeldir. Derinliği çok sınırlı karar ağaçları da veriyi yeterince bölüp ince kalıpları bulamadıkları için yüksek önyargı eğilimindedir.
Yüksek önyargı, modelinizin veriden yeterince öğrenmediği; bunun yerine problemi iyi bir doğrulukla çözemeyecek kadar basitleştirdiği anlamına gelir.
Varyans Nedir?
Varyans, modelinizin kullandığınız belirli eğitim verilerine ne kadar duyarlı olduğunu ölçer.
İstatistikteki veri yayılımı ölçüsüyle ilgisi yoktur. Makine öğreniminde varyans, veri dağılımını değil, model davranışını tanımlar.
Bir model yüksek varyansa sahipse, eğitim verilerindeki küçük değişiklikler modelin tahminlerinde büyük değişikliklere yol açar. Başka bir deyişle, aynı modeli birbirine çok yakın iki farklı veri kümesiyle eğitirseniz, bambaşka sonuçlar elde edersiniz.
Buna aşırı uyum denir.
Yüksek varyanslı bir model fazlasıyla esnektir. Verinizdeki gerçek kalıpları değil, aynı zamanda yeni verilere genellenmeyen gürültü ve rastgele dalgalanmaları da öğrenir. Model, temel ilişkileri öğrenmek yerine eğitim örneklerini ezberler.
Hâlâ konut fiyatlarını tahmin ettiğinizi ama bu kez yüzlerce parametreli karmaşık bir model kullandığınızı hayal edin. Eğitim verinizde Oak Street'teki evlerin her zaman tam olarak 427.350 $'a satıldığını öğrenebilir.
Sonuç, eğitim verilerinde harika ama yeni verilerde berbat performans gösteren bir modeldir; çünkü eğitim setine özgü tuhaflıkları öğrenmiştir.
Derin sinir ağları ve sınırsız derinlikte karar ağaçları, klasik yüksek varyanslı modellerdir. Anlamsız olanlar da dahil neredeyse her kalıbı uydurabilecek kadar esnektirler.
Yüksek varyans, modelinizin veriden gereğinden fazla şey öğrendiği anlamına gelir. Sinyalle birlikte gürültüyü de uydurur; bu da modeli yeni örneklerde dengesiz ve güvenilmez kılar.
Önyargı ve Varyans: Temel Farklar
Önyargı ve varyans, tahmin hatasının tamamen farklı iki kaynağıdır. Bu ayrımı anladığınızda, modelinizde neyin yanlış olduğunu daha hızlı teşhis edersiniz.
- Önyargı, modelinizin varsayımlarından kaynaklanır. Seçtiğiniz algoritma, dahil ettiğiniz özellikler ve problemi nasıl yapılandırdığınızla ilgilidir. Doğrusal regresyon modeli doğrusal ilişkiler varsayar; gerçek ilişki doğrusal değilse önyargı oluşur. Bu hata, eğitim verilerinize bakmadan önce bile mevcuttur.
- Varyans, eğitim verilerine duyarlılıktan kaynaklanır. Aynı popülasyondan alınan farklı örneklerle eğittiğinizde modelinizin ne kadar değiştiğiyle ilgilidir. Yüksek varyanslı bir model, biraz farklı eğitim setlerinden farklı kalıplar öğrenir; bu da tahminlerini dengesiz kılar.
Önyargı ve varyansın tahmin hatasına etkisi şöyle:
- Yüksek önyargı modelinizin aynı yönde tutarlı hatalar yapması demektir. Gerçek ilişkiyi temsil edemediği için belirli kalıpları sürekli eksik ya da fazla tahmin eder. Hatalar sistematik ve öngörülebilirdir.
- Yüksek varyans modelinizin veriye göre değişen tutarsız hatalar yapması demektir. Pazartesi verisiyle eğitin bir şey tahmin eder; Salı verisiyle eğitin tamamen başka bir şey. Hatalar rastgele ve öngörülemezdir.
Sorun şu ki birini azaltmak genelde diğerini artırır.
Önyargıyı azaltmak için modelinizi daha karmaşık yaptığınızda, esnekliğini artırırsınız. Bu esneklik modeli eğitim verilerine daha duyarlı kılar ve varyansı yükseltir. Varyansı azaltmak için modelinizi basitleştirdiğinizde, karmaşık kalıpları yakalama kabiliyetini düşürür ve önyargıyı artırırsınız.
Bu ters ilişki, ikisini aynı anda en aza indirememenizin sebebidir. Bunun yerine toplam hatayı en düşük yapan dengeyi bulmalısınız.
Önyargı-Varyans Dengesi Nedir?
Önyargı-varyans dengesi, bu iki hata kaynağı arasındaki gerilimi tanımlar – birini azalttığınızda, neredeyse her zaman diğerini artırırsınız.
Şöyle düşünün: Bir hedefi vurmaya çalışıyorsunuz, ama birbirine karşı çalışan iki sorun var. Daha dikkatli nişan alabilirsiniz (önyargıyı azaltmak), ancak bu sizi rüzgâra ve el titremesine daha duyarlı yapar (varyansı artırır). Ya da daha basit, daha stabil bir atış duruşu kullanabilirsiniz (varyansı azaltmak), ama bu da hassasiyetinizi sınırlar (önyargıyı artırır).
Model karmaşıklığı bu dengenin merkezindedir.
Az sayıda parametreye sahip basit bir model kullandığınızda, yüksek önyargı ve düşük varyans elde edersiniz. Model tutarlı varsayımlar yapar ve farklı eğitim verileriyle çok değişmez; ama karmaşık kalıpları yakalayamaz.
Çok sayıda parametreye sahip karmaşık bir model kullandığınızda, düşük önyargı ve yüksek varyans elde edersiniz. Model girift ilişkileri temsil edebilir; ancak eğittiğiniz spesifik örneklere aşırı duyarlı ve dengesiz hale gelir.
Bunu açıklayan kavramsal eğri şöyledir:
- Sol tarafta (basit modeller): Eğitim hatası yüksektir çünkü model yetersiz uyum sağlar. Test hatası da yüksektir çünkü model gerçek kalıpları kaçırır.
- Ortada (dengeli modeller): Hem eğitim hem test hataları düşüktür. Model, gürültüyü ezberlemeden gerçek kalıpları yakalar. Burası tatlı noktadır.
- Sağ tarafta (karmaşık modeller): Eğitim hatası çok düşüktür çünkü model her şeyi uydurur. Test hatası yüksektir çünkü model gürültüyü öğrenmiştir.
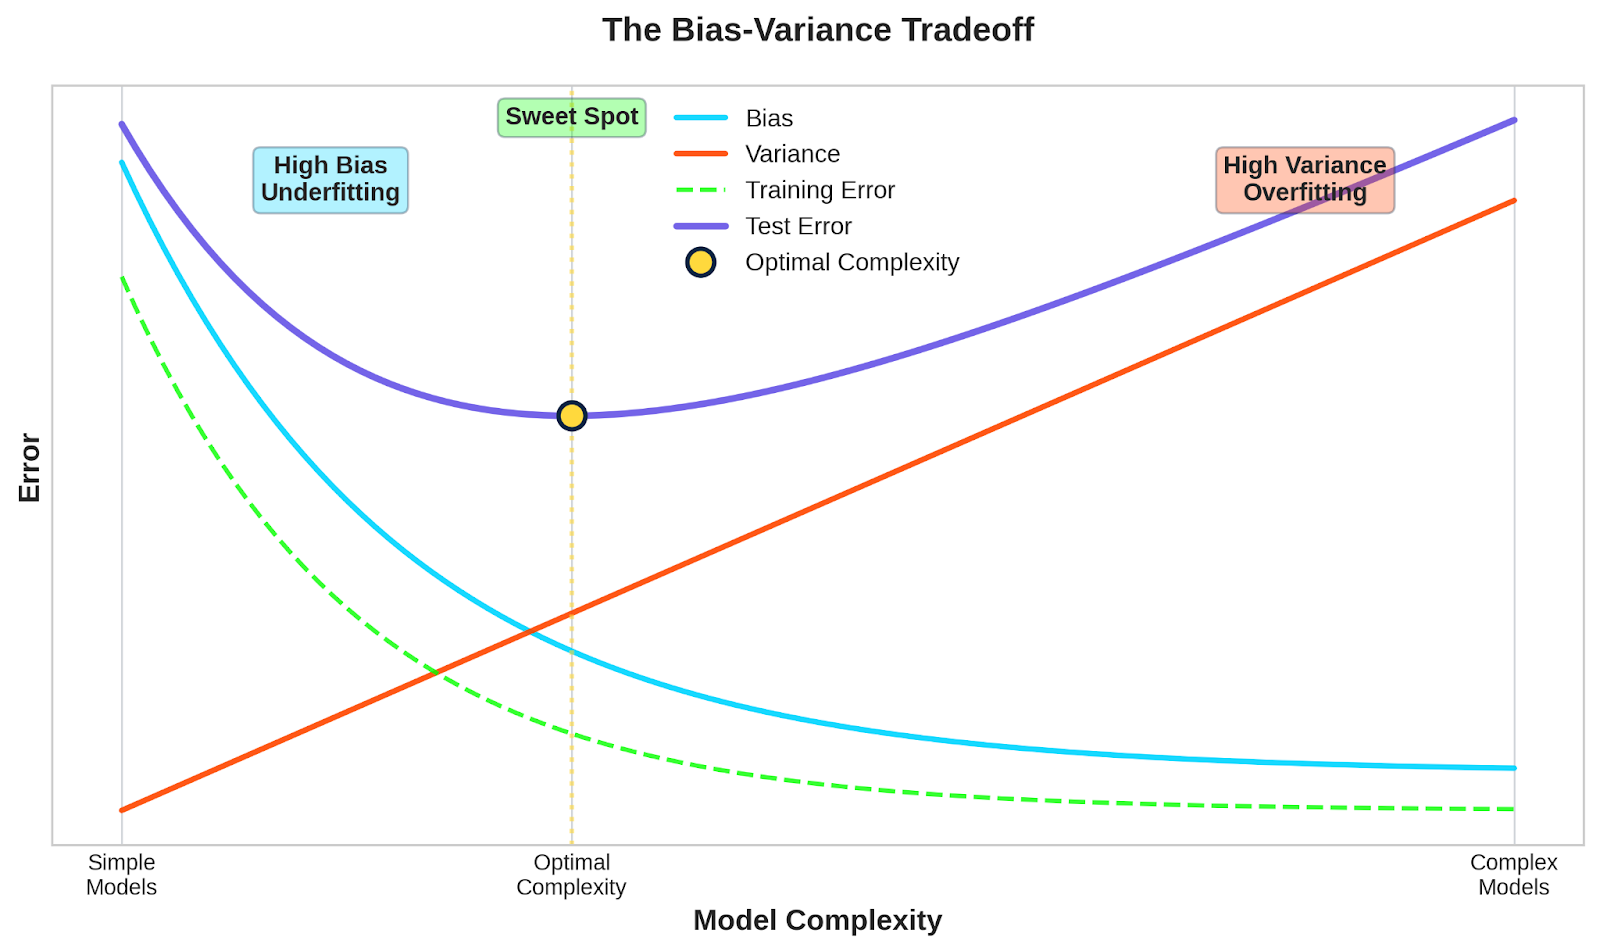
Önyargı-varyans dengesi eğrisi
Aradığınız, birleşik etkilerinin en düşük test hatasını verdiği noktadır.
Her problem için işe yarayan tek bir "mükemmel" model yoktur. Optimal denge, verilerinize, probleminizin karmaşıklığına ve sahip olduğunuz eğitim verisi miktarına bağlıdır. Daha fazla veri, genelde aşırı uydurmadan daha karmaşık modeller kullanmanıza izin verir ve tatlı noktayı sağa kaydırır.
Basit Bir Önyargı-Varyans Dengesi Örneği
Bu kavramı, önyargı ve varyansın pratikte nasıl ortaya çıktığını gösteren gerçekçi bir senaryoyla somutlaştıralım.
Bir şehirde daire kira fiyatlarını tahmin eden bir model kurduğunuzu hayal edin. Metrekare, yatak odası sayısı, mahalle, metroya uzaklık, bina yaşı ve imkânlar gibi özellikleriniz var.
Basit model: Tek özellikli doğrusal regresyon
Yalnızca metrekareyi kullanarak basit doğrusal regresyon ile fiyatı tahmin etmeye karar veriyorsunuz.
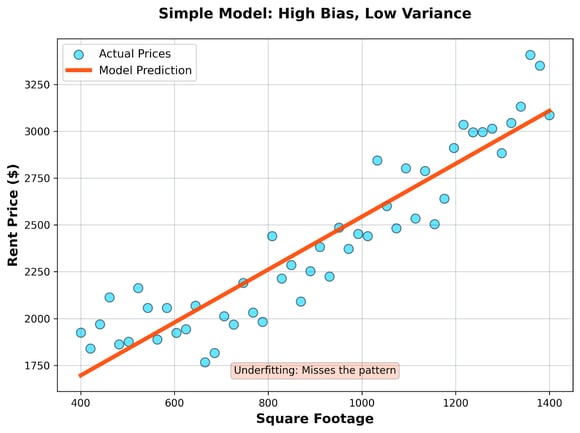
Basit model
- Ne olur: Model, veri noktalarınızdan geçen düz bir çizgi çizer. Konum veya diğer faktörlerden bağımsız olarak, her 100 metrekarenin kiraya sabit bir tutar eklediğini tahmin eder.
- Sonuç: Bu model yüksek önyargı ve düşük varyansa sahiptir. Lüks daireleri sürekli düşük, stüdyo daireleri sürekli yüksek tahmin eder; çünkü farklı mahallelerde boyut ile fiyat arasındaki karmaşık ilişkiyi yakalayamaz. Ancak farklı daire örnekleriyle eğitirseniz her seferinde kabaca aynı çizgiyi elde edersiniz – stabil ama isabetsizdir.
Karmaşık model: Tüm özelliklerle derin sinir ağı
Şimdi, mevcut tüm özellikleri ve mahalle suç oranları, yürünebilirlik puanları, parklara yakınlık gibi türetilmiş özellikleri kullanarak birden çok gizli katmanlı derin bir sinir ağı kuruyorsunuz.
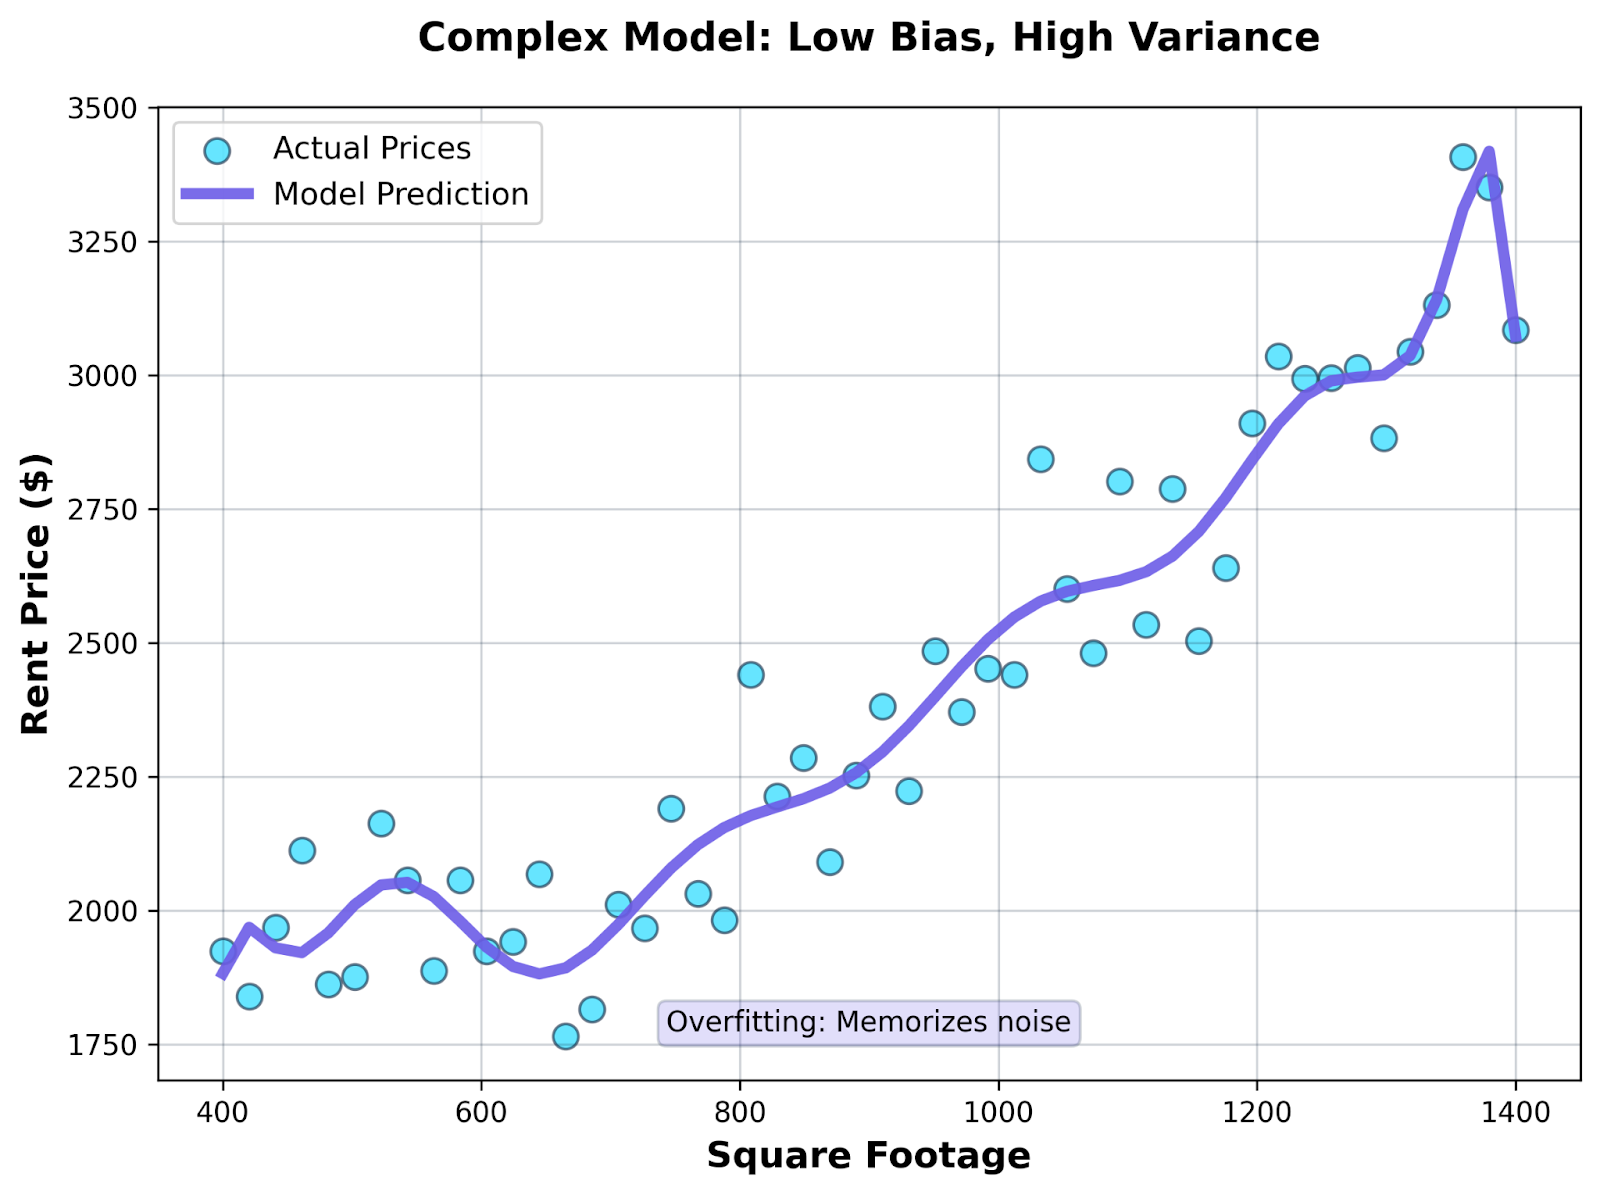
Karmaşık model
- Ne olur: Ağ, girift kalıpları öğrenir. Belirli eğitim verinizde 5. kattaki dairelerin her zaman tam 2.847 $'a kiralandığını ya da Oak Street'e bakan kuzey cepheli dairelerin güney cepheye göre kirayı %37 daha yüksek aldığını keşfedebilir.
- Sonuç: Bu model düşük önyargı ve yüksek varyansa sahiptir. Eğitim verinizi neredeyse kusursuz uydurur ve her ayrıntı ile dalgalanmayı yakalar. Ancak bu kalıplar genellenmez – örnekleminize özgü artifaktlardır. Farklı daire setleriyle eğitin, tamamen farklı kalıplar öğrenir. Tahminler yeni veride dengesiz ve güvenilmezdir.
Dengeli model: Temel özelliklerle düzenlileştirilmiş regresyon
Ridge veya Lasso gibi düzenlileştirilmiş bir regresyonu, özenle seçilmiş bir özellik alt kümesiyle kullanıyorsunuz: metrekare, yatak odası sayısı, mahalle kategorisi ve toplu taşımaya uzaklık.
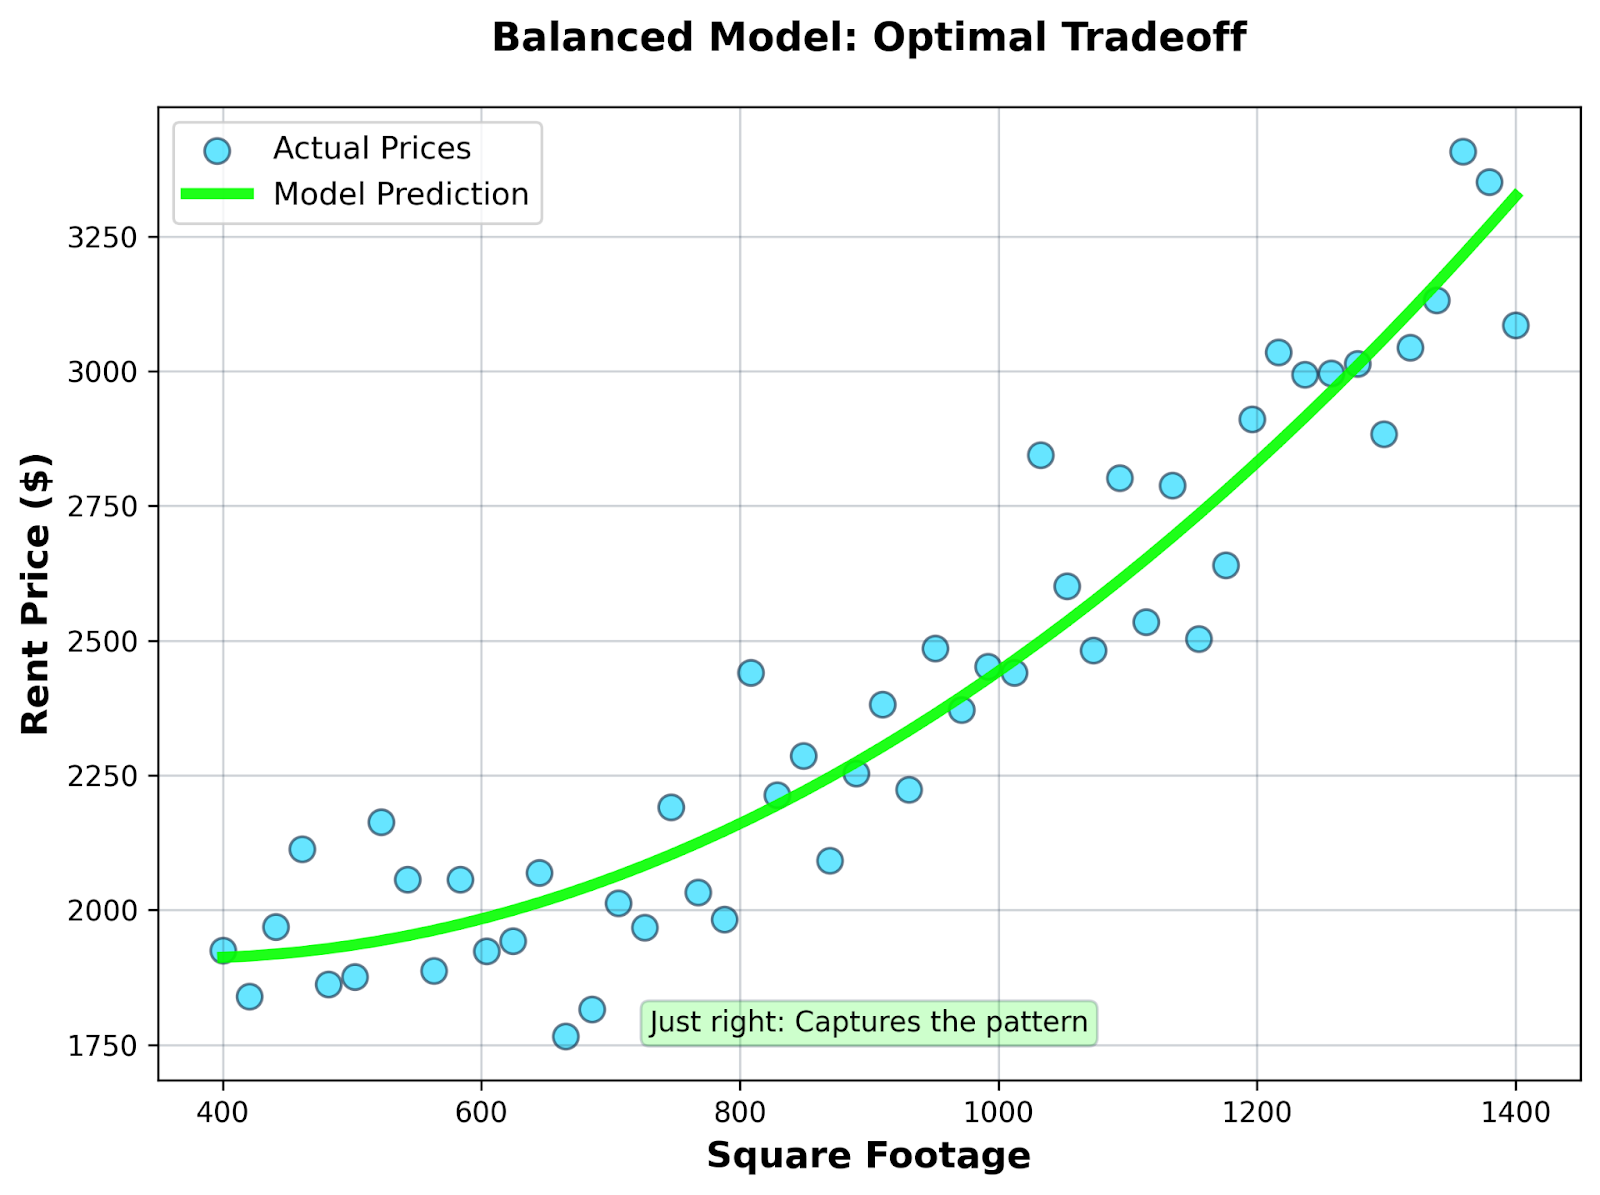
Dengeli model
- Ne olur: Model, gürültüyü ezberlemeden ana ilişkileri yakalar. Boyut ve konumun önemli olduğunu öğrenir, ancak eğitim verisindeki her küçük dalgalanmaya takılıp kalmaz.
- Sonuç: Bu model, önyargı ve varyansı dengeler. Gerçek kalıpları yakalayacak kadar esnektir ama aşırı uyumu önleyecek kadar da kısıtlıdır. Eğitim hatası orta seviyededir, ancak test hatası düşüktür – yeni dairelerdeki tahminler için asıl önemli olan budur.
Dengeli model eğitim verilerinizi mükemmel şekilde uydurmayacaktır ve tam da mesele budur.
Makine Öğrenimi Modellerinde Önyargı-Varyans Dengesi
Farklı makine öğrenimi algoritmaları doğal olarak yüksek önyargı veya yüksek varyans eğilimindedir. Probleminiz için doğru aracı seçmek adına bu eğilimleri anlamanız gerekir.
Doğrusal modeller
Doğrusal regresyon ve lojistik regresyon, tayfın yüksek önyargı tarafında yer alır.
Bu modeller ilişkilerin doğrusal olduğunu varsayar – bir özellik değiştiğinde çıktı sabit bir miktar değişir. Verileriniz doğrusal olmayan kalıplar, eğrisel ilişkiler veya özellikler arası karmaşık etkileşimler içeriyorsa, doğrusal modeller bunları yakalayamaz.
Artısı ise stabilliktir. Doğrusal bir modeli verilerinizin farklı örneklemleri üzerinde eğitirseniz, her seferinde benzer katsayılar elde edersiniz. Düşük varyans, ancak gerçek ilişki doğrusal değilse potansiyel olarak yüksek önyargı.
Karar ağaçları
Karar ağaçları, nasıl yapılandırdığınıza bağlı olarak farklı davranabilir.
Yalnızca birkaç bölünmeye sahip sığ bir ağaç, basit bir model gibi davranır – yüksek önyargı, düşük varyans. Geniş genellemeler yapar ve ince ayrıntılı kalıpları yakalayamaz.
Derinlik sınırı olmayan derin bir ağaç son derece esnek hale gelir. Her yaprakta yalnızca birkaç veri noktası kalana kadar bölmeye devam eder; bu da eğitim verinizi ezberlediği anlamına gelir. Düşük önyargı ama aşırı yüksek varyans – farklı eğitim örneklemleriyle ağaç yapısı dramatik biçimde değişir.
Bu yüzden rastgele ormanlar çok iyi çalışır. Birçok ağacın tahminlerini ortalayarak, önyargıyı düşük tutarken varyans sorununu azaltırlar.
K-en yakın komşu
KNN'in önyargı-varyans dengesi tamamen k seçiminize bağlıdır.
k küçük olduğunda (örneğin k=1 veya k=3), model yüksek varyansa sahiptir. Tahminleri yalnızca birkaç yakın noktaya dayandırır; bu nedenle eğitim setinizdeki belirli örneklere son derece duyarlıdır. Eğitim verilerindeki küçük değişiklikler tamamen farklı tahminlere yol açar.
k büyük olduğunda (örneğin k=50 veya k=100), model yüksek önyargıya sahiptir. O kadar çok komşu üzerinde ortalama alır ki yerel kalıpları düzleştirir ve verideki önemli ayrıntıları kaçırır.
Optimal k değeri, bu iki uç arasında bir yerdedir ve ikisini dengeler.
Sinir ağları
Sinir ağları, öğrenilecek çok sayıda parametreye sahip oldukları için doğası gereği yüksek varyanslı modellerdir.
Birden fazla katman ve yüzlerce nörona sahip bir ağ, son derece karmaşık fonksiyonları temsil edebilir. Bu esneklik düşük önyargı demektir – ağ neredeyse her kalıbı öğrenebilir. Ancak bu aynı zamanda yüksek varyans anlamına gelir – öğrendiğiniz kesin ağırlıklar, belirli eğitim verilerinize, başlangıç değerlerinize ve eğitim sürecinize fazlasıyla bağlıdır.
Bu nedenle sinir ağlarının iyi çalışması için büyük veri setlerine ihtiyaç vardır. Daha fazla eğitim verisi, öğrenme sürecini stabilize eder ve varyansı azaltır. Dropout, batch normalization ve erken durdurma gibi tekniklerin varlık nedeni de budur – hepsi varyansı kontrol etmek ve aşırı uyumu önlemek için tasarlanmıştır.
Daha küçük, daha az katmanlı ve nöronlu ağlar daha yüksek önyargı ama daha düşük varyansa; daha büyük ağlar ise daha düşük önyargı ama daha yüksek varyansa sahiptir.
Model Karmaşıklığı Önyargı ve Varyansı Nasıl Etkiler
Ne yazık ki model karmaşıklığı ölçülebilecek tek bir sayı değildir. Modelinizin farklı kalıpları uydurma esnekliğiyle ilgilidir.
Karmaşıklık; daha fazla özellik, sinir ağında daha fazla katman, daha derin karar ağaçları, regresyonda polinom terimleri veya KNN'de daha düşük k değerleri gibi birden çok kaynaktan gelir. Ortak nokta; bunların, modelinize verideki girift kalıpları uydurma özgürlüğünü daha fazla vermesidir.
Parametre eklediğinizde, modelinize verilerinizdeki ilişkileri temsil etmesi için daha fazla yol verirsiniz. Üç özellikli bir doğrusal model verinizin içinden yalnızca düz bir düzlem geçirebilir. Polinom terimleri ve etkileşim özellikleri eklediğinizde, daha karmaşık kalıplara uyacak şekilde bükülüp kıvrılabilir. Modelin varsayımları daha az kısıtlayıcı hale gelir; bu da daha düşük önyargı demektir.
Ancak bu esneklik bir bedelle gelir; yani varyans artışıyla.
Daha fazla parametre, eğitim verilerinizden öğrenilecek daha fazla değer demektir. Her parametre, belirli eğitim örneklerinize uyacak şekilde ayarlanır; bu da modeli hangi örnekleri dahil ettiğinize daha duyarlı kılar. Birkaç eğitim örneğini değiştirdiğinizde, tüm bu parametreler yeni veriye uyum sağlamak için kayar. Model dengesizleşir.
Bu yüzden yalnızca eğitim hatasına bakmak yanıltıcı ve tehlikelidir.
Karmaşıklığı artırdıkça eğitim hatası her zaman azalır. Modeliniz eğitim verisini giderek daha iyi uydurur ve sonunda neredeyse kusursuz doğruluğa ulaşır. Bu, modelin kalıpları öğrenmek yerine gürültüyü ezberlediğini fark edene kadar harika görünür.
Gerçek performansı, test setindeki hata gösterecektir.
Başlangıçta, karmaşıklık ekledikçe test hatası azalır; çünkü model gerçek kalıpları yakalamaya başlar. Ancak belli bir noktadan sonra, eğitim hatası düşmeye devam etse de test hatası artar. Model aşırı uyum sağlar – eğitim setine özgü tuhaflıkları öğrenir ve bunlar genellenmez.
Eğitim ve test hatası arasındaki küçük fark, modelinizin iyi genelleştiği anlamına gelir. Büyük fark ise aşırı uyum sağladığınızı ve karmaşıklığı azaltmanız veya daha fazla eğitim verisi eklemeniz gerektiğini gösterir.
Önyargı-Varyans Dengesini Yönetme Teknikleri
Önyargı-varyans dengesini ortadan kaldıramazsınız; ancak doğru tekniklerle kontrol edebilirsiniz. İşte birkaç yöntem.
Eğitim/test ayrımları
Modelinizi asla üzerinde eğittiğiniz aynı veriyle değerlendirmeyin.
Başka bir şey yapmadan önce verinizi eğitim ve test setlerine ayırın. Bir bölümde eğitin, diğerinde değerlendirin. Bu, modelinizin yeni veriye ne kadar iyi genelleştiğine dair dürüst bir ölçüm verir.
Test seti, gerçek dünya performansının bir vekili olarak görev yapar. Eğitim hatası düşük ama test hatası yüksekse, aşırı uyum söz konusudur. İkisi de yüksekse, yetersiz uyum vardır.
Çapraz doğrulama
Eğitim/test ayrımlarının bir zayıflığı vardır – her birine düşen belirli örneklere bağlıdırlar.
Çapraz doğrulama, verinizin farklı ayrımlarında birden çok kez eğitip test ederek bunu düzeltir. En yaygın yaklaşım k-katlı çapraz doğrulamadır; verinizi k parçaya bölersiniz, k-1 parça üzerinde eğitir, kalan parça üzerinde test edersiniz. Her parça bir kez test seti olacak şekilde k kez tekrarlarsınız.
Bu, model performansına daha güvenilir bir tahmin verir ve tek bir test setine aşırı uyum sağlamadan hiperparametreleri ayarlamanıza yardımcı olur.
Düzenlileştirme
Düzenlileştirme, model karmaşıklığı için doğrudan kayıp fonksiyonunuza bir ceza ekler.
L1 (Lasso) ve L2 (Ridge) gibi teknikler, büyük parametre değerlerini caydırır; bu da modeli daha basit ve daha stabil kalmaya zorlar. Bu, önyargıyı bir miktar artırır ama varyansı azaltır ve çoğu zaman genel test performansını iyileştirir.
Sinir ağlarında dropout da benzer çalışır – eğitim sırasında nöronları rastgele düşürür; böylece ağın belirli parametrelere aşırı bağımlı olmasını engeller ve aşırı uyumu azaltır.
Daha fazla veri ve daha iyi modeller
Daha fazla eğitim verisi, genellikle yüksek varyans için en iyi çözümdür.
Daha fazla örnek olduğunda, modeliniz öğrenilecek olası kalıpların daha geniş bir örneklemini görür. Bu, gürültüye aşırı uyum sağlamayı zorlaştırır; çünkü gürültü daha çok veri noktasında ortalamaya gelir. Varyans, karmaşık bir modelin düşük önyargısından ödün vermeden azalır.
Ancak daha fazla veri toplamak her zaman pratik veya mümkün değildir.
Veriniz kısıtlıysa, bunun yerine model seçimine odaklanın – daha basit modeller seçin, düzenlileştirme ekleyin veya birden fazla modeli birleştirerek varyansı azaltan topluluk yöntemleri kullanın.
Özellik seçimi
Her özellik modelinizi iyileştirmez. Bazıları yalnızca gürültü katar.
İlgisiz veya fazlalık içeren özellikleri kaldırarak, önemli kalıpları kaybetmeden model karmaşıklığını azaltın. Daha az özellik, öğrenilecek daha az parametre demektir; bu da varyansı düşürür. Ayrıca, sınırlı verili yüksek boyutlu uzaylarda modellerin zorlandığı boyutsallık lanetinden kaçınırsınız.
Korelasyon analizi, ağaç tabanlı modellerden özellik önem puanları veya önemsiz özellikleri otomatik olarak sıfıra çeken düzenlileştirme yöntemleri gibi teknikleri kullanın.
Amaç, sinyali gürültüsüz yakalayan asgari özellik kümesini bulmaktır.
Önyargı-Varyans Dengesi Hakkında Yaygın Yanılgılar
Kötü modelleme kararlarına yol açan üç yaygın hatayı netleştireyim.
"Daha düşük önyargı her zaman daha iyidir"
Yanlış. Daha düşük önyargı, modelinizin karmaşık kalıpları temsil edebileceği anlamına gelir; ancak bu yalnızca bu kalıplar verinizde gerçekten varsa ve yeni örneklere genelleniyorsa faydalıdır.
Karmaşıklık ekleyerek önyargıyı azaltmak, çoğu zaman önyargıdaki azalmadan daha hızlı şekilde varyansı artırır. Eğitim verilerini mükemmel uyduran ama test verilerinde daha kötü performans gösteren bir modelle kalırsınız. Amaç, sadece önyargıyı değil toplam hatayı en aza indirmektir.
Bazen daha yüksek önyargıya sahip daha basit bir model, yeterince düşük varyansla iyi genelleştiği için genel olarak daha iyi performans gösterebilir.
"Aşırı uyum demek model kötüdür"
Tam olarak değil. Aşırı uyum, modelinizin elinizdeki veri miktarı için fazla karmaşık olduğu anlamına gelir; ama modelin kendisi doğası gereği kötü değildir.
1.000 eğitim örneğinde aşırı uyum sağlayan aynı sinir ağı mimarisi, 100.000 örnekte mükemmel performans gösterebilir. Sorun, kapasite ile veri boyutu arasındaki uyumsuzluktadır.
Aşırı uyumu, daha fazla veri ekleyerek, karmaşıklığı azaltarak veya düzenlileştirme uygulayarak düzeltebilirsiniz. Modeli çöpe atıp tamamen farklı bir şeyle yeniden başlamak gerekmez.
"Daha fazla veri her zaman varyansı düzeltir"
Daha fazla veri varyansı azaltır; ancak onu ortadan kaldırmaz ve faydasının da sınırları vardır.
Modeliniz probleminize göre aşırı derecede karmaşıksa, büyük veri setleri bile yeterince stabilize etmeyebilir. Milyonlarca parametreli bir sinir ağının iyi eğitilmesi için muazzam miktarda veriye ihtiyaç vardır.
Ayrıca, yalnızca yeni verinizle aynı dağılımı temsil eden daha fazla veri eklemek yardımcı olur. Önyargılı veya düşük kaliteli daha fazla veri toplamak varyansı azaltmaz – genellenmeyen kalıpları pekiştirerek işleri daha da kötüleştirebilir.
Önyargı-Varyans Dengesi vs. Aşırı Uyum ve Yetersiz Uyum
Önyargı-varyans ve aşırı uyum–yetersiz uyum, aynı sorunları farklı açılardan tanımlar; ancak birbirlerinin yerine geçen terimler değildir.
Unutmamanız gerekenler şunlardır:
- Yüksek önyargı, yetersiz uyuma yol açar. Modelinizin varsayımları gerçek verilerle örtüşmediğinde, hem eğitim hem test verilerinde kalıpları sistematik olarak kaçırır. Model, gerçek ilişkiyi temsil edecek kadar güçlü değildir; yani yetersiz uyum budur.
- Yüksek varyans, aşırı uyuma yol açar. Modeliniz eğitim verisine gereğinden fazla duyarlı olduğunda, genellenmeyen gürültü ve kalıpları öğrenir. Model, temel kalıbı öğrenmek yerine eğitim örneklerini ezberler; yani aşırı uyum budur.
Önyargı ve varyans, modelinizin özellikleridir.
Farklı eğitim setleri arasında modelinizin nasıl davrandığını tanımlarlar. Modelinizin ortalama tahminlerinin gerçeklerden ne kadar uzak olduğuna bakarak önyargıyı ölçebilirsiniz. Farklı eğitim verileriyle tahminlerin ne kadar değiştiğine bakarak da varyansı ölçebilirsiniz.
Yetersiz uyum ve aşırı uyum, gözlemlediğiniz semptomlardır.
Modelinizi eğitip test ettiğinizde ne olduğunu tanımlarlar. Hem eğitim hem test hatası yüksek olduğunda yetersiz uyumu görürsünüz. Eğitim hatası düşük, test hatası yüksek olduğunda aşırı uyumu görürsünüz.
Bağlantı doğrudandır ama bire bir değildir. Yüksek önyargı genellikle yetersiz uyuma, yüksek varyans genellikle aşırı uyuma yol açar. Ancak önyargı ve varyansı orta seviyede olan bir model, ne aşırı ne de yetersiz uyum göstermeden de kötü performans sergileyebilir – örneğin yanlış özellikler veya yetersiz veri kalitesi gibi başka nedenlerle.
Önyargı-varyans sorunlarını teşhis etmek ve daha iyi modelleme kararları almak için son dakikada birkaç ipucu:
Eğitim ve doğrulama hatalarına ayrı ayrı değil, birlikte bakın
Tek başına eğitim hatası genelleme hakkında hiçbir şey söylemez. Eğitim hatası %1 olan bir model, aşırı uyum sağlıyorsa test hatası %50 olabilir.
Neler olduğunu anlamak için iki hatayı karşılaştırın.
- İkisi de yüksekse, önyargınız yüksektir – model fazla basittir
- Eğitim hatası düşük ama doğrulama hatası yüksekse, varyansınız yüksektir – model aşırı uyum sağlıyordur
- Her ikisi de düşükse doğru dengeyi bulmuşsunuzdur
Yalnızca eğitim doğruluğunu optimize etmeyin
Mükemmel eğitim doğruluğu bir uyarı işaretidir. Genellikle, genellenebilir kalıpları öğrenmeden eğitim setini ezberlediğiniz anlamına gelir.
Bunun yerine doğrulama performansına odaklanın. Amacınız, her ikisi de makul ölçüde düşük kalırken eğitim ve doğrulama hatası arasındaki farkı en aza indirmektir.
Güvenilir tahminler için çapraz doğrulama kullanın
Tek bir eğitim-test ayrımı yanıltıcı olabilir; çünkü her sete düşen örneklere bağlıdır. Şanssız bir ayrım, iyi bir modeli kötü; kötü bir modeli iyi gösterebilir.
Çapraz doğrulama, birden çok ayrımda performansı ortalar ve modelinizin yeni veride nasıl performans göstereceğine dair daha stabil bir tahmin verir. Bu, özellikle veriniz sınırlı olduğunda veya hiperparametre ayarı yaptığınızda önemlidir.
Basitlik ve esnekliği veri boyutunuza göre dengeleyin
Küçük veri setlerinde, daha basit modellere yönelin. Öğrenilecek örnek az olduğunda daha stabildirler ve aşırı uyum olasılığı daha düşüktür.
Büyük veri setlerinde, daha karmaşık modellere yönelebilirsiniz; çünkü fazladan veri, öğrenme sürecini stabilize eder ve varyansı azaltır. Ancak sırf mümkün diye karmaşıklık eklemeyin – yalnızca doğrulama performansını iyileştiriyorsa ekleyin.
Sonuç
Sıfır önyargı ve sıfır varyanslı bir model kuramazsınız. Verdiğiniz her modelleme kararı, bu iki hata kaynağı arasındaki dengeyi değiştirir. Karmaşıklık ekleyin, önyargıyı azaltır ama varyansı artırırsınız. Basitleştirin, varyansı azaltır ama önyargıyı artırırsınız.
Model performansı, doğru dengeyi bulmaya bağlıdır. En iyi model, belirli probleminiz ve veri setiniz için önyargı ve varyansı dengeleyerek toplam hatayı en aza indirendir. Bu dengeyi anlamak, modelinizin yüksek önyargı mı yoksa yüksek varyanstan mı muzdarip olduğunu teşhis edip doğru çözümü uygulayabilmenizi sağlar.
Makine öğrenimini uygulamalı olarak deneyimlemeye hazırsanız, Python ile Makine Öğrenimi Temelleri eğitim yolumuza kaydolun. İlk işinizi bulmanıza yardımcı olacak 16 saatlik video içeriği içerir.








Önyargı-varyans dengesi, model performansının sadece karmaşıklık veya doğrulukla ilgili olmadığını açıklar; asıl mesele, modeli ne problemi aşırı basitleştirecek ne de eğitim setinize aşırı uyum sağlayacak şekilde, görülmemiş veriye iyi genelleyecek tatlı noktayı bulmaktır.
Bu yazıda, makine öğreniminde önyargı ve varyansın gerçekte ne anlama geldiğini, birbirlerine nasıl karşıtlık oluşturduklarını ve bu dengeyi anlamanın neden daha sağlam modeller kurmanıza yardımcı olduğunu açıklayacağım.
Makine öğrenimine yeni başladıysanız, 2026'da Makine Öğrenimini Nasıl Öğrenirsiniz başlıklı makalemiz kısa sürede yetkinleşmenize yardımcı olacaktır.
Önyargı Nedir?
Önyargı, verileriniz hakkında gereğinden basit varsayımlar yapmaktan kaynaklanan hatadır. Makine öğrenimi bağlamında, önyargının önyargıcılıkla (prejudice) ilgisi yoktur.
Bir model yüksek önyargıya sahipse, verilerinizdeki gerçek kalıpları yakalamak için fazla katıdır demektir. Bunu, belirgin şekilde eğri olan verilere düz bir çizgi uydurmaya çalışmak gibi düşünün: O çizgiyi nasıl ayarlarsanız ayarlayın, asıl şekle asla uymaz.
Buna yetersiz uyum denir.
Yüksek önyargılı bir model problemi aşırı basitleştirir. İlişkilerin gerçekte olduğundan daha basit olduğunu varsayar ve bu da doğru tahminler yapmasına yardımcı olacak önemli kalıpları kaçırmasına yol açar.
Metrekare, yatak odası sayısı, konum ve evin yaşı gibi değişkenlere göre konut fiyatlarını tahmin ettiğinizi düşünün. Yüksek önyargılı bir model yalnızca metrekareyi kullanıp diğer her şeyi yok sayabilir. Fiyatı yalnızca metrekarenin belirlediğini varsayar ki bu fazlasıyla basittir.
Sonuç olarak hem eğitim verilerinde hem de yeni verilerde kötü performans gösteren bir model elde edersiniz, çünkü gerçek konut fiyatlarının karmaşıklığını yakalayamaz.
Az sayıda özellikli doğrusal regresyon, klasik bir yüksek önyargılı modeldir. Derinliği çok sınırlı karar ağaçları da veriyi yeterince bölüp ince kalıpları bulamadıkları için yüksek önyargı eğilimindedir.
Yüksek önyargı, modelinizin veriden yeterince öğrenmediği; bunun yerine problemi iyi bir doğrulukla çözemeyecek kadar basitleştirdiği anlamına gelir.
Varyans Nedir?
Varyans, modelinizin kullandığınız belirli eğitim verilerine ne kadar duyarlı olduğunu ölçer.
İstatistikteki veri yayılımı ölçüsüyle ilgisi yoktur. Makine öğreniminde varyans, veri dağılımını değil, model davranışını tanımlar.
Bir model yüksek varyansa sahipse, eğitim verilerindeki küçük değişiklikler modelin tahminlerinde büyük değişikliklere yol açar. Başka bir deyişle, aynı modeli birbirine çok yakın iki farklı veri kümesiyle eğitirseniz, bambaşka sonuçlar elde edersiniz.
Buna aşırı uyum denir.
Yüksek varyanslı bir model fazlasıyla esnektir. Verinizdeki gerçek kalıpları değil, aynı zamanda yeni verilere genellenmeyen gürültü ve rastgele dalgalanmaları da öğrenir. Model, temel ilişkileri öğrenmek yerine eğitim örneklerini ezberler.
Hâlâ konut fiyatlarını tahmin ettiğinizi ama bu kez yüzlerce parametreli karmaşık bir model kullandığınızı hayal edin. Eğitim verinizde Oak Street'teki evlerin her zaman tam olarak 427.350 $'a satıldığını öğrenebilir.
Sonuç, eğitim verilerinde harika ama yeni verilerde berbat performans gösteren bir modeldir; çünkü eğitim setine özgü tuhaflıkları öğrenmiştir.
Derin sinir ağları ve sınırsız derinlikte karar ağaçları, klasik yüksek varyanslı modellerdir. Anlamsız olanlar da dahil neredeyse her kalıbı uydurabilecek kadar esnektirler.
Yüksek varyans, modelinizin veriden gereğinden fazla şey öğrendiği anlamına gelir. Sinyalle birlikte gürültüyü de uydurur; bu da modeli yeni örneklerde dengesiz ve güvenilmez kılar.
Önyargı ve Varyans: Temel Farklar
Önyargı ve varyans, tahmin hatasının tamamen farklı iki kaynağıdır. Bu ayrımı anladığınızda, modelinizde neyin yanlış olduğunu daha hızlı teşhis edersiniz.
Önyargı ve varyansın tahmin hatasına etkisi şöyle:
Sorun şu ki birini azaltmak genelde diğerini artırır.
Önyargıyı azaltmak için modelinizi daha karmaşık yaptığınızda, esnekliğini artırırsınız. Bu esneklik modeli eğitim verilerine daha duyarlı kılar ve varyansı yükseltir. Varyansı azaltmak için modelinizi basitleştirdiğinizde, karmaşık kalıpları yakalama kabiliyetini düşürür ve önyargıyı artırırsınız.
Bu ters ilişki, ikisini aynı anda en aza indirememenizin sebebidir. Bunun yerine toplam hatayı en düşük yapan dengeyi bulmalısınız.
Önyargı-Varyans Dengesi Nedir?
Önyargı-varyans dengesi, bu iki hata kaynağı arasındaki gerilimi tanımlar – birini azalttığınızda, neredeyse her zaman diğerini artırırsınız.
Şöyle düşünün: Bir hedefi vurmaya çalışıyorsunuz, ama birbirine karşı çalışan iki sorun var. Daha dikkatli nişan alabilirsiniz (önyargıyı azaltmak), ancak bu sizi rüzgâra ve el titremesine daha duyarlı yapar (varyansı artırır). Ya da daha basit, daha stabil bir atış duruşu kullanabilirsiniz (varyansı azaltmak), ama bu da hassasiyetinizi sınırlar (önyargıyı artırır).
Model karmaşıklığı bu dengenin merkezindedir.
Az sayıda parametreye sahip basit bir model kullandığınızda, yüksek önyargı ve düşük varyans elde edersiniz. Model tutarlı varsayımlar yapar ve farklı eğitim verileriyle çok değişmez; ama karmaşık kalıpları yakalayamaz.
Çok sayıda parametreye sahip karmaşık bir model kullandığınızda, düşük önyargı ve yüksek varyans elde edersiniz. Model girift ilişkileri temsil edebilir; ancak eğittiğiniz spesifik örneklere aşırı duyarlı ve dengesiz hale gelir.
Bunu açıklayan kavramsal eğri şöyledir:
Önyargı-varyans dengesi eğrisi
Aradığınız, birleşik etkilerinin en düşük test hatasını verdiği noktadır.
Her problem için işe yarayan tek bir "mükemmel" model yoktur. Optimal denge, verilerinize, probleminizin karmaşıklığına ve sahip olduğunuz eğitim verisi miktarına bağlıdır. Daha fazla veri, genelde aşırı uydurmadan daha karmaşık modeller kullanmanıza izin verir ve tatlı noktayı sağa kaydırır.
Basit Bir Önyargı-Varyans Dengesi Örneği
Bu kavramı, önyargı ve varyansın pratikte nasıl ortaya çıktığını gösteren gerçekçi bir senaryoyla somutlaştıralım.
Bir şehirde daire kira fiyatlarını tahmin eden bir model kurduğunuzu hayal edin. Metrekare, yatak odası sayısı, mahalle, metroya uzaklık, bina yaşı ve imkânlar gibi özellikleriniz var.
Basit model: Tek özellikli doğrusal regresyon
Yalnızca metrekareyi kullanarak basit doğrusal regresyon ile fiyatı tahmin etmeye karar veriyorsunuz.
Basit model
Karmaşık model: Tüm özelliklerle derin sinir ağı
Şimdi, mevcut tüm özellikleri ve mahalle suç oranları, yürünebilirlik puanları, parklara yakınlık gibi türetilmiş özellikleri kullanarak birden çok gizli katmanlı derin bir sinir ağı kuruyorsunuz.
Karmaşık model
Dengeli model: Temel özelliklerle düzenlileştirilmiş regresyon
Ridge veya Lasso gibi düzenlileştirilmiş bir regresyonu, özenle seçilmiş bir özellik alt kümesiyle kullanıyorsunuz: metrekare, yatak odası sayısı, mahalle kategorisi ve toplu taşımaya uzaklık.
Dengeli model
Dengeli model eğitim verilerinizi mükemmel şekilde uydurmayacaktır ve tam da mesele budur.
Makine Öğrenimi Modellerinde Önyargı-Varyans Dengesi
Farklı makine öğrenimi algoritmaları doğal olarak yüksek önyargı veya yüksek varyans eğilimindedir. Probleminiz için doğru aracı seçmek adına bu eğilimleri anlamanız gerekir.
Doğrusal modeller
Doğrusal regresyon ve lojistik regresyon, tayfın yüksek önyargı tarafında yer alır.
Bu modeller ilişkilerin doğrusal olduğunu varsayar – bir özellik değiştiğinde çıktı sabit bir miktar değişir. Verileriniz doğrusal olmayan kalıplar, eğrisel ilişkiler veya özellikler arası karmaşık etkileşimler içeriyorsa, doğrusal modeller bunları yakalayamaz.
Artısı ise stabilliktir. Doğrusal bir modeli verilerinizin farklı örneklemleri üzerinde eğitirseniz, her seferinde benzer katsayılar elde edersiniz. Düşük varyans, ancak gerçek ilişki doğrusal değilse potansiyel olarak yüksek önyargı.
Karar ağaçları
Karar ağaçları, nasıl yapılandırdığınıza bağlı olarak farklı davranabilir.
Yalnızca birkaç bölünmeye sahip sığ bir ağaç, basit bir model gibi davranır – yüksek önyargı, düşük varyans. Geniş genellemeler yapar ve ince ayrıntılı kalıpları yakalayamaz.
Derinlik sınırı olmayan derin bir ağaç son derece esnek hale gelir. Her yaprakta yalnızca birkaç veri noktası kalana kadar bölmeye devam eder; bu da eğitim verinizi ezberlediği anlamına gelir. Düşük önyargı ama aşırı yüksek varyans – farklı eğitim örneklemleriyle ağaç yapısı dramatik biçimde değişir.
Bu yüzden rastgele ormanlar çok iyi çalışır. Birçok ağacın tahminlerini ortalayarak, önyargıyı düşük tutarken varyans sorununu azaltırlar.
K-en yakın komşu
KNN'in önyargı-varyans dengesi tamamen k seçiminize bağlıdır.
k küçük olduğunda (örneğin k=1 veya k=3), model yüksek varyansa sahiptir. Tahminleri yalnızca birkaç yakın noktaya dayandırır; bu nedenle eğitim setinizdeki belirli örneklere son derece duyarlıdır. Eğitim verilerindeki küçük değişiklikler tamamen farklı tahminlere yol açar.
k büyük olduğunda (örneğin k=50 veya k=100), model yüksek önyargıya sahiptir. O kadar çok komşu üzerinde ortalama alır ki yerel kalıpları düzleştirir ve verideki önemli ayrıntıları kaçırır.
Optimal k değeri, bu iki uç arasında bir yerdedir ve ikisini dengeler.
Sinir ağları
Sinir ağları, öğrenilecek çok sayıda parametreye sahip oldukları için doğası gereği yüksek varyanslı modellerdir.
Birden fazla katman ve yüzlerce nörona sahip bir ağ, son derece karmaşık fonksiyonları temsil edebilir. Bu esneklik düşük önyargı demektir – ağ neredeyse her kalıbı öğrenebilir. Ancak bu aynı zamanda yüksek varyans anlamına gelir – öğrendiğiniz kesin ağırlıklar, belirli eğitim verilerinize, başlangıç değerlerinize ve eğitim sürecinize fazlasıyla bağlıdır.
Bu nedenle sinir ağlarının iyi çalışması için büyük veri setlerine ihtiyaç vardır. Daha fazla eğitim verisi, öğrenme sürecini stabilize eder ve varyansı azaltır. Dropout, batch normalization ve erken durdurma gibi tekniklerin varlık nedeni de budur – hepsi varyansı kontrol etmek ve aşırı uyumu önlemek için tasarlanmıştır.
Daha küçük, daha az katmanlı ve nöronlu ağlar daha yüksek önyargı ama daha düşük varyansa; daha büyük ağlar ise daha düşük önyargı ama daha yüksek varyansa sahiptir.
Model Karmaşıklığı Önyargı ve Varyansı Nasıl Etkiler
Ne yazık ki model karmaşıklığı ölçülebilecek tek bir sayı değildir. Modelinizin farklı kalıpları uydurma esnekliğiyle ilgilidir.
Karmaşıklık; daha fazla özellik, sinir ağında daha fazla katman, daha derin karar ağaçları, regresyonda polinom terimleri veya KNN'de daha düşük k değerleri gibi birden çok kaynaktan gelir. Ortak nokta; bunların, modelinize verideki girift kalıpları uydurma özgürlüğünü daha fazla vermesidir.
Parametre eklediğinizde, modelinize verilerinizdeki ilişkileri temsil etmesi için daha fazla yol verirsiniz. Üç özellikli bir doğrusal model verinizin içinden yalnızca düz bir düzlem geçirebilir. Polinom terimleri ve etkileşim özellikleri eklediğinizde, daha karmaşık kalıplara uyacak şekilde bükülüp kıvrılabilir. Modelin varsayımları daha az kısıtlayıcı hale gelir; bu da daha düşük önyargı demektir.
Ancak bu esneklik bir bedelle gelir; yani varyans artışıyla.
Daha fazla parametre, eğitim verilerinizden öğrenilecek daha fazla değer demektir. Her parametre, belirli eğitim örneklerinize uyacak şekilde ayarlanır; bu da modeli hangi örnekleri dahil ettiğinize daha duyarlı kılar. Birkaç eğitim örneğini değiştirdiğinizde, tüm bu parametreler yeni veriye uyum sağlamak için kayar. Model dengesizleşir.
Bu yüzden yalnızca eğitim hatasına bakmak yanıltıcı ve tehlikelidir.
Karmaşıklığı artırdıkça eğitim hatası her zaman azalır. Modeliniz eğitim verisini giderek daha iyi uydurur ve sonunda neredeyse kusursuz doğruluğa ulaşır. Bu, modelin kalıpları öğrenmek yerine gürültüyü ezberlediğini fark edene kadar harika görünür.
Gerçek performansı, test setindeki hata gösterecektir.
Başlangıçta, karmaşıklık ekledikçe test hatası azalır; çünkü model gerçek kalıpları yakalamaya başlar. Ancak belli bir noktadan sonra, eğitim hatası düşmeye devam etse de test hatası artar. Model aşırı uyum sağlar – eğitim setine özgü tuhaflıkları öğrenir ve bunlar genellenmez.
Eğitim ve test hatası arasındaki küçük fark, modelinizin iyi genelleştiği anlamına gelir. Büyük fark ise aşırı uyum sağladığınızı ve karmaşıklığı azaltmanız veya daha fazla eğitim verisi eklemeniz gerektiğini gösterir.
Önyargı-Varyans Dengesini Yönetme Teknikleri
Önyargı-varyans dengesini ortadan kaldıramazsınız; ancak doğru tekniklerle kontrol edebilirsiniz. İşte birkaç yöntem.
Eğitim/test ayrımları
Modelinizi asla üzerinde eğittiğiniz aynı veriyle değerlendirmeyin.
Başka bir şey yapmadan önce verinizi eğitim ve test setlerine ayırın. Bir bölümde eğitin, diğerinde değerlendirin. Bu, modelinizin yeni veriye ne kadar iyi genelleştiğine dair dürüst bir ölçüm verir.
Test seti, gerçek dünya performansının bir vekili olarak görev yapar. Eğitim hatası düşük ama test hatası yüksekse, aşırı uyum söz konusudur. İkisi de yüksekse, yetersiz uyum vardır.
Çapraz doğrulama
Eğitim/test ayrımlarının bir zayıflığı vardır – her birine düşen belirli örneklere bağlıdırlar.
Çapraz doğrulama, verinizin farklı ayrımlarında birden çok kez eğitip test ederek bunu düzeltir. En yaygın yaklaşım k-katlı çapraz doğrulamadır; verinizi k parçaya bölersiniz, k-1 parça üzerinde eğitir, kalan parça üzerinde test edersiniz. Her parça bir kez test seti olacak şekilde k kez tekrarlarsınız.
Bu, model performansına daha güvenilir bir tahmin verir ve tek bir test setine aşırı uyum sağlamadan hiperparametreleri ayarlamanıza yardımcı olur.
Düzenlileştirme
Düzenlileştirme, model karmaşıklığı için doğrudan kayıp fonksiyonunuza bir ceza ekler.
L1 (Lasso) ve L2 (Ridge) gibi teknikler, büyük parametre değerlerini caydırır; bu da modeli daha basit ve daha stabil kalmaya zorlar. Bu, önyargıyı bir miktar artırır ama varyansı azaltır ve çoğu zaman genel test performansını iyileştirir.
Sinir ağlarında dropout da benzer çalışır – eğitim sırasında nöronları rastgele düşürür; böylece ağın belirli parametrelere aşırı bağımlı olmasını engeller ve aşırı uyumu azaltır.
Daha fazla veri ve daha iyi modeller
Daha fazla eğitim verisi, genellikle yüksek varyans için en iyi çözümdür.
Daha fazla örnek olduğunda, modeliniz öğrenilecek olası kalıpların daha geniş bir örneklemini görür. Bu, gürültüye aşırı uyum sağlamayı zorlaştırır; çünkü gürültü daha çok veri noktasında ortalamaya gelir. Varyans, karmaşık bir modelin düşük önyargısından ödün vermeden azalır.
Ancak daha fazla veri toplamak her zaman pratik veya mümkün değildir.
Veriniz kısıtlıysa, bunun yerine model seçimine odaklanın – daha basit modeller seçin, düzenlileştirme ekleyin veya birden fazla modeli birleştirerek varyansı azaltan topluluk yöntemleri kullanın.
Özellik seçimi
Her özellik modelinizi iyileştirmez. Bazıları yalnızca gürültü katar.
İlgisiz veya fazlalık içeren özellikleri kaldırarak, önemli kalıpları kaybetmeden model karmaşıklığını azaltın. Daha az özellik, öğrenilecek daha az parametre demektir; bu da varyansı düşürür. Ayrıca, sınırlı verili yüksek boyutlu uzaylarda modellerin zorlandığı boyutsallık lanetinden kaçınırsınız.
Korelasyon analizi, ağaç tabanlı modellerden özellik önem puanları veya önemsiz özellikleri otomatik olarak sıfıra çeken düzenlileştirme yöntemleri gibi teknikleri kullanın.
Amaç, sinyali gürültüsüz yakalayan asgari özellik kümesini bulmaktır.
Önyargı-Varyans Dengesi Hakkında Yaygın Yanılgılar
Kötü modelleme kararlarına yol açan üç yaygın hatayı netleştireyim.
"Daha düşük önyargı her zaman daha iyidir"
Yanlış. Daha düşük önyargı, modelinizin karmaşık kalıpları temsil edebileceği anlamına gelir; ancak bu yalnızca bu kalıplar verinizde gerçekten varsa ve yeni örneklere genelleniyorsa faydalıdır.
Karmaşıklık ekleyerek önyargıyı azaltmak, çoğu zaman önyargıdaki azalmadan daha hızlı şekilde varyansı artırır. Eğitim verilerini mükemmel uyduran ama test verilerinde daha kötü performans gösteren bir modelle kalırsınız. Amaç, sadece önyargıyı değil toplam hatayı en aza indirmektir.
Bazen daha yüksek önyargıya sahip daha basit bir model, yeterince düşük varyansla iyi genelleştiği için genel olarak daha iyi performans gösterebilir.
"Aşırı uyum demek model kötüdür"
Tam olarak değil. Aşırı uyum, modelinizin elinizdeki veri miktarı için fazla karmaşık olduğu anlamına gelir; ama modelin kendisi doğası gereği kötü değildir.
1.000 eğitim örneğinde aşırı uyum sağlayan aynı sinir ağı mimarisi, 100.000 örnekte mükemmel performans gösterebilir. Sorun, kapasite ile veri boyutu arasındaki uyumsuzluktadır.
Aşırı uyumu, daha fazla veri ekleyerek, karmaşıklığı azaltarak veya düzenlileştirme uygulayarak düzeltebilirsiniz. Modeli çöpe atıp tamamen farklı bir şeyle yeniden başlamak gerekmez.
"Daha fazla veri her zaman varyansı düzeltir"
Daha fazla veri varyansı azaltır; ancak onu ortadan kaldırmaz ve faydasının da sınırları vardır.
Modeliniz probleminize göre aşırı derecede karmaşıksa, büyük veri setleri bile yeterince stabilize etmeyebilir. Milyonlarca parametreli bir sinir ağının iyi eğitilmesi için muazzam miktarda veriye ihtiyaç vardır.
Ayrıca, yalnızca yeni verinizle aynı dağılımı temsil eden daha fazla veri eklemek yardımcı olur. Önyargılı veya düşük kaliteli daha fazla veri toplamak varyansı azaltmaz – genellenmeyen kalıpları pekiştirerek işleri daha da kötüleştirebilir.
Önyargı-Varyans Dengesi vs. Aşırı Uyum ve Yetersiz Uyum
Önyargı-varyans ve aşırı uyum–yetersiz uyum, aynı sorunları farklı açılardan tanımlar; ancak birbirlerinin yerine geçen terimler değildir.
Unutmamanız gerekenler şunlardır:
Önyargı ve varyans, modelinizin özellikleridir.
Farklı eğitim setleri arasında modelinizin nasıl davrandığını tanımlarlar. Modelinizin ortalama tahminlerinin gerçeklerden ne kadar uzak olduğuna bakarak önyargıyı ölçebilirsiniz. Farklı eğitim verileriyle tahminlerin ne kadar değiştiğine bakarak da varyansı ölçebilirsiniz.
Yetersiz uyum ve aşırı uyum, gözlemlediğiniz semptomlardır.
Modelinizi eğitip test ettiğinizde ne olduğunu tanımlarlar. Hem eğitim hem test hatası yüksek olduğunda yetersiz uyumu görürsünüz. Eğitim hatası düşük, test hatası yüksek olduğunda aşırı uyumu görürsünüz.
Bağlantı doğrudandır ama bire bir değildir. Yüksek önyargı genellikle yetersiz uyuma, yüksek varyans genellikle aşırı uyuma yol açar. Ancak önyargı ve varyansı orta seviyede olan bir model, ne aşırı ne de yetersiz uyum göstermeden de kötü performans sergileyebilir – örneğin yanlış özellikler veya yetersiz veri kalitesi gibi başka nedenlerle.
Model Performansını Yorumlamak İçin Pratik İpuçları
Önyargı-varyans sorunlarını teşhis etmek ve daha iyi modelleme kararları almak için son dakikada birkaç ipucu:
Eğitim ve doğrulama hatalarına ayrı ayrı değil, birlikte bakın
Tek başına eğitim hatası genelleme hakkında hiçbir şey söylemez. Eğitim hatası %1 olan bir model, aşırı uyum sağlıyorsa test hatası %50 olabilir.
Neler olduğunu anlamak için iki hatayı karşılaştırın.
Yalnızca eğitim doğruluğunu optimize etmeyin
Mükemmel eğitim doğruluğu bir uyarı işaretidir. Genellikle, genellenebilir kalıpları öğrenmeden eğitim setini ezberlediğiniz anlamına gelir.
Bunun yerine doğrulama performansına odaklanın. Amacınız, her ikisi de makul ölçüde düşük kalırken eğitim ve doğrulama hatası arasındaki farkı en aza indirmektir.
Güvenilir tahminler için çapraz doğrulama kullanın
Tek bir eğitim-test ayrımı yanıltıcı olabilir; çünkü her sete düşen örneklere bağlıdır. Şanssız bir ayrım, iyi bir modeli kötü; kötü bir modeli iyi gösterebilir.
Çapraz doğrulama, birden çok ayrımda performansı ortalar ve modelinizin yeni veride nasıl performans göstereceğine dair daha stabil bir tahmin verir. Bu, özellikle veriniz sınırlı olduğunda veya hiperparametre ayarı yaptığınızda önemlidir.
Basitlik ve esnekliği veri boyutunuza göre dengeleyin
Küçük veri setlerinde, daha basit modellere yönelin. Öğrenilecek örnek az olduğunda daha stabildirler ve aşırı uyum olasılığı daha düşüktür.
Büyük veri setlerinde, daha karmaşık modellere yönelebilirsiniz; çünkü fazladan veri, öğrenme sürecini stabilize eder ve varyansı azaltır. Ancak sırf mümkün diye karmaşıklık eklemeyin – yalnızca doğrulama performansını iyileştiriyorsa ekleyin.
Sonuç
Sıfır önyargı ve sıfır varyanslı bir model kuramazsınız. Verdiğiniz her modelleme kararı, bu iki hata kaynağı arasındaki dengeyi değiştirir. Karmaşıklık ekleyin, önyargıyı azaltır ama varyansı artırırsınız. Basitleştirin, varyansı azaltır ama önyargıyı artırırsınız.
Model performansı, doğru dengeyi bulmaya bağlıdır. En iyi model, belirli probleminiz ve veri setiniz için önyargı ve varyansı dengeleyerek toplam hatayı en aza indirendir. Bu dengeyi anlamak, modelinizin yüksek önyargı mı yoksa yüksek varyanstan mı muzdarip olduğunu teşhis edip doğru çözümü uygulayabilmenizi sağlar.
Makine öğrenimini uygulamalı olarak deneyimlemeye hazırsanız, Python ile Makine Öğrenimi Temelleri eğitim yolumuza kaydolun. İlk işinizi bulmanıza yardımcı olacak 16 saatlik video içeriği içerir.