बायस-वेरीयंस ट्रेडऑफ बताता है कि प्रदर्शन सिर्फ जटिलता या सटीकता का मामला नहीं है—असल में लक्ष्य वह संतुलन खोजना है जहाँ आपका मॉडल समस्या को अतिसरलीकृत किए बिना और ट्रेनिंग सेट पर ओवरफिट हुए बिना, अनदेखे डेटा पर अच्छी तरह सामान्यीकृत करे।
इस लेख में, मैं समझाऊँगा कि मशीन लर्निंग में बायस और वेरीयंस का वास्तविक अर्थ क्या है, वे एक-दूसरे के साथ कैसे ट्रेडऑफ करते हैं, और इस ट्रेडऑफ को समझना आपको अधिक मजबूत मॉडल बनाने में क्यों मदद करता है।
यदि आप मशीन लर्निंग में नए हैं, तो हमारा 2026 में मशीन लर्निंग कैसे सीखें लेख आपको जल्दी दक्ष बना देगा।
बायस क्या है?
बायस वह त्रुटि है जो आपके डेटा के बारे में अत्यधिक सरल मान्यताओं से आती है। इसका पक्षपात (prejudice) से कोई संबंध नहीं है, कम से कम मशीन लर्निंग के संदर्भ में तो नहीं।
जब किसी मॉडल में बायस अधिक होता है, तो इसका मतलब है कि मॉडल आपके डेटा के वास्तविक पैटर्न पकड़ने के लिए बहुत कठोर है। इसे ऐसे समझें जैसे आप ऐसे डेटा पर सीधी रेखा फिट करने की कोशिश कर रहे हों जो स्पष्ट रूप से मुड़ता है: आप रेखा को जितना भी समायोजित करें, वह असली आकार से मेल नहीं खाएगी।
इसे अंडरफिटिंग कहते हैं।
उच्च-बायस मॉडल समस्या को अतिसरलीकृत कर देता है। वह संबंधों को वास्तविकता से अधिक सरल मानता है, इसलिए वे महत्वपूर्ण पैटर्न चूक जाता है जो सटीक भविष्यवाणी में मदद करते।
मान लें आप घर की कीमत का अनुमान वर्गफुट, बेडरूम की संख्या, स्थान और घर की उम्र के आधार पर लगा रहे हैं। उच्च-बायस मॉडल शायद केवल वर्गफुट का उपयोग करेगा और बाकी सबको नज़रअंदाज़ करेगा। वह मानता है कि केवल वर्गफुट ही कीमत तय करता है, जो अत्यधिक सरल है।
नतीजा यह होता है कि मॉडल ट्रेनिंग और नए दोनों डेटा पर खराब प्रदर्शन करता है क्योंकि वह वास्तविक घर की कीमतों की जटिलता को पकड़ नहीं पाता।
कम फीचर्स वाली लीनियर रिग्रेशन एक क्लासिक उच्च-बायस मॉडल है। बहुत सीमित गहराई वाले डिसीजन ट्री भी प्रायः उच्च बायस रखते हैं क्योंकि वे सूक्ष्म पैटर्न खोजने हेतु पर्याप्त बार डेटा को विभाजित नहीं कर पाते।
उच्च बायस का अर्थ है कि आपका मॉडल डेटा से पर्याप्त नहीं सीख रहा, बल्कि समस्या को इतना सरल बना रहा है कि अच्छी सटीकता से हल ही नहीं हो पा रही।
वेरीयंस क्या है?
वेरीयंस यह मापता है कि आपका मॉडल इस्तेमाल किए गए विशिष्ट ट्रेनिंग डेटा के प्रति कितना संवेदनशील है।
इसका डेटा फैलाव के सांख्यिकीय माप से कोई लेना-देना नहीं। मशीन लर्निंग में, वेरीयंस मॉडल के व्यवहार का वर्णन करता है, न कि डेटा वितरण का।
जब किसी मॉडल में वेरीयंस अधिक होता है, तो ट्रेनिंग डेटा में छोटे बदलाव भी मॉडल की भविष्यवाणियों में बड़े बदलाव ला देते हैं। यानी, यदि आप एक ही मॉडल को दो थोड़ा भिन्न डाटासेट्स पर ट्रेन करें, तो परिणाम बहुत अलग हो सकते हैं।
इसे ओवरफिटिंग कहते हैं।
उच्च-वेरीयंस मॉडल बहुत लचीला होता है। वह आपके डेटा के वास्तविक पैटर्न के साथ-साथ उस शोर और यादृच्छिक उतार-चढ़ाव को भी सीख लेता है जो नए डेटा पर सामान्यीकृत नहीं होते। मॉडल मूल संबंधों को सीखने के बजाय ट्रेनिंग उदाहरणों को रट लेता है।
मान लें आप अभी भी घर की कीमतों की भविष्यवाणी कर रहे हैं, पर अब आप सैकड़ों पैरामीटर्स वाला एक जटिल मॉडल उपयोग कर रहे हैं। यह सीख सकता है कि Oak Street पर घर हमेशा ठीक $427,350 में बिकते हैं, क्योंकि आपके ट्रेनिंग डेटा में ऐसा ही था।
नतीजा यह होता है कि मॉडल ट्रेनिंग डेटा पर शानदार प्रदर्शन करता है लेकिन नए डेटा पर बहुत खराब, क्योंकि उसने ट्रेनिंग सेट की विशिष्ट विचित्रताओं को सीख लिया है।
डीप न्यूरल नेटवर्क और असीमित गहराई वाले डिसीजन ट्री उच्च-वेरीयंस मॉडलों के क्लासिक उदाहरण हैं। इनमें लगभग किसी भी पैटर्न—यहाँ तक कि निरर्थक—को फिट करने की पर्याप्त लचीलापन होता है।
उच्च वेरीयंस का मतलब है कि आपका मॉडल डेटा से बहुत अधिक सीख रहा है। यह सिग्नल के साथ शोर को भी फिट कर देता है, जिससे वह नए उदाहरणों पर अस्थिर और अविश्वसनीय हो जाता है।
बायस बनाम वेरीयंस: मुख्य अंतर
बायस और वेरीयंस भविष्यवाणी-त्रुटि के दो बिल्कुल अलग स्रोत हैं। एक बार जब आप फर्क समझ लेते हैं, तो आप अपने मॉडल में क्या गड़बड़ है, यह जल्दी पहचान पाएँगे।
- बायस आपके मॉडल की मान्यताओं से आता है। यह उस एल्गोरिद्म, चुने गए फीचर्स और समस्या की संरचना से संबंधित है। लीनियर रिग्रेशन रैखिक संबंध मानता है, इसलिए जब वास्तविक संबंध नॉन-लिनियर हो, तो उसमें बायस रहता है। यह त्रुटि तो तब भी मौजूद है जब आपने ट्रेनिंग डेटा देखा ही नहीं।
- वेरीयंस ट्रेनिंग डेटा के प्रति संवेदनशीलता से आता है। यह बताता है कि एक ही जनसंख्या से अलग-अलग सैंपल्स पर ट्रेन करने से आपका मॉडल कितना बदल जाता है। उच्च वेरीयंस वाला मॉडल थोड़े भिन्न ट्रेनिंग सेट्स से अलग-अलग पैटर्न सीखता है, जिससे उसकी भविष्यवाणियाँ अस्थिर हो जाती हैं।
भविष्यवाणी-त्रुटि पर बायस और वेरीयंस का असर ऐसे होता है:
- उच्च बायस का अर्थ है कि आपका मॉडल एक ही दिशा में लगातार गलतियाँ करता है। वह हमेशा कुछ पैटर्न को कम आँकता या अधिक आँकता है क्योंकि वह वास्तविक संबंध को प्रस्तुत नहीं कर पाता। त्रुटियाँ प्रणालीगत और पूर्वानुमेय होती हैं।
- उच्च वेरीयंस का अर्थ है कि आपका मॉडल असंगत गलतियाँ करता है जो डेटा के साथ बदलती हैं। सोमवार के डेटा पर ट्रेन करें तो एक बात, मंगलवार के डेटा पर ट्रेन करें तो बिल्कुल अलग। त्रुटियाँ यादृच्छिक और अप्रत्याशित होती हैं।
समस्या यह है कि एक को घटाने पर आमतौर पर दूसरा बढ़ता है।
जब आप बायस घटाने के लिए मॉडल को अधिक जटिल बनाते हैं, तो आप उसकी लचीलापन बढ़ाते हैं। यह लचीलापन उसे ट्रेनिंग डेटा के प्रति अधिक संवेदनशील बना देता है, जिससे वेरीयंस बढ़ता है। जब आप वेरीयंस घटाने के लिए मॉडल को सरल बनाते हैं, तो आप उसकी जटिल पैटर्न पकड़ने की क्षमता घटा देते हैं, जिससे बायस बढ़ता है।
यह व्युत्क्रम संबंध बताता है कि आप दोनों को एक साथ न्यूनतम नहीं कर सकते। इसके बजाय, आपको वह संतुलन खोजना होता है जो कुल त्रुटि को सबसे कम करे।
बायस-वेरीयंस ट्रेडऑफ क्या है?
बायस-वेरीयंस ट्रेडऑफ इन दोनों त्रुटि-स्रोतों के बीच के तनाव का वर्णन करता है—एक घटाएँ, तो लगभग हमेशा दूसरा बढ़ता है।
इसे ऐसे समझें: आप एक निशाने पर लगा रहे हैं, पर दो समस्याएँ एक-दूसरे के खिलाफ काम कर रही हैं। आप और सावधानी से निशाना लगा सकते हैं (बायस घटाएँ), लेकिन उससे आप हवा और हाथ के काँपने के प्रति अधिक संवेदनशील हो जाते हैं (वेरीयंस बढ़ेगा)। या आप सरल, अधिक स्थिर शूटिंग मुद्रा अपनाते हैं (वेरीयंस घटाएँ), पर उससे परिशुद्धता सीमित हो जाती है (बायस बढ़ेगा)।
मॉडल जटिलता इस ट्रेडऑफ के केंद्र में है।
जब आप कम पैरामीटर्स वाला सरल मॉडल उपयोग करते हैं, तो आपको उच्च बायस और निम्न वेरीयंस मिलता है। मॉडल सुसंगत मान्यताएँ बनाता है और अलग-अलग ट्रेनिंग डेटा से ज़्यादा नहीं बदलता, पर जटिल पैटर्न पकड़ नहीं पाता।
जब आप अधिक पैरामीटर्स वाला जटिल मॉडल उपयोग करते हैं, तो बायस कम और वेरीयंस अधिक होता है। मॉडल जटिल संबंधों को दर्शा सकता है, पर वह अस्थिर और उन विशिष्ट उदाहरणों के प्रति अत्यधिक संवेदनशील हो जाता है जिन पर आपने उसे ट्रेन किया।
इसका वैचारिक वक्र कुछ ऐसा दिखता है:
- बाएँ तरफ (सरल मॉडल): ट्रेनिंग त्रुटि अधिक है क्योंकि मॉडल अंडरफिट करता है। टेस्ट त्रुटि भी अधिक है क्योंकि मॉडल वास्तविक पैटर्न चूक जाता है।
- बीच में (संतुलित मॉडल): ट्रेनिंग और टेस्ट दोनों त्रुटियाँ कम हैं। मॉडल शोर याद किए बिना वास्तविक पैटर्न पकड़ता है। यही आपकी मीठी जगह है।
- दाएँ तरफ (जटिल मॉडल): ट्रेनिंग त्रुटि बहुत कम है क्योंकि मॉडल सबकुछ फिट कर देता है। टेस्ट त्रुटि अधिक है क्योंकि मॉडल ने शोर सीख लिया है।
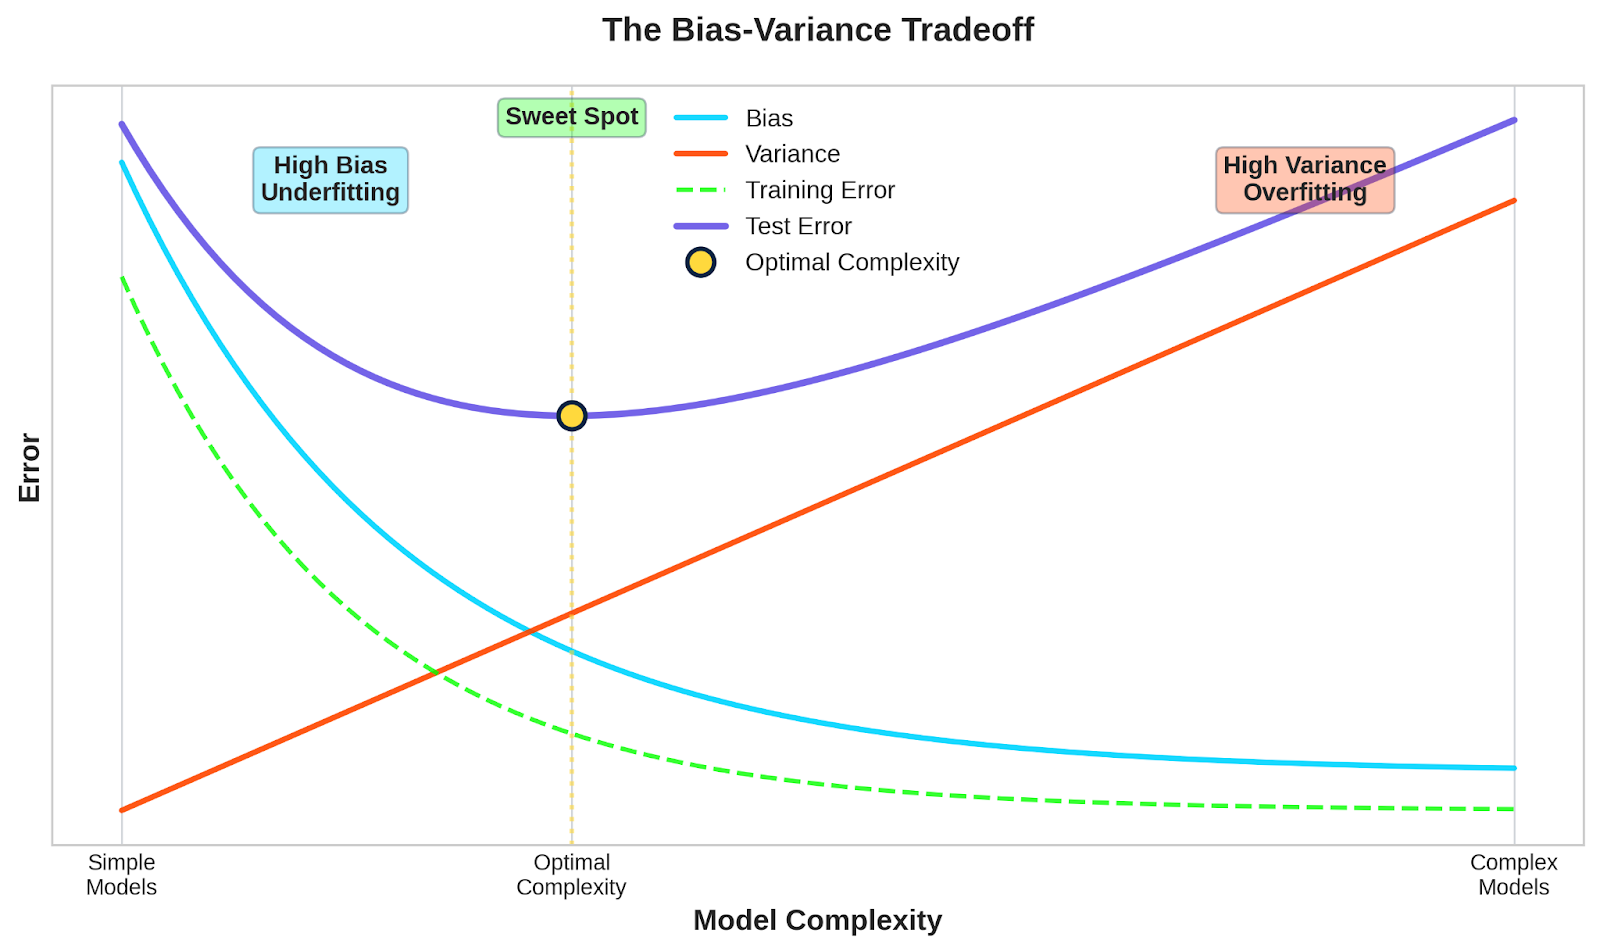
बायस-वेरीयंस ट्रेडऑफ वक्र
आप वह बिंदु खोज रहे हैं जहाँ इनका संयुक्त प्रभाव आपको सबसे कम टेस्ट त्रुटि देता है।
हर समस्या के लिए कोई एकल "परफेक्ट" मॉडल नहीं होता। सर्वोत्तम संतुलन आपके डेटा, समस्या की जटिलता और उपलब्ध ट्रेनिंग डेटा की मात्रा पर निर्भर करता है। अधिक डेटा आमतौर पर आपको अधिक जटिल मॉडल बिना ओवरफिटिंग के उपयोग करने देता है, जिससे मीठी जगह दाईं ओर खिसक जाती है।
एक सरल बायस-वेरीयंस ट्रेडऑफ उदाहरण
आईए इसे एक वास्तविक परिदृश्य से ठोस बनाते हैं, जो दिखाता है कि व्यवहार में बायस और वेरीयंस कैसे प्रभाव डालते हैं।
मान लें आप किसी शहर में अपार्टमेंट किराये की कीमत का अनुमान लगाने के लिए मॉडल बना रहे हैं। आपके पास वर्गफुट, बेडरूम की संख्या, पड़ोस, मेट्रो से दूरी, बिल्डिंग की उम्र और सुविधाओं जैसे फीचर्स हैं।
सरल मॉडल: एक फीचर वाली लीनियर रिग्रेशन
आप केवल वर्गफुट का उपयोग कर सिंपल लीनियर रिग्रेशन से कीमत का अनुमान लगाने का निर्णय लेते हैं।
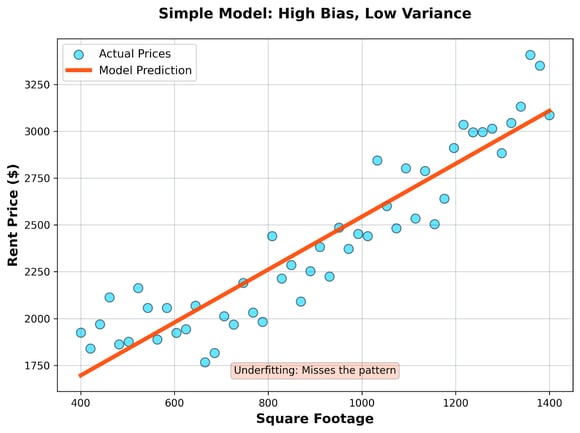
सरल मॉडल
- क्या होता है: मॉडल आपके डेटा बिंदुओं के बीच सीधी रेखा खींचता है। यह अनुमान लगाता है कि हर 100 वर्गफुट से किराए में एक निश्चित राशि जुड़ती है, स्थान या अन्य कारकों की परवाह किए बिना।
- परिणाम: इस मॉडल में उच्च बायस और निम्न वेरीयंस है। यह लग्ज़री अपार्टमेंट्स का कम अनुमान और स्टूडियो अपार्टमेंट्स का अधिक अनुमान लगाता है क्योंकि यह विभिन्न पड़ोसों में आकार और कीमत के जटिल संबंध को पकड़ नहीं सकता। लेकिन यदि आप इसे अपार्टमेंट्स के अलग-अलग सैंपल्स पर ट्रेन करें, तो हर बार लगभग वही रेखा मिलेगी—यह स्थिर है लेकिन सटीक नहीं।
जटिल मॉडल: सभी फीचर्स वाला डीप न्यूरल नेटवर्क
अब आप सभी उपलब्ध फीचर्स के साथ, और साथ ही इंजीनियर किए गए फीचर्स जैसे पड़ोस का अपराध दर, वॉकएबिलिटी स्कोर और पार्क की निकटता सहित, कई हिडन लेयर्स वाला डीप न्यूरल नेटवर्क बनाते हैं।
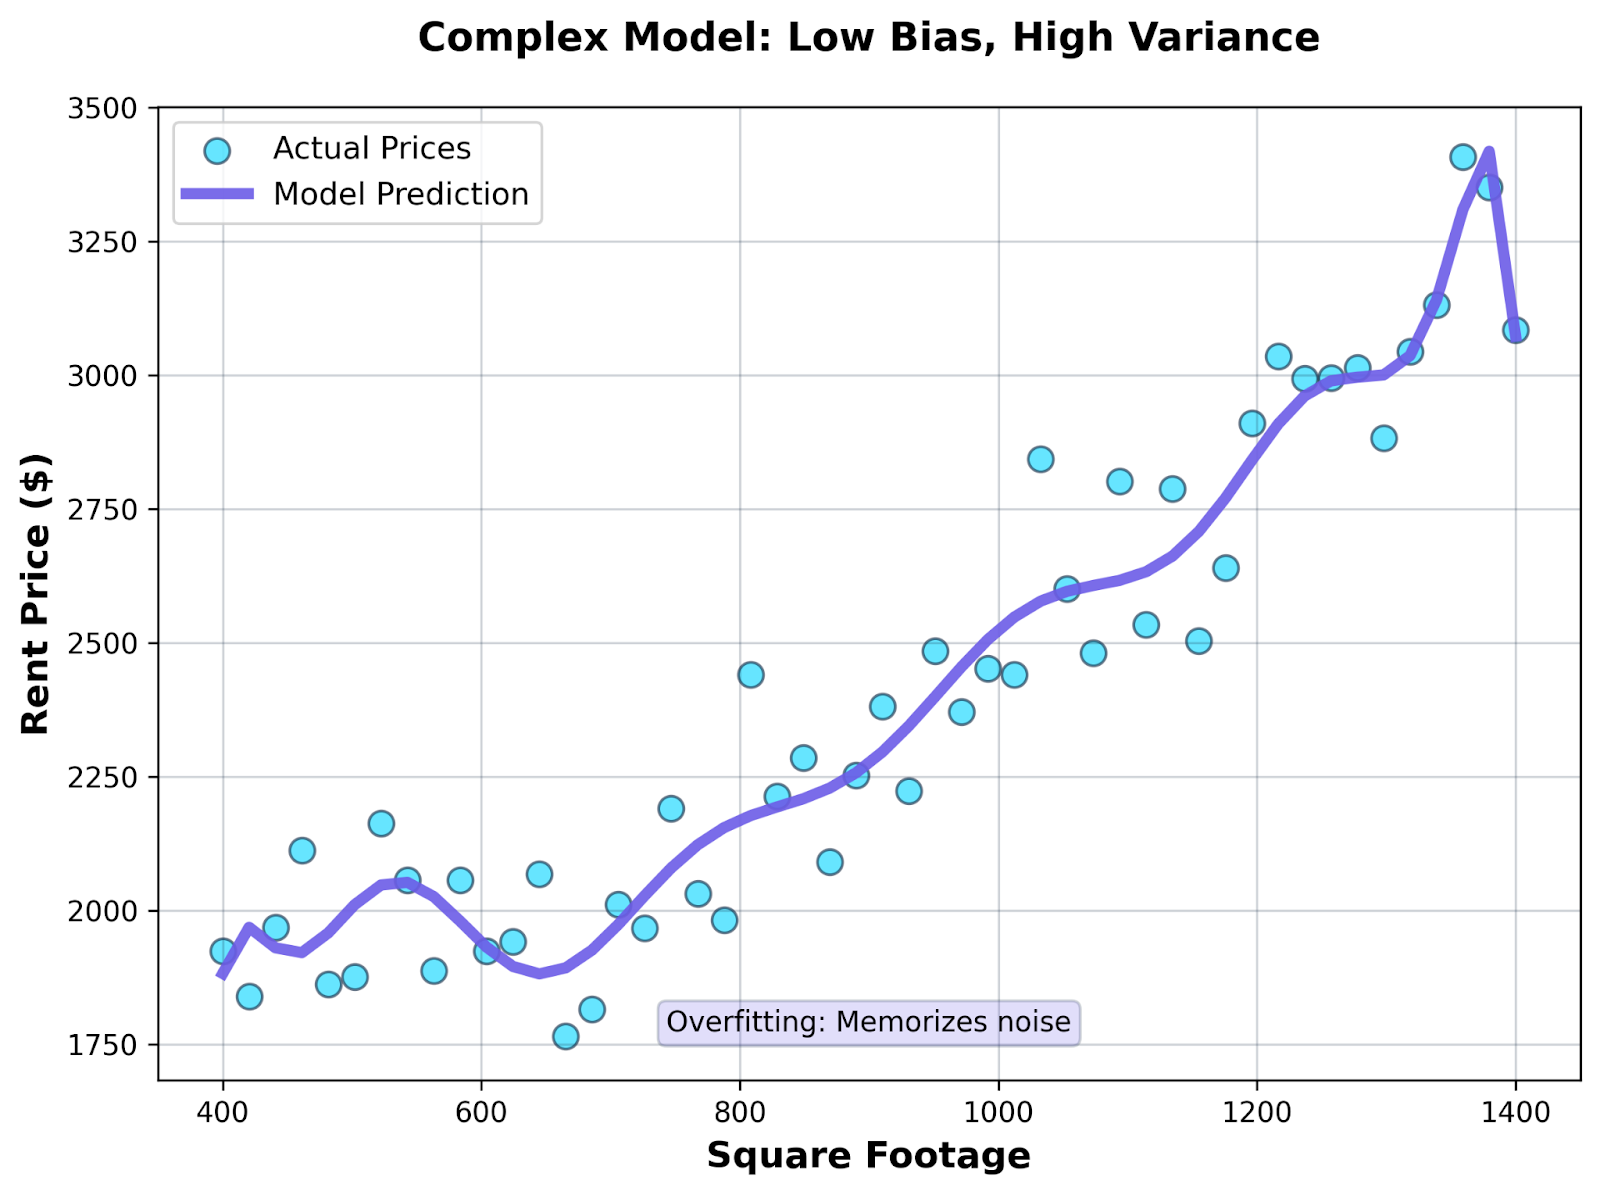
जटिल मॉडल
- क्या होता है: नेटवर्क सूक्ष्म पैटर्न सीखता है। यह यह भी खोज सकता है कि आपके विशिष्ट ट्रेनिंग डेटा में 5वीं मंजिल के अपार्टमेंट हमेशा ठीक $2,847 में किराये पर जाते हैं, या Oak Street की उत्तर की ओर मुख वाले यूनिट्स दक्षिण की ओर वालों से 37% अधिक किराये पर जाते हैं।
- परिणाम: इस मॉडल में निम्न बायस और उच्च वेरीयंस है। यह ट्रेनिंग डेटा को लगभग पूर्णतः फिट कर, हर विवरण और उतार-चढ़ाव पकड़ लेता है। पर ये पैटर्न सामान्यीकृत नहीं होते—ये आपके सैंपल-विशिष्ट कलाकृतियाँ हैं। इसे अलग अपार्टमेंट सेट पर ट्रेन करें, तो यह बिल्कुल अलग पैटर्न सीख लेता है। भविष्यवाणियाँ नई डेटा पर अस्थिर और अविश्वसनीय होती हैं।
संतुलित मॉडल: प्रमुख फीचर्स के साथ नियमितीकृत रिग्रेशन
आप नियमितीकृत रिग्रेशन (जैसे Ridge या Lasso) का उपयोग फीचर्स के सावधानी से चुने गए सबसेट—वर्गफुट, बेडरूम्स, पड़ोस श्रेणी, और ट्रांज़िट तक की दूरी—के साथ करते हैं।
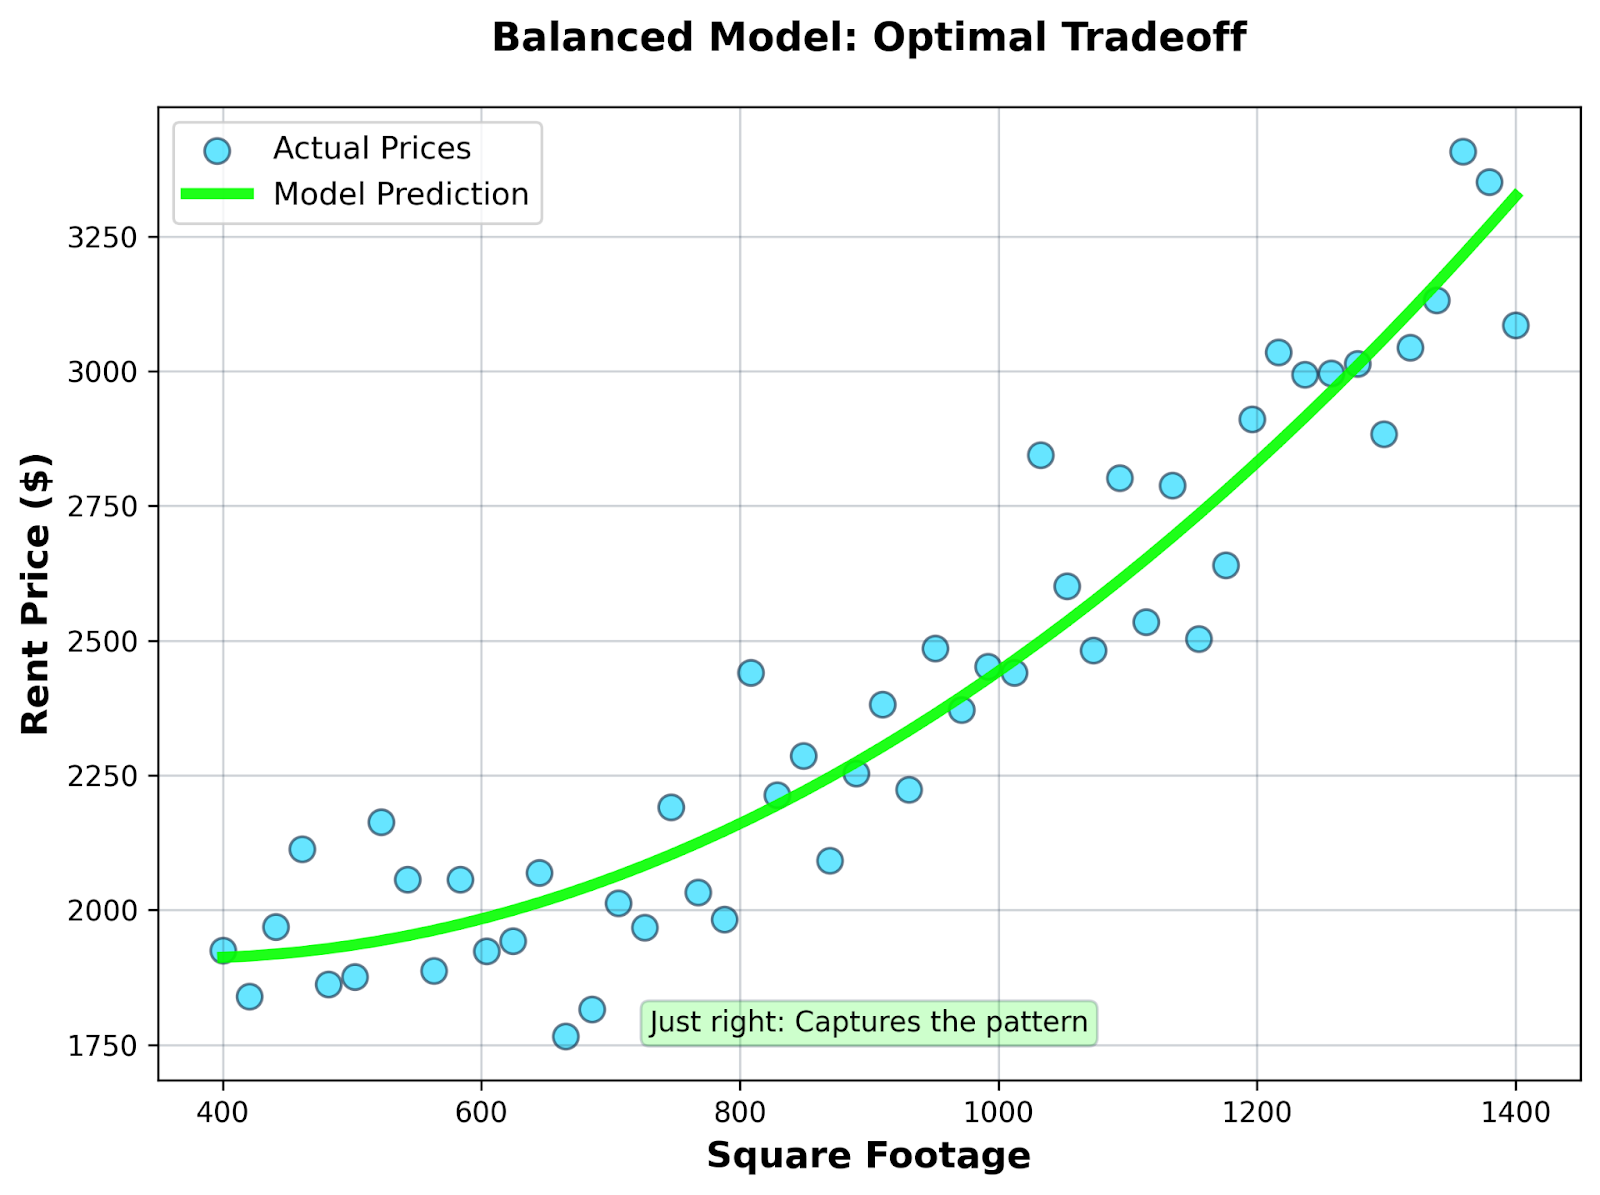
संतुलित मॉडल
- क्या होता है: मॉडल शोर याद किए बिना मुख्य संबंधों को पकड़ता है। यह सीखता है कि आकार और स्थान मायने रखते हैं, पर ट्रेनिंग डेटा के हर छोटे उतार-चढ़ाव पर नहीं अटकता।
- परिणाम: यह मॉडल बायस और वेरीयंस का संतुलन बनाता है। यह वास्तविक पैटर्न पकड़ने जितना लचीला है, पर ओवरफिटिंग से बचने जितना नियंत्रित। ट्रेनिंग त्रुटि मध्यम है, पर टेस्ट त्रुटि कम—और नए अपार्टमेंट्स पर भविष्यवाणी के लिए यही सबसे महत्वपूर्ण है।
संतुलित मॉडल आपका ट्रेनिंग डेटा पूरी तरह फिट नहीं करेगा—और यही बात मायने रखती है।
मशीन लर्निंग मॉडलों में बायस-वेरीयंस ट्रेडऑफ
अलग-अलग मशीन लर्निंग एल्गोरिद्म स्वाभाविक तौर पर या तो उच्च बायस या उच्च वेरीयंस की ओर झुकते हैं। सही टूल चुनने के लिए आपको इन प्रवृत्तियों को समझना होगा।
लिनियर मॉडल
लिनियर रिग्रेशन और लॉजिस्टिक रिग्रेशन स्पेक्ट्रम के उच्च-बायस छोर पर हैं।
ये मॉडल मानते हैं कि संबंध रैखिक हैं—एक फीचर बदले तो आउटपुट एक निश्चित मात्रा से बदलता है। जब आपके डेटा में नॉन-लिनियर पैटर्न, वक्र संबंध, या फीचर्स के बीच जटिल अंतःक्रियाएँ हों, तो लिनियर मॉडल उन्हें पकड़ नहीं पाते।
फायदा स्थिरता है। अलग-अलग सैंपल्स पर लिनियर मॉडल ट्रेन करें, तो हर बार मिलते-जुलते गुणांक मिलेंगे। वेरीयंस कम, पर यदि वास्तविक संबंध रैखिक नहीं है तो बायस अधिक हो सकता है।
डिसीजन ट्री
डिसीजन ट्री का व्यवहार इस पर निर्भर करता है कि आप उन्हें कैसे कॉन्फ़िगर करते हैं।
कुछ ही स्प्लिट्स वाला उथला ट्री एक सरल मॉडल जैसा व्यवहार करता है—उच्च बायस, निम्न वेरीयंस। यह व्यापक सामान्यीकरण करता है और सूक्ष्म पैटर्न पकड़ नहीं पाता।
बिना गहराई-सीमा वाला गहरा ट्री अत्यधिक लचीला हो जाता है। यह तब तक स्प्लिट करता रहता है जब तक प्रत्येक पत्ती में कुछ ही डेटा बिंदु रह जाते हैं, यानी यह आपका ट्रेनिंग डेटा याद कर लेता है। बायस कम, पर वेरीयंस बहुत अधिक—अलग ट्रेनिंग सैंपल्स पर ट्री की संरचना नाटकीय रूप से बदलती है।
यही कारण है कि रैंडम फॉरेस्ट अच्छे से काम करते हैं। वे कई ट्री की भविष्यवाणियों का औसत लेते हैं, जिससे वेरीयंस की समस्या घटती है जबकि बायस कम ही रहता है।
K-nearest neighbors
KNN का बायस-वेरीयंस संतुलन पूरी तरह आपके k के चयन पर निर्भर करता है।
जब k छोटा होता है (जैसे k=1 या k=3), मॉडल में वेरीयंस अधिक होता है। यह बस कुछ नज़दीकी बिंदुओं पर आधारित भविष्यवाणी करता है, इसलिए ट्रेनिंग सेट में मौजूद विशिष्ट उदाहरणों के प्रति अत्यधिक संवेदनशील होता है। ट्रेनिंग डेटा में छोटे बदलाव पूरी तरह अलग भविष्यवाणियों तक ले जाते हैं।
जब k बड़ा होता है (जैसे k=50 या k=100), मॉडल में बायस अधिक होता है। यह इतने अधिक पड़ोसियों पर औसत लेता है कि स्थानीय पैटर्न समतल हो जाते हैं और डेटा के महत्वपूर्ण विवरण छूट जाते हैं।
सर्वोत्तम k मान बीच में कहीं होता है, जो इन दोनों अतियों का संतुलन बनाता है।
न्यूरल नेटवर्क
न्यूरल नेटवर्क स्वाभाविक रूप से उच्च-वेरीयंस मॉडल होते हैं क्योंकि उन्हें बहुत सारे पैरामीटर्स सीखने होते हैं।
कई लेयर्स और सैकड़ों न्यूरॉन्स वाला नेटवर्क अत्यंत जटिल फंक्शन्स को निरूपित कर सकता है। यह लचीलापन निम्न बायस देता है—नेटवर्क लगभग कोई भी पैटर्न सीख सकता है। पर इसका मतलब उच्च वेरीयंस भी है—सीखे गए सटीक वेट्स आपके विशिष्ट ट्रेनिंग डेटा, इनिशियलाइज़ेशन और ट्रेनिंग प्रक्रिया पर बहुत निर्भर करते हैं।
इसीलिए न्यूरल नेटवर्क को अच्छे से काम करने के लिए बड़े डाटासेट्स चाहिए। अधिक ट्रेनिंग डेटा सीखने की प्रक्रिया को स्थिर करता है और वेरीयंस घटाता है। इसी कारण dropout, बैच नॉर्मलाइज़ेशन और अर्ली स्टॉपिंग जैसी तकनीकें हैं—ये सभी वेरीयंस नियंत्रित करने और ओवरफिटिंग रोकने के लिए बनी हैं।
कम लेयर्स और न्यूरॉन्स वाले छोटे नेटवर्क में बायस अधिक पर वेरीयंस कम होता है, जबकि बड़े नेटवर्क में बायस कम पर वेरीयंस अधिक।
मॉडल जटिलता बायस और वेरीयंस को कैसे प्रभावित करती है
दुर्भाग्यवश, मॉडल जटिलता कोई एकल संख्या नहीं है जिसे आप नाप लें। यह इस बारे में है कि आपका मॉडल अलग-अलग पैटर्न्स को फिट करने में कितना लचीला है।
जटिलता कई स्रोतों से आती है—जैसे अधिक फीचर्स, न्यूरल नेटवर्क में अधिक लेयर्स, गहरे डिसीजन ट्री, रिग्रेशन में पॉलीनॉमियल टर्म्स, या KNN में कम k मान। सामान्य सूत्र यह है कि ये सब आपके मॉडल को डेटा में सूक्ष्म पैटर्न फिट करने की अधिक स्वतंत्रता देते हैं।
जब आप पैरामीटर्स बढ़ाते हैं, तो आप अपने मॉडल को डेटा में संबंधों को दर्शाने के अधिक तरीके दे रहे होते हैं। 3 फीचर्स वाला लिनियर मॉडल आपके डेटा के बीच सिर्फ एक सपाट समतल खींच सकता है। यदि आप पॉलीनॉमियल टर्म्स और इंटरेक्शन फीचर्स जोड़ते हैं, तो यह अधिक जटिल पैटर्न से मेल खाने के लिए मुड़-तुड़ सकता है। मॉडल की मान्यताएँ कम प्रतिबंधात्मक हो जाती हैं, यानी बायस कम होता है।
पर यह लचीलापन एक कीमत पर आता है, अर्थात वेरीयंस में वृद्धि।
अधिक पैरामीटर्स का अर्थ है ट्रेनिंग डेटा से सीखने के लिए अधिक मान। प्रत्येक पैरामीटर आपके विशिष्ट ट्रेनिंग उदाहरणों के अनुसार ट्यून होता है, जिससे मॉडल इस बात के प्रति अधिक संवेदनशील हो जाता है कि आपने कौन से उदाहरण शामिल किए। जब आप कुछ ट्रेनिंग सैंपल्स बदलते हैं, तो नया डेटा समायोजित करने के लिए वे सभी पैरामीटर्स खिसक जाते हैं। मॉडल अस्थिर हो जाता है।
इसीलिए केवल ट्रेनिंग त्रुटि पर भरोसा करना भ्रामक और खतरनाक है।
जैसे-जैसे आप जटिलता बढ़ाते हैं, ट्रेनिंग त्रुटि हमेशा घटेगी। आपका मॉडल ट्रेनिंग डेटा को बेहतर फिट करेगा और अंततः लगभग परफेक्ट एक्यूरेसी तक पहुँच जाएगा। यह अच्छा दिखता है, जब तक कि आपको एहसास न हो कि यह पैटर्न सीखने के बजाय शोर याद कर रहा है।
टेस्ट सेट पर त्रुटि बताएगी कि आपका मॉडल वास्तव में कितना अच्छा है।
शुरुआत में, जैसे-जैसे आप जटिलता जोड़ते हैं, टेस्ट त्रुटि घटती है क्योंकि मॉडल असली पैटर्न पकड़ना शुरू करता है। पर एक सीमा के बाद, ट्रेनिंग त्रुटि घटती रहती है, फिर भी टेस्ट त्रुटि बढ़ती है। मॉडल ओवरफिट कर रहा है—ट्रेनिंग सेट की विशिष्ट विचित्रताएँ सीख रहा है जो सामान्यीकृत नहीं होतीं।
ट्रेन और टेस्ट त्रुटि के बीच छोटा अंतर बताता है कि आपका मॉडल अच्छी तरह सामान्यीकृत करता है। बड़ा अंतर बताता है कि आप ओवरफिटिंग कर रहे हैं और आपको जटिलता घटाने या अधिक ट्रेनिंग डेटा जोड़ने की ज़रूरत है।
बायस-वेरीयंस ट्रेडऑफ प्रबंधित करने की तकनीकें
आप बायस-वेरीयंस ट्रेडऑफ को समाप्त नहीं कर सकते, लेकिन सही तकनीकों से इसे नियंत्रित कर सकते हैं। कुछ तरीके देखते हैं।
ट्रेन/टेस्ट स्प्लिट्स
कभी भी जिस डेटा पर आपने ट्रेन किया हो, उसी पर मॉडल का मूल्यांकन न करें।
सबसे पहले अपने डेटा को ट्रेनिंग और टेस्ट सेट में बाँटें। एक हिस्से पर ट्रेन करें, दूसरे पर मूल्यांकन। इससे आपको यह ईमानदार माप मिलता है कि आपका मॉडल नए डेटा पर कितना सामान्यीकृत करता है।
टेस्ट सेट वास्तविक दुनिया के प्रदर्शन का प्रॉक्सी होता है। जब ट्रेनिंग त्रुटि कम पर टेस्ट त्रुटि अधिक हो, तो आप ओवरफिटिंग कर रहे हैं। जब दोनों अधिक हों, तो आप अंडरफिटिंग कर रहे हैं।
क्रॉस-वैलिडेशन
ट्रेन/टेस्ट स्प्लिट्स की एक कमजोरी है—वे इस पर निर्भर करते हैं कि किन उदाहरणों को किस सेट में डाला गया।
क्रॉस-वैलिडेशन इसे ठीक करता है—आपके डेटा के अलग-अलग स्प्लिट्स पर बार-बार ट्रेन और टेस्ट करके। सबसे आम तरीका k-fold क्रॉस-वैलिडेशन है, जिसमें आप डेटा को k भागों में बाँटते हैं, k-1 भागों पर ट्रेन करते हैं और शेष भाग पर टेस्ट। इसे k बार दोहराते हैं ताकि हर भाग एक बार टेस्ट सेट बने।
यह आपको मॉडल प्रदर्शन का अधिक विश्वसनीय अनुमान देता है और एकल टेस्ट सेट पर ओवरफिटिंग किए बिना हाइपरपैरामीटर्स ट्यून करने में मदद करता है।
रेग्युलराइज़ेशन
रेग्युलराइज़ेशन आपके लॉस फंक्शन में सीधे मॉडल जटिलता के लिए पेनल्टी जोड़ता है।
L1 (Lasso) और L2 (Ridge) जैसी तकनीकें बड़े पैरामीटर मानों को हतोत्साहित करती हैं, जिससे मॉडल सरल और अधिक स्थिर रहता है। इससे बायस थोड़ा बढ़ता है पर वेरीयंस घटता है, जो अक्सर कुल टेस्ट प्रदर्शन में सुधार लाता है।
न्यूरल नेटवर्क में dropout भी इसी तरह काम करता है—यह ट्रेनिंग के दौरान कुछ न्यूरॉन्स को यादृच्छिक रूप से हटा देता है, जिससे नेटवर्क विशिष्ट पैरामीटर्स पर अधिक निर्भर नहीं रहता और ओवरफिटिंग घटती है।
अधिक डेटा बनाम बेहतर मॉडल
उच्च वेरीयंस के लिए अधिक ट्रेनिंग डेटा अक्सर सर्वोत्तम समाधान होता है।
जब आपके पास अधिक उदाहरण होते हैं, तो आपका मॉडल संभावित पैटर्न का व्यापक नमूना देखता है। इससे शोर पर ओवरफिट करना कठिन हो जाता है क्योंकि शोर अधिक बिंदुओं पर औसत हो जाता है। वेरीयंस घटता है, और जटिल मॉडल का निम्न बायस भी बना रहता है।
पर अधिक डेटा इकट्ठा करना हमेशा व्यावहारिक या संभव नहीं होता।
यदि आप सीमित डेटा में फँसे हैं, तो मॉडल चयन पर ध्यान दें—सरल मॉडल चुनें, रेग्युलराइज़ेशन जोड़ें, या ऐसे एंसेंबल तरीकों का उपयोग करें जो वेरीयंस घटाने के लिए कई मॉडलों को संयोजित करते हैं।
फीचर चयन
हर फीचर आपके मॉडल में सुधार नहीं लाता। कुछ तो केवल शोर ही जोड़ेंगे।
अप्रासंगिक या अनावश्यक फीचर्स हटाएँ ताकि बिना महत्वपूर्ण पैटर्न खोए मॉडल जटिलता घटे। कम फीचर्स का अर्थ कम पैरामीटर्स सीखना है, जिससे वेरीयंस घटता है। आप उच्च-आयामी स्पेस में सीमित डेटा के साथ मॉडलों के संघर्ष—डायमेंशनलिटी के अभिशाप—से भी बचते हैं।
सहसंबंध विश्लेषण, ट्री-आधारित मॉडलों से फीचर इंपॉर्टेंस स्कोर, या ऐसे रेग्युलराइज़ेशन तरीकों का उपयोग करें जो स्वतः ही गैर-महत्वपूर्ण फीचर्स को शून्य कर दें।
लक्ष्य है—शोर के बिना सिग्नल पकड़ने वाला न्यूनतम फीचर सेट खोजना।
बायस-वेरीयंस ट्रेडऑफ के बारे में आम गलतफहमियाँ
तीन आम भूलों को साफ़ कर लेते हैं जो लोगों को गलत मॉडलिंग निर्णय लेने पर मजबूर करती हैं।
"कम बायस हमेशा बेहतर होता है"
गलत। कम बायस का अर्थ है कि आपका मॉडल जटिल पैटर्न प्रस्तुत कर सकता है, पर यह तभी उपयोगी है जब वे पैटर्न वास्तव में आपके डेटा में हों और नए उदाहरणों पर सामान्यीकृत हों।
जटिलता जोड़कर बायस घटाने से अक्सर वेरीयंस इतनी तेज़ी से बढ़ता है कि बायस कम होने का लाभ खत्म हो जाता है। अंत में मॉडल ट्रेनिंग डेटा को पूरी तरह फिट कर लेता है पर टेस्ट डेटा पर बदतर प्रदर्शन करता है। लक्ष्य कुल त्रुटि को कम करना है, केवल बायस को नहीं।
कभी-कभी अधिक बायस वाला सरल मॉडल समग्र रूप से बेहतर प्रदर्शन करता है क्योंकि उसका वेरीयंस पर्याप्त रूप से कम होता है, जिससे वह अच्छी तरह सामान्यीकृत करता है।
"ओवरफिटिंग का मतलब मॉडल खराब है"
पूरी तरह नहीं। ओवरफिटिंग का अर्थ है कि आपका मॉडल आपके पास मौजूद डेटा की मात्रा के लिए बहुत जटिल है, पर मॉडल स्वयं जन्मगत रूप से खराब नहीं है।
वही न्यूरल नेटवर्क आर्किटेक्चर जो 1,000 ट्रेनिंग उदाहरणों पर ओवरफिट करता है, 100,000 उदाहरणों पर बेहतरीन प्रदर्शन कर सकता है। समस्या क्षमता और डेटा आकार के मिसमैच में है।
आप ओवरफिटिंग को अधिक डेटा जोड़कर, जटिलता घटाकर, या रेग्युलराइज़ेशन लागू करके ठीक कर सकते हैं। आपको मॉडल फेंककर पूरी तरह अलग चीज़ से शुरू करने की ज़रूरत नहीं।
"अधिक डेटा हमेशा वेरीयंस ठीक कर देता है"
अधिक डेटा वेरीयंस घटाता है, पर उसे समाप्त नहीं करता, और मदद की भी एक सीमा है।
यदि आपका मॉडल आपकी समस्या के सापेक्ष अत्यधिक जटिल है, तो बड़े डाटासेट्स भी उसे पर्याप्त रूप से स्थिर नहीं कर सकते। लाखों पैरामीटर्स वाला न्यूरल नेटवर्क अच्छे से ट्रेन होने के लिए भारी मात्रा में डेटा चाहता है।
साथ ही, अधिक डेटा तभी मदद करता है जब नया डेटा आपके टेस्ट डेटा के समान वितरण का प्रतिनिधित्व करे। अधिक पक्षपाती या शोरयुक्त डेटा इकट्ठा करना वेरीयंस नहीं घटाएगा—यह स्थिति और बिगाड़ भी सकता है, गैर-सामान्यीकृत होने वाले पैटर्न को और मजबूत करके।
बायस-वेरीयंस ट्रेडऑफ बनाम ओवरफिटिंग और अंडरफिटिंग
बायस-वेरीयंस और ओवरफिटिंग-अंडरफिटिंग एक ही समस्याओं को अलग कोण से वर्णित करते हैं, पर ये परस्पर विनिमेय शब्द नहीं हैं।
याद रखने की बातें:
- उच्च बायस अंडरफिटिंग का कारण बनता है। जब आपके मॉडल की मजबूत मान्यताएँ वास्तविक डेटा से मेल नहीं खातीं, तो वह ट्रेनिंग और टेस्ट दोनों डेटा में पैटर्न व्यवस्थित रूप से चूकता है। मॉडल वास्तविक संबंध दर्शाने के लिए बहुत सरल है—इसे ही अंडरफिटिंग कहते हैं।
- उच्च वेरीयंस ओवरफिटिंग का कारण बनता है। जब आपका मॉडल ट्रेनिंग डेटा के प्रति अत्यधिक संवेदनशील होता है, तो वह शोर और गैर-सामान्यीकृत होने वाले पैटर्न सीख लेता है। मॉडल अंतर्निहित पैटर्न सीखने के बजाय ट्रेनिंग उदाहरणों को याद कर लेता है—इसे ही ओवरफिटिंग कहते हैं।
बायस और वेरीयंस आपके मॉडल के गुण हैं।
ये बताते हैं कि अलग-अलग ट्रेनिंग सेट्स पर आपका मॉडल कैसा व्यवहार करता है। आप बायस को इस तरह नाप सकते हैं कि मॉडल की औसत भविष्यवाणी सच से कितनी दूर है। आप वेरीयंस को इस तरह नाप सकते हैं कि अलग ट्रेनिंग डेटा के साथ भविष्यवाणियाँ कितनी बदलती हैं।
अंडरफिटिंग और ओवरफिटिंग वे लक्षण हैं जो आप देखते हैं।
ये बताते हैं कि जब आप अपने मॉडल को ट्रेन और टेस्ट करते हैं तो क्या होता है। जब ट्रेनिंग और टेस्ट दोनों त्रुटियाँ अधिक हों, तो अंडरफिटिंग दिखती है। जब ट्रेनिंग त्रुटि कम पर टेस्ट त्रुटि अधिक हो, तो ओवरफिटिंग दिखती है।
संबंध सीधा है पर एक-से-एक नहीं। उच्च बायस प्रायः अंडरफिटिंग की ओर ले जाता है, और उच्च वेरीयंस प्रायः ओवरफिटिंग की ओर। पर मध्यम बायस और मध्यम वेरीयंस वाला मॉडल भी न तो अंडरफिट कर सकता है, न ओवरफिट—फिर भी अन्य कारणों, जैसे गलत फीचर्स या अपर्याप्त डेटा गुणवत्ता, के चलते खराब प्रदर्शन कर सकता है।
मॉडल प्रदर्शन की व्याख्या के व्यावहारिक सुझाव
यहाँ कुछ अंतिम समय के सुझाव हैं कि बायस-वेरीयंस समस्याओं का निदान कैसे करें और बेहतर मॉडलिंग निर्णय कैसे लें।
ट्रेनिंग और वैलिडेशन त्रुटि को साथ में देखें, अलग-अलग नहीं
सिर्फ ट्रेनिंग त्रुटि आपको सामान्यीकरण के बारे में कुछ नहीं बताती। 1% ट्रेनिंग त्रुटि वाला मॉडल भी यदि ओवरफिट कर रहा हो तो 50% टेस्ट त्रुटि दे सकता है।
क्या हो रहा है, यह समझने के लिए दोनों त्रुटियों की तुलना करें।
- जब दोनों अधिक हों, तो उच्च बायस है—मॉडल बहुत सरल है
- जब ट्रेनिंग त्रुटि कम पर वैलिडेशन त्रुटि अधिक हो, तो उच्च वेरीयंस है—मॉडल ओवरफिट कर रहा है
- जब दोनों कम हों, तो आपने सही संतुलन पा लिया है
सिर्फ ट्रेनिंग एक्यूरेसी के लिए ऑप्टिमाइज़ न करें
परफेक्ट ट्रेनिंग एक्यूरेसी एक लाल झंडा है। यह आमतौर पर बताता है कि आपने ट्रेनिंग सेट याद कर लिया है, सामान्यीकृत होने वाले पैटर्न नहीं सीखे।
इसके बजाय वैलिडेशन प्रदर्शन पर ध्यान दें। आपका लक्ष्य ट्रेनिंग और वैलिडेशन त्रुटि के बीच का अंतर कम करना है, साथ ही दोनों को यथोचित रूप से कम रखना।
विश्वसनीय अनुमान के लिए क्रॉस-वैलिडेशन का उपयोग करें
एकल ट्रेन-टेस्ट स्प्लिट भ्रामक हो सकता है क्योंकि यह इस पर निर्भर करता है कि किन उदाहरणों को किस सेट में डाला गया। एक बदकिस्मत स्प्लिट अच्छे मॉडल को बुरा या बुरे मॉडल को अच्छा दिखा सकता है।
क्रॉस-वैलिडेशन कई स्प्लिट्स में प्रदर्शन का औसत लेता है, जिससे नए डेटा पर मॉडल के प्रदर्शन का अधिक स्थिर अनुमान मिलता है। यह विशेष रूप से तब महत्वपूर्ण है जब आपके पास सीमित डेटा हो या आप हाइपरपैरामीटर्स ट्यून कर रहे हों।
डेटा आकार के आधार पर सादगी और लचीलेपन का संतुलन बनाएँ
छोटे डाटासेट्स के साथ, सरल मॉडलों की ओर झुकें। वे अधिक स्थिर होते हैं और कम उदाहरणों से सीखते समय ओवरफिट होने की संभावना कम होती है।
बड़े डाटासेट्स के साथ, आप अधिक जटिल मॉडलों का खर्च उठा सकते हैं क्योंकि अतिरिक्त डेटा सीखने की प्रक्रिया को स्थिर करता है और वेरीयंस घटाता है। पर केवल इसलिए जटिलता न जोड़ें कि आप जोड़ सकते हैं—उसे तभी जोड़ें जब वह वैलिडेशन प्रदर्शन सुधारती हो।
निष्कर्ष
आप शून्य बायस और शून्य वेरीयंस वाला मॉडल नहीं बना सकते। आपके हर मॉडलिंग निर्णय से इन दो त्रुटि-स्रोतों के बीच का संतुलन बदलता है। जटिलता बढ़ाएँ तो बायस घटता है पर वेरीयंस बढ़ता है। सरल करें तो वेरीयंस घटता है पर बायस बढ़ता है।
मॉडल प्रदर्शन सही संतुलन खोजने पर निर्भर करता है। सर्वश्रेष्ठ मॉडल वह है जो आपके विशिष्ट समस्या और डाटासेट के लिए बायस और वेरीयंस का संतुलन बनाकर कुल त्रुटि को न्यूनतम करे। इस ट्रेडऑफ को समझने का अर्थ है कि आप पहचान सकते हैं कि आपका मॉडल उच्च बायस से ग्रस्त है या उच्च वेरीयंस से—और फिर सही समाधान लागू कर सकते हैं।
यदि आप मशीन लर्निंग में हाथ-on अनुभव के लिए तैयार हैं, तो हमारे Machine Learning Fundamentals in Python ट्रैक में नामांकन करें। इसमें 16 घंटे की वीडियो सामग्री है जो आपकी पहली नौकरी पाने में मदद करेगी।


बायस-वेरीयंस ट्रेडऑफ बताता है कि प्रदर्शन सिर्फ जटिलता या सटीकता का मामला नहीं है—असल में लक्ष्य वह संतुलन खोजना है जहाँ आपका मॉडल समस्या को अतिसरलीकृत किए बिना और ट्रेनिंग सेट पर ओवरफिट हुए बिना, अनदेखे डेटा पर अच्छी तरह सामान्यीकृत करे।
इस लेख में, मैं समझाऊँगा कि मशीन लर्निंग में बायस और वेरीयंस का वास्तविक अर्थ क्या है, वे एक-दूसरे के साथ कैसे ट्रेडऑफ करते हैं, और इस ट्रेडऑफ को समझना आपको अधिक मजबूत मॉडल बनाने में क्यों मदद करता है।
यदि आप मशीन लर्निंग में नए हैं, तो हमारा 2026 में मशीन लर्निंग कैसे सीखें लेख आपको जल्दी दक्ष बना देगा।
बायस क्या है?
बायस वह त्रुटि है जो आपके डेटा के बारे में अत्यधिक सरल मान्यताओं से आती है। इसका पक्षपात (prejudice) से कोई संबंध नहीं है, कम से कम मशीन लर्निंग के संदर्भ में तो नहीं।
जब किसी मॉडल में बायस अधिक होता है, तो इसका मतलब है कि मॉडल आपके डेटा के वास्तविक पैटर्न पकड़ने के लिए बहुत कठोर है। इसे ऐसे समझें जैसे आप ऐसे डेटा पर सीधी रेखा फिट करने की कोशिश कर रहे हों जो स्पष्ट रूप से मुड़ता है: आप रेखा को जितना भी समायोजित करें, वह असली आकार से मेल नहीं खाएगी।
इसे अंडरफिटिंग कहते हैं।
उच्च-बायस मॉडल समस्या को अतिसरलीकृत कर देता है। वह संबंधों को वास्तविकता से अधिक सरल मानता है, इसलिए वे महत्वपूर्ण पैटर्न चूक जाता है जो सटीक भविष्यवाणी में मदद करते।
मान लें आप घर की कीमत का अनुमान वर्गफुट, बेडरूम की संख्या, स्थान और घर की उम्र के आधार पर लगा रहे हैं। उच्च-बायस मॉडल शायद केवल वर्गफुट का उपयोग करेगा और बाकी सबको नज़रअंदाज़ करेगा। वह मानता है कि केवल वर्गफुट ही कीमत तय करता है, जो अत्यधिक सरल है।
नतीजा यह होता है कि मॉडल ट्रेनिंग और नए दोनों डेटा पर खराब प्रदर्शन करता है क्योंकि वह वास्तविक घर की कीमतों की जटिलता को पकड़ नहीं पाता।
कम फीचर्स वाली लीनियर रिग्रेशन एक क्लासिक उच्च-बायस मॉडल है। बहुत सीमित गहराई वाले डिसीजन ट्री भी प्रायः उच्च बायस रखते हैं क्योंकि वे सूक्ष्म पैटर्न खोजने हेतु पर्याप्त बार डेटा को विभाजित नहीं कर पाते।
उच्च बायस का अर्थ है कि आपका मॉडल डेटा से पर्याप्त नहीं सीख रहा, बल्कि समस्या को इतना सरल बना रहा है कि अच्छी सटीकता से हल ही नहीं हो पा रही।
वेरीयंस क्या है?
वेरीयंस यह मापता है कि आपका मॉडल इस्तेमाल किए गए विशिष्ट ट्रेनिंग डेटा के प्रति कितना संवेदनशील है।
इसका डेटा फैलाव के सांख्यिकीय माप से कोई लेना-देना नहीं। मशीन लर्निंग में, वेरीयंस मॉडल के व्यवहार का वर्णन करता है, न कि डेटा वितरण का।
जब किसी मॉडल में वेरीयंस अधिक होता है, तो ट्रेनिंग डेटा में छोटे बदलाव भी मॉडल की भविष्यवाणियों में बड़े बदलाव ला देते हैं। यानी, यदि आप एक ही मॉडल को दो थोड़ा भिन्न डाटासेट्स पर ट्रेन करें, तो परिणाम बहुत अलग हो सकते हैं।
इसे ओवरफिटिंग कहते हैं।
उच्च-वेरीयंस मॉडल बहुत लचीला होता है। वह आपके डेटा के वास्तविक पैटर्न के साथ-साथ उस शोर और यादृच्छिक उतार-चढ़ाव को भी सीख लेता है जो नए डेटा पर सामान्यीकृत नहीं होते। मॉडल मूल संबंधों को सीखने के बजाय ट्रेनिंग उदाहरणों को रट लेता है।
मान लें आप अभी भी घर की कीमतों की भविष्यवाणी कर रहे हैं, पर अब आप सैकड़ों पैरामीटर्स वाला एक जटिल मॉडल उपयोग कर रहे हैं। यह सीख सकता है कि Oak Street पर घर हमेशा ठीक $427,350 में बिकते हैं, क्योंकि आपके ट्रेनिंग डेटा में ऐसा ही था।
नतीजा यह होता है कि मॉडल ट्रेनिंग डेटा पर शानदार प्रदर्शन करता है लेकिन नए डेटा पर बहुत खराब, क्योंकि उसने ट्रेनिंग सेट की विशिष्ट विचित्रताओं को सीख लिया है।
डीप न्यूरल नेटवर्क और असीमित गहराई वाले डिसीजन ट्री उच्च-वेरीयंस मॉडलों के क्लासिक उदाहरण हैं। इनमें लगभग किसी भी पैटर्न—यहाँ तक कि निरर्थक—को फिट करने की पर्याप्त लचीलापन होता है।
उच्च वेरीयंस का मतलब है कि आपका मॉडल डेटा से बहुत अधिक सीख रहा है। यह सिग्नल के साथ शोर को भी फिट कर देता है, जिससे वह नए उदाहरणों पर अस्थिर और अविश्वसनीय हो जाता है।
बायस बनाम वेरीयंस: मुख्य अंतर
बायस और वेरीयंस भविष्यवाणी-त्रुटि के दो बिल्कुल अलग स्रोत हैं। एक बार जब आप फर्क समझ लेते हैं, तो आप अपने मॉडल में क्या गड़बड़ है, यह जल्दी पहचान पाएँगे।
भविष्यवाणी-त्रुटि पर बायस और वेरीयंस का असर ऐसे होता है:
समस्या यह है कि एक को घटाने पर आमतौर पर दूसरा बढ़ता है।
जब आप बायस घटाने के लिए मॉडल को अधिक जटिल बनाते हैं, तो आप उसकी लचीलापन बढ़ाते हैं। यह लचीलापन उसे ट्रेनिंग डेटा के प्रति अधिक संवेदनशील बना देता है, जिससे वेरीयंस बढ़ता है। जब आप वेरीयंस घटाने के लिए मॉडल को सरल बनाते हैं, तो आप उसकी जटिल पैटर्न पकड़ने की क्षमता घटा देते हैं, जिससे बायस बढ़ता है।
यह व्युत्क्रम संबंध बताता है कि आप दोनों को एक साथ न्यूनतम नहीं कर सकते। इसके बजाय, आपको वह संतुलन खोजना होता है जो कुल त्रुटि को सबसे कम करे।
बायस-वेरीयंस ट्रेडऑफ क्या है?
बायस-वेरीयंस ट्रेडऑफ इन दोनों त्रुटि-स्रोतों के बीच के तनाव का वर्णन करता है—एक घटाएँ, तो लगभग हमेशा दूसरा बढ़ता है।
इसे ऐसे समझें: आप एक निशाने पर लगा रहे हैं, पर दो समस्याएँ एक-दूसरे के खिलाफ काम कर रही हैं। आप और सावधानी से निशाना लगा सकते हैं (बायस घटाएँ), लेकिन उससे आप हवा और हाथ के काँपने के प्रति अधिक संवेदनशील हो जाते हैं (वेरीयंस बढ़ेगा)। या आप सरल, अधिक स्थिर शूटिंग मुद्रा अपनाते हैं (वेरीयंस घटाएँ), पर उससे परिशुद्धता सीमित हो जाती है (बायस बढ़ेगा)।
मॉडल जटिलता इस ट्रेडऑफ के केंद्र में है।
जब आप कम पैरामीटर्स वाला सरल मॉडल उपयोग करते हैं, तो आपको उच्च बायस और निम्न वेरीयंस मिलता है। मॉडल सुसंगत मान्यताएँ बनाता है और अलग-अलग ट्रेनिंग डेटा से ज़्यादा नहीं बदलता, पर जटिल पैटर्न पकड़ नहीं पाता।
जब आप अधिक पैरामीटर्स वाला जटिल मॉडल उपयोग करते हैं, तो बायस कम और वेरीयंस अधिक होता है। मॉडल जटिल संबंधों को दर्शा सकता है, पर वह अस्थिर और उन विशिष्ट उदाहरणों के प्रति अत्यधिक संवेदनशील हो जाता है जिन पर आपने उसे ट्रेन किया।
इसका वैचारिक वक्र कुछ ऐसा दिखता है:
बायस-वेरीयंस ट्रेडऑफ वक्र
आप वह बिंदु खोज रहे हैं जहाँ इनका संयुक्त प्रभाव आपको सबसे कम टेस्ट त्रुटि देता है।
हर समस्या के लिए कोई एकल "परफेक्ट" मॉडल नहीं होता। सर्वोत्तम संतुलन आपके डेटा, समस्या की जटिलता और उपलब्ध ट्रेनिंग डेटा की मात्रा पर निर्भर करता है। अधिक डेटा आमतौर पर आपको अधिक जटिल मॉडल बिना ओवरफिटिंग के उपयोग करने देता है, जिससे मीठी जगह दाईं ओर खिसक जाती है।
एक सरल बायस-वेरीयंस ट्रेडऑफ उदाहरण
आईए इसे एक वास्तविक परिदृश्य से ठोस बनाते हैं, जो दिखाता है कि व्यवहार में बायस और वेरीयंस कैसे प्रभाव डालते हैं।
मान लें आप किसी शहर में अपार्टमेंट किराये की कीमत का अनुमान लगाने के लिए मॉडल बना रहे हैं। आपके पास वर्गफुट, बेडरूम की संख्या, पड़ोस, मेट्रो से दूरी, बिल्डिंग की उम्र और सुविधाओं जैसे फीचर्स हैं।
सरल मॉडल: एक फीचर वाली लीनियर रिग्रेशन
आप केवल वर्गफुट का उपयोग कर सिंपल लीनियर रिग्रेशन से कीमत का अनुमान लगाने का निर्णय लेते हैं।
सरल मॉडल
जटिल मॉडल: सभी फीचर्स वाला डीप न्यूरल नेटवर्क
अब आप सभी उपलब्ध फीचर्स के साथ, और साथ ही इंजीनियर किए गए फीचर्स जैसे पड़ोस का अपराध दर, वॉकएबिलिटी स्कोर और पार्क की निकटता सहित, कई हिडन लेयर्स वाला डीप न्यूरल नेटवर्क बनाते हैं।
जटिल मॉडल
संतुलित मॉडल: प्रमुख फीचर्स के साथ नियमितीकृत रिग्रेशन
आप नियमितीकृत रिग्रेशन (जैसे Ridge या Lasso) का उपयोग फीचर्स के सावधानी से चुने गए सबसेट—वर्गफुट, बेडरूम्स, पड़ोस श्रेणी, और ट्रांज़िट तक की दूरी—के साथ करते हैं।
संतुलित मॉडल
संतुलित मॉडल आपका ट्रेनिंग डेटा पूरी तरह फिट नहीं करेगा—और यही बात मायने रखती है।
मशीन लर्निंग मॉडलों में बायस-वेरीयंस ट्रेडऑफ
अलग-अलग मशीन लर्निंग एल्गोरिद्म स्वाभाविक तौर पर या तो उच्च बायस या उच्च वेरीयंस की ओर झुकते हैं। सही टूल चुनने के लिए आपको इन प्रवृत्तियों को समझना होगा।
लिनियर मॉडल
लिनियर रिग्रेशन और लॉजिस्टिक रिग्रेशन स्पेक्ट्रम के उच्च-बायस छोर पर हैं।
ये मॉडल मानते हैं कि संबंध रैखिक हैं—एक फीचर बदले तो आउटपुट एक निश्चित मात्रा से बदलता है। जब आपके डेटा में नॉन-लिनियर पैटर्न, वक्र संबंध, या फीचर्स के बीच जटिल अंतःक्रियाएँ हों, तो लिनियर मॉडल उन्हें पकड़ नहीं पाते।
फायदा स्थिरता है। अलग-अलग सैंपल्स पर लिनियर मॉडल ट्रेन करें, तो हर बार मिलते-जुलते गुणांक मिलेंगे। वेरीयंस कम, पर यदि वास्तविक संबंध रैखिक नहीं है तो बायस अधिक हो सकता है।
डिसीजन ट्री
डिसीजन ट्री का व्यवहार इस पर निर्भर करता है कि आप उन्हें कैसे कॉन्फ़िगर करते हैं।
कुछ ही स्प्लिट्स वाला उथला ट्री एक सरल मॉडल जैसा व्यवहार करता है—उच्च बायस, निम्न वेरीयंस। यह व्यापक सामान्यीकरण करता है और सूक्ष्म पैटर्न पकड़ नहीं पाता।
बिना गहराई-सीमा वाला गहरा ट्री अत्यधिक लचीला हो जाता है। यह तब तक स्प्लिट करता रहता है जब तक प्रत्येक पत्ती में कुछ ही डेटा बिंदु रह जाते हैं, यानी यह आपका ट्रेनिंग डेटा याद कर लेता है। बायस कम, पर वेरीयंस बहुत अधिक—अलग ट्रेनिंग सैंपल्स पर ट्री की संरचना नाटकीय रूप से बदलती है।
यही कारण है कि रैंडम फॉरेस्ट अच्छे से काम करते हैं। वे कई ट्री की भविष्यवाणियों का औसत लेते हैं, जिससे वेरीयंस की समस्या घटती है जबकि बायस कम ही रहता है।
K-nearest neighbors
KNN का बायस-वेरीयंस संतुलन पूरी तरह आपके k के चयन पर निर्भर करता है।
जब k छोटा होता है (जैसे k=1 या k=3), मॉडल में वेरीयंस अधिक होता है। यह बस कुछ नज़दीकी बिंदुओं पर आधारित भविष्यवाणी करता है, इसलिए ट्रेनिंग सेट में मौजूद विशिष्ट उदाहरणों के प्रति अत्यधिक संवेदनशील होता है। ट्रेनिंग डेटा में छोटे बदलाव पूरी तरह अलग भविष्यवाणियों तक ले जाते हैं।
जब k बड़ा होता है (जैसे k=50 या k=100), मॉडल में बायस अधिक होता है। यह इतने अधिक पड़ोसियों पर औसत लेता है कि स्थानीय पैटर्न समतल हो जाते हैं और डेटा के महत्वपूर्ण विवरण छूट जाते हैं।
सर्वोत्तम k मान बीच में कहीं होता है, जो इन दोनों अतियों का संतुलन बनाता है।
न्यूरल नेटवर्क
न्यूरल नेटवर्क स्वाभाविक रूप से उच्च-वेरीयंस मॉडल होते हैं क्योंकि उन्हें बहुत सारे पैरामीटर्स सीखने होते हैं।
कई लेयर्स और सैकड़ों न्यूरॉन्स वाला नेटवर्क अत्यंत जटिल फंक्शन्स को निरूपित कर सकता है। यह लचीलापन निम्न बायस देता है—नेटवर्क लगभग कोई भी पैटर्न सीख सकता है। पर इसका मतलब उच्च वेरीयंस भी है—सीखे गए सटीक वेट्स आपके विशिष्ट ट्रेनिंग डेटा, इनिशियलाइज़ेशन और ट्रेनिंग प्रक्रिया पर बहुत निर्भर करते हैं।
इसीलिए न्यूरल नेटवर्क को अच्छे से काम करने के लिए बड़े डाटासेट्स चाहिए। अधिक ट्रेनिंग डेटा सीखने की प्रक्रिया को स्थिर करता है और वेरीयंस घटाता है। इसी कारण dropout, बैच नॉर्मलाइज़ेशन और अर्ली स्टॉपिंग जैसी तकनीकें हैं—ये सभी वेरीयंस नियंत्रित करने और ओवरफिटिंग रोकने के लिए बनी हैं।
कम लेयर्स और न्यूरॉन्स वाले छोटे नेटवर्क में बायस अधिक पर वेरीयंस कम होता है, जबकि बड़े नेटवर्क में बायस कम पर वेरीयंस अधिक।
मॉडल जटिलता बायस और वेरीयंस को कैसे प्रभावित करती है
दुर्भाग्यवश, मॉडल जटिलता कोई एकल संख्या नहीं है जिसे आप नाप लें। यह इस बारे में है कि आपका मॉडल अलग-अलग पैटर्न्स को फिट करने में कितना लचीला है।
जटिलता कई स्रोतों से आती है—जैसे अधिक फीचर्स, न्यूरल नेटवर्क में अधिक लेयर्स, गहरे डिसीजन ट्री, रिग्रेशन में पॉलीनॉमियल टर्म्स, या KNN में कम k मान। सामान्य सूत्र यह है कि ये सब आपके मॉडल को डेटा में सूक्ष्म पैटर्न फिट करने की अधिक स्वतंत्रता देते हैं।
जब आप पैरामीटर्स बढ़ाते हैं, तो आप अपने मॉडल को डेटा में संबंधों को दर्शाने के अधिक तरीके दे रहे होते हैं। 3 फीचर्स वाला लिनियर मॉडल आपके डेटा के बीच सिर्फ एक सपाट समतल खींच सकता है। यदि आप पॉलीनॉमियल टर्म्स और इंटरेक्शन फीचर्स जोड़ते हैं, तो यह अधिक जटिल पैटर्न से मेल खाने के लिए मुड़-तुड़ सकता है। मॉडल की मान्यताएँ कम प्रतिबंधात्मक हो जाती हैं, यानी बायस कम होता है।
पर यह लचीलापन एक कीमत पर आता है, अर्थात वेरीयंस में वृद्धि।
अधिक पैरामीटर्स का अर्थ है ट्रेनिंग डेटा से सीखने के लिए अधिक मान। प्रत्येक पैरामीटर आपके विशिष्ट ट्रेनिंग उदाहरणों के अनुसार ट्यून होता है, जिससे मॉडल इस बात के प्रति अधिक संवेदनशील हो जाता है कि आपने कौन से उदाहरण शामिल किए। जब आप कुछ ट्रेनिंग सैंपल्स बदलते हैं, तो नया डेटा समायोजित करने के लिए वे सभी पैरामीटर्स खिसक जाते हैं। मॉडल अस्थिर हो जाता है।
इसीलिए केवल ट्रेनिंग त्रुटि पर भरोसा करना भ्रामक और खतरनाक है।
जैसे-जैसे आप जटिलता बढ़ाते हैं, ट्रेनिंग त्रुटि हमेशा घटेगी। आपका मॉडल ट्रेनिंग डेटा को बेहतर फिट करेगा और अंततः लगभग परफेक्ट एक्यूरेसी तक पहुँच जाएगा। यह अच्छा दिखता है, जब तक कि आपको एहसास न हो कि यह पैटर्न सीखने के बजाय शोर याद कर रहा है।
टेस्ट सेट पर त्रुटि बताएगी कि आपका मॉडल वास्तव में कितना अच्छा है।
शुरुआत में, जैसे-जैसे आप जटिलता जोड़ते हैं, टेस्ट त्रुटि घटती है क्योंकि मॉडल असली पैटर्न पकड़ना शुरू करता है। पर एक सीमा के बाद, ट्रेनिंग त्रुटि घटती रहती है, फिर भी टेस्ट त्रुटि बढ़ती है। मॉडल ओवरफिट कर रहा है—ट्रेनिंग सेट की विशिष्ट विचित्रताएँ सीख रहा है जो सामान्यीकृत नहीं होतीं।
ट्रेन और टेस्ट त्रुटि के बीच छोटा अंतर बताता है कि आपका मॉडल अच्छी तरह सामान्यीकृत करता है। बड़ा अंतर बताता है कि आप ओवरफिटिंग कर रहे हैं और आपको जटिलता घटाने या अधिक ट्रेनिंग डेटा जोड़ने की ज़रूरत है।
बायस-वेरीयंस ट्रेडऑफ प्रबंधित करने की तकनीकें
आप बायस-वेरीयंस ट्रेडऑफ को समाप्त नहीं कर सकते, लेकिन सही तकनीकों से इसे नियंत्रित कर सकते हैं। कुछ तरीके देखते हैं।
ट्रेन/टेस्ट स्प्लिट्स
कभी भी जिस डेटा पर आपने ट्रेन किया हो, उसी पर मॉडल का मूल्यांकन न करें।
सबसे पहले अपने डेटा को ट्रेनिंग और टेस्ट सेट में बाँटें। एक हिस्से पर ट्रेन करें, दूसरे पर मूल्यांकन। इससे आपको यह ईमानदार माप मिलता है कि आपका मॉडल नए डेटा पर कितना सामान्यीकृत करता है।
टेस्ट सेट वास्तविक दुनिया के प्रदर्शन का प्रॉक्सी होता है। जब ट्रेनिंग त्रुटि कम पर टेस्ट त्रुटि अधिक हो, तो आप ओवरफिटिंग कर रहे हैं। जब दोनों अधिक हों, तो आप अंडरफिटिंग कर रहे हैं।
क्रॉस-वैलिडेशन
ट्रेन/टेस्ट स्प्लिट्स की एक कमजोरी है—वे इस पर निर्भर करते हैं कि किन उदाहरणों को किस सेट में डाला गया।
क्रॉस-वैलिडेशन इसे ठीक करता है—आपके डेटा के अलग-अलग स्प्लिट्स पर बार-बार ट्रेन और टेस्ट करके। सबसे आम तरीका k-fold क्रॉस-वैलिडेशन है, जिसमें आप डेटा को k भागों में बाँटते हैं, k-1 भागों पर ट्रेन करते हैं और शेष भाग पर टेस्ट। इसे k बार दोहराते हैं ताकि हर भाग एक बार टेस्ट सेट बने।
यह आपको मॉडल प्रदर्शन का अधिक विश्वसनीय अनुमान देता है और एकल टेस्ट सेट पर ओवरफिटिंग किए बिना हाइपरपैरामीटर्स ट्यून करने में मदद करता है।
रेग्युलराइज़ेशन
रेग्युलराइज़ेशन आपके लॉस फंक्शन में सीधे मॉडल जटिलता के लिए पेनल्टी जोड़ता है।
L1 (Lasso) और L2 (Ridge) जैसी तकनीकें बड़े पैरामीटर मानों को हतोत्साहित करती हैं, जिससे मॉडल सरल और अधिक स्थिर रहता है। इससे बायस थोड़ा बढ़ता है पर वेरीयंस घटता है, जो अक्सर कुल टेस्ट प्रदर्शन में सुधार लाता है।
न्यूरल नेटवर्क में dropout भी इसी तरह काम करता है—यह ट्रेनिंग के दौरान कुछ न्यूरॉन्स को यादृच्छिक रूप से हटा देता है, जिससे नेटवर्क विशिष्ट पैरामीटर्स पर अधिक निर्भर नहीं रहता और ओवरफिटिंग घटती है।
अधिक डेटा बनाम बेहतर मॉडल
उच्च वेरीयंस के लिए अधिक ट्रेनिंग डेटा अक्सर सर्वोत्तम समाधान होता है।
जब आपके पास अधिक उदाहरण होते हैं, तो आपका मॉडल संभावित पैटर्न का व्यापक नमूना देखता है। इससे शोर पर ओवरफिट करना कठिन हो जाता है क्योंकि शोर अधिक बिंदुओं पर औसत हो जाता है। वेरीयंस घटता है, और जटिल मॉडल का निम्न बायस भी बना रहता है।
पर अधिक डेटा इकट्ठा करना हमेशा व्यावहारिक या संभव नहीं होता।
यदि आप सीमित डेटा में फँसे हैं, तो मॉडल चयन पर ध्यान दें—सरल मॉडल चुनें, रेग्युलराइज़ेशन जोड़ें, या ऐसे एंसेंबल तरीकों का उपयोग करें जो वेरीयंस घटाने के लिए कई मॉडलों को संयोजित करते हैं।
फीचर चयन
हर फीचर आपके मॉडल में सुधार नहीं लाता। कुछ तो केवल शोर ही जोड़ेंगे।
अप्रासंगिक या अनावश्यक फीचर्स हटाएँ ताकि बिना महत्वपूर्ण पैटर्न खोए मॉडल जटिलता घटे। कम फीचर्स का अर्थ कम पैरामीटर्स सीखना है, जिससे वेरीयंस घटता है। आप उच्च-आयामी स्पेस में सीमित डेटा के साथ मॉडलों के संघर्ष—डायमेंशनलिटी के अभिशाप—से भी बचते हैं।
सहसंबंध विश्लेषण, ट्री-आधारित मॉडलों से फीचर इंपॉर्टेंस स्कोर, या ऐसे रेग्युलराइज़ेशन तरीकों का उपयोग करें जो स्वतः ही गैर-महत्वपूर्ण फीचर्स को शून्य कर दें।
लक्ष्य है—शोर के बिना सिग्नल पकड़ने वाला न्यूनतम फीचर सेट खोजना।
बायस-वेरीयंस ट्रेडऑफ के बारे में आम गलतफहमियाँ
तीन आम भूलों को साफ़ कर लेते हैं जो लोगों को गलत मॉडलिंग निर्णय लेने पर मजबूर करती हैं।
"कम बायस हमेशा बेहतर होता है"
गलत। कम बायस का अर्थ है कि आपका मॉडल जटिल पैटर्न प्रस्तुत कर सकता है, पर यह तभी उपयोगी है जब वे पैटर्न वास्तव में आपके डेटा में हों और नए उदाहरणों पर सामान्यीकृत हों।
जटिलता जोड़कर बायस घटाने से अक्सर वेरीयंस इतनी तेज़ी से बढ़ता है कि बायस कम होने का लाभ खत्म हो जाता है। अंत में मॉडल ट्रेनिंग डेटा को पूरी तरह फिट कर लेता है पर टेस्ट डेटा पर बदतर प्रदर्शन करता है। लक्ष्य कुल त्रुटि को कम करना है, केवल बायस को नहीं।
कभी-कभी अधिक बायस वाला सरल मॉडल समग्र रूप से बेहतर प्रदर्शन करता है क्योंकि उसका वेरीयंस पर्याप्त रूप से कम होता है, जिससे वह अच्छी तरह सामान्यीकृत करता है।
"ओवरफिटिंग का मतलब मॉडल खराब है"
पूरी तरह नहीं। ओवरफिटिंग का अर्थ है कि आपका मॉडल आपके पास मौजूद डेटा की मात्रा के लिए बहुत जटिल है, पर मॉडल स्वयं जन्मगत रूप से खराब नहीं है।
वही न्यूरल नेटवर्क आर्किटेक्चर जो 1,000 ट्रेनिंग उदाहरणों पर ओवरफिट करता है, 100,000 उदाहरणों पर बेहतरीन प्रदर्शन कर सकता है। समस्या क्षमता और डेटा आकार के मिसमैच में है।
आप ओवरफिटिंग को अधिक डेटा जोड़कर, जटिलता घटाकर, या रेग्युलराइज़ेशन लागू करके ठीक कर सकते हैं। आपको मॉडल फेंककर पूरी तरह अलग चीज़ से शुरू करने की ज़रूरत नहीं।
"अधिक डेटा हमेशा वेरीयंस ठीक कर देता है"
अधिक डेटा वेरीयंस घटाता है, पर उसे समाप्त नहीं करता, और मदद की भी एक सीमा है।
यदि आपका मॉडल आपकी समस्या के सापेक्ष अत्यधिक जटिल है, तो बड़े डाटासेट्स भी उसे पर्याप्त रूप से स्थिर नहीं कर सकते। लाखों पैरामीटर्स वाला न्यूरल नेटवर्क अच्छे से ट्रेन होने के लिए भारी मात्रा में डेटा चाहता है।
साथ ही, अधिक डेटा तभी मदद करता है जब नया डेटा आपके टेस्ट डेटा के समान वितरण का प्रतिनिधित्व करे। अधिक पक्षपाती या शोरयुक्त डेटा इकट्ठा करना वेरीयंस नहीं घटाएगा—यह स्थिति और बिगाड़ भी सकता है, गैर-सामान्यीकृत होने वाले पैटर्न को और मजबूत करके।
बायस-वेरीयंस ट्रेडऑफ बनाम ओवरफिटिंग और अंडरफिटिंग
बायस-वेरीयंस और ओवरफिटिंग-अंडरफिटिंग एक ही समस्याओं को अलग कोण से वर्णित करते हैं, पर ये परस्पर विनिमेय शब्द नहीं हैं।
याद रखने की बातें:
बायस और वेरीयंस आपके मॉडल के गुण हैं।
ये बताते हैं कि अलग-अलग ट्रेनिंग सेट्स पर आपका मॉडल कैसा व्यवहार करता है। आप बायस को इस तरह नाप सकते हैं कि मॉडल की औसत भविष्यवाणी सच से कितनी दूर है। आप वेरीयंस को इस तरह नाप सकते हैं कि अलग ट्रेनिंग डेटा के साथ भविष्यवाणियाँ कितनी बदलती हैं।
अंडरफिटिंग और ओवरफिटिंग वे लक्षण हैं जो आप देखते हैं।
ये बताते हैं कि जब आप अपने मॉडल को ट्रेन और टेस्ट करते हैं तो क्या होता है। जब ट्रेनिंग और टेस्ट दोनों त्रुटियाँ अधिक हों, तो अंडरफिटिंग दिखती है। जब ट्रेनिंग त्रुटि कम पर टेस्ट त्रुटि अधिक हो, तो ओवरफिटिंग दिखती है।
संबंध सीधा है पर एक-से-एक नहीं। उच्च बायस प्रायः अंडरफिटिंग की ओर ले जाता है, और उच्च वेरीयंस प्रायः ओवरफिटिंग की ओर। पर मध्यम बायस और मध्यम वेरीयंस वाला मॉडल भी न तो अंडरफिट कर सकता है, न ओवरफिट—फिर भी अन्य कारणों, जैसे गलत फीचर्स या अपर्याप्त डेटा गुणवत्ता, के चलते खराब प्रदर्शन कर सकता है।
मॉडल प्रदर्शन की व्याख्या के व्यावहारिक सुझाव
यहाँ कुछ अंतिम समय के सुझाव हैं कि बायस-वेरीयंस समस्याओं का निदान कैसे करें और बेहतर मॉडलिंग निर्णय कैसे लें।
ट्रेनिंग और वैलिडेशन त्रुटि को साथ में देखें, अलग-अलग नहीं
सिर्फ ट्रेनिंग त्रुटि आपको सामान्यीकरण के बारे में कुछ नहीं बताती। 1% ट्रेनिंग त्रुटि वाला मॉडल भी यदि ओवरफिट कर रहा हो तो 50% टेस्ट त्रुटि दे सकता है।
क्या हो रहा है, यह समझने के लिए दोनों त्रुटियों की तुलना करें।
सिर्फ ट्रेनिंग एक्यूरेसी के लिए ऑप्टिमाइज़ न करें
परफेक्ट ट्रेनिंग एक्यूरेसी एक लाल झंडा है। यह आमतौर पर बताता है कि आपने ट्रेनिंग सेट याद कर लिया है, सामान्यीकृत होने वाले पैटर्न नहीं सीखे।
इसके बजाय वैलिडेशन प्रदर्शन पर ध्यान दें। आपका लक्ष्य ट्रेनिंग और वैलिडेशन त्रुटि के बीच का अंतर कम करना है, साथ ही दोनों को यथोचित रूप से कम रखना।
विश्वसनीय अनुमान के लिए क्रॉस-वैलिडेशन का उपयोग करें
एकल ट्रेन-टेस्ट स्प्लिट भ्रामक हो सकता है क्योंकि यह इस पर निर्भर करता है कि किन उदाहरणों को किस सेट में डाला गया। एक बदकिस्मत स्प्लिट अच्छे मॉडल को बुरा या बुरे मॉडल को अच्छा दिखा सकता है।
क्रॉस-वैलिडेशन कई स्प्लिट्स में प्रदर्शन का औसत लेता है, जिससे नए डेटा पर मॉडल के प्रदर्शन का अधिक स्थिर अनुमान मिलता है। यह विशेष रूप से तब महत्वपूर्ण है जब आपके पास सीमित डेटा हो या आप हाइपरपैरामीटर्स ट्यून कर रहे हों।
डेटा आकार के आधार पर सादगी और लचीलेपन का संतुलन बनाएँ
छोटे डाटासेट्स के साथ, सरल मॉडलों की ओर झुकें। वे अधिक स्थिर होते हैं और कम उदाहरणों से सीखते समय ओवरफिट होने की संभावना कम होती है।
बड़े डाटासेट्स के साथ, आप अधिक जटिल मॉडलों का खर्च उठा सकते हैं क्योंकि अतिरिक्त डेटा सीखने की प्रक्रिया को स्थिर करता है और वेरीयंस घटाता है। पर केवल इसलिए जटिलता न जोड़ें कि आप जोड़ सकते हैं—उसे तभी जोड़ें जब वह वैलिडेशन प्रदर्शन सुधारती हो।
निष्कर्ष
आप शून्य बायस और शून्य वेरीयंस वाला मॉडल नहीं बना सकते। आपके हर मॉडलिंग निर्णय से इन दो त्रुटि-स्रोतों के बीच का संतुलन बदलता है। जटिलता बढ़ाएँ तो बायस घटता है पर वेरीयंस बढ़ता है। सरल करें तो वेरीयंस घटता है पर बायस बढ़ता है।
मॉडल प्रदर्शन सही संतुलन खोजने पर निर्भर करता है। सर्वश्रेष्ठ मॉडल वह है जो आपके विशिष्ट समस्या और डाटासेट के लिए बायस और वेरीयंस का संतुलन बनाकर कुल त्रुटि को न्यूनतम करे। इस ट्रेडऑफ को समझने का अर्थ है कि आप पहचान सकते हैं कि आपका मॉडल उच्च बायस से ग्रस्त है या उच्च वेरीयंस से—और फिर सही समाधान लागू कर सकते हैं।
यदि आप मशीन लर्निंग में हाथ-on अनुभव के लिए तैयार हैं, तो हमारे Machine Learning Fundamentals in Python ट्रैक में नामांकन करें। इसमें 16 घंटे की वीडियो सामग्री है जो आपकी पहली नौकरी पाने में मदद करेगी।