Đánh đổi độ chệch - phương sai giải thích vì sao hiệu suất mô hình không chỉ là vấn đề về độ phức tạp hay độ chính xác, mà là tìm điểm ngọt nơi mô hình của bạn khái quát hóa tốt cho dữ liệu chưa thấy mà không đơn giản hóa quá mức vấn đề hoặc quá khớp với tập huấn luyện.
Trong bài viết này, tôi sẽ giải thích độ chệch và phương sai thực sự có nghĩa là gì trong học máy, cách chúng đánh đổi lẫn nhau, và vì sao hiểu được sự đánh đổi này giúp bạn xây dựng các mô hình vững vàng hơn.
Nếu bạn mới bắt đầu với học máy, bài viết Cách học Machine Learning năm 2026 của chúng tôi sẽ giúp bạn thành thạo trong thời gian ngắn.
Độ chệch là gì?
Độ chệch là sai số phát sinh từ việc đưa ra các giả định quá đơn giản về dữ liệu của bạn. Nó không liên quan đến định kiến theo nghĩa xã hội, ít nhất là trong học máy.
Khi một mô hình có độ chệch cao, nghĩa là mô hình quá cứng nhắc để bắt được các mẫu thực trong dữ liệu của bạn. Hãy hình dung như cố gắng khớp một đường thẳng qua dữ liệu rõ ràng là cong: Dù bạn điều chỉnh đường thẳng ra sao thì nó cũng không bao giờ khớp được hình dạng thật.
Điều này được gọi là thiếu khớp.
Một mô hình có độ chệch cao sẽ đơn giản hóa quá mức vấn đề. Nó giả định các mối quan hệ đơn giản hơn thực tế, nên bỏ lỡ những mẫu quan trọng giúp dự đoán chính xác.
Hãy tưởng tượng bạn dự đoán giá nhà dựa trên diện tích, số phòng ngủ, vị trí và tuổi nhà. Một mô hình có độ chệch cao có thể chỉ dùng diện tích và bỏ qua mọi thứ khác. Nó giả định chỉ riêng diện tích quyết định giá, điều này quá đơn giản.
Kết quả là một mô hình hoạt động kém trên cả dữ liệu huấn luyện lẫn dữ liệu mới vì nó không thể nắm bắt được độ phức tạp của giá nhà thực tế.
Hồi quy tuyến tính với ít đặc trưng là ví dụ kinh điển của mô hình có độ chệch cao. Cây quyết định với độ sâu rất hạn chế cũng thường có độ chệch cao vì chúng không thể phân chia dữ liệu đủ nhiều lần để tìm các mẫu tinh vi.
Độ chệch cao có nghĩa là mô hình của bạn không học đủ từ dữ liệu, mà thay vào đó biến vấn đề thành quá đơn giản để đạt độ chính xác tốt.
Phương sai là gì?
Phương sai đo lường mức độ nhạy của mô hình đối với dữ liệu huấn luyện cụ thể mà bạn sử dụng.
Nó không liên quan đến thước đo thống kê về độ phân tán dữ liệu. Trong học máy, phương sai mô tả hành vi của mô hình, không phải phân phối dữ liệu.
Khi một mô hình có phương sai cao, những thay đổi nhỏ trong dữ liệu huấn luyện sẽ dẫn đến thay đổi lớn trong dự đoán của mô hình. Nói cách khác, khi bạn huấn luyện cùng một mô hình trên hai bộ dữ liệu hơi khác nhau, bạn sẽ nhận được kết quả khác nhau rất nhiều.
Điều này được gọi là quá khớp.
Một mô hình có phương sai cao quá linh hoạt. Nó học không chỉ các mẫu thực trong dữ liệu mà còn cả nhiễu và dao động ngẫu nhiên không khái quát hóa được cho dữ liệu mới. Về bản chất, mô hình ghi nhớ các ví dụ huấn luyện thay vì học các mối quan hệ cốt lõi.
Hãy tưởng tượng bạn vẫn đang dự đoán giá nhà, nhưng giờ dùng một mô hình phức tạp với hàng trăm tham số. Nó có thể học rằng nhà trên Phố Oak luôn bán đúng $427,350 vì đó là những gì diễn ra trong dữ liệu huấn luyện của bạn.
Kết quả là mô hình hoạt động rất tốt trên dữ liệu huấn luyện nhưng tệ trên dữ liệu mới vì nó đã học các đặc trưng riêng của tập huấn luyện.
Mạng nơ-ron sâu và cây quyết định không giới hạn độ sâu là những mô hình phương sai cao kinh điển. Chúng đủ linh hoạt để khớp gần như mọi mẫu, kể cả những mẫu vô nghĩa.
Phương sai cao có nghĩa là mô hình của bạn học quá nhiều từ dữ liệu. Nó khớp cả nhiễu lẫn tín hiệu, khiến mô hình không ổn định và không tin cậy trên ví dụ mới.
Độ chệch so với phương sai: Khác biệt chính
Độ chệch và phương sai là hai nguồn sai số dự đoán hoàn toàn khác nhau. Khi hiểu rõ khác biệt, bạn sẽ nhanh hơn trong việc chẩn đoán vấn đề của mô hình.
- Độ chệch xuất phát từ các giả định của mô hình. Nó liên quan đến thuật toán bạn chọn, các đặc trưng bạn đưa vào và cách bạn cấu trúc vấn đề. Mô hình hồi quy tuyến tính giả định mối quan hệ tuyến tính, nên sẽ có độ chệch khi mối quan hệ thực tế là phi tuyến. Sai số này tồn tại ngay cả trước khi bạn xem dữ liệu huấn luyện.
- Phương sai xuất phát từ độ nhạy với dữ liệu huấn luyện. Nó nói về việc mô hình của bạn thay đổi bao nhiêu khi huấn luyện trên các mẫu khác nhau từ cùng một quần thể. Mô hình có phương sai cao học các mẫu khác nhau từ những tập huấn luyện hơi khác nhau, khiến dự đoán không ổn định.
Đây là cách độ chệch và phương sai ảnh hưởng đến sai số dự đoán:
- Độ chệch cao nghĩa là mô hình của bạn mắc sai lầm nhất quán theo cùng một hướng. Nó luôn dự đoán thấp hoặc cao hơn cho một số mẫu nhất định vì không thể biểu diễn mối quan hệ thật. Các sai số có tính hệ thống và có thể đoán trước.
- Phương sai cao nghĩa là mô hình mắc các sai lầm không nhất quán, thay đổi theo dữ liệu. Huấn luyện bằng dữ liệu ngày thứ Hai thì dự đoán một kiểu. Huấn luyện bằng dữ liệu ngày thứ Ba thì dự đoán kiểu hoàn toàn khác. Các sai số là ngẫu nhiên và khó dự đoán.
Vấn đề là giảm cái này thường làm tăng cái kia.
Khi bạn làm mô hình phức tạp hơn để giảm độ chệch, bạn tăng độ linh hoạt. Độ linh hoạt đó khiến mô hình nhạy cảm hơn với dữ liệu huấn luyện, làm tăng phương sai. Khi bạn đơn giản hóa mô hình để giảm phương sai, bạn loại bỏ khả năng nắm bắt các mẫu phức tạp, làm tăng độ chệch.
Mối quan hệ nghịch đảo này là lý do bạn không thể đồng thời tối thiểu hóa cả hai. Thay vào đó, bạn phải tìm sự cân bằng đem lại tổng sai số thấp nhất.
Đánh đổi độ chệch - phương sai là gì?
Đánh đổi độ chệch - phương sai mô tả sự căng kéo giữa hai nguồn sai số này - khi bạn giảm một bên, hầu như luôn làm tăng bên còn lại.
Hãy hình dung như sau: bạn đang cố bắn trúng mục tiêu, nhưng có hai vấn đề đối nghịch nhau. Bạn có thể ngắm kỹ hơn (giảm độ chệch), nhưng điều đó khiến bạn nhạy cảm hơn với gió và run tay (tăng phương sai). Hoặc bạn dùng tư thế bắn đơn giản, ổn định hơn (giảm phương sai), nhưng hạn chế độ chính xác (tăng độ chệch).
Độ phức tạp của mô hình nằm ở trung tâm của sự đánh đổi này.
Khi bạn dùng mô hình đơn giản với ít tham số, bạn có độ chệch cao và phương sai thấp. Mô hình đưa ra các giả định nhất quán và không thay đổi nhiều với các dữ liệu huấn luyện khác nhau, nhưng không thể nắm bắt các mẫu phức tạp.
Khi bạn dùng mô hình phức tạp với nhiều tham số, bạn có độ chệch thấp và phương sai cao. Mô hình có thể biểu diễn các mối quan hệ tinh vi, nhưng trở nên không ổn định và quá nhạy với các ví dụ cụ thể mà bạn dùng để huấn luyện.
Dưới đây là đường cong khái niệm giải thích điều này:
- Bên trái (mô hình đơn giản): Lỗi huấn luyện cao vì mô hình thiếu khớp. Lỗi kiểm thử cũng cao vì mô hình bỏ lỡ các mẫu thực.
- Ở giữa (mô hình cân bằng): Cả lỗi huấn luyện và kiểm thử đều thấp. Mô hình nắm bắt được các mẫu thực mà không ghi nhớ nhiễu. Đây là điểm ngọt.
- Bên phải (mô hình phức tạp): Lỗi huấn luyện rất thấp vì mô hình khớp mọi thứ. Lỗi kiểm thử cao vì mô hình đã học nhiễu.
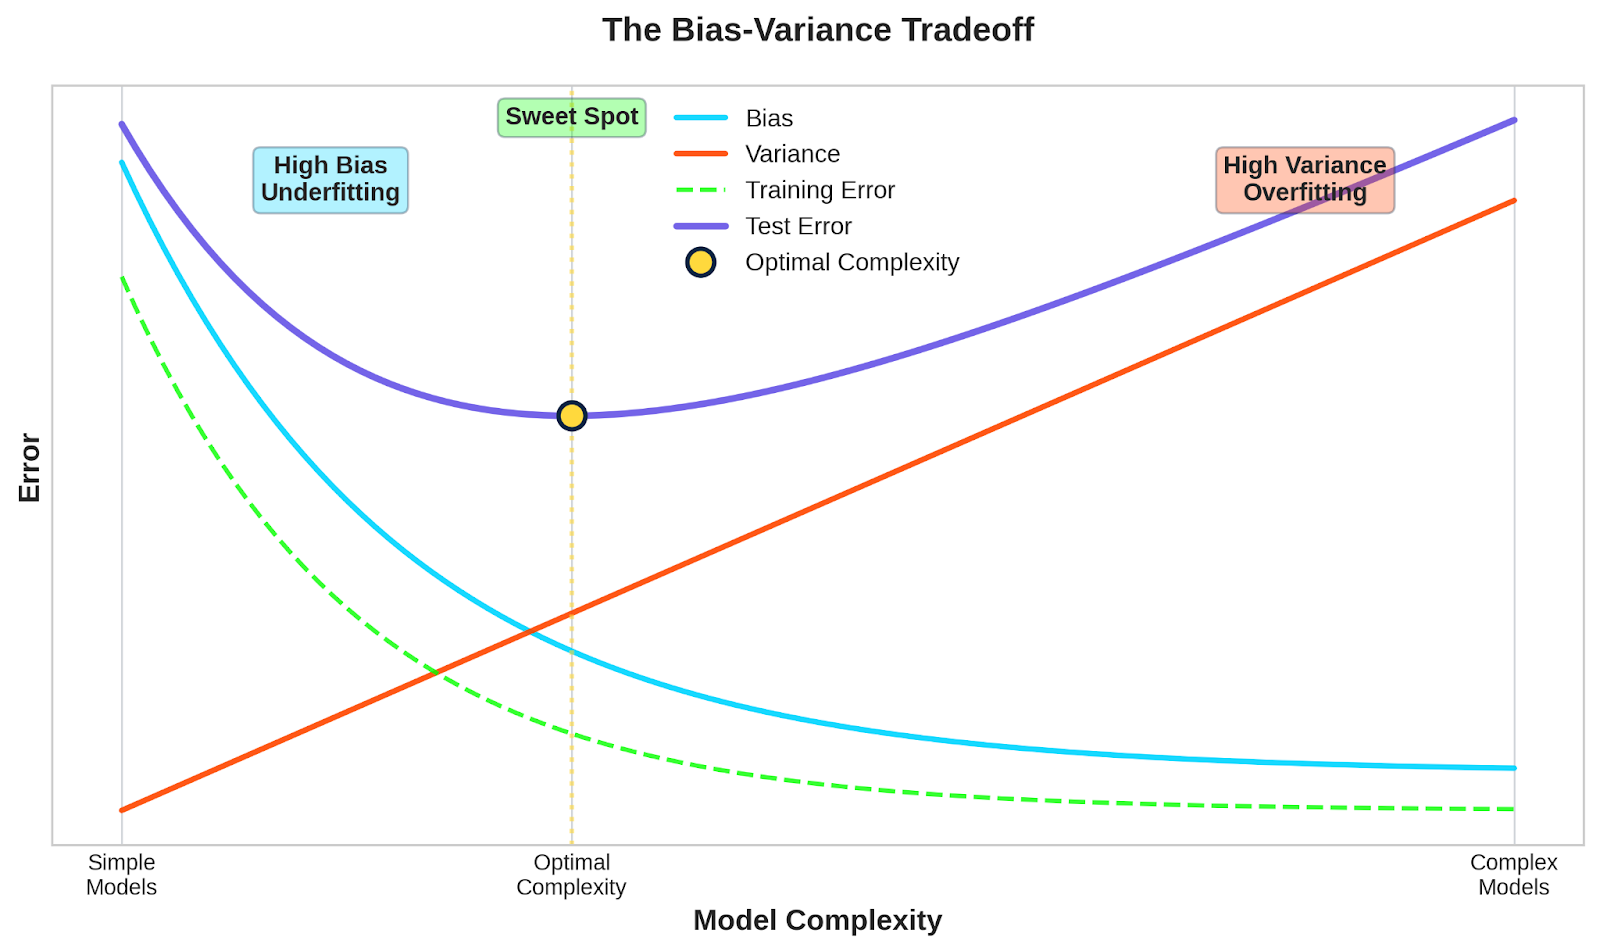
Đường cong đánh đổi độ chệch - phương sai
Bạn đang tìm điểm mà tác động kết hợp của chúng đem lại lỗi kiểm thử thấp nhất.
Không có một mô hình "hoàn hảo" áp dụng cho mọi vấn đề. Cân bằng tối ưu phụ thuộc vào dữ liệu của bạn, độ phức tạp của vấn đề và lượng dữ liệu huấn luyện bạn có. Nhiều dữ liệu hơn thường cho phép bạn dùng mô hình phức tạp hơn mà không quá khớp, dịch chuyển điểm ngọt sang bên phải.
Ví dụ đơn giản về đánh đổi độ chệch - phương sai
Hãy làm khái niệm này trở nên cụ thể với một kịch bản thực tế cho thấy độ chệch và phương sai thể hiện ra sao trong thực hành.
Hãy tưởng tượng bạn xây dựng mô hình dự đoán giá thuê căn hộ trong một thành phố. Bạn có các đặc trưng như diện tích, số phòng ngủ, khu phố, khoảng cách tới tàu điện ngầm, tuổi tòa nhà và tiện ích.
Mô hình đơn giản: Hồi quy tuyến tính với một đặc trưng
Bạn quyết định chỉ dùng diện tích để dự đoán giá với hồi quy tuyến tính đơn.
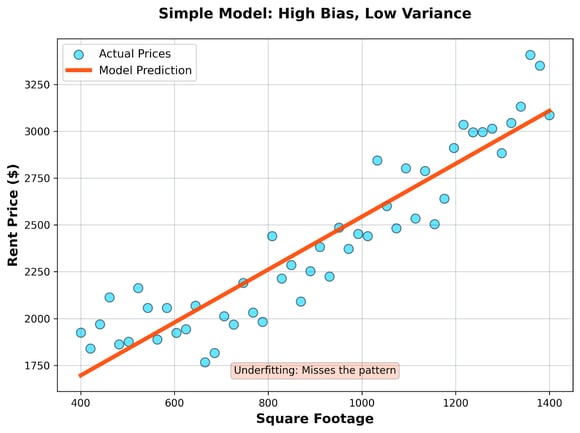
Mô hình đơn giản
- Điều gì xảy ra: Mô hình vẽ một đường thẳng qua các điểm dữ liệu của bạn. Nó dự đoán rằng cứ mỗi 100 foot vuông sẽ cộng thêm một khoản tiền thuê cố định, bất kể vị trí hay yếu tố khác.
- Kết quả: Mô hình này có độ chệch cao và phương sai thấp. Nó liên tục dự đoán thấp cho căn hộ cao cấp và dự đoán cao cho căn hộ studio vì không thể nắm bắt mối quan hệ phức tạp giữa kích thước và giá ở các khu phố khác nhau. Nhưng nếu bạn huấn luyện trên các mẫu căn hộ khác nhau, bạn sẽ thu được xấp xỉ cùng một đường thẳng mỗi lần - ổn định nhưng thiếu chính xác.
Mô hình phức tạp: Mạng nơ-ron sâu với mọi đặc trưng
Giờ bạn xây dựng một mạng nơ-ron sâu với nhiều tầng ẩn, dùng tất cả đặc trưng sẵn có, cộng thêm đặc trưng tạo mới như tỷ lệ tội phạm theo khu, điểm khả năng đi bộ và gần công viên.
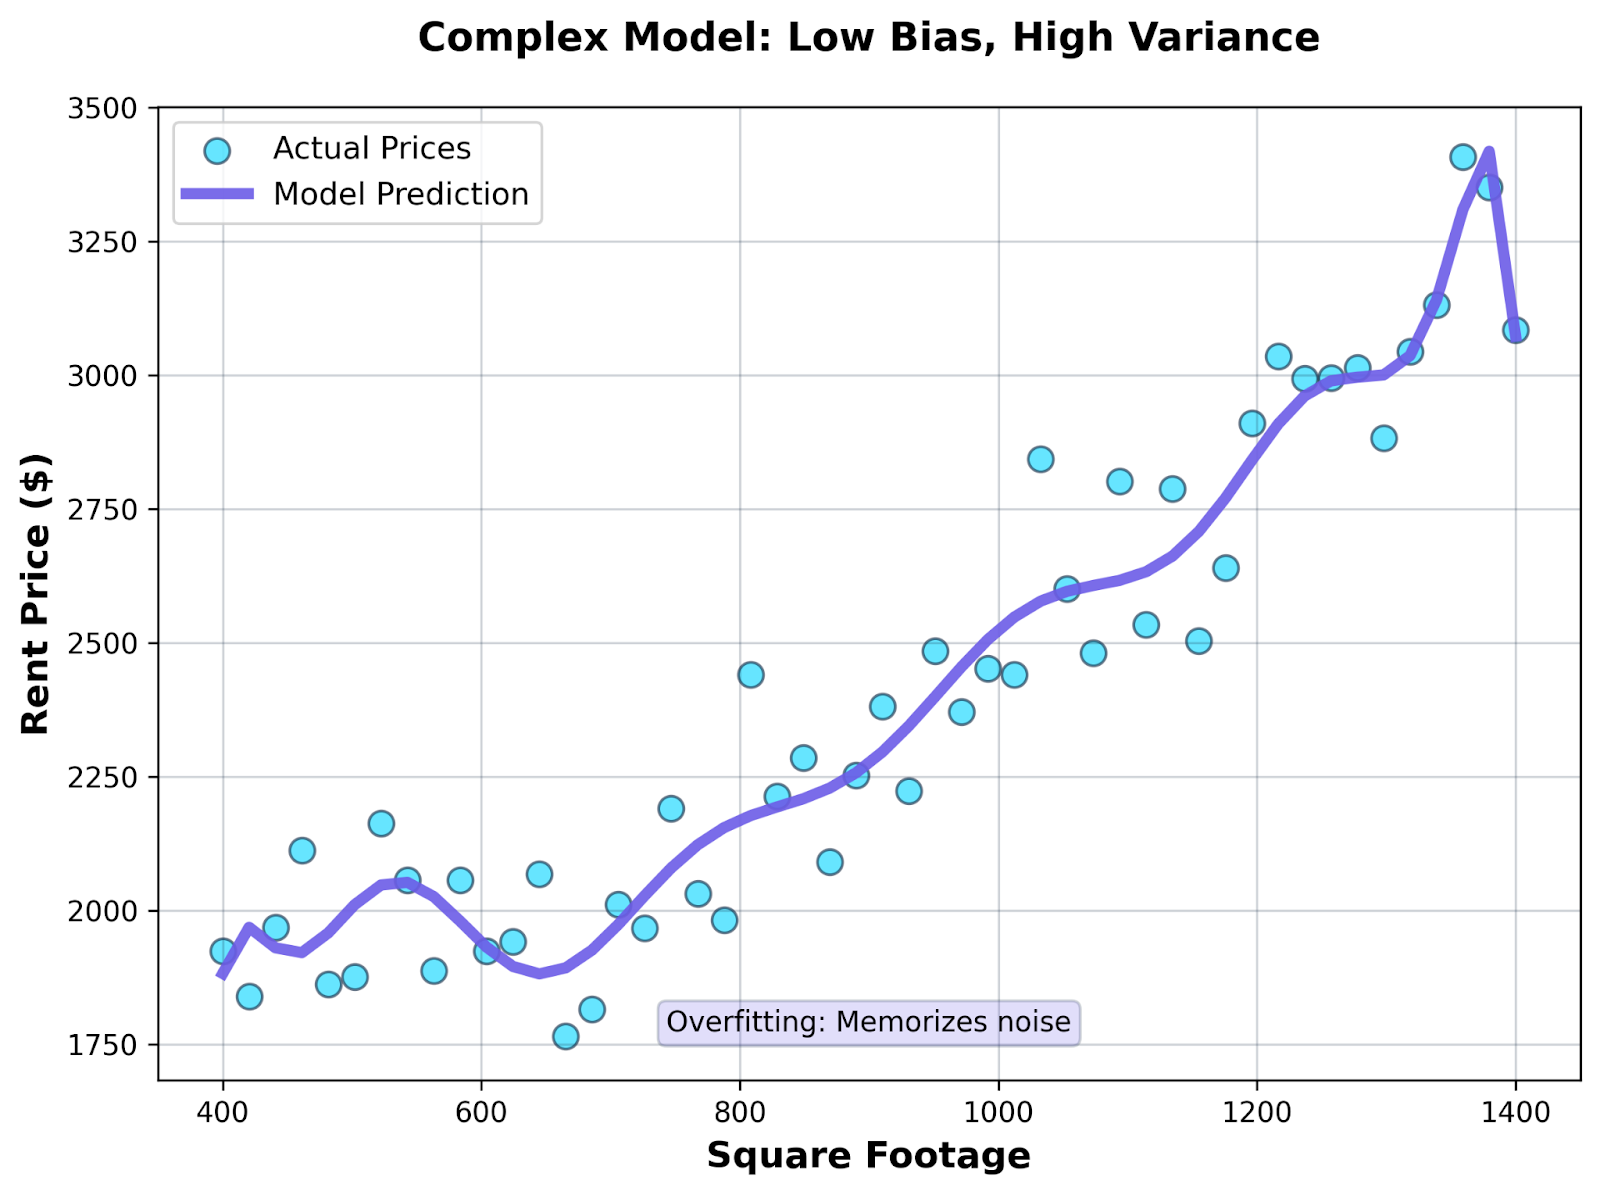
Mô hình phức tạp
- Điều gì xảy ra: Mạng học các mẫu tinh vi. Nó có thể phát hiện rằng các căn hộ tầng 5 trong dữ liệu huấn luyện cụ thể của bạn luôn cho thuê đúng $2,847, hoặc các căn hướng bắc trên Phố Oak cao hơn 37% so với các căn hướng nam.
- Kết quả: Mô hình này có độ chệch thấp và phương sai cao. Nó khớp gần như hoàn hảo dữ liệu huấn luyện và bắt từng chi tiết, dao động. Nhưng các mẫu đó không khái quát hóa - chúng là hiện tượng riêng của mẫu dữ liệu của bạn. Huấn luyện trên một bộ căn hộ khác, nó sẽ học các mẫu hoàn toàn khác. Dự đoán không ổn định và không đáng tin trên dữ liệu mới.
Mô hình cân bằng: Hồi quy có điều chuẩn với đặc trưng chủ chốt
Bạn dùng hồi quy có điều chuẩn (như Ridge hoặc Lasso) với tập đặc trưng được chọn lọc kỹ: diện tích, số phòng ngủ, phân loại khu phố và khoảng cách tới phương tiện công cộng.
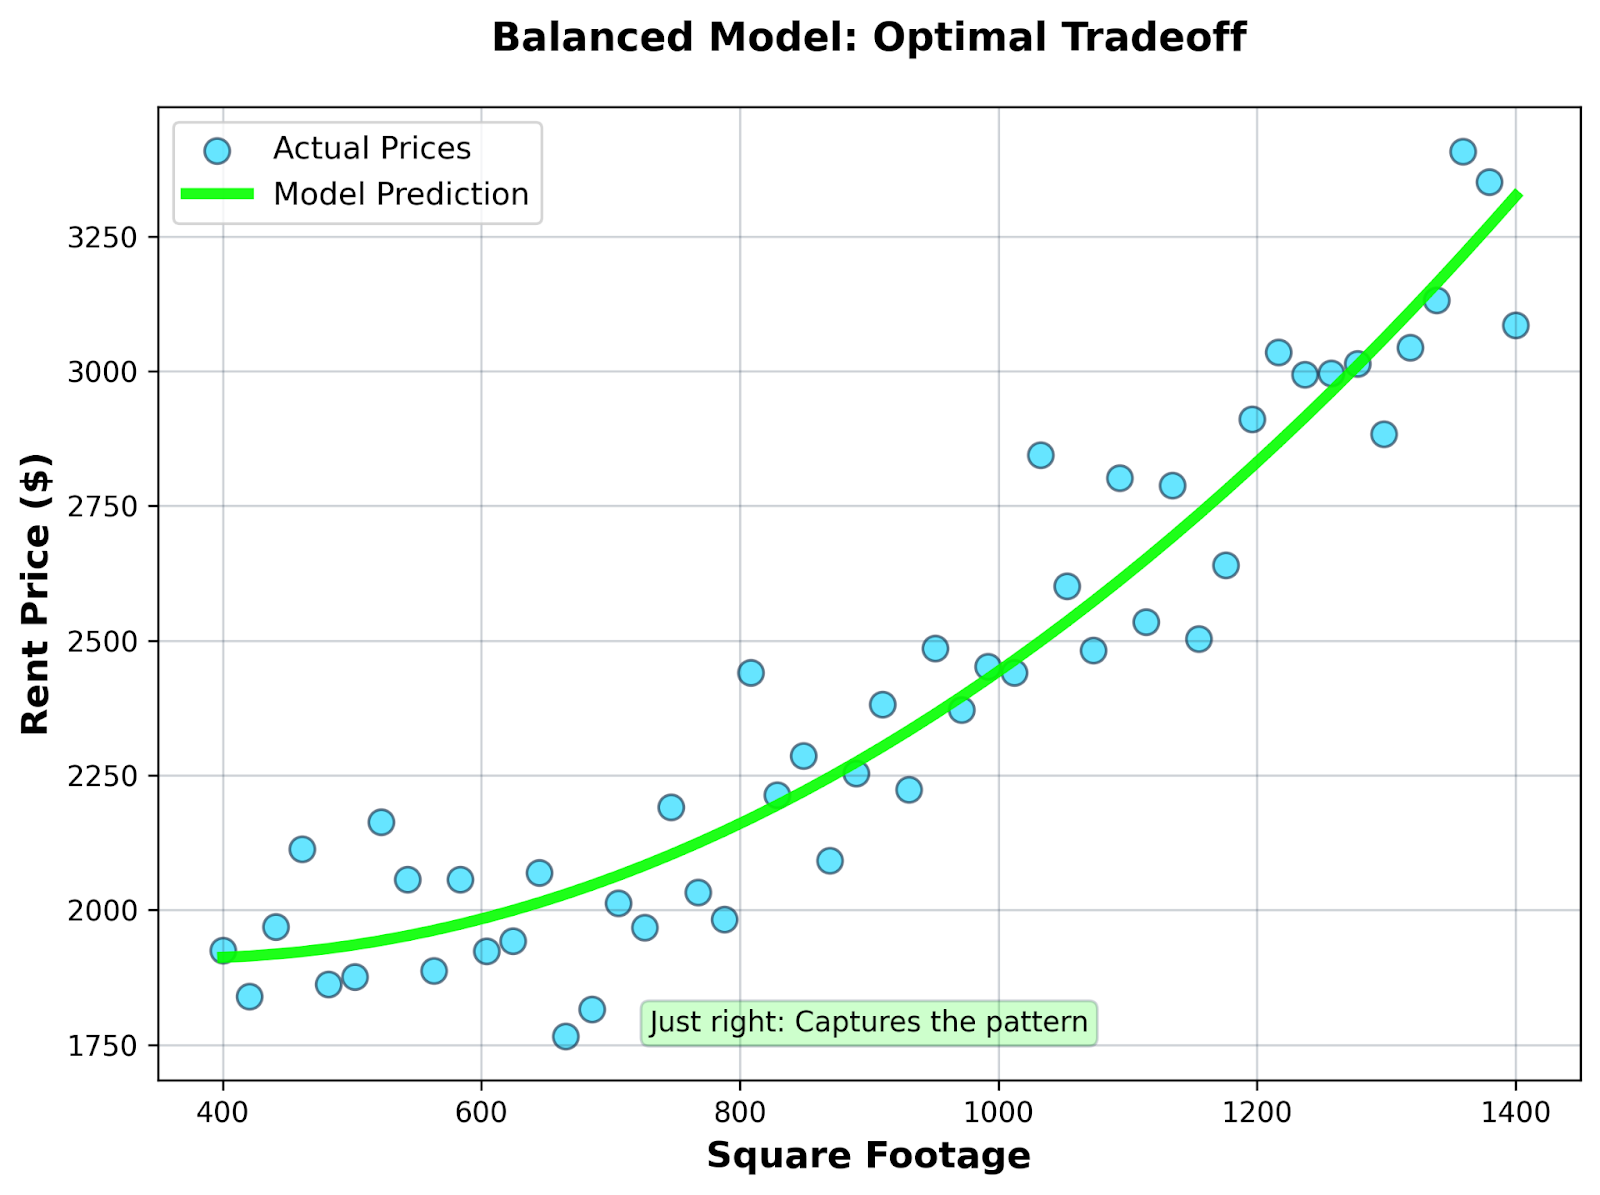
Mô hình cân bằng
- Điều gì xảy ra: Mô hình nắm bắt các mối quan hệ chính mà không ghi nhớ nhiễu. Nó học rằng kích thước và vị trí quan trọng, nhưng không ám ảnh mọi biến động nhỏ trong dữ liệu huấn luyện.
- Kết quả: Mô hình này cân bằng độ chệch và phương sai. Nó đủ linh hoạt để nắm các mẫu thực nhưng đủ ràng buộc để tránh quá khớp. Lỗi huấn luyện ở mức vừa phải, nhưng lỗi kiểm thử thấp - đó mới là điều quan trọng cho dự đoán trên căn hộ mới.
Mô hình cân bằng sẽ không khớp hoàn hảo dữ liệu huấn luyện, và đó chính là mục tiêu.
Đánh đổi độ chệch - phương sai trong các mô hình học máy
Các thuật toán học máy khác nhau tự nhiên nghiêng về độ chệch cao hoặc phương sai cao. Bạn cần hiểu các xu hướng này để chọn đúng công cụ cho vấn đề của mình.
Mô hình tuyến tính
Hồi quy tuyến tính và hồi quy logistic nằm ở đầu phổ có độ chệch cao.
Các mô hình này giả định mối quan hệ là tuyến tính - một đặc trưng thay đổi thì đầu ra thay đổi một lượng cố định. Khi dữ liệu của bạn có mẫu phi tuyến, mối quan hệ cong, hoặc tương tác phức tạp giữa các đặc trưng, mô hình tuyến tính không thể nắm bắt chúng.
Điểm cộng là tính ổn định. Huấn luyện mô hình tuyến tính trên các mẫu khác nhau của dữ liệu, bạn sẽ nhận được các hệ số tương tự mỗi lần. Phương sai thấp, nhưng có thể độ chệch cao nếu mối quan hệ thực không tuyến tính.
Cây quyết định
Cây quyết định có thể hành xử khác nhau tùy cách bạn cấu hình.
Một cây nông với chỉ vài lần chia tách hoạt động như mô hình đơn giản - độ chệch cao, phương sai thấp. Nó đưa ra các khái quát rộng và không thể nắm bắt các mẫu chi tiết.
Một cây sâu không giới hạn độ sâu trở nên vô cùng linh hoạt. Nó tiếp tục chia cho đến khi mỗi lá chỉ chứa vài điểm dữ liệu, nghĩa là nó ghi nhớ dữ liệu huấn luyện. Độ chệch thấp nhưng phương sai rất cao - cấu trúc cây thay đổi đáng kể với các mẫu huấn luyện khác nhau.
Đó là lý do rừng ngẫu nhiên hoạt động tốt. Chúng bình quân dự đoán từ nhiều cây, giảm vấn đề phương sai đồng thời giữ độ chệch thấp.
K-láng giềng gần nhất
Cân bằng độ chệch - phương sai của KNN hoàn toàn phụ thuộc vào lựa chọn k của bạn.
Khi k nhỏ (như k=1 hoặc k=3), mô hình có phương sai cao. Nó dựa vào chỉ vài điểm gần nhất để dự đoán, nên cực kỳ nhạy với các ví dụ cụ thể trong tập huấn luyện. Thay đổi nhỏ trong dữ liệu huấn luyện dẫn đến dự đoán hoàn toàn khác.
Khi k lớn (như k=50 hoặc k=100), mô hình có độ chệch cao. Nó bình quân trên quá nhiều láng giềng đến mức làm mờ các mẫu cục bộ và bỏ lỡ những chi tiết quan trọng trong dữ liệu.
Giá trị k tối ưu nằm đâu đó ở giữa, cân bằng hai thái cực này.
Mạng nơ-ron
Mạng nơ-ron vốn dĩ là các mô hình có phương sai cao vì chúng có quá nhiều tham số cần học.
Một mạng với nhiều tầng và hàng trăm nơ-ron có thể biểu diễn các hàm cực kỳ phức tạp. Sự linh hoạt này đồng nghĩa với độ chệch thấp - mạng có thể học gần như mọi mẫu. Nhưng nó cũng đồng nghĩa với phương sai cao - trọng số học được phụ thuộc nặng vào dữ liệu huấn luyện cụ thể, khởi tạo và quá trình huấn luyện.
Đó là lý do các mạng nơ-ron cần bộ dữ liệu lớn để hoạt động tốt. Nhiều dữ liệu huấn luyện giúp ổn định quá trình học và giảm phương sai. Cũng vì thế mà các kỹ thuật như dropout, chuẩn hóa theo lô và dừng sớm tồn tại - tất cả nhằm kiểm soát phương sai và ngăn quá khớp.
Các mạng nhỏ hơn với ít tầng và ít nơ-ron có độ chệch cao hơn nhưng phương sai thấp hơn, trong khi mạng lớn hơn có độ chệch thấp hơn nhưng phương sai cao hơn.
Độ phức tạp mô hình ảnh hưởng đến độ chệch và phương sai thế nào
Đáng tiếc là độ phức tạp của mô hình không phải một con số đơn lẻ bạn có thể đo. Nó nói về mức độ linh hoạt của mô hình trong việc khớp các mẫu khác nhau.
Độ phức tạp đến từ nhiều nguồn, như nhiều đặc trưng hơn, nhiều tầng hơn trong mạng nơ-ron, cây quyết định sâu hơn, các hạng tử đa thức trong hồi quy, hoặc giá trị k thấp hơn trong KNN. Điểm chung là chúng cho mô hình của bạn nhiều tự do hơn để khớp các mẫu tinh vi trong dữ liệu.
Khi bạn thêm tham số, bạn trao cho mô hình nhiều cách hơn để biểu diễn các mối quan hệ trong dữ liệu. Một mô hình tuyến tính với 3 đặc trưng chỉ có thể vẽ một mặt phẳng phẳng qua dữ liệu. Nếu bạn thêm các hạng tử đa thức và đặc trưng tương tác, nó có thể uốn cong để khớp các mẫu phức tạp hơn. Giả định của mô hình bớt ràng buộc, nghĩa là độ chệch thấp hơn.
Nhưng sự linh hoạt này phải trả giá, tức là tăng phương sai.
Nhiều tham số đồng nghĩa nhiều giá trị phải học từ dữ liệu huấn luyện. Mỗi tham số được tinh chỉnh để khớp các ví dụ huấn luyện cụ thể, khiến mô hình nhạy cảm hơn với những ví dụ bạn vô tình đưa vào. Khi bạn thay đổi vài mẫu huấn luyện, tất cả tham số sẽ dịch chuyển để thích nghi dữ liệu mới. Mô hình trở nên không ổn định.
Đó là lý do chỉ nhìn lỗi huấn luyện là sai lầm và nguy hiểm.
Khi bạn tăng độ phức tạp, lỗi huấn luyện sẽ luôn giảm. Mô hình khớp dữ liệu huấn luyện ngày càng tốt, cuối cùng đạt độ chính xác gần như hoàn hảo. Điều này trông rất ổn cho đến khi bạn nhận ra mô hình đang ghi nhớ nhiễu thay vì học các mẫu.
Lỗi trên tập kiểm thử sẽ cho bạn biết mô hình thực sự tốt đến đâu.
Ban đầu, khi bạn thêm độ phức tạp, lỗi kiểm thử giảm vì mô hình bắt đầu nắm bắt các mẫu thực. Nhưng vượt qua một ngưỡng, lỗi kiểm thử tăng dù lỗi huấn luyện tiếp tục giảm. Mô hình đang quá khớp - học các đặc điểm riêng của tập huấn luyện không khái quát hóa được.
Khoảng cách nhỏ giữa lỗi huấn luyện và kiểm thử nghĩa là mô hình của bạn khái quát hóa tốt. Khoảng cách lớn nghĩa là bạn đang quá khớp và cần giảm độ phức tạp hoặc thêm dữ liệu huấn luyện.
Kỹ thuật quản lý đánh đổi độ chệch - phương sai
Bạn không thể loại bỏ đánh đổi độ chệch - phương sai, nhưng bạn có thể kiểm soát nó bằng các kỹ thuật phù hợp. Hãy cùng xem vài cách.
Chia tập huấn luyện/kiểm thử
Không bao giờ đánh giá mô hình trên chính dữ liệu đã dùng để huấn luyện.
Hãy chia dữ liệu của bạn thành tập huấn luyện và tập kiểm thử trước khi làm bất kỳ điều gì khác. Huấn luyện trên một phần, đánh giá trên phần còn lại. Điều này cho bạn thước đo trung thực về khả năng mô hình khái quát hóa cho dữ liệu mới.
Tập kiểm thử đóng vai trò đại diện cho hiệu suất ngoài đời thực. Khi lỗi huấn luyện thấp nhưng lỗi kiểm thử cao, bạn biết mình đang quá khớp. Khi cả hai đều cao, bạn đang thiếu khớp.
Xác thực chéo
Chia huấn luyện/kiểm thử có điểm yếu - nó phụ thuộc vào những ví dụ cụ thể rơi vào mỗi tập.
Xác thực chéo khắc phục bằng cách huấn luyện và kiểm thử nhiều lần trên các phép chia khác nhau của dữ liệu. Cách phổ biến nhất là xác thực chéo k-fold, bạn chia dữ liệu thành k phần, huấn luyện trên k-1 phần và kiểm thử trên phần còn lại. Lặp k lần để mỗi phần làm tập kiểm thử một lần.
Cách này cho bạn ước lượng đáng tin cậy hơn về hiệu suất mô hình và giúp tinh chỉnh siêu tham số mà không quá khớp vào một tập kiểm thử duy nhất.
Điều chuẩn
Điều chuẩn thêm một khoản phạt cho độ phức tạp của mô hình trực tiếp vào hàm mất mát.
Các kỹ thuật như L1 (Lasso) và L2 (Ridge) không khuyến khích giá trị tham số lớn, buộc mô hình phải đơn giản và ổn định hơn. Điều này làm tăng nhẹ độ chệch nhưng giảm phương sai, thường cải thiện hiệu suất kiểm thử tổng thể.
Dropout trong mạng nơ-ron hoạt động tương tự - nó ngẫu nhiên loại bỏ nơ-ron trong quá trình huấn luyện, ngăn mạng phụ thuộc quá nhiều vào các tham số cụ thể và giảm quá khớp.
Thêm dữ liệu so với mô hình tốt hơn
Thêm dữ liệu huấn luyện thường là giải pháp tốt nhất cho phương sai cao.
Khi bạn có nhiều ví dụ hơn, mô hình của bạn thấy được mẫu các khả năng rộng hơn để học. Điều này khiến việc quá khớp với nhiễu khó hơn vì nhiễu được bình quân qua nhiều điểm dữ liệu. Phương sai giảm mà không phải hy sinh độ chệch thấp của một mô hình phức tạp.
Nhưng thu thập thêm dữ liệu không phải lúc nào cũng khả thi.
Nếu bạn bị giới hạn dữ liệu, hãy tập trung vào lựa chọn mô hình - chọn mô hình đơn giản hơn, thêm điều chuẩn, hoặc dùng phương pháp tập hợp kết hợp nhiều mô hình để giảm phương sai.
Lựa chọn đặc trưng
Không phải mọi đặc trưng đều cải thiện mô hình. Một số chỉ thêm nhiễu.
Loại bỏ các đặc trưng không liên quan hoặc dư thừa để giảm độ phức tạp mà không mất các mẫu quan trọng. Ít đặc trưng hơn đồng nghĩa ít tham số cần học hơn, làm giảm phương sai. Bạn cũng tránh được lời nguyền chiều không gian, nơi mô hình gặp khó trong không gian nhiều chiều với dữ liệu hạn chế.
Dùng các kỹ thuật như phân tích tương quan, điểm quan trọng đặc trưng từ mô hình dựa trên cây, hoặc các phương pháp điều chuẩn tự động đưa về 0 những đặc trưng không quan trọng.
Mục tiêu là tìm tập đặc trưng tối thiểu nắm bắt tín hiệu mà không mang theo nhiễu.
Hiểu lầm phổ biến về đánh đổi độ chệch - phương sai
Hãy làm rõ ba sai lầm phổ biến dẫn đến các quyết định mô hình kém.
"Độ chệch thấp luôn tốt hơn"
Sai. Độ chệch thấp nghĩa là mô hình có thể biểu diễn các mẫu phức tạp, nhưng điều đó chỉ hữu ích nếu các mẫu đó thực sự tồn tại trong dữ liệu của bạn và khái quát hóa được cho ví dụ mới.
Giảm độ chệch bằng cách tăng độ phức tạp thường làm phương sai tăng nhanh hơn mức giảm độ chệch. Bạn rơi vào mô hình khớp hoàn hảo dữ liệu huấn luyện nhưng hoạt động tệ hơn trên dữ liệu kiểm thử. Mục tiêu là tối thiểu hóa tổng sai số, không chỉ riêng độ chệch.
Đôi khi một mô hình đơn giản hơn với độ chệch cao hơn lại hoạt động tốt hơn tổng thể vì nó có phương sai đủ thấp để khái quát hóa tốt.
"Quá khớp nghĩa là mô hình tệ"
Không hẳn. Quá khớp nghĩa là mô hình của bạn quá phức tạp so với lượng dữ liệu bạn có, nhưng bản thân mô hình không cố hữu là tệ.
Cùng một kiến trúc mạng nơ-ron có thể quá khớp trên 1.000 ví dụ huấn luyện nhưng lại hoạt động hoàn hảo trên 100.000 ví dụ. Vấn đề nằm ở sự không tương xứng giữa năng lực và kích thước dữ liệu.
Bạn có thể khắc phục quá khớp bằng cách thêm dữ liệu, giảm độ phức tạp, hoặc áp dụng điều chuẩn. Bạn không cần vứt bỏ mô hình và bắt đầu lại với thứ hoàn toàn khác.
"Thêm dữ liệu luôn khắc phục phương sai"
Thêm dữ liệu giúp giảm phương sai, nhưng không loại bỏ nó, và có giới hạn cho mức độ hữu ích.
Nếu mô hình của bạn cực kỳ phức tạp so với vấn đề, thậm chí bộ dữ liệu lớn cũng có thể không đủ để ổn định nó. Một mạng nơ-ron với hàng triệu tham số cần lượng dữ liệu khổng lồ để huấn luyện tốt.
Ngoài ra, thêm nhiều dữ liệu chỉ hữu ích nếu dữ liệu mới đại diện cho cùng phân phối với dữ liệu kiểm thử của bạn. Thu thập thêm dữ liệu thiên lệch hoặc nhiễu sẽ không giảm phương sai - thậm chí có thể làm tệ hơn bằng cách củng cố các mẫu không khái quát hóa được.
Đánh đổi độ chệch - phương sai so với quá khớp và thiếu khớp
Độ chệch - phương sai và quá khớp - thiếu khớp mô tả cùng vấn đề từ những góc nhìn khác nhau, nhưng không phải thuật ngữ có thể thay thế cho nhau.
Hãy nhớ những điều sau:
- Độ chệch cao gây thiếu khớp. Khi mô hình có các giả định mạnh không khớp dữ liệu thực, nó bỏ lỡ các mẫu một cách có hệ thống trên cả dữ liệu huấn luyện và kiểm thử. Mô hình quá đơn giản để biểu diễn mối quan hệ thật, đó chính là thiếu khớp.
- Phương sai cao gây quá khớp. Khi mô hình quá nhạy với dữ liệu huấn luyện, nó học nhiễu và các mẫu không khái quát hóa. Mô hình ghi nhớ ví dụ huấn luyện thay vì học mẫu cốt lõi, đó là quá khớp.
Độ chệch và phương sai là các thuộc tính của mô hình.
Chúng mô tả cách mô hình hành xử trên các tập huấn luyện khác nhau. Bạn có thể đo độ chệch bằng cách xem trung bình dự đoán của mô hình lệch bao xa so với sự thật. Bạn có thể đo phương sai bằng cách xem dự đoán thay đổi bao nhiêu khi dùng các dữ liệu huấn luyện khác nhau.
Thiếu khớp và quá khớp là các triệu chứng bạn quan sát được.
Chúng mô tả điều xảy ra khi bạn huấn luyện và kiểm thử mô hình. Bạn thấy thiếu khớp khi cả lỗi huấn luyện và kiểm thử đều cao. Bạn thấy quá khớp khi lỗi huấn luyện thấp nhưng lỗi kiểm thử cao.
Mối liên hệ là trực tiếp nhưng không phải một-một. Độ chệch cao thường dẫn đến thiếu khớp, và phương sai cao thường dẫn đến quá khớp. Nhưng bạn có thể có một mô hình với độ chệch và phương sai trung bình, không thiếu khớp hay quá khớp - nó chỉ hoạt động kém vì những lý do khác, như đặc trưng không đúng hoặc chất lượng dữ liệu không đủ.
Mẹo thực tiễn để diễn giải hiệu suất mô hình
Dưới đây là vài mẹo cuối cùng về cách chẩn đoán vấn đề độ chệch - phương sai và đưa ra quyết định mô hình tốt hơn.
Xem lỗi huấn luyện và xác thực cùng nhau, không tách rời
Chỉ nhìn lỗi huấn luyện không nói lên gì về khả năng khái quát hóa. Một mô hình có lỗi huấn luyện 1% vẫn có thể có lỗi kiểm thử 50% nếu nó quá khớp.
Hãy so sánh hai loại lỗi để hiểu điều gì đang xảy ra.
- Khi cả hai đều cao, bạn có độ chệch cao - mô hình quá đơn giản
- Khi lỗi huấn luyện thấp nhưng lỗi xác thực cao, bạn có phương sai cao - mô hình đang quá khớp
- Khi cả hai đều thấp, bạn đã tìm được cân bằng đúng
Đừng tối ưu chỉ cho độ chính xác huấn luyện
Độ chính xác huấn luyện hoàn hảo là dấu hiệu cảnh báo. Nó thường có nghĩa bạn đã ghi nhớ tập huấn luyện mà không học các mẫu có thể khái quát hóa.
Hãy tập trung vào hiệu suất xác thực. Mục tiêu của bạn là tối thiểu hóa khoảng cách giữa lỗi huấn luyện và xác thực trong khi giữ cả hai ở mức thấp hợp lý.
Dùng xác thực chéo để có ước lượng đáng tin
Một phép chia huấn luyện-kiểm thử duy nhất có thể gây hiểu lầm vì phụ thuộc vào những ví dụ rơi vào mỗi tập. Một phép chia không may có thể khiến mô hình tốt trông tệ hoặc mô hình tệ trông tốt.
Xác thực chéo bình quân hiệu suất qua nhiều phép chia, giúp bạn có ước lượng ổn định hơn về cách mô hình sẽ hoạt động trên dữ liệu mới. Điều này đặc biệt quan trọng khi bạn có dữ liệu hạn chế hoặc khi tinh chỉnh siêu tham số.
Cân bằng sự đơn giản và linh hoạt dựa trên kích thước dữ liệu
Với bộ dữ liệu nhỏ, hãy thiên về mô hình đơn giản hơn. Chúng ổn định hơn và ít có khả năng quá khớp khi bạn không có nhiều ví dụ để học.
Với bộ dữ liệu lớn, bạn có thể dùng mô hình phức tạp hơn vì dữ liệu bổ sung giúp ổn định quá trình học và giảm phương sai. Nhưng đừng thêm độ phức tạp chỉ vì có thể - chỉ thêm nếu nó cải thiện hiệu suất xác thực.
Kết luận
Bạn không thể xây dựng một mô hình có độ chệch bằng 0 và phương sai bằng 0. Mọi quyết định mô hình bạn đưa ra đều thay đổi cân bằng giữa hai nguồn sai số này. Thêm độ phức tạp sẽ giảm độ chệch nhưng tăng phương sai. Đơn giản hóa sẽ giảm phương sai nhưng tăng độ chệch.
Hiệu suất mô hình phụ thuộc vào việc tìm được cân bằng đúng. Mô hình tốt nhất là mô hình tối thiểu hóa tổng sai số bằng cách cân bằng độ chệch và phương sai cho bài toán và bộ dữ liệu cụ thể của bạn. Hiểu được sự đánh đổi này giúp bạn chẩn đoán mô hình đang chịu độ chệch cao hay phương sai cao và áp dụng giải pháp phù hợp.
Nếu bạn sẵn sàng trải nghiệm thực hành với học máy, hãy đăng ký lộ trình Nền tảng Machine Learning bằng Python của chúng tôi. Lộ trình có 16 giờ video giúp bạn chinh phục công việc đầu tiên.


Đánh đổi độ chệch - phương sai giải thích vì sao hiệu suất mô hình không chỉ là vấn đề về độ phức tạp hay độ chính xác, mà là tìm điểm ngọt nơi mô hình của bạn khái quát hóa tốt cho dữ liệu chưa thấy mà không đơn giản hóa quá mức vấn đề hoặc quá khớp với tập huấn luyện.
Trong bài viết này, tôi sẽ giải thích độ chệch và phương sai thực sự có nghĩa là gì trong học máy, cách chúng đánh đổi lẫn nhau, và vì sao hiểu được sự đánh đổi này giúp bạn xây dựng các mô hình vững vàng hơn.
Nếu bạn mới bắt đầu với học máy, bài viết Cách học Machine Learning năm 2026 của chúng tôi sẽ giúp bạn thành thạo trong thời gian ngắn.
Độ chệch là gì?
Độ chệch là sai số phát sinh từ việc đưa ra các giả định quá đơn giản về dữ liệu của bạn. Nó không liên quan đến định kiến theo nghĩa xã hội, ít nhất là trong học máy.
Khi một mô hình có độ chệch cao, nghĩa là mô hình quá cứng nhắc để bắt được các mẫu thực trong dữ liệu của bạn. Hãy hình dung như cố gắng khớp một đường thẳng qua dữ liệu rõ ràng là cong: Dù bạn điều chỉnh đường thẳng ra sao thì nó cũng không bao giờ khớp được hình dạng thật.
Điều này được gọi là thiếu khớp.
Một mô hình có độ chệch cao sẽ đơn giản hóa quá mức vấn đề. Nó giả định các mối quan hệ đơn giản hơn thực tế, nên bỏ lỡ những mẫu quan trọng giúp dự đoán chính xác.
Hãy tưởng tượng bạn dự đoán giá nhà dựa trên diện tích, số phòng ngủ, vị trí và tuổi nhà. Một mô hình có độ chệch cao có thể chỉ dùng diện tích và bỏ qua mọi thứ khác. Nó giả định chỉ riêng diện tích quyết định giá, điều này quá đơn giản.
Kết quả là một mô hình hoạt động kém trên cả dữ liệu huấn luyện lẫn dữ liệu mới vì nó không thể nắm bắt được độ phức tạp của giá nhà thực tế.
Hồi quy tuyến tính với ít đặc trưng là ví dụ kinh điển của mô hình có độ chệch cao. Cây quyết định với độ sâu rất hạn chế cũng thường có độ chệch cao vì chúng không thể phân chia dữ liệu đủ nhiều lần để tìm các mẫu tinh vi.
Độ chệch cao có nghĩa là mô hình của bạn không học đủ từ dữ liệu, mà thay vào đó biến vấn đề thành quá đơn giản để đạt độ chính xác tốt.
Phương sai là gì?
Phương sai đo lường mức độ nhạy của mô hình đối với dữ liệu huấn luyện cụ thể mà bạn sử dụng.
Nó không liên quan đến thước đo thống kê về độ phân tán dữ liệu. Trong học máy, phương sai mô tả hành vi của mô hình, không phải phân phối dữ liệu.
Khi một mô hình có phương sai cao, những thay đổi nhỏ trong dữ liệu huấn luyện sẽ dẫn đến thay đổi lớn trong dự đoán của mô hình. Nói cách khác, khi bạn huấn luyện cùng một mô hình trên hai bộ dữ liệu hơi khác nhau, bạn sẽ nhận được kết quả khác nhau rất nhiều.
Điều này được gọi là quá khớp.
Một mô hình có phương sai cao quá linh hoạt. Nó học không chỉ các mẫu thực trong dữ liệu mà còn cả nhiễu và dao động ngẫu nhiên không khái quát hóa được cho dữ liệu mới. Về bản chất, mô hình ghi nhớ các ví dụ huấn luyện thay vì học các mối quan hệ cốt lõi.
Hãy tưởng tượng bạn vẫn đang dự đoán giá nhà, nhưng giờ dùng một mô hình phức tạp với hàng trăm tham số. Nó có thể học rằng nhà trên Phố Oak luôn bán đúng $427,350 vì đó là những gì diễn ra trong dữ liệu huấn luyện của bạn.
Kết quả là mô hình hoạt động rất tốt trên dữ liệu huấn luyện nhưng tệ trên dữ liệu mới vì nó đã học các đặc trưng riêng của tập huấn luyện.
Mạng nơ-ron sâu và cây quyết định không giới hạn độ sâu là những mô hình phương sai cao kinh điển. Chúng đủ linh hoạt để khớp gần như mọi mẫu, kể cả những mẫu vô nghĩa.
Phương sai cao có nghĩa là mô hình của bạn học quá nhiều từ dữ liệu. Nó khớp cả nhiễu lẫn tín hiệu, khiến mô hình không ổn định và không tin cậy trên ví dụ mới.
Độ chệch so với phương sai: Khác biệt chính
Độ chệch và phương sai là hai nguồn sai số dự đoán hoàn toàn khác nhau. Khi hiểu rõ khác biệt, bạn sẽ nhanh hơn trong việc chẩn đoán vấn đề của mô hình.
Đây là cách độ chệch và phương sai ảnh hưởng đến sai số dự đoán:
Vấn đề là giảm cái này thường làm tăng cái kia.
Khi bạn làm mô hình phức tạp hơn để giảm độ chệch, bạn tăng độ linh hoạt. Độ linh hoạt đó khiến mô hình nhạy cảm hơn với dữ liệu huấn luyện, làm tăng phương sai. Khi bạn đơn giản hóa mô hình để giảm phương sai, bạn loại bỏ khả năng nắm bắt các mẫu phức tạp, làm tăng độ chệch.
Mối quan hệ nghịch đảo này là lý do bạn không thể đồng thời tối thiểu hóa cả hai. Thay vào đó, bạn phải tìm sự cân bằng đem lại tổng sai số thấp nhất.
Đánh đổi độ chệch - phương sai là gì?
Đánh đổi độ chệch - phương sai mô tả sự căng kéo giữa hai nguồn sai số này - khi bạn giảm một bên, hầu như luôn làm tăng bên còn lại.
Hãy hình dung như sau: bạn đang cố bắn trúng mục tiêu, nhưng có hai vấn đề đối nghịch nhau. Bạn có thể ngắm kỹ hơn (giảm độ chệch), nhưng điều đó khiến bạn nhạy cảm hơn với gió và run tay (tăng phương sai). Hoặc bạn dùng tư thế bắn đơn giản, ổn định hơn (giảm phương sai), nhưng hạn chế độ chính xác (tăng độ chệch).
Độ phức tạp của mô hình nằm ở trung tâm của sự đánh đổi này.
Khi bạn dùng mô hình đơn giản với ít tham số, bạn có độ chệch cao và phương sai thấp. Mô hình đưa ra các giả định nhất quán và không thay đổi nhiều với các dữ liệu huấn luyện khác nhau, nhưng không thể nắm bắt các mẫu phức tạp.
Khi bạn dùng mô hình phức tạp với nhiều tham số, bạn có độ chệch thấp và phương sai cao. Mô hình có thể biểu diễn các mối quan hệ tinh vi, nhưng trở nên không ổn định và quá nhạy với các ví dụ cụ thể mà bạn dùng để huấn luyện.
Dưới đây là đường cong khái niệm giải thích điều này:
Đường cong đánh đổi độ chệch - phương sai
Bạn đang tìm điểm mà tác động kết hợp của chúng đem lại lỗi kiểm thử thấp nhất.
Không có một mô hình "hoàn hảo" áp dụng cho mọi vấn đề. Cân bằng tối ưu phụ thuộc vào dữ liệu của bạn, độ phức tạp của vấn đề và lượng dữ liệu huấn luyện bạn có. Nhiều dữ liệu hơn thường cho phép bạn dùng mô hình phức tạp hơn mà không quá khớp, dịch chuyển điểm ngọt sang bên phải.
Ví dụ đơn giản về đánh đổi độ chệch - phương sai
Hãy làm khái niệm này trở nên cụ thể với một kịch bản thực tế cho thấy độ chệch và phương sai thể hiện ra sao trong thực hành.
Hãy tưởng tượng bạn xây dựng mô hình dự đoán giá thuê căn hộ trong một thành phố. Bạn có các đặc trưng như diện tích, số phòng ngủ, khu phố, khoảng cách tới tàu điện ngầm, tuổi tòa nhà và tiện ích.
Mô hình đơn giản: Hồi quy tuyến tính với một đặc trưng
Bạn quyết định chỉ dùng diện tích để dự đoán giá với hồi quy tuyến tính đơn.
Mô hình đơn giản
Mô hình phức tạp: Mạng nơ-ron sâu với mọi đặc trưng
Giờ bạn xây dựng một mạng nơ-ron sâu với nhiều tầng ẩn, dùng tất cả đặc trưng sẵn có, cộng thêm đặc trưng tạo mới như tỷ lệ tội phạm theo khu, điểm khả năng đi bộ và gần công viên.
Mô hình phức tạp
Mô hình cân bằng: Hồi quy có điều chuẩn với đặc trưng chủ chốt
Bạn dùng hồi quy có điều chuẩn (như Ridge hoặc Lasso) với tập đặc trưng được chọn lọc kỹ: diện tích, số phòng ngủ, phân loại khu phố và khoảng cách tới phương tiện công cộng.
Mô hình cân bằng
Mô hình cân bằng sẽ không khớp hoàn hảo dữ liệu huấn luyện, và đó chính là mục tiêu.
Đánh đổi độ chệch - phương sai trong các mô hình học máy
Các thuật toán học máy khác nhau tự nhiên nghiêng về độ chệch cao hoặc phương sai cao. Bạn cần hiểu các xu hướng này để chọn đúng công cụ cho vấn đề của mình.
Mô hình tuyến tính
Hồi quy tuyến tính và hồi quy logistic nằm ở đầu phổ có độ chệch cao.
Các mô hình này giả định mối quan hệ là tuyến tính - một đặc trưng thay đổi thì đầu ra thay đổi một lượng cố định. Khi dữ liệu của bạn có mẫu phi tuyến, mối quan hệ cong, hoặc tương tác phức tạp giữa các đặc trưng, mô hình tuyến tính không thể nắm bắt chúng.
Điểm cộng là tính ổn định. Huấn luyện mô hình tuyến tính trên các mẫu khác nhau của dữ liệu, bạn sẽ nhận được các hệ số tương tự mỗi lần. Phương sai thấp, nhưng có thể độ chệch cao nếu mối quan hệ thực không tuyến tính.
Cây quyết định
Cây quyết định có thể hành xử khác nhau tùy cách bạn cấu hình.
Một cây nông với chỉ vài lần chia tách hoạt động như mô hình đơn giản - độ chệch cao, phương sai thấp. Nó đưa ra các khái quát rộng và không thể nắm bắt các mẫu chi tiết.
Một cây sâu không giới hạn độ sâu trở nên vô cùng linh hoạt. Nó tiếp tục chia cho đến khi mỗi lá chỉ chứa vài điểm dữ liệu, nghĩa là nó ghi nhớ dữ liệu huấn luyện. Độ chệch thấp nhưng phương sai rất cao - cấu trúc cây thay đổi đáng kể với các mẫu huấn luyện khác nhau.
Đó là lý do rừng ngẫu nhiên hoạt động tốt. Chúng bình quân dự đoán từ nhiều cây, giảm vấn đề phương sai đồng thời giữ độ chệch thấp.
K-láng giềng gần nhất
Cân bằng độ chệch - phương sai của KNN hoàn toàn phụ thuộc vào lựa chọn k của bạn.
Khi k nhỏ (như k=1 hoặc k=3), mô hình có phương sai cao. Nó dựa vào chỉ vài điểm gần nhất để dự đoán, nên cực kỳ nhạy với các ví dụ cụ thể trong tập huấn luyện. Thay đổi nhỏ trong dữ liệu huấn luyện dẫn đến dự đoán hoàn toàn khác.
Khi k lớn (như k=50 hoặc k=100), mô hình có độ chệch cao. Nó bình quân trên quá nhiều láng giềng đến mức làm mờ các mẫu cục bộ và bỏ lỡ những chi tiết quan trọng trong dữ liệu.
Giá trị k tối ưu nằm đâu đó ở giữa, cân bằng hai thái cực này.
Mạng nơ-ron
Mạng nơ-ron vốn dĩ là các mô hình có phương sai cao vì chúng có quá nhiều tham số cần học.
Một mạng với nhiều tầng và hàng trăm nơ-ron có thể biểu diễn các hàm cực kỳ phức tạp. Sự linh hoạt này đồng nghĩa với độ chệch thấp - mạng có thể học gần như mọi mẫu. Nhưng nó cũng đồng nghĩa với phương sai cao - trọng số học được phụ thuộc nặng vào dữ liệu huấn luyện cụ thể, khởi tạo và quá trình huấn luyện.
Đó là lý do các mạng nơ-ron cần bộ dữ liệu lớn để hoạt động tốt. Nhiều dữ liệu huấn luyện giúp ổn định quá trình học và giảm phương sai. Cũng vì thế mà các kỹ thuật như dropout, chuẩn hóa theo lô và dừng sớm tồn tại - tất cả nhằm kiểm soát phương sai và ngăn quá khớp.
Các mạng nhỏ hơn với ít tầng và ít nơ-ron có độ chệch cao hơn nhưng phương sai thấp hơn, trong khi mạng lớn hơn có độ chệch thấp hơn nhưng phương sai cao hơn.
Độ phức tạp mô hình ảnh hưởng đến độ chệch và phương sai thế nào
Đáng tiếc là độ phức tạp của mô hình không phải một con số đơn lẻ bạn có thể đo. Nó nói về mức độ linh hoạt của mô hình trong việc khớp các mẫu khác nhau.
Độ phức tạp đến từ nhiều nguồn, như nhiều đặc trưng hơn, nhiều tầng hơn trong mạng nơ-ron, cây quyết định sâu hơn, các hạng tử đa thức trong hồi quy, hoặc giá trị k thấp hơn trong KNN. Điểm chung là chúng cho mô hình của bạn nhiều tự do hơn để khớp các mẫu tinh vi trong dữ liệu.
Khi bạn thêm tham số, bạn trao cho mô hình nhiều cách hơn để biểu diễn các mối quan hệ trong dữ liệu. Một mô hình tuyến tính với 3 đặc trưng chỉ có thể vẽ một mặt phẳng phẳng qua dữ liệu. Nếu bạn thêm các hạng tử đa thức và đặc trưng tương tác, nó có thể uốn cong để khớp các mẫu phức tạp hơn. Giả định của mô hình bớt ràng buộc, nghĩa là độ chệch thấp hơn.
Nhưng sự linh hoạt này phải trả giá, tức là tăng phương sai.
Nhiều tham số đồng nghĩa nhiều giá trị phải học từ dữ liệu huấn luyện. Mỗi tham số được tinh chỉnh để khớp các ví dụ huấn luyện cụ thể, khiến mô hình nhạy cảm hơn với những ví dụ bạn vô tình đưa vào. Khi bạn thay đổi vài mẫu huấn luyện, tất cả tham số sẽ dịch chuyển để thích nghi dữ liệu mới. Mô hình trở nên không ổn định.
Đó là lý do chỉ nhìn lỗi huấn luyện là sai lầm và nguy hiểm.
Khi bạn tăng độ phức tạp, lỗi huấn luyện sẽ luôn giảm. Mô hình khớp dữ liệu huấn luyện ngày càng tốt, cuối cùng đạt độ chính xác gần như hoàn hảo. Điều này trông rất ổn cho đến khi bạn nhận ra mô hình đang ghi nhớ nhiễu thay vì học các mẫu.
Lỗi trên tập kiểm thử sẽ cho bạn biết mô hình thực sự tốt đến đâu.
Ban đầu, khi bạn thêm độ phức tạp, lỗi kiểm thử giảm vì mô hình bắt đầu nắm bắt các mẫu thực. Nhưng vượt qua một ngưỡng, lỗi kiểm thử tăng dù lỗi huấn luyện tiếp tục giảm. Mô hình đang quá khớp - học các đặc điểm riêng của tập huấn luyện không khái quát hóa được.
Khoảng cách nhỏ giữa lỗi huấn luyện và kiểm thử nghĩa là mô hình của bạn khái quát hóa tốt. Khoảng cách lớn nghĩa là bạn đang quá khớp và cần giảm độ phức tạp hoặc thêm dữ liệu huấn luyện.
Kỹ thuật quản lý đánh đổi độ chệch - phương sai
Bạn không thể loại bỏ đánh đổi độ chệch - phương sai, nhưng bạn có thể kiểm soát nó bằng các kỹ thuật phù hợp. Hãy cùng xem vài cách.
Chia tập huấn luyện/kiểm thử
Không bao giờ đánh giá mô hình trên chính dữ liệu đã dùng để huấn luyện.
Hãy chia dữ liệu của bạn thành tập huấn luyện và tập kiểm thử trước khi làm bất kỳ điều gì khác. Huấn luyện trên một phần, đánh giá trên phần còn lại. Điều này cho bạn thước đo trung thực về khả năng mô hình khái quát hóa cho dữ liệu mới.
Tập kiểm thử đóng vai trò đại diện cho hiệu suất ngoài đời thực. Khi lỗi huấn luyện thấp nhưng lỗi kiểm thử cao, bạn biết mình đang quá khớp. Khi cả hai đều cao, bạn đang thiếu khớp.
Xác thực chéo
Chia huấn luyện/kiểm thử có điểm yếu - nó phụ thuộc vào những ví dụ cụ thể rơi vào mỗi tập.
Xác thực chéo khắc phục bằng cách huấn luyện và kiểm thử nhiều lần trên các phép chia khác nhau của dữ liệu. Cách phổ biến nhất là xác thực chéo k-fold, bạn chia dữ liệu thành k phần, huấn luyện trên k-1 phần và kiểm thử trên phần còn lại. Lặp k lần để mỗi phần làm tập kiểm thử một lần.
Cách này cho bạn ước lượng đáng tin cậy hơn về hiệu suất mô hình và giúp tinh chỉnh siêu tham số mà không quá khớp vào một tập kiểm thử duy nhất.
Điều chuẩn
Điều chuẩn thêm một khoản phạt cho độ phức tạp của mô hình trực tiếp vào hàm mất mát.
Các kỹ thuật như L1 (Lasso) và L2 (Ridge) không khuyến khích giá trị tham số lớn, buộc mô hình phải đơn giản và ổn định hơn. Điều này làm tăng nhẹ độ chệch nhưng giảm phương sai, thường cải thiện hiệu suất kiểm thử tổng thể.
Dropout trong mạng nơ-ron hoạt động tương tự - nó ngẫu nhiên loại bỏ nơ-ron trong quá trình huấn luyện, ngăn mạng phụ thuộc quá nhiều vào các tham số cụ thể và giảm quá khớp.
Thêm dữ liệu so với mô hình tốt hơn
Thêm dữ liệu huấn luyện thường là giải pháp tốt nhất cho phương sai cao.
Khi bạn có nhiều ví dụ hơn, mô hình của bạn thấy được mẫu các khả năng rộng hơn để học. Điều này khiến việc quá khớp với nhiễu khó hơn vì nhiễu được bình quân qua nhiều điểm dữ liệu. Phương sai giảm mà không phải hy sinh độ chệch thấp của một mô hình phức tạp.
Nhưng thu thập thêm dữ liệu không phải lúc nào cũng khả thi.
Nếu bạn bị giới hạn dữ liệu, hãy tập trung vào lựa chọn mô hình - chọn mô hình đơn giản hơn, thêm điều chuẩn, hoặc dùng phương pháp tập hợp kết hợp nhiều mô hình để giảm phương sai.
Lựa chọn đặc trưng
Không phải mọi đặc trưng đều cải thiện mô hình. Một số chỉ thêm nhiễu.
Loại bỏ các đặc trưng không liên quan hoặc dư thừa để giảm độ phức tạp mà không mất các mẫu quan trọng. Ít đặc trưng hơn đồng nghĩa ít tham số cần học hơn, làm giảm phương sai. Bạn cũng tránh được lời nguyền chiều không gian, nơi mô hình gặp khó trong không gian nhiều chiều với dữ liệu hạn chế.
Dùng các kỹ thuật như phân tích tương quan, điểm quan trọng đặc trưng từ mô hình dựa trên cây, hoặc các phương pháp điều chuẩn tự động đưa về 0 những đặc trưng không quan trọng.
Mục tiêu là tìm tập đặc trưng tối thiểu nắm bắt tín hiệu mà không mang theo nhiễu.
Hiểu lầm phổ biến về đánh đổi độ chệch - phương sai
Hãy làm rõ ba sai lầm phổ biến dẫn đến các quyết định mô hình kém.
"Độ chệch thấp luôn tốt hơn"
Sai. Độ chệch thấp nghĩa là mô hình có thể biểu diễn các mẫu phức tạp, nhưng điều đó chỉ hữu ích nếu các mẫu đó thực sự tồn tại trong dữ liệu của bạn và khái quát hóa được cho ví dụ mới.
Giảm độ chệch bằng cách tăng độ phức tạp thường làm phương sai tăng nhanh hơn mức giảm độ chệch. Bạn rơi vào mô hình khớp hoàn hảo dữ liệu huấn luyện nhưng hoạt động tệ hơn trên dữ liệu kiểm thử. Mục tiêu là tối thiểu hóa tổng sai số, không chỉ riêng độ chệch.
Đôi khi một mô hình đơn giản hơn với độ chệch cao hơn lại hoạt động tốt hơn tổng thể vì nó có phương sai đủ thấp để khái quát hóa tốt.
"Quá khớp nghĩa là mô hình tệ"
Không hẳn. Quá khớp nghĩa là mô hình của bạn quá phức tạp so với lượng dữ liệu bạn có, nhưng bản thân mô hình không cố hữu là tệ.
Cùng một kiến trúc mạng nơ-ron có thể quá khớp trên 1.000 ví dụ huấn luyện nhưng lại hoạt động hoàn hảo trên 100.000 ví dụ. Vấn đề nằm ở sự không tương xứng giữa năng lực và kích thước dữ liệu.
Bạn có thể khắc phục quá khớp bằng cách thêm dữ liệu, giảm độ phức tạp, hoặc áp dụng điều chuẩn. Bạn không cần vứt bỏ mô hình và bắt đầu lại với thứ hoàn toàn khác.
"Thêm dữ liệu luôn khắc phục phương sai"
Thêm dữ liệu giúp giảm phương sai, nhưng không loại bỏ nó, và có giới hạn cho mức độ hữu ích.
Nếu mô hình của bạn cực kỳ phức tạp so với vấn đề, thậm chí bộ dữ liệu lớn cũng có thể không đủ để ổn định nó. Một mạng nơ-ron với hàng triệu tham số cần lượng dữ liệu khổng lồ để huấn luyện tốt.
Ngoài ra, thêm nhiều dữ liệu chỉ hữu ích nếu dữ liệu mới đại diện cho cùng phân phối với dữ liệu kiểm thử của bạn. Thu thập thêm dữ liệu thiên lệch hoặc nhiễu sẽ không giảm phương sai - thậm chí có thể làm tệ hơn bằng cách củng cố các mẫu không khái quát hóa được.
Đánh đổi độ chệch - phương sai so với quá khớp và thiếu khớp
Độ chệch - phương sai và quá khớp - thiếu khớp mô tả cùng vấn đề từ những góc nhìn khác nhau, nhưng không phải thuật ngữ có thể thay thế cho nhau.
Hãy nhớ những điều sau:
Độ chệch và phương sai là các thuộc tính của mô hình.
Chúng mô tả cách mô hình hành xử trên các tập huấn luyện khác nhau. Bạn có thể đo độ chệch bằng cách xem trung bình dự đoán của mô hình lệch bao xa so với sự thật. Bạn có thể đo phương sai bằng cách xem dự đoán thay đổi bao nhiêu khi dùng các dữ liệu huấn luyện khác nhau.
Thiếu khớp và quá khớp là các triệu chứng bạn quan sát được.
Chúng mô tả điều xảy ra khi bạn huấn luyện và kiểm thử mô hình. Bạn thấy thiếu khớp khi cả lỗi huấn luyện và kiểm thử đều cao. Bạn thấy quá khớp khi lỗi huấn luyện thấp nhưng lỗi kiểm thử cao.
Mối liên hệ là trực tiếp nhưng không phải một-một. Độ chệch cao thường dẫn đến thiếu khớp, và phương sai cao thường dẫn đến quá khớp. Nhưng bạn có thể có một mô hình với độ chệch và phương sai trung bình, không thiếu khớp hay quá khớp - nó chỉ hoạt động kém vì những lý do khác, như đặc trưng không đúng hoặc chất lượng dữ liệu không đủ.
Mẹo thực tiễn để diễn giải hiệu suất mô hình
Dưới đây là vài mẹo cuối cùng về cách chẩn đoán vấn đề độ chệch - phương sai và đưa ra quyết định mô hình tốt hơn.
Xem lỗi huấn luyện và xác thực cùng nhau, không tách rời
Chỉ nhìn lỗi huấn luyện không nói lên gì về khả năng khái quát hóa. Một mô hình có lỗi huấn luyện 1% vẫn có thể có lỗi kiểm thử 50% nếu nó quá khớp.
Hãy so sánh hai loại lỗi để hiểu điều gì đang xảy ra.
Đừng tối ưu chỉ cho độ chính xác huấn luyện
Độ chính xác huấn luyện hoàn hảo là dấu hiệu cảnh báo. Nó thường có nghĩa bạn đã ghi nhớ tập huấn luyện mà không học các mẫu có thể khái quát hóa.
Hãy tập trung vào hiệu suất xác thực. Mục tiêu của bạn là tối thiểu hóa khoảng cách giữa lỗi huấn luyện và xác thực trong khi giữ cả hai ở mức thấp hợp lý.
Dùng xác thực chéo để có ước lượng đáng tin
Một phép chia huấn luyện-kiểm thử duy nhất có thể gây hiểu lầm vì phụ thuộc vào những ví dụ rơi vào mỗi tập. Một phép chia không may có thể khiến mô hình tốt trông tệ hoặc mô hình tệ trông tốt.
Xác thực chéo bình quân hiệu suất qua nhiều phép chia, giúp bạn có ước lượng ổn định hơn về cách mô hình sẽ hoạt động trên dữ liệu mới. Điều này đặc biệt quan trọng khi bạn có dữ liệu hạn chế hoặc khi tinh chỉnh siêu tham số.
Cân bằng sự đơn giản và linh hoạt dựa trên kích thước dữ liệu
Với bộ dữ liệu nhỏ, hãy thiên về mô hình đơn giản hơn. Chúng ổn định hơn và ít có khả năng quá khớp khi bạn không có nhiều ví dụ để học.
Với bộ dữ liệu lớn, bạn có thể dùng mô hình phức tạp hơn vì dữ liệu bổ sung giúp ổn định quá trình học và giảm phương sai. Nhưng đừng thêm độ phức tạp chỉ vì có thể - chỉ thêm nếu nó cải thiện hiệu suất xác thực.
Kết luận
Bạn không thể xây dựng một mô hình có độ chệch bằng 0 và phương sai bằng 0. Mọi quyết định mô hình bạn đưa ra đều thay đổi cân bằng giữa hai nguồn sai số này. Thêm độ phức tạp sẽ giảm độ chệch nhưng tăng phương sai. Đơn giản hóa sẽ giảm phương sai nhưng tăng độ chệch.
Hiệu suất mô hình phụ thuộc vào việc tìm được cân bằng đúng. Mô hình tốt nhất là mô hình tối thiểu hóa tổng sai số bằng cách cân bằng độ chệch và phương sai cho bài toán và bộ dữ liệu cụ thể của bạn. Hiểu được sự đánh đổi này giúp bạn chẩn đoán mô hình đang chịu độ chệch cao hay phương sai cao và áp dụng giải pháp phù hợp.
Nếu bạn sẵn sàng trải nghiệm thực hành với học máy, hãy đăng ký lộ trình Nền tảng Machine Learning bằng Python của chúng tôi. Lộ trình có 16 giờ video giúp bạn chinh phục công việc đầu tiên.