Cours
Réduction de dimension en Python
4 h
37.1K
Le compromis biais-variance explique pourquoi la performance d’un modèle ne se résume ni à sa complexité ni à sa précision : tout l’enjeu est de trouver le juste milieu où votre modèle généralise correctement sur des données nouvelles sans simplifier à l’excès le problème ni surajuster l’ensemble d’apprentissage.
Dans cet article, j’explique ce que recouvrent vraiment le biais et la variance en apprentissage automatique, comment ils se compensent et pourquoi comprendre ce compromis vous aide à construire des modèles plus robustes.
Si vous débutez en apprentissage automatique, notre How to Learn Machine Learning in 2026 vous mettra rapidement sur les rails.
Le biais est l’erreur qui provient d’hypothèses trop simplistes sur vos données. Rien à voir avec la prévention au sens sociétal : en apprentissage automatique, il s’agit d’un concept différent.
Un modèle à fort biais est trop rigide pour capter les véritables motifs de vos données. C’est comme essayer d’ajuster une droite sur des données clairement curvilignes : vous aurez beau la déplacer, elle ne collera jamais à la réalité.
On parle alors de sous-apprentissage.
Un modèle à fort biais simplifie à l’excès le problème. Il suppose des relations plus simples qu’elles ne le sont et manque des motifs essentiels à une bonne prédiction.
Imaginons que vous prédisiez le prix de logements à partir de la superficie, du nombre de chambres, de l’emplacement et de l’ancienneté. Un modèle à fort biais pourrait n’utiliser que la superficie, ignorant tout le reste. Il postule que la surface suffit à déterminer le prix : c’est beaucoup trop simple.
Résultat : le modèle performe mal sur l’apprentissage comme sur les nouvelles données, incapable de refléter la complexité des prix réels.
La régression linéaire avec peu de variables est l’archétype du modèle à fort biais. Des arbres de décision à profondeur très limitée présentent également un biais élevé faute de pouvoir segmenter suffisamment pour déceler des motifs fins.
Un fort biais signifie que votre modèle n’apprend pas assez des données et rend le problème trop simple pour atteindre une précision satisfaisante.
La variance mesure à quel point votre modèle est sensible aux données d’apprentissage spécifiques utilisées.
Cela ne renvoie pas à la dispersion statistique des données : en apprentissage, la variance décrit le comportement du modèle, pas la distribution des données.
Avec une forte variance, de petits changements dans l’apprentissage entraînent de grandes différences de prédiction. En clair, le même modèle entraîné sur deux jeux de données légèrement différents produira des résultats très divergents.
On parle alors de surapprentissage.
Un modèle à forte variance est trop flexible. Il apprend non seulement les vrais motifs mais aussi le bruit et les fluctuations aléatoires qui ne généralisent pas. Il mémorise les exemples d’entraînement au lieu d’apprendre les relations sous-jacentes.
Toujours sur les prix de logements, un modèle très complexe avec des centaines de paramètres pourrait apprendre que les maisons de Oak Street se vendent toujours exactement 427 350 $ parce que c’est ce qu’indiquait votre échantillon d’apprentissage.
Résultat : le modèle excelle sur l’apprentissage mais se dégrade fortement sur des données nouvelles, car il a appris des particularités propres au jeu d’entraînement.
Les réseaux de neurones profonds et les arbres de décision sans limite de profondeur sont des cas typiques de forte variance : leur flexibilité leur permet d’ajuster presque n’importe quel motif, y compris les motifs non pertinents.
Une forte variance signifie que votre modèle apprend trop des données, en ajustant le bruit autant que le signal : il devient instable et peu fiable sur de nouveaux exemples.
Le biais et la variance sont deux sources d’erreur de prédiction distinctes. Une fois la distinction comprise, vous diagnostiquerez bien plus vite ce qui cloche dans votre modèle.
Voici comment biais et variance impactent l’erreur de prédiction :
Le problème, c’est que réduire l’un augmente généralement l’autre.
En complexifiant votre modèle pour diminuer le biais, vous augmentez sa flexibilité ; il devient plus sensible aux données d’apprentissage, donc plus variant. En le simplifiant pour réduire la variance, vous perdez sa capacité à capter des motifs complexes, ce qui accroît le biais.
Cette relation inverse empêche de minimiser les deux simultanément. Il faut donc trouver l’équilibre qui minimise l’erreur totale.
Le compromis biais-variance décrit la tension entre ces deux sources d’erreur : quand on diminue l’une, on augmente presque toujours l’autre.
Imaginez que vous visiez une cible avec deux facteurs antagonistes. Vous pouvez soigner votre visée (réduire le biais), mais vous devenez plus sensible au vent et aux tremblements (augmenter la variance). Ou adopter une posture plus simple et stable (réduire la variance), mais au prix d’une précision moindre (augmenter le biais).
La complexité du modèle est au cœur de ce compromis.
Avec un modèle simple et peu paramétré, vous obtenez un biais élevé et une variance faible : des hypothèses cohérentes, peu de sensibilité aux échantillons, mais une incapacité à saisir des motifs complexes.
Avec un modèle complexe et très paramétré, vous obtenez un biais faible et une variance élevée : il représente des relations fines, mais devient instable et très sensible aux exemples d’entraînement.
Voici la courbe conceptuelle qui l’illustre :
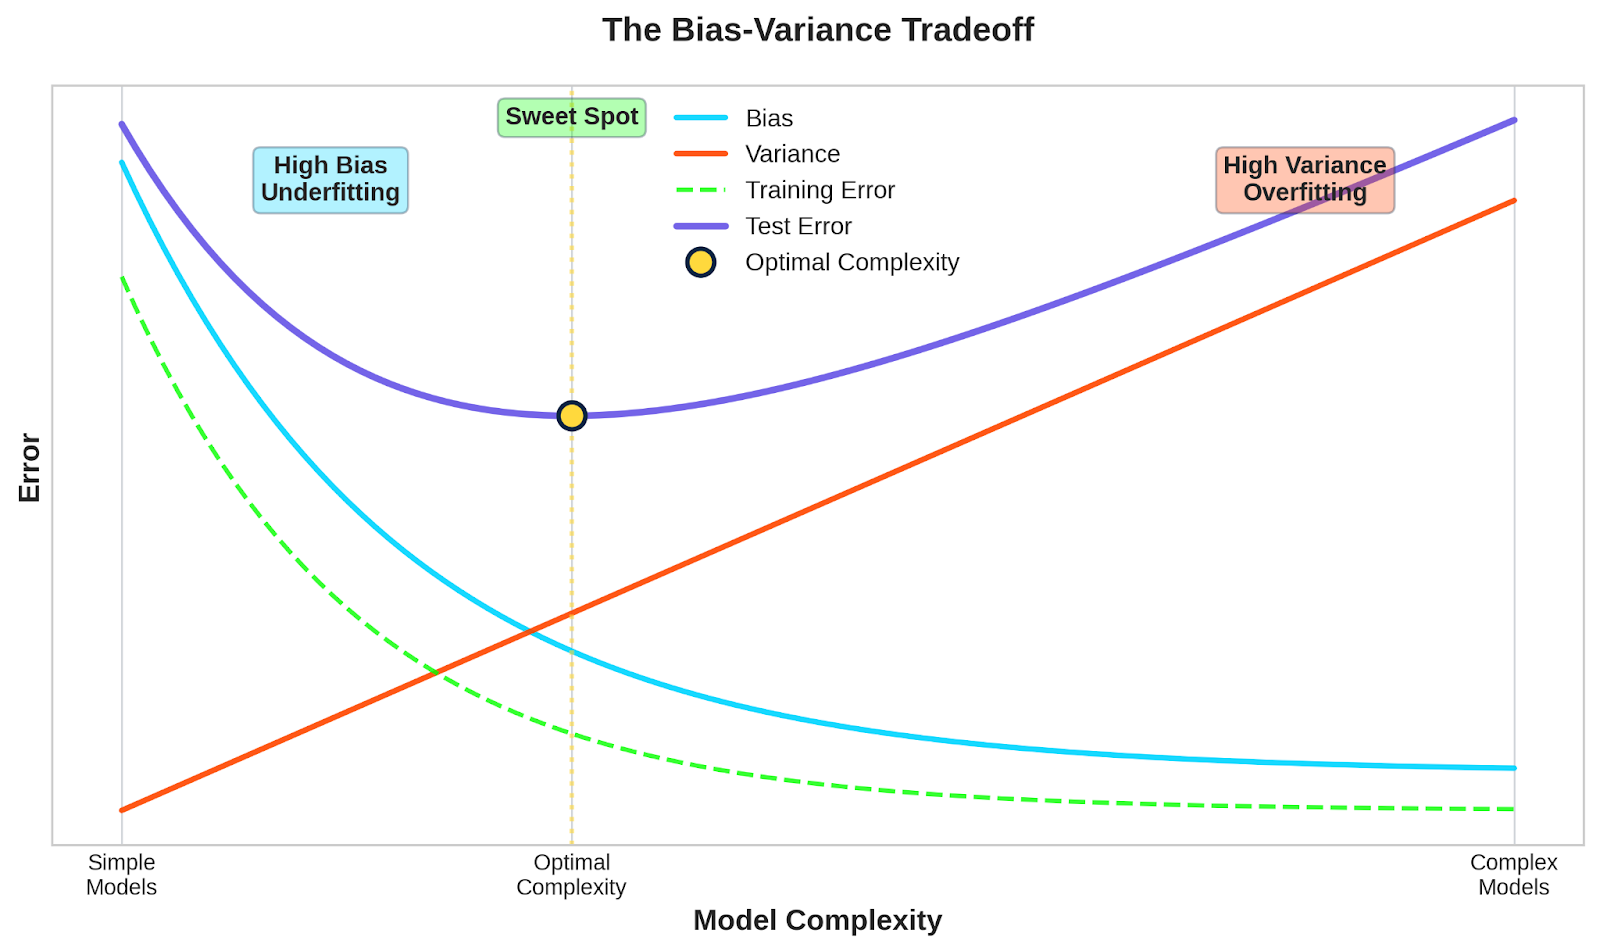
Courbe du compromis biais-variance
Vous recherchez le point où leur effet combiné minimise l’erreur de test.
Il n’existe pas de modèle « parfait » universel. L’équilibre optimal dépend de vos données, de la complexité du problème et de la quantité de données disponibles. Plus de données permettent en général d’utiliser des modèles plus complexes sans surapprentissage, décalant le sweet spot vers la droite.
Illustrons avec un scénario concret montrant comment biais et variance se manifestent en pratique.
Vous construisez un modèle pour prédire le loyer d’appartements en ville. Variables : surface, nombre de chambres, quartier, distance au métro, ancienneté de l’immeuble, équipements.
Vous n’utilisez que la surface pour prédire le prix avec une simple linear regression.
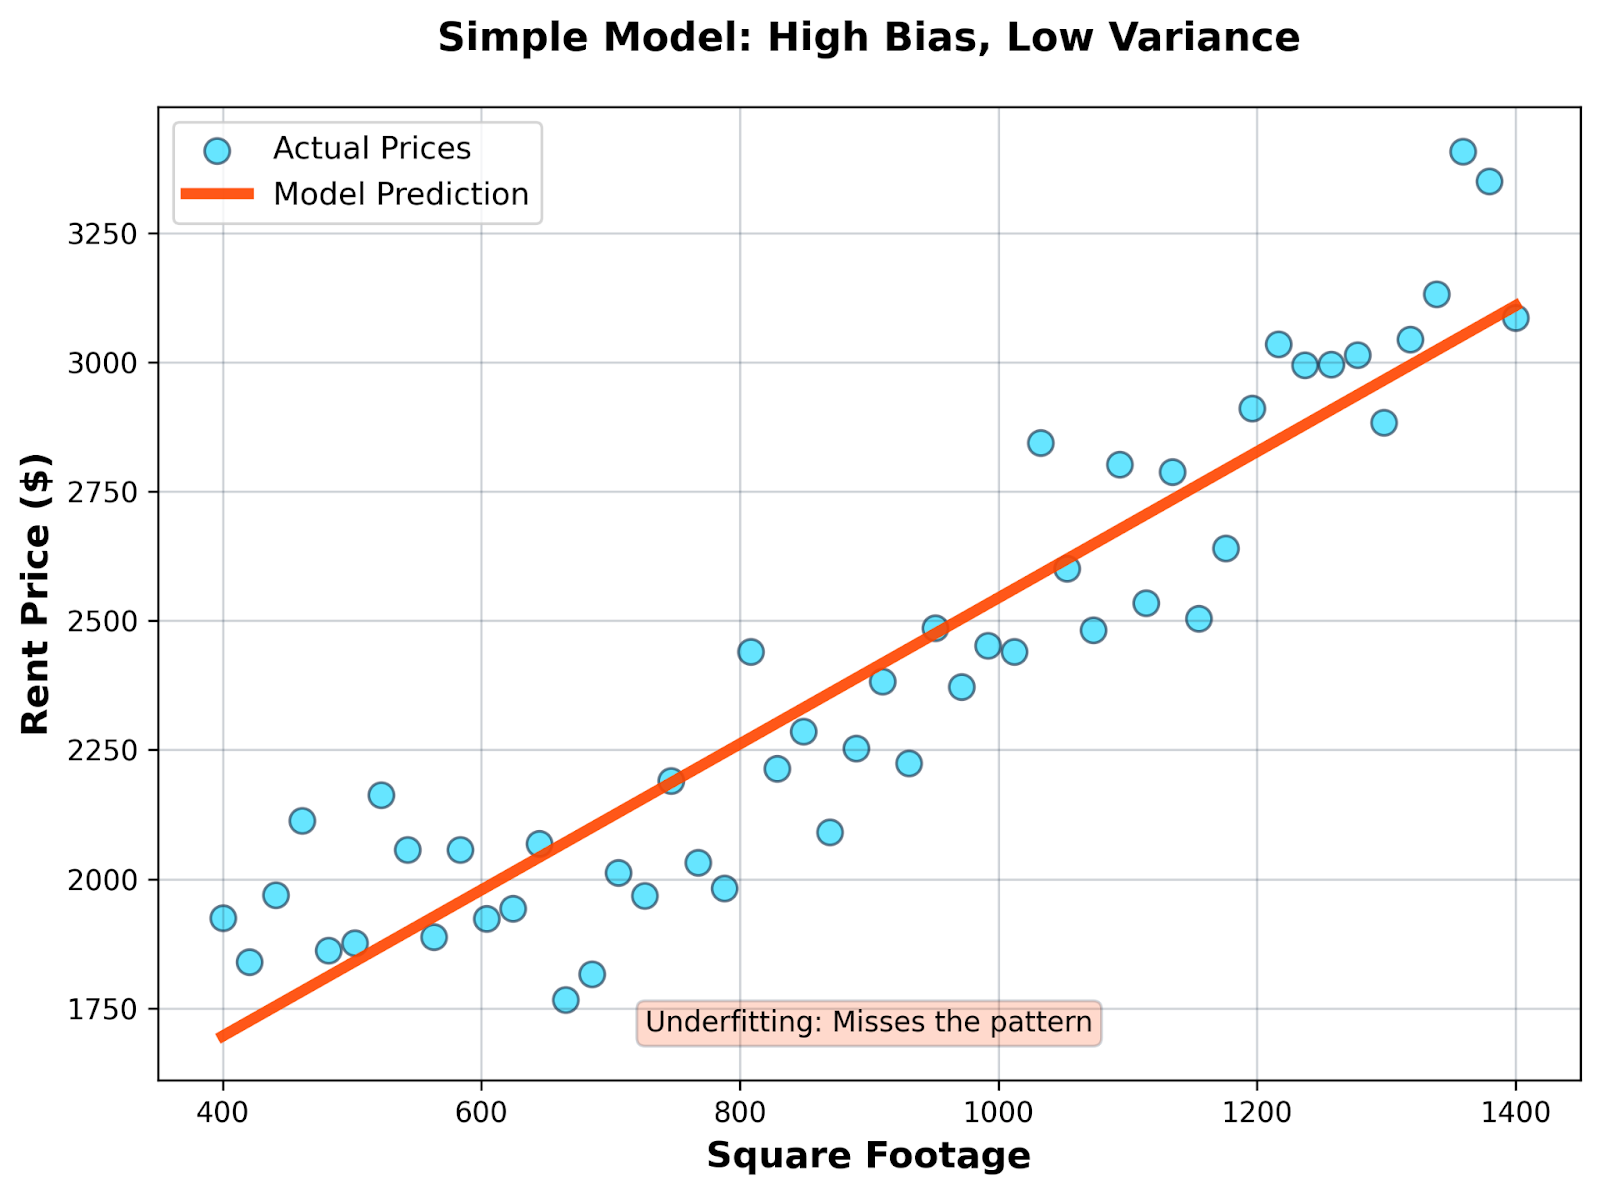
Modèle simple
Vous construisez un réseau profond à plusieurs couches avec toutes les variables disponibles, plus des variables créées comme le taux de criminalité par quartier, l’indice de marchabilité et la proximité des parcs.
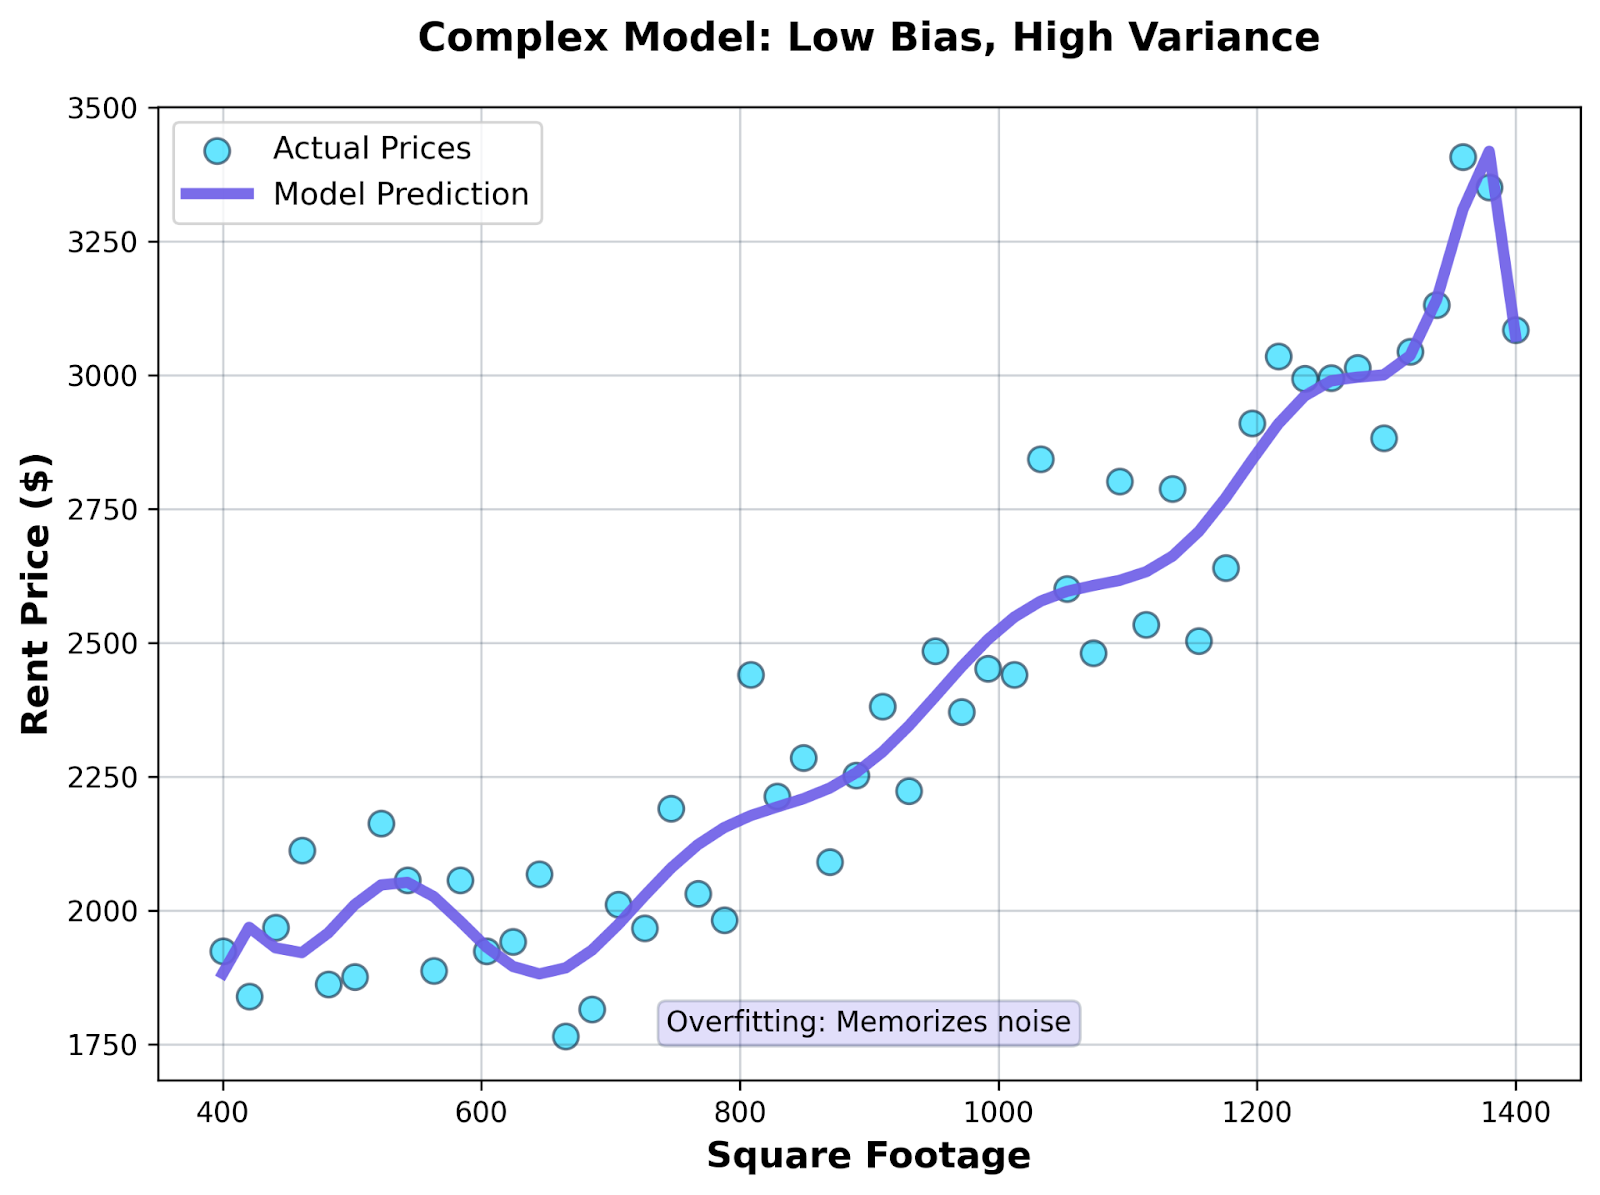
Modèle complexe
Vous utilisez une régression régularisée (Ridge ou Lasso) avec un sous-ensemble sélectionné : surface, chambres, catégorie de quartier, distance aux transports.
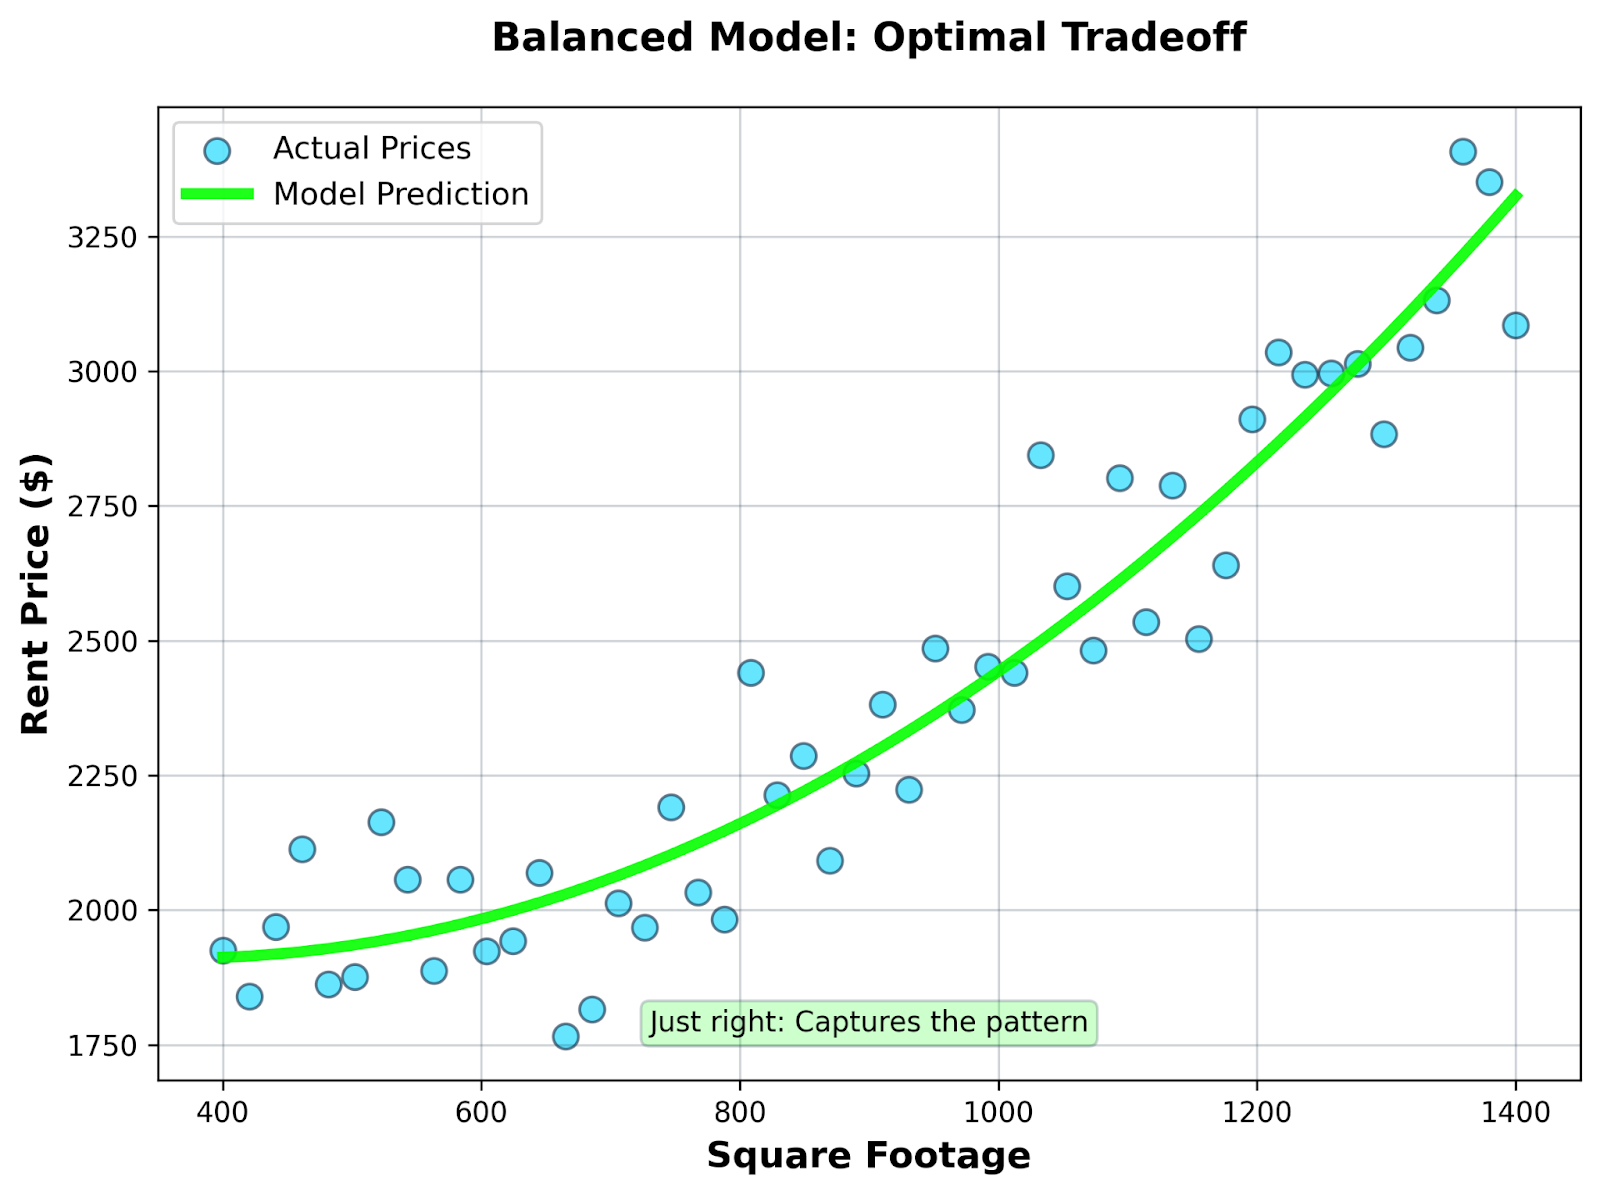
Modèle équilibré
Le modèle équilibré n’ajustera pas parfaitement vos données d’apprentissage, et c’est précisément le but.
Les algorithmes ont des penchants naturels vers un biais élevé ou une variance élevée. Comprendre ces tendances aide à choisir le bon outil.
La régression linéaire et la régression logistique se situent du côté biais élevé.
Elles supposent des relations linéaires : quand une variable change, la sortie change d’une quantité fixe. Si les motifs sont non linéaires, courbes ou avec interactions complexes, elles passent à côté.
L’avantage, c’est la stabilité : entraînées sur des échantillons différents, elles produisent des coefficients proches. Variance faible, mais biais potentiellement élevé si la réalité n’est pas linéaire.
Leur comportement dépend de leur configuration.
Un arbre peu profond, avec peu de coupes, agit comme un modèle simple : biais élevé, variance faible. Il généralise grosso modo et rate les détails.
Un arbre profond sans limite devient très flexible. Il segmente jusqu’à n’avoir que quelques points par feuille : il mémorise l’apprentissage. Biais faible, variance très élevée : sa structure change fortement selon l’échantillon.
C’est pourquoi les random forests fonctionnent si bien : elles moyennent des arbres multiples, réduisant la variance tout en gardant un biais bas.
L’équilibre biais-variance de KNN dépend entièrement du choix de k.
Pour un petit k (1 ou 3), la variance est élevée. Les prédictions reposent sur très peu de voisins, donc sont très sensibles aux exemples présents dans l’apprentissage. De légères variations de données mènent à des prédictions très différentes.
Pour un grand k (50 ou 100), le biais est élevé. En moyennant trop de voisins, on lisse les motifs locaux et on passe à côté de détails importants.
La meilleure valeur de k se situe entre les deux, en équilibre.
Les réseaux de neurones sont naturellement à forte variance car ils comportent beaucoup de paramètres à apprendre.
Avec plusieurs couches et des centaines de neurones, ils représentent des fonctions très complexes. Flexibilité = biais faible : ils peuvent apprendre presque n’importe quel motif. Mais aussi variance élevée : les poids appris dépendent fortement des données, de l’initialisation et du processus d’entraînement.
D’où le besoin de grands jeux d’apprentissage. Plus de données stabilisent l’apprentissage et réduisent la variance. Des techniques comme le dropout, la batch normalization et l’early stopping visent toutes à contrôler la variance et à prévenir le surapprentissage.
Des réseaux plus petits (moins de couches/neurones) ont davantage de biais mais moins de variance ; des réseaux plus grands, l’inverse.
La complexité ne se résume pas à un chiffre : elle reflète la flexibilité du modèle à ajuster différents motifs.
Elle provient de sources multiples : plus de variables, plus de couches dans un réseau, arbres plus profonds, termes polynomiaux en régression, valeurs de k plus petites en KNN, etc. Le point commun : donner plus de liberté au modèle pour ajuster des motifs complexes.
Ajouter des paramètres, c’est offrir plus de moyens de représenter les relations. Une régression linéaire avec 3 variables ne peut tracer qu’un plan. En ajoutant des termes polynomiaux et des interactions, elle peut se courber pour suivre des motifs plus complexes. Les hypothèses se desserrent : le biais diminue.
Mais cette flexibilité a un coût : une hausse de la variance.
Plus de paramètres, c’est plus de valeurs à estimer sur l’apprentissage. Chaque paramètre s’accorde aux exemples vus, rendant le modèle plus sensible à la composition de l’échantillon. En changeant quelques exemples, les paramètres se déplacent et le modèle devient instable.
Voilà pourquoi l’erreur d’apprentissage seule est trompeuse — et dangereuse.
En augmentant la complexité, l’erreur d’apprentissage baisse toujours. Le modèle ajuste de mieux en mieux les données, jusqu’à frôler la perfection. Tentant — jusqu’à réaliser qu’il mémorise le bruit au lieu d’apprendre le signal.
L’erreur sur le jeu de test révèle la réelle qualité du modèle.
Au départ, en ajoutant de la complexité, l’erreur de test diminue car le modèle capte des motifs réels. Puis, au-delà d’un certain point, elle remonte alors que l’erreur d’apprentissage continue de baisser : le modèle surapprend ; il apprend des particularités non généralisables.
Un faible écart train/test indique une bonne généralisation. Un grand écart signale du surapprentissage : réduisez la complexité ou ajoutez des données.
On ne supprime pas le compromis biais-variance, mais on le contrôle avec les bonnes techniques. En voici quelques-unes.
N’évaluez jamais votre modèle sur les mêmes données que celles utilisées pour l’entraîner.
Séparez très tôt vos données en ensembles d’apprentissage et de test. Entraînez sur l’un, évaluez sur l’autre. Vous obtenez ainsi une mesure honnête de la généralisation.
Le jeu de test sert de proxy de performance réelle. Erreur d’apprentissage faible mais erreur de test élevée : surapprentissage. Les deux élevées : sous-apprentissage.
La simple coupe train/test dépend des exemples tombés dans chaque ensemble.
La validation croisée corrige cela en entraînant/testant plusieurs fois sur des partitions différentes. La plus courante : la k-fold, où l’on divise en k parts, on entraîne sur k-1 et on teste sur la restante, en répétant k fois.
Vous obtenez une estimation plus fiable des performances et vous pouvez régler les hyperparamètres sans surajuster un seul jeu de test.
La régularisation ajoute une pénalité de complexité directement dans la fonction de coût.
Des techniques comme L1 (Lasso) et L2 (Ridge) découragent de grands coefficients, forçant un modèle plus simple et stable. Le biais augmente légèrement, la variance diminue, et la performance de test s’améliore souvent.
Le dropout en réseau de neurones agit de même : supprimer aléatoirement des neurones pendant l’apprentissage empêche le réseau de trop dépendre de paramètres spécifiques et réduit le surapprentissage.
Augmenter les données est souvent la meilleure réponse à une variance élevée.
Plus d’exemples offrent un échantillon plus large de motifs possibles, ce qui rend plus difficile l’ajustement au bruit, qui s’annule en moyenne. La variance diminue sans sacrifier le biais faible d’un modèle complexe.
Mais collecter davantage n’est pas toujours réaliste.
Avec des données limitées, soignez le choix du modèle : optez pour plus simple, ajoutez de la régularisation, ou utilisez des ensembles (ensembles de modèles) pour réduire la variance.
Toutes les variables n’améliorent pas votre modèle. Certaines n’apportent que du bruit.
Supprimez les variables non pertinentes ou redondantes pour réduire la complexité sans perdre l’essentiel. Moins de variables = moins de paramètres à apprendre : la variance baisse. Vous évitez aussi la malédiction de la dimensionnalité, où les modèles peinent dans des espaces très dimensionnels avec peu de données.
Utilisez l’analyse de corrélation, les scores d’importance des modèles en arbres, ou des méthodes de régularisation qui mettent à zéro les variables inutiles.
Objectif : le jeu minimal de variables qui capture le signal sans le bruit.
Voici trois erreurs fréquentes qui mènent à de mauvais choix de modélisation.
Faux. Un biais plus faible signifie que le modèle peut représenter des motifs complexes, à condition qu’ils existent vraiment et généralisent.
Réduire le biais en ajoutant de la complexité augmente souvent la variance plus vite que cela ne diminue le biais. Vous finissez avec un modèle parfait sur l’apprentissage mais moins bon sur le test. La cible, c’est l’erreur totale, pas seulement le biais.
Un modèle plus simple, donc plus biaisé, peut parfois mieux performer grâce à une variance suffisamment basse pour bien généraliser.
Pas exactement. Le surapprentissage indique un modèle trop complexe au regard de la quantité de données à disposition, pas un mauvais modèle en soi.
La même architecture réseau qui surajuste sur 1 000 exemples peut être excellente sur 100 000. Le problème est l’adéquation entre capacité et volume de données.
Pour corriger, ajoutez des données, réduisez la complexité ou appliquez de la régularisation. Inutile de tout jeter et repartir à zéro.
Plus de données réduisent la variance, mais ne l’éliminent pas, et l’effet a ses limites.
Si votre modèle est extrêmement complexe au regard du problème, même des gros volumes peuvent ne pas suffire à le stabiliser. Un réseau à des millions de paramètres exige des masses de données.
Et surtout, les nouvelles données doivent représenter la même distribution que vos données cibles. Ajouter des données biaisées ou bruitées n’aidera pas — pire, cela peut ancrer des motifs qui ne généralisent pas.
Ces notions décrivent les mêmes problèmes sous des angles différents, sans être interchangeables.
Retenez :
Le biais et la variance sont des propriétés du modèle.
Ils décrivent son comportement selon les jeux d’apprentissage. On mesure le biais par l’écart moyen aux valeurs vraies ; la variance par la variabilité des prédictions selon les données d’entraînement.
Le sous-apprentissage et le surapprentissage sont des symptômes observables.
On les constate à l’entraînement et au test : erreurs élevées des deux côtés (sous-apprentissage) ; erreur d’apprentissage faible mais test élevé (surapprentissage).
Le lien est direct mais pas bijectif. Un biais élevé mène généralement au sous-apprentissage, une variance élevée au surapprentissage. On peut aussi avoir biais et variance modérés sans sur- ni sous-apprentissage, mais de piètres résultats pour d’autres raisons (mauvaises variables, qualité de données insuffisante, etc.).
Voici quelques conseils de dernière minute pour diagnostiquer biais/variance et améliorer vos choix de modélisation.
L’erreur d’apprentissage seule ne dit rien de la généralisation. Un modèle à 1 % d’erreur d’apprentissage peut afficher 50 % d’erreur de test s’il surapprend.
Comparez les deux pour comprendre.
Une précision parfaite en apprentissage est un signal d’alarme : votre modèle mémorise le jeu d’entraînement.
Visez la performance en validation. L’objectif est de minimiser l’écart apprentissage/validation tout en gardant les deux erreurs raisonnablement basses.
Un unique split train/test peut être trompeur selon la répartition. Un split malchanceux peut desservir un bon modèle — ou l’inverse.
La validation croisée moyenne les performances sur plusieurs splits et fournit une estimation plus stable, essentielle avec peu de données ou lors du réglage d’hyperparamètres.
Avec de petits jeux de données, préférez des modèles simples : plus stables, moins enclins à surapprendre.
Avec de grands jeux, vous pouvez vous permettre plus de complexité car l’apprentissage est stabilisé et la variance réduite. Mais n’ajoutez pas de complexité pour le principe : seulement si la validation s’améliore.
On ne bâtit pas un modèle à biais zéro et variance zéro. Chaque choix de modélisation déplace l’équilibre entre ces deux sources d’erreur. Plus de complexité diminue le biais mais augmente la variance ; plus de simplicité fait l’inverse.
La performance repose sur le bon équilibre. Le meilleur modèle est celui qui minimise l’erreur totale en équilibrant biais et variance pour votre problème et vos données. Comprendre ce compromis vous permet de diagnostiquer si votre modèle souffre d’un biais ou d’une variance élevés et d’appliquer la bonne correction.
Prêt à passer à la pratique ? Inscrivez-vous à notre parcours Machine Learning Fundamentals in Python. 16 heures de vidéo pour vous aider à décrocher votre premier poste.
Apprenez avec DataCamp
Cours
Cours
Cours
blog
Kurtis Pykes
15 min
blog
Kurtis Pykes
9 min
blog
Lynn Heidmann
Tutoriel
Josef Waples
8 min
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Laiba Siddiqui
14 min