

一般来说,算法是一系列精确的指令,计算机按照这些指令完成特定任务或解决问题。查看我们的博文 What is an Algorithm,了解机器学习中的各种算法类型。
概念概览
二分查找是一种强大的算法,旨在高效地在已排序的数据集中查找某个值。其核心思想很直观:不同于线性查找那样逐个检查数据集中的每个元素,二分查找在每一步都将搜索范围缩小一半,从而使过程更快。
其工作原理如下:
- 首先,将目标值与数据集的中间元素进行比较。中间值的索引通过以下公式计算:middle = (low + high) / 2, 其中 low 是当前搜索范围内第一个元素的索引,high 是最后一个元素的索引。
- 将中间值与目标值进行比较。如果目标值等于中间元素,您就找到了索引,搜索完成。若目标值小于中间元素,则在数据集的左半部分继续搜索;若更大,则在右半部分继续搜索。
- 重复步骤 1-2。每一步搜索范围都会被减半。重复此过程,直到找到目标值或搜索范围为空。
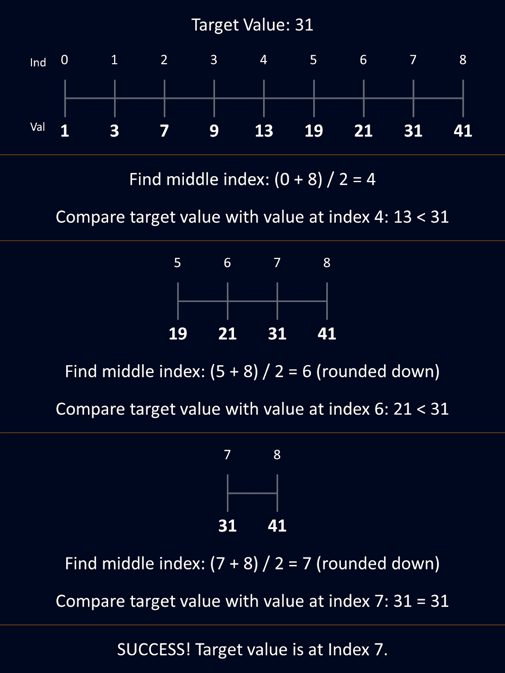
二分查找流程。作者制图
上图是一个简化示例,用于演示二分查找背后的概念。
正是这种“对半”过程让二分查找如此高效。不过,需要注意的是,数据集必须是已排序的,二分查找才能正确工作。如果数据未排序,算法将无法按预期运行。
查看Data Structures: A Comprehensive Guide With Python Examples,了解您可能需要搜索的不同类型数据结构。
关键要点
以下要点突出展示了二分查找的核心原理。
效率
二分查找比线性查找快得多,尤其是在处理大型数据集时。线性查找的时间复杂度为 O(n),意味着在最坏情况下可能需要检查每一个元素;而二分查找更高效,其时间复杂度为 O(log n),意味着每一步都将搜索空间减半,大幅减少所需比较次数。
有关算法评估的详细分解,请参阅我们的 Big O Notation and Time Complexity Guide: Intuition and Math。另一个选择是我们的 Analyzing Complexity of Code through Python 教程。
前提条件
要使二分查找生效,数据集必须按升序或降序排序。这是必要条件,因为算法依赖元素的顺序来判断下一步应搜索数据集的哪一半。如果数据未排序,二分查找无法准确定位目标值。
灵活性
二分查找既可以用迭代方式实现,也可以用递归方式实现。迭代方法使用循环不断将搜索范围对半缩小;递归方法让函数自我调用,并使用更小的搜索范围。这种灵活性使其适用于不同的应用场景。
真实世界的应用
二分查找是一种非常强大的工具。它能迅速缩小搜索范围的效率,尤其在处理大型数据集、性能和速度至关重要的情况下,显得极其重要。让我们探索一些具体应用,并看看二分查找与其他算法相比如何。
数据库
在数据库中,二分查找常用于在已排序的字段中快速定位记录,例如在按用户 ID 排序的数据库中查找特定用户。想象一个包含数百万条记录的数据库。线性查找需要逐条扫描,可能耗时很长。相反,二分查找可以通过系统性地将搜索空间减半,迅速锁定目标记录,显著减少比较次数。
数据科学
在数据科学中,遍历大型、已排序的数据集是常见任务。例如在时间序列分析中,二分查找可用于在排序的事件序列中查找特定时间戳。在机器学习中,二分查找算法可以通过在某个范围内寻找最佳值来优化超参数。
计算机图形学
在计算机图形学中,二分查找用于需要精度与速度的算法中。一个例子是光线追踪,这是一种用于模拟光线与物体交互的渲染技术。二分查找可以用于快速找到光线与表面的交点。
复杂算法的基石
二分查找不仅本身有用,还是更复杂算法和数据结构的基石。例如,搜索树(如二叉搜索树,BST)以及平衡树(如 AVL 树)都基于二分查找的原理。这些结构支持高效的搜索、插入和删除操作,适用于需要动态更新并频繁查询的数据。进一步了解这些树结构,请参阅 AVL Tree: Complete Guide With Python Implementation。
二分查找与其他搜索算法对比
让我们看看二分查找与另外两种常见搜索算法(线性查找和哈希查找)的比较。
线性查找
线性查找是一种简单直接的算法,按顺序检查数据集中的每个元素。与二分查找相比,它的效率要低得多,时间复杂度为 O(n)。不过,线性查找不要求数据已排序,在某些场景下依然有用。
哈希查找
哈希查找是一种高效算法,用于在值与唯一键关联时快速在数据集中查找该值。其原理是对键应用哈希函数,计算出对应值在哈希表中的索引位置。这样可以几乎瞬时地检索到值,通常为 O(1) 时间。不过,尽管哈希查找在查找特定元素方面非常快,但它需要额外内存来存储哈希表,也不适合在值的范围内进行搜索——这类任务更适合二分查找。
在 Python 中实现二分查找
下面我们探索几种在 Python 中实现简单二分查找的方法。但首先,我们需要准备一个简单的数据集和一个要查找的目标值。假设我们有如下已排序数组和搜索目标:
arr = [2, 5, 8, 12, 16, 23, 38, 56, 72, 91]
target = 56迭代方法
迭代方法或许是最直观的实现方式。通过 while 循环不断将搜索区间对半缩小,直到找到目标。该方法因其清晰和高效而常被采用。
以下是迭代实现二分查找的方式:
def binary_search_iterative(arr, target):
# Define the search bounds
left, right = 0, len(arr) - 1
while left <= right:
# Calculate the middle index
mid = left + (right - left) // 2
# If the middle element is the target, return its index
if arr[mid] == target:
return mid
# If the target is bigger, narrow the search to the right half
elif arr[mid] < target:
left = mid + 1
# If the target is smaller, narrow the search to the left half
else:
right = mid - 1
# Return -1 if the target is not found
return -1
# Run the iterative function
result = binary_search_iterative(arr, target)
if result != -1:
print(f"Iterative: Target found at index {result}")
else:
print("Iterative: Target not found")我们来更仔细地看看这段代码:
-
首先设置搜索空间的边界 left 和 right。初始时,left 为
0(数组起始位置),right 为len(arr) - 1(数组末尾)。 -
每次迭代时,我们计算中间索引 mid,它表示当前搜索区间的中点。使用的公式为
mid = left + (right - left) /2。 -
然后将
mid位置的元素与target比较: -
如果相等,说明找到了目标,函数返回
mid。 -
如果
mid处元素小于目标,说明目标一定在右半部分,于是将left调整为mid + 1。 -
如果
mid处元素大于目标,说明目标在左半部分,于是将right调整为mid - 1。 -
循环持续进行,直到找到目标或
left大于right,这意味着目标不在数组中。
递归方法
递归方法是实现该算法的另一种方式。它不使用循环,而是让函数自我调用,每次调整搜索边界,直到找到目标或确定目标不存在。
以下是递归实现二分查找的方法:
def binary_search_recursive(arr, target, left, right):
# If the search bounds cross, the target isn't in the array
if left > right:
return -1
# Calculate the middle index
mid = left + (right - left) // 2
# If middle value equals the target, return the index
if arr[mid] == target:
return mid
# If the target is bigger than the middle value, search in the right half
elif arr[mid] < target:
return binary_search_recursive(arr, target, mid + 1, right)
# If the target is smaller than the middle value, search in the left half
else:
return binary_search_recursive(arr, target, left, mid - 1)
# Run the recursive function
result = binary_search_recursive(arr, target, 0, len(arr) - 1)
if result != -1:
print(f"Iterative: Target found at index {result}")
else:
print("Iterative: Target not found")我们来更仔细地看看这段代码:
-
递归函数与迭代函数一样,起始的
left和right边界相同。 -
首先检查
left是否超过right。如果是,则返回-1,表示目标不在数组中。 -
否则,计算
mid索引,并将目标与mid位置的元素进行比较。 -
如果目标等于
mid位置元素,函数返回mid。 -
如果目标大于
mid位置元素,函数以更新后的边界递归调用自身,在右半部分搜索。 -
如果目标小于
mid位置元素,函数在左半部分搜索。 -
递归将持续进行,直至找到目标或搜索空间耗尽。
关于递归函数的更多内容,请查看 Understanding Recursive Functions in Python。
使用 Python 内置的 bisect 模块
Python 标准库提供了 bisect 模块,其中包含预先实现的二分查找函数。该模块效率很高,常常比我们自己编写函数更省时。
我们可以这样使用 bisect 模块在数组中查找目标:
# Import the bisect module
import bisect
# Call the module and provide the array and the target value
index = bisect.bisect_left(arr, target)
#Print results
if index < len(arr) and arr[index] == target:
print(f"Bisect: Target found at index {index}")
else:
print("Bisect: Target not found")我们来更仔细地看看这段代码:
-
bisect_left函数会返回目标应插入的位置,以保持数组有序。若目标正好在该索引处,说明目标存在于数组中。 -
该方法在处理已排序数组时尤其实用,也可用于在保持有序的前提下插入元素。
-
bisect模块还提供bisect_right和insort等函数,可用于查找插入点或直接插入元素。
时间与空间复杂度
在讨论算法效率时,我们常使用大 O 表示法(记作 O(x))来描述当输入规模增大时运行时间或空间需求如何增长。对于二分查找,时间复杂度通常为 O(log n)。这意味着随着数据集增长,找到目标所需的操作次数以对数方式增加,即使面对大型数据集,二分查找也依然高效。
迭代版二分查找的时间复杂度为 O(log n),因为每次迭代都会将搜索区间减半。其空间复杂度为 O(1),因为只使用常量级的额外空间,仅需少量变量来跟踪搜索边界和中间元素。
递归版的时间复杂度同样为 O(log n),原因相同。但其空间复杂度为 O(log n),因为每次递归调用都需要在调用栈上占用空间。随着递归调用层数增加,递归深度与对半次数成正比,相对于数据集大小是对数级的。
虽然两种方法在时间上都很高效,但迭代方法在空间上更节省。这也是 bisect 模块在底层采用迭代方法的原因。就我个人而言,也更偏好迭代方法。不过,对一些人来说,递归方法更直观,且可能需要更少的代码行数。
常见陷阱及规避方法
在使用二分查找时,有一些常见陷阱需要注意。它们会影响算法的正确性和效率,因此务必重视。
首先,二分查找依赖数据集是已排序的。如果数据未排序,二分查找将无法正确工作,可能返回错误结果或彻底失败。因此,在使用二分查找前必须先对数据集进行排序。如果无法排序,那么二分查找并不适用。
一个常见问题是“差一错误”(off-by-one)。当索引计算略有偏差时,可能导致无限循环或无法定位目标值。这通常发生在中点计算或边界调整处理不严谨时。为避免此问题,请确保中间索引的计算正确无误,并在每次比较后正确更新边界。请记住,Python 中的索引从 0 开始,而不是 1。
若使用递归实现二分查找,还需留意递归深度问题。Python 为防止过度占用内存,对递归调用次数设有上限。如果数据集非常大,较深的递归可能超过此上限并导致栈溢出。为减轻风险,建议使用不受递归深度限制的迭代方法。如果更偏好或必须使用递归,您也可以通过 sys.setrecursionlimit() 提高递归上限,但务必谨慎,以避免引发其他问题。
结论
二分查找是一种强大而高效的算法,每位 Python 开发者都应掌握。无论以迭代还是递归方式实现,它都能相较线性查找带来显著的性能优势,尤其在大型数据集上。更多内容请查看 DataCamp’s Python Programming 技能路径或 Software Engineering Principles in Python 交互式课程。

我拥有博士学位,在生物研究环境中从事数据相关工作已有13年。我使用包括 Python、MATLAB 和 R 在内的多种编程语言开发软件。我热衷于与世界分享我对学习的热爱。
二分查找常见问答
在哪些常见的真实场景中,二分查找可能效率不高?
当数据未排序或频繁更新时,排序会带来额外开销,从而降低二分查找的效率。
二分查找能用于数组之外的数据结构(如链表)吗?
不能,因为访问链表的中间位置需要线性时间,这会抵消二分查找的速度优势。
二分查找如何处理数据集中的重复值?
二分查找能找到一个匹配项。若要找到所有重复值,需要额外搜索上下界。
在 Python 中使用 bisect 模块相比自写二分查找函数有什么优势?
bisect 模块经过优化且可靠,并提供保持数据集有序的插入等附加功能。
想象一下,您在玩一个猜数字的游戏,需要在 1 到 100 之间找出一个特定的数字。您可以随机猜测,但在最坏情况下,可能需要 100 次才能猜到正确答案。
更聪明的方法是先猜中间的数字 50,然后询问目标数字是更大还是更小。如果目标数字更大,您就可以忽略 50 以下的所有数字,并在 51-100 范围内重复这一过程。持续缩小范围,直到找到正确的数字。
通过每次将可能性减半,您可以更快逼近目标。用这种方法,即使在最坏情况下,最多也只需 7 次猜测就能找到正确数字。这一策略正是二分查找的精髓。
在本指南中,我们将深入介绍什么是二分查找、它的实际应用,以及如何使用 Python 以迭代和递归两种方式实现它。若想系统学习,请查看我们的 Data Structures and Algorithms in Python 课程,该课程详细探讨二分查找,并涵盖其他常见且重要的搜索算法,如线性查找、深度优先搜索和广度优先搜索。
什么是二分查找?
在数据集中查找某个值时,您的目标是找到它的索引(位置),以便在代码中轻松检索和使用该值。有多种搜索算法可以帮助您定位特定值的索引。其中最高效、最基础的方法之一就是二分查找。