

सामान्य रूप से कहें तो, एक एल्गोरिदम निर्देशों का एक सटीक अनुक्रम होता है जिसे कंप्यूटर किसी विशिष्ट कार्य को पूरा करने या किसी समस्या को हल करने के लिए अनुसरण करता है। हमारे ब्लॉग पोस्ट What is an Algorithm पर नज़र डालें, ताकि मशीन लर्निंग में विभिन्न प्रकार के एल्गोरिदम के बारे में जान सकें।
संकल्पना अवलोकन
बाइनरी सर्च एक शक्तिशाली एल्गोरिदम है जिसे किसी सॉर्टेड डेटा सेट में किसी मान को कुशलता से खोजने के लिए डिज़ाइन किया गया है। बाइनरी सर्च के पीछे का मूल विचार सरल है: linear search की तरह क्रम से हर तत्व की जाँच करने के बजाय, बाइनरी सर्च हर चरण में खोज दायरे को आधा कर देता है, जिससे प्रक्रिया काफी तेज़ हो जाती है।
यह इस प्रकार काम करता है:
- डेटासेट के मध्य तत्व के साथ लक्ष्य मान की तुलना करके शुरू करें। मध्य मान का इंडेक्स इस सूत्र से निकाला जाता है: middle = (low + high) / 2, जहाँ low वर्तमान खोज दायरे के पहले तत्व का इंडेक्स है और high अंतिम तत्व का इंडेक्स है।
- मध्य मान की तुलना लक्ष्य से करें। यदि लक्ष्य मान मध्य तत्व के बराबर है, तो आपने इंडेक्स खोज लिया है और खोज पूर्ण है। यदि लक्ष्य मान मध्य तत्व से छोटा है, तो खोज डेटासेट के बाएँ आधे हिस्से में जारी रहती है। यदि लक्ष्य मान बड़ा है, तो खोज दाएँ आधे हिस्से में जारी रहती है।
- चरण 1-2 दोहराएँ। प्रत्येक चरण में खोज दायरा लगातार आधा होता जाता है। इस प्रक्रिया को तब तक दोहराएँ जब तक लक्ष्य मान न मिल जाए या खोज दायरा खाली न हो जाए।
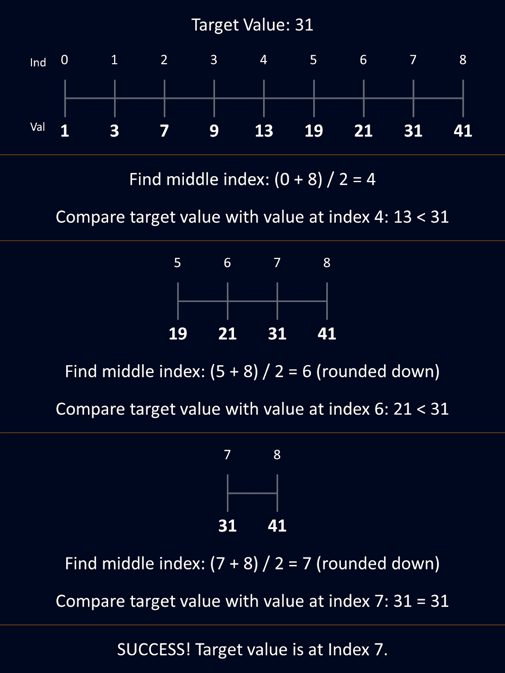
बाइनरी सर्च की प्रक्रिया। छवि: लेखक द्वारा
ऊपर बाइनरी सर्च के पीछे की अवधारणा को दर्शाता एक सरल उदाहरण है।
यही आधा करने की प्रक्रिया बाइनरी सर्च को इतना कुशल बनाती है। हालाँकि, यह ध्यान रखना महत्वपूर्ण है कि बाइनरी सर्च के सही ढंग से काम करने के लिए डेटा सेट का सॉर्टेड होना आवश्यक है। यदि डेटा सॉर्टेड नहीं है, तो एल्गोरिदम इच्छित रूप से कार्य नहीं करेगा.
और जानने के लिए देखें Data Structures: A Comprehensive Guide With Python Examples, जहाँ विभिन्न प्रकार के डेटा स्ट्रक्चर के बारे में बताया गया है जिन्हें आप खोजना चाहेंगे।
याद रखने योग्य मुख्य बिंदु
निम्नलिखित बिंदु बाइनरी सर्च के मूल सिद्धांतों को रेखांकित करते हैं।
दक्षता
बाइनरी सर्च विशेष रूप से बड़े डेटा सेट के साथ काम करते समय linear search की तुलना में काफी तेज़ है। जहाँ linear search की समय जटिलता O(n) होती है, अर्थात सबसे बुरे हाल में उसे हर तत्व की जाँच करनी पड़ सकती है, वहीं बाइनरी सर्च अधिक कुशल है। इसकी समय जटिलता O(log n) होती है, यानी हर चरण में खोज दायरा आधा हो जाता है, जिससे आवश्यक तुलना की संख्या काफी घट जाती है।
एल्गोरिदम का मूल्यांकन कैसे किया जाता है, इसका विस्तृत विवरण पाने के लिए हमारा Big O Notation and Time Complexity Guide: Intuition and Math देखें। एक विकल्प हमारा Analyzing Complexity of Code through Python ट्यूटोरियल है।
आवश्यकताएँ
बाइनरी सर्च के काम करने के लिए, डेटा सेट का या तो आरोही या अवरोही क्रम में सॉर्टेड होना आवश्यक है। ऐसा इसलिए क्योंकि एल्गोरिदम यह निर्धारित करने के लिए तत्वों के क्रम पर निर्भर करता है कि अगली बार डेटासेट के किस आधे हिस्से में खोज करनी है। यदि डेटा सॉर्टेड नहीं है, तो बाइनरी सर्च लक्ष्य मान को सटीक रूप से खोज नहीं सकता।
लचीलापन
बाइनरी सर्च को या तो iterative या recursive तरीके से लागू किया जा सकता है। iterative विधि लूप का उपयोग करके बार-बार खोज दायरे को आधा करती है। recursive विधि में फ़ंक्शन स्वयं को छोटे खोज दायरे के साथ कॉल करता है। यह लचीलापन इसे विभिन्न अनुप्रयोगों के लिए उपयुक्त बनाता है।
वास्तविक दुनिया के अनुप्रयोग
बाइनरी सर्च एक शक्तिशाली उपकरण है। खोज दायरे को तेजी से संकीर्ण करने में इसकी दक्षता इसे अमूल्य बनाती है, विशेष रूप से तब जब बड़े डेटा सेट से निपटना हो और प्रदर्शन व गति महत्वपूर्ण हों। आइए कुछ विशिष्ट अनुप्रयोगों का अन्वेषण करें और देखें कि बाइनरी सर्च अन्य एल्गोरिदम की तुलना में कैसा है।
डेटाबेस
डेटाबेस में, बाइनरी सर्च का अक्सर सॉर्टेड फील्ड्स के भीतर रिकॉर्ड को जल्दी ढूंढ़ने के लिए उपयोग किया जाता है, जैसे कि यूज़र ID द्वारा सॉर्टेड डेटाबेस में किसी विशिष्ट यूज़र को खोजना। कल्पना करें कि डेटाबेस में लाखों रिकॉर्ड हैं। एक linear search में हर रिकॉर्ड को क्रम से स्कैन करना पड़ेगा, जिसमें काफी समय लग सकता है। इसके बजाय, बाइनरी सर्च खोज दायरे को व्यवस्थित रूप से आधा करके वांछित रिकॉर्ड को जल्दी से ढूंढ़ सकती है, जिससे आवश्यक तुलनाओं की संख्या काफी कम हो जाती है।
डेटा साइंस
बड़े, सॉर्टेड डेटा सेट में खोज करना डेटा साइंस में आम कार्य है। उदाहरण के लिए, time series विश्लेषण में, बाइनरी सर्च का उपयोग घटनाओं के सॉर्टेड क्रम में विशिष्ट timestamps खोजने के लिए किया जा सकता है। मशीन लर्निंग में, बाइनरी सर्च एल्गोरिदम का उपयोग किसी दायरे के भीतर सर्वोत्तम मान ढूंढ़कर हाइपरपैरामीटर्स को अनुकूलित करने के लिए किया जा सकता है।
कंप्यूटर ग्राफ़िक्स
कंप्यूटर ग्राफ़िक्स में, जहाँ सटीकता और गति दोनों की आवश्यकता होती है, बाइनरी सर्च का उपयोग एल्गोरिदम में किया जाता है। एक उदाहरण रे ट्रेसिंग है, जो वस्तुओं के साथ प्रकाश की अंतःक्रिया का अनुकरण करने के लिए प्रयुक्त रेंडरिंग तकनीक है। बाइनरी सर्च का उपयोग किरणों और सतहों के बीच प्रतिच्छेदन बिंदु को जल्दी से खोजने के लिए किया जा सकता है।
जटिल एल्गोरिदम के निर्माण खंड
बाइनरी सर्च केवल अपने आप में उपयोगी नहीं है; यह और भी जटिल एल्गोरिदम और डेटा संरचनाओं के लिए निर्माण खंड के रूप में कार्य करता है। उदाहरण के लिए, search trees, जैसे binary search trees (BSTs), और balanced trees, जैसे AVL trees, बाइनरी सर्च के सिद्धांतों पर आधारित हैं। ये संरचनाएँ कुशल खोज, insertion, और deletion ऑपरेशनों की अनुमति देती हैं, जिससे वे तब उपयोगी होती हैं जब डेटा को गतिशील रूप से अपडेट और बार-बार खोजने की आवश्यकता होती है। इन ट्रीज़ के बारे में अधिक जानें: AVL Tree: Complete Guide With Python Implementation।
बाइनरी सर्च बनाम अन्य सर्च एल्गोरिदम
आइए देखें कि बाइनरी सर्च की तुलना दो अन्य सामान्य सर्च एल्गोरिदम—linear search और hash lookup—से कैसे होती है।
Linear search
Linear search एक सरल एल्गोरिदम है जो किसी डेटा सेट के प्रत्येक तत्व की क्रम से जाँच करता है। यह बाइनरी सर्च की तुलना में काफी कम कुशल है, जिसकी समय जटिलता O(n) होती है। हालाँकि, linear search के लिए डेटा का सॉर्टेड होना आवश्यक नहीं है, जिससे यह कुछ परिदृश्यों में उपयोगी हो जाता है।
Hash lookup
Hash lookup किसी डेटा सेट में मानों को तेज़ी से खोजने के लिए उपयोग किया जाने वाला कुशल एल्गोरिदम है जब वे मान अद्वितीय keys से संबद्ध होते हैं। यह key पर एक hash फ़ंक्शन लागू करके काम करता है, जो उस इंडेक्स की गणना करता है जहाँ संबंधित मान hash table में संग्रहीत है। यह मानों की लगभग तात्कालिक प्राप्ति की अनुमति देता है, अक्सर O(1) समय में। हालाँकि, जबकि hash lookup विशिष्ट तत्व खोजने के लिए बहुत तेज़ है, hash table को संग्रहीत करने के लिए अतिरिक्त मेमोरी की आवश्यकता होती है और यह मानों की किसी रेंज के भीतर खोज के लिए उपयुक्त नहीं है—ऐसा कार्य जहाँ बाइनरी सर्च अधिक उपयुक्त है।
Python में बाइनरी सर्च को लागू करना
आइए Python में एक साधारण बाइनरी सर्च को लागू करने के कुछ तरीकों का अन्वेषण करें। लेकिन पहले, हमें काम करने के लिए एक सरल डेटा सेट और खोजने के लिए एक target मान स्थापित करना होगा। मान लीजिए हमारे पास निम्नलिखित सॉर्टेड array और खोज लक्ष्य है:
arr = [2, 5, 8, 12, 16, 23, 38, 56, 72, 91]
target = 56Iterative विधि
Iterative विधि शायद सबसे सीधी-सादी पद्धति है। इस तरीके में, हम while लूप का उपयोग करते हैं जो हमारे target मिलने तक खोज अंतराल को बार-बार आधे में विभाजित करता है। यह विधि अक्सर अपनी स्पष्टता और दक्षता के लिए पसंद की जाती है।
यहाँ आप बाइनरी सर्च को iterative तरीके से कैसे लागू कर सकते हैं:
def binary_search_iterative(arr, target):
# Define the search bounds
left, right = 0, len(arr) - 1
while left <= right:
# Calculate the middle index
mid = left + (right - left) // 2
# If the middle element is the target, return its index
if arr[mid] == target:
return mid
# If the target is bigger, narrow the search to the right half
elif arr[mid] < target:
left = mid + 1
# If the target is smaller, narrow the search to the left half
else:
right = mid - 1
# Return -1 if the target is not found
return -1
# Run the iterative function
result = binary_search_iterative(arr, target)
if result != -1:
print(f"Iterative: Target found at index {result}")
else:
print("Iterative: Target not found")आइए इस कोड को क़रीब से देखें:
-
हम 'left' और 'right' को खोज स्थान की सीमाओं के रूप में सेट करके शुरू करते हैं। शुरू में left
0होता है (array की शुरुआत) और 'right'len(arr) - 1होता है (array का अंत)। -
हर iteration में, हम mid इंडेक्स की गणना करते हैं, जो वर्तमान खोज अंतराल के मध्य का प्रतिनिधित्व करता है। यह सूत्र से किया जाता है
mid = left + (right - left) /2। -
फिर हम
midपर स्थित तत्व कीtargetसे तुलना करते हैं: -
यदि वे मेल खाते हैं, तो हमें target मिल गया है, और फ़ंक्शन
midलौटाता है। -
यदि
midपर स्थित तत्व target से कम है, तो इसका मतलब है कि target दाईं आधी में होगा, इसलिए हमleftकोmid + 1कर देते हैं। -
यदि
midपर स्थित तत्व target से बड़ा है, तो target बाईं आधी में होगा, इसलिए हमrightकोmid - 1कर देते हैं। -
लूप तब तक चलता है जब तक target नहीं मिल जाता या
leftrightसे आगे नहीं निकल जाता, जिसका मतलब है कि target array में नहीं है।
Recursive विधि
बाइनरी सर्च के लिए recursive विधि इस एल्गोरिदम को लागू करने का एक और तरीका है। लूप का उपयोग करने के बजाय, फ़ंक्शन स्वयं को कॉल करता है, हर बार खोज सीमाओं को समायोजित करते हुए, जब तक कि target नहीं मिल जाता या यह निर्धारित नहीं हो जाता कि target मौजूद नहीं है।
यहाँ आप बाइनरी सर्च को recursive तरीके से कैसे लागू कर सकते हैं:
def binary_search_recursive(arr, target, left, right):
# If the search bounds cross, the target isn't in the array
if left > right:
return -1
# Calculate the middle index
mid = left + (right - left) // 2
# If middle value equals the target, return the index
if arr[mid] == target:
return mid
# If the target is bigger than the middle value, search in the right half
elif arr[mid] < target:
return binary_search_recursive(arr, target, mid + 1, right)
# If the target is smaller than the middle value, search in the left half
else:
return binary_search_recursive(arr, target, left, mid - 1)
# Run the recursive function
result = binary_search_recursive(arr, target, 0, len(arr) - 1)
if result != -1:
print(f"Iterative: Target found at index {result}")
else:
print("Iterative: Target not found")आइए इस कोड को क़रीब से देखें:
-
Recursive फ़ंक्शन iterative फ़ंक्शन की तरह ही प्रारंभिक
leftऔरrightसीमाओं से शुरू होता है। -
यह पहले जाँचता है कि क्या
leftrightसे आगे निकल गया है। यदि हाँ, तो फ़ंक्शन-1लौटाता है, जो इंगित करता है कि target array में नहीं है। -
अन्यथा, फ़ंक्शन
midइंडेक्स की गणना करता है औरmidपर स्थित तत्व से target की तुलना करता है। -
यदि target
midपर स्थित तत्व के बराबर है, तो फ़ंक्शनmidलौटाता है। -
यदि target
midसे बड़ा है, तो फ़ंक्शन दाएँ आधे हिस्से में खोजने के लिए अद्यतन सीमाओं के साथ स्वयं को पुनः कॉल करता है। -
यदि target
midसे कम है, तो फ़ंक्शन बाएँ आधे हिस्से में खोजता है। -
रिकर्शन तब तक जारी रहता है जब तक target नहीं मिल जाता या खोज दायरा समाप्त नहीं हो जाता।
Recursive फ़ंक्शनों पर अधिक जानकारी के लिए देखें Understanding Recursive Functions in Python।
Python के बिल्ट-इन bisect मॉड्यूल का उपयोग
Python की स्टैंडर्ड लाइब्रेरी में bisect मॉड्यूल शामिल है, जो पहले से लागू बाइनरी सर्च फ़ंक्शंस प्रदान करता है। यह मॉड्यूल अत्यंत कुशल है और अक्सर अपना फ़ंक्शन बनाने की तुलना में हमारा समय बचा सकता है।
यहाँ देखें कि हम अपनी array में target ढूँढ़ने के लिए bisect मॉड्यूल का कैसे उपयोग कर सकते हैं:
# Import the bisect module
import bisect
# Call the module and provide the array and the target value
index = bisect.bisect_left(arr, target)
#Print results
if index < len(arr) and arr[index] == target:
print(f"Bisect: Target found at index {index}")
else:
print("Bisect: Target not found")आइए इस कोड को क़रीब से देखें:
-
bisect_leftफ़ंक्शन वह इंडेक्स लौटाता है जहाँ target को डाला जाना चाहिए ताकि array का क्रम बना रहे। यदि target इसी इंडेक्स पर मिलता है, तो इसका मतलब है कि target array में मौजूद है। -
यह तरीका विशेष रूप से सॉर्टेड arrays के साथ काम करते समय उपयोगी है और सॉर्टेड क्रम बनाए रखते हुए तत्वों को insert करने के लिए भी उपयोग किया जा सकता है।
-
bisectमॉड्यूलbisect_rightऔरinsortजैसे अन्य फ़ंक्शंस भी प्रदान करता है, जिनका उपयोग insertion points खोजने या सीधे तत्व insert करने के लिए किया जा सकता है।
समय और स्पेस जटिलता
किसी एल्गोरिदम की दक्षता पर चर्चा करते समय, हम अक्सर Big O नोटेशन, जिसे O(x) के रूप में दर्शाया जाता है, का उपयोग करते हैं ताकि यह बताया जा सके कि इनपुट के आकार के बढ़ने पर रनटाइम या स्पेस आवश्यकताएँ कैसे बढ़ती हैं। बाइनरी सर्च के लिए, समय जटिलता आमतौर पर O(log n) होती है। इसका अर्थ यह है कि जैसे-जैसे डेटा सेट बढ़ता है, target को खोजने के लिए आवश्यक ऑपरेशनों की संख्या लघुगणकीय रूप से बढ़ती है, जिससे बाइनरी सर्च बड़े डेटा सेट के लिए भी कुशल रहता है।
बाइनरी सर्च की iterative विधि की समय जटिलता O(log n) होती है क्योंकि हर iteration में खोज अंतराल आधा हो जाता है। इसकी स्पेस जटिलता O(1) होती है क्योंकि यह अतिरिक्त स्पेस की एक स्थिर मात्रा का उपयोग करती है—सिर्फ कुछ वेरिएबल्स जो खोज सीमाएँ और मध्य तत्व को ट्रैक करते हैं।
Recursive विधि की भी समय जटिलता O(log n) होती है, इसी कारण से। हालाँकि, इसकी स्पेस जटिलता O(log n) होती है क्योंकि प्रत्येक recursive कॉल के लिए कॉल स्टैक को बनाए रखने में स्पेस लगता है। जैसे-जैसे प्रत्येक recursive कॉल स्टैक में एक परत जोड़ती है, रिकर्शन की गहराई आधा करने वाले चरणों की संख्या के अनुपात में होती है, जो डेटा सेट के आकार के सापेक्ष लघुगणकीय होती है।
यद्यपि दोनों तरीके समय के दृष्टिकोण से कुशल हैं, iterative तरीका स्पेस के दृष्टिकोण से अधिक कुशल है। यही कारण है कि bisect मॉड्यूल अंदर ही अंदर iterative तरीका उपयोग करता है। व्यक्तिगत रूप से, मैं भी इसी कारण iterative तरीके को प्राथमिकता देता/देती हूँ। हालाँकि, recursive तरीका कुछ लोगों के लिए अधिक सहज हो सकता है और कोड की कम पंक्तियाँ मांग सकता है।
सामान्य गलतियाँ और उनसे कैसे बचें
बाइनरी सर्च का उपयोग करते समय कुछ सामान्य गलतियों पर ध्यान देना चाहिए। ये आपके एल्गोरिदम की शुद्धता और दक्षता को प्रभावित कर सकती हैं, इसलिए इन्हें ध्यान में रखना महत्वपूर्ण है।
पहले, बाइनरी सर्च इस बात पर निर्भर करता है कि डेटा सेट सॉर्टेड हो। यदि डेटा सॉर्टेड नहीं है, तो बाइनरी सर्च सही तरह से काम नहीं करेगा; यह गलत परिणाम दे सकता है या बिल्कुल विफल हो सकता है। इसलिए, बाइनरी सर्च लागू करने से पहले हमारे डेटा सेट को सॉर्ट करना आवश्यक है। यदि डेटा को सॉर्ट करना संभव नहीं है, तो बाइनरी सर्च उपयुक्त उपकरण नहीं है।
एक सामान्य समस्या off-by-one त्रुटियाँ हैं। ये तब होती हैं जब इंडेक्स की गणनाएँ थोड़ी गलत होती हैं, जिससे अनंत लूप हो सकते हैं या target को खोजने में विफलता हो सकती है। यह तब हो सकता है जब मध्य बिंदु की गणना या सीमा का समायोजन सटीक रूप से न किया गया हो। इससे बचने के लिए, सुनिश्चित करें कि मध्य इंडेक्स की गणना सही है और प्रत्येक तुलना के बाद सीमाएँ ठीक से अपडेट होती हैं। याद रखें, Python में इंडेक्स मान 0 से शुरू होते हैं, 1 से नहीं।
यदि आप बाइनरी सर्च को recursive तरीके से उपयोग करते हैं, तो एक और चुनौती है रिकर्शन गहराई की समस्या। Python में रिकर्शन कॉल्स की संख्या की एक सीमा होती है ताकि अत्यधिक मेमोरी उपयोग रोका जा सके। यदि आपका डेटा सेट बहुत बड़ा है, तो गहरी रिकर्शन इस सीमा से अधिक हो सकती है और stack overflow का कारण बन सकती है। इसे कम करने के लिए, बाइनरी सर्च के लिए iterative तरीका अपनाने पर विचार करें, जो रिकर्शन गहराई की सीमाओं से ग्रस्त नहीं है। यदि रिकर्शन पसंदीदा या आवश्यक है, तो आप sys.setrecursionlimit() का उपयोग करके रिकर्शन सीमा बढ़ा सकते हैं, लेकिन संभावित अन्य समस्याओं से बचने के लिए यह सावधानी से किया जाना चाहिए।
निष्कर्ष
बाइनरी सर्च एक शक्तिशाली और कुशल एल्गोरिदम है जो हर Python डेवलपर के टूलकिट में होना चाहिए। चाहे इसे iterative रूप में लागू किया जाए या recursive रूप में, यह विशेष रूप से बड़े डेटा सेट के साथ linear search की तुलना में महत्वपूर्ण प्रदर्शन लाभ देता है। और अधिक के लिए देखें DataCamp का Python Programming स्किल ट्रैक या Software Engineering Principles in Python इंटरैक्टिव कोर्स।

मैं एक पीएचडी हूँ, जिसके पास जैविक अनुसंधान परिवेश में डेटा के साथ काम करने का 13 वर्षों का अनुभव है। मैं Python, MATLAB और R सहित कई प्रोग्रामिंग भाषाओं में सॉफ्टवेयर बनाती/बनाता हूँ। मुझे सीखने के प्रति अपने प्रेम को दुनिया के साथ साझा करने का जुनून है।
बाइनरी सर्च FAQs
कौन-से वास्तविक-world परिदृश्य हैं जहाँ बाइनरी सर्च अक्षम हो सकती है?
जब डेटा सॉर्टेड न हो या बार-बार अपडेट होता हो, तो sorting धीमी पड़ सकती है, जिससे बाइनरी सर्च कम कुशल हो जाती है।
क्या बाइनरी सर्च arrays के अलावा अन्य डेटा संरचनाओं, जैसे linked lists, पर उपयोग की जा सकती है?
नहीं, क्योंकि linked list के मध्य तक पहुँचना linear समय लेता है, जिससे बाइनरी सर्च की गति का लाभ समाप्त हो जाता है।
किसी डेटा सेट में डुप्लीकेट मानों को बाइनरी सर्च कैसे संभालती है?
बाइनरी सर्च एक occurrence ढूँढ़ती है। सभी डुप्लीकेट्स खोजने के लिए, सीमाओं के लिए अतिरिक्त खोज करनी पड़ती है।
Python में कस्टम बाइनरी सर्च फ़ंक्शन लिखने की तुलना में bisect मॉड्यूल का उपयोग करने का क्या लाभ है?
bisect मॉड्यूल अनुकूलित, विश्वसनीय है, और इसमें सॉर्टेड डेटासेट को बनाए रखते हुए insertion जैसी अतिरिक्त सुविधाएँ हैं।
कल्पना करें कि आप एक अनुमान लगाने वाला खेल खेल रहे हैं जिसमें आपको 1 और 100 के बीच एक विशिष्ट संख्या खोजनी है। आप यादृच्छिक रूप से अनुमान लगा सकते हैं, लेकिन सबसे बुरे हाल में सही उत्तर तक पहुँचने में आपको 100 अनुमान लगाने पड़ सकते हैं।
एक छोटा तरीका यह हो सकता है कि आप बीच की संख्या, 50, चुनें और पूछें कि लक्ष्य संख्या इससे बड़ी है या छोटी। यदि आपकी लक्ष्य संख्या बड़ी है, तो आप 50 से नीचे की हर चीज़ को नज़रअंदाज़ कर सकते हैं और 51-100 के साथ यह कार्य दोहरा सकते हैं। आप ऐसा तब तक जारी रख सकते हैं जब तक सही संख्या न मिल जाए।
हर बार संभावनाओं को आधा करके, आप लक्ष्य तक जल्दी पहुँचते हैं। इस तरीके से, सबसे बुरे हाल में भी, सही संख्या खोजने में अधिकतम 7 अनुमान ही लगेंगे। यही रणनीति बाइनरी सर्च का सार है।
इस मार्गदर्शिका में, हम देखेंगे कि बाइनरी सर्च क्या है, इसके व्यावहारिक उपयोग क्या हैं, और Python में इसे iterative और recursive दोनों तरीकों से कैसे लागू करें। एक पूर्ण-विशेषताओं वाले पाठ्यक्रम के लिए, हमारे Data Structures and Algorithms in Python कोर्स को देखें, जो बाइनरी सर्च के साथ-साथ linear search, depth first search, और breadth first search जैसे अन्य सामान्य और महत्वपूर्ण सर्च एल्गोरिदम का भी विस्तार से अध्ययन करता है।
बाइनरी सर्च क्या है?
किसी डेटा सेट में किसी मान को खोजते समय, आपका लक्ष्य उसका इंडेक्स या स्थान खोजना होता है ताकि आप अपने कोड में उस मान को आसानी से प्राप्त कर सकें और उपयोग कर सकें। कई सर्च एल्गोरिदम किसी विशिष्ट मान का इंडेक्स ढूंढ़ने में मदद कर सकते हैं। इनमें से सबसे कुशल और मौलिक तरीकों में से एक बाइनरी सर्च है.