

Parlando in generale, un algoritmo è una sequenza precisa di istruzioni che un computer segue per svolgere un compito specifico o risolvere un problema. Dai un'occhiata al nostro post sul blog, What is an Algorithm, per scoprire i tanti tipi diversi di algoritmi nel machine learning.
Panoramica del concetto
La ricerca binaria è un potente algoritmo progettato per trovare in modo efficiente un valore in un dataset ordinato. L'idea di base è semplice: invece di controllare ogni elemento uno per uno, come nella ricerca lineare, la ricerca binaria restringe l'intervallo di ricerca dimezzandolo a ogni passo, rendendo il processo molto più rapido.
Ecco come funziona:
- Inizia confrontando il valore target con l'elemento centrale del dataset. L'indice dell'elemento centrale si calcola con la formula: middle = (low + high) / 2, dove low è l'indice del primo elemento nell'attuale intervallo di ricerca e high è l'indice dell'ultimo elemento.
- Confronta il valore centrale con il target. Se il valore target è uguale all'elemento centrale, hai trovato l'indice e la ricerca è completata. Se il valore target è minore dell'elemento centrale, la ricerca continua nella metà sinistra del dataset. Se è maggiore, continua nella metà destra.
- Ripeti i passaggi 1-2. L'intervallo di ricerca viene continuamente dimezzato a ogni passo. Ripeti il processo finché trovi il valore target o finché l'intervallo di ricerca non diventa vuoto.
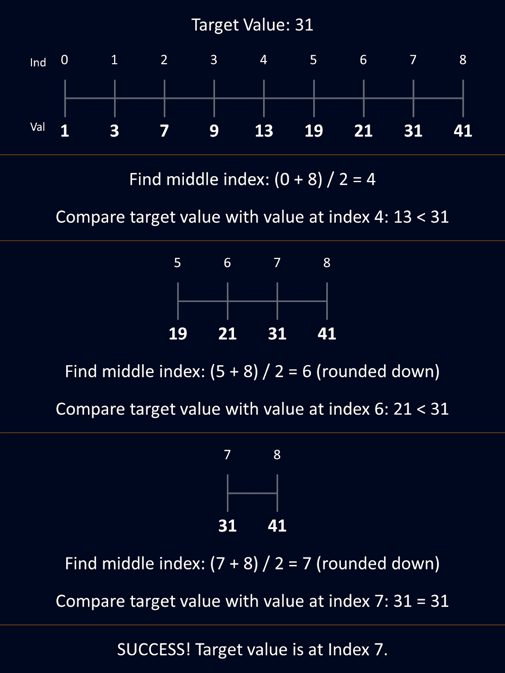
Il processo di ricerca binaria. Immagine dell'autore
Sopra c'è un esempio semplificato che illustra il concetto alla base della ricerca binaria.
Questo processo di dimezzamento è ciò che rende la ricerca binaria così efficiente. Tuttavia, è importante notare che il dataset deve essere ordinato perché la ricerca binaria funzioni correttamente. Se i dati non sono ordinati, l'algoritmo non funzionerà come previsto.
Dai un'occhiata a Data Structures: A Comprehensive Guide With Python Examples per saperne di più sui diversi tipi di strutture dati che potresti voler cercare.
Punti chiave da ricordare
I seguenti punti evidenziano i principi fondamentali della ricerca binaria.
Efficienza
La ricerca binaria è significativamente più veloce della ricerca lineare, soprattutto con dataset di grandi dimensioni. Mentre la ricerca lineare ha una complessità temporale O(n), cioè nel peggiore dei casi può dover controllare ogni singolo elemento, la ricerca binaria è più efficiente. Ha una complessità O(log n), il che significa che lo spazio di ricerca si dimezza a ogni passo, riducendo notevolmente il numero di confronti necessari.
Per un'analisi dettagliata di come vengono valutati gli algoritmi, consulta la nostra guida alla notazione Big O e alla complessità temporale: intuizione e matematica. Un'alternativa è il nostro tutorial Analyzing Complexity of Code through Python.
Requisiti
Perché la ricerca binaria funzioni, il dataset deve essere ordinato in ordine crescente o decrescente. Questo è un requisito perché l'algoritmo si basa sull'ordine degli elementi per determinare quale metà del dataset cercare successivamente. Se i dati non sono ordinati, la ricerca binaria non può individuare correttamente il valore target.
Flessibilità
La ricerca binaria può essere implementata con un approccio iterativo o ricorsivo. Il metodo iterativo usa dei cicli per dimezzare ripetutamente l'intervallo di ricerca. Il metodo ricorsivo prevede che la funzione richiami se stessa con un intervallo di ricerca più piccolo. Questa flessibilità si adatta bene a diverse applicazioni.
Applicazioni nel mondo reale
La ricerca binaria è uno strumento potente. La sua efficienza nel restringere rapidamente gli intervalli di ricerca la rende preziosa, soprattutto con dataset di grandi dimensioni in cui prestazioni e velocità sono critiche. Esploriamo alcune applicazioni specifiche e vediamo come la ricerca binaria si confronta con altri algoritmi.
Database
Nei database, la ricerca binaria è spesso usata per localizzare rapidamente record all'interno di campi ordinati, ad esempio per trovare un utente specifico in un database ordinato per ID utente. Immagina un database con milioni di record. Una ricerca lineare richiederebbe di esaminare ogni record uno per uno, con tempi considerevoli. Invece, la ricerca binaria può individuare rapidamente il record desiderato dimezzando sistematicamente lo spazio di ricerca, riducendo sensibilmente il numero di confronti necessari.
Data science
Cercare in grandi dataset ordinati è un compito comune nella data science. Per esempio, nell'analisi delle serie temporali, la ricerca binaria può essere usata per trovare timestamp specifici all'interno di una sequenza ordinata di eventi. Nel machine learning, algoritmi di ricerca binaria possono essere usati per ottimizzare gli iperparametri trovando il valore migliore in un intervallo.
Computer grafica
Nella computer grafica, la ricerca binaria è utilizzata in algoritmi che richiedono precisione e velocità. Un esempio è il ray tracing, una tecnica di rendering usata per simulare l'interazione della luce con gli oggetti. La ricerca binaria può essere usata per trovare rapidamente i punti di intersezione tra raggi e superfici.
Mattoni per algoritmi complessi
La ricerca binaria non è utile solo da sola; funge anche da mattone per algoritmi e strutture dati più complessi. Per esempio, gli alberi di ricerca, come i binary search tree (BST), e gli alberi bilanciati, come gli AVL tree, si basano sui principi della ricerca binaria. Queste strutture consentono ricerche, inserimenti e cancellazioni efficienti, risultando utili quando i dati devono essere aggiornati dinamicamente e cercati di frequente. Scopri di più su questi alberi in AVL Tree: Complete Guide With Python Implementation.
Ricerca binaria vs. altri algoritmi di ricerca
Vediamo come la ricerca binaria si confronta con altri due algoritmi di ricerca comuni: la ricerca lineare e la ricerca tramite hash.
Ricerca lineare
La ricerca lineare è un algoritmo semplice che esamina ogni elemento di un dataset in sequenza. È significativamente meno efficiente della ricerca binaria, con una complessità O(n). Tuttavia, la ricerca lineare non richiede che i dati siano ordinati, il che la rende utile in alcuni scenari.
Hash lookup
La ricerca tramite hash è un algoritmo efficiente usato per trovare rapidamente valori in un dataset quando quei valori sono associati a chiavi uniche. Funziona applicando una funzione di hash alla chiave, che calcola un indice in cui il valore corrispondente è memorizzato in una tabella hash. Questo consente un recupero quasi istantaneo dei valori, spesso in tempo O(1). Tuttavia, sebbene la ricerca tramite hash sia molto veloce per trovare elementi specifici, richiede memoria aggiuntiva per la tabella hash e non è adatta a cercare all'interno di un intervallo di valori, compito per cui la ricerca binaria è più appropriata.
Implementare la ricerca binaria in Python
Esploriamo alcuni modi per implementare una semplice ricerca binaria in Python. Ma prima, dobbiamo definire un dataset semplice su cui lavorare e un valore target da cercare. Immagina di avere il seguente array ordinato e il target di ricerca:
arr = [2, 5, 8, 12, 16, 23, 38, 56, 72, 91]
target = 56Metodo iterativo
Il metodo iterativo è probabilmente l'approccio più diretto. Con questo metodo, usiamo un ciclo while per dividere ripetutamente a metà l'intervallo di ricerca finché non troviamo il target. Questo metodo è spesso preferito per chiarezza ed efficienza.
Ecco come puoi implementare la ricerca binaria in modo iterativo:
def binary_search_iterative(arr, target):
# Define the search bounds
left, right = 0, len(arr) - 1
while left <= right:
# Calculate the middle index
mid = left + (right - left) // 2
# If the middle element is the target, return its index
if arr[mid] == target:
return mid
# If the target is bigger, narrow the search to the right half
elif arr[mid] < target:
left = mid + 1
# If the target is smaller, narrow the search to the left half
else:
right = mid - 1
# Return -1 if the target is not found
return -1
# Run the iterative function
result = binary_search_iterative(arr, target)
if result != -1:
print(f"Iterative: Target found at index {result}")
else:
print("Iterative: Target not found")Osserviamo più da vicino questo codice:
-
Iniziamo impostando "left" e "right" come limiti dello spazio di ricerca. Inizialmente, left è
0(l'inizio dell'array) e "right" èlen(arr) - 1(la fine dell'array). -
A ogni iterazione, calcoliamo l'indice centrale, che rappresenta il centro dell'intervallo di ricerca corrente. Questo avviene usando la formula
mid = left + (right - left) /2. -
Quindi confrontiamo l'elemento a
midcon iltarget: -
Se coincidono, abbiamo trovato il nostro target e la funzione restituisce
mid. -
Se l'elemento a
midè minore del target, significa che il target deve trovarsi nella metà destra, quindi impostiamoleftamid + 1. -
Se l'elemento a
midè maggiore del target, il target deve trovarsi nella metà sinistra, quindi impostiamorightamid - 1. -
Il ciclo continua finché il target non viene trovato o finché
leftsuperaright, il che significa che il target non è nell'array.
Metodo ricorsivo
Il metodo ricorsivo per la ricerca binaria è un altro modo per implementare questo algoritmo. Invece di usare un ciclo, la funzione richiama se stessa, regolando ogni volta i limiti di ricerca finché non trova il target o determina che il target non è presente.
Ecco come puoi implementare la ricerca binaria in modo ricorsivo:
def binary_search_recursive(arr, target, left, right):
# If the search bounds cross, the target isn't in the array
if left > right:
return -1
# Calculate the middle index
mid = left + (right - left) // 2
# If middle value equals the target, return the index
if arr[mid] == target:
return mid
# If the target is bigger than the middle value, search in the right half
elif arr[mid] < target:
return binary_search_recursive(arr, target, mid + 1, right)
# If the target is smaller than the middle value, search in the left half
else:
return binary_search_recursive(arr, target, left, mid - 1)
# Run the recursive function
result = binary_search_recursive(arr, target, 0, len(arr) - 1)
if result != -1:
print(f"Iterative: Target found at index {result}")
else:
print("Iterative: Target not found")Osserviamo più da vicino questo codice:
-
La funzione ricorsiva inizia con gli stessi limiti iniziali
lefterightdel metodo iterativo. -
Per prima cosa verifica se
leftsuperaright. In tal caso, la funzione restituisce-1, indicando che il target non è nell'array. -
Altrimenti, la funzione calcola l'indice
mide confronta il target con l'elemento inmid. -
Se il target è uguale all'elemento in
mid, la funzione restituiscemid. -
Se il target è maggiore del valore in
mid, la funzione richiama ricorsivamente se stessa con limiti aggiornati per cercare nella metà destra. -
Se il target è minore del valore in
mid, la funzione cerca nella metà sinistra. -
La ricorsione continua finché non trova il target o esaurisce lo spazio di ricerca.
Per saperne di più sulle funzioni ricorsive, dai un'occhiata a Understanding Recursive Functions in Python.
Uso del modulo bisect integrato in Python
La libreria standard di Python include il modulo bisect, che fornisce funzioni di ricerca binaria già implementate. Questo modulo è molto efficiente e spesso può farci risparmiare tempo rispetto a scrivere una funzione da zero.
Ecco come possiamo usare il modulo bisect per trovare il target nel nostro array:
# Import the bisect module
import bisect
# Call the module and provide the array and the target value
index = bisect.bisect_left(arr, target)
#Print results
if index < len(arr) and arr[index] == target:
print(f"Bisect: Target found at index {index}")
else:
print("Bisect: Target not found")Osserviamo più da vicino questo codice:
-
La funzione
bisect_leftrestituisce l'indice in cui il target dovrebbe essere inserito per mantenere l'ordine dell'array. Se il target si trova a questo indice, significa che il target esiste nell'array. -
Questo metodo è particolarmente utile quando si lavora con array ordinati e può essere usato anche per inserire elementi mantenendo l'ordine.
-
Il modulo
bisectfornisce anche altre funzioni comebisect_righteinsort, che possono essere usate per trovare punti di inserimento o inserire elementi direttamente.
Complessità temporale e spaziale
Quando si discute dell'efficienza di un algoritmo, si usa spesso la notazione Big O, rappresentata come O(x), per descrivere come crescono il tempo di esecuzione o i requisiti di memoria all'aumentare della dimensione dell'input. Per la ricerca binaria, la complessità temporale è tipicamente O(log n). Ciò significa che, man mano che il dataset cresce, il numero di operazioni necessarie per trovare il target aumenta in modo logaritmico, rendendo la ricerca binaria efficiente anche per dataset molto grandi.
Il metodo iterativo della ricerca binaria ha una complessità O(log n) perché l'intervallo di ricerca si dimezza a ogni iterazione. La complessità spaziale è O(1) poiché utilizza una quantità costante di spazio extra, richiedendo solo poche variabili per tracciare i limiti di ricerca e l'elemento centrale.
Anche il metodo ricorsivo ha una complessità temporale O(log n) per lo stesso motivo. Tuttavia, la sua complessità spaziale è O(log n) a causa dello spazio necessario per mantenere lo stack delle chiamate per ciascuna chiamata ricorsiva. Poiché ogni chiamata aggiunge un livello allo stack, la profondità della ricorsione è proporzionale al numero di passi di dimezzamento, che è logaritmico rispetto alla dimensione del dataset.
Sebbene entrambi i metodi siano efficienti in termini di tempo, l'approccio iterativo è più efficiente in termini di spazio. Per questo motivo il modulo bisect usa sotto il cofano un approccio iterativo. Personalmente, preferisco anche l'approccio iterativo per questo motivo. Tuttavia, l'approccio ricorsivo può risultare più intuitivo per alcune persone e può richiedere meno righe di codice.
Errori comuni e come evitarli
Quando usi una ricerca binaria, ci sono alcuni errori comuni a cui prestare attenzione. Questi possono influire sulla correttezza e sull'efficienza dell'algoritmo, quindi è importante tenerli a mente.
Innanzitutto, la ricerca binaria si basa sul fatto che il dataset sia ordinato. Se i dati non sono ordinati, la ricerca binaria non funzionerà correttamente; potrebbe restituire risultati errati o fallire del tutto. Pertanto, è essenziale ordinare il dataset prima di applicare la ricerca binaria. Se non è possibile ordinare i dati, la ricerca binaria non è lo strumento appropriato.
Un problema frequente è rappresentato dagli errori di uno fuori. Questi errori si verificano quando i calcoli degli indici sono leggermente errati, portando potenzialmente a cicli infiniti o al mancato rilevamento del valore target. Può accadere se il calcolo del punto medio o l'aggiornamento dei limiti non sono gestiti con precisione. Per evitarlo, assicurati che i calcoli dell'indice centrale siano corretti e che i limiti vengano aggiornati correttamente dopo ogni confronto. Ricorda, in Python gli indici partono da 0, non da 1.
Un'altra sfida da considerare, se usi la ricerca binaria in modo ricorsivo, sono i problemi di profondità di ricorsione. In Python c'è un limite al numero di chiamate ricorsive consentite, per evitare un uso eccessivo di memoria. Se il tuo dataset è molto grande, una ricorsione profonda potrebbe superare questo limite, causando uno stack overflow. Per mitigarne il rischio, considera l'uso dell'approccio iterativo, che non soffre di limiti di profondità. Se la ricorsione è preferita o necessaria, potresti aumentare il limite con sys.setrecursionlimit(), ma fallo con cautela per evitare altri potenziali problemi.
Conclusione
La ricerca binaria è un algoritmo potente ed efficiente che dovrebbe far parte della cassetta degli attrezzi di ogni sviluppatore Python. Che sia implementata in modo iterativo o ricorsivo, offre un notevole vantaggio prestazionale rispetto alla ricerca lineare, soprattutto con dataset di grandi dimensioni. Per approfondire, dai un'occhiata allo skill track Python Programming di DataCamp o al corso interattivo Software Engineering Principles in Python.
Sono un PhD con 13 anni di esperienza nel lavoro con i dati in un contesto di ricerca biologica. Creo software in diversi linguaggi di programmazione, tra cui Python, MATLAB e R. Sono appassionato di condividere con il mondo il mio amore per l’apprendimento.
Domande frequenti sulla ricerca binaria
In quali scenari reali la ricerca binaria potrebbe essere inefficiente?
Quando i dati non sono ordinati o vengono aggiornati frequentemente, l'ordinamento può rallentare le operazioni, rendendo la ricerca binaria meno efficiente.
La ricerca binaria può essere utilizzata su strutture dati diverse dagli array, come le liste collegate?
No, perché accedere all'elemento centrale di una lista collegata richiede tempo lineare, annullando la velocità della ricerca binaria.
Come gestisce la ricerca binaria i valori duplicati in un dataset?
La ricerca binaria trova una sola occorrenza. Per trovare tutti i duplicati, servono ricerche aggiuntive per i limiti.
Qual è il vantaggio di usare il modulo bisect in Python invece di scrivere una funzione di ricerca binaria personalizzata?
Il modulo bisect è ottimizzato, affidabile e offre funzionalità aggiuntive come l'inserimento mantenendo il dataset ordinato.



Immagina di giocare a un gioco di indovinelli in cui devi trovare un numero specifico tra 1 e 100. Potresti provare a indovinare a caso, ma nel peggiore dei casi potresti aver bisogno di 100 tentativi per arrivare alla risposta corretta.
Un metodo più rapido potrebbe essere scegliere il numero a metà, 50, e chiedere se il numero target è più alto o più basso. Se il tuo numero target è più alto, puoi ignorare tutto ciò che è sotto 50 e ripetere l'operazione con i numeri 51-100. Puoi continuare finché non trovi il numero corretto.
Dimezzando le possibilità ogni volta, arrivi rapidamente al target. Con questo metodo, anche nel peggiore dei casi, basterebbero al massimo 7 tentativi per trovare il numero corretto. Questa strategia è l'essenza della ricerca binaria.
In questa guida, vedremo cos'è la ricerca binaria, le sue applicazioni pratiche e come implementarla in Python con metodi sia iterativi che ricorsivi. Per un corso completo, esplora il nostro corso Data Structures and Algorithms in Python, che approfondisce la ricerca binaria insieme ad altri algoritmi di ricerca comuni e importanti come ricerca lineare, depth first search e breadth first search.
Cos'è la ricerca binaria?
Quando cerchi un valore in un dataset, il tuo obiettivo è trovarne l'indice, o la posizione, così da poter recuperare e usare facilmente quel valore nel tuo codice. Esistono diversi algoritmi di ricerca che possono aiutarti a individuare l'indice di un valore specifico. Uno dei metodi più efficienti e fondamentali è la ricerca binaria.