数据结构既存在于数字世界也存在于物理世界。字典就是数据结构的一个实体示例,其中的数据是按字母顺序组织在书中的词条定义。这种组织方式支持一种特定查询:给定一个单词,就可以查找它的定义。
从本质上讲,数据结构是一种组织数据的方法,使之便于在该数据上执行特定类型的查询和操作。
我们将从线性数据结构开始,例如数组、列表、队列和栈。然后回到线性与非线性结构的区别,再深入介绍哈希表、树和图。
如果您想进一步学习,请查看这门关于Python 中的数据结构与算法的课程。
数组
数组是各类编程语言中广泛可用的基础数据结构。它们允许在内存中顺序存储固定数量(N)的值。
数组元素的索引从第一个元素的索引(0)到最后一个元素的索引(N-1)。
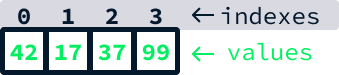
它们支持以下操作:
- 读取给定索引处的值。
- 更新给定索引处的值。
- 遍历所有已存储的值。
- 获取数组的大小。
当需要存储的值的数量事先已知,且主要操作是在特定索引进行读写时,数组非常高效。
设想这样一个场景:您需要存储 12 月的每日气温读数。您可能希望让用户检索某一天的气温,并对整个月的气温进行各种统计分析。
由于 12 月的天数事先已知为 31,数组是存储气温读数的绝佳选择。最初可以创建一个具有 31 个空位置的数组。然后,在获得每次读数后,将对应日期的气温赋给相应的数组索引:第 1 天存于索引 0,第 2 天存于索引 1,如此类推,直到第 31 天存于索引 30。
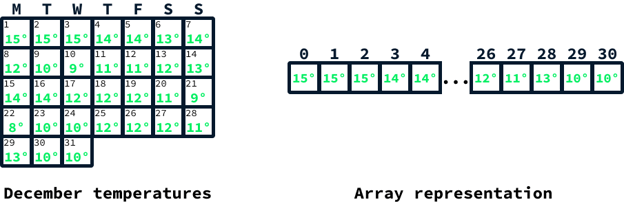
通过访问相应索引即可检索某一天的气温。统计值(如平均气温)可以通过遍历所有元素、维护一个累计和,然后除以数组大小来计算。
Python 并不原生提供数组。数组在幕后作为多种数据类型的底层结构使用,但在语言层面并不直接支持。若要显式使用数组,可以利用诸如 array 等库,它们提供数组实现。不过,在许多需要数组的场景中,使用固定大小的列表往往更实用。列表更灵活,也是 Python 核心功能的一部分,我们接下来会讨论。
我们可以用 [None] * 31 创建一个列表,模拟一个包含 31 个元素的数组,每个元素初始化为 None。这里的 None 表示尚未记录任何气温读数。
december_temperatures = [None] * 31技术支持
要设置特定索引处的值,我们使用 december_temperatures[index],其中 index 的取值为 0 到 30。例如,要记录第一天(存于索引 0)的气温,可以这样做:
december_temperatures[0] = 15技术支持
访问某一天的气温同样很简单,使用 december_temperatures[index] 即可。
print(december_temperatures[0])技术支持
15技术支持
列表
现在设想一下,我们不再只关注 12 月,而是在某处安装一个传感器,在不确定的时间段内定期记录气温。在这种情况下,数组并不是最佳选择,因为由于其在创建时大小固定,可能会出现空间不足的问题。
在这种场景中,更合适的数据结构是列表。列表有两种类型:
数组列表
数组列表可以看作是数组的更灵活版本。它们能完成数组的所有功能,还能追加新值,因此创建时大小并不固定。Python 中的 list() 就对应数组列表。
其实现依赖于在空间用尽时扩容底层数组,因此被称为数组列表。但我们前面提到,数组本身无法增长,那这是如何实现的呢?
当数组列表的底层数组已满且我们想追加新值时,系统会在幕后创建一个更大的数组。之前的所有值都会被复制到这个新的更大数组中,然后新值会被添加到新数组中第一个可用位置。
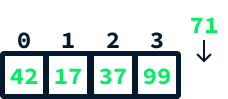
设想我们想把数值 71 追加到这个数组中:
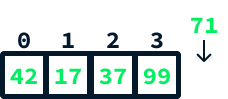
可以像下面这样完成:
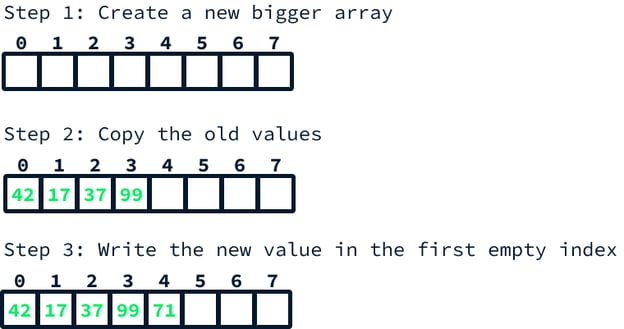
每次进行该操作时新分配的空间大小对数组列表的性能至关重要。如果每次追加都只创建一个仅容纳新值的数组位置,就意味着每次追加操作都需要复制全部已有数据。这将非常低效——想象一下仅为添加一个新记录就要复制数百万条记录。
因此,常见策略是每次需要更多空间时将数组大小翻倍。可以证明,随着时间推移,这种做法能抵消这些额外复制步骤的影响。
在 Python 中向列表添加元素,我们使用 .append() 方法。下面是创建一个空列表并添加一条气温读数的示例:
temperatures = []
temperatures.append(35)技术支持
链表
在计算机中组织数据,我们需要一种将各个值相互关联的方式。数组通过分配连续的内存位置(即彼此紧邻的内存位置)并顺序存储值来实现。可以把它想象成街道上一排房屋:每套房都有唯一地址(索引),并且它们在物理上彼此相邻。
然而,这并不是组织数据的唯一方法。另一种方法是使用基于节点的结构。
节点是一个对象,它存储一个值以及指向其他节点的引用。例如,为了用节点创建类似列表的结构,我们可以让一个节点同时保存一个值和对列表中下一个元素的引用。在 Python 中,可以用一个类来实现:
class Node:
    def __init__(self, value, next_node):
        self.value = value
        self.next_node = next_node技术支持
采用这种方式,可以通过 next_node 引用将各个值连接起来,从而创建一个列表。以下代码片段创建了一个包含值 42、17 和 37 的列表:
node_37 = Node(37, None)
node_17 = Node(17, node_37)
node_42 = Node(42, node_17)技术支持
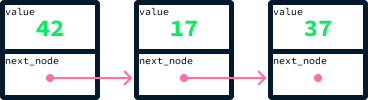
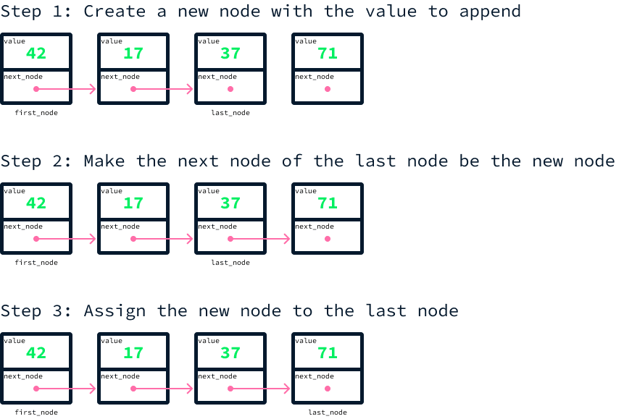
像这样手动链接节点并不实际。真正的实现需要再创建一个类来维护对列表首节点和尾节点的引用。要追加一个新值,我们需:
- 创建一个包含目标值的节点。
- 将该新节点设为当前尾节点的下一个节点。
- 将尾节点的引用更新为这个新添加的节点。
设想我们想把数值 71 追加到示例数组中:
可以像下面这样完成:
class LinkedList:
    def __init__(self):
        self.first_node = None
        self.last_node = None

    def append(self, value):
        node = Node(value, None)
        if self.first_node is None:
            self.first_node = node
            self.last_node = node
        else:
            self.last_node.next_node = node
            self.last_node = node技术支持
与数组列表不同,我们无法通过索引直接访问值。要读取某个索引处的值,必须从首节点开始,依次从一个节点移动到下一个节点,直到到达目标索引。这个过程远比直接访问慢。如果列表中存有数百万个值,就需要在内存中读取数百万个值才能到达特定索引。
链表的优势在于,我们可以在列表头部或尾部即时添加和删除元素。这一能力使我们能够实现两种新数据结构:队列和栈,我们接下来会讨论。
队列
想象您正在开发一款餐厅应用,用于记录顾客点单并将订单发送到后厨。顾客到达餐厅时会排队下单,并期望按到达顺序被服务。这意味着排在第一位的顾客应先拿到餐品,最后一位的顾客应最后拿到。
在后厨,厨师更倾向于一次只专注一个订单,因此应用应仅显示当前订单。一旦订单完成并送出,队列中的下一个订单应被显示。
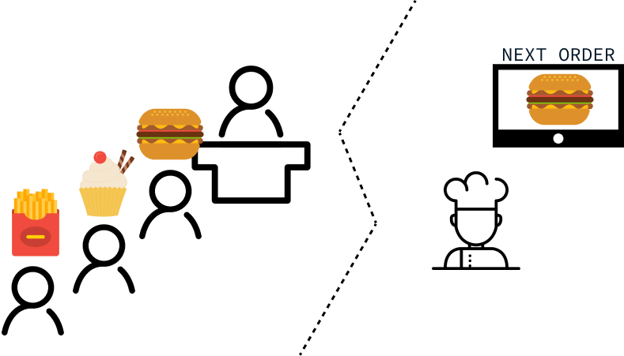
我们可以将上述需求理解为需要一种支持以下操作的数据结构:
- 添加元素。
- 查看最先添加的元素。
- 移除最先添加的元素。
这些操作正是队列提供的功能。队列可以用链表实现,其中元素通过追加的方式添加到列表中。由于元素按到达时间排序,首节点始终是下一个应被处理的节点。
以下是如何在队列中存储上述订单:
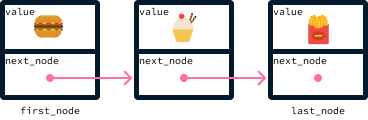
订单完成后,可以通过将首元素更新为其 next_node(假设存在后继节点)来删除它。新的首节点就变成原来的第二个节点:
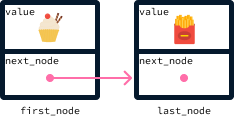
队列被称为先进先出(FIFO)数据结构,因为最先被添加的元素也将最先被移除。在我们的餐厅示例中,第一个到达的顾客也是第一个被服务的(并从厨师的列表中移除)。
在 Python 中要使用队列,我们可以利用 collections 模块中的 deque 集合。如下所示导入该模块并创建一个空队列:
from collections import deque
orders = deque()技术支持
使用 .append() 方法可以在队列尾部添加新元素:
orders.append("burger")
orders.append("sunday")
orders.append("fries")技术支持
要从队列头部检索并移除下一个订单,我们使用 .popleft() 方法:
orders.append("burger")
orders.append("sunday")
orders.append("fries")技术支持
burger
sunday
fries技术支持
栈
在某些情境中,我们希望得到与队列相反的行为——我们更关注最近添加的元素。
例如,设想您需要为一款图像编辑器添加撤销功能。这需要一种方法来跟踪用户操作,并能访问最近的操作。这是因为撤销通常从最后执行的操作开始逆向回退。
栈正是支持以下操作的数据结构:
- 添加元素。
- 查看最后添加的元素。
- 移除最后添加的元素。
与队列类似,栈也可以用链表实现。添加元素仍然通过将元素追加到列表来完成。但此时我们关注的是列表的最后一个元素而非第一个。要获取最近的元素,我们查看列表的最后一个元素。要删除最后一个元素,我们需要将其删除。
在我们的节点结构中,我们只追踪下一个节点。为便于删除最后一个元素,我们需要访问其前一个元素,删除该元素的 next_node,并将其提升为新的末尾节点。我们可以通过修改节点结构,使每个节点同时追踪前一个节点来实现。这种链表称为双向链表。
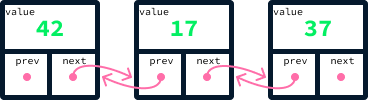
栈被称为后进先出(LIFO)数据结构,因为最后添加的元素也将最先被移除。
在 Python 中使用栈,我们可以继续使用同一个 deque 集合。我们使用 .append() 方法来添加新元素:
from collections import deque
actions = deque()

actions.append("crop")
actions.append("desaturate")
actions.append("resize")技术支持
要从栈顶检索并移除下一个操作,我们使用 .pop() 方法:
print(actions.pop())
print(actions.pop())
print(actions.pop())技术支持
resize
desaturate
crop技术支持
线性与非线性数据结构
到目前为止,我们已经探讨了五种数据结构:数组、数组列表、链表、队列和栈。它们都是线性数据结构,因为其元素按序排列,每个元素都有明确的前驱和后继。
接下来,我们将把注意力转向非线性数据结构。与线性类型不同,这些结构不会以线性方式把元素彼此相邻地组织起来。因此,它们没有明确的前后元素概念,而是为元素之间建立不同类型的关系。
这一特性使它们更适合以高效率执行针对数据的特定查询,而不仅仅是作为将数据存入内存的一种手段。
哈希表
我们在本文开头通过现实中的字典示例讨论了数据结构。事实证明,将数据按某个特定字段组织以便查找(例如给定单词查找定义)在一般情况下非常有用,因此计算机科学家也发明了支持这一点的数据结构。
为理解这种数据结构,让我们看看如何创建一个虚拟字典——也就是一种数据结构,我们可以:
- 添加一个单词及其定义。
- 给定一个单词,查找它的定义。
回想记录 12 月气温的例子。我们用一个包含 31 个元素的数组来对应每一天,将气温存于相应的索引中。这种方法能高效地查找任意一天的气温。
这个场景类似于处理数据对(day,temperature),目标是通过指定 day 来检索 temperature。同样地,在字典的情形中,我们处理的是(word,definition)的数据对,并希望在给定 word 时找到其 definition。
这样的对被称为键值对或条目。键是用于查找查询的参数,值是该查询的结果。
| |
key
|
value
|
|
12 月气温问题
|
day
|
temperature
|
|
字典问题
|
word
|
definition
|
我们之所以不能用数组来解决字典问题,是因为我们的键是字符串而不是数字。对于数字键,我们可以直接用数组通过把值放在相应的索引位置来关联键和值。
为解决这个问题,我们首先需要把单词转换为数字。执行这种转换的函数称为哈希函数。创建这种函数的方法很多。例如,我们可以为字母分配数值,a 为 1、b 为 2、c 为 3,以此类推,然后对这些值求和。
例如,单词 data 会计算为 4 + 1 + 20 + 1 = 26。不过,这个函数有其缺点,我们稍后会讨论。如何设计一个有效的哈希函数超出了本文范围,但 Python 方便地提供了 hash() 函数来高效处理这一任务。
hash("data")技术支持
-6138587229816301269技术支持
在上述示例中,您可能注意到哈希函数产生了一个负数。需要注意的是,数组的正索引范围是 0 到 N - 1。一旦我们把键转换成了数字,就可以使用取模运算符 % 将它们映射到 0 到 N - 1 的范围(取模会输出除法的余数——例如,10 % 3 输出 1)。
顺带一提,Python 的 hash() 函数在不同程序执行间可能返回不同的值。它只在同一次程序运行中是确定的,这意味着如果多次执行程序,您可能会看到同一对象的哈希值不同。
设想一个包含 100 个元素的数组。要定位字符串 "data" 对应的索引,我们可以这样做:
hash("data") % 100技术支持
31技术支持
哈希表数据结构本质上是一个大型数组,它在由哈希函数作用于键所确定的索引处存储键值对。
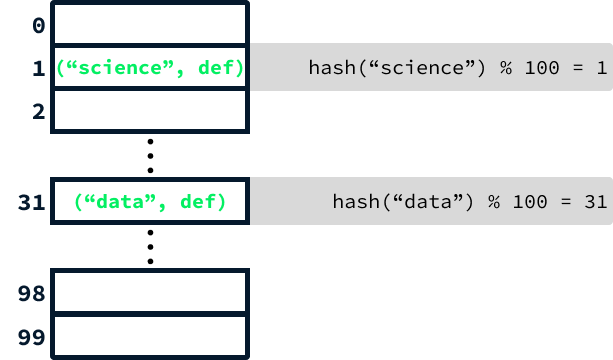
由于空间限制,上图只用缩写 "def" 表示定义。但在实际中,每个条目的第二个元素将是该单词的完整定义。
还有另一个重要方面需要考虑。鉴于单词的数量远超 100,如果我们不断添加单词,不同的单词最终不可避免地会产生相同的哈希值。为解决这个问题,我们不再限制每个数组元素只存放单个键值对,而是用链表来存储具有相同哈希值的所有条目。
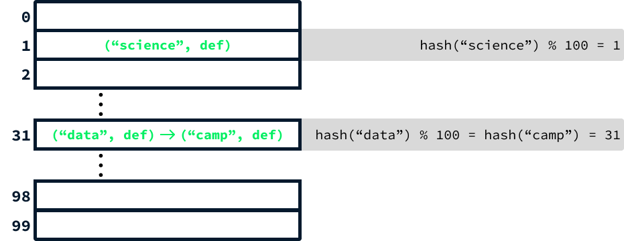
当两个条目产生相同哈希时,这称为碰撞。这会稍微修改查找流程。在计算出哈希码后,需要遍历链表来定位正确的条目。虽然这种方法会让查找稍慢,但可以证明,通过选择足够大的初始数组大小(大于 100)以及设计良好的哈希函数,可以显著减轻碰撞的影响。因此,整体效率仍几乎等同于数组。
对于设计良好的哈希函数,得到相同哈希的不同值应该很少见。这也是为什么简单地将单词中字符的数值相加并非理想的哈希函数。任何由相同字母组成的两个词,不论顺序如何,都会得到相同的哈希码。例如,“listen”和“silent”会产生相同的哈希。相比之下,Python 提供的内置哈希函数要健壮得多,专为最小化碰撞而设计。
哈希表可以说是最重要的数据结构。它们既高效又通用。在 Python 中,哈希表通过 dict() 类实现。由于与字典的相似性,在 Python 中该数据结构实际上被称为字典而非哈希表。
为简明起见,我们的示例聚焦于添加与查找条目。一般而言,字典更灵活,支持包括删除在内的其他操作。要在 Python 中创建一个空字典(哈希表),您可以像这样使用 {}:
word_definitions = {}
word_definitions["data"] = "Facts or information."技术支持
您可以用单词作为键来访问其定义,如下所示:
print(word_definitions["data"])技术支持
Facts or information.技术支持
树
想象您在为一家房地产中介开发网站。您的任务是创建一个按价格筛选房源的功能。该功能应允许用户:
- 找到最便宜的房源。
- 找到最贵的房源。
- 找到所有低于某个价格的房源。
通常,这个过程会涉及遍历所有房源并过滤掉不在目标价格范围内的房子。然而,我们的目标是开发一种更可扩展的解决方案,即无需检查整个数据集就能找到相关房源。树正是回答这类查询的理想数据结构。
树是基于节点的数据结构,类似链表。但与只有前后引用不同,每个节点会保存一个值和两个引用:左节点与右节点。
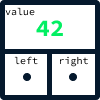
在我们的房地产网站示例中,每个节点表示一个房源。为了优化与价格相关的查询,我们制定一条规则:价格较低的房源总是存放在某个节点的左侧,价格较高的房源总是存放在右侧。
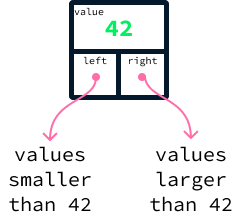
举个具体例子,考虑下图这棵树,包含值 42、17、73、4、22 和 89。
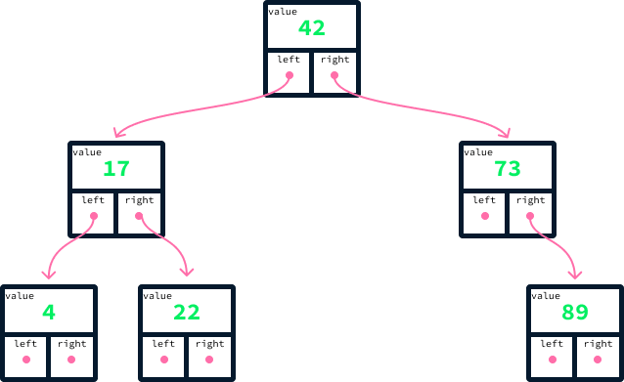
对于每个节点,其左侧所有节点的值都更小,右侧所有节点的值都更大。满足这一性质的树称为二叉搜索树(BST)。之所以称为“二叉”,是因为每个节点最多引用两个其他节点,称为子节点。“搜索”一词则源于左、右子节点的有序性质,使得可以高效地在树中搜索。
我们已经可以看到 BST 如何帮助快速找到最便宜和最贵的房源。由于数值的有序性,最便宜的总是最左侧的节点,最贵的总是最右侧的节点。
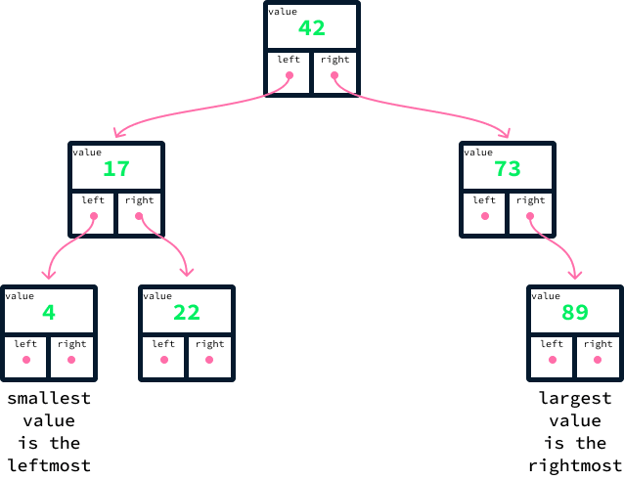
这意味着我们无需检查大多数数据即可定位它们。从顶部节点(也称为根节点)开始,我们持续沿着左链接寻找最小值,沿着右链接寻找最大值。也就是说,只需检查连接根到最小(或最大)节点路径上的那些节点即可。
设想我们想找到所有值至少为 50 的节点。可以按以下步骤进行:
- 从根开始,将目标值
50 与根的值 42 比较。
- 发现
50 更大,于是我们知道根及其左侧的所有节点值都更小,可以忽略。
- 然后移动到根的右侧节点
73。比较发现 50 小于 73。这表明在 73 的右侧的所有节点都满足条件。
- 不过,由于
73 没有左子节点,我们的搜索到此结束。
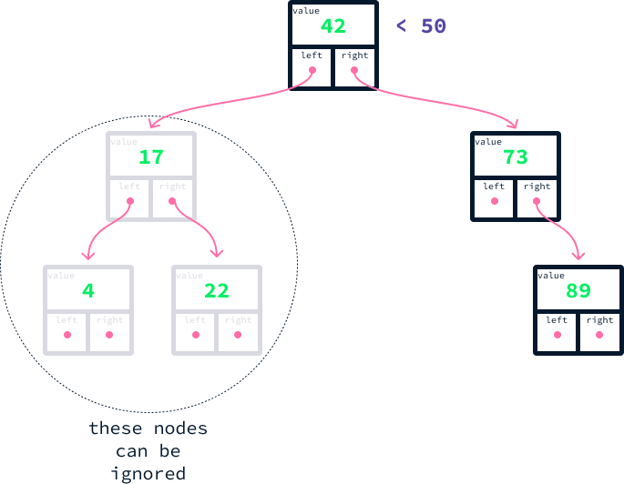
我们已经可以看到,BST 能显著加速查询。即使在这个小例子中,我们也避免了检查一半数据。
一般而言,在 BST 中找出落入给定范围的所有节点,只需检查的节点数量与查询结果数量相近。这相比必须检查每个数据点具有巨大的优势。想象有 1,000,000 条房源,而查询仅返回 10 条结果。使用列表,需要检查一百万条房源以过滤不在范围内的记录。使用 BST,则只需检查约 10 条房源。加速比约为 100,000。
BST 的效率高度依赖树的平衡性。如果我们像之前那样按从小到大顺序添加相同的值——4、17、22、42、73,然后是 89——就可能得到如下不平衡的树:
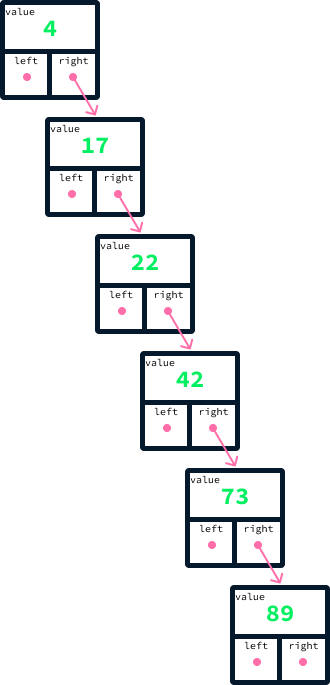
回想一下,在 BST 中查找最大值,我们从根开始一路沿着右链接前进,直到到达没有右链接的节点。在上图这种不平衡的树中,这个过程需要检查每一个节点。理想情况下,我们希望节点在左右两侧均匀分布。至于如何始终如一地实现这种平衡,超出了本文范围。以保持平衡著称的一种二叉搜索树称为 AVL 树。
avltree 包提供了 AVL 树的实现。下面的代码片段展示了如何在这个房源数据集上使用它,这是 美国房地产数据集的一个清洗子集。
import csv
from avltree import AvlTree as Tree
with open("listings.csv", "rt") as f:
reader = csv.reader(f)
listings = list(reader)
tree = Tree()
for listing in listings[1:]:
price = float(listing[2])
tree[price] = listing
print("Cheapest:", tree.minimum())
print("Most expensive:", tree.maximum())
listings_in_range = list(tree.between(100000, 110000))
print("Num listings between 100000 and 110000:", len(listings_in_range))技术支持
Cheapest: 50017.0
Most expensive: 19999900.0
Num listings between 100000 and 110000: 403技术支持
我们首先使用 csv 模块读取 listings.csv 数据集。随后,我们基于价格列创建 AVL 树。然后使用 minimum()、maximum() 和 between() 方法来确定最低价、最高价以及价格在 100,000 到 110,000 美元之间的房源数量。
图
本文要介绍的最后一种数据结构是图。
假设您在分析某社交媒体平台的数据。这些数据包含用户列表以及他们之间的好友关系,您的目标是识别社交网络中的社群。尽管社群的定义有多种方式,但通常指的是彼此之间拥有大量好友关系的一组用户。
当我们拥有若干实体以及这些实体两两之间的关系时,图是表示数据的理想数据结构。在我们的示例中,实体是用户,关系是他们之间的好友关系。
图是基于节点的结构。然而,不同于链表和树那样在节点之间呈现线性或层级关系,图允许任意节点与多个其他节点相连。节点之间的这些连接称为边,用于表示它们之间的关系。
在我们的社交网络示例中,每位用户都可以被可视化为一个节点。可以在两个节点之间画一条边,以表示相应用户之间的好友关系。
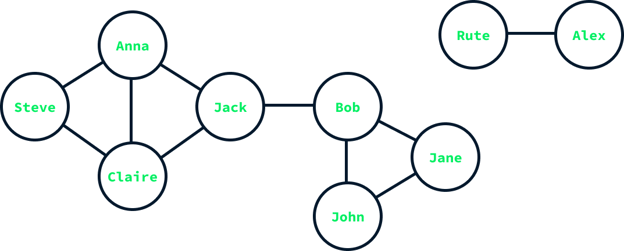
上图展示了一个表示小型社交网络中好友关系的图。节点代表用户,并用他们的名字标注,边代表好友关系。例如,Anna 与 Steve、Claire 和 Jack 是朋友,因此她的节点与这些人的节点之间都有边相连。
图数据结构应支持的操作包括:
- 添加新节点。
- 用一条边连接两个节点。
- 检索与某个特定节点相连的所有节点。
实现图的一种常见方式是使用哈希表和列表。创建一个哈希表,为每个节点建立一个条目。每个条目的键是节点本身,值是一个列表,包含与该节点相连的所有节点。
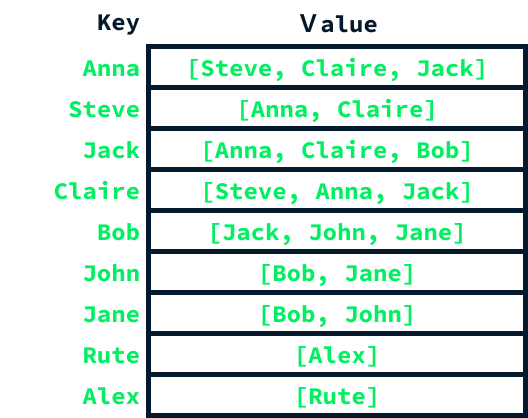
networkx 包提供了在 Python 中创建和操作图的实现。此外,networkx 库还包含了大量图算法,包括社群检测算法。让我们用它来构建前面提到的图,并应用一种常见的社群检测算法来观察结果。
开始创建图时,我们先导入 networkx 库并初始化一个空图:
import networkx as nx
G = nx.Graph()技术支持
可以使用 add_node() 方法添加节点。
G.add_node("Anna")
G.add_node("Steve")
G.add_node("Jack")
G.add_node("Claire")
G.add_node("Bob")
G.add_node("Jane")
G.add_node("John")
G.add_node("Rute")
G.add_node("Alex")技术支持
可以使用 add_edge() 方法添加边。
G.add_edge("Anna", "Steve")
G.add_edge("Anna", "Jack")
G.add_edge("Anna", "Claire")
G.add_edge("Steve", "Claire")
G.add_edge("Claire", "Jack")
G.add_edge("Jack", "Bob")
G.add_edge("Bob", "John")
G.add_edge("Bob", "Jane")
G.add_edge("John", "Jane")
G.add_edge("Rute", "Alex")技术支持
创建好图之后,我们可以计算其中的社群。社群检测有多种算法可用,在这个例子中,我们将使用 Louvain 方法。社群检测算法位于 networkx 的 community 子包中。具体来说,我们将使用 louvain_communities() 函数。
使用方法如下:
communities = nx.community.louvain_communities(G)
print(communities)技术支持
[{'Jack', 'Claire', 'Anna', 'Steve'}, {'Bob', 'John', 'Jane'}, {'Rute', 'Alex'}]技术支持
输出是一个集合列表,每个集合代表一个社群。我们可以看到该算法检测到了三个社群,这与图的结构相符。
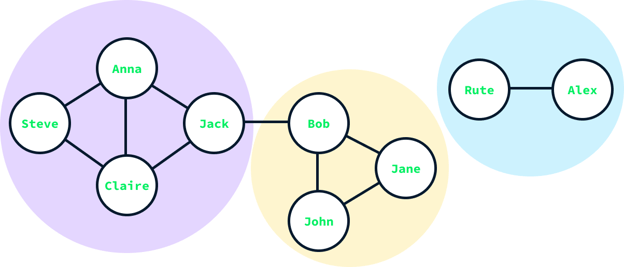
想进一步了解图,请学习如何实现Python 中的 Dijkstra 算法。
选择合适的数据结构
在介绍每种数据结构时,我们都列举了其支持的操作。这些操作为何时使用该数据结构提供了指南,因为它正是为高效执行这些操作而设计的。
例如,Python 的 list() 也支持诸如删除元素等其他操作。然而,这些额外操作并非数组列表的强项。具体而言,从列表中间删除一个元素需要将所有数据(除了被删除的元素)复制到一个新列表中,这会非常耗时。
当数据天然以数字索引且条目数量已知(例如一个月的天数)时,数组通常是首选。对于更通用的索引方式或动态数据集,字典是很好的替代方案。
当需要按顺序一次处理一个数据项时,根据期望的处理顺序,常使用队列或栈。
当我们想对数据执行更复杂的查询(如查找落入给定范围内或极值的所有条目)时,通常选择树。
最后,当数据点之间存在成对关系时,图是存储和表示这些关系的有效方式。各种图算法可以帮助我们回答这类具备成对关系的数据集中的常见问题。
数据结构是一个广阔的领域,而我们只涉及了冰山一角。在某些情况下,解决方案是设计一个完全针对手头问题量身定制的全新数据结构。不过,熟悉本文讨论的数据结构,应该能在解决与数据相关的问题时为您指明方向。
结语
本文中,我们了解到数据结构是以特定格式组织数据的方法,以便高效地检索信息。
数据结构大体分为两类:基于数组的结构(例如哈希表)和基于节点的结构(例如图)。
线性结构(如数组、队列和栈)将元素按顺序一个接一个地组织起来。相对地,非线性结构(如哈希表、树和图)则根据数据内部的关系来组织数据。
选择合适的数据结构取决于要执行的查询的性质。
如果您想了解 Python 中的各种数据结构,请查看这篇关于Python 数据结构的教程。


数据结构既存在于数字世界也存在于物理世界。字典就是数据结构的一个实体示例,其中的数据是按字母顺序组织在书中的词条定义。这种组织方式支持一种特定查询:给定一个单词,就可以查找它的定义。
从本质上讲,数据结构是一种组织数据的方法,使之便于在该数据上执行特定类型的查询和操作。
我们将从线性数据结构开始,例如数组、列表、队列和栈。然后回到线性与非线性结构的区别,再深入介绍哈希表、树和图。
如果您想进一步学习,请查看这门关于Python 中的数据结构与算法的课程。
数组
数组是各类编程语言中广泛可用的基础数据结构。它们允许在内存中顺序存储固定数量(N)的值。
数组元素的索引从第一个元素的索引(0)到最后一个元素的索引(N-1)。
它们支持以下操作:
当需要存储的值的数量事先已知,且主要操作是在特定索引进行读写时,数组非常高效。
设想这样一个场景:您需要存储 12 月的每日气温读数。您可能希望让用户检索某一天的气温,并对整个月的气温进行各种统计分析。
由于 12 月的天数事先已知为 31,数组是存储气温读数的绝佳选择。最初可以创建一个具有 31 个空位置的数组。然后,在获得每次读数后,将对应日期的气温赋给相应的数组索引:第 1 天存于索引 0,第 2 天存于索引 1,如此类推,直到第 31 天存于索引 30。
通过访问相应索引即可检索某一天的气温。统计值(如平均气温)可以通过遍历所有元素、维护一个累计和,然后除以数组大小来计算。
Python 并不原生提供数组。数组在幕后作为多种数据类型的底层结构使用,但在语言层面并不直接支持。若要显式使用数组,可以利用诸如 array 等库,它们提供数组实现。不过,在许多需要数组的场景中,使用固定大小的列表往往更实用。列表更灵活,也是 Python 核心功能的一部分,我们接下来会讨论。
我们可以用
[None] * 31创建一个列表,模拟一个包含 31 个元素的数组,每个元素初始化为 None。这里的None表示尚未记录任何气温读数。要设置特定索引处的值,我们使用
december_temperatures[index],其中index的取值为0到30。例如,要记录第一天(存于索引0)的气温,可以这样做:访问某一天的气温同样很简单,使用
december_temperatures[index]即可。列表
现在设想一下,我们不再只关注 12 月,而是在某处安装一个传感器,在不确定的时间段内定期记录气温。在这种情况下,数组并不是最佳选择,因为由于其在创建时大小固定,可能会出现空间不足的问题。
在这种场景中,更合适的数据结构是列表。列表有两种类型:
数组列表
数组列表可以看作是数组的更灵活版本。它们能完成数组的所有功能,还能追加新值,因此创建时大小并不固定。Python 中的
list()就对应数组列表。其实现依赖于在空间用尽时扩容底层数组,因此被称为数组列表。但我们前面提到,数组本身无法增长,那这是如何实现的呢?
当数组列表的底层数组已满且我们想追加新值时,系统会在幕后创建一个更大的数组。之前的所有值都会被复制到这个新的更大数组中,然后新值会被添加到新数组中第一个可用位置。
设想我们想把数值 71 追加到这个数组中:
可以像下面这样完成:
每次进行该操作时新分配的空间大小对数组列表的性能至关重要。如果每次追加都只创建一个仅容纳新值的数组位置,就意味着每次追加操作都需要复制全部已有数据。这将非常低效——想象一下仅为添加一个新记录就要复制数百万条记录。
因此,常见策略是每次需要更多空间时将数组大小翻倍。可以证明,随着时间推移,这种做法能抵消这些额外复制步骤的影响。
在 Python 中向列表添加元素,我们使用
.append()方法。下面是创建一个空列表并添加一条气温读数的示例:链表
在计算机中组织数据,我们需要一种将各个值相互关联的方式。数组通过分配连续的内存位置(即彼此紧邻的内存位置)并顺序存储值来实现。可以把它想象成街道上一排房屋:每套房都有唯一地址(索引),并且它们在物理上彼此相邻。
然而,这并不是组织数据的唯一方法。另一种方法是使用基于节点的结构。
节点是一个对象,它存储一个值以及指向其他节点的引用。例如,为了用节点创建类似列表的结构,我们可以让一个节点同时保存一个值和对列表中下一个元素的引用。在 Python 中,可以用一个类来实现:
采用这种方式,可以通过
next_node引用将各个值连接起来,从而创建一个列表。以下代码片段创建了一个包含值42、17和37的列表:像这样手动链接节点并不实际。真正的实现需要再创建一个类来维护对列表首节点和尾节点的引用。要追加一个新值,我们需:
设想我们想把数值
71追加到示例数组中:可以像下面这样完成:
与数组列表不同,我们无法通过索引直接访问值。要读取某个索引处的值,必须从首节点开始,依次从一个节点移动到下一个节点,直到到达目标索引。这个过程远比直接访问慢。如果列表中存有数百万个值,就需要在内存中读取数百万个值才能到达特定索引。
链表的优势在于,我们可以在列表头部或尾部即时添加和删除元素。这一能力使我们能够实现两种新数据结构:队列和栈,我们接下来会讨论。
队列
想象您正在开发一款餐厅应用,用于记录顾客点单并将订单发送到后厨。顾客到达餐厅时会排队下单,并期望按到达顺序被服务。这意味着排在第一位的顾客应先拿到餐品,最后一位的顾客应最后拿到。
在后厨,厨师更倾向于一次只专注一个订单,因此应用应仅显示当前订单。一旦订单完成并送出,队列中的下一个订单应被显示。
我们可以将上述需求理解为需要一种支持以下操作的数据结构:
这些操作正是队列提供的功能。队列可以用链表实现,其中元素通过追加的方式添加到列表中。由于元素按到达时间排序,首节点始终是下一个应被处理的节点。
以下是如何在队列中存储上述订单:
订单完成后,可以通过将首元素更新为其
next_node(假设存在后继节点)来删除它。新的首节点就变成原来的第二个节点:队列被称为先进先出(FIFO)数据结构,因为最先被添加的元素也将最先被移除。在我们的餐厅示例中,第一个到达的顾客也是第一个被服务的(并从厨师的列表中移除)。
在 Python 中要使用队列,我们可以利用
collections模块中的deque集合。如下所示导入该模块并创建一个空队列:使用
.append()方法可以在队列尾部添加新元素:要从队列头部检索并移除下一个订单,我们使用
.popleft()方法:栈
在某些情境中,我们希望得到与队列相反的行为——我们更关注最近添加的元素。
例如,设想您需要为一款图像编辑器添加撤销功能。这需要一种方法来跟踪用户操作,并能访问最近的操作。这是因为撤销通常从最后执行的操作开始逆向回退。
栈正是支持以下操作的数据结构:
与队列类似,栈也可以用链表实现。添加元素仍然通过将元素追加到列表来完成。但此时我们关注的是列表的最后一个元素而非第一个。要获取最近的元素,我们查看列表的最后一个元素。要删除最后一个元素,我们需要将其删除。
在我们的节点结构中,我们只追踪下一个节点。为便于删除最后一个元素,我们需要访问其前一个元素,删除该元素的 next_node,并将其提升为新的末尾节点。我们可以通过修改节点结构,使每个节点同时追踪前一个节点来实现。这种链表称为双向链表。
栈被称为后进先出(LIFO)数据结构,因为最后添加的元素也将最先被移除。
在 Python 中使用栈,我们可以继续使用同一个
deque集合。我们使用.append()方法来添加新元素:要从栈顶检索并移除下一个操作,我们使用
.pop()方法:线性与非线性数据结构
到目前为止,我们已经探讨了五种数据结构:数组、数组列表、链表、队列和栈。它们都是线性数据结构,因为其元素按序排列,每个元素都有明确的前驱和后继。
接下来,我们将把注意力转向非线性数据结构。与线性类型不同,这些结构不会以线性方式把元素彼此相邻地组织起来。因此,它们没有明确的前后元素概念,而是为元素之间建立不同类型的关系。
这一特性使它们更适合以高效率执行针对数据的特定查询,而不仅仅是作为将数据存入内存的一种手段。
哈希表
我们在本文开头通过现实中的字典示例讨论了数据结构。事实证明,将数据按某个特定字段组织以便查找(例如给定单词查找定义)在一般情况下非常有用,因此计算机科学家也发明了支持这一点的数据结构。
为理解这种数据结构,让我们看看如何创建一个虚拟字典——也就是一种数据结构,我们可以:
回想记录 12 月气温的例子。我们用一个包含 31 个元素的数组来对应每一天,将气温存于相应的索引中。这种方法能高效地查找任意一天的气温。
这个场景类似于处理数据对(
day,temperature),目标是通过指定 day 来检索temperature。同样地,在字典的情形中,我们处理的是(word,definition)的数据对,并希望在给定word时找到其definition。这样的对被称为键值对或条目。键是用于查找查询的参数,值是该查询的结果。
key
value
12 月气温问题
day
temperature
字典问题
word
definition
我们之所以不能用数组来解决字典问题,是因为我们的键是字符串而不是数字。对于数字键,我们可以直接用数组通过把值放在相应的索引位置来关联键和值。
为解决这个问题,我们首先需要把单词转换为数字。执行这种转换的函数称为哈希函数。创建这种函数的方法很多。例如,我们可以为字母分配数值,
a为1、b为2、c为3,以此类推,然后对这些值求和。例如,单词
data会计算为4 + 1 + 20 + 1 = 26。不过,这个函数有其缺点,我们稍后会讨论。如何设计一个有效的哈希函数超出了本文范围,但 Python 方便地提供了hash()函数来高效处理这一任务。在上述示例中,您可能注意到哈希函数产生了一个负数。需要注意的是,数组的正索引范围是 0 到 N - 1。一旦我们把键转换成了数字,就可以使用取模运算符
%将它们映射到 0 到 N - 1 的范围(取模会输出除法的余数——例如,10 % 3输出1)。顺带一提,Python 的
hash()函数在不同程序执行间可能返回不同的值。它只在同一次程序运行中是确定的,这意味着如果多次执行程序,您可能会看到同一对象的哈希值不同。设想一个包含 100 个元素的数组。要定位字符串
"data"对应的索引,我们可以这样做:哈希表数据结构本质上是一个大型数组,它在由哈希函数作用于键所确定的索引处存储键值对。
由于空间限制,上图只用缩写 "def" 表示定义。但在实际中,每个条目的第二个元素将是该单词的完整定义。
还有另一个重要方面需要考虑。鉴于单词的数量远超 100,如果我们不断添加单词,不同的单词最终不可避免地会产生相同的哈希值。为解决这个问题,我们不再限制每个数组元素只存放单个键值对,而是用链表来存储具有相同哈希值的所有条目。
当两个条目产生相同哈希时,这称为碰撞。这会稍微修改查找流程。在计算出哈希码后,需要遍历链表来定位正确的条目。虽然这种方法会让查找稍慢,但可以证明,通过选择足够大的初始数组大小(大于 100)以及设计良好的哈希函数,可以显著减轻碰撞的影响。因此,整体效率仍几乎等同于数组。
对于设计良好的哈希函数,得到相同哈希的不同值应该很少见。这也是为什么简单地将单词中字符的数值相加并非理想的哈希函数。任何由相同字母组成的两个词,不论顺序如何,都会得到相同的哈希码。例如,“listen”和“silent”会产生相同的哈希。相比之下,Python 提供的内置哈希函数要健壮得多,专为最小化碰撞而设计。
哈希表可以说是最重要的数据结构。它们既高效又通用。在 Python 中,哈希表通过
dict()类实现。由于与字典的相似性,在 Python 中该数据结构实际上被称为字典而非哈希表。为简明起见,我们的示例聚焦于添加与查找条目。一般而言,字典更灵活,支持包括删除在内的其他操作。要在 Python 中创建一个空字典(哈希表),您可以像这样使用
{}:您可以用单词作为键来访问其定义,如下所示:
树
想象您在为一家房地产中介开发网站。您的任务是创建一个按价格筛选房源的功能。该功能应允许用户:
通常,这个过程会涉及遍历所有房源并过滤掉不在目标价格范围内的房子。然而,我们的目标是开发一种更可扩展的解决方案,即无需检查整个数据集就能找到相关房源。树正是回答这类查询的理想数据结构。
树是基于节点的数据结构,类似链表。但与只有前后引用不同,每个节点会保存一个值和两个引用:左节点与右节点。
在我们的房地产网站示例中,每个节点表示一个房源。为了优化与价格相关的查询,我们制定一条规则:价格较低的房源总是存放在某个节点的左侧,价格较高的房源总是存放在右侧。
举个具体例子,考虑下图这棵树,包含值
42、17、73、4、22和89。对于每个节点,其左侧所有节点的值都更小,右侧所有节点的值都更大。满足这一性质的树称为二叉搜索树(BST)。之所以称为“二叉”,是因为每个节点最多引用两个其他节点,称为子节点。“搜索”一词则源于左、右子节点的有序性质,使得可以高效地在树中搜索。
我们已经可以看到 BST 如何帮助快速找到最便宜和最贵的房源。由于数值的有序性,最便宜的总是最左侧的节点,最贵的总是最右侧的节点。
这意味着我们无需检查大多数数据即可定位它们。从顶部节点(也称为根节点)开始,我们持续沿着左链接寻找最小值,沿着右链接寻找最大值。也就是说,只需检查连接根到最小(或最大)节点路径上的那些节点即可。
设想我们想找到所有值至少为
50的节点。可以按以下步骤进行:50与根的值42比较。50更大,于是我们知道根及其左侧的所有节点值都更小,可以忽略。73。比较发现50小于73。这表明在73的右侧的所有节点都满足条件。73没有左子节点,我们的搜索到此结束。我们已经可以看到,BST 能显著加速查询。即使在这个小例子中,我们也避免了检查一半数据。
一般而言,在 BST 中找出落入给定范围的所有节点,只需检查的节点数量与查询结果数量相近。这相比必须检查每个数据点具有巨大的优势。想象有 1,000,000 条房源,而查询仅返回 10 条结果。使用列表,需要检查一百万条房源以过滤不在范围内的记录。使用 BST,则只需检查约 10 条房源。加速比约为 100,000。
BST 的效率高度依赖树的平衡性。如果我们像之前那样按从小到大顺序添加相同的值——4、17、22、42、73,然后是 89——就可能得到如下不平衡的树:
回想一下,在 BST 中查找最大值,我们从根开始一路沿着右链接前进,直到到达没有右链接的节点。在上图这种不平衡的树中,这个过程需要检查每一个节点。理想情况下,我们希望节点在左右两侧均匀分布。至于如何始终如一地实现这种平衡,超出了本文范围。以保持平衡著称的一种二叉搜索树称为 AVL 树。
avltree包提供了 AVL 树的实现。下面的代码片段展示了如何在这个房源数据集上使用它,这是 美国房地产数据集的一个清洗子集。我们首先使用
csv模块读取listings.csv数据集。随后,我们基于价格列创建 AVL 树。然后使用minimum()、maximum()和between()方法来确定最低价、最高价以及价格在 100,000 到 110,000 美元之间的房源数量。图
本文要介绍的最后一种数据结构是图。
假设您在分析某社交媒体平台的数据。这些数据包含用户列表以及他们之间的好友关系,您的目标是识别社交网络中的社群。尽管社群的定义有多种方式,但通常指的是彼此之间拥有大量好友关系的一组用户。
当我们拥有若干实体以及这些实体两两之间的关系时,图是表示数据的理想数据结构。在我们的示例中,实体是用户,关系是他们之间的好友关系。
图是基于节点的结构。然而,不同于链表和树那样在节点之间呈现线性或层级关系,图允许任意节点与多个其他节点相连。节点之间的这些连接称为边,用于表示它们之间的关系。
在我们的社交网络示例中,每位用户都可以被可视化为一个节点。可以在两个节点之间画一条边,以表示相应用户之间的好友关系。
上图展示了一个表示小型社交网络中好友关系的图。节点代表用户,并用他们的名字标注,边代表好友关系。例如,Anna 与 Steve、Claire 和 Jack 是朋友,因此她的节点与这些人的节点之间都有边相连。
图数据结构应支持的操作包括:
实现图的一种常见方式是使用哈希表和列表。创建一个哈希表,为每个节点建立一个条目。每个条目的键是节点本身,值是一个列表,包含与该节点相连的所有节点。
networkx包提供了在 Python 中创建和操作图的实现。此外,networkx库还包含了大量图算法,包括社群检测算法。让我们用它来构建前面提到的图,并应用一种常见的社群检测算法来观察结果。开始创建图时,我们先导入
networkx库并初始化一个空图:可以使用
add_node()方法添加节点。可以使用
add_edge()方法添加边。创建好图之后,我们可以计算其中的社群。社群检测有多种算法可用,在这个例子中,我们将使用 Louvain 方法。社群检测算法位于
networkx的community子包中。具体来说,我们将使用louvain_communities()函数。使用方法如下:
输出是一个集合列表,每个集合代表一个社群。我们可以看到该算法检测到了三个社群,这与图的结构相符。
想进一步了解图,请学习如何实现Python 中的 Dijkstra 算法。
选择合适的数据结构
在介绍每种数据结构时,我们都列举了其支持的操作。这些操作为何时使用该数据结构提供了指南,因为它正是为高效执行这些操作而设计的。
例如,Python 的
list()也支持诸如删除元素等其他操作。然而,这些额外操作并非数组列表的强项。具体而言,从列表中间删除一个元素需要将所有数据(除了被删除的元素)复制到一个新列表中,这会非常耗时。当数据天然以数字索引且条目数量已知(例如一个月的天数)时,数组通常是首选。对于更通用的索引方式或动态数据集,字典是很好的替代方案。
当需要按顺序一次处理一个数据项时,根据期望的处理顺序,常使用队列或栈。
当我们想对数据执行更复杂的查询(如查找落入给定范围内或极值的所有条目)时,通常选择树。
最后,当数据点之间存在成对关系时,图是存储和表示这些关系的有效方式。各种图算法可以帮助我们回答这类具备成对关系的数据集中的常见问题。
数据结构是一个广阔的领域,而我们只涉及了冰山一角。在某些情况下,解决方案是设计一个完全针对手头问题量身定制的全新数据结构。不过,熟悉本文讨论的数据结构,应该能在解决与数据相关的问题时为您指明方向。
结语
本文中,我们了解到数据结构是以特定格式组织数据的方法,以便高效地检索信息。
数据结构大体分为两类:基于数组的结构(例如哈希表)和基于节点的结构(例如图)。
线性结构(如数组、队列和栈)将元素按顺序一个接一个地组织起来。相对地,非线性结构(如哈希表、树和图)则根据数据内部的关系来组织数据。
选择合适的数据结构取决于要执行的查询的性质。
如果您想了解 Python 中的各种数据结构,请查看这篇关于Python 数据结构的教程。