
Kurs
Generalisierte lineare Modelle in Python
5 Std.
12K
Allgemein gesprochen ist ein Algorithmus eine präzise Abfolge von Anweisungen, denen ein Computer folgt, um eine bestimmte Aufgabe zu erledigen oder ein Problem zu lösen. Lies unseren Blogpost What is an Algorithm, um mehr über die vielen Algorithmusarten im Machine Learning zu erfahren.
Die binäre Suche ist ein leistungsstarker Algorithmus, der schnell einen Wert in einem sortierten Datensatz findet. Die Idee dahinter ist simpel: Statt wie bei der linearen Suche jedes Element nacheinander zu prüfen, halbiert die binäre Suche den Suchbereich in jedem Schritt – und wird dadurch viel schneller.
So funktioniert’s:
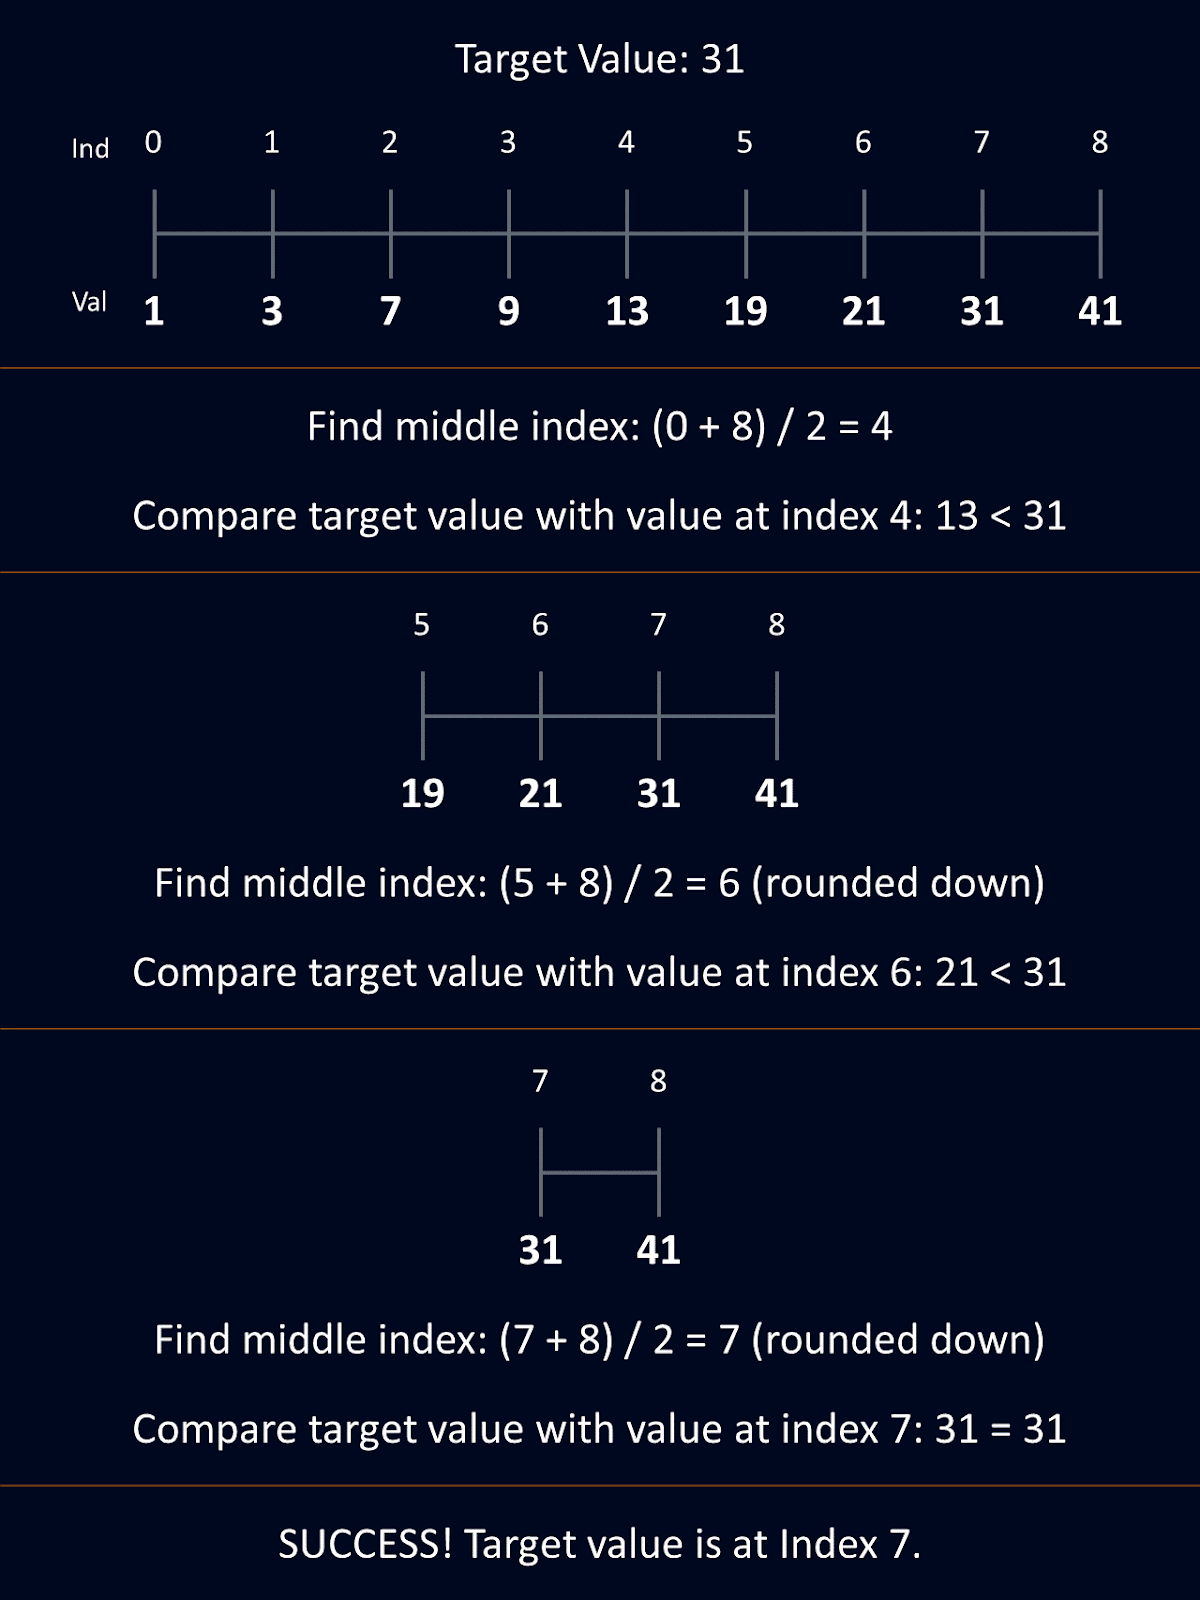
Der Ablauf der binären Suche. Bild: Autorin/Autor
Oben siehst du ein vereinfachtes Beispiel, das das Prinzip der binären Suche zeigt.
Dieses Halbieren macht die binäre Suche so effizient. Wichtig ist aber: Der Datensatz muss sortiert sein, damit die binäre Suche korrekt funktioniert. Ist er nicht sortiert, liefert der Algorithmus nicht die gewünschten Ergebnisse.
Sieh dir auch Data Structures: A Comprehensive Guide With Python Examples an, um mehr über verschiedene Datenstrukturen zu erfahren, in denen du suchen kannst.
Die folgenden Punkte fassen die Kernprinzipien der binären Suche zusammen.
Die binäre Suche ist deutlich schneller als die lineare Suche, vor allem bei großen Datensätzen. Während die lineare Suche eine Zeitkomplexität von O(n) hat (im schlimmsten Fall muss jedes Element geprüft werden), ist die binäre Suche effizienter: Mit O(log n) wird der Suchraum in jedem Schritt halbiert – das reduziert die Anzahl der Vergleiche erheblich.
Eine detaillierte Einordnung, wie Algorithmen bewertet werden, findest du in unserem Big-O-Notation- und Zeitkomplexitäts-Guide: Intuition und Mathematik. Eine weitere Option ist das Tutorial Analyzing Complexity of Code through Python.
Damit die binäre Suche funktioniert, muss der Datensatz auf- oder absteigend sortiert sein. Das ist notwendig, weil der Algorithmus die Ordnung der Elemente nutzt, um zu entscheiden, welche Hälfte als Nächstes durchsucht wird. Ohne Sortierung kann die binäre Suche den Zielwert nicht zuverlässig finden.
Die binäre Suche lässt sich iterativ oder rekursiv implementieren. Die iterative Methode nutzt Schleifen, um den Suchraum wiederholt zu halbieren. Bei der rekursiven Methode ruft sich die Funktion selbst mit kleinerem Suchbereich auf. Diese Flexibilität macht sie vielseitig einsetzbar.
Die binäre Suche ist ein starkes Werkzeug. Ihre Effizienz beim schnellen Eingrenzen des Suchraums ist besonders bei großen Datensätzen Gold wert, wenn Performance und Geschwindigkeit entscheidend sind. Schauen wir uns konkrete Anwendungen an und vergleichen sie mit anderen Algorithmen.
In Datenbanken wird die binäre Suche oft genutzt, um Datensätze in sortierten Feldern schnell zu finden – etwa eine bestimmte Nutzerin bzw. einen bestimmten Nutzer in einer nach User-ID sortierten Tabelle. Stell dir Millionen von Einträgen vor: Eine lineare Suche müsste einen Datensatz nach dem anderen scannen. Die binäre Suche halbiert den Suchraum systematisch und reduziert so die nötigen Vergleiche drastisch.
Das Durchsuchen großer, sortierter Datensätze ist in der Data Science Alltag. In der Zeitreihenanalyse kann die binäre Suche z. B. genutzt werden, um bestimmte Zeitstempel in einer sortierten Ereignisfolge zu finden. Im Machine Learning helfen binäre Suchstrategien beim Optimieren von Hyperparametern, indem sie in einem Bereich den besten Wert eingrenzen.
In der Computergrafik kommt die binäre Suche in Algorithmen zum Einsatz, bei denen Präzision und Geschwindigkeit gefragt sind. Ein Beispiel ist Raytracing, eine Rendering-Technik zur Simulation von Licht. Hier kann die binäre Suche Schnittpunkte zwischen Strahlen und Oberflächen schnell finden.
Die binäre Suche ist nicht nur für sich nützlich, sondern auch ein Baustein für komplexe Algorithmen und Datenstrukturen. Suchbäume wie Binary Search Trees (BSTs) und balancierte Bäume wie AVL-Bäume basieren auf ihren Prinzipien. Sie ermöglichen effizientes Suchen, Einfügen und Löschen – ideal, wenn Daten dynamisch aktualisiert und häufig durchsucht werden. Mehr dazu im Guide AVL Tree: Complete Guide With Python Implementation.
Schauen wir, wie sich die binäre Suche im Vergleich zu zwei gängigen Alternativen schlägt: linearer Suche und Hash-Lookup.
Die lineare Suche prüft die Elemente eines Datensatzes der Reihe nach. Sie ist deutlich weniger effizient als die binäre Suche und hat eine Zeitkomplexität von O(n). Dafür benötigt sie keine Sortierung der Daten und ist in manchen Szenarien daher praktikabel.
Der Hash-Lookup findet Werte effizient, wenn sie eindeutigen Schlüsseln zugeordnet sind. Eine Hashfunktion berechnet aus dem Schlüssel den Index, unter dem der Wert in einer Hashtabelle liegt. Der Abruf gelingt dadurch quasi sofort, oft in O(1). Allerdings braucht das zusätzliche Speicher für die Hashtabelle und eignet sich nicht für Bereichssuchen – dafür ist die binäre Suche die bessere Wahl.
Wir schauen uns nun verschiedene Wege an, eine einfache binäre Suche in Python umzusetzen. Zuerst brauchen wir einen kleinen, sortierten Datensatz und einen Zielwert. Stell dir folgendes sortiertes Array und das Suchziel vor:
arr = [2, 5, 8, 12, 16, 23, 38, 56, 72, 91]
target = 56Die iterative Methode ist wahrscheinlich der direkteste Ansatz. Dabei halbierst du mit einer while-Schleife den Suchbereich immer wieder, bis du das Ziel findest. Diese Methode ist wegen ihrer Klarheit und Effizienz beliebt.
So implementierst du die binäre Suche iterativ:
def binary_search_iterative(arr, target):
    # Definiere die Suchgrenzen
    left, right = 0, len(arr) - 1
    while left <= right:
        # Berechne den mittleren Index
        mid = left + (right - left) // 2
        # Wenn das mittlere Element dem Ziel entspricht, gib den Index zurück
        if arr[mid] == target:
            return mid
        # Ist das Ziel größer, suche in der rechten Hälfte weiter
        elif arr[mid] < target:
            left = mid + 1
        # Ist das Ziel kleiner, suche in der linken Hälfte weiter
        else:
            right = mid - 1
    # Gib -1 zurück, wenn das Ziel nicht gefunden wurde
    return -1

# Führe die iterative Funktion aus
result = binary_search_iterative(arr, target)
if result != -1:
    print(f"Iterative: Target found at index {result}")
else:
    print("Iterative: Target not found")
Schauen wir uns den Code genauer an:
Wir setzen left und right als Grenzen des Suchraums. Anfangs ist left 0 (Beginn des Arrays) und right len(arr) - 1 (Ende des Arrays).
In jeder Iteration berechnen wir den mittleren Index, also die Mitte des aktuellen Suchintervalls. Das geschieht mit der Formel mid = left + (right - left) /2.
Dann vergleichen wir das Element an mid mit dem target:
Bei Übereinstimmung haben wir das Ziel gefunden und die Funktion gibt mid zurück.
Ist das Element an mid kleiner als das Ziel, muss das Ziel rechts liegen. Wir setzen left auf mid + 1.
Ist das Element an mid größer, muss das Ziel links liegen. Wir setzen right auf mid - 1.
Die Schleife läuft, bis das Ziel gefunden ist oder left größer als right wird – dann ist das Ziel nicht im Array.
Die rekursive Methode ist eine alternative Implementierung. Anstatt einer Schleife ruft sich die Funktion selbst auf und passt jedes Mal die Suchgrenzen an, bis das Ziel gefunden wird oder feststeht, dass es nicht vorhanden ist.
So implementierst du die binäre Suche rekursiv:
def binary_search_recursive(arr, target, left, right):
    # Wenn sich die Suchgrenzen kreuzen, ist das Ziel nicht im Array
    if left > right:
        return -1
    # Berechne den mittleren Index
    mid = left + (right - left) // 2
    # Wenn der Mittelwert dem Ziel entspricht, gib den Index zurück
    if arr[mid] == target:
        return mid
    # Ist das Ziel größer als der Mittelwert, suche rechts weiter
    elif arr[mid] < target:
        return binary_search_recursive(arr, target, mid + 1, right)
    # Ist das Ziel kleiner als der Mittelwert, suche links weiter
    else:
        return binary_search_recursive(arr, target, left, mid - 1)

# Führe die rekursive Funktion aus
result = binary_search_recursive(arr, target, 0, len(arr) - 1)

if result != -1:
    print(f"Iterative: Target found at index {result}")
else:
    print("Iterative: Target not found")
Schauen wir uns den Code genauer an:
Die rekursive Funktion startet mit denselben Anfangsgrenzen left und right wie die iterative Variante.
Zuerst prüft sie, ob left größer als right ist. Wenn ja, gibt sie -1 zurück – das Ziel ist nicht im Array.
Andernfalls berechnet die Funktion den Index mid und vergleicht das Element an mid mit dem Ziel.
Wenn Ziel und Element an mid übereinstimmen, gibt sie mid zurück.
Ist das Ziel größer als das Element an mid, ruft sie sich mit angepassten Grenzen für die rechte Hälfte erneut auf.
Ist das Ziel kleiner, durchsucht sie die linke Hälfte.
Die Rekursion läuft weiter, bis das Ziel gefunden ist oder der Suchraum erschöpft ist.
Mehr zu rekursiven Funktionen findest du in Understanding Recursive Functions in Python.
Pythons Standardbibliothek enthält das Modul bisect mit vorimplementierten Funktionen für binäre Suche. Das ist sehr effizient und spart oft Zeit gegenüber einer Eigenimplementierung.
So findest du das Ziel mit bisect in unserem Array:
# Importiere das bisect-Modul
import bisect

# Rufe die Funktion auf und übergib Array und Zielwert
index = bisect.bisect_left(arr, target)

# Ergebnisse ausgeben
if index < len(arr) and arr[index] == target:
    print(f"Bisect: Target found at index {index}")
else:
    print("Bisect: Target not found")
Schauen wir uns den Code genauer an:
Die Funktion bisect_left gibt den Index zurück, an dem der Zielwert eingefügt werden müsste, um die Sortierung zu erhalten. Steht an diesem Index bereits der Zielwert, ist er im Array vorhanden.
Diese Methode ist besonders nützlich bei sortierten Arrays und kann auch verwendet werden, um Elemente sortiert einzufügen.
Das Modul bisect bietet außerdem Funktionen wie bisect_right und insort, um Einfügepositionen zu finden oder Elemente direkt einzufügen.
Lerne Python mit DataCamp
Kurs
Kurs
Kurs