

Nói chung, một thuật toán là một chuỗi hướng dẫn chính xác mà máy tính tuân theo để hoàn thành một tác vụ cụ thể hoặc giải một bài toán. Xem bài viết blog của chúng tôi, Thuật toán là gì, để tìm hiểu về nhiều loại thuật toán khác nhau trong machine learning.
Tổng quan khái niệm
Tìm kiếm nhị phân là một thuật toán mạnh mẽ được thiết kế để tìm nhanh một giá trị trong tập dữ liệu đã được sắp xếp. Ý tưởng cốt lõi rất đơn giản: Thay vì kiểm tra từng phần tử lần lượt như trong tìm kiếm tuyến tính, tìm kiếm nhị phân thu hẹp phạm vi tìm kiếm đi một nửa sau mỗi bước, giúp quá trình nhanh hơn nhiều.
Cách hoạt động như sau:
- Bắt đầu bằng cách so sánh giá trị cần tìm với phần tử ở giữa tập dữ liệu. Chỉ số của giá trị giữa được tính theo công thức: middle = (low + high) / 2, trong đó low là chỉ số của phần tử đầu tiên trong phạm vi tìm kiếm hiện tại, và high là chỉ số của phần tử cuối cùng.
- So sánh giá trị giữa với mục tiêu. Nếu giá trị cần tìm bằng phần tử giữa, bạn đã tìm được chỉ số và hoàn tất tìm kiếm. Nếu nhỏ hơn phần tử giữa, tiếp tục tìm trong nửa bên trái tập dữ liệu. Nếu lớn hơn, tiếp tục tìm trong nửa bên phải.
- Lặp lại bước 1–2. Phạm vi tìm kiếm liên tục bị chia đôi ở mỗi bước. Lặp lại đến khi tìm thấy giá trị cần tìm hoặc phạm vi tìm kiếm rỗng.
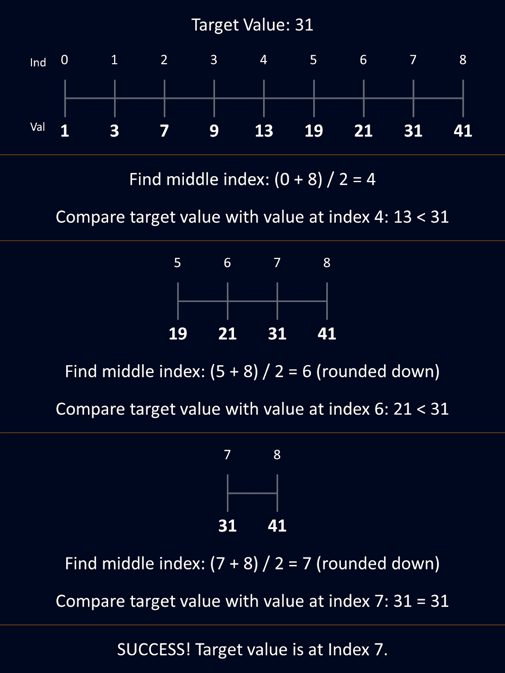
Quy trình tìm kiếm nhị phân. Ảnh: Tác giả
Trên đây là ví dụ đơn giản minh họa ý tưởng phía sau tìm kiếm nhị phân.
Chính quá trình chia đôi này khiến tìm kiếm nhị phân hiệu quả. Tuy nhiên, cần lưu ý rằng tập dữ liệu phải được sắp xếp để thuật toán hoạt động đúng. Nếu dữ liệu không được sắp xếp, thuật toán sẽ không cho kết quả như mong muốn.
Xem thêm Cấu trúc dữ liệu: Hướng dẫn toàn diện với ví dụ Python để tìm hiểu thêm về các kiểu cấu trúc dữ liệu bạn có thể muốn tìm kiếm.
Điểm mấu chốt cần ghi nhớ
Những điểm sau nhấn mạnh các nguyên tắc cốt lõi của tìm kiếm nhị phân.
Hiệu quả
Tìm kiếm nhị phân nhanh hơn đáng kể so với tìm kiếm tuyến tính, đặc biệt khi làm việc với tập dữ liệu lớn. Trong khi tìm kiếm tuyến tính có độ phức tạp thời gian O(n), nghĩa là trong trường hợp xấu nhất có thể phải kiểm tra mọi phần tử, thì tìm kiếm nhị phân hiệu quả hơn với độ phức tạp O(log n), tức là không gian tìm kiếm bị chia đôi qua mỗi bước, giảm đáng kể số lần so sánh cần thiết.
Để xem phân tích chi tiết về cách đánh giá thuật toán, tham khảo Hướng dẫn ký hiệu Big O và độ phức tạp thời gian: Trực giác và Toán học. Một lựa chọn khác là hướng dẫn Phân tích độ phức tạp của mã bằng Python.
Yêu cầu
Để tìm kiếm nhị phân hoạt động, tập dữ liệu phải được sắp xếp theo thứ tự tăng dần hoặc giảm dần. Đây là yêu cầu bắt buộc vì thuật toán dựa vào trật tự của các phần tử để quyết định nửa nào của tập dữ liệu sẽ tìm tiếp. Nếu dữ liệu không được sắp xếp, tìm kiếm nhị phân không thể xác định chính xác giá trị cần tìm.
Tính linh hoạt
Tìm kiếm nhị phân có thể được triển khai bằng cách lặp hoặc đệ quy. Phương pháp lặp sử dụng vòng lặp để liên tục chia đôi phạm vi tìm kiếm. Phương pháp đệ quy cho hàm tự gọi lại chính nó với phạm vi nhỏ hơn. Tính linh hoạt này phù hợp với nhiều ứng dụng khác nhau.
Ứng dụng trong thực tế
Tìm kiếm nhị phân là một công cụ mạnh mẽ. Khả năng nhanh chóng thu hẹp phạm vi tìm kiếm khiến nó cực kỳ hữu ích, đặc biệt khi xử lý tập dữ liệu lớn nơi hiệu năng và tốc độ là then chốt. Hãy khám phá một vài ứng dụng cụ thể và xem tìm kiếm nhị phân so với các thuật toán khác như thế nào.
Cơ sở dữ liệu
Trong cơ sở dữ liệu, tìm kiếm nhị phân thường được dùng để nhanh chóng định vị bản ghi trong các trường đã sắp xếp, ví dụ tìm một người dùng cụ thể trong bảng được sắp theo ID. Hãy hình dung một cơ sở dữ liệu có hàng triệu bản ghi. Tìm kiếm tuyến tính sẽ cần quét từng bản ghi một, có thể tốn nhiều thời gian. Thay vào đó, tìm kiếm nhị phân có thể nhanh chóng định vị bản ghi mong muốn bằng cách chia đôi không gian tìm kiếm một cách có hệ thống, giảm đáng kể số lần so sánh cần thiết.
Khoa học dữ liệu
Việc tìm kiếm qua các tập dữ liệu lớn, đã sắp xếp là tác vụ thường gặp trong khoa học dữ liệu. Ví dụ, trong phân tích chuỗi thời gian, tìm kiếm nhị phân có thể dùng để tìm mốc thời gian cụ thể trong một dãy sự kiện đã sắp xếp. Trong machine learning, các thuật toán tìm kiếm nhị phân có thể dùng để tối ưu siêu tham số bằng cách tìm giá trị tốt nhất trong một khoảng.
Đồ họa máy tính
Trong đồ họa máy tính, tìm kiếm nhị phân được dùng trong các thuật toán cần độ chính xác và tốc độ. Một ví dụ là ray tracing, kỹ thuật kết xuất mô phỏng cách ánh sáng tương tác với vật thể. Tìm kiếm nhị phân có thể nhanh chóng tìm điểm giao giữa tia và bề mặt.
Nền tảng cho các thuật toán phức tạp
Tìm kiếm nhị phân không chỉ hữu ích khi đứng riêng lẻ; nó còn là nền tảng cho các thuật toán và cấu trúc dữ liệu phức tạp hơn. Ví dụ, cây tìm kiếm như cây nhị phân tìm kiếm (BST) và các cây cân bằng như cây AVL đều dựa trên nguyên lý tìm kiếm nhị phân. Những cấu trúc này cho phép tìm kiếm, chèn, và xóa hiệu quả, hữu ích khi dữ liệu cần được cập nhật động và tìm kiếm thường xuyên. Tìm hiểu thêm về các cây này trong AVL Tree: Hướng dẫn đầy đủ kèm triển khai Python.
Tìm kiếm nhị phân so với các thuật toán tìm kiếm khác
Hãy xem tìm kiếm nhị phân so sánh thế nào với hai thuật toán tìm kiếm phổ biến khác: tìm kiếm tuyến tính và tra cứu băm.
Tìm kiếm tuyến tính
Tìm kiếm tuyến tính là thuật toán đơn giản kiểm tra lần lượt từng phần tử trong tập dữ liệu. Nó kém hiệu quả hơn nhiều so với tìm kiếm nhị phân, với độ phức tạp thời gian O(n). Tuy nhiên, tìm kiếm tuyến tính không yêu cầu dữ liệu đã sắp xếp, nên hữu ích trong một số trường hợp.
Tra cứu băm
Tra cứu băm là thuật toán hiệu quả để tìm nhanh các giá trị trong tập dữ liệu khi các giá trị gắn với khóa duy nhất. Nó hoạt động bằng cách áp dụng một hàm băm lên khóa để tính ra chỉ số nơi giá trị tương ứng được lưu trong bảng băm. Điều này cho phép truy xuất gần như tức thời, thường là trong thời gian O(1). Tuy nhiên, dù rất nhanh trong việc tìm phần tử cụ thể, tra cứu băm cần thêm bộ nhớ để lưu bảng băm và không phù hợp cho việc tìm trong một phạm vi giá trị — nhiệm vụ mà tìm kiếm nhị phân thích hợp hơn.
Triển khai tìm kiếm nhị phân trong Python
Hãy khám phá vài cách triển khai tìm kiếm nhị phân đơn giản trong Python. Nhưng trước hết, ta cần xác lập một tập dữ liệu đơn giản và một giá trị mục tiêu để tìm. Giả sử ta có mảng đã sắp xếp và mục tiêu sau:
arr = [2, 5, 8, 12, 16, 23, 38, 56, 72, 91]
target = 56Phương pháp lặp
Phương pháp lặp có lẽ là cách tiếp cận dễ hiểu nhất. Với phương pháp này, chúng ta dùng vòng lặp while để liên tục chia đôi khoảng tìm kiếm cho đến khi tìm thấy mục tiêu. Cách này thường được ưa chuộng vì tính rõ ràng và hiệu quả.
Bạn có thể triển khai tìm kiếm nhị phân theo cách lặp như sau:
def binary_search_iterative(arr, target):
# Define the search bounds
left, right = 0, len(arr) - 1
while left <= right:
# Calculate the middle index
mid = left + (right - left) // 2
# If the middle element is the target, return its index
if arr[mid] == target:
return mid
# If the target is bigger, narrow the search to the right half
elif arr[mid] < target:
left = mid + 1
# If the target is smaller, narrow the search to the left half
else:
right = mid - 1
# Return -1 if the target is not found
return -1
# Run the iterative function
result = binary_search_iterative(arr, target)
if result != -1:
print(f"Iterative: Target found at index {result}")
else:
print("Iterative: Target not found")Cùng xem kỹ đoạn mã này:
-
Chúng ta bắt đầu bằng cách đặt ‘left’ và ‘right’ làm giới hạn của không gian tìm kiếm. Ban đầu, left là
0(đầu mảng) và ‘right’ làlen(arr) - 1(cuối mảng). -
Ở mỗi vòng lặp, ta tính chỉ số mid, đại diện cho phần giữa của khoảng tìm kiếm hiện tại. Việc này được thực hiện bằng công thức
mid = left + (right - left) /2. -
Sau đó, ta so sánh phần tử tại
midvớitarget: -
Nếu trùng khớp, ta đã tìm thấy mục tiêu và hàm trả về
mid. -
Nếu phần tử tại
midnhỏ hơn mục tiêu, tức mục tiêu ở nửa bên phải, ta cập nhậtleftthànhmid + 1. -
Nếu phần tử tại
midlớn hơn mục tiêu, mục tiêu ở nửa bên trái, ta cập nhậtrightthànhmid - 1. -
Vòng lặp tiếp tục cho đến khi tìm được mục tiêu hoặc khi
leftvượt quáright, nghĩa là mục tiêu không có trong mảng.
Phương pháp đệ quy
Phương pháp đệ quy để tìm kiếm nhị phân là một cách triển khai khác. Thay vì dùng vòng lặp, hàm sẽ tự gọi lại, điều chỉnh giới hạn tìm kiếm mỗi lần cho đến khi tìm thấy mục tiêu hoặc xác định rằng mục tiêu không tồn tại.
Bạn có thể triển khai tìm kiếm nhị phân theo cách đệ quy như sau:
def binary_search_recursive(arr, target, left, right):
# If the search bounds cross, the target isn't in the array
if left > right:
return -1
# Calculate the middle index
mid = left + (right - left) // 2
# If middle value equals the target, return the index
if arr[mid] == target:
return mid
# If the target is bigger than the middle value, search in the right half
elif arr[mid] < target:
return binary_search_recursive(arr, target, mid + 1, right)
# If the target is smaller than the middle value, search in the left half
else:
return binary_search_recursive(arr, target, left, mid - 1)
# Run the recursive function
result = binary_search_recursive(arr, target, 0, len(arr) - 1)
if result != -1:
print(f"Iterative: Target found at index {result}")
else:
print("Iterative: Target not found")Cùng xem kỹ đoạn mã này:
-
Hàm đệ quy bắt đầu với cùng giới hạn
leftvàrightnhư hàm lặp. -
Đầu tiên kiểm tra nếu
leftvượt quáright. Nếu đúng, hàm trả về-1, cho biết mục tiêu không có trong mảng. -
Ngược lại, hàm tính chỉ số
midvà so sánh mục tiêu với phần tử tạimid. -
Nếu mục tiêu bằng phần tử tại
mid, hàm trả vềmid. -
Nếu mục tiêu lớn hơn
mid, hàm đệ quy tự gọi với giới hạn mới để tìm ở nửa bên phải. -
Nếu mục tiêu nhỏ hơn
mid, hàm tìm ở nửa bên trái. -
Quá trình đệ quy tiếp tục cho đến khi tìm thấy mục tiêu hoặc hết không gian tìm kiếm.
Để biết thêm về hàm đệ quy, hãy xem Hiểu về hàm đệ quy trong Python.
Sử dụng mô-đun bisect tích hợp của Python
Thư viện chuẩn của Python bao gồm mô-đun bisect, cung cấp sẵn các hàm tìm kiếm nhị phân. Mô-đun này rất hiệu quả và thường giúp tiết kiệm thời gian so với tự viết hàm.
Cách dùng mô-đun bisect để tìm mục tiêu trong mảng của chúng ta:
# Import the bisect module
import bisect
# Call the module and provide the array and the target value
index = bisect.bisect_left(arr, target)
#Print results
if index < len(arr) and arr[index] == target:
print(f"Bisect: Target found at index {index}")
else:
print("Bisect: Target not found")Cùng xem kỹ đoạn mã này:
-
Hàm
bisect_lefttrả về chỉ số nơi mục tiêu nên được chèn vào để giữ trật tự của mảng. Nếu tìm thấy mục tiêu tại chỉ số này, tức là mục tiêu tồn tại trong mảng. -
Cách này đặc biệt hữu ích khi làm việc với mảng đã sắp xếp, và cũng có thể dùng để chèn phần tử trong khi vẫn duy trì thứ tự.
-
Mô-đun
bisectcũng cung cấp các hàm khác nhưbisect_rightvàinsort, có thể dùng để tìm điểm chèn hoặc chèn trực tiếp phần tử.
Độ phức tạp thời gian và không gian
Khi bàn về hiệu quả của thuật toán, chúng ta thường dùng ký hiệu Big O, ký hiệu là O(x), để mô tả cách thời gian chạy hoặc nhu cầu bộ nhớ tăng lên khi kích thước đầu vào tăng. Với tìm kiếm nhị phân, độ phức tạp thời gian thường là O(log n). Điều này có nghĩa là khi tập dữ liệu lớn hơn, số phép toán cần để tìm mục tiêu tăng theo hàm logarit, giúp tìm kiếm nhị phân hiệu quả ngay cả với tập dữ liệu lớn.
Phương pháp lặp của tìm kiếm nhị phân có độ phức tạp thời gian O(log n) vì khoảng tìm kiếm bị chia đôi ở mỗi vòng lặp. Độ phức tạp không gian là O(1) vì chỉ dùng lượng bộ nhớ bổ sung hằng số, chỉ cần vài biến để theo dõi giới hạn tìm kiếm và phần tử giữa.
Phương pháp đệ quy cũng có độ phức tạp thời gian O(log n) vì cùng lý do. Tuy nhiên, độ phức tạp không gian là O(log n) do cần bộ nhớ để duy trì ngăn xếp lời gọi cho mỗi lần đệ quy. Mỗi lần gọi đệ quy thêm một lớp vào ngăn xếp, độ sâu đệ quy tỷ lệ với số bước chia đôi, tức là logarit theo kích thước tập dữ liệu.
Mặc dù cả hai phương pháp đều hiệu quả về thời gian, cách lặp tiết kiệm bộ nhớ hơn. Đây là lý do mô-đun bisect sử dụng cách lặp ở bên dưới. Cá nhân tôi cũng ưa cách lặp vì lý do này. Tuy vậy, cách đệ quy có thể trực quan hơn với một số người và đôi khi cần ít dòng mã hơn.
Các lỗi thường gặp và cách tránh
Khi dùng tìm kiếm nhị phân, có một vài lỗi thường gặp cần lưu ý. Chúng có thể ảnh hưởng đến tính đúng đắn và hiệu quả của thuật toán, vì vậy việc chú ý là quan trọng.
Trước hết, tìm kiếm nhị phân phụ thuộc vào việc tập dữ liệu đã được sắp xếp. Nếu dữ liệu không được sắp xếp, tìm kiếm nhị phân sẽ không hoạt động đúng; có thể trả về kết quả sai hoặc thất bại hoàn toàn. Do đó, cần sắp xếp tập dữ liệu trước khi áp dụng tìm kiếm nhị phân. Nếu không thể sắp xếp dữ liệu, tìm kiếm nhị phân không phải công cụ phù hợp.
Một vấn đề thường gặp là lỗi lệch một đơn vị (off-by-one). Những lỗi này xảy ra khi phép tính chỉ số hơi sai, có thể dẫn đến vòng lặp vô hạn hoặc không tìm thấy giá trị mục tiêu. Điều này có thể xảy ra nếu phép tính điểm giữa hoặc việc điều chỉnh biên không được xử lý chính xác. Để tránh, hãy đảm bảo phép tính chỉ số giữa đúng và cập nhật biên hợp lý sau mỗi lần so sánh. Nhớ rằng chỉ số trong Python bắt đầu từ 0, không phải 1.
Một thách thức khác cần lưu ý nếu bạn dùng tìm kiếm nhị phân theo cách đệ quy là giới hạn độ sâu đệ quy. Trong Python, có giới hạn số lần gọi đệ quy nhằm ngăn dùng bộ nhớ quá mức. Nếu tập dữ liệu rất lớn, đệ quy sâu có thể vượt quá giới hạn này, gây tràn ngăn xếp. Để giảm thiểu, hãy cân nhắc dùng cách lặp cho tìm kiếm nhị phân, vốn không gặp hạn chế về độ sâu đệ quy. Nếu ưu tiên hoặc bắt buộc dùng đệ quy, bạn có thể tăng giới hạn đệ quy bằng sys.setrecursionlimit(), nhưng cần thận trọng để tránh các vấn đề khác.
Kết luận
Tìm kiếm nhị phân là một thuật toán mạnh mẽ và hiệu quả mà mọi lập trình viên Python nên có trong bộ công cụ. Dù triển khai theo cách lặp hay đệ quy, nó mang lại lợi thế hiệu năng đáng kể so với tìm kiếm tuyến tính, đặc biệt với tập dữ liệu lớn. Để tìm hiểu thêm, hãy xem lộ trình kỹ năng Python Programming của DataCamp hoặc khóa học tương tác Nguyên lý Kỹ thuật Phần mềm trong Python.
Tôi là Tiến sĩ với 13 năm kinh nghiệm làm việc với dữ liệu trong môi trường nghiên cứu sinh học. Tôi phát triển phần mềm bằng nhiều ngôn ngữ lập trình, bao gồm Python, MATLAB và R. Tôi đam mê chia sẻ tình yêu học hỏi của mình với mọi người.
Câu hỏi thường gặp về Tìm kiếm nhị phân
Những kịch bản thực tế nào thường khiến tìm kiếm nhị phân kém hiệu quả?
Khi dữ liệu chưa được sắp xếp hoặc được cập nhật thường xuyên, việc sắp xếp có thể làm chậm hệ thống, khiến tìm kiếm nhị phân kém hiệu quả.
Tìm kiếm nhị phân có thể dùng cho cấu trúc dữ liệu khác ngoài mảng, như danh sách liên kết, không?
Không, vì truy cập phần tử giữa của danh sách liên kết mất thời gian tuyến tính, làm mất đi lợi thế tốc độ của tìm kiếm nhị phân.
Tìm kiếm nhị phân xử lý giá trị trùng lặp trong tập dữ liệu như thế nào?
Tìm kiếm nhị phân tìm một lần xuất hiện. Để tìm tất cả bản sao, cần tìm thêm các biên trái/phải.
Ưu điểm của dùng mô-đun bisect trong Python so với tự viết hàm tìm kiếm nhị phân là gì?
Mô-đun bisect được tối ưu, đáng tin cậy và có thêm tính năng như chèn phần tử trong khi vẫn giữ tập dữ liệu được sắp xếp.


Hãy tưởng tượng bạn đang chơi trò đoán số, cần tìm một số cụ thể từ 1 đến 100. Bạn có thể đoán ngẫu nhiên, nhưng trong kịch bản tệ nhất, bạn có thể cần tới 100 lần đoán mới ra đáp án đúng.
Một cách ngắn gọn hơn là chọn số ở giữa, 50, và hỏi xem số cần tìm lớn hơn hay nhỏ hơn. Nếu số cần tìm lớn hơn, bạn có thể bỏ qua mọi số dưới 50 và lặp lại với các số từ 51–100. Cứ tiếp tục như vậy cho đến khi tìm được số đúng.
Bằng cách liên tục chia đôi khả năng, bạn nhanh chóng thu hẹp đến mục tiêu. Với cách này, ngay cả trong kịch bản tệ nhất, bạn chỉ mất tối đa 7 lần đoán để tìm ra số đúng. Chiến lược này chính là tinh thần của tìm kiếm nhị phân.
Trong hướng dẫn này, chúng ta sẽ tìm hiểu tìm kiếm nhị phân là gì, các ứng dụng thực tế, và cách triển khai trong Python bằng cả phương pháp lặp và đệ quy. Để học đầy đủ, hãy khám phá khóa học Data Structures and Algorithms in Python của chúng tôi, khóa này đi sâu vào tìm kiếm nhị phân cùng các thuật toán tìm kiếm phổ biến và quan trọng khác như tìm kiếm tuyến tính, duyệt sâu trước (depth first search), và duyệt rộng trước (breadth first search).
Tìm kiếm nhị phân là gì?
Khi tìm kiếm một giá trị trong tập dữ liệu, mục tiêu của bạn là tìm ra chỉ số (vị trí) của nó để có thể dễ dàng lấy và sử dụng giá trị đó trong mã. Có một số thuật toán tìm kiếm có thể giúp bạn xác định chỉ số của một giá trị cụ thể. Một trong những phương pháp cơ bản và hiệu quả nhất là tìm kiếm nhị phân.