
学习路径
AI智能体基础知识
6 小时
实践并学习路径你的进步。
使用 Google 继续如果您是一名数据从业者,日常很可能要处理大量重复的编码任务。比如为全新数据集做画像、从零搭建数据管道,或手工撰写数据转换测试。这些事情必不可少,但非常耗时。
但如果您的终端能替您管理并写好这些重复的样板代码,而您把精力投入到构思与决策上,会怎样?这正是 OpenAI 的 Codex-CLI 的用武之地。它是一款直接内置在命令行中的高能力 AI 编码代理,如您将看到的,它非常适合精简数据工作流。
在本教程中,我们将介绍数据分析师和数据科学家如何使用 Codex-CLI 加速最常见的日常数据任务。我们将涵盖从初步探索性数据分析到构建完善的数据管道,甚至为您的转换编写自动化测试,全部都在终端中完成。
如果您想进一步了解如何构建具备代理能力的 AI 系统,强烈推荐报名我们的 AI Agent Fundamentals 技能方向,该方向涵盖您需要了解的一切。
先来了解一下 Codex CLI 的本质。Codex CLI 是由 OpenAI 开发的开源、基于终端的编码代理。
它使用 Rust 编程语言构建,因此相当快速高效。但最重要的一点是,它直接在您的命令行中运行,这使它能够读取您的文件、编辑代码,甚至在本机上执行命令。
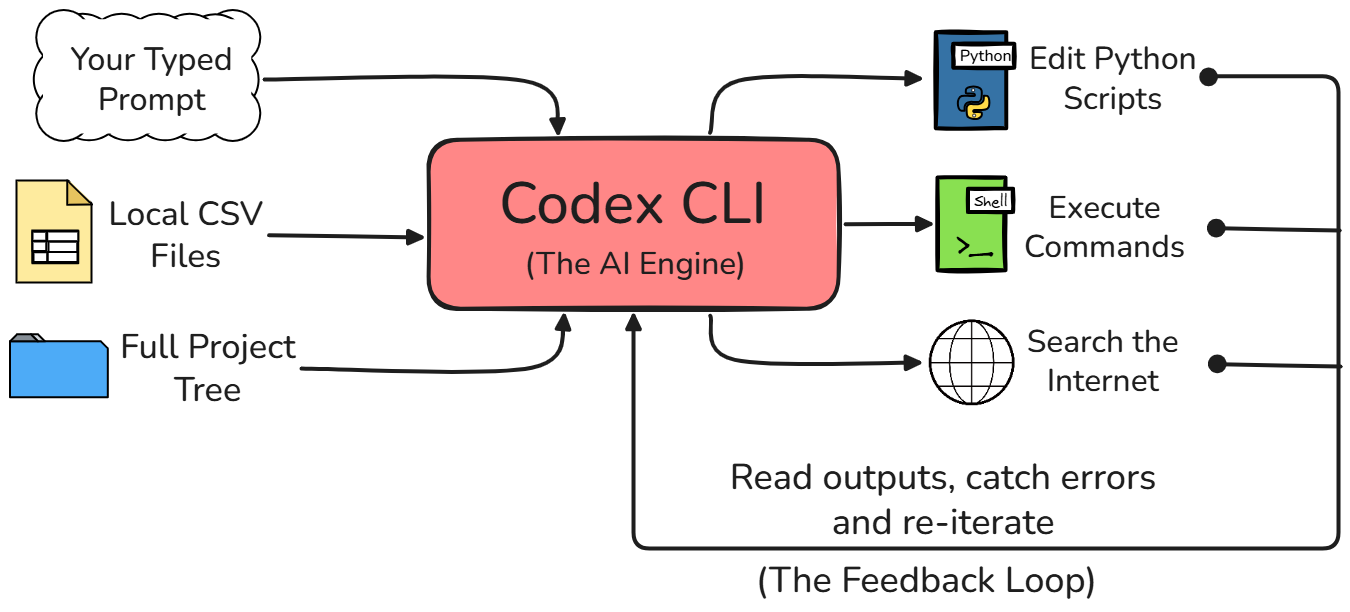
尽管您可能已经习惯在工作中使用标准的 ChatGPT 网页界面,但 Codex CLI 非常不同。在使用网页界面时,AI 模型与您的工作环境是完全隔离的。
而在 Codex CLI 中,代理可以直接访问您的本地文件系统。它可以运行 Python 脚本,查看输出或返回的错误,并且在无需您事先解释一切的情况下,始终了解整个项目结构。
|
工作流步骤 / 特性 |
ChatGPT(网页浏览器) |
Codex CLI(终端) |
|
访问数据 |
您需要手动打开 CSV 文件,并复制粘贴几行原始数据到对话中,帮助其理解。 |
它可以独立地直接从您的本地文件系统打开并读取 CSV 文件。 |
|
执行代码 |
您必须手动复制生成的脚本,粘贴到本地代码编辑器中,然后自行运行。 |
它会自动编写所需的 Python 脚本、运行它,并直接在终端中展示最终输出。 |
|
整体体验 |
需要在多个窗口间进行大量繁琐的来回复制粘贴。 |
一切都在终端内以单一、连续、无缝的流程完成。 |
当然,由于 Codex 代理可以直接编辑您的文件并在机器上运行命令,因此它提供不同的审批模式,确保您始终掌控全局。三种审批模式为:
刚开始使用时,建议从只读模式起步,待您信任该工作流后再逐步放开。
您可以在 Codex 的会话中使用 /permissions 切换审批模式。这是从只读切换到 Auto 的最简便方式。
/permissions如果您希望一开始就以更严格的模式启动 Codex,可以在启动时设置沙箱和审批策略标志。例如,以下命令将以保守的只读设置启动,并在需要时提示。
codex --sandbox read-only --ask-for-approval on-request要顺利跟进本教程,您需要满足一些先决条件。
首先,您需要在本机安装 Codex CLI。为此,只需打开终端,使用以下命令在系统中全局安装 CLI:
npm install -g @openai/codex接下来需要对您的账号进行认证,让工具识别您的身份。您可以在终端中输入 codex 来验证安装是否正确并首次启动代理。它会显示类似如下的界面:
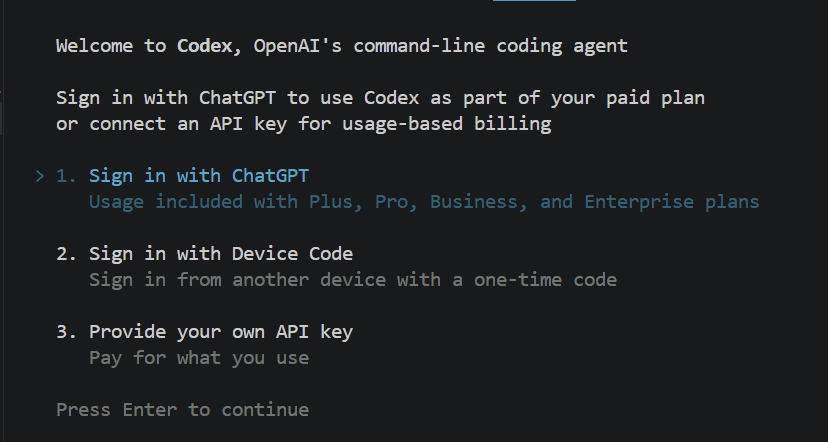
按下回车后,将打开浏览器窗口,提示您通过 ChatGPT 账号登录。登录完成后,您即可开始使用该工具。
如果您没有付费的 ChatGPT 订阅并希望使用 API Key,也可以选择按量付费。可在 OpenAI 控制台获取密钥。
在开始让 AI 进行数据分析前,正确配置 Python 数据环境非常重要。这一点至关重要,因为 Codex CLI 会在其当前运行的环境中操作。因此,如果代理需要编写使用 pandas、scikit-learn 或 matplotlib 等数据科学库的脚本,您需要确保这些库已安装且可供其使用。
我们可以在启动 Codex 前激活一个 Python 虚拟环境。以下是一个示例设置脚本,包含可在终端运行的精确命令,用于创建虚拟环境、安装必要的数据包、激活环境并启动代理:
python3 -m venv data_env
source data_env/bin/activate
pip install pandas scikit-learn matplotlib
codex在设置项目时,还有一步很重要:在主项目文件夹中创建名为 AGENTS.md 的文件。可以将该文件视为一组持久化指令,Codex 代理每次打开您的项目都会自动读取。它告诉 AI 在此特定工作区应如何行为、如何写代码。
对于数据类工作,我们希望 AI 生成的代码干净、可读、专业。下面是一个专为数据项目定制的AGENTS.md 示例文件。您只需创建该文件并将下述文本粘贴进去:
# Data Project Guidelines


When writing Python code for this project, please strictly follow these rules:
- Enforce PEP 8 formatting standards for all Python code.
- Always use highly descriptive variable names. Do not use generic, lazy names like df, data, x, or y. Instead, use specific names like transaction_data or revenue_series.
- Prefer pandas best practices, such as using vectorized operations instead of iterating through rows.
- Generate clear, descriptive docstrings for every single function.
- Always include Python type hints for function arguments and return values.由于该文件会在每次任务无关紧要地被读取,最佳实践是保持简洁,仅关注适用于所有提示的指令。对于更具体的指令,您应改用技能。
接下来进入实际数据工作,我们先从探索性数据分析(EDA)开始。您可能已经知道,这几乎是任何新数据项目最常见的起点。在构建模型或管道之前,必须先了解数据的样貌。
好消息是,借助 Codex CLI,一条简单的自然语言提示就能为您生成一份完整可用的 EDA 脚本。
场景:在今天的示例中,不妨设想我们使用一个真实感强的合成数据集。假设在项目文件夹中有一个名为 transactions.csv 的电商数据集,包含订单 ID、用户 ID、购买时间戳和交易金额等真实业务数据。
拿到这样的新文件时,第一件事就是进行画像以了解其基本结构。无需自己编写样板 pandas 代码,直接在运行着 Codex 会话的终端中,输入如下提示即可:
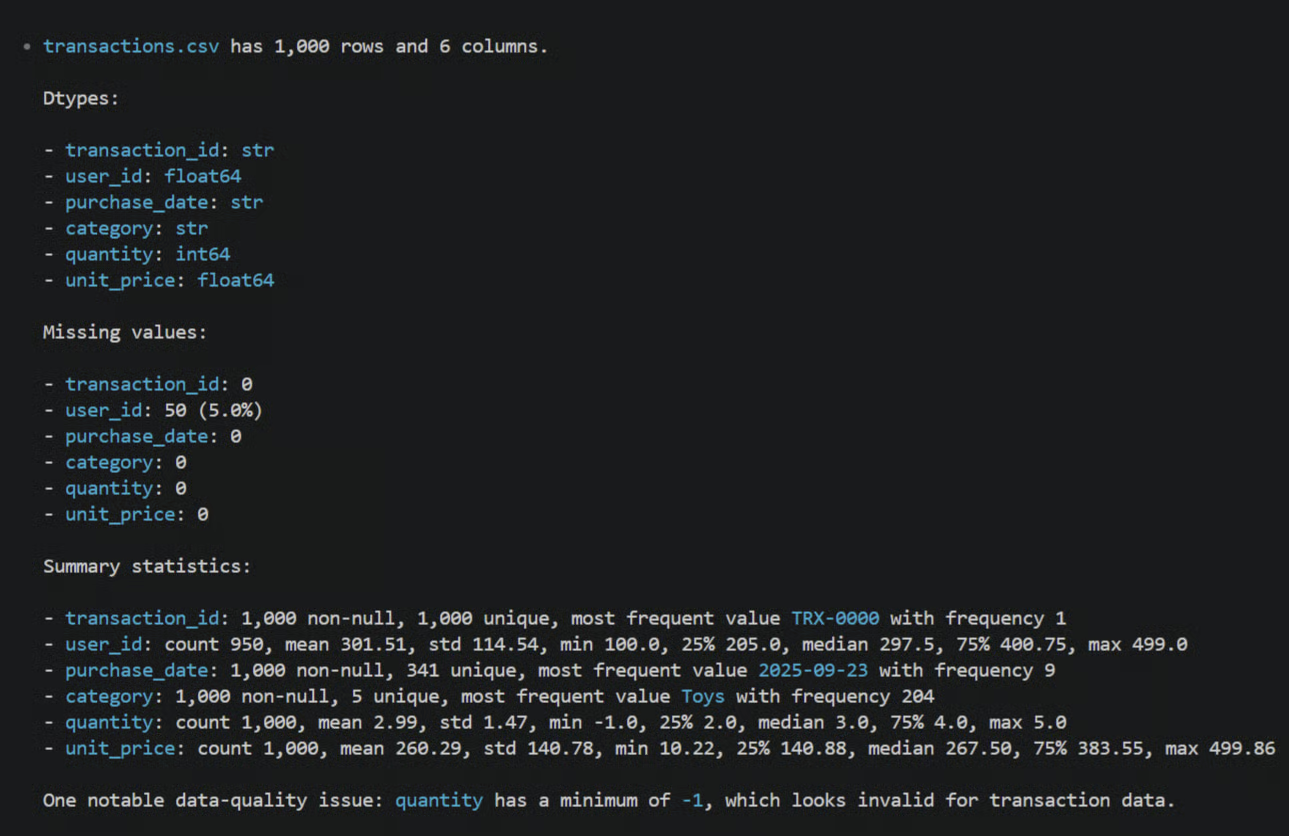
Profile the transactions.csv file. Show shape, dtypes, missing values, and summary statistics.按下回车后,Codex 会直接从本地文件系统读取 transactions.csv 的前几行数据。随后它会生成一段完整的 Python 脚本来执行画像,并在“建议”模式下询问您是否要运行。
您将立刻看到数据的精确形状、电商各列的数据类型,以及需要处理的缺失值数量(如下图示例),而无需亲自写一行代码。
终端中的数字固然有用,但最终您需要把数据可视化。只需用简明的英语描述,您就能生成复杂度不低的可视化。
例如,若您想从全局俯瞰电商业务,可以给 Codex 这样一个提示:
Create a matplotlib dashboard with 3 subplots showing revenue by month, product categories ranked by sales, and order distribution by day of week.这是个相当复杂的请求。但 Codex 会再次分析提示与数据文件,推断如何按日期分组并汇总收入,制定分步计划,并将其转化为稳健的 matplotlib 脚本来生成这些子图。
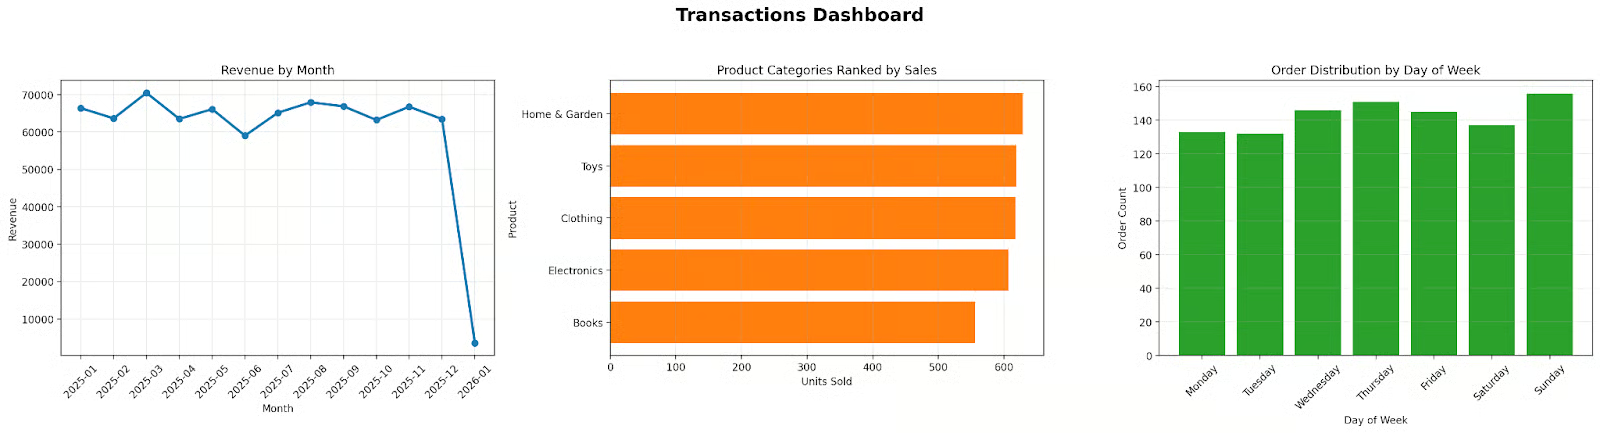
在与此类 AI 代理协作时,有一点至关重要:它本质上是一个迭代过程。Codex 给出第一版可视化代码建议时,您可以先批准执行看看效果。
也许第一版能画出图,但您注意到底部 x 轴标签重叠难读,或颜色过于鲜艳。您并不需要手动打开脚本修改 matplotlib 参数。
您只需给出后续提示,例如:“底部标签重叠,请将其旋转 45 度,并将图例颜色调柔和些。”随后 Codex 会优化脚本、重新运行,并给出更新后的精致看板。
在完成数据初探和早期探索后,您最终需要告别那些零散的临时脚本。
更理想的做法是构建可复现、模块化的代码。在数据领域,这通常意味着构建一条 ETL(抽取、转换与加载)管道。它是拉取数据、清洗整理并保存结果以供后续使用的标准方式。
为了演示其工作方式,我们使用一个非常实用的场景:从 CSV 文件中摄取同一份电商交易数据,清洗脏数据,计算一些业务汇总,然后将最终结果保存为一份整洁的新文件。
无需亲自编写所有样板架构,您可以使用 Codex CLI 根据高层描述搭好整个脚手架。
第一步是搭建项目结构。优秀的数据管道会拆分为多个文件,便于日后阅读与维护。您可以让 Codex 代理代劳。在终端中给出如下提示:
Create a project layout for an ETL pipeline. I need separate Python modules for extraction, transformation, and loading, plus a main entry point script to run them all.Codex 会在您的目录中创建这些文件。批准后查看文件树,您会看到类似如下的清晰专业架构:
etl_pipeline/
├──__init__.py
├── extract.py
├── transformation.py
└── loading.py
– run_etl.py
Codex 之所以选择这种特定架构,是为了实现关注点分离。读取数据的逻辑与数学和业务逻辑完全分离,这正是数据工程师应当组织代码的方式。
现在,来描述我们需要的数据转换。在 ETL 管道中,转换逻辑通常最难,但我们可以通过提示让 Codex 处理细节。假设我们需要清理缺失值,并计算每个订单带来的收入。
您可以在 CLI 中直接输入如下提示:
In transformation.py, write a function that takes the transactions data, drops any rows where the user ID is missing, and creates a new derived column called 'revenue' by multiplying the 'quantity' column by the 'unit_price' column.由于 Codex 可以读取 transactions.csv,它知道真实的列名。它不会去猜测然后写出 df['qty'] * df['price'] 这类代码并听天由命。它会查看文件,确认列名实际是 quantity 与 unit_price,并写出精确正确的 pandas 代码以保证脚本可用。
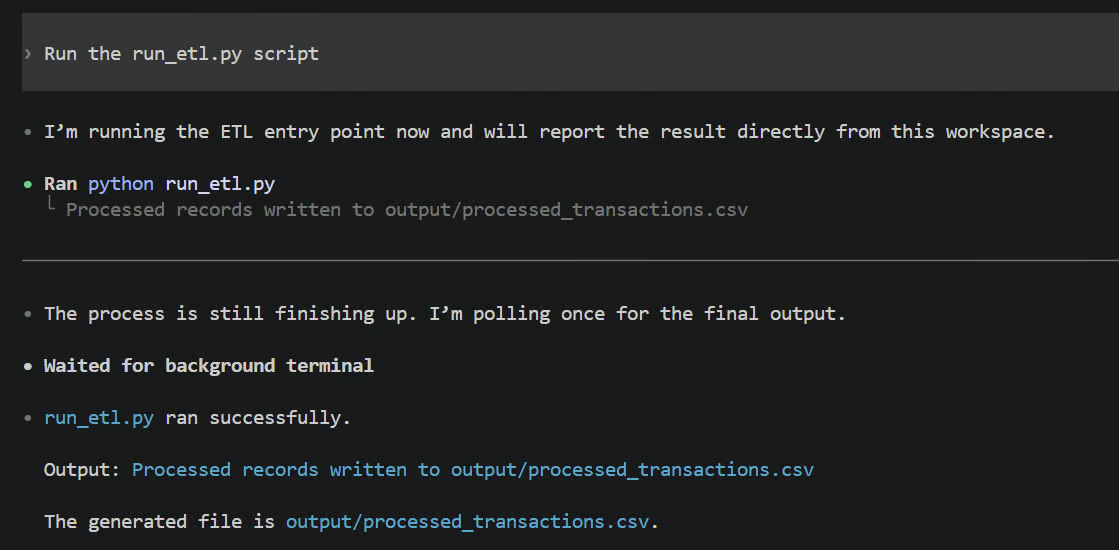
代码生成后,最后一步是端到端运行管道以确保其可用。您只需对 Codex 说,“运行 run_etl.py 脚本。”
运行时,您将在终端中看到所有输出,可能类似如下:
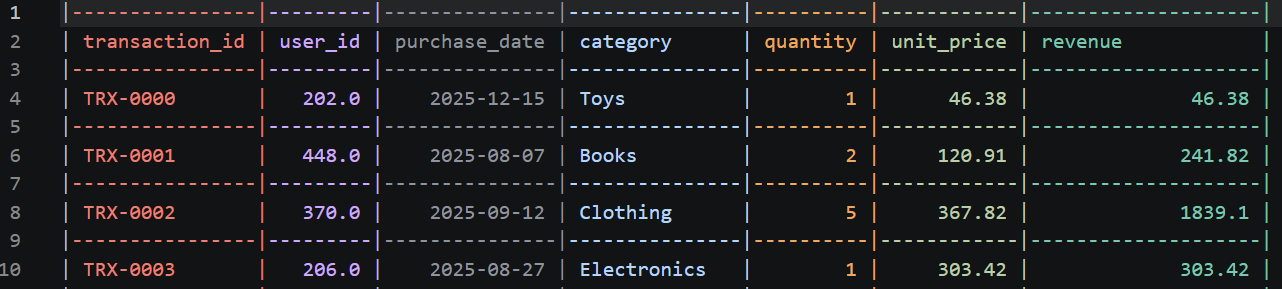
新的 processed_transactions.csv 应该大致如下所示:
在真实世界中,问题难免出现。也许某个数值列里潜藏了奇怪的字符串,导致 TypeError。发生这种情况时,无需慌张或复制错误到浏览器搜索。Codex CLI 会自动捕获错误,读取 Python 回溯,并常常当场提出修复建议以自我纠正代码。
这很好地体现了与 AI 编码代理协作的核心迭代循环:
这是一个持续的协作循环,比起手敲所有代码,能更快构建出可用的软件。
测试至关重要,以免您在生产中无意破坏功能,但这一步常常被跳过。
写测试很枯燥,尤其当您只是想从新数据集中快速获得洞见时,停下来写单元测试会让人感觉像是个巨大的负担。但有了就在终端旁的 Codex CLI,这道门槛基本被移除了。
如果您想为上一节的转换代码生成测试,甚至无需离开终端或打开空白文件。我们可以使用标准的 Python 测试框架 pytest。给 Codex 一个简单提示即可:
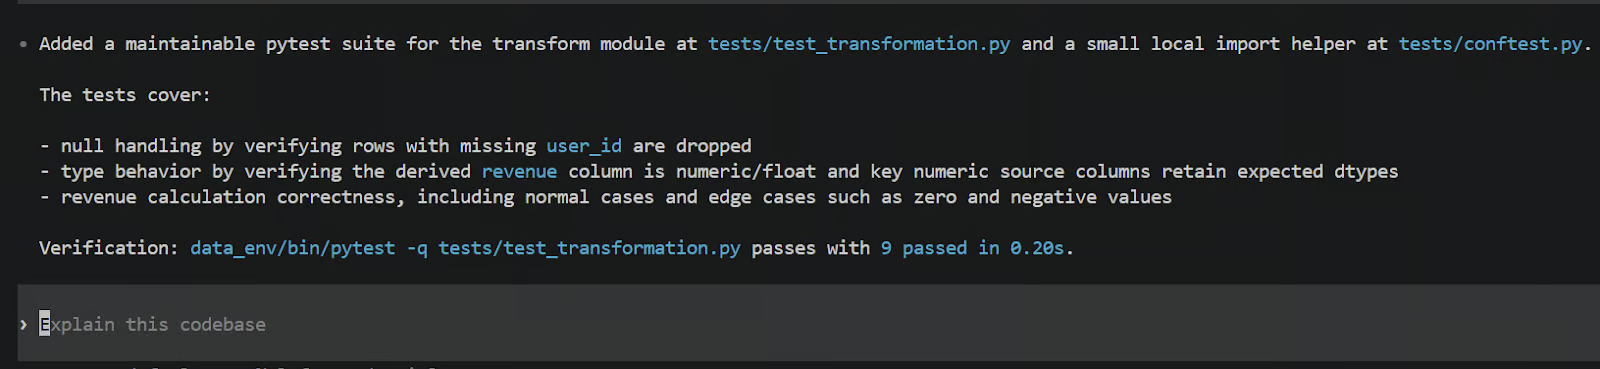
Write high-quality, maintainable pytest tests for the transform module. Test null handling, extreme edge cases like zeroes or negative values, type casting, and revenue calculation.Codex 会回头查看先前创建的 transformation.py 文件。它读取您的逻辑,理解函数应做什么,然后为您生成全新的测试文件。下图是 Codex 生成这些测试后,您在终端中可能看到的样子。
在我的案例中,它在新建的 tests 文件夹内生成了一个 test_transformation.py 脚本,用于检查指定的转换函数是否正确完成了工作。
Codex 不仅仅写通用断言,它还会创建非常贴近实际的小型合成数据输入(称为 fixtures),送入函数进行压力测试。它会有意构造边界情况,例如完全缺失用户 ID 的行,或负数的购买数量,以确保您的转换逻辑在这些奇怪且异常的场景下也能稳健正确地处理。
测试 Python 代码是一方面,但作为数据从业者,我们也需要测试流经代码的实际数据,这通常称为数据验证。在将数据交付给干系人或加载到看板前,您需要生成真实的断言来检查数据质量。
您可以演示这一点,让 Codex 生成一个特定的数据验证脚本。输入如下提示:
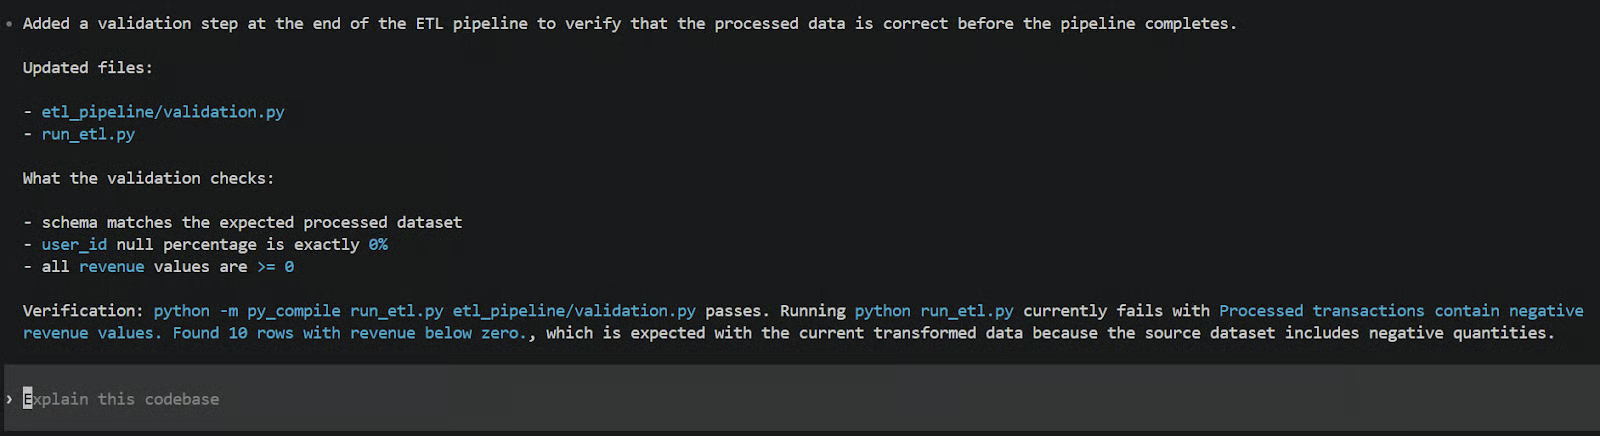
Create a data validation script that runs after the very end of the pipeline. It should check that the schema matches our expectations, ensure the null-percentage for user_id is exactly 0%, and verify that all revenue values are greater than or equal to zero.随后 Codex 会输出一个专门的验证脚本,作为项目的最后一道安全网。您可以轻松将其配置为在管道末尾作为最终后置步骤运行。
这样一来,如果原始 CSV 数据的结构在明天突然发生变化,或某个故障导致负收入值莫名出现,该脚本会立即捕捉并抛错,确保您的管道不会悄悄把坏数据传递给业务用户。
到目前为止,我们主要在讨论如何以交互方式使用 Codex CLI,通过对话往来完成工作。但对于希望把该工具融入日常工作流的数据从业者,还有一些更进阶的用法,基本可以让枯燥工作进入自动驾驶模式。
Jupyter Notebooks 非常适合前期玩数据和探索,但在需要可靠地在生产中运行代码时就不太理想。通常您需要花上数小时手动复制单元格、粘贴到 Python 文件中,并修复各种全局变量问题。
使用 Codex CLI,您只需把代理指向笔记本并让它替您做繁重工作。在终端中输入如下提示:
Refactor analysis.ipynb into a modular Python package with separate files for data loading, transformation, visualization, and a main.py entry point.在您批准后,Codex 会读取笔记本文件的 JSON 结构,提取实际的 Python 代码,忽略零散的输出日志,并对整体进行重组。
对比前后结构,会有很大不同。之前只有一个巨大的 analysis.ipynb 文件,所有内容纠缠在一起。
完成后,您会看到一个干净、专业的文件夹,其中包含独立的 data_loader.py、transformer.py 和 visualizer.py 文件(您的命名可能不同),并由 main.py 脚本整洁地串联起来。这一步可瞬间弥合混乱的探索性数据分析与真正面向生产的软件工程之间的鸿沟。
有时您并不想坐在那里与聊天界面互动。如果您在构建自动化管道,例如在与团队共享代码前运行的自动化检查,您需要 AI 在后台全自动完成工作。
这正是 codex exec 发挥作用的地方。它专为在脚本与非交互环境中运行 Codex 而设计,无需在每一步都征求您的许可。
举个实用例子,我们来快速跑个测试。我们可以用 codex exec 作为模拟的 CI/CD 检查,自动捕获/验证坏数据。
打开终端,输入如下命令:
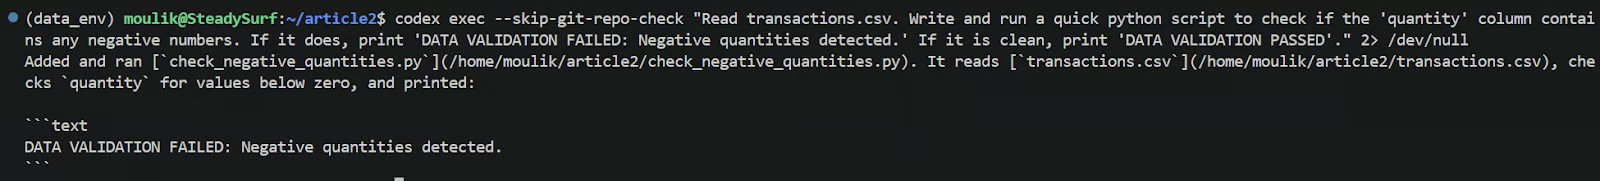
codex exec --skip-git-repo-check "Read transactions.csv. Write and run a quick python script to check if the 'quantity' column contains any negative numbers. If it does, print 'DATA VALIDATION FAILED: Negative quantities detected.' If it is clean, print 'DATA VALIDATION PASSED'." 2> /dev/null按下回车后,Codex 将以非交互方式运行。它不会打开常规的交互式聊天界面,审批行为取决于已配置的审批标志和默认值;除非您禁用审批,否则某些操作仍可能需要允许。更多信息建议阅读 Codex 文档。
它会快速编写验证脚本,在本地 CSV 文件上执行,然后将最终结果直接输出到您的终端标准输出,只要该目录被视为受信任且审批配置允许。您应能在控制台看到类似如下的输出:
该语句有诸多用例。想象一下在 pre-commit 钩子或 GitHub Actions 工作流中原样使用此命令。如果您的管道遇到缺列、存在 NaN 值或其他异常行为,Codex 都能当场捕捉,无需您亲自手写这些 PyTest 与验证脚本。
在用 AI 工具做数据工作时,您与代理的交互方式将直接影响返回的 Python 代码质量。以下是一些最佳实践,帮助您保持顺畅而专业的工作流。
首先要掌握的是如何写出有效提示。不能只说“清洗数据”就期待完美结果。以下是组织请求的方式:
要具体:需明确列名、所需的数据类型以及期望的输出格式。例如,不要含糊其辞,而应明确说明:“将 'purchase_date' 列转换为 datetime,并输出汇总后的 CSV。”
直接引用文件:一个很实用的小技巧是在提示中使用 @ 语法直接引用文件。输入 @transactions.csv 会强制 Codex 即刻读取该文件并纳入上下文。
拆解复杂任务:尤其重要的是,将任务拆分为更小的单元,而不要让 Codex 一次性处理一个超大提示。对于复杂任务,先用 Codex 的专用计划模式起草方案,然后按部就班执行,是更稳妥的做法。
如需更进一步提升提示工程能力,推荐学习我们的 Prompt Engineering with the OpenAI API 课程。
如前所述,CLI 提供不同审批模式,明确何时使用哪一种很重要。以下是使用指南:
最后,保持数据工作流可复现对任何数据从业者都至关重要。一个重要准则是始终在已初始化的 Git 仓库中运行 Codex。由于Codex 会在本机写入并编辑文件,让 Git 追踪这些变更意味着您可以清楚地看到 AI 做了什么,并在出现问题时轻松回滚。
还应务必将我们先前创建的 AGENTS.md 与项目代码一同提交。这样,当团队中的其他数据科学家克隆您的仓库并打开 Codex 时,整个团队都能遵循相同的编码标准与指令。
同样适用于您为个别任务定义的任何 代理技能。如需灵感,请参阅我们关于上百条 顶级代理技能 的指南,适用于 Codex 及其他代理式编码工具。
如果您在数日内进行一项繁重分析,没必要每天早上重头开始。您只需在终端中使用 codex resume 命令即可继续多会话数据项目。它会直接载入您先前的聊天,不会丢失您与代理昨日协作的宝贵上下文。
如果您在数日内进行一项繁重分析,您也不必每天都从头开始。只需在终端中使用 codex resume 命令继续多会话数据项目。它会在该项目中重新打开您上一次的 Codex 会话,让您无缝衔接之前的进度,同时保留先前的对话、计划与文件变更(受制于常规的模型与历史记录限制)。
想了解更多代理式编码最佳实践,也可查看我们的 Claude Code 最佳实践指南。尽管 Claude Code 与 Codex 存在差异,正如我们在 Codex vs Claude Code 的比较中指出的,许多基础理念同样适用于 Codex。
我们已针对您的数据工作与本地 Python 环境完成了 Codex CLI 的设置。随后,我们演示了如何从零生成探索性数据分析脚本、构建可复现的 ETL 数据管道、编写(经常被忽略的)自动化转换测试,并探索自动化高重复性日常数据任务的进阶方法。
最重要的是,我们全程都在命令行中完成,无需在浏览器与终端之间来回切换。Codex CLI 有效弥合了探索性数据分析的混乱与真正面向生产的数据工程之间那道令人沮丧的鸿沟。
如果您有兴趣学习如何用 Codex CLI 构建更复杂的代理,建议阅读我们的 Codex CLI MCP 教程。它将带您一步步创建一个金融投资组合仪表板代理。
AI 课程
学习路径
课程
实践并学习路径你的进步。
使用 Google 继续