
लर्निंग पाथ
एआई एजेंट मूलभूत बातें
6 घंटा
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंयदि आप डेटा प्रोफेशनल हैं, तो संभवतः आप रोज़ कई दोहराए जाने वाले कोडिंग कार्य संभालते हैं। जैसे बिल्कुल नए डेटासेट्स का प्रोफाइलिंग करना, शून्य से डेटा पाइपलाइन्स बनाना, या डेटा ट्रांसफ़ॉर्मेशन के टेस्ट मैन्युअली लिखना। ऐसे कार्य आवश्यक होते हैं, लेकिन इनमें काफी समय लग जाता है।
पर यदि आपका टर्मिनल ही वह सारा रिपेटिटिव बोयलरप्लेट कोड मैनेज और लिख दे, ताकि आप अपनी ऊर्जा ब्रेनस्टॉर्मिंग और निर्णय लेने वाले कामों पर केंद्रित कर सकें? यहीं OpenAI का Codex-CLI काम आता है। यह एक अत्यंत सक्षम AI कोडिंग एजेंट है जो सीधे आपके कमांड लाइन में बना होता है, और जैसा हम देखेंगे, यह डेटा वर्कफ़्लोज़ को सुव्यवस्थित करने में बेहतरीन है।
इस ट्यूटोरियल में, हम देखेंगे कि डेटा विश्लेषक और वैज्ञानिक Codex-CLI का उपयोग करके अपने सबसे आम रोज़मर्रा के डेटा कार्यों को कैसे तेज़ कर सकते हैं। हम शुरुआती एक्सप्लोरेटरी डेटा एनालिसिस से लेकर पूरी तरह से तैयार डेटा पाइपलाइन्स बनाने तक, और यहां तक कि आपके ट्रांसफ़ॉर्मेशन्स के लिए ऑटोमेटेड टेस्ट बनाने तक—यह सब कुछ टर्मिनल से ही—कवर करेंगे।
यदि आप एजेंटिक AI सिस्टम्स बनाने के बारे में अधिक जानना चाहते हैं, तो मैं हमारी AI Agent Fundamentals स्किल ट्रैक में नामांकन करने की अत्यधिक अनुशंसा करता/करती हूँ, जिसमें आपको आवश्यक सब कुछ मिलता है।
तो, पहले समझते हैं कि Codex CLI है क्या। अपने मूल में, Codex CLI एक ओपन‑सोर्स, टर्मिनल‑आधारित कोडिंग एजेंट है, जिसे OpenAI ने विकसित किया है।
इसे Rust प्रोग्रामिंग भाषा से बनाया गया है, जो इसे काफी तेज़ और कुशल बनाती है। लेकिन सबसे महत्वपूर्ण बात यह है कि यह सीधे आपके कमांड लाइन से संचालित होता है, जिससे इसे आपकी फाइलें पढ़ने, आपका कोड संपादित करने, और यहां तक कि मशीन पर लोकली कमांड्स चलाने की क्षमता मिलती है।
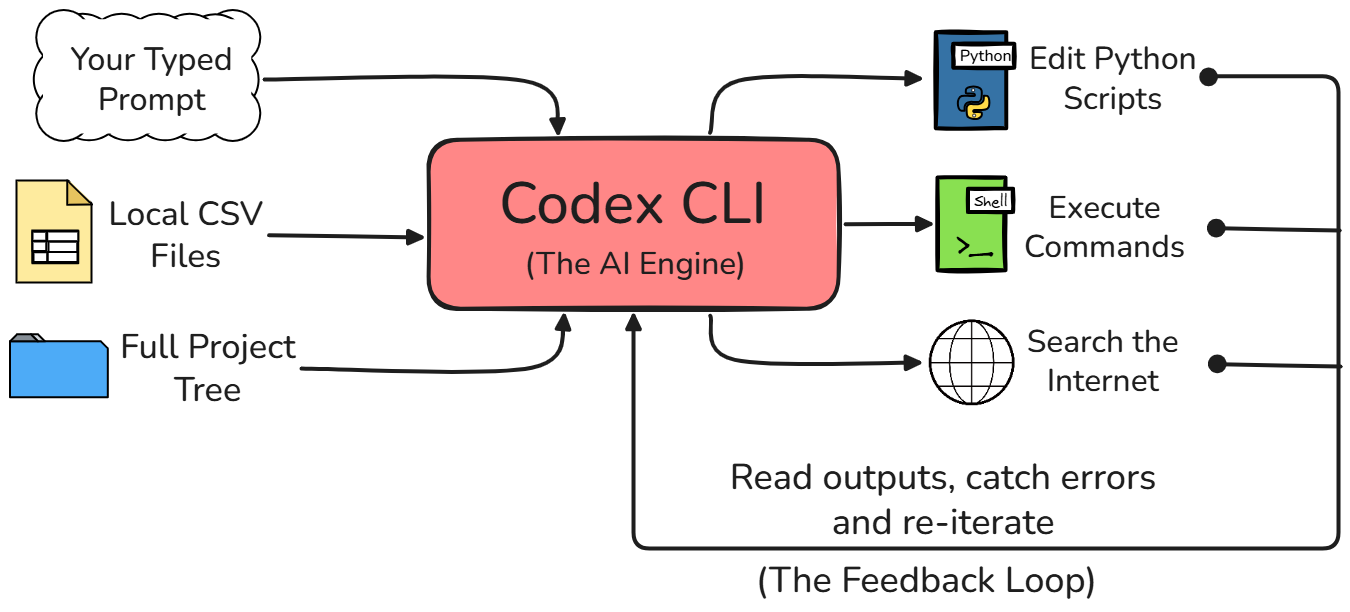
भले ही आप अपने काम के लिए ChatGPT के मानक वेब इंटरफ़ेस के आदी हों, Codex CLI काफी अलग है। वेब इंटरफ़ेस उपयोग करने पर AI मॉडल आपके काम के वातावरण से पूरी तरह अलग-थलग रहता है।
Codex CLI के साथ, एजेंट को वास्तव में आपके लोकल फाइल सिस्टम तक सीधी पहुंच होती है। यह Python स्क्रिप्ट्स चला सकता है, आउटपुट या लौटे किसी भी एरर को देख सकता है, और बिना आपके सब कुछ पहले समझाने के, आपके पूरे प्रोजेक्ट स्ट्रक्चर की पूरी जागरूकता बनाए रखता है।
|
वर्कफ़्लो चरण / फीचर |
ChatGPT (वेब ब्राउज़र) |
Codex CLI (टर्मिनल) |
|
डेटा तक पहुँच |
आपको अपना CSV फाइल मैन्युअली खोलकर कच्चे डेटा की कुछ पंक्तियाँ कॉपी‑पेस्ट करनी पड़ती हैं ताकि वह समझ सके। |
यह आपके लोकल फाइल सिस्टम से सीधे आपका CSV फाइल स्वयं खोलकर पढ़ सकता है। |
|
कोड निष्पादन |
आपको जेनरेटेड स्क्रिप्ट को मैन्युअली कॉपी करके अपने लोकल कोड एडिटर में पेस्ट करना पड़ता है, और फिर स्वयं चलाना होता है। |
यह आवश्यक Python स्क्रिप्ट स्वतः लिखता है, चलाता है, और अंतिम आउटपुट यहीं टर्मिनल में दिखाता है। |
|
कुल अनुभव |
काफ़ी थकाऊ आगे‑पीछे, विंडोज़ के बीच कॉपी‑पेस्ट करने की ज़रूरत होती है। |
सब कुछ एक ही, निरंतर और सहज फ्लो में टर्मिनल के भीतर होता है। |
अब, स्वाभाविक है, क्योंकि Codex एजेंट आपके फाइल्स को सीधे एडिट करने और आपकी मशीन पर कमांड्स चलाने की शक्ति रखता है, यह अलग‑अलग अप्रूवल मोड्स के साथ आता है ताकि आप हमेशा नियंत्रण में रहें। तीन अप्रूवल मोड्स हैं:
शुरुआत में, मैं Read-only मोड से आरंभ करने और वर्कफ़्लो पर भरोसा होने पर आगे बढ़ने की सलाह देता/देती हूँ।
आप चल रही Codex सत्र में /permissions का उपयोग करके अप्रूवल मोड्स बदल सकते हैं। Read-only से Auto में सहज होने पर जाना इसी तरह सबसे आसान है।
/permissionsयदि आप शुरुआत से ही सख्त मोड में Codex शुरू करना चाहते हैं, तो लॉन्च करते समय सैंडबॉक्स और अप्रूवल पॉलिसी फ्लैग्स सेट कर सकते हैं। उदाहरण के लिए, यह एक रूढ़िवादी read-only सेटअप में शुरू करता है जो ज़रूरत पड़ने पर फिर भी प्रॉम्प्ट करता है।
codex --sandbox read-only --ask-for-approval on-requestइस ट्यूटोरियल के साथ सही तरीके से चलने के लिए कुछ पूर्वापेक्षाएँ आवश्यक हैं।
सबसे पहले, आपको अपनी मशीन पर Codex CLI इंस्टॉल करना होगा। इसके लिए, अपना टर्मिनल खोलें और इस कमांड का उपयोग करके CLI को सिस्टम पर ग्लोबली इंस्टॉल करें:
npm install -g @openai/codexअगला चरण आपके अकाउंट को प्रमाणित करना है, ताकि टूल को आपकी पहचान पता हो। आप अपने टर्मिनल में codex टाइप करके यह सत्यापित कर सकते हैं कि सब कुछ सही से इंस्टॉल हो गया है और एजेंट को पहली बार लॉन्च कर सकते हैं। यह कुछ ऐसा दिखाएगा:
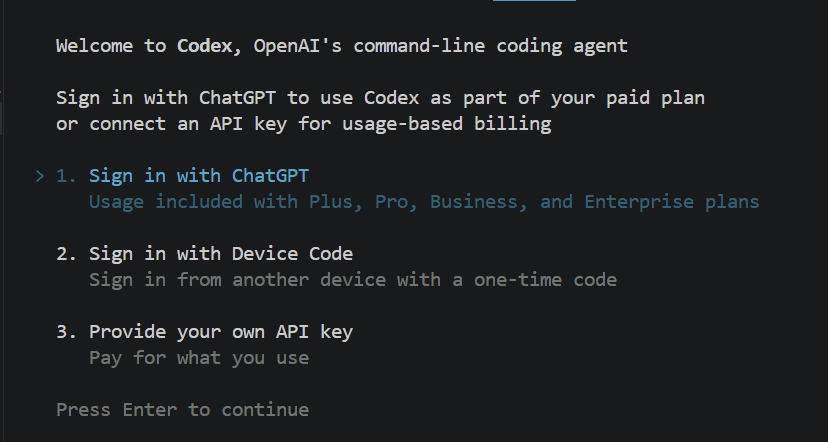
एंटर दबाते ही, यह एक ब्राउज़र विंडो खोलेगा जहाँ आपको अपने ChatGPT अकाउंट से लॉग इन करने के लिए कहा जाएगा। लॉगिन के बाद, आप टूल उपयोग के लिए तैयार हैं।
यदि आपके पास पेड ChatGPT सब्सक्रिप्शन नहीं है और आप API key का उपयोग करना चाहते हैं, तो पे‑पर‑यूज़ विकल्प भी है। आप OpenAI कंसोल से key प्राप्त कर सकते हैं।
AI से डेटा विश्लेषण कराने से पहले, यह महत्वपूर्ण है कि हम अपना Python डेटा एनवायरनमेंट सही तरह से कॉन्फ़िगर करें। यह इसलिए आवश्यक है क्योंकि Codex CLI उसी एनवायरनमेंट में काम करता है जिसमें वह चल रहा होता है। इसलिए, यदि एजेंट को pandas, scikit-learn, या matplotlib जैसी डेटा साइंस लाइब्रेरीज़ का उपयोग करने वाली स्क्रिप्ट लिखनी है, तो सुनिश्चित करें कि वे लाइब्रेरीज़ इंस्टॉल हों और उपलब्ध हों।
हम Codex लॉन्च करने से पहले एक Python वर्चुअल एनवायरनमेंट सक्रिय करके यह कर सकते हैं। यहाँ एक सैंपल सेटअप स्क्रिप्ट है, जिसमें वे सटीक कमांड्स हैं जिन्हें आप अपने टर्मिनल में चलाकर वर्चुअल एनवायरनमेंट बना सकते हैं, आवश्यक डेटा पैकेज इंस्टॉल कर सकते हैं, उसे सक्रिय कर सकते हैं, और फिर एजेंट लॉन्च कर सकते हैं:
python3 -m venv data_env
source data_env/bin/activate
pip install pandas scikit-learn matplotlib
codexअपने प्रोजेक्ट की सेटिंग में एक और महत्वपूर्ण कदम है मुख्य प्रोजेक्ट फ़ोल्डर में AGENTS.md नाम की फाइल बनाना। इस फाइल को आप स्थायी निर्देशों के सेट के रूप में देख सकते हैं जिसे Codex एजेंट हर बार आपके प्रोजेक्ट को खोलते ही स्वतः पढ़ता है। यह AI को बताती है कि इस विशेष वर्कस्पेस के लिए आप उससे कैसे व्यवहार और किस तरह का कोड लिखने की अपेक्षा रखते हैं।
डेटा कार्य के लिए, हम चाहते हैं कि AI द्वारा जेनरेटेड कोड साफ़, पठनीय और प्रोफ़ेशनल हो। तो यहाँ एक सैंपल AGENTS.md फाइल है जो खासतौर पर डेटा प्रोजेक्ट के लिए तैयार की गई है। आप बस यह फाइल बनाकर इसके अंदर यह टेक्स्ट पेस्ट कर सकते हैं:
# Data Project Guidelines


When writing Python code for this project, please strictly follow these rules:
- Enforce PEP 8 formatting standards for all Python code.
- Always use highly descriptive variable names. Do not use generic, lazy names like df, data, x, or y. Instead, use specific names like transaction_data or revenue_series.
- Prefer pandas best practices, such as using vectorized operations instead of iterating through rows.
- Generate clear, descriptive docstrings for every single function.
- Always include Python type hints for function arguments and return values.
चूंकि यह फाइल हर बार पढ़ी जाएगी, कार्य से स्वतंत्र, इसलिए इसे संक्षिप्त रखना और केवल वे निर्देश देना सर्वश्रेष्ठ अभ्यास है जो हर प्रॉम्प्ट पर लागू होते हैं। अधिक विशिष्ट निर्देशों के लिए आपको skills का उपयोग करना चाहिए।
अब वास्तविक डेटा कार्य पर आते हैं, हम एक्सप्लोरेटरी डेटा एनालिसिस या EDA से शुरू करेंगे। जैसा कि आप जानते हैं, लगभग हर नए डेटा प्रोजेक्ट में यह सबसे आम शुरुआती बिंदु होता है। मॉडल्स या पाइपलाइन्स बनाने से पहले आपको अपने डेटा का स्वरूप समझना होता है।
यहाँ अच्छी बात यह है कि Codex CLI के साथ, एक सरल प्राकृतिक‑भाषा प्रॉम्प्ट आपके लिए पूरा, काम करने वाला EDA स्क्रिप्ट तैयार कर सकता है।
परिदृश्य: आज के उदाहरणों के लिए, मान लें कि हम एक यथार्थपरक, सिंथेटिक डेटासेट के साथ काम कर रहे हैं। मान लीजिए हमारे पास transactions.csv नाम का एक ई‑कॉमर्स डेटासेट हमारे प्रोजेक्ट फ़ोल्डर में मौजूद है। इसमें ऑर्डर IDs, यूज़र IDs, परचेज टाइमस्टैम्प्स, और ट्रांज़ैक्शन अमाउंट्स जैसे यथार्थपरक बिज़नेस डेटा भरे हुए हैं।
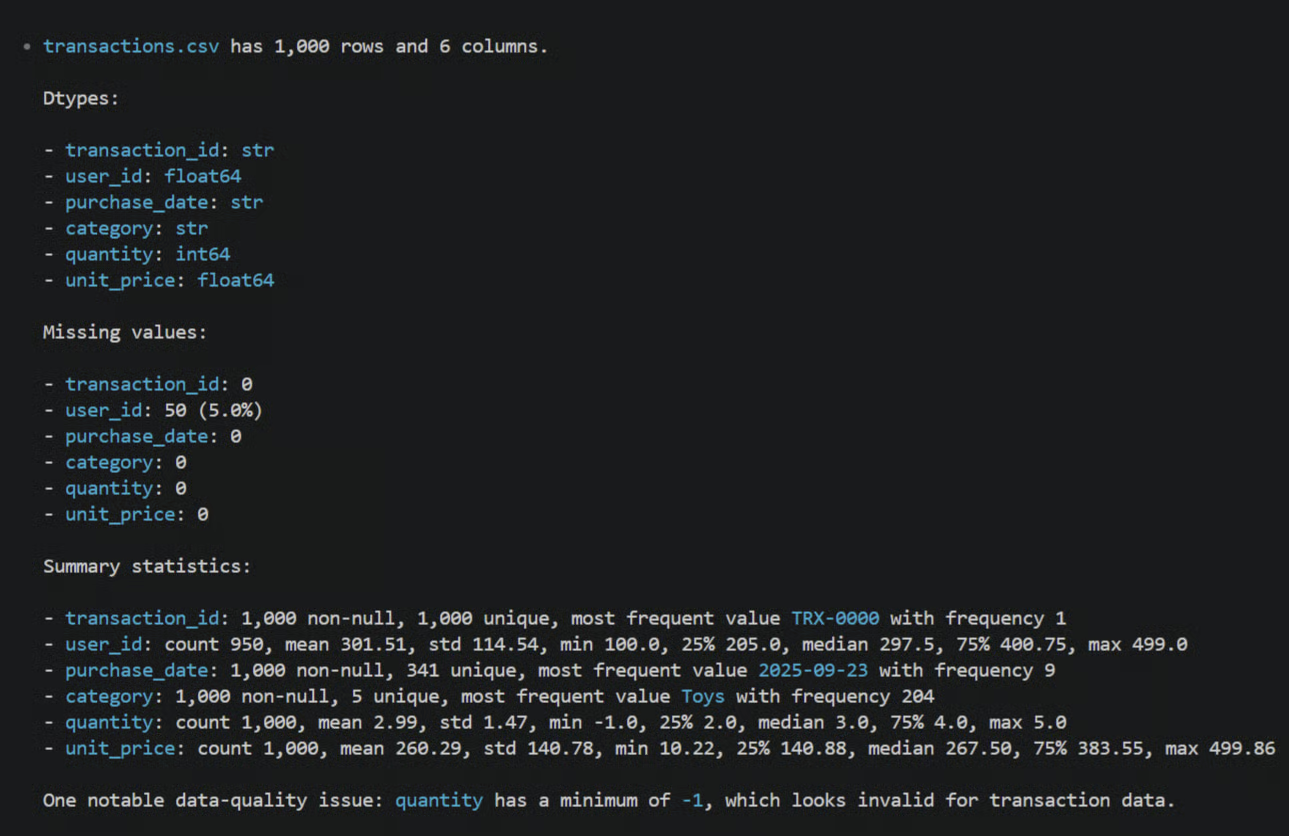
ऐसी नई फाइल मिलने पर, सबसे पहले आप इसकी बुनियादी संरचना समझने के लिए इसका प्रोफाइल बनाना चाहेंगे। खुद बोयलरप्लेट pandas कोड लिखने के बजाय, आप जिस टर्मिनल में आपका Codex सत्र चल रहा है, उसमें ठीक ऐसा एक प्रॉम्प्ट टाइप कर सकते हैं:
Profile the transactions.csv file. Show shape, dtypes, missing values, and summary statistics.एंटर दबाने पर, Codex आपके transactions.csv फाइल की शुरुआती कुछ पंक्तियाँ सीधे आपके लोकल फाइल सिस्टम से पढ़ता है। फिर यह प्रोफाइलिंग करने के लिए एक पूरा Python स्क्रिप्ट जेनरेट करेगा, और "suggest" मोड में आपसे पूछेगा कि क्या इसे चलाना है।
आप तुरंत डेटा का सटीक shape, आपके विशेष ई‑कॉमर्स कॉलम्स के डेटा टाइप्स, और कितने मिसिंग वैल्यूज़ हैं (नीचे उदाहरण) देख लेंगे—वह भी बिना खुद एक भी लाइन कोड लिखे।
टर्मिनल में नंबर अच्छे हैं, पर अंततः आपको डेटा को विज़ुअली देखना भी पड़ता है। आप केवल अपनी ज़रूरत को साधारण अंग्रेज़ी में बताकर आश्चर्यजनक रूप से जटिल विज़ुअलाइज़ेशन जेनरेट कर सकते हैं।
उदाहरण के लिए, यदि आप अपने ई‑कॉमर्स बिज़नेस का बर्ड्स‑आई व्यू चाहते हैं, तो आप Codex को ऐसा प्रॉम्प्ट दे सकते हैं:
Create a matplotlib dashboard with 3 subplots showing revenue by month, product categories ranked by sales, and order distribution by day of week.यह काफ़ी जटिल अनुरोध है। लेकिन Codex प्रॉम्प्ट और आपके डेटा फाइल दोनों का विश्लेषण करेगा, तारीखों को कैसे ग्रुप करना है और रेवेन्यू को कैसे जोड़ना है यह तय करेगा, चरणबद्ध योजना बनाएगा, और ठीक वही सबप्लॉट्स जेनरेट करने के लिए एक मजबूत matplotlib स्क्रिप्ट में बदलेगा।
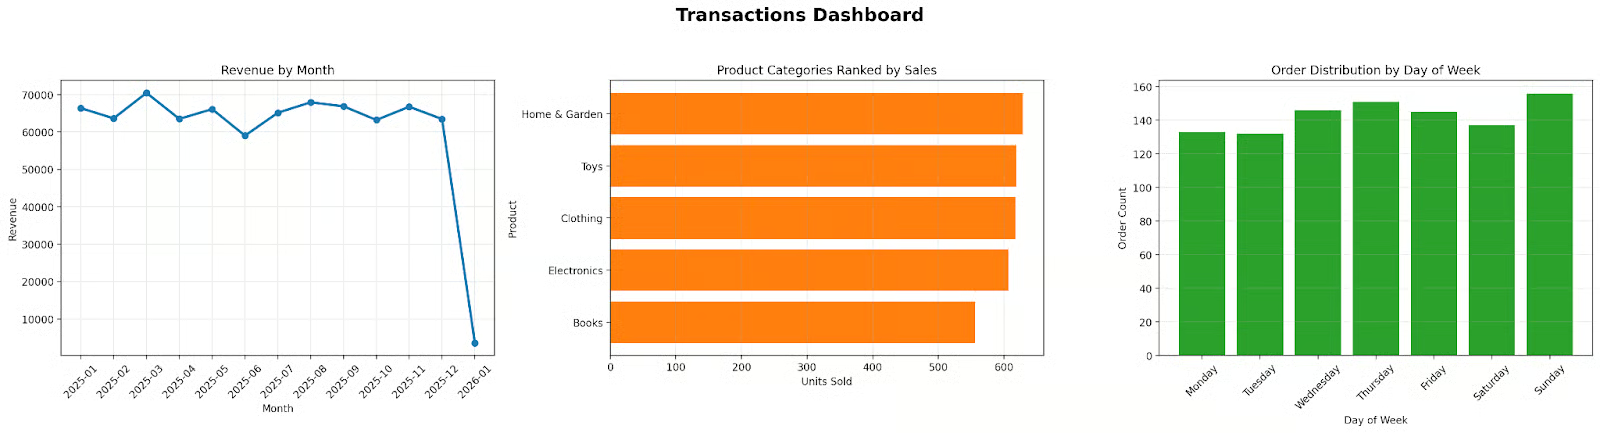
अब, ऐसे AI एजेंट्स के साथ काम करने का एक बहुत ही महत्वपूर्ण बिंदु है: यह स्वभावतः एक आवर्ती (iterative) प्रक्रिया है। जब Codex विज़ुअलाइज़ेशन कोड का पहला संस्करण सुझाए, तो उसे चलाकर देख लें कि वह कैसा दिखता है।
संभव है पहला संस्करण चार्ट तो बना दे, लेकिन आप देखें कि x‑अक्ष के लेबल्स आपस में चढ़ रहे हैं और पढ़ना मुश्किल है, या रंग बहुत चमकीले हैं। आपको स्क्रिप्ट खोलकर matplotlib पैरामीटर्स मैन्युअली ठीक करने की ज़रूरत नहीं है।
बस एक फॉलो‑अप प्रॉम्प्ट दें, जैसे, "नीचे के लेबल्स ओवरलैप हो रहे हैं, कृपया उन्हें 45 डिग्री घुमा दें और लेजेंड के रंग हल्के कर दें।" Codex स्क्रिप्ट को परिष्कृत करेगा, फिर चलाएगा, और आपको अपडेटेड, पॉलिश्ड डैशबोर्ड देगा।
तो, जब आप डेटा के साथ खेलना और शुरुआती एक्सप्लोरेटरी एनालिसिस पूरा कर लें, तो अंततः आपको उन उलझे हुए, ऐड‑हॉक स्क्रिप्ट्स से आगे बढ़ना होता है।
वास्तव में आपको जो चाहिए, वह है वास्तविक, पुनरुत्पादनीय, मॉड्यूलर कोड। डेटा जगत में, इसका मतलब प्रायः ETL (Extract, Transform, Load) पाइपलाइन बनाना होता है। यह आपका डेटा लाने, उसे साफ़ करने, और परिणामों को आगे उपयोग के लिए सहेजने का मानक तरीका है।
यह दिखाने के लिए कि यह कैसे काम करता है, हम एक व्यावहारिक परिदृश्य लेंगे। हम उसी CSV फाइल से ई‑कॉमर्स ट्रांज़ैक्शन डेटा इनजेस्ट करना चाहते हैं, कोई भी गंदा डेटा साफ़ करना चाहते हैं, कुछ बिज़नेस एग्रीगेशन्स निकालना चाहते हैं, और फिर अंतिम नतीजों को एक नए, साफ़ फाइल में सहेजना चाहते हैं।
यह सारा बोयलरप्लेट आर्किटेक्चर खुद लिखने के बजाय, आप Codex CLI का उपयोग करके उच्च‑स्तरीय विवरण से पूरी संरचना स्कैफ़ोल्ड करवा सकते हैं।
सबसे पहला कदम वास्तविक प्रोजेक्ट संरचना सेट करना है। अच्छी डेटा पाइपलाइन अलग‑अलग फाइलों में विभाजित होती है, ताकि बाद में पढ़ना और मेंटेन करना आसान हो। आप यह मेहनत Codex एजेंट से करवा सकते हैं। टर्मिनल में आप ऐसा प्रॉम्प्ट देंगे:
Create a project layout for an ETL pipeline. I need separate Python modules for extraction, transformation, and loading, plus a main entry point script to run them all.Codex आपके डायरेक्टरी में वे फाइलें बना देगा। एक्शन मंज़ूर करने के बाद यदि आप फाइल ट्री देखें, तो आपको कुछ ऐसा साफ़, प्रोफेशनल आर्किटेक्चर दिखेगा:
etl_pipeline/
├──__init__.py
├── extract.py
├── transformation.py
└── loading.py
– run_etl.py
Codex यह विशिष्ट आर्किटेक्चर इसलिए चुनता है क्योंकि यह आपके कोड की जिम्मेदारियों को अलग करता है। आपका डेटा‑रीडिंग लॉजिक पूरी तरह से आपके गणित और बिज़नेस लॉजिक से अलग रहता है, जो बिल्कुल वही है जैसा डेटा इंजीनियर्स को अपना काम स्ट्रक्चर करना चाहिए।
अब, वह ट्रांसफ़ॉर्मेशन बताते हैं जो हम अपने डेटा पर चाहते हैं। ETL पाइपलाइन में ट्रांसफ़ॉर्मेशन लॉजिक आमतौर पर सबसे कठिन होता है, पर हम Codex को विशिष्टताओं को संभालने के लिए प्रॉम्प्ट कर सकते हैं। मान लें कि हमें कुछ मिसिंग वैल्यूज़ साफ़ करनी हैं और प्रत्येक ऑर्डर ने कितना पैसा बनाया, यह निकालना है।
आप CLI में सीधे ऐसा प्रॉम्प्ट टाइप कर सकते हैं:
In transformation.py, write a function that takes the transactions data, drops any rows where the user ID is missing, and creates a new derived column called 'revenue' by multiplying the 'quantity' column by the 'unit_price' column.क्योंकि Codex आपका transactions.csv फाइल पढ़ सकता है, उसे असल कॉलम नाम पता होते हैं। यह अंदाज़ा लगाकर df['qty'] * df['price'] जैसा नहीं लिखेगा। यह आपकी फाइल देखकर समझेगा कि कॉलम्स वास्तव में quantity और unit_price हैं, और वही सही pandas कोड लिखेगा जिससे स्क्रिप्ट काम करे।
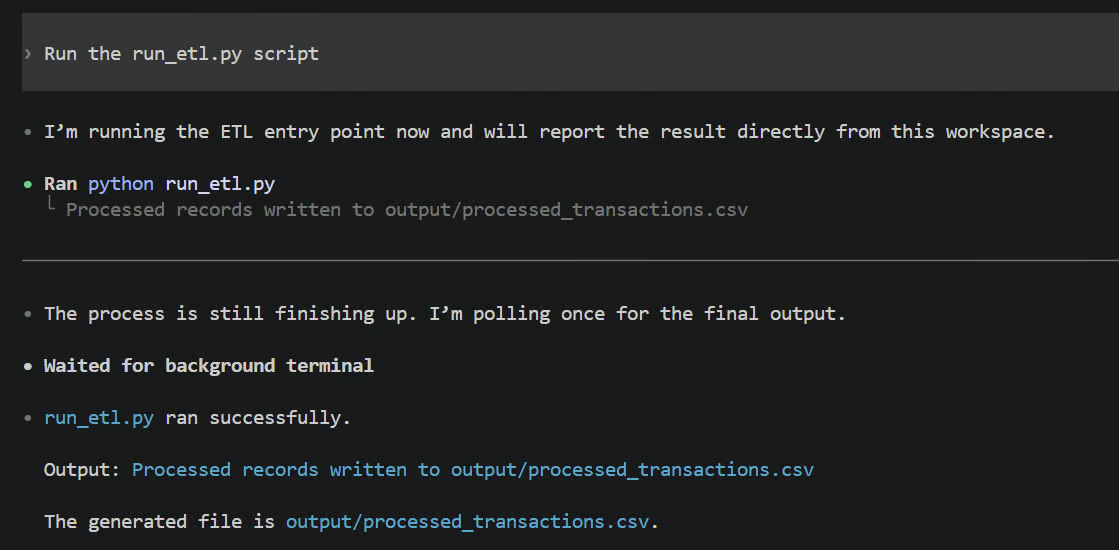
कोड जेनरेट होने के बाद, अंतिम कदम है पाइपलाइन को एंड‑टू‑एंड चलाकर सुनिश्चित करना कि सब कुछ काम कर रहा है। आप बस Codex से कहें, "run_etl.py स्क्रिप्ट चलाएँ।"
जब यह चलेगी, तो सारा टर्मिनल आउटपुट यहीं सामने प्रिंट होता दिखेगा, और यह कुछ ऐसा दिख सकता है:
नई processed_transactions.csv कुछ ऐसी दिखनी चाहिए:
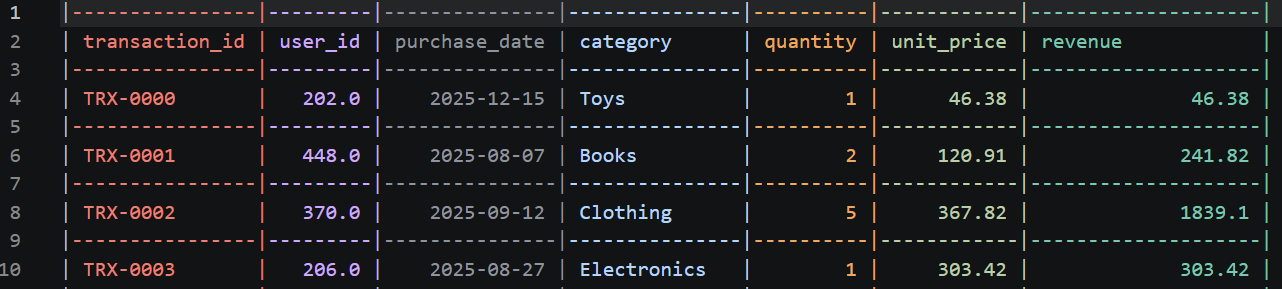
अब, वास्तविक दुनिया में चीज़ें टूटती हैं। हो सकता है किसी न्यूमेरिक कॉलम में छिपा कोई अजीब स्ट्रिंग वैल्यू TypeError का कारण बने। ऐसा होने पर घबराने या एरर को वेब ब्राउज़र में कॉपी‑पेस्ट करने की ज़रूरत नहीं है। Codex CLI स्वतः एरर पकड़ लेगा, Python ट्रेसबैक पढ़ेगा, और अक्सर उसी वक्त सुधार का प्रस्ताव देकर अपना कोड स्वयं ठीक कर लेगा।
यह AI कोडिंग एजेंट के साथ काम करने के मूल आवर्ती लूप को रौशन करता है:
यह एक सतत, सहयोगी लूप है जो हाथ से टाइप करने की तुलना में कहीं तेज़ी से काम करने वाला सॉफ़्टवेयर बनाता है।
अपने कोड का परीक्षण करना बिल्कुल महत्वपूर्ण है ताकि आप प्रोडक्शन में अनजाने में चीज़ें न तोड़ दें, लेकिन यह वही कदम है जो लगभग हमेशा छूट जाता है।
टेस्ट लिखना उबाऊ लगता है, खासकर जब आप किसी नए डेटासेट से केवल त्वरित इनसाइट्स चाहते हैं; सब कुछ रोककर यूनिट टेस्ट लिखना बड़ा बोझ लगता है। लेकिन आपके टर्मिनल में Codex CLI होने से यह बाधा लगभग हट जाती है।
यदि आप पिछले सेक्शन में लिखे ट्रांसफ़ॉर्मेशन कोड के लिए टेस्ट जेनरेट करना चाहते हैं, तो आपको टर्मिनल छोड़ने या खाली फाइल खोलने की ज़रूरत भी नहीं। हम pytest जैसे मानक Python टेस्टिंग फ्रेमवर्क का उपयोग कर सकते हैं। आप Codex को ऐसा सरल प्रॉम्प्ट दें:
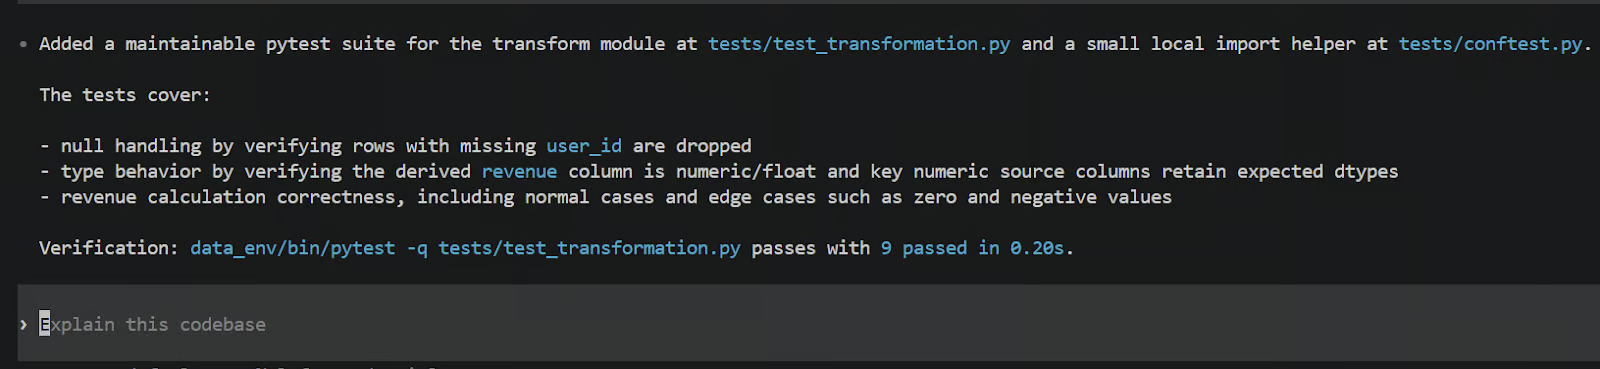
Write high-quality, maintainable pytest tests for the transform module. Test null handling, extreme edge cases like zeroes or negative values, type casting, and revenue calculation.Codex वापस जाकर पहले बनाया transformation.py फाइल देखेगा। यह आपकी लॉजिक पढ़ेगा, समझेगा कि फ़ंक्शन्स क्या करने चाहिए, और फिर आपके लिए एक नया टेस्ट फाइल जेनरेट करेगा। नीचे वह दिखाया है जो Codex द्वारा टेस्ट जेनरेट करने के बाद आपके टर्मिनल में दिख सकता है।
मेरे केस में, इसने एक नया test_transformation.py स्क्रिप्ट एक नए tests फ़ोल्डर में बनाया, जिसका काम निर्दिष्ट ट्रांसफ़ॉर्मेशन फ़ंक्शन्स के सही ढंग से काम करने की जाँच करना है।
Codex केवल जनरिक एसरशन्स नहीं लिखता, बल्कि बहुत वास्तविक, छोटे सिंथेटिक डेटा इनपुट्स (fixtures) बनाता है जिन्हें वह आपके फ़ंक्शन्स में फीड करके उन्हें स्ट्रेस‑टेस्ट करता है। यह जानबूझकर एज केस बनाता है, जैसे पूरी तरह गायब user IDs या नेगेटिव परचेज क्वांटिटीज़, ताकि यह सुनिश्चित किया जा सके कि आपका ट्रांसफ़ॉर्मेशन लॉजिक उन अजीब, टूटे हुए परिदृश्यों को भी मज़बूती से और सही ढंग से संभाले।
Python कोड का परीक्षण एक बात है, लेकिन डेटा प्रोफेशनल्स के रूप में हमें उस वास्तविक डेटा का भी परीक्षण करना चाहिए जो उस कोड से होकर गुजरता है। इसे आमतौर पर डेटा वैलिडेशन कहते हैं। आप ऐसे वास्तविक एसरशन्स बनाना चाहते हैं जो डेटा की समग्र गुणवत्ता को जाँचें, इससे पहले कि आप उसे स्टेकहोल्डर्स को दें या किसी डैशबोर्ड में लोड करें।
आप Codex से एक विशिष्ट डेटा वैलिडेशन स्क्रिप्ट जेनरेट करने के लिए कहकर इसे प्रदर्शित कर सकते हैं। बस ऐसा प्रॉम्प्ट टाइप करें:
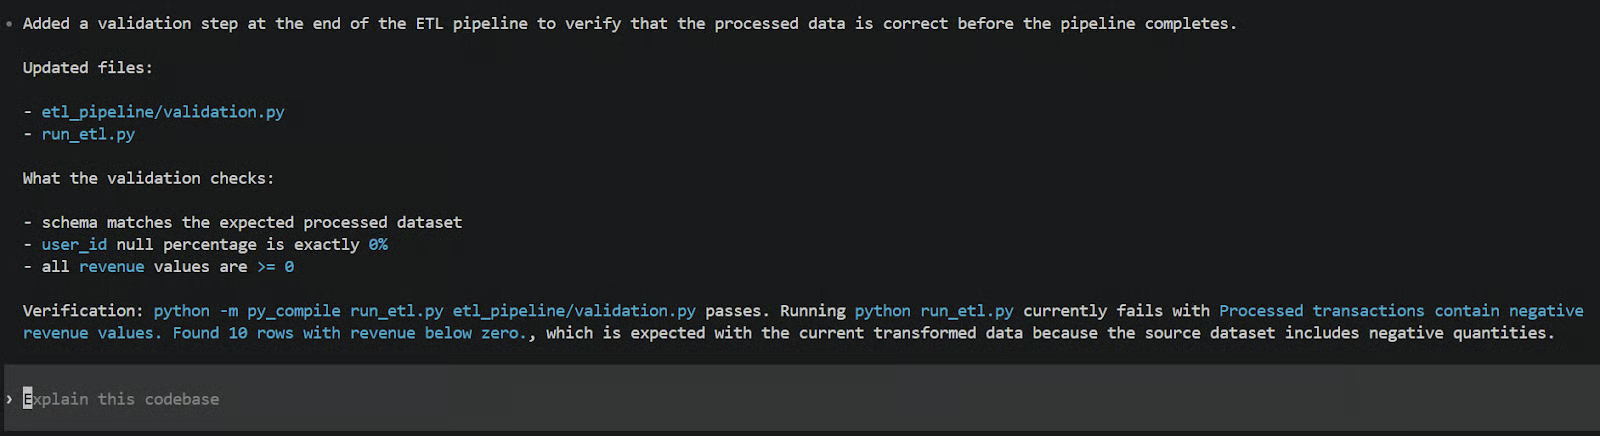
Create a data validation script that runs after the very end of the pipeline. It should check that the schema matches our expectations, ensure the null-percentage for user_id is exactly 0%, and verify that all revenue values are greater than or equal to zero.इसके बाद Codex एक समर्पित वैलिडेशन स्क्रिप्ट आउटपुट करेगा जो आपके प्रोजेक्ट के लिए अंतिम सेफ़्टी नेट का काम करता है। आप इसे आसानी से पाइपलाइन के बिल्कुल अंत में पोस्ट‑स्टेप के रूप में चलाने के लिए कॉन्फ़िगर कर सकते हैं।
इस तरह, यदि कच्चे CSV डेटा का स्ट्रक्चर कल अचानक बदल जाए, या किसी गड़बड़ी से अचानक नेगेटिव रेवेन्यू वैल्यूज़ दिखने लगें, तो यह स्क्रिप्ट उसे पकड़ेगी और तुरंत एरर थ्रो करेगी। यह सुनिश्चित करती है कि आपकी पाइपलाइन चुपचाप खराब डेटा आपके बिज़नेस यूज़र्स तक डाउनस्ट्रीम न भेज दे।
अब तक, हमने मुख्यतः देखा कि Codex CLI का इंटरैक्टिव रूप से—टाइप करके आगे‑पीछे—कैसे उपयोग करें। लेकिन जो डेटा प्रोफेशनल्स इस टूल को अपने नियमित, रोज़मर्रा के वर्कफ़्लो में सच में एकीकृत करना चाहते हैं, उनके लिए कुछ उन्नत उपयोग पैटर्न हैं जो मूलतः आपके उबाऊ काम को ऑटो‑पायलट पर डाल सकते हैं।
Jupyter Notebooks डेटा से खेलने और शुरुआती खोजबीन के लिए शानदार हैं, लेकिन जब उस कोड को प्रोडक्शन में विश्वसनीय रूप से चलाने का समय आता है, तो ये कमज़ोर साबित होते हैं। आमतौर पर आपको घंटों लगते हैं कोशिकाओं (cells) की कॉपी‑पेस्ट करने में और सभी अजीब ग्लोबल वैरिएबल मुद्दों को ठीक करने में।
Codex CLI के साथ, आप एजेंट को अपने नोटबुक की ओर संकेत करके भारी काम उससे करवा सकते हैं। बस टर्मिनल खोलें और ठीक ऐसा प्रॉम्प्ट टाइप करें:
Refactor analysis.ipynb into a modular Python package with separate files for data loading, transformation, visualization, and a main.py entry point.इसे मंज़ूरी देते ही, Codex आपके नोटबुक फाइल की JSON संरचना पढ़ता है, वास्तविक Python कोड निकालता है, रैंडम आउटपुट लॉग्स को नज़रअंदाज़ करता है, और पूरे सेटअप को पुनर्गठित कर देता है।
यदि आप पहले‑और‑बाद की संरचनाएँ देखें, तो वे बेहद अलग दिखेंगी। पहले, आपके पास एक विशाल analysis.ipynb फाइल थी जिसमें सब कुछ उलझा हुआ था।
Codex के बाद, आपको एक साफ़, प्रोफ़ेशनल फोल्डर दिखेगा जिसमें अलग‑अलग data_loader.py, transformer.py, और visualizer.py फाइलें (नाम आपके लिए अलग हो सकते हैं) होंगी, जो main.py स्क्रिप्ट से सलीके से जुड़ी होंगी। यह आपके उलझे हुए एक्सप्लोरेटरी एनालिसिस और प्रोडक्शन‑रेडी सॉफ़्टवेयर इंजीनियरिंग के बीच की खाई तुरंत पाट देता है।
कई बार आप बिल्कुल भी चैट इंटरफ़ेस में बैठकर इंटरैक्ट नहीं करना चाहते। यदि आप ऑटोमेटेड पाइपलाइन्स बना रहे हैं—जैसे वे ऑटोमेटेड चेक्स जो टीम के साथ कोड शेयर करने से ठीक पहले चलते हैं—तो आपको चाहिए कि AI बैकग्राउंड में, पूरी तरह ऑटो‑पायलट पर अपना काम करे।
यही वह जगह है जहाँ codex exec कमांड काम आती है। यह खासतौर पर स्क्रिप्ट्स और नॉन‑इंटरैक्टिव वातावरणों में Codex चलाने के लिए डिज़ाइन की गई है, ताकि हर कदम पर आपसे अनुमति न मांगी जाए।
इसका व्यावहारिक उदाहरण देने के लिए, चलिए एक त्वरित परीक्षण चलाते हैं। हम codex exec का उपयोग एक सिम्युलेटेड CI/CD चेक के रूप में करेंगे जो खराब डेटा को स्वतः पकड़/मान्य करे।
अपना टर्मिनल खोलें और ठीक यह कमांड टाइप करें:
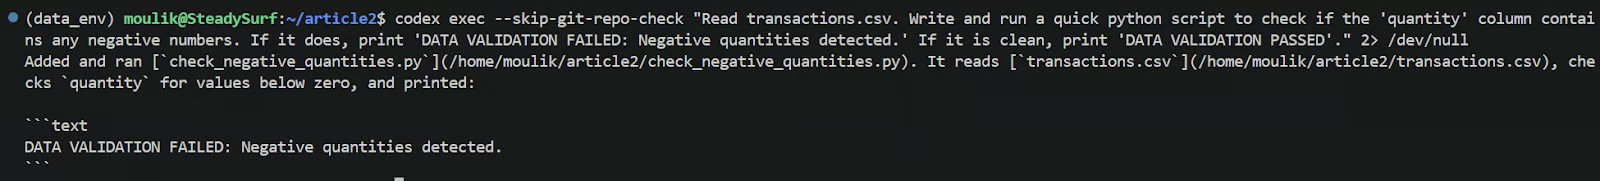
codex exec --skip-git-repo-check "Read transactions.csv. Write and run a quick python script to check if the 'quantity' column contains any negative numbers. If it does, print 'DATA VALIDATION FAILED: Negative quantities detected.' If it is clean, print 'DATA VALIDATION PASSED'." 2> /dev/nullएंटर दबाते ही, Codex नॉन‑इंटरैक्टिव रूप से चलेगा। यह सामान्य इंटरैक्टिव चैट इंटरफ़ेस नहीं खोलेगा, और अप्रूवल व्यवहार कॉन्फ़िगर किए गए अप्रूवल फ्लैग्स और डिफ़ॉल्ट्स पर निर्भर करेगा; जब तक आप अप्रूवल्स अक्षम नहीं करते, कुछ कार्रवाइयों की अनुमति फिर भी देनी पड़ सकती है। अधिक जानकारी के लिए, मैं Codex Documentation पढ़ने की सलाह देता/देती हूँ।
यह जल्दी से वैलिडेशन स्क्रिप्ट लिखेगा, उसे आपके लोकल CSV फाइल पर चलाएगा, और फिर डिरेक्ट आपके मानक टर्मिनल आउटपुट पर अंतिम परिणाम उगलेगा, बशर्ते डायरेक्टरी को trusted माना गया हो और अप्रूवल्स की सेटिंग्स इसकी अनुमति देती हों। आपको अपने कंसोल पर कुछ ऐसा आउटपुट दिखना चाहिए:
यह तरीका कई उपयोग मामलों में काम आता है। कल्पना करें कि आप इस कमांड को ज्यों‑का‑त्यों किसी pre‑commit hook या GitHub Actions वर्कफ़्लो में उपयोग कर रहे हैं। यदि आपकी पाइपलाइन कभी ऐसे डेटा से टकराती है जिसमें कोई कॉलम गायब है, NaN वैल्यूज़ हैं, या कोई और अनपेक्षित बर्ताव है, तो Codex उसे उसी समय पकड़ सकता है—बिना आपको वे PyTest और वैलिडेशन स्क्रिप्ट्स मैन्युअली लिखे।
जब आप डेटा कार्यों के लिए AI टूल्स का उपयोग करते हैं, तो एजेंट के साथ आपका इंटरैक्शन जिस तरह से होता है, वह आपको मिलने वाले Python कोड की गुणवत्ता बदल देता है। चलिए कुछ श्रेष्ठ अभ्यास देखते हैं ताकि आपका वर्कफ़्लो यथासंभव सुचारू और प्रोफेशनल बना रहे।
सबसे पहली चीज़ है प्रभावी प्रॉम्प्ट लिखना। आप सिर्फ "डेटा साफ़ करो" कहकर बेहतरीन नतीजे नहीं पा सकते। यहाँ अनुरोधों की संरचना करने का तरीका है:
विशिष्ट बनें: कॉलम्स के वास्तविक नाम, ठीक वे डेटा टाइप्स जो आप चाहते हैं, और अपेक्षित आउटपुट फ़ॉर्मेट—इन सब के बारे में विशिष्ट रहें। उदाहरण के लिए, अस्पष्ट अनुरोध के बजाय स्पष्ट रूप से कहें, "'purchase_date' कॉलम को datetime में कास्ट करें और summarized CSV आउटपुट करें।"
फाइल्स को सीधे संदर्भित करें: एक बहुत उपयोगी ट्रिक है प्रॉम्प्ट में @ सिंटैक्स से फाइल्स को सीधे संदर्भित करना। यदि आप @transactions.csv टाइप करते हैं, तो यह Codex को उसी वक्त उस विशेष फाइल को अपने कॉन्टेक्स्ट में पढ़ने के लिए बाध्य करता है।
जटिल कार्यों को तोड़ें: शायद सबसे महत्वपूर्ण, कार्यों को छोटे हिस्सों में तोड़ने की कोशिश करें, बजाय इसके कि Codex एक विशाल मेगा‑प्रॉम्प्ट पर कार्रवाई करे। जटिल कार्यों के लिए पहले ड्राफ्ट बनाने और फिर क्रमवार कदम उठाने हेतु Codex के समर्पित प्लान मोड का उपयोग करना बेहतर रहता है।
यदि आप अपनी प्रॉम्प्टिंग को अगले स्तर पर ले जाना चाहते हैं, तो हमारा Prompt Engineering with the OpenAI API कोर्स करें।
जैसा कि पहले बताया, CLI में अलग‑अलग अप्रूवल मोड्स हैं, और यह जानना कि किसे कब उपयोग करना है, महत्वपूर्ण है। यहाँ एक मार्गदर्शिका है:
अंततः, अपने डेटा वर्कफ़्लोज़ को पुनरुत्पादनीय रखना किसी भी डेटा प्रोफेशनल के लिए बहुत महत्वपूर्ण है। सबसे बड़े नियमों में से एक यह है कि हमेशा Codex को एक इनिशियलाइज़्ड Git रिपोजिटरी के अंदर चलाएँ। क्योंकि Codex आपकी मशीन पर फाइलें लिखेगा और एडिट करेगा, Git द्वारा उन बदलावों को ट्रैक करने से आप आसानी से देख सकते हैं कि AI ने क्या किया और गड़बड़ी होने पर उसे वापस कर सकते हैं।
आपको वह AGENTS.md फाइल भी ज़रूर अपने प्रोजेक्ट कोड के साथ कमिट करनी चाहिए, जो हमने पहले बनाई थी। इस तरह, यदि आपकी टीम का कोई और डेटा साइंटिस्ट आपका रिपो क्लोन करता है और Codex खोलता है, तो पूरी टीम को वही कोडिंग स्टैंडर्ड्स और निर्देशों का लाभ मिलता है।
यही बात किसी भी व्यक्तिगत कार्यों के लिए परिभाषित agent skills पर भी लागू होती है। प्रेरणा के लिए, Codex और अन्य agentic कोडिंग टूल्स के लिए हमारे सौ से अधिक टॉप एजेंट स्किल्स पर गाइड देखें।
और यदि आप कई दिनों तक चलने वाले किसी भारी विश्लेषण पर काम कर रहे हैं, तो आपको हर सुबह शुरू से आरंभ करने की ज़रूरत नहीं। आप बस अपने टर्मिनल में codex resume कमांड का उपयोग करके मल्टी‑सेशन डेटा प्रोजेक्ट्स जारी रख सकते हैं। यह बिना कोई मूल्यवान संदर्भ खोए आपके पिछले चैट में लौट आता है, जो आप और एजेंट कल कर रहे थे।
यदि आप कई दिनों तक चलने वाले किसी भारी विश्लेषण पर काम कर रहे हैं, तो आपको हर सुबह शुरू से शुरू करने की ज़रूरत नहीं है। आप बस अपने टर्मिनल में codex resume कमांड का उपयोग करके मल्टी‑सेशन डेटा प्रोजेक्ट्स जारी रख सकते हैं। यह उस प्रोजेक्ट में आपका पिछला Codex सत्र दोबारा खोल देता है ताकि आप वहीं से आगे बढ़ सकें, पिछली बातचीत, योजनाएँ, और फाइल बदलाव अब भी संदर्भ में रहते हैं (सामान्य मॉडल और इतिहास सीमाओं के अधीन)।
एजेंटिक कोडिंग में अधिक श्रेष्ठ अभ्यासों के लिए, आप हमारा Claude Code Best Practices गाइड भी देख सकते हैं। भले ही Claude Code और Codex अलग हैं, जैसा कि हमने अपने Codex बनाम Claude Code तुलना में बताया है, कई बुनियादी अवधारणाएँ Codex पर भी लागू होती हैं।
हमने आपके डेटा कार्य और लोकल Python एनवायरनमेंट्स के लिए विशेष रूप से Codex CLI सेटअप किया। वहाँ से, हमने शून्य से शुरुआती एक्सप्लोरेटरी डेटा एनालिसिस स्क्रिप्ट्स जेनरेट करना, पुनरुत्पादनीय ETL डेटा पाइपलाइन्स बनाना, ऑटोमेटेड ट्रांसफ़ॉर्मेशन टेस्ट लिखना (जो अक्सर छोड़ दिए जाते हैं), और अंत में उन बहुत‑ही‑दोहराए जाने वाले दैनिक डेटा कार्यों को ऑटोमेट करने के उन्नत तरीकों का पता लगाया।
सबसे महत्वपूर्ण बात याद रखने की यह है कि हमने यह सब कुछ कमांड लाइन से ही किया, बिना वेब ब्राउज़र में आगे‑पीछे कूदे। Codex CLI प्रभावी रूप से उस परेशान करने वाली खाई को पाटता है जो उलझे हुए, एक्सप्लोरेटरी डेटा एनालिसिस और वास्तविक, प्रोडक्शन‑क्वालिटी डेटा इंजीनियरिंग के बीच होती है।
यदि आप Codex CLI के साथ एक अधिक जटिल एजेंट बनाना सीखने में रुचि रखते हैं, तो मैं आपको हमारा Codex CLI MCP ट्यूटोरियल देखने की सलाह देता/देती हूँ। यह आपको एक फाइनेंशियल पोर्टफोलियो डैशबोर्ड एजेंट बनाने की प्रक्रिया से गुज़रता है।
AI पाठ्यक्रम
लर्निंग पाथ
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें