

数据增强技术
本节将学习音频、文本、图像及高级数据增强技术。
音频数据增强
- 噪声注入:向音频数据集中添加高斯或随机噪声,以提升模型表现。
- 时间偏移:将音频向左(快进)或向右随机偏移若干秒。
- 变速:按固定倍率拉伸时间序列。
- 变调:随机改变音频的音高。
文本数据增强
- 词或句子打乱:随机改变词或句子的顺序。
- 同义替换:用同义词替换词语。
- 句法树操作:在不改变用词的情况下,对句子进行同义改写。
- 随机插入词语:随机插入词语。
- 随机删除词语:随机删除词语。
图像增强
通过我们的 Image Processing with Python 技能路径中的动手练习,进一步学习图像变换与处理。
- 几何变换:随机翻转、裁剪、旋转、拉伸与缩放图像。需注意在同一图像上叠加多种变换可能会降低模型表现。
- 颜色空间变换:随机改变 RGB 颜色通道、对比度与亮度。
- 卷积核滤波:随机改变图像锐度或模糊程度。
- 随机抹除:删除原始图像的一部分。
- 图像混合:对多张图像进行混合与融合。
高级技术
- 生成对抗网络(GAN):用于生成新的数据点或图像。它在生成合成数据时不一定需要现有数据。
- 神经风格迁移:通过一系列卷积层对图像进行解构,分离内容与风格。
数据增强的应用
在难以获取高质量数据的所有机器学习应用中,数据增强皆可发挥作用。此外,它还能在各个研究领域提升模型的鲁棒性与性能。
医疗健康
采集与标注医学影像数据集既耗时又昂贵。在数据分析前,您还需要领域专家对数据集进行验证。通过几何等变换,可以帮助您训练稳健且准确的机器学习模型。
例如,在肺炎分类任务中,您可以使用随机裁剪、缩放、拉伸与颜色空间变换来提升模型表现。但需谨慎选择增强方式,否则可能适得其反。例如,对 X 光影像数据集不建议使用随机旋转和沿 x 轴反射。
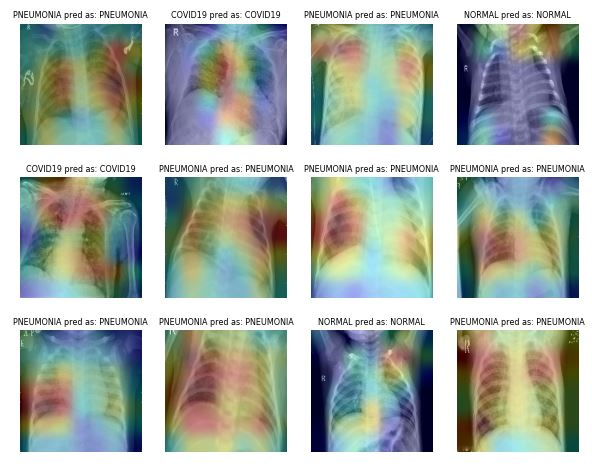
图片来源 ibrahimsobh.github.io | kaggle-COVID19-Classification
自动驾驶
关于自动驾驶的真实数据有限,企业正借助强化学习在仿真环境中生成合成数据。这有助于在数据安全存在问题的场景下训练与测试机器学习应用。
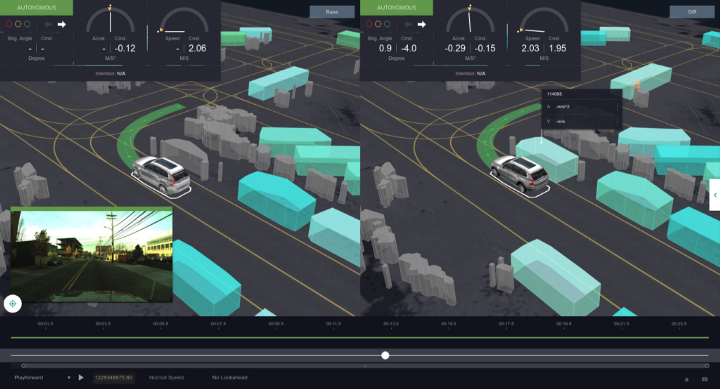
图片作者 David Silver | Uber ATG 自动化可视化系统
作为仿真的一种形式,增强数据的可能性几乎无穷无尽,可用于生成真实世界场景。
自然语言处理
文本数据增强通常用于高质量数据有限、且提升性能指标优先的场景。您可以应用同义词增强、词向量替换、字符交换、随机插入与删除。这些技术对低资源语言同样有价值。

图片来源 Papers With Code | 低资源文本分类中基于词语角色的选择性文本增强。
研究者会在高识别错误率场景、序列到序列数据生成与文本分类中,使用面向语言模型的文本增强。
自动语音识别
在声音分类与语音识别中,数据增强效果显著。即便在低资源语言上,也能提升模型表现。
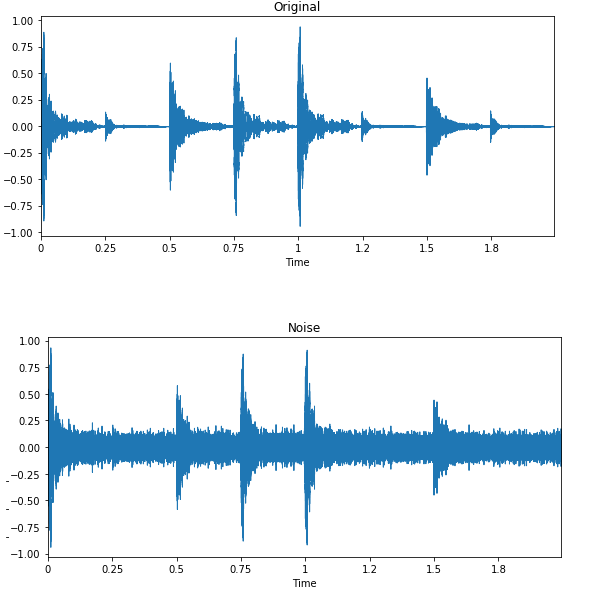
图片作者 Edward Ma | 噪声注入
随机噪声注入、时间偏移与变调有助于构建先进的语音转文本模型。您也可以使用 GAN 为特定应用生成逼真的声音。
数据增强的伦理影响
尽管数据增强是提升机器学习模型的强大工具,但也带来若干需要谨慎对待的伦理问题:
- 偏见放大:对带有偏见的数据集进行增强,可能复制并加剧既有不平等,导致模型在弱势群体上的表现更差。
- 隐私风险:合成数据生成可能无意中保留原始数据中的敏感细节,从而违反隐私法规。
- 数据真实性:不当的增强会产生不现实或误导性的数据点,可能损害模型表现与信任。
- 透明度:务必清晰记录增强技术,并确保相关方了解数据如何被转换或生成。
- 公平与公正:确保增强数据能反映多样人群与场景,对于避免非预期偏见并确保模型稳健性至关重要。
- 合规性:增强数据集必须遵守数据保护法律与伦理准则,以规避法律与声誉风险。
为负责任地使用数据增强,实践者应对增强数据进行验证、处理偏见,并确保遵守相关伦理与法律标准。
使用 Keras 与 TensorFlow 进行数据增强
在本教程中,我们将学习如何使用 Keras 与 Tensorflow 对图像数据进行增强。此外,您还将学习如何使用增强后的数据训练一个简单的二分类器。下面的代码基于TensorFlow 官方示例进行了修改。
建议您一边练习一边跟随编码教程。本教程的代码与输出可在此 DataLab 工作簿中获取。
开始上手
我们将使用 TensorFlow 与 Keras 进行数据增强,并用 matplotlib 展示图像。
%%capture
import matplotlib.pyplot as plt
import numpy as np
import tensorflow as tf
from tensorflow.keras import layers
from tensorflow.keras.models import Sequential
数据加载
TensorFlow Dataset 资源非常丰富,包含文本、音频、视频、图、时间序列与图像数据集。本教程将使用 cats_vs_dogs 数据集。该数据集大小为 786.68 MiB,我们将对其应用多种图像增强并训练一个二分类器。
在下面的代码中,我们将数据划分为 80% 训练集、10% 验证集与 10% 测试集,并包含标签与元数据。
%%capture
(train_ds, val_ds, test_ds), metadata = tfds.load(
'cats_vs_dogs',
split=['train[:80%]', 'train[80%:90%]', 'train[90%:]'],
with_info=True,
as_supervised=True,
)数据分析
该数据集包含两个类别:cat 与 dog。
num_classes = metadata.features['label'].num_classes
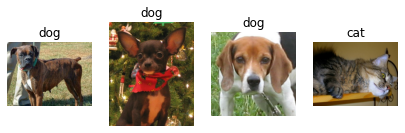
print(num_classes)2我们将使用迭代器从训练集中随机提取四张带标签的图像,并使用 matplotlib 的 `.imshow()` 函数进行展示。
try:
get_label_name = metadata.features['label'].int2str
train_iter = iter(train_ds)
fig = plt.figure(figsize=(7, 8))
for x in range(4):
image, label = next(train_iter)
fig.add_subplot(1, 4, x + 1)
plt.imshow(image)
plt.axis('off')
plt.title(get_label_name(label))
except StopIteration:
print("Dataset iterator is empty!")
可以看到,我们获得了多张狗的图像以及一张猫的图像。
使用 keras.Sequential() 进行数据增强
我们通常使用 keras.Sequential() 构建模型,但也可以用它来添加增强层。
调整大小与缩放
在示例中,我们将使用 Keras Sequential 与图像增强层对图像进行尺寸调整与缩放。首先将图像调整为 180×180,然后按 1/255 进行缩放。较小的图像尺寸有助于节省时间、内存与计算资源。
可以看到,我们已成功将图像传入增强层,最终输出已调整尺寸并完成缩放。
IMG_SIZE = 180
resize_and_rescale = keras.Sequential([
layers.Resizing(IMG_SIZE, IMG_SIZE),
layers.Rescaling(1./255)
])
result = resize_and_rescale(image)
plt.axis('off')
plt.imshow(result);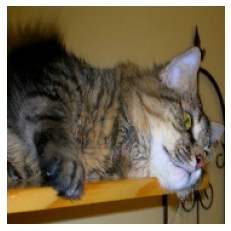
1
旋转与翻转
让我们对同一张图像应用随机翻转与旋转。我们将使用循环、子图与 imshow 展示六张经过随机几何增强的图像。
data_augmentation = keras.Sequential([
layers.RandomFlip("horizontal_and_vertical"),
layers.RandomRotation(0.4),
])
plt.figure(figsize=(8, 7))
for i in range(6):
augmented_image = data_augmentation(image)
ax = plt.subplot(2, 3, i + 1)
plt.imshow(augmented_image.numpy()/255)
plt.axis("off")注意:如果您看到“WARNING:matplotlib.image:Clipping input data to the valid range for imshow with RGB data ([0..1] for floats or [0..255] for integers).”之类的警告,请尝试将图像转换为 numpy 并除以 255。这样会得到更清晰的输出,而非泛白的图像。
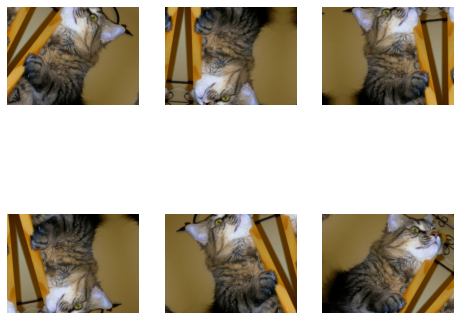
除了这些简单的增强,您还可以对图像应用 RandomContrast、RandomCrop、CenterCrop 与 RandomZoom 等操作。
直接添加到模型层
有两种方式对图像应用增强。第一种是将增强层直接添加到模型中。
model = keras.Sequential([
# Add the preprocessing layers you created earlier.
resize_and_rescale,
data_augmentation,
# Add the model layers
layers.Conv2D(16, 3, padding='same', activation='relu'),
layers.MaxPooling2D(),
layers.Flatten(),
layers.Dense(128, activation='relu'),
layers.Dense(64, activation='relu'),
layers.Dense(1,activation='sigmoid')
])注意:数据增强在测试阶段处于非激活状态。它仅在 Model.fit 中生效,不适用于 Model.evaluate 或 Model.predict。
使用 .map 应用增强函数
第二种方式是使用 Dataset.map 将数据增强应用到整个训练集。
aug_ds = train_ds.map(lambda x, y: (data_augmentation(x, training=True), y))数据预处理
我们将创建一个数据预处理函数,对训练集、验证集与测试集进行处理。
该函数将:
- 对整个数据集应用尺寸调整与缩放。
- 若 shuffle 为 True,则对数据集进行打乱。
- 按 32 的批大小对数据进行分批处理。
- 若 augment 为 True,则对所有数据集应用数据增强函数。
- 最后使用 Dataset.prefetch,将 GPU 上的模型训练与数据处理重叠进行。
batch_size = 32
AUTOTUNE = tf.data.AUTOTUNE
def prepare(ds, shuffle=False, augment=False):
# Resize and rescale all datasets.
ds = ds.map(lambda x, y: (resize_and_rescale(x), y),
num_parallel_calls=AUTOTUNE)
if shuffle:
ds = ds.shuffle(1000)
# Batch all datasets.
ds = ds.batch(batch_size)
# Use data augmentation only on the training set.
if augment:
ds = ds.map(lambda x, y: (data_augmentation(x, training=True), y),
num_parallel_calls=AUTOTUNE)
# Use buffered prefetching on all datasets.
return ds.prefetch(buffer_size=AUTOTUNE)
train_ds = prepare(train_ds, shuffle=True, augment=True)
val_ds = prepare(val_ds)
test_ds = prepare(test_ds)构建模型
我们将创建一个包含卷积与全连接层的简单模型。请确保输入形状与图像形状一致。
model = keras.Sequential([
layers.Conv2D(32, (3, 3), input_shape=(180,180,3), padding='same', activation='relu'),
layers.MaxPooling2D(pool_size=(2, 2)),
layers.Flatten(),
layers.Dense(32, activation='relu'),
layers.Dense(1,activation='softmax')
])训练与评估
我们现在编译模型,并训练一个 epoch。优化器使用 Adam,损失函数为二元交叉熵,评估指标为准确率。
从结果可见,单次运行的验证准确率为 51%。您可以训练更多轮并调优超参数以获得更好的结果。
模型的构建与训练仅用于演示如何对图像进行增强并训练模型。
model.compile(optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy'])
epochs=1
history = model.fit(
train_ds,
validation_data=val_ds,
epochs=epochs
)582/582 [==============================] - 98s 147ms/step - loss: 0.6993 - accuracy: 0.4961 - val_loss: 0.6934 - val_accuracy: 0.5185loss, acc = model.evaluate(test_ds)73/73 [==============================] - 4s 48ms/step - loss: 0.6932 - accuracy: 0.5013通过参加 Image Processing with Keras 课程,学习进行图像分析,并构建、训练与评估卷积网络。
使用 tf.image() 进行数据增强
本节我们将使用 TensorFlow 进行图像增强,以便对数据增强拥有更细粒度的控制。
数据加载
我们将再次加载带标签与元数据的 cats_vs_dogs 数据集。
%%capture
(train_ds, val_ds, test_ds), metadata = tfds.load(
'cats_vs_dogs',
split=['train[:80%]', 'train[80%:90%]', 'train[90%:]'],
with_info=True,
as_supervised=True,
)这一次我们不再使用猫的图像,而是选取一张狗的图像并应用多种增强技术。
image, label = next(iter(train_ds))
plt.imshow(image)
plt.title(get_label_name(label));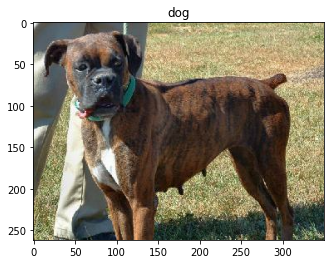
1
左右翻转
我们将创建 visualize() 函数来展示原始图像与增强后图像的差异。
该函数十分直接:它接收原始图像与增强函数作为输入,并使用 matplotlib 展示差异。
def visualize(original, augmented):
fig = plt.figure()
plt.subplot(1,2,1)
plt.title('Original image')
plt.imshow(original)
plt.axis("off")
plt.subplot(1,2,2)
plt.title('Augmented image')
plt.imshow(augmented)
plt.axis("off")可以看到,我们已使用 tf.image 函数将图像进行左右翻转。相较于 keras.Sequential(),这种方式更为简洁。
flipped = tf.image.flip_left_right(image)
visualize(image, flipped)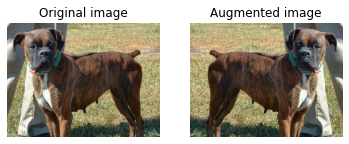
1
灰度化
让我们使用 tf.image.rgb_to_grayscale() 将图像转换为灰度。
grayscaled = tf.image.rgb_to_grayscale(image)
visualize(image, tf.squeeze(grayscaled))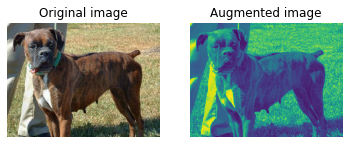
1
调整饱和度
您也可以按系数 3 调整饱和度。
saturated = tf.image.adjust_saturation(image, 3)
visualize(image, saturated)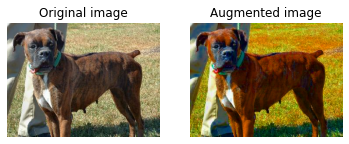
1
调整亮度
通过传入亮度系数来调整亮度。
bright = tf.image.adjust_brightness(image, 0.4)
visualize(image, bright)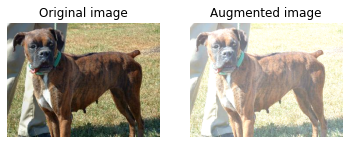
1
中心裁剪
使用 0.5 的中心比例从图像中心进行裁剪。
cropped = tf.image.central_crop(image, central_fraction=0.5)
visualize(image, cropped)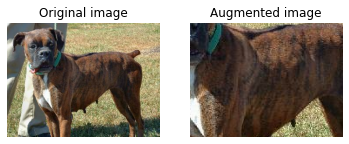
1
旋转 90 度
使用 tf.image.rot90() 将图像旋转 90 度。
rotated = tf.image.rot90(image)
visualize(image, rotated)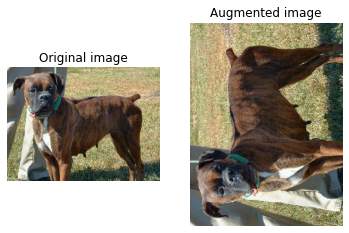
1
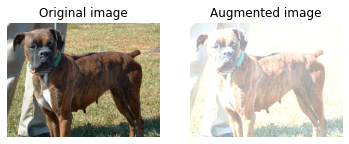
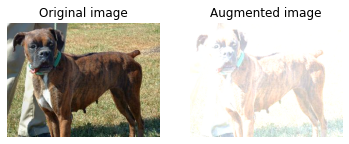
应用随机亮度
与 Keras 的层类似,tf.image() 也提供随机增强函数。下面的示例将对图像应用随机亮度,并展示多种结果。
可以看到,第一张图更暗,接下来的两张更亮一些。
for i in range(3):
seed = (i, 0) # tuple of size (2,)
stateless_random_brightness = tf.image.stateless_random_brightness(
image, max_delta=0.95, seed=seed)
visualize(image, stateless_random_brightness)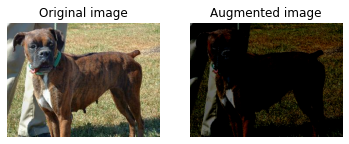
应用增强函数
与 Keras 类似,我们可以使用 Dataset.map() 将数据增强函数应用到整个数据集。
def augment(image, label):
image = tf.cast(image, tf.float32)
image = tf.image.resize(image, [IMG_SIZE, IMG_SIZE])
image = (image / 255.0)
image = tf.image.random_crop(image, size=[IMG_SIZE, IMG_SIZE, 3])
image = tf.image.random_brightness(image, max_delta=0.5)
return image, label
train_ds = (
train_ds
.shuffle(1000)
.map(augment, num_parallel_calls=AUTOTUNE)
.batch(batch_size)
.prefetch(AUTOTUNE)
)使用 ImageDataGenerator 进行数据增强
Keras 的 ImageDataGenerator() 甚至更为简洁。当您从本地目录或 CSV 加载数据时效果最佳。
在示例中,我们将从 Keras 默认数据集库下载并加载一个较小的 CIFAR10 数据集。
随后,我们将使用 keras.preprocessing.image.ImageDataGenerator() 进行增强。该函数会随机旋转、改变高度与宽度,并水平翻转图像。
最后,我们对训练数据集拟合 ImageDataGenerator() 并展示六张经过随机增强的图像。
注意:图像大小为 32×32,因此显示分辨率较低。
(x_train, y_train), (x_test, y_test) = keras.datasets.cifar10.load_data()
datagen = keras.preprocessing.image.ImageDataGenerator(rotation_range=20,
width_shift_range=0.2,
height_shift_range=0.2,
horizontal_flip=True,
validation_split=0.2)
datagen.fit(x_train)
for X_batch, y_batch in datagen.flow(x_train,y_train, batch_size=6):
for i in range(0, 6):
plt.subplot(2,3,i+1)
plt.imshow(X_batch[i]/255)
plt.axis('off')
break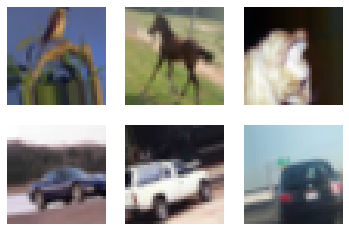
数据增强工具
本节将介绍其他可用于执行多种数据增强技术并提升模型表现的开源工具。
Pytorch
图像变换可在 torchvision.transforms 模块中找到。与 Keras 类似,您可以在 torch.nn.Sequential 中添加变换层,或单独对数据集应用增强函数。
Augmentor
Augmentor 是用于图像增强与人工图像生成的 Python 包。您可以执行透视倾斜、弹性形变、旋转、错切、裁剪与镜像等操作。Augmentor 还提供基本的图像预处理功能。
Albumentations
Albumentations 是一款快速灵活的 Python 图像增强工具。它广泛用于机器学习竞赛、工业界与科研中,以提升深度卷积神经网络的性能。
Imgaug
Imgaug 是开源的图像增强工具。它支持多种增强技术,如高斯噪声、对比度、锐度、裁剪、仿射与翻转。其接口简单而强大,并支持关键点、边界框、热力图与分割图。
OpenCV
OpenCV 是一个庞大的开源库,面向计算机视觉、机器学习与图像处理。它通常用于构建实时应用。您可以使用 OpenCV 便捷地对图像和视频进行增强。
结语
Tensorflow 与 Keras 提供的图像增强函数非常便捷。您只需添加增强层、使用 tf.image() 或 ImageDataGenerator() 即可执行增强。除深度学习框架外,您还可以使用 Augmentor、Albumentations、OpenCV 与 Imgaug 等独立工具进行数据增强。
在本教程中,我们学习了数据增强的优势、局限、应用与技术。此外,我们还学习了如何在 cats_vs_dogs 数据集上,使用 Keras 与 Tensorflow 进行图像增强。如果您希望进一步学习图像处理,请查看我们的 Image Processing with Python 技能路径。该路径将教授图像变换与处理基础、医学图像分析,以及使用 Keras 的高级图像处理。
数据增强常见问题
数据增强是什么意思?
这是一组通过修改现有数据的副本,或基于现有数据集合成生成新副本,从而人为增加数据集规模的技术。在训练机器学习模型时,它起到正则化作用并减少过拟合。
数据增强能提高准确率吗?
在大多数情况下,数据增强可以提升模型的准确率。它能降低模型过拟合,并提高对未见数据集的准确性。
数据增强的缺点是什么?
数据增强的主要劣势源于数据偏差。如果原始数据存在偏差,增强后的数据也会带有偏差,从而导致次优结果。
数据增强的示例有哪些?
例如,若您有 40 张猫狗图像数据集,通过随机进行水平与垂直翻转,您可以创建这些图像的新副本,从而将训练集翻倍。
有哪些数据增强技术?
在图像增强中,您可以随机翻转、裁剪、旋转、缩放、调整大小、拉伸以及进行仿射变换。此外,还可以调整饱和度、亮度、对比度、锐度,甚至添加噪声。
CNN 中的数据增强是什么?
卷积神经网络(CNN)模型的性能会随着训练数据的增加而提升。CNN 对平移、视角、尺寸与光照具有不变性,因此与数据增强配合良好。
模型的效果取决于其训练数据,但收集大而多样的数据集往往需要大量人力。
数据增强提供了一种解决方案:通过对现有数据进行修改,您可以人为扩充训练集、降低过拟合,并构建更具泛化能力的模型。
本指南涵盖图像、文本与音频的核心数据增强技术,并概述可加入您工作流的常用独立工具。
什么是数据增强?
数据增强是一种利用现有数据对数据集创建修改副本、从而人为增加训练集规模的技术。它既包括对数据集进行小幅改动,也包括使用深度学习生成新的数据点。
增强数据 vs. 合成数据
数据增强与合成数据生成是机器学习中既不同又互补的技术:
注意:增强技术并不限于图像。您也可以对音频、视频、文本及其他类型数据进行增强。
为什么数据增强很重要?
数据增强通过最大化利用现有数据来帮助机器学习模型表现更佳。它可防止过拟合、提升准确率,并为训练数据带来多样性——这在数据集较小或类别不平衡时尤为关键。通过模拟真实世界的变化,它使模型更稳健、更可靠,而无需昂贵的数据采集。简言之,这是帮助模型有效学习与泛化的一种简单而强大的方法。
何时应使用数据增强?
数据增强的局限