
Cursus
Datastructuren en algoritmen in Python
4 uur
48.3K
Datastructuren bestaan zowel in de digitale als in de fysieke wereld. Een woordenboek is een fysiek voorbeeld van een datastructuur waarbij de data bestaat uit woorddefinities die alfabetisch in een boek zijn geordend. Deze ordening maakt een specifieke query mogelijk: gegeven een woord kun je de definitie opzoeken.
In de kern is een datastructuur een manier om data te organiseren die specifieke soorten queries en bewerkingen op die data mogelijk maakt.
We beginnen met lineaire datastructuren zoals arrays, lijsten, wachtrijen en stacks. Daarna leggen we het verschil uit tussen lineaire en niet-lineaire structuren, om vervolgens in te gaan op hashtabellen, bomen en grafen.
Wil je meer leren? Bekijk dan deze cursus over datastructuren en algoritmen in Python.
Arrays zijn fundamentele datastructuren die in veel programmeertalen beschikbaar zijn. Ze maken het mogelijk om een vast aantal (N) waarden sequentieel in het geheugen op te slaan.
Elementen in een array worden geïndexeerd van het eerste element op index (0) tot het laatste element op index (N-1).
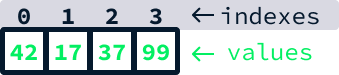
Ze ondersteunen de volgende bewerkingen:
Arrays zijn zeer effectief in situaties waarin het aantal op te slaan waarden vooraf bekend is en de primaire bewerkingen bestaan uit het lezen en schrijven van data op specifieke indexen.
Stel dat je dagelijkse temperatuurmetingen voor de maand december moet opslaan. Je wilt gebruikers in staat stellen de temperatuur voor een specifieke dag op te vragen en verschillende statistische analyses over de maand uit te voeren.
Omdat het aantal dagen in december vooraf bekend is (31), zijn arrays een uitstekende keuze om de metingen op te slaan. Je maakt aanvankelijk een array met 31 lege posities. Daarna ken je, na elke meting, de temperatuur van een bepaalde dag toe aan de corresponderende array-index: dag 1 op index 0, dag 2 op index 1, enzovoort, tot en met dag 31 op index 30.
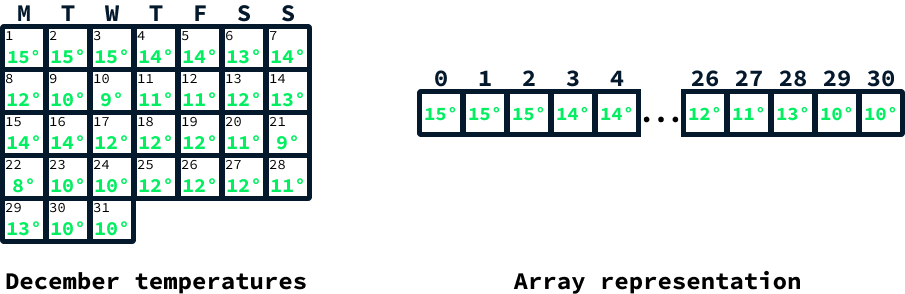
Door de bijbehorende index te benaderen, kun je de temperatuur voor een specifieke dag ophalen. Statistieken, zoals de gemiddelde temperatuur, bepaal je door over alle elementen te itereren, een cumulatieve som bij te houden en vervolgens te delen door de grootte van de array.
Arrays zijn niet native beschikbaar in Python. Ze worden onder de motorkap gebruikt als onderliggende structuur voor verschillende datatypen, maar worden niet direct in de taal ondersteund. Om arrays expliciet te gebruiken, kun je libraries zoals array inzetten, die een array-implementatie bieden. Vaak is het echter praktischer om een lijst met vaste grootte te gebruiken in situaties waarin je anders een array zou kiezen. Lijsten bieden flexibiliteit en zijn een kernonderdeel van Python, zoals we hierna bespreken.
We kunnen een lijst maken om een array van 31 elementen te simuleren, elk geïnitialiseerd met None, door [None] * 31 te gebruiken. Hier geeft None aan dat er nog geen temperatuurmeting is geregistreerd.
december_temperatures = [None] * 31Om de waarde op een specifieke index te zetten, gebruiken we december_temperatures[index], waarbij index een getal is van 0 tot 30. Bijvoorbeeld, om de temperatuur voor de eerste dag (opgeslagen op index 0) vast te leggen, doe je dit zo:
december_temperatures[0] = 15Een temperatuur opvragen is net zo eenvoudig, met december_temperatures[index].
print(december_temperatures[0])15Stel nu dat we in plaats van te focussen op december, ergens een sensor plaatsen om periodieke temperatuurmetingen over een onbepaalde periode te doen. In dit scenario is een array geen goede optie, omdat we door de vaste grootte bij aanmaak ruimte tekort kunnen komen.
Een geschiktere datastructuur in dit geval is een lijst. Er zijn twee soorten lijsten:
Array-lijsten kun je zien als een flexibelere versie van arrays. Ze kunnen alles wat arrays kunnen, maar ook nieuwe waarden toevoegen, zodat de grootte niet vaststaat bij aanmaak. Array-lijsten komen overeen met het gebruik van list() in Python.
Hun implementatie is gebaseerd op het gebruik van een array die wordt vergroot wanneer de ruimte opraakt, vandaar de naam array-lijst. Maar zoals we eerder leerden, kunnen arrays niet groeien, dus hoe werkt dit?
Wanneer de onderliggende array van een array-lijst vol is en we een nieuwe waarde willen toevoegen, wordt onder water een grotere array aangemaakt. Alle eerdere waarden worden gekopieerd naar deze nieuwe, grotere array. Daarna wordt de nieuwe waarde toegevoegd op de eerste beschikbare positie in de nieuwe array.
Stel dat we de waarde 71 aan deze array willen toevoegen:
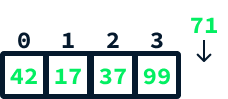
Dat kan als volgt worden uitgevoerd:
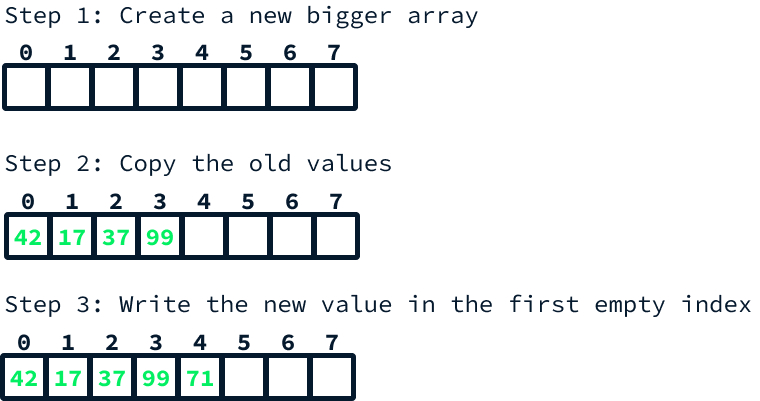
De hoeveelheid nieuwe ruimte die wordt toegewezen wanneer we deze operatie uitvoeren, is cruciaal voor de prestaties van de array-lijst. Als we bij elke toevoeging een array zouden aanmaken met slechts één extra positie voor de nieuwe waarde, dan zou elke append-operatie het kopiëren van alle bestaande data vereisen. Dat is extreem inefficiënt—stel je voor dat je miljoenen records moet kopiëren om er één toe te voegen.
In plaats daarvan is de gebruikelijke strategie om de arraygrootte te verdubbelen telkens wanneer meer ruimte nodig is. Deze aanpak neutraliseert op termijn het effect van die extra kopieerstappen.
Om elementen aan een Python-lijst toe te voegen, gebruiken we de methode .append(). Hier is een voorbeeld van het maken van een lege lijst en het toevoegen van een temperatuurmeting:
temperatures = []
temperatures.append(35)Om data in een computer te structureren, hebben we een manier nodig om waarden met elkaar te relateren. Arrays doen dit door aaneengesloten geheugencellen toe te wijzen—geheugencellen die direct naast elkaar liggen—en waarden sequentieel op te slaan. Denk aan een rij huizen in een straat: elk huis heeft een uniek adres (index) en ze liggen fysiek naast elkaar.
Dit is echter niet de enige manier om data te organiseren. Een alternatief is een knooppuntgebaseerde structuur.
Een knooppunt (node) is een object dat een waarde opslaat samen met verwijzingen naar andere knooppunten. Om bijvoorbeeld een lijstachtige structuur met knooppunten te maken, kunnen we een knooppunt laten verwijzen naar de volgende in de lijst. In Python kan dit met een class worden geïmplementeerd:
class Node:
    def __init__(self, value, next_node):
        self.value = value
        self.next_node = next_node
Met deze aanpak kun je een lijst maken door waarden aan elkaar te koppelen via de verwijzing next_node. Hier is een codefragment dat een lijst maakt met de waarden 42, 17 en 37:
node_37 = Node(37, None) # There's no node after 37 so next_node is None
node_17 = Node(17, node_37)
node_42 = Node(42, node_17)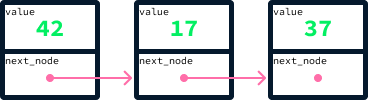
Knooppunten op deze manier handmatig koppelen is niet praktisch. In de daadwerkelijke implementatie maken we een extra class die verwijzingen bijhoudt naar zowel het eerste als het laatste knooppunt van de lijst. Om een nieuwe waarde toe te voegen, doen we het volgende:
Stel dat we de waarde 71 aan onze voorbeeldarray willen toevoegen:
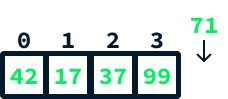
Dat kan als volgt worden uitgevoerd:
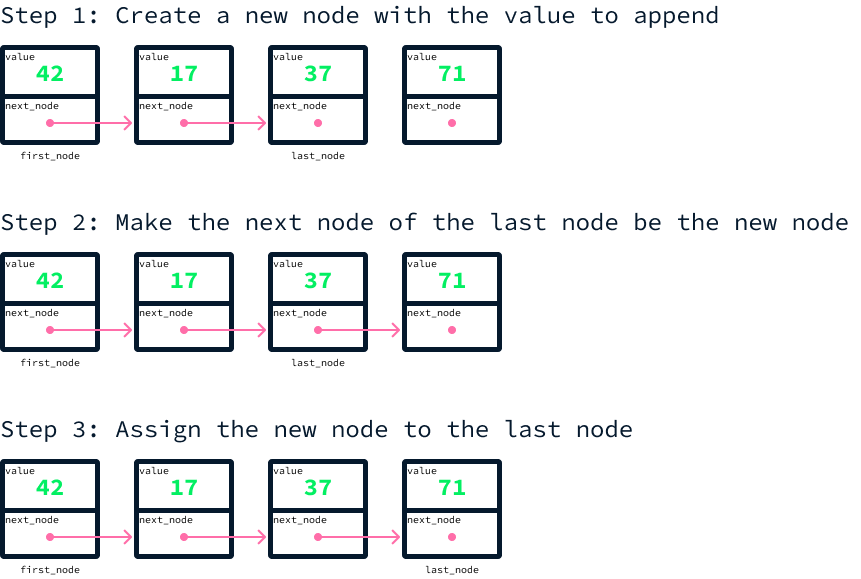
class LinkedList:
    def __init__(self):
        self.first_node = None
        self.last_node = None

    def append(self, value):
        node = Node(value, None)
        if self.first_node is None:
            self.first_node = node
            self.last_node = node
        else:
            self.last_node.next_node = node
            self.last_node = node
In tegenstelling tot bij array-lijsten kunnen we waarden niet direct op hun index benaderen. Om een specifieke waarde op een index te lezen, moeten we bij het eerste knooppunt beginnen en sequentieel van knooppunt naar knooppunt gaan tot we de gewenste index bereiken. Dit is aanzienlijk trager dan directe toegang. Als we miljoenen waarden in de lijst hebben opgeslagen, moeten we miljoenen waarden in het geheugen doorlopen om een specifieke index te bereiken.
Het voordeel van een gelinkte lijst is dat we direct elementen vooraan of achteraan aan de lijst kunnen toevoegen en verwijderen. Dit maakt het mogelijk om twee nieuwe datastructuren te implementeren: queues (wachtrijen) en stacks, die we hierna bespreken.
Stel je ontwikkelt een restaurantapp die bestellingen van klanten registreert en doorstuurt naar de keuken. Wanneer klanten arriveren, sluiten ze aan in de rij om te bestellen en verwachten ze in volgorde van aankomst geholpen te worden. Dat betekent dat de eerste klant in de rij als eerste zijn bestelling krijgt en de laatste als laatste.
In de keuken werkt de chef liever één bestelling tegelijk af, dus de app mag alleen de huidige bestelling tonen. Zodra een bestelling is bereid en verzonden, moet de volgende bestelling in de queue worden getoond.
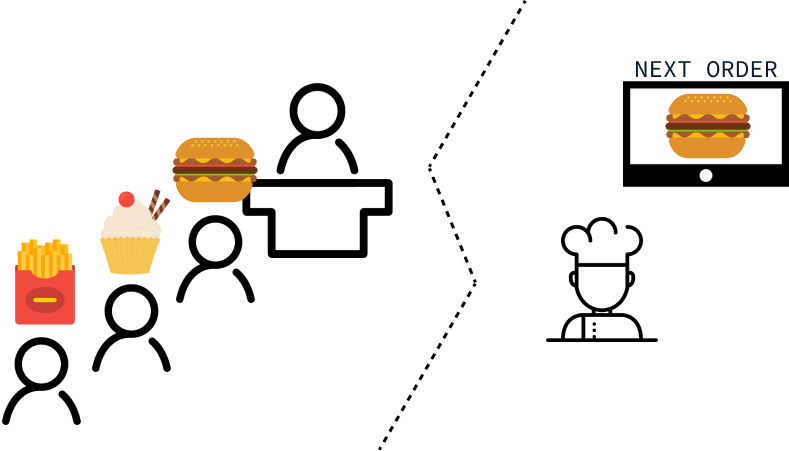
We kunnen de bovenstaande vereisten interpreteren als de behoefte aan een datastructuur die de volgende bewerkingen ondersteunt:
Dit zijn precies de bewerkingen die een queue biedt. Een queue kan worden geïmplementeerd met een gelinkte lijst, waarbij elementen worden toegevoegd door ze aan het einde van de lijst te plakken. Omdat elementen geordend zijn op aankomsttijd, is het eerste knooppunt altijd degene die als volgende moet worden bediend.
Zo worden de bovenstaande bestellingen in de queue opgeslagen:
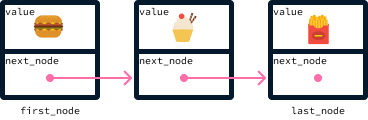
Zodra een bestelling klaar is, kan die worden verwijderd door het eerste element bij te werken naar zijn next_node, ervan uitgaande dat er een volgend knooppunt is. Het nieuwe eerste knooppunt is dan het vorige tweede knooppunt:
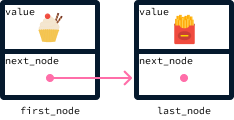
Queues worden omschreven als een first-in, first-out (FIFO) datastructuur, omdat het eerste toegevoegde element ook als eerste wordt verwijderd. In ons restaurantvoorbeeld is de eerste klant die arriveert ook de eerste die wordt geholpen (en uit de lijst van de chef verdwijnt).
Om in Python een queue te gebruiken, kunnen we de deque-collectie uit de module collections gebruiken. Importeer deze module en maak een lege queue zoals hieronder:
from collections import deque
orders = deque()
Een nieuw element achteraan in de queue toevoegen kan met de .append()-methode:
orders.append("burger")
orders.append("sunday")
orders.append("fries")
Om de volgende bestelling vooraan in de queue op te halen en te verwijderen, gebruiken we de .popleft()-methode:
orders.append("burger")
orders.append("sunday")
orders.append("fries")
burger
sunday
friesIn sommige situaties willen we juist het tegenovergestelde gedrag van een queue—we willen het meest recent toegevoegde element bijhouden.
Stel bijvoorbeeld dat je een undo-functie toevoegt aan een foto-editor. Hiervoor moet je de acties van de gebruiker bijhouden, met toegang tot de meest recente bewerkingen. Undo-functionaliteiten draaien handelingen immers meestal terug beginnend bij de laatste en zo terug naar de eerste.
Een stack is precies een datastructuur die deze bewerkingen ondersteunt:
Net als queues kunnen stacks ook met een gelinkte lijst worden geïmplementeerd. Een element toevoegen gebeurt nog steeds door het aan het einde van de lijst te plakken. Onze interesse verschuift echter naar het laatste element van de lijst in plaats van het eerste. Om het meest recente element op te halen, kijken we naar het laatste element. Om het laatste element te verwijderen, moeten we dat laatste element wissen.
In onze knooppuntstructuur hielden we alleen het volgende knooppunt bij. Om het verwijderen van het laatste element te vergemakkelijken, moeten we toegang hebben tot het element dat eraan voorafgaat, diens next_node verwijderen en dat knooppunt promoveren tot laatste. Dit kunnen we bereiken door de knooppuntstructuur aan te passen zodat elk knooppunt ook het vorige knooppunt bijhoudt. Zo’n gelinkte lijst noemen we een dubbellinked lijst.
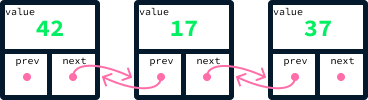
Stacks worden omschreven als een last-in, first-out (LIFO) datastructuur, omdat het laatst toegevoegde element ook als eerste wordt verwijderd.
Om in Python een stack te gebruiken, kunnen we dezelfde deque-collectie benutten. We gebruiken de .append()-methode om nieuwe elementen toe te voegen:
from collections import deque
actions = deque()

actions.append("crop")
actions.append("desaturate")
actions.append("resize")
Om de volgende bewerking bovenaan de stack op te halen en te verwijderen, gebruiken we de .pop()-methode:
print(actions.pop())
print(actions.pop())
print(actions.pop())
resize
desaturate
cropTot nu toe hebben we vijf datastructuren besproken: arrays, array-lijsten, gelinkte lijsten, queues en stacks. Elk hiervan is een lineaire datastructuur omdat de elementen in een volgorde staan, met voor elk element een duidelijk vorig en volgend element.
Vervolgens richten we ons op niet-lineaire datastructuren. In tegenstelling tot lineaire types ordenen deze structuren de elementen niet lineair naast elkaar. Daardoor is er geen gedefinieerd idee van vorige en volgende elementen. In plaats daarvan leggen ze andere soorten relaties tussen de elementen vast.
Deze eigenschap maakt ze bijzonder geschikt om gespecialiseerde queries op de data zeer efficiënt uit te voeren, in plaats van alleen maar te dienen als opslag in het geheugen.
We begonnen dit artikel met een realistisch voorbeeld van een datastructuur: woordenboeken. Het blijkt dat data zo organiseren dat je kunt opzoeken op een specifiek veld (bijvoorbeeld een definitie opzoeken bij een woord) in het algemeen extreem nuttig is, dus informatici hebben hiervoor ook een datastructuur bedacht.
Om deze datastructuur te begrijpen, bekijken we hoe we een virtueel woordenboek kunnen maken—een datastructuur waarin we kunnen:
Herinner je het voorbeeld van de temperatuurregistraties in december. We gebruikten een array met 31 elementen die overeenkomen met elke dag van de maand om de temperaturen op hun respectieve indexen op te slaan. Deze aanpak maakt het efficiënt opzoeken van de temperatuur voor een bepaalde dag mogelijk.
Dit lijkt op het werken met dataparen (dag, temperatuur), waarbij het doel is om de temperatuur op te halen door de dag op te geven. Vergelijkbaar werken we bij woordenboeken met dataparen (woord, definitie) en willen we de definitie vinden wanneer we een woord hebben.
Dergelijke paren noemen we sleutel-waardeparen of entries. De sleutel is de parameter die in de zoekquery wordt gebruikt en de waarde is de uitkomst van die query.
|
sleutel |
waarde |
|
|
Temperaturen in december |
dag |
temperatuur |
|
Woordenboekprobleem |
woord |
definitie |
Wat ons ervan weerhoudt om een array voor het woordenboekprobleem te gebruiken, is dat onze sleutels strings zijn in plaats van getallen. Met numerieke sleutels kunnen we direct een array gebruiken om sleutels en waarden te koppelen door de waarden op hun corresponderende indexen te plaatsen.
Om dit probleem op te lossen, moeten we eerst de woorden omzetten in getallen. Een functie die deze conversie uitvoert, noemen we een hashfunctie. Er zijn talloze manieren om zo’n functie te maken. We zouden bijvoorbeeld numerieke waarden aan letters kunnen toekennen, met a als 1, b als 2, c als 3, enzovoort, en deze vervolgens optellen.
Het woord data zou dan bijvoorbeeld 4 + 1 + 20 + 1 = 26 opleveren. Deze functie heeft echter nadelen, die we zo bespreken. De details van het ontwerpen van een goede hashfunctie vallen buiten de scope van dit artikel, maar Python biedt handig een hash()-functie die dit efficiënt voor ons afhandelt.
hash("data")-6138587229816301269In het bovenstaande voorbeeld zag je wellicht dat de hashfunctie een negatief getal opleverde. Belangrijk om te weten is dat positieve array-indexen lopen van 0 tot N - 1. Zodra we sleutels naar getallen hebben omgezet, kunnen we ze met de modulo-operator % (die de rest van een deling geeft—bijvoorbeeld 10 % 3 geeft 1) naar het bereik 0 tot N - 1 mappen.
Terzijde: de hash()-functie van Python kan bij verschillende programmasessies andere waarden teruggeven. Ze is alleen deterministisch binnen dezelfde run, wat betekent dat je verschillende hashwaarden voor hetzelfde object kunt zien als je je programma meerdere keren uitvoert.
Neem een array met 100 elementen. Om de index voor de string "data" te vinden, doen we het volgende:
hash("data") % 10031De datastructuur hashtabel is in essentie een grote array die sleutel-waardeparen opslaat op indexen die worden bepaald door een hashfunctie op de sleutels toe te passen.
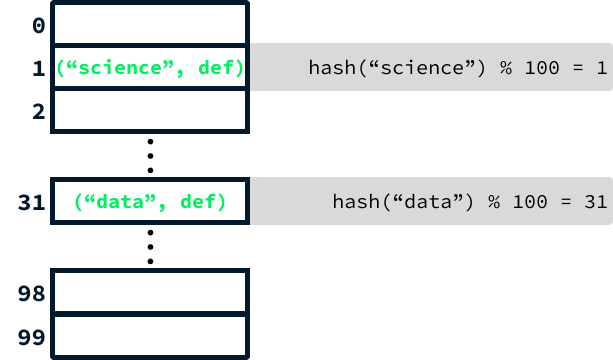
Vanwege ruimtebeperkingen bevat het diagram hierboven alleen de afkorting "def" om de definitie weer te geven. In de praktijk zou het tweede element van elke entry de volledige definitie van het woord zijn.
Er is nog een belangrijk aspect. Omdat er veel meer dan 100 woorden zijn, zullen verschillende woorden onvermijdelijk dezelfde hashwaarde opleveren als we woorden blijven toevoegen. Om dit op te lossen, beperken we elk array-element niet tot één enkel sleutel-waardepaar, maar gebruiken we een gelinkte lijst om alle entries met dezelfde hashwaarde op te slaan.
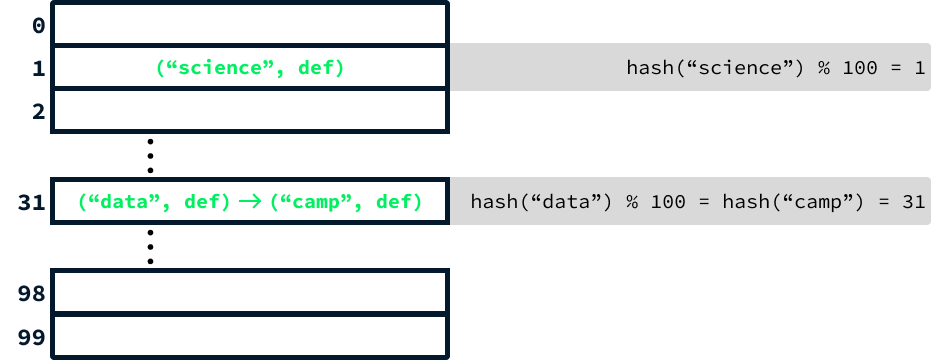
Wanneer twee entries dezelfde hash opleveren, noemen we dat een collisie. Dit verandert de opzoekprocedure licht. Na het berekenen van de hashcode moeten we de lijst doorlopen om de juiste entry te vinden. Hoewel dit de opzoekbewerking vertraagt, kun je aantonen dat het gebruik van een voldoende grote initiële arraygrootte (groter dan 100) en een goed ontworpen hashfunctie de impact van collisions aanzienlijk vermindert. Daardoor blijft de efficiëntie vrijwel gelijk aan die van een array.
Bij een goed ontworpen hashfunctie moet het zeldzaam zijn om verschillende waarden te vinden die dezelfde hash opleveren. Daarom is een simpele hashfunctie die alleen de numerieke waarden van de letters in een woord optelt niet ideaal. Twee woorden die uit dezelfde letters bestaan, ongeacht de volgorde, zouden dan identieke hashcodes opleveren. Zo zouden “listen” en “silent” dezelfde hash hebben. De ingebouwde hashfunctie van Python is daarentegen veel robuuster en specifiek ontworpen om collisions te minimaliseren.
Hashtabellen zijn waarschijnlijk de belangrijkste beschikbare datastructuur. Ze zijn extreem efficiënt en veelzijdig. In Python worden ze geïmplementeerd via de class dict(). Vanwege de gelijkenis met een woordenboek wordt de datastructuur in Python zelfs dictionary genoemd in plaats van hashtabel.
Voor de eenvoud focust ons voorbeeld op het toevoegen en opzoeken van entries. In het algemeen bieden dictionaries meer flexibiliteit en ondersteunen ze extra bewerkingen, zoals verwijderen. Om in Python een lege dictionary (hashtabel) te maken, kun je {} gebruiken, zoals dit:
word_definitions = {}
word_definitions["data"] = "Facts or information."
Je kunt de definitie van een woord opvragen door het woord als sleutel te gebruiken, zoals dit:
print(word_definitions["data"])Facts or information.Stel dat je een website voor een makelaarskantoor ontwikkelt. Je taak is een functie bouwen waarmee gebruikers kunnen filteren op prijs. De functie moet gebruikers in staat stellen om:
Normaal gesproken zou dit betekenen dat je alle woningadvertenties doorloopt en de woningen buiten het gewenste bereik wegfiltert. Wij willen echter een oplossing die beter schaalt, eentje die niet vereist dat je de hele dataset bekijkt om relevante woningen te vinden. Bomen zijn de perfecte datastructuur voor dit soort queries.
Bomen zijn knooppuntgebaseerde datastructuren, zoals gelinkte lijsten. In plaats van vorige en volgende verwijzingen heeft elk knooppunt een waarde en twee verwijzingen: een linker en een rechter knooppunt.
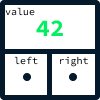
In ons makelaarsvoorbeeld vertegenwoordigt elk knooppunt een woningadvertentie. Om prijsgerelateerde queries te optimaliseren, stellen we een regel vast: advertenties met lagere prijzen staan altijd links van een knooppunt en advertenties met hogere prijzen altijd rechts.
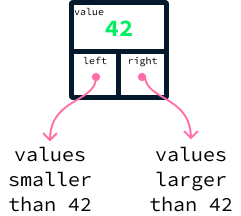
Neem als concreet voorbeeld de volgende boom met de waarden 42, 17, 73, 4, 22 en 89.
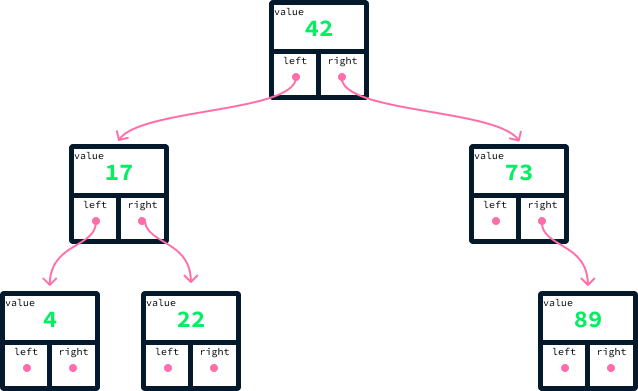
Voor elk knooppunt hebben alle knooppunten links kleinere waarden en alle knooppunten rechts grotere waarden. Een boom die aan deze eigenschap voldoet, heet een binaire zoekboom (binary search tree, BST). Hij is binair omdat elk knooppunt naar maximaal twee andere knooppunten verwijst, de zogenaamde kinderen. Het zoekdeel van de term komt voort uit het feit dat de ordening van de linker- en rechterkinderen het mogelijk maakt om efficiënt in de boom te zoeken.
We zien al hoe een BST helpt om snel de goedkoopste en de duurste woningen te vinden. Door de waardesortering is de goedkoopste altijd het meest linkse knooppunt en de duurste het meest rechtse knooppunt.
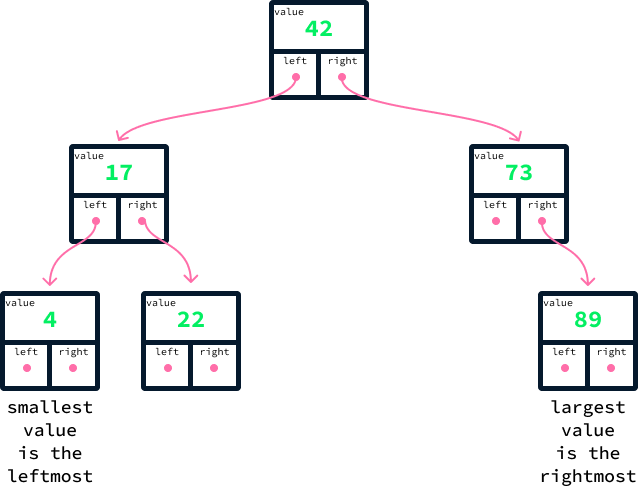
Dit betekent dat we ze kunnen vinden zonder het merendeel van de data te inspecteren. Beginnend bij het bovenste knooppunt, de wortel, volgen we consistent de linker verwijzingen om het minimum en de rechter verwijzingen om het maximum te vinden. Alleen de knooppunten op het pad van de wortel naar respectievelijk het minimum en maximum hoeven te worden bekeken.
Stel dat we alle knooppunten met een waarde van minstens 50 willen vinden. Dit zijn de stappen:
50, met de waarde van de wortel, 42.50 groter is, weten we dat de wortel en alle knooppunten links ervan kleinere waarden hebben. Die kunnen we negeren.73. Bij vergelijking blijkt 50 kleiner dan 73. Dit geeft aan dat alle knooppunten rechts van knooppunt 73 aan ons criterium voldoen.73 geen linkerkind heeft, eindigt onze zoekactie daar.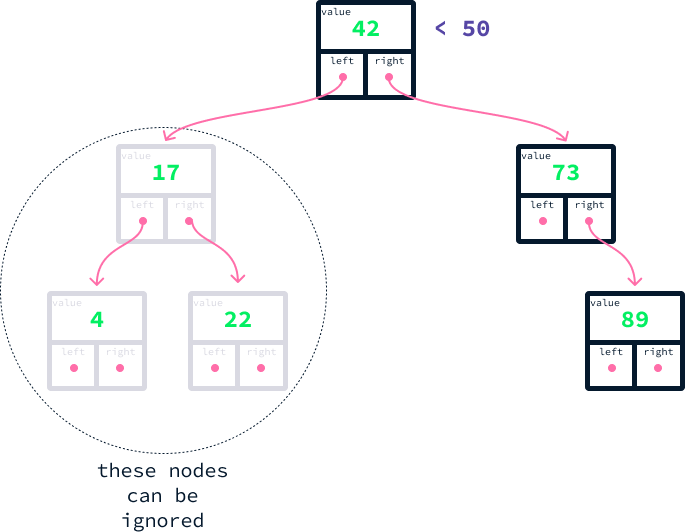
We zien al hoe BST’s queries aanzienlijk kunnen versnellen. Zelfs in dit kleine voorbeeld hebben we de helft van de data niet hoeven te bekijken.
In het algemeen vereist het identificeren van alle knooppunten in een BST die binnen een gegeven bereik vallen het inspecteren van een aantal knooppunten dat in de buurt ligt van het aantal zoekresultaten. Dit is een enorm voordeel ten opzichte van het moeten inspecteren van elk datapunt. Stel je 1.000.000 advertenties voor en een query die slechts 10 resultaten oplevert. Met een lijst zou je een miljoen advertenties moeten inspecteren om de rest weg te filteren. Met een BST hoef je er ongeveer 10 te bekijken. Dat is een snelheidswinst van 100.000.
De efficiëntie van een BST hangt sterk af van de balans van de boom. Als we dezelfde waarden als eerder toevoegen, van klein naar groot—4, 17, 22, 42, 73 en daarna 89—kunnen we eindigen met een ongebalanceerde boom, zoals hieronder:
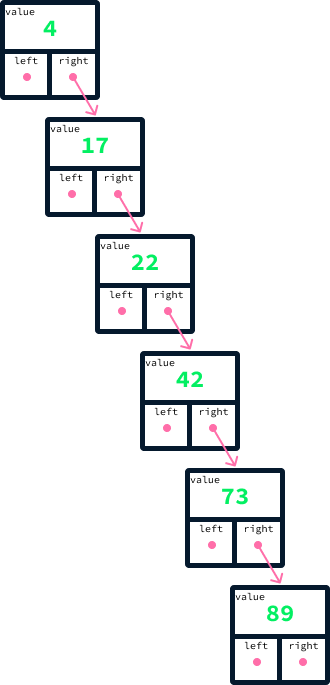
Om het maximum te vinden in een BST, beginnen we bij de wortel en volgen we de rechter verwijzingen tot we bij een knooppunt zonder rechterkind komen. In het geval van een ongebalanceerde boom zoals hierboven, vereist dit het bekijken van elk knooppunt. Idealiter willen we dat de knooppunten gelijkmatiger over links en rechts verdeeld zijn. Hoe je die balans consequent bereikt, valt buiten de scope van dit artikel. Een type binaire zoekboom dat zo’n balans bewaart, heet een AVL-boom.
Het avltree-pakket biedt een implementatie van een AVL-boom. Het onderstaande codefragment laat zien hoe we het kunnen gebruiken op deze dataset met woningadvertenties, een opgeschoonde subset van de USA Real Estate Dataset.
import csv
from avltree import AvlTree as Tree

# Load the listings CSV data
with open("listings.csv", "rt") as f:
    reader = csv.reader(f)
    listings = list(reader)

# Create the tree based on the price column (column index 2)
tree = Tree()
for listing in listings[1:]:
    price = float(listing[2])
    tree[price] = listing

# Display the cheapest listing price
print("Cheapest:", tree.minimum())

# Display the most expensive listing price
print("Most expensive:", tree.maximum())

# Display the number of listings whose price is between 100,000 and 110,000
listings_in_range = list(tree.between(100000, 110000))
print("Num listings between 100000 and 110000:", len(listings_in_range))
Cheapest: 50017.0
Most expensive: 19999900.0
Num listings between 100000 and 110000: 403We gebruiken eerst de csv-module om de dataset listings.csv te lezen. Vervolgens maken we een AVL-boom op basis van de prijskolom. Daarna gebruiken we de methoden minimum(), maximum() en between() om de minimumprijs, maximumprijs en het aantal advertenties met een prijs tussen $100.000 en $110.000 te bepalen.
De laatste datastructuur die we in dit artikel bespreken is de graaf.
Stel dat je data analyseert van een socialmediaplatform. Deze data bestaat uit een lijst met gebruikers en de vriendschappen tussen hen. Je doel is om gemeenschappen binnen het sociale netwerk te identificeren. Hoewel het begrip gemeenschap op verschillende manieren kan worden gedefinieerd, verwijst het doorgaans naar een groep gebruikers met relatief veel vriendschappen binnen die groep.
Grafen zijn de ideale datastructuur om data te representeren wanneer we entiteiten en relaties tussen paren van die entiteiten hebben. In ons voorbeeld zijn de entiteiten de gebruikers en de relaties hun vriendschappen.
Grafen zijn knooppuntgebaseerde structuren. In tegenstelling tot gelinkte lijsten en bomen, die lineaire of hiërarchische verbindingen tussen knooppunten hebben, kan in een graaf elk knooppunt met meerdere andere knooppunten verbonden zijn. Deze verbindingen, randen genaamd, geven relaties tussen de knooppunten aan.
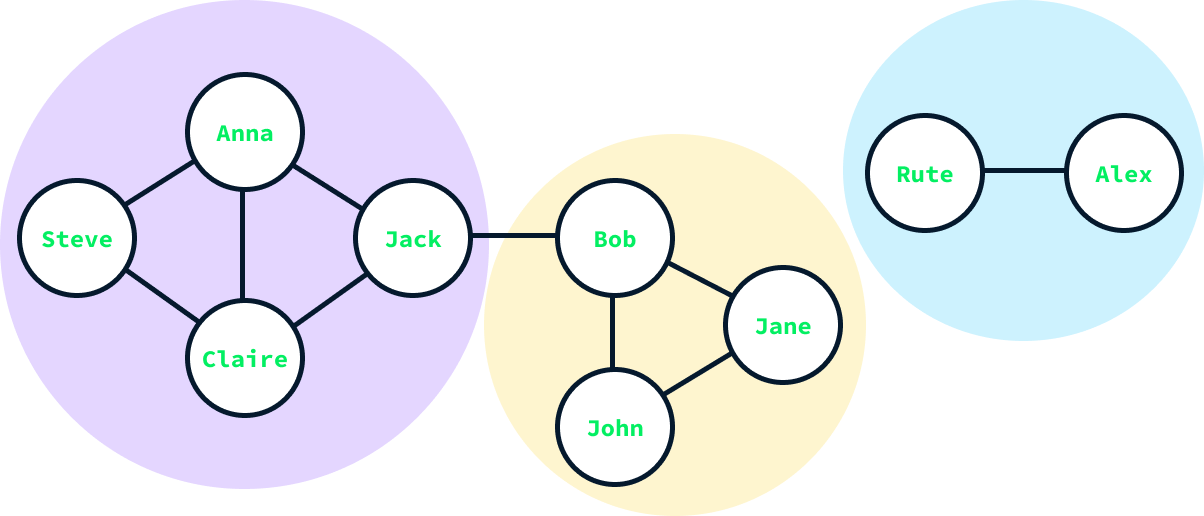
In ons sociale netwerk kan elke gebruiker als een knooppunt worden weergegeven. Tussen twee knooppunten kan een rand worden getrokken om een vriendschap aan te duiden.
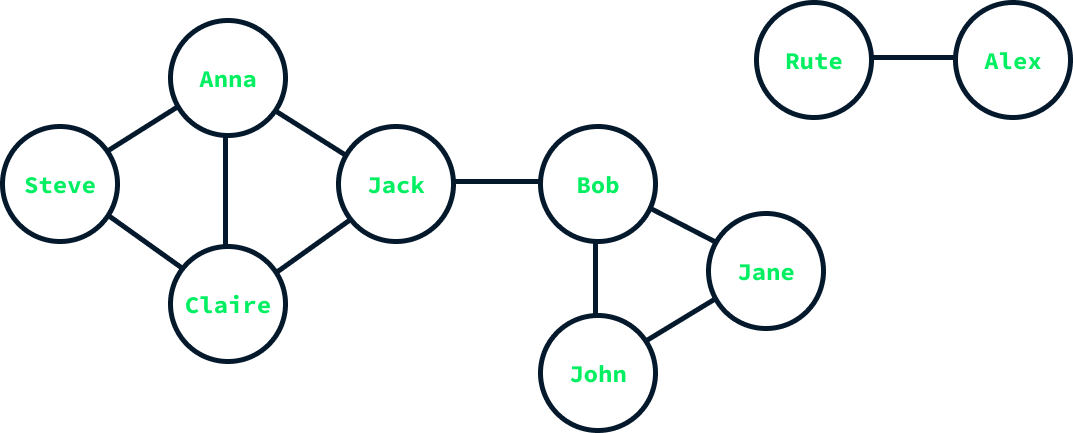
Het bovenstaande diagram toont een graaf die vriendschappen binnen een klein sociaal netwerk weergeeft. De knooppunten representeren de gebruikers en zijn gelabeld met hun namen, terwijl de randen de vriendschappen weergeven. Zo is Anna bevriend met Steve, Claire en Jack, wat betekent dat er randen lopen tussen haar knooppunt en die van hen.
De bewerkingen die een graaf zou moeten ondersteunen, zijn onder meer:
Een gangbare manier om een graaf te implementeren is met een hashtabel en lijsten. We maken een hashtabel met één entry per knooppunt. De sleutel van elke entry is het knooppunt en de waarde is een lijst met alle knooppunten waarmee dat knooppunt verbonden is.
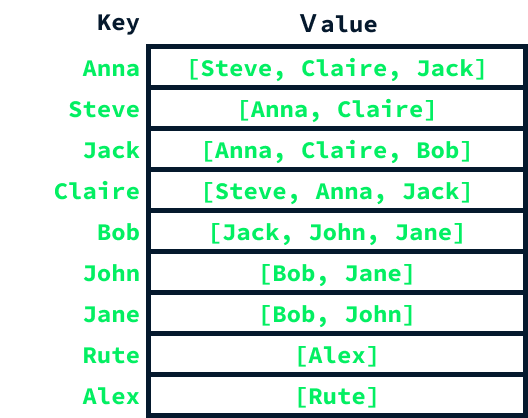
Het pakket networkx biedt een Python-implementatie voor het maken en manipuleren van grafen. Bovendien bevat de networkx-library een breed scala aan graafalgoritmen, waaronder die voor communitydetectie. Laten we het gebruiken om de hierboven genoemde graaf te bouwen en een gangbaar communitydetectie-algoritme toe te passen om de uitkomsten te zien.
Om de graaf te maken, beginnen we met het importeren van de networkx-library en het initialiseren van een lege graaf:
import networkx as nx
G = nx.Graph()
Knooppunten kun je toevoegen met de add_node()-methode.
G.add_node("Anna")
G.add_node("Steve")
G.add_node("Jack")
G.add_node("Claire")
G.add_node("Bob")
G.add_node("Jane")
G.add_node("John")
G.add_node("Rute")
G.add_node("Alex")
Randen kun je toevoegen met de add_edge()-methode.
G.add_edge("Anna", "Steve")
G.add_edge("Anna", "Jack")
G.add_edge("Anna", "Claire")
G.add_edge("Steve", "Claire")
G.add_edge("Claire", "Jack")
G.add_edge("Jack", "Bob")
G.add_edge("Bob", "John")
G.add_edge("Bob", "Jane")
G.add_edge("John", "Jane")
G.add_edge("Rute", "Alex")
Met onze graaf gemaakt, kunnen we de communities erin berekenen. Er zijn verschillende algoritmen voor communitydetectie en in dit geval gebruiken we de Louvain-methode. De communitydetectie-algoritmen vind je in de subpackage community van networkx. We focussen specifiek op de functie louvain_communities().
Zo gebruik je die:
communities = nx.community.louvain_communities(G)
print(communities)
[{'Jack', 'Claire', 'Anna', 'Steve'}, {'Bob', 'John', 'Jane'}, {'Rute', 'Alex'}]De output is een lijst met sets, waarbij elke set een community voorstelt. We zien dat het algoritme drie communities heeft gedetecteerd, wat overeenkomt met onze verwachting gezien de structuur van de graaf.
Wil je meer leren over grafen, leer dan hoe je het Dijkstra-algoritme in Python implementeert.
Bij elke datastructuur hebben we een lijst met ondersteunde bewerkingen gegeven. Deze bewerkingen dienen als richtlijnen voor wanneer je die datastructuur gebruikt, omdat ze erop is ontworpen om die bewerkingen efficiënt uit te voeren.
Zo ondersteunt de Python-list() ook extra bewerkingen, zoals het verwijderen van elementen. Maar dit zijn niet de taken waarin een array-lijst uitblinkt. Specifiek vereist het verwijderen van een element uit het midden van een lijst dat alle data (behalve het verwijderde element) naar een nieuwe lijst wordt gekopieerd, wat erg tijdrovend kan zijn.
Wanneer de data van nature met getallen wordt geïndexeerd en het aantal entries bekend is (bijvoorbeeld de dagen van een maand), is een array meestal de beste keuze. Voor algemenere indexering of dynamische datasets zijn dictionaries een goed alternatief.
Om data sequentieel te verwerken, één entry tegelijk, gebruik je vaak queues of stacks, afhankelijk van de gewenste verwerkingsvolgorde.
Bomen zijn doorgaans het antwoord wanneer we complexere queries op de data willen uitvoeren, zoals het vinden van alle entries binnen een bereik of extremen.
En wanneer er een relatie tussen paren datapoints is, is een graaf een effectieve manier om die relaties op te slaan en weer te geven. Er bestaan graafalgoritmen die ons in staat stellen om veelvoorkomende vragen over datasets met zulke paarrelaties te beantwoorden.
Datastructuren vormen een enorm domein, en we hebben hier slechts het topje van de ijsberg behandeld. In sommige situaties is de oplossing om een compleet nieuwe datastructuur te ontwerpen die volledig is afgestemd op het probleem. Toch helpt vertrouwdheid met de in dit artikel besproken datastructuren je om in de juiste richting te denken bij het oplossen van je dataproblemen.
In dit artikel hebben we geleerd dat datastructuren methoden zijn om data in specifieke formaten te organiseren om efficiënt informatie op te halen.
Er zijn twee fundamentele typen datastructuren: array-gebaseerde (bijvoorbeeld hashtabellen) en knooppuntgebaseerde (bijvoorbeeld grafen) structuren.
Lineaire structuren, zoals arrays, queues en stacks, organiseren elementen sequentieel, de een na de ander. Niet-lineaire structuren, zoals hashtabellen, bomen en grafen, organiseren data op basis van de onderlinge relaties.
De keuze voor de juiste datastructuur hangt af van de aard van de queries die je wilt uitvoeren.
Wil je leren over de verschillende datastructuren in Python, bekijk dan deze tutorial over Python-datastructuren.
Leer Python met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

