
Khóa học
Cấu trúc dữ liệu và Thuật toán với Python
4 giờ
48.3K
Cấu trúc dữ liệu tồn tại cả trong thế giới số và thế giới vật lý. Một cuốn từ điển là ví dụ vật lý của một cấu trúc dữ liệu, trong đó dữ liệu gồm các định nghĩa từ được sắp xếp theo thứ tự bảng chữ cái trong một cuốn sách. Cách tổ chức này cho phép đặt một truy vấn cụ thể: với một từ cho trước, ta có thể tra định nghĩa của nó.
Cốt lõi mà nói, một cấu trúc dữ liệu là phương pháp tổ chức dữ liệu giúp thực hiện các kiểu truy vấn và thao tác cụ thể trên dữ liệu đó.
Chúng ta sẽ bắt đầu với các cấu trúc dữ liệu tuyến tính như mảng, danh sách, hàng đợi và ngăn xếp. Sau đó, chúng ta sẽ quay lại giải thích sự khác biệt giữa cấu trúc tuyến tính và phi tuyến tính trước khi đi sâu vào bảng băm, cây và đồ thị.
Nếu bạn muốn tìm hiểu thêm, hãy xem khóa học này về cấu trúc dữ liệu và thuật toán trong Python.
Mảng là các cấu trúc dữ liệu nền tảng, có mặt rộng rãi trong các ngôn ngữ lập trình. Chúng cho phép lưu trữ một số lượng cố định (N) các giá trị tuần tự trong bộ nhớ.
Các phần tử mảng được đánh chỉ số từ phần tử đầu tiên tại chỉ số (0) đến phần tử cuối cùng tại chỉ số (N-1).
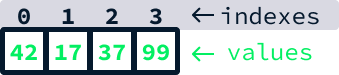
Chúng cho phép các thao tác sau:
Mảng rất hiệu quả trong các tình huống mà số lượng giá trị cần lưu trữ được biết trước, và các thao tác chính liên quan đến đọc và ghi dữ liệu tại các chỉ số cụ thể.
Hãy xét một tình huống bạn cần lưu các số đo nhiệt độ hằng ngày cho tháng 12. Bạn có thể muốn cho phép người dùng truy xuất nhiệt độ của một ngày cụ thể và thực hiện các phân tích thống kê trên nhiệt độ trong cả tháng.
Vì số ngày trong tháng 12 được biết trước là 31, mảng là lựa chọn tuyệt vời để lưu trữ các số đo nhiệt độ. Ban đầu, ta sẽ tạo một mảng với 31 vị trí trống. Sau đó, mỗi khi có số đo nhiệt độ, nhiệt độ của một ngày sẽ được gán vào chỉ số mảng tương ứng: ngày 1 lưu ở chỉ số 0, ngày 2 ở chỉ số 1, và cứ thế cho đến ngày 31 ở chỉ số 30.
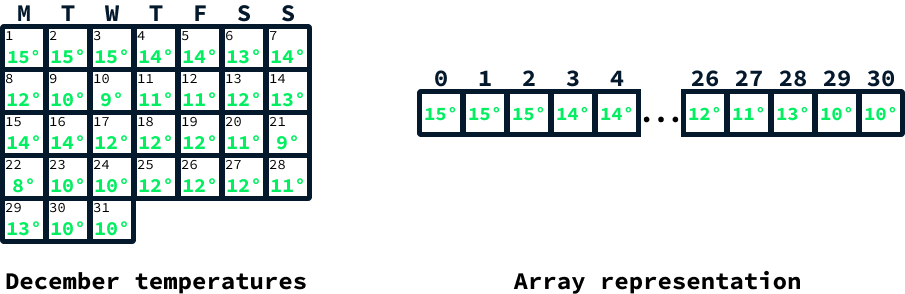
Truy cập chỉ số tương ứng cho phép lấy nhiệt độ của một ngày cụ thể. Các thống kê như nhiệt độ trung bình có thể được xác định bằng cách duyệt qua tất cả phần tử, duy trì tổng lũy tích, rồi chia cho kích thước mảng.
Mảng không có sẵn một cách thuần trong Python. Chúng được dùng ở tầng dưới làm cấu trúc nền cho nhiều kiểu dữ liệu, nhưng không được hỗ trợ trực tiếp trong ngôn ngữ. Để dùng mảng một cách tường minh, có thể dùng các thư viện như array, cung cấp triển khai mảng. Tuy vậy, trong nhiều trường hợp, dùng danh sách với kích thước cố định sẽ thực tế hơn ở những tình huống cần mảng. Danh sách linh hoạt và là một phần cốt lõi của Python, như ta sẽ bàn ngay sau đây.
Ta có thể tạo một danh sách để mô phỏng một mảng 31 phần tử, mỗi phần tử khởi tạo là None, bằng [None] * 31. Ở đây, None cho biết chưa có số đo nhiệt độ nào được ghi nhận.
december_temperatures = [None] * 31Để gán giá trị tại một chỉ số cụ thể, ta dùng december_temperatures[index], trong đó index là số từ 0 đến 30. Ví dụ, để ghi nhiệt độ cho ngày đầu tiên (lưu tại chỉ số 0), ta làm như sau:
december_temperatures[0] = 15Truy cập một nhiệt độ cũng tương tự, dùng december_temperatures[index].
print(december_temperatures[0])15Giờ hãy tưởng tượng thay vì tập trung vào tháng 12, ta lắp một cảm biến ở đâu đó để lấy số đo nhiệt độ định kỳ trong một khoảng thời gian không xác định. Trong kịch bản này, dùng mảng không phải lựa chọn tốt nhất vì ta có thể hết chỗ do kích thước cố định ngay khi tạo.
Một cấu trúc dữ liệu phù hợp hơn trong trường hợp này là danh sách. Có hai loại danh sách:
Danh sách mảng có thể xem như phiên bản linh hoạt hơn của mảng. Chúng có thể thực hiện tất cả chức năng của mảng và còn có thể nối thêm giá trị mới, vì vậy kích thước không cố định khi tạo. Trong Python, danh sách mảng tương ứng với việc dùng list().
Triển khai của chúng dựa vào việc dùng một mảng được mở rộng khi hết chỗ, do đó mới có tên array list. Tuy nhiên, như ta đã biết, mảng không thể tự lớn lên, vậy điều này diễn ra thế nào?
Khi mảng nền của một danh sách mảng đã đầy và ta muốn nối thêm giá trị mới, một mảng lớn hơn sẽ được tạo ngầm. Tất cả các giá trị trước đó được sao chép vào mảng mới, lớn hơn này. Sau đó, giá trị mới được thêm vào vị trí trống đầu tiên trong mảng mới.
Hãy tưởng tượng ta muốn nối giá trị 71 vào mảng này:
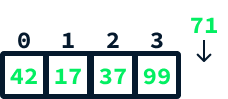
Ta có thể thực hiện như sau:
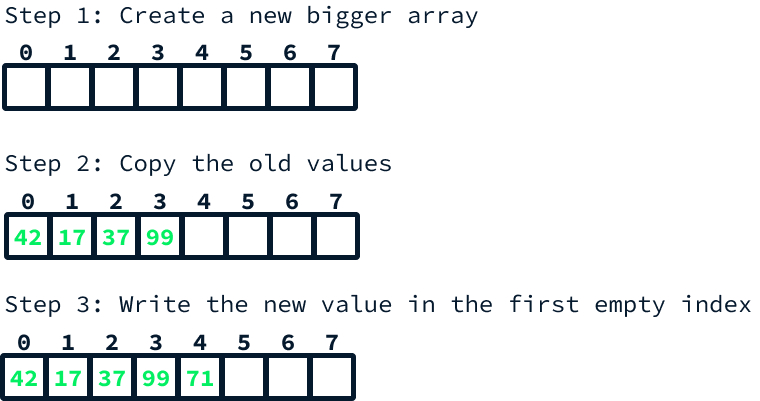
Lượng không gian mới được cấp phát mỗi khi ta thực hiện thao tác này là yếu tố then chốt đối với hiệu năng của danh sách mảng. Nếu mỗi lần nối, ta tạo một mảng chỉ có đúng một vị trí mới cho giá trị vừa thêm, điều đó có nghĩa là mỗi thao tác nối sẽ cần sao chép toàn bộ dữ liệu hiện có. Cực kỳ kém hiệu quả—hãy tưởng tượng phải sao chép hàng triệu bản ghi chỉ để thêm một bản ghi mới.
Thay vào đó, chiến lược phổ biến là nhân đôi kích thước mảng mỗi khi cần thêm chỗ. Cách tiếp cận này có thể chứng minh rằng về lâu dài sẽ triệt tiêu ảnh hưởng của các bước sao chép bổ sung này.
Để thêm phần tử vào một danh sách Python, ta dùng phương thức .append(). Đây là ví dụ tạo một danh sách rỗng và thêm một số đo nhiệt độ vào đó:
temperatures = []
temperatures.append(35)Để cấu trúc dữ liệu trong máy tính, ta cần một cách để liên hệ các giá trị với nhau. Mảng làm điều này bằng cách cấp phát các vị trí bộ nhớ liền kề—tức là các vị trí bộ nhớ nằm sát nhau—và lưu trữ giá trị tuần tự. Hãy hình dung như một dãy nhà trên một con phố: mỗi ngôi nhà có một địa chỉ duy nhất (chỉ số), và chúng nằm cạnh nhau về mặt vật lý.
Tuy nhiên, đây không phải là phương pháp duy nhất để tổ chức dữ liệu. Một phương án khác là dùng cấu trúc dựa trên nút (node).
Một nút là một đối tượng lưu trữ một giá trị cùng với các tham chiếu tới các nút khác. Ví dụ, để tạo một cấu trúc giống danh sách bằng các nút, ta có thể có một nút giữ cả giá trị và tham chiếu tới phần tử tiếp theo trong danh sách. Trong Python, có thể triển khai bằng một lớp:
class Node:
    def __init__(self, value, next_node):
        self.value = value
        self.next_node = next_node
Dùng cách này, ta có thể tạo một danh sách bằng cách liên kết các giá trị với nhau qua tham chiếu next_node. Sau đây là đoạn mã tạo một danh sách với các giá trị 42, 17 và 37:
node_37 = Node(37, None) # There's no node after 37 so next_node is None
node_17 = Node(17, node_37)
node_42 = Node(42, node_17)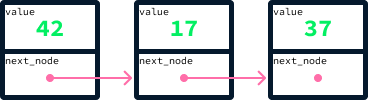
Liên kết thủ công các nút theo cách này không thực tế. Triển khai thực tế cần tạo thêm một lớp khác để duy trì tham chiếu tới cả nút đầu và nút cuối của danh sách. Để nối thêm một giá trị, ta:
Hãy tưởng tượng ta muốn nối giá trị 71 vào mảng ví dụ:
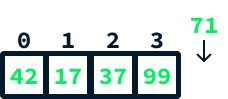
Ta có thể thực hiện như sau:
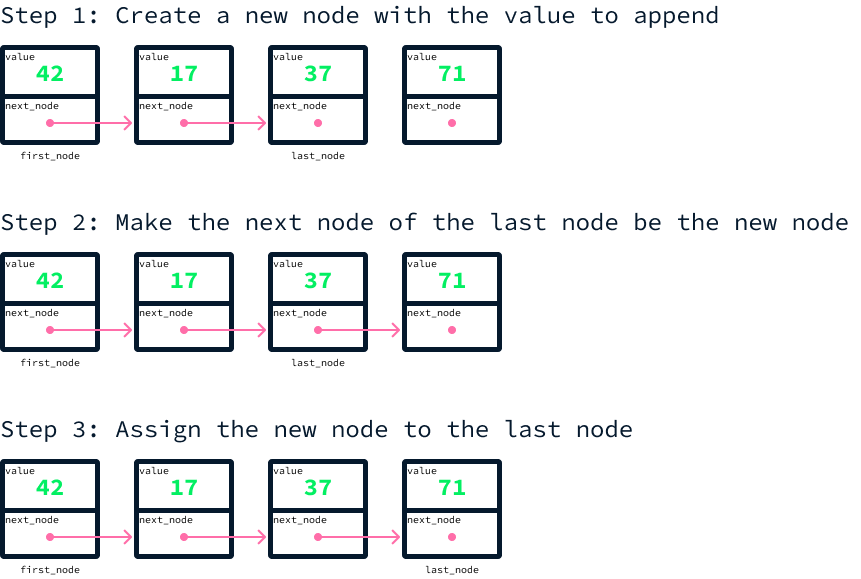
class LinkedList:
    def __init__(self):
        self.first_node = None
        self.last_node = None

    def append(self, value):
        node = Node(value, None)
        if self.first_node is None:
            self.first_node = node
            self.last_node = node
        else:
            self.last_node.next_node = node
            self.last_node = node
Không giống danh sách mảng, ta không thể truy cập trực tiếp giá trị theo chỉ số. Để đọc một giá trị cụ thể tại một chỉ số, ta phải bắt đầu từ nút đầu và lần lượt di chuyển từ nút này sang nút kế tiếp cho đến khi tới chỉ số mong muốn. Quá trình này chậm hơn rất nhiều so với truy cập trực tiếp. Nếu có hàng triệu giá trị lưu trong danh sách, ta sẽ phải đọc qua hàng triệu giá trị trong bộ nhớ để đến được một chỉ số cụ thể.
Ưu điểm của danh sách liên kết nằm ở chỗ ta có thể thêm và xóa phần tử ngay lập tức ở đầu hoặc cuối danh sách. Khả năng này mở ra việc triển khai hai cấu trúc dữ liệu mới: hàng đợi và ngăn xếp, mà ta sẽ thảo luận tiếp theo.
Hãy tưởng tượng bạn đang phát triển một ứng dụng nhà hàng ghi nhận đơn hàng khách và chuyển chúng đến bếp. Khi khách đến nhà hàng, họ sẽ xếp hàng để gọi món, kỳ vọng được phục vụ theo thứ tự họ đến. Điều này có nghĩa là khách đầu tiên trong hàng sẽ nhận món trước, và khách cuối cùng sẽ nhận món sau cùng.
Trong bếp, đầu bếp muốn tập trung vào một đơn mỗi lần, nên ứng dụng chỉ nên hiển thị đơn hiện tại. Khi một đơn đã được chuẩn bị và chuyển đi, đơn tiếp theo trong hàng đợi nên được hiển thị.
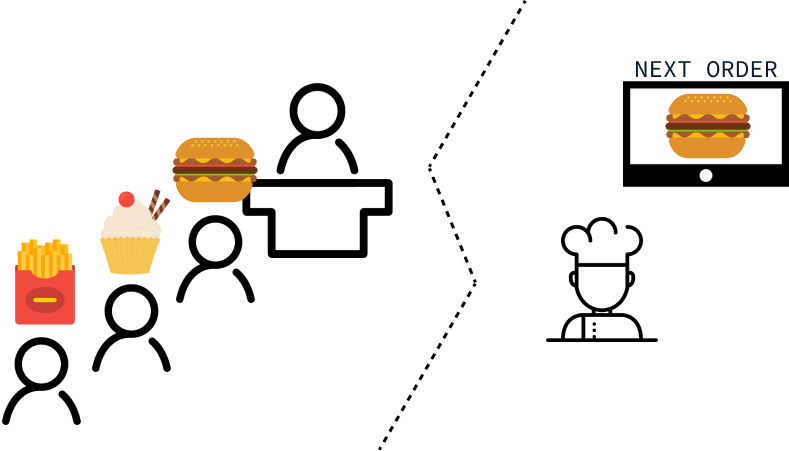
Ta có thể diễn giải các yêu cầu trên là cần một cấu trúc dữ liệu hỗ trợ các thao tác sau:
Đó chính xác là những gì hàng đợi cung cấp. Hàng đợi có thể được triển khai bằng danh sách liên kết, trong đó phần tử được thêm bằng cách nối vào cuối danh sách. Vì các phần tử được sắp theo thời gian đến, nút đầu tiên luôn là nút nên được phục vụ tiếp theo.
Đây là cách các đơn ở trên sẽ được lưu trong hàng đợi:
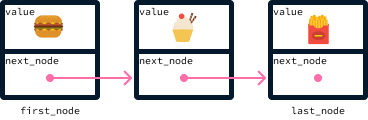
Khi một đơn đã sẵn sàng, nó có thể được xóa bằng cách cập nhật phần tử đầu tiên sang next_node của nó, giả sử có nút phía sau. Nút đầu mới trở thành nút thứ hai trước đó:
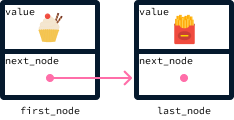
Hàng đợi được mô tả là cấu trúc vào trước, ra trước (FIFO) vì phần tử được thêm đầu tiên cũng là phần tử bị xóa đầu tiên. Trong ví dụ nhà hàng, khách đến đầu tiên cũng là người được phục vụ đầu tiên (và bị loại khỏi danh sách của đầu bếp).
Để dùng hàng đợi trong Python, ta có thể sử dụng bộ sưu tập deque từ mô-đun collections. Hãy import mô-đun này và tạo một hàng đợi rỗng như sau:
from collections import deque
orders = deque()
Thêm phần tử mới vào cuối hàng đợi có thể thực hiện bằng phương thức .append():
orders.append("burger")
orders.append("sunday")
orders.append("fries")
Để lấy và loại bỏ đơn tiếp theo ở đầu hàng đợi, ta dùng phương thức .popleft():
orders.append("burger")
orders.append("sunday")
orders.append("fries")
burger
sunday
friesTrong một số tình huống, ta muốn hành vi ngược lại với hàng đợi—ta muốn theo dõi phần tử được thêm gần đây nhất.
Để minh họa, hãy tưởng tượng bạn được giao nhiệm vụ thêm tính năng hoàn tác (undo) vào một trình chỉnh sửa ảnh. Điều này đòi hỏi một cách để theo dõi các thao tác của người dùng, cung cấp quyền truy cập tới các thao tác gần đây nhất. Bởi vì tính năng hoàn tác thường đảo ngược các hành động bắt đầu từ hành động cuối cùng và lùi dần về đầu.
Ngăn xếp chính là cấu trúc dữ liệu hỗ trợ các thao tác này:
Tương tự hàng đợi, ngăn xếp cũng có thể được triển khai bằng danh sách liên kết. Thêm phần tử vẫn được thực hiện bằng cách nối vào danh sách. Tuy nhiên, trọng tâm của ta chuyển sang phần tử cuối cùng của danh sách thay vì phần tử đầu. Để truy xuất phần tử gần nhất, ta tìm phần tử cuối của danh sách. Xóa phần tử cuối yêu cầu ta loại bỏ phần tử cuối đó.
Trong cấu trúc nút của chúng ta, ta chỉ theo dõi nút tiếp theo. Để tạo điều kiện xóa phần tử cuối, ta cần truy cập phần tử đứng trước nó, xóa next_node của phần tử đó, và đẩy phần tử đó thành phần tử cuối. Ta có thể làm điều này bằng cách sửa cấu trúc nút để cũng theo dõi cả nút trước của mỗi nút. Danh sách liên kết như vậy được gọi là danh sách liên kết kép.
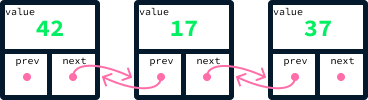
Ngăn xếp được mô tả là cấu trúc vào sau, ra trước (LIFO) vì phần tử thêm sau cùng sẽ bị loại bỏ đầu tiên.
Để dùng ngăn xếp trong Python, ta có thể sử dụng cùng bộ sưu tập deque. Ta dùng phương thức .append() để thêm phần tử mới:
from collections import deque
actions = deque()

actions.append("crop")
actions.append("desaturate")
actions.append("resize")
Để lấy và loại bỏ phần tử tiếp theo trên đỉnh ngăn xếp, ta dùng phương thức .pop():
print(actions.pop())
print(actions.pop())
print(actions.pop())
resize
desaturate
cropĐến giờ, ta đã khám phá năm cấu trúc dữ liệu: mảng, danh sách mảng, danh sách liên kết, hàng đợi và ngăn xếp. Mỗi cấu trúc trong số này đều là cấu trúc tuyến tính vì các phần tử được sắp xếp theo một chuỗi, với mỗi phần tử có phần tử trước và sau rõ ràng.
Tiếp theo, ta sẽ chuyển sang các cấu trúc dữ liệu phi tuyến tính. Không giống các loại tuyến tính, các cấu trúc này không sắp xếp các phần tử nằm cạnh nhau theo kiểu tuyến tính. Do đó, chúng không có khái niệm xác định về phần tử trước và sau. Thay vào đó, chúng thiết lập các kiểu quan hệ khác nhau giữa các phần tử.
Đặc điểm này khiến chúng đặc biệt phù hợp để thực hiện các truy vấn chuyên biệt trên dữ liệu với hiệu quả cao thay vì chỉ đơn thuần là phương tiện lưu dữ liệu trong bộ nhớ.
Chúng ta mở đầu bài viết bằng việc bàn về một ví dụ đời thực của cấu trúc dữ liệu: từ điển. Hóa ra việc tổ chức dữ liệu sao cho có thể tra cứu theo một trường cụ thể (ví dụ, tra định nghĩa theo từ) là điều cực kỳ hữu ích nói chung, nên các nhà khoa học máy tính cũng phát minh ra một cấu trúc dữ liệu cho phép điều này.
Để hiểu cấu trúc dữ liệu này, hãy xem cách ta có thể tạo ra một từ điển ảo—tức là một cấu trúc dữ liệu mà ở đó ta có thể:
Hãy nhớ lại ví dụ ghi nhận nhiệt độ trong suốt tháng 12. Ta đã dùng một mảng với 31 phần tử tương ứng với mỗi ngày trong tháng để lưu nhiệt độ tại các chỉ số tương ứng. Cách tiếp cận này cho phép tra cứu hiệu quả nhiệt độ của bất kỳ ngày nào.
Kịch bản này tương tự như làm việc với các cặp dữ liệu (ngày, nhiệt độ), trong đó mục tiêu là truy xuất nhiệt độ bằng cách chỉ định ngày. Tương tự, trong trường hợp từ điển, ta xử lý các cặp dữ liệu (từ, định nghĩa) và nhằm tìm định nghĩa khi cung cấp một từ.
Các cặp như vậy được gọi là cặp khóa-giá trị hay mục nhập (entry). Khóa là tham số dùng trong truy vấn tra cứu, và giá trị là kết quả của truy vấn đó.
|
khóa |
giá trị |
|
|
Bài toán nhiệt độ tháng 12 |
ngày |
nhiệt độ |
|
Bài toán từ điển |
từ |
định nghĩa |
Điều ngăn ta dùng mảng cho bài toán từ điển là khóa của ta là chuỗi thay vì số. Với khóa là số, ta có thể dùng trực tiếp mảng để gắn khóa và giá trị bằng cách đặt giá trị tại chỉ số tương ứng.
Để giải bài toán này, trước tiên ta cần chuyển các từ thành số. Một hàm thực hiện phép chuyển đổi này được gọi là hàm băm. Có rất nhiều cách để tạo ra một hàm như vậy. Ví dụ, ta có thể gán giá trị số cho từng chữ cái, với a là 1, b là 2, c là 3, v.v., rồi cộng các giá trị này lại.
Ví dụ, từ data sẽ được tính là 4 + 1 + 20 + 1 = 26. Tuy nhiên, hàm này có nhược điểm, sẽ bàn ngay sau. Việc thiết kế một hàm băm hiệu quả vượt ngoài phạm vi bài viết này, nhưng Python thuận tiện cung cấp hàm hash() xử lý tác vụ này một cách hiệu quả cho chúng ta.
hash("data")-6138587229816301269Trong ví dụ trên, bạn có thể nhận thấy hàm băm trả về một số âm. Lưu ý rằng chỉ số dương của mảng nằm trong khoảng từ 0 đến N - 1. Sau khi đã chuyển khóa thành số, ta có thể ánh xạ chúng vào khoảng 0 đến N - 1 bằng toán tử modulo % (trả về phần dư của một phép chia—chẳng hạn, 10 % 3 cho ra 1).
Lưu ý thêm: hàm hash() của Python có thể trả về các giá trị khác nhau giữa các lần chạy chương trình. Nó chỉ xác định trong cùng một lần chạy, nghĩa là bạn có thể thấy các giá trị băm khác nhau cho cùng một đối tượng nếu bạn chạy chương trình nhiều lần.
Xét một mảng chứa 100 phần tử. Để xác định chỉ số tương ứng với chuỗi "data", ta làm như sau:
hash("data") % 10031Cấu trúc dữ liệu bảng băm về bản chất là một mảng lớn lưu trữ các cặp khóa-giá trị tại các chỉ số được quyết định bằng cách áp dụng hàm băm lên các khóa.
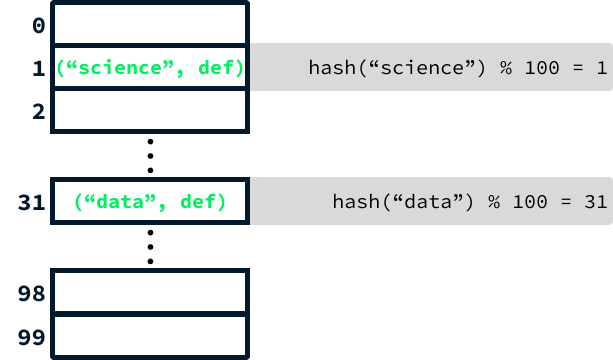
Vì hạn chế không gian, sơ đồ trên chỉ bao gồm viết tắt "def" để đại diện cho định nghĩa. Tuy nhiên, trong thực tế, phần tử thứ hai của mỗi mục sẽ là định nghĩa đầy đủ của từ.
Có một khía cạnh quan trọng khác cần cân nhắc. Do có nhiều hơn 100 từ rất nhiều, nếu ta tiếp tục thêm từ, các từ khác nhau chắc chắn sẽ cho ra cùng một giá trị băm. Để giải quyết điều này, thay vì giới hạn mỗi phần tử mảng chỉ một cặp khóa-giá trị, ta dùng một danh sách liên kết để lưu tất cả các mục có cùng giá trị băm.
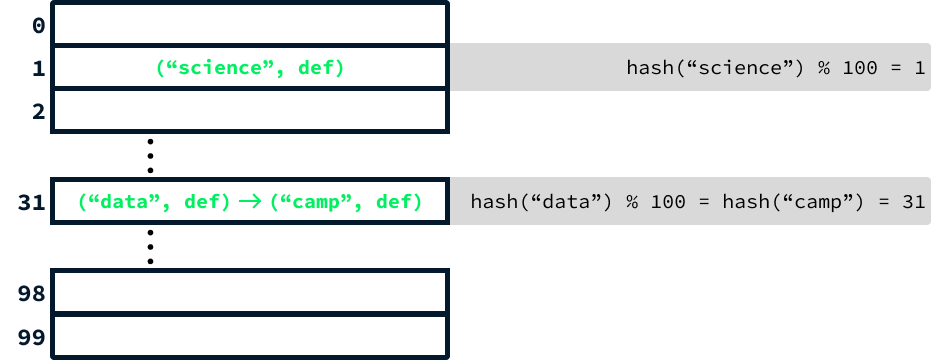
Khi hai mục tạo ra cùng một giá trị băm, điều này được gọi là va chạm. Tình huống này làm thay đổi chút ít quy trình tra cứu. Sau khi tính mã băm, cần duyệt qua danh sách để tìm đúng mục. Dù cách này làm chậm thao tác tra cứu, có thể chứng minh rằng dùng kích thước mảng khởi tạo đủ lớn (lớn hơn 100) và một hàm băm được thiết kế tốt sẽ giảm đáng kể tác động của va chạm. Do đó, hiệu năng vẫn gần tương đương với mảng.
Với một hàm băm được thiết kế hiệu quả, việc tìm các giá trị khác nhau tạo ra cùng băm sẽ hiếm khi xảy ra. Đây là lý do tại sao một hàm băm đơn giản chỉ cộng các giá trị số của ký tự trong một từ không phải là lựa chọn tốt. Bất kỳ hai từ có cùng tập chữ cái, bất kể thứ tự, sẽ cho cùng mã băm. Ví dụ, “listen” và “silent” sẽ cho cùng băm. Ngược lại, hàm băm tích hợp sẵn của Python mạnh mẽ hơn nhiều và được thiết kế đặc biệt để giảm thiểu va chạm.
Bảng băm có lẽ là cấu trúc dữ liệu quan trọng nhất. Chúng cực kỳ hiệu quả và linh hoạt. Trong Python, chúng được triển khai qua lớp dict(). Do giống với từ điển, trong Python, cấu trúc dữ liệu này thực tế được gọi là dictionary thay vì hash table.
Để đơn giản, ví dụ của chúng ta tập trung vào thêm và tra cứu mục. Nhìn chung, dictionary linh hoạt hơn và hỗ trợ nhiều thao tác bổ sung, bao gồm xóa. Để tạo một dictionary (bảng băm) rỗng trong Python, bạn có thể dùng {} như sau:
word_definitions = {}
word_definitions["data"] = "Facts or information."
Bạn có thể truy cập định nghĩa của một từ bằng cách dùng từ đó làm khóa, như sau:
print(word_definitions["data"])Facts or information.Hãy tưởng tượng bạn đang phát triển một website cho một công ty bất động sản. Nhiệm vụ của bạn là tạo một tính năng cho phép người dùng lọc danh sách theo giá. Tính năng này nên cho phép người dùng:
Thông thường, quá trình này sẽ bao gồm việc duyệt qua tất cả danh sách nhà và lọc ra những danh sách nằm ngoài phạm vi giá mong muốn. Tuy nhiên, mục tiêu của chúng ta là phát triển một giải pháp mở rộng hiệu quả hơn, không cần phải xem toàn bộ dữ liệu để tìm các danh sách liên quan. Cây là cấu trúc dữ liệu hoàn hảo để trả lời loại truy vấn này.
Cây là cấu trúc dữ liệu dựa trên nút, giống danh sách liên kết. Tuy nhiên, thay vì có tham chiếu trước và sau, mỗi nút sẽ giữ một giá trị và hai tham chiếu: nút trái và nút phải.
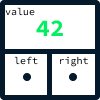
Trong ví dụ website bất động sản, mỗi nút sẽ đại diện cho một danh sách bất động sản. Để tối ưu các truy vấn liên quan đến giá, ta sẽ đặt ra quy tắc: các danh sách có giá thấp hơn sẽ luôn được lưu ở bên trái một nút, trong khi các danh sách có giá cao hơn sẽ luôn lưu ở bên phải.
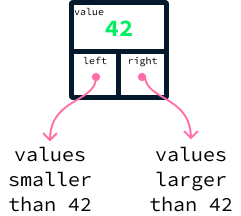
Xét ví dụ cụ thể, hãy xem cây sau giữ các giá trị 42, 17, 73, 4, 22 và 89.
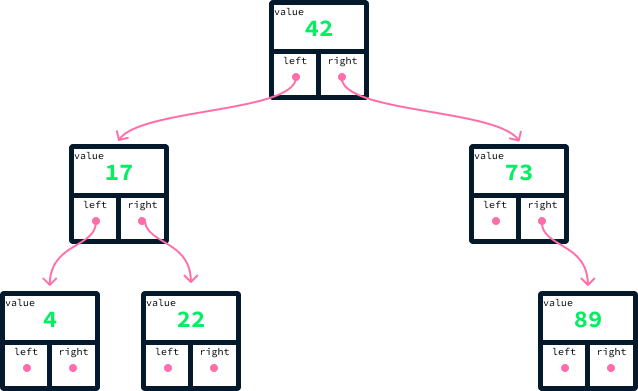
Với mỗi nút, tất cả các nút bên trái có giá trị nhỏ hơn, và tất cả các nút bên phải có giá trị lớn hơn. Cây thỏa mãn tính chất này được gọi là cây tìm kiếm nhị phân (BST). Gọi là nhị phân vì mỗi nút tham chiếu tối đa hai nút khác, gọi là con. Phần “tìm kiếm” đến từ việc tính chất sắp xếp ở các con trái và phải cho phép ta tìm kiếm trong cây hiệu quả.
Ta có thể thấy ngay BST giúp nhanh chóng tìm danh sách rẻ nhất và đắt nhất như thế nào. Do sắp xếp theo giá trị, phần tử rẻ nhất luôn là nút ngoài cùng bên trái, và đắt nhất là nút ngoài cùng bên phải.
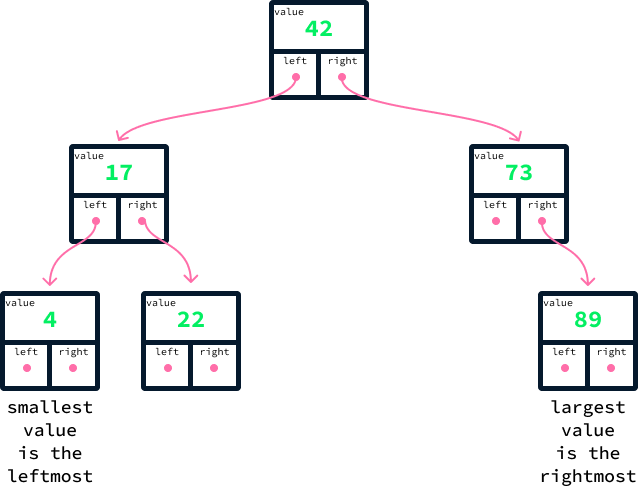
Điều này ngụ ý rằng ta có thể xác định chúng mà không cần xem xét phần lớn dữ liệu. Bắt đầu từ nút trên cùng, còn gọi là nút gốc, ta liên tục theo các liên kết bên trái để xác định giá trị nhỏ nhất và theo các liên kết bên phải để xác định giá trị lớn nhất. Nghĩa là chỉ cần kiểm tra các nút trên đường đi từ gốc đến các nút cực trị tương ứng.
Hãy tưởng tượng ta muốn tìm tất cả các nút có giá trị ít nhất là 50. Ta có thể thực hiện các bước sau:
50 với giá trị gốc là 42.50 lớn hơn, ta hiểu rằng gốc và tất cả nút bên trái của nó đều có giá trị nhỏ hơn. Do đó, có thể bỏ qua chúng.73. Khi so sánh, ta thấy 50 nhỏ hơn 73. Điều này cho thấy tất cả các nút bên phải của nút 73 đều đáp ứng tiêu chí của ta.73 không có con trái, việc tìm kiếm của ta dừng tại đó.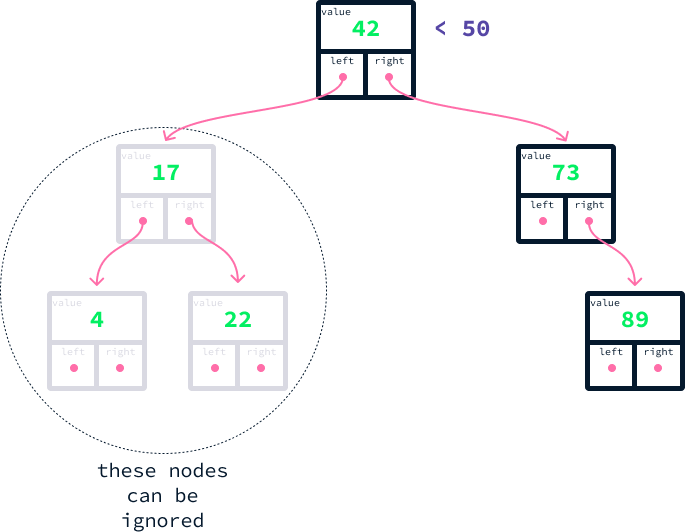
Ta có thể thấy BST giúp tăng tốc truy vấn đáng kể. Ngay cả trong ví dụ nhỏ này, ta đã tránh kiểm tra một nửa dữ liệu.
Nói chung, việc xác định tất cả các nút trong BST phù hợp với một khoảng cho trước yêu cầu kiểm tra một số lượng nút xấp xỉ với số lượng kết quả truy vấn. Đây là lợi thế lớn so với việc phải kiểm tra từng điểm dữ liệu. Hãy tưởng tượng có 1.000.000 danh sách và một truy vấn chỉ trả về 10 kết quả. Dùng danh sách, ta phải kiểm tra một triệu danh sách để lọc ra những cái không phù hợp. Với BST, ta chỉ cần kiểm tra khoảng 10 danh sách. Đó là mức tăng tốc 100.000 lần.
Hiệu quả của BST phụ thuộc mạnh vào độ cân bằng của cây. Nếu ta thêm cùng các giá trị như trước, theo thứ tự từ nhỏ đến lớn—4, 17, 22, 42, 73, rồi 89—ta có thể nhận một cây mất cân bằng như sau:
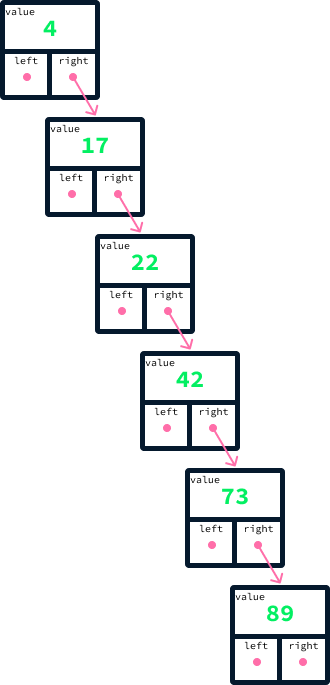
Hãy nhớ rằng để tìm giá trị lớn nhất trong BST, ta bắt đầu ở gốc và lần theo các liên kết bên phải cho đến khi tới một nút không có liên kết bên phải. Trong trường hợp cây mất cân bằng như minh họa, quá trình này đòi hỏi phải kiểm tra từng nút một. Lý tưởng là các nút được phân bố đều giữa hai phía trái và phải. Giải thích chi tiết cách luôn đạt được cân bằng vượt ngoài phạm vi bài viết này. Một loại cây tìm kiếm nhị phân nổi tiếng duy trì cân bằng như vậy là cây AVL.
Gói avltree cung cấp triển khai cây AVL. Đoạn mã dưới đây cho thấy cách ta có thể dùng nó trên bộ dữ liệu danh sách nhà này, một tập con đã được làm sạch của USA Real Estate Dataset.
import csv
from avltree import AvlTree as Tree

# Load the listings CSV data
with open("listings.csv", "rt") as f:
    reader = csv.reader(f)
    listings = list(reader)

# Create the tree based on the price column (column index 2)
tree = Tree()
for listing in listings[1:]:
    price = float(listing[2])
    tree[price] = listing

# Display the cheapest listing price
print("Cheapest:", tree.minimum())

# Display the most expensive listing price
print("Most expensive:", tree.maximum())

# Display the number of listings whose price is between 100,000 and 110,000
listings_in_range = list(tree.between(100000, 110000))
print("Num listings between 100000 and 110000:", len(listings_in_range))
Cheapest: 50017.0
Most expensive: 19999900.0
Num listings between 100000 and 110000: 403Đầu tiên, ta dùng mô-đun csv để đọc bộ dữ liệu listings.csv. Sau đó, ta tạo một cây AVL dựa trên cột giá. Ta dùng các phương thức minimum(), maximum() và between() để xác định giá thấp nhất, giá cao nhất, và số lượng danh sách có giá trong khoảng 100.000 đến 110.000 đô la.
Cấu trúc dữ liệu cuối cùng chúng ta sẽ thảo luận trong bài viết này là đồ thị.
Giả sử bạn đang phân tích dữ liệu từ một nền tảng mạng xã hội. Dữ liệu gồm một danh sách người dùng và các mối quan hệ bạn bè giữa họ, và mục tiêu của bạn là xác định các cộng đồng trong mạng xã hội. Mặc dù khái niệm cộng đồng có thể được định nghĩa theo nhiều cách, nhìn chung nó chỉ một nhóm người dùng có số lượng kết bạn đáng kể trong nội bộ nhóm đó.
Đồ thị là cấu trúc dữ liệu lý tưởng để biểu diễn dữ liệu khi ta có các thực thể và các mối quan hệ giữa từng cặp thực thể. Trong ví dụ của chúng ta, các thực thể là người dùng và các mối quan hệ là tình bạn giữa họ.
Đồ thị là các cấu trúc dựa trên nút. Tuy nhiên, không giống danh sách liên kết và cây, vốn biểu hiện các kết nối tuyến tính hoặc phân cấp giữa các nút, một đồ thị cho phép bất kỳ nút nào cũng có thể nối với nhiều nút khác. Những kết nối giữa các nút, gọi là cạnh, biểu thị mối quan hệ giữa chúng.
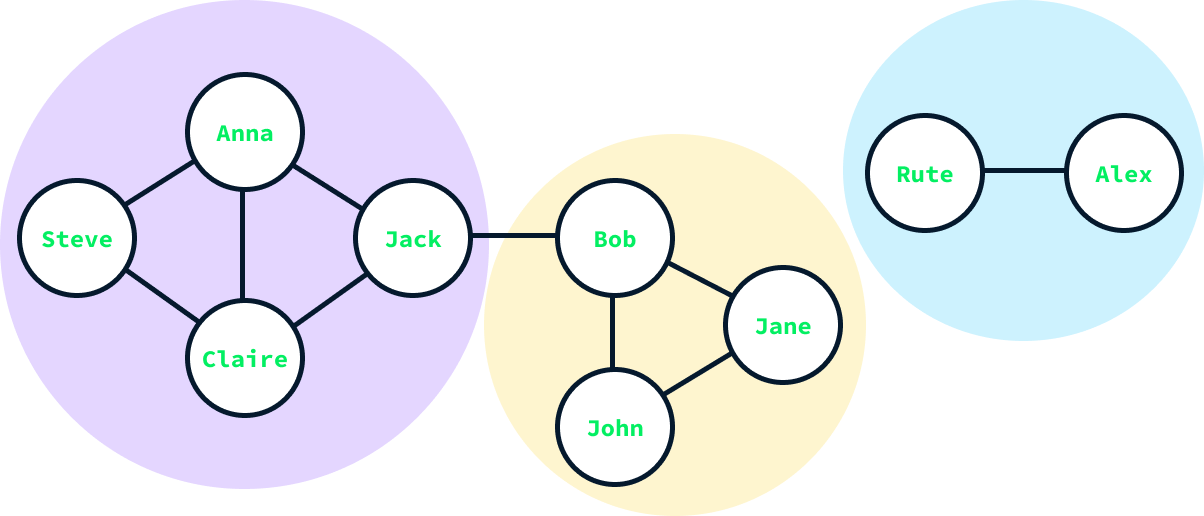
Trong ví dụ về mạng xã hội, mỗi người dùng có thể được hình dung như một nút. Một cạnh có thể được vẽ giữa hai nút để biểu thị tình bạn giữa hai người dùng tương ứng.
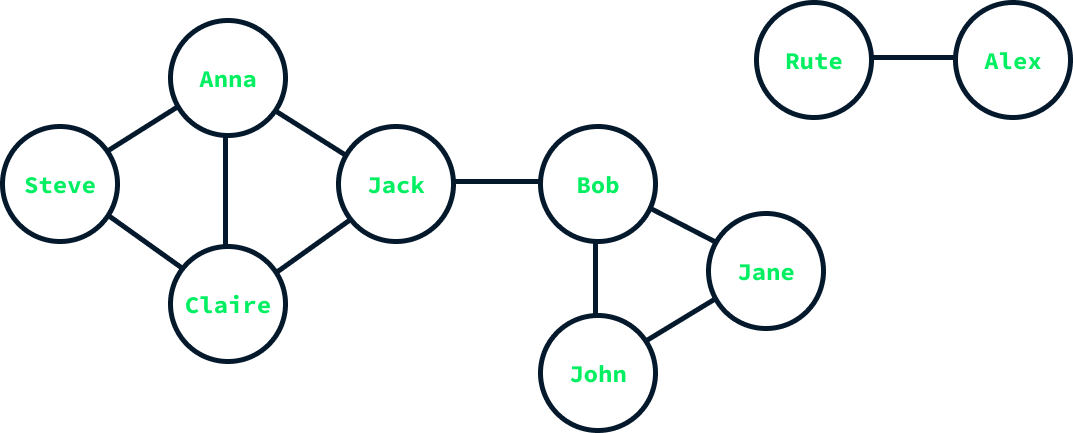
Sơ đồ trên minh họa một đồ thị biểu diễn tình bạn trong một mạng xã hội nhỏ. Các nút đại diện cho người dùng và được gắn nhãn tên của họ, còn các cạnh đại diện cho các mối quan hệ bạn bè. Ví dụ, Anna là bạn với Steve, Claire và Jack, nghĩa là có các cạnh nối nút của cô ấy với các nút của những người này.
Các thao tác mà một cấu trúc dữ liệu đồ thị nên hỗ trợ gồm:
Một cách triển khai đồ thị phổ biến là dùng bảng băm và danh sách. Ta tạo một bảng băm với một mục cho mỗi nút. Khóa của mỗi mục là nút, và giá trị là một danh sách chứa tất cả các nút mà nút đó kết nối tới.
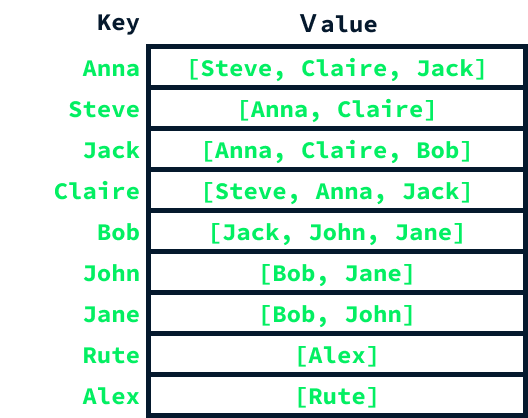
Gói networkx cung cấp một triển khai Python để tạo và thao tác đồ thị. Hơn nữa, thư viện networkx bao hàm một loạt thuật toán đồ thị phong phú, bao gồm cả các thuật toán phát hiện cộng đồng. Hãy dùng nó để xây dựng đồ thị nói trên và áp dụng một thuật toán phát hiện cộng đồng phổ biến để xem kết quả.
Để bắt đầu tạo đồ thị, ta import thư viện networkx và khởi tạo một đồ thị rỗng:
import networkx as nx
G = nx.Graph()
Có thể thêm nút bằng phương thức add_node().
G.add_node("Anna")
G.add_node("Steve")
G.add_node("Jack")
G.add_node("Claire")
G.add_node("Bob")
G.add_node("Jane")
G.add_node("John")
G.add_node("Rute")
G.add_node("Alex")
Có thể thêm cạnh bằng phương thức add_edge().
G.add_edge("Anna", "Steve")
G.add_edge("Anna", "Jack")
G.add_edge("Anna", "Claire")
G.add_edge("Steve", "Claire")
G.add_edge("Claire", "Jack")
G.add_edge("Jack", "Bob")
G.add_edge("Bob", "John")
G.add_edge("Bob", "Jane")
G.add_edge("John", "Jane")
G.add_edge("Rute", "Alex")
Khi đồ thị đã được tạo, ta có thể tính các cộng đồng trong đó. Có một số thuật toán được thiết kế cho việc phát hiện cộng đồng, và trong trường hợp này, ta sẽ dùng phương pháp Louvain. Các thuật toán phát hiện cộng đồng có ở tiểu gói community của networkx. Cụ thể, ta sẽ tập trung vào hàm louvain_communities().
Cách sử dụng như sau:
communities = nx.community.louvain_communities(G)
print(communities)
[{'Jack', 'Claire', 'Anna', 'Steve'}, {'Bob', 'John', 'Jane'}, {'Rute', 'Alex'}]Kết quả là một danh sách các tập hợp, mỗi tập hợp đại diện cho một cộng đồng. Ta nhận thấy thuật toán đã phát hiện ba cộng đồng, phù hợp với kỳ vọng dựa trên cấu trúc của đồ thị.
Để tìm hiểu thêm về đồ thị, hãy học cách triển khai thuật toán Dijkstra trong Python.
Khi giới thiệu mỗi cấu trúc dữ liệu, chúng ta đã trình bày danh sách các thao tác được hỗ trợ. Những thao tác này đóng vai trò là hướng dẫn về thời điểm sử dụng cấu trúc dữ liệu đó, vì nó được thiết kế để thực hiện các thao tác này một cách hiệu quả.
Ví dụ, Python list() cũng hỗ trợ các thao tác bổ sung như xóa phần tử. Tuy nhiên, các thao tác bổ sung này không phải là thế mạnh của danh sách mảng. Cụ thể, xóa một phần tử ở giữa danh sách yêu cầu sao chép toàn bộ dữ liệu (trừ phần tử bị xóa) sang một danh sách mới, điều này có thể rất tốn thời gian.
Khi dữ liệu được đánh chỉ số tự nhiên bằng số, và số lượng mục được biết (ví dụ, các ngày trong một tháng), mảng thường là lựa chọn ưu tiên. Với việc đánh chỉ số tổng quát hơn hoặc các tập dữ liệu động, dictionary là một giải pháp thay thế tốt.
Để xử lý dữ liệu tuần tự, mỗi lần một mục, thường dùng hàng đợi hoặc ngăn xếp, tùy vào thứ tự xử lý dữ liệu mong muốn.
Cây thường là câu trả lời khi ta muốn thực hiện các truy vấn phức tạp hơn trên dữ liệu, như tìm tất cả các mục trong một khoảng cho trước hoặc các giá trị cực trị.
Cuối cùng, khi có mối quan hệ giữa các cặp điểm dữ liệu, đồ thị là cách hiệu quả để lưu trữ và biểu diễn các mối quan hệ này. Có các thuật toán đồ thị cho phép chúng ta trả lời những câu hỏi thường gặp về các bộ dữ liệu có kiểu quan hệ cặp như vậy.
Cấu trúc dữ liệu là một lĩnh vực rộng lớn, và chúng ta mới chỉ chạm vào phần nổi của tảng băng. Trong một số tình huống, giải pháp là thiết kế một cấu trúc dữ liệu hoàn toàn mới, phù hợp tuyệt đối với bài toán. Dù vậy, quen thuộc với các cấu trúc dữ liệu đã bàn trong bài viết này sẽ giúp bạn đi đúng hướng khi giải quyết các vấn đề liên quan đến dữ liệu.
Trong bài viết này, chúng ta đã biết rằng cấu trúc dữ liệu là các phương pháp tổ chức dữ liệu theo những định dạng cụ thể để hỗ trợ truy xuất thông tin hiệu quả.
Có hai loại cấu trúc dữ liệu cơ bản: cấu trúc dựa trên mảng (ví dụ, bảng băm) và cấu trúc dựa trên nút (ví dụ, đồ thị).
Các cấu trúc tuyến tính như mảng, hàng đợi và ngăn xếp sắp xếp các phần tử tuần tự, nối tiếp nhau. Ngược lại, các cấu trúc phi tuyến tính như bảng băm, cây và đồ thị tổ chức dữ liệu dựa trên các mối quan hệ trong dữ liệu.
Việc lựa chọn cấu trúc dữ liệu phù hợp phụ thuộc vào bản chất các truy vấn cần thực hiện.
Nếu bạn muốn tìm hiểu về các cấu trúc dữ liệu khác nhau trong Python, hãy xem hướng dẫn này về cấu trúc dữ liệu Python.
Học Python với những khóa học này!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
