
Corso
Strutture dati e algoritmi in Python
4 ore
48.3K
Le strutture dati esistono sia nel mondo digitale che in quello fisico. Un dizionario è un esempio fisico di struttura dati, in cui i dati consistono nelle definizioni delle parole organizzate in ordine alfabetico all'interno di un libro. Questa organizzazione consente una specifica interrogazione: dato un termine, se ne può cercare la definizione.
Alla base, una struttura dati è un metodo di organizzazione dei dati che facilita particolari tipi di interrogazioni e operazioni su tali dati.
Inizieremo trattando le strutture dati lineari come array, liste, code e pile. Poi torneremo a spiegare la differenza tra strutture lineari e non lineari, prima di passare a tabelle hash, alberi e grafi.
Se vuoi approfondire, dai un'occhiata a questo corso su strutture dati e algoritmi in Python.
Gli array sono strutture dati fondamentali, ampiamente disponibili nei linguaggi di programmazione. Consentono di memorizzare un numero fisso (N) di valori in modo sequenziale in memoria.
Gli elementi dell'array sono indicizzati dal primo elemento all'indice (0) fino all'ultimo all'indice (N-1).
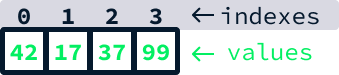
Consentono le seguenti operazioni:
Gli array sono molto efficaci negli scenari in cui il numero di valori da memorizzare è noto in anticipo e le operazioni principali riguardano lettura e scrittura di dati a indici specifici.
Considera lo scenario in cui devi memorizzare le rilevazioni di temperatura giornaliere per il mese di dicembre. Potresti voler permettere agli utenti di recuperare la temperatura di un giorno specifico ed eseguire varie analisi statistiche sulle temperature del mese.
Poiché il numero di giorni di dicembre è noto in anticipo (31), gli array sono un'ottima scelta per memorizzare le rilevazioni. Inizialmente, si creerebbe un array con 31 posizioni vuote. Poi, dopo ogni rilevazione, la temperatura di un dato giorno verrebbe assegnata al corrispondente indice dell'array: il giorno 1 all'indice 0, il giorno 2 all'indice 1, e così via, fino al giorno 31, memorizzato all'indice 30.
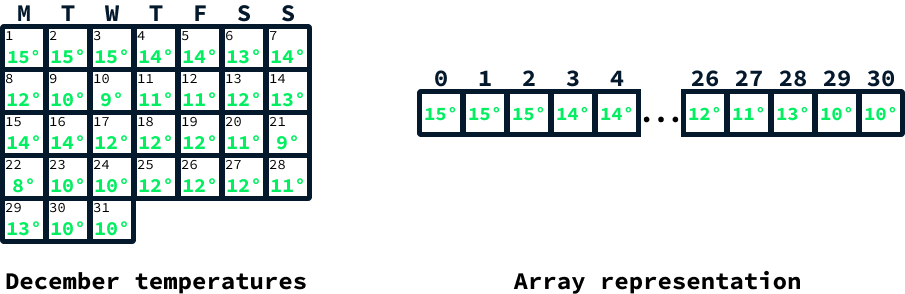
L'accesso all'indice corrispondente consente di recuperare la temperatura di un giorno specifico. Statistiche come la temperatura media possono essere determinate iterando su tutti gli elementi, mantenendo una somma cumulativa e poi dividendo per la dimensione dell'array.
Gli array non sono disponibili nativamente in Python. Sono utilizzati dietro le quinte come struttura sottostante di vari tipi di dato, ma non sono supportati direttamente dal linguaggio. Per usare esplicitamente gli array, si possono sfruttare librerie come array, che offrono un'implementazione di array. Tuttavia, spesso è più pratico usare una lista a dimensione fissa nelle situazioni in cui si richiederebbe un array. Le liste offrono flessibilità e sono una parte centrale della funzionalità di Python, come vedremo subito.
Possiamo creare una lista per simulare un array di 31 elementi, ciascuno inizializzato a None, usando [None] * 31. Qui, None indica che non è stata ancora registrata alcuna temperatura.
december_temperatures = [None] * 31Per impostare il valore a un indice specifico, usiamo december_temperatures[index], dove index è un numero da 0 a 30. Per esempio, per registrare la temperatura del primo giorno (memorizzata all'indice 0), faremmo così:
december_temperatures[0] = 15L'accesso a una temperatura è altrettanto semplice, usando december_temperatures[index].
print(december_temperatures[0])15Immagina ora che, invece di concentrarti su dicembre, installiamo un sensore per effettuare rilevazioni di temperatura periodiche per un periodo non specificato. In questo scenario, usare un array non è l'opzione migliore perché potremmo esaurire lo spazio a causa della dimensione fissa definita alla creazione.
Una struttura dati più adatta in questo caso sarebbe una lista. Esistono due tipi di liste:
Le liste basate su array possono essere viste come una versione più flessibile degli array. Possono svolgere tutte le funzioni degli array, ma possono anche aggiungere nuovi valori, quindi la loro dimensione non è fissa alla creazione. Le liste basate su array corrispondono all'uso di list() in Python.
La loro implementazione si basa su un array che viene ampliato quando lo spazio si esaurisce, da qui il nome lista array. Tuttavia, come abbiamo visto, gli array non possono crescere, quindi come è possibile?
Quando l'array sottostante di una lista basata su array è pieno e vogliamo aggiungere un nuovo valore, dietro le quinte viene creato un array più grande. Tutti i valori precedenti vengono copiati in questo nuovo array più grande. Poi, il nuovo valore viene aggiunto alla prima posizione disponibile nel nuovo array.
Immagina di voler aggiungere il valore 71 a questo array:
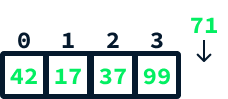
Questo si può realizzare così:
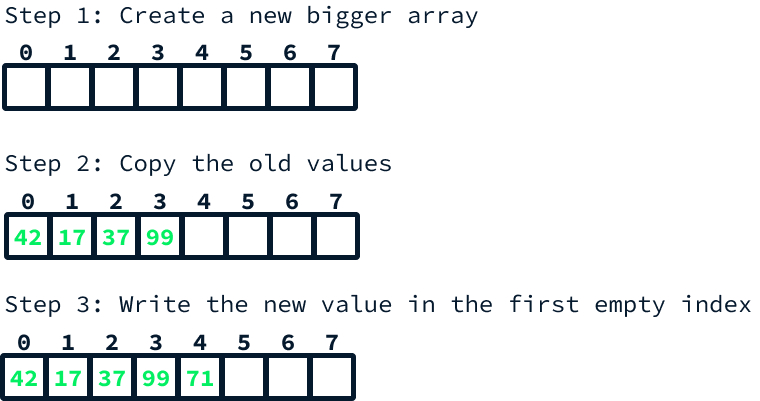
La quantità di nuovo spazio allocato ogni volta che eseguiamo questa operazione è cruciale per le prestazioni della lista basata su array. Se, a ogni append, creassimo un array con una sola nuova posizione per il valore da aggiungere, significherebbe che ogni operazione di append richiederebbe di copiare l'intero insieme di dati preesistente. Sarebbe estremamente inefficiente: immagina di dover copiare milioni di record solo per aggiungerne uno nuovo.
Invece, la strategia comune è raddoppiare la dimensione dell'array ogni volta che è necessario più spazio. Si può dimostrare che questo approccio annulla col tempo l'effetto di questi passaggi extra di copia.
Per aggiungere elementi a una lista Python, usiamo il metodo .append(). Ecco un esempio di come creare una lista vuota e aggiungervi una rilevazione di temperatura:
temperatures = []
temperatures.append(35)Per strutturare i dati in un computer, abbiamo bisogno di un modo per mettere in relazione i valori tra loro. Gli array lo fanno allocando posizioni di memoria contigue – cioè direttamente adiacenti – e memorizzando i valori in sequenza. Pensala come una fila di case in una strada: ogni casa ha un indirizzo univoco (indice) e si trova fisicamente accanto alle altre.
Tuttavia, questo non è l'unico metodo per organizzare i dati. Un'alternativa consiste nell'usare una struttura basata su nodi.
Un nodo è un oggetto che memorizza un valore insieme a riferimenti ad altri nodi. Per esempio, per creare una struttura simile a una lista usando i nodi, possiamo avere un nodo che contiene sia un valore sia un riferimento all'elemento successivo nella lista. In Python, questo può essere implementato con una classe:
class Node:
    def __init__(self, value, next_node):
        self.value = value
        self.next_node = next_node
Con questo approccio, si può creare una lista collegando i valori tramite il riferimento next_node. Ecco un frammento di codice che crea una lista con i valori 42, 17 e 37:
node_37 = Node(37, None) # Non c'è un nodo dopo 37, quindi next_node è None
node_17 = Node(17, node_37)
node_42 = Node(42, node_17)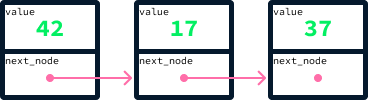
Collegare manualmente i nodi in questo modo non è pratico. L'implementazione reale richiede la creazione di un'altra classe che mantenga i riferimenti sia al primo sia all'ultimo nodo della lista. Per aggiungere un nuovo valore, dobbiamo:
Immagina di voler aggiungere il valore 71 al nostro array d'esempio:
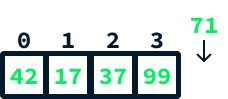
Questo si può realizzare così:
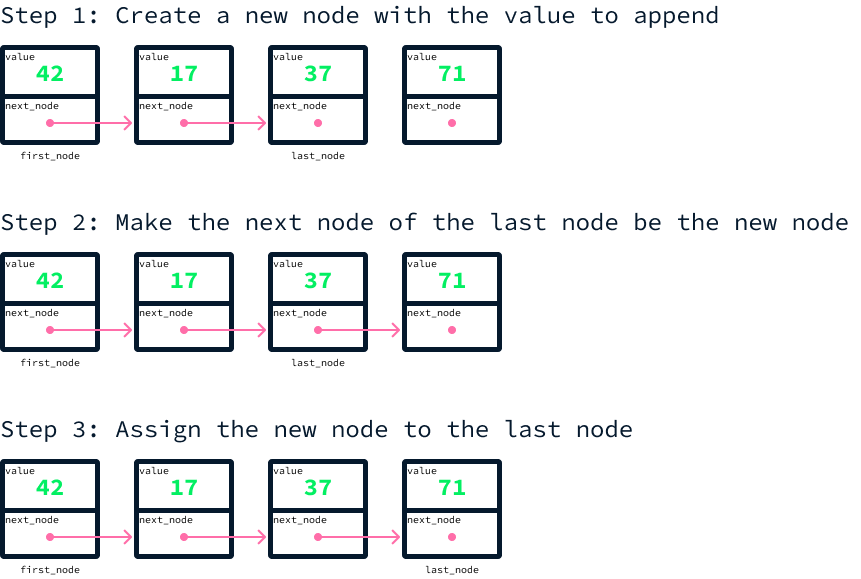
class LinkedList:
    def __init__(self):
        self.first_node = None
        self.last_node = None

    def append(self, value):
        node = Node(value, None)
        if self.first_node is None:
            self.first_node = node
            self.last_node = node
        else:
            self.last_node.next_node = node
            self.last_node = node
A differenza delle liste basate su array, non possiamo accedere direttamente ai valori tramite i loro indici. Per leggere un valore specifico a un dato indice, dobbiamo partire dal primo nodo e spostarci sequenzialmente da un nodo al successivo finché non raggiungiamo l'indice desiderato. Questo processo è significativamente più lento dell'accesso diretto. Se abbiamo milioni di valori memorizzati nella lista, dovremmo scorrere milioni di valori in memoria per raggiungere un indice specifico.
Il vantaggio di una lista collegata sta nel fatto che possiamo aggiungere e rimuovere istantaneamente elementi sia all'inizio sia alla fine della lista. Questa capacità apre alla possibilità di implementare due nuove strutture dati: code e pile, di cui parleremo a breve.
Immagina di sviluppare un'app per ristorante che registra gli ordini dei clienti e li inoltra in cucina. Quando i clienti arrivano al ristorante, si mettono in fila per ordinare, aspettandosi di essere serviti nell'ordine di arrivo. Ciò significa che il primo cliente in fila dovrebbe ricevere l'ordine per primo e l'ultimo in fila per ultimo.
In cucina, lo chef preferisce concentrarsi su un ordine alla volta, quindi l'app dovrebbe mostrare solo l'ordine corrente. Una volta che un ordine è pronto e inviato, dovrebbe essere mostrato il successivo in coda.
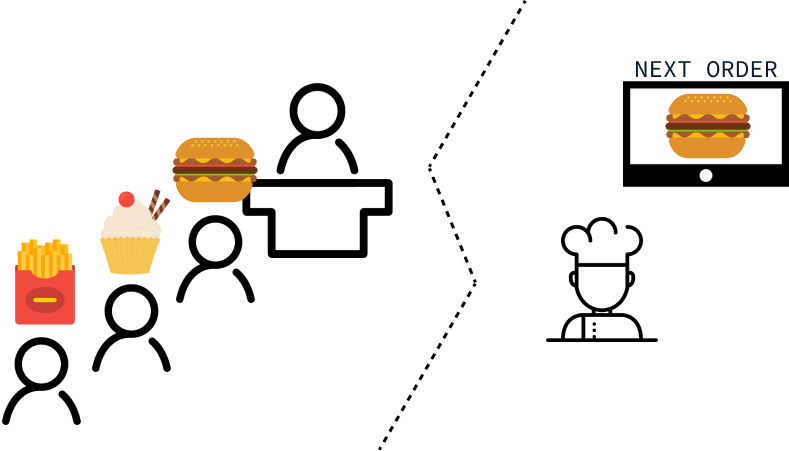
Possiamo interpretare i requisiti sopra come la necessità di una struttura dati che supporti le seguenti operazioni:
Queste operazioni sono esattamente ciò che offre una coda. Una coda può essere implementata usando una lista collegata, dove gli elementi vengono aggiunti accodandoli alla lista. Poiché gli elementi sono ordinati per tempo di arrivo, il primo nodo è sempre quello che dovrebbe essere servito successivamente.
Ecco come gli ordini sopra verrebbero memorizzati nella coda:
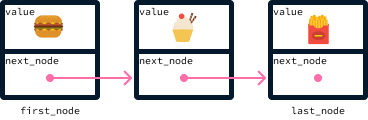
Una volta pronto un ordine, può essere rimosso aggiornando il primo elemento al suo next_node, se esiste un nodo successivo. Il nuovo primo nodo diventa il secondo nodo:
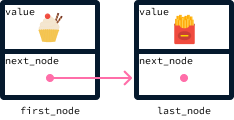
Le code sono descritte come una struttura dati first-in, first-out (FIFO) perché il primo elemento aggiunto è anche il primo a essere rimosso. Nel nostro esempio del ristorante, il primo cliente ad arrivare è anche il primo a essere servito (e rimosso dall'elenco dello chef).
Per usare una coda in Python, possiamo utilizzare la collezione deque dal modulo collections. Importa questo modulo e crea una coda vuota come mostrato di seguito:
from collections import deque
orders = deque()
Aggiungere un nuovo elemento in fondo alla coda si può fare con il metodo .append():
orders.append("burger")
orders.append("sunday")
orders.append("fries")
Per recuperare e rimuovere l'ordine successivo dalla testa della coda, usiamo il metodo .popleft():
orders.append("burger")
orders.append("sunday")
orders.append("fries")
burger
sunday
friesIn alcune situazioni, desideriamo il comportamento opposto a quello di una coda: vogliamo tenere traccia dell'elemento aggiunto più di recente.
Per esempio, immagina di dover aggiungere una funzione di annullamento (undo) a un editor di immagini. Questo richiede un metodo per monitorare le azioni dell'utente, fornendo accesso alle operazioni più recenti. Questo perché le funzionalità di annullamento in genere ripristinano le azioni a partire dall'ultima eseguita e procedendo verso la prima.
Una pila è esattamente una struttura dati che supporta queste operazioni:
Come le code, anche le pile possono essere implementate usando una lista collegata. L'aggiunta di un elemento avviene ancora accodando l'elemento alla lista. Tuttavia, il nostro interesse si sposta sull'ultimo elemento della lista invece che sul primo. Per recuperare l'elemento più recente, guardiamo l'ultimo elemento della lista. Per rimuovere l'ultimo elemento, dobbiamo eliminare proprio l'ultimo.
Nella nostra struttura dei nodi, tenevamo traccia solo del nodo successivo. Per facilitare la rimozione dell'ultimo elemento, dobbiamo accedere all'elemento che lo precede, eliminare il suo next_node e promuovere quel nodo a ultimo. Possiamo farlo modificando la struttura del nodo in modo da tracciare anche il nodo precedente di ciascun nodo. Una lista collegata di questo tipo è detta doppia (doubly linked list).
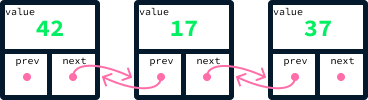
Le pile sono descritte come una struttura dati LIFO (last-in, first-out) perché l'ultimo elemento aggiunto è anche il primo a essere rimosso.
Per usare una pila in Python, possiamo utilizzare la stessa collezione deque. Usiamo il metodo .append() per aggiungere nuovi elementi:
from collections import deque
actions = deque()

actions.append("crop")
actions.append("desaturate")
actions.append("resize")
Per recuperare e rimuovere il prossimo elemento dalla cima della pila, usiamo il metodo .pop():
print(actions.pop())
print(actions.pop())
print(actions.pop())
resize
desaturate
cropFinora abbiamo esplorato cinque strutture dati: array, liste basate su array, liste collegate, code e pile. Ciascuna di queste è una struttura dati lineare perché i loro elementi sono disposti in sequenza, con ogni elemento che ha un chiaro precedente e successivo.
Ora sposteremo l'attenzione sulle strutture dati non lineari. A differenza dei tipi lineari, queste strutture non organizzano gli elementi uno accanto all'altro in modo lineare. Di conseguenza, non hanno una nozione definita di elementi precedente e successivo. Al contrario, stabiliscono diversi tipi di relazioni tra gli elementi.
Questa caratteristica le rende particolarmente adatte a eseguire interrogazioni specializzate sui dati con grande efficienza, più che a fungere semplicemente da mezzo per memorizzare dati in memoria.
Abbiamo iniziato questo articolo parlando di un esempio reale di struttura dati: i dizionari. Si scopre che organizzare i dati in modo che possano essere cercati tramite un campo specifico (per esempio, cercare una definizione dato un termine) è estremamente utile in generale, quindi gli informatici hanno inventato anche una struttura dati che lo consente.
Per capire questa struttura dati, vediamo come possiamo creare un dizionario virtuale, ossia una struttura dati in cui possiamo:
Ricorda l'esempio della registrazione delle temperature durante dicembre. Abbiamo usato un array con 31 elementi corrispondenti a ciascun giorno del mese per memorizzare le temperature ai rispettivi indici. Questo approccio consente di cercare in modo efficiente la temperatura di un giorno qualsiasi.
Questo scenario è simile alla gestione di coppie di dati (giorno, temperatura), dove l'obiettivo è recuperare la temperatura specificando il giorno. Allo stesso modo, nel caso dei dizionari, gestiamo coppie (parola, definizione) e puntiamo a trovare la definizione quando ci viene fornita una parola.
Tali coppie sono dette coppie chiave-valore o voci (entry). La chiave è il parametro usato nell'interrogazione, e il valore è l'esito di tale interrogazione.
|
chiave |
valore |
|
|
Problema delle temperature di dicembre |
giorno |
temperatura |
|
Problema del dizionario |
parola |
definizione |
Ciò che ci impedisce di usare un array per il problema del dizionario è che le nostre chiavi sono stringhe anziché numeri. Con chiavi numeriche, possiamo usare direttamente un array per associare chiavi e valori posizionando i valori ai rispettivi indici.
Per risolvere questo problema, dobbiamo prima convertire le parole in numeri. Una funzione che esegue questa conversione è detta funzione di hash. Esistono numerosi approcci per crearla. Ad esempio, potremmo assegnare valori numerici alle lettere, con a come 1, b come 2, c come 3 e così via, quindi sommare questi valori.
Per esempio, la parola data verrebbe calcolata come 4 + 1 + 20 + 1 = 26. Tuttavia, questa funzione ha dei difetti, che discuteremo tra poco. I dettagli su come ideare una buona funzione di hash esulano dallo scopo di questo articolo, ma Python fornisce comodamente una funzione hash() che gestisce questo compito in modo efficiente.
hash("data")-6138587229816301269Nell'esempio sopra, potresti aver notato che la funzione di hash ha prodotto un numero negativo. È importante ricordare che gli indici positivi degli array vanno da 0 a N - 1. Una volta convertite le chiavi in numeri, possiamo ricondurle all'intervallo 0–N - 1 usando l'operatore modulo % (che restituisce il resto di una divisione—per esempio, 10 % 3 restituisce 1).
Come nota a margine, la funzione hash() di Python può restituire valori diversi tra esecuzioni differenti del programma. È deterministica solo all'interno della stessa esecuzione, il che significa che potresti osservare hash diversi per lo stesso oggetto se esegui il programma più volte.
Considera un array che contiene 100 elementi. Per individuare l'indice corrispondente alla stringa "data", procediamo così:
hash("data") % 10031La struttura dati tabella hash è essenzialmente un grande array che memorizza coppie chiave-valore agli indici determinati applicando una funzione di hash alle chiavi.
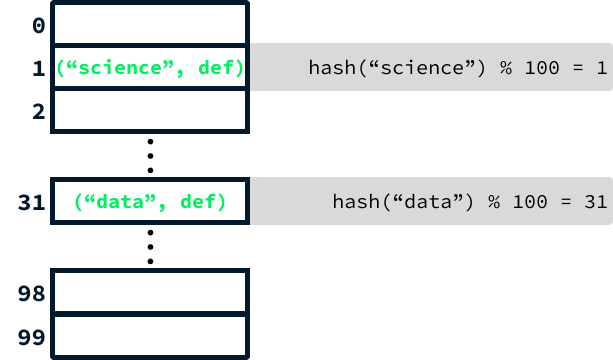
Per ragioni di spazio, il diagramma sopra include solo l'abbreviazione "def" per rappresentare la definizione. In pratica, però, il secondo elemento di ogni voce sarebbe la definizione completa della parola.
C'è un altro aspetto importante da considerare. Dato che esistono ben più di 100 parole, se continuiamo ad aggiungerne, parole distinte produrranno inevitabilmente lo stesso valore di hash. Per risolvere questo problema, invece di limitare ogni elemento dell'array a una singola coppia chiave-valore, impieghiamo una lista collegata per memorizzare tutte le voci che condividono lo stesso valore di hash.
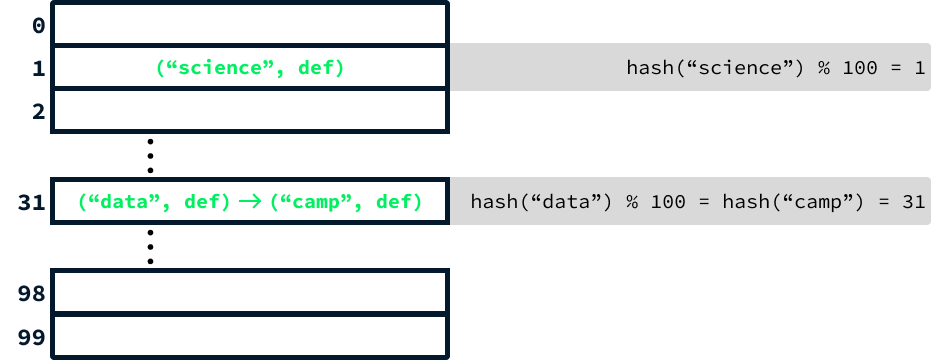
Quando due voci generano lo stesso hash, si parla di collisione. Questo scenario modifica leggermente il processo di ricerca. Dopo aver calcolato il codice hash, è necessario attraversare la lista per trovare la voce corretta. Sebbene questo rallenti l'operazione di lookup, si può dimostrare che usando una dimensione iniziale dell'array sufficientemente grande (più di 100) e una buona funzione di hash si può ridurre significativamente l'impatto delle collisioni. Di conseguenza, l'efficienza rimane quasi equivalente a quella di un array.
Per una funzione di hash ben progettata, trovare valori distinti che producono lo stesso hash dovrebbe essere raro. Ecco perché una funzione di hash semplicistica che somma i valori numerici dei caratteri in una parola non è ideale. Qualsiasi due parole composte dalle stesse lettere, indipendentemente dall'ordine, produrrebbero codici hash identici. Per esempio, “listen” e “silent” produrrebbero lo stesso hash. Al contrario, la funzione di hash integrata in Python è molto più robusta ed è progettata specificamente per ridurre al minimo le collisioni.
Le tabelle hash sono probabilmente la struttura dati più importante a disposizione. Sono estremamente efficienti e versatili. In Python, sono implementate tramite la classe dict(). Per la somiglianza con un dizionario, in Python la struttura dati è effettivamente chiamata dizionario invece che tabella hash.
Per semplicità, il nostro esempio si concentra sull'aggiunta e sulla ricerca di voci. In generale, i dizionari offrono maggiore flessibilità e supportano operazioni aggiuntive, inclusa l'eliminazione. Per creare un dizionario (tabella hash) vuoto in Python, puoi usare {} così:
word_definitions = {}
word_definitions["data"] = "Facts or information."
Puoi accedere alla definizione di una parola usando la parola come chiave, in questo modo:
print(word_definitions["data"])Facts or information.Immagina di sviluppare un sito web per un'agenzia immobiliare. Il tuo compito è creare una funzione che permetta agli utenti di filtrare gli annunci per prezzo. La funzione dovrebbe permettere agli utenti di:
Tipicamente, questo processo comporterebbe l'attraversamento di tutti gli annunci e il filtraggio di quelli che escono dall'intervallo desiderato. Tuttavia, il nostro obiettivo è sviluppare una soluzione che sia più scalabile, che non richieda di esaminare l'intero dataset per trovare gli annunci rilevanti. Gli alberi sono la struttura dati perfetta per rispondere a questo tipo di query.
Gli alberi sono strutture dati basate su nodi, come le liste collegate. Tuttavia, invece di avere riferimenti al precedente e al successivo, ogni nodo conserva un valore e due riferimenti: un nodo sinistro e un nodo destro.
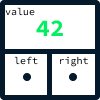
Nel nostro esempio del sito dell'agenzia immobiliare, ogni nodo rappresenterà un annuncio. Per ottimizzare le query relative al prezzo, stabiliremo una regola: gli annunci con prezzo inferiore saranno sempre memorizzati a sinistra di un nodo, mentre quelli con prezzo superiore saranno sempre memorizzati a destra.
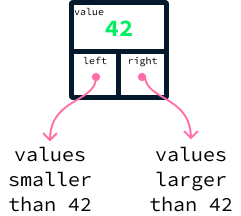
Per un esempio concreto, considera il seguente albero che contiene i valori 42, 17, 73, 4, 22 e 89.
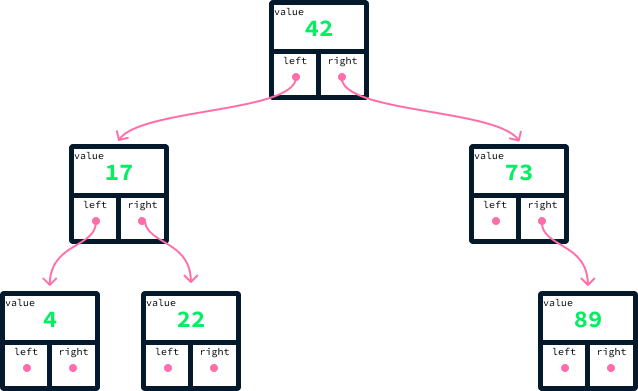
Per ciascun nodo, tutti i nodi a sinistra hanno valori più piccoli e tutti quelli a destra hanno valori più grandi. Un albero che soddisfa questa proprietà è chiamato albero binario di ricerca (BST). È binario perché ogni nodo fa riferimento ad al massimo due altri nodi, detti figli. La parte di ricerca del termine deriva dal fatto che la proprietà d'ordine sui figli sinistro e destro rende possibile cercare nell'albero in modo efficiente.
Possiamo già vedere come un BST aiuti a trovare rapidamente gli annunci più economico e più costoso. Grazie all'ordinamento dei valori, il più economico è sempre il nodo più a sinistra e il più costoso è sempre il nodo più a destra.
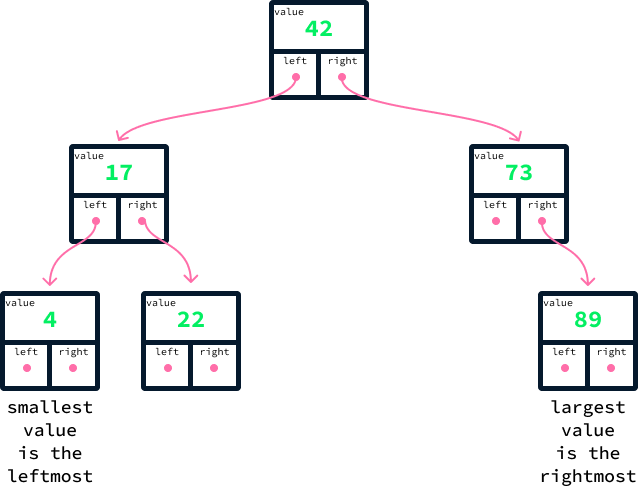
Questo implica che possiamo individuarli senza esaminare la maggior parte dei dati. Partendo dal nodo in cima, detto radice, seguiamo sistematicamente i collegamenti a sinistra per identificare il minimo e quelli a destra per identificare il massimo. Ciò significa che è necessario ispezionare solo i nodi lungo il percorso che collega la radice rispettivamente al nodo minimo e a quello massimo.
Immagina di voler trovare tutti i nodi con un valore di almeno 50. Questi sono i passaggi che possiamo seguire per riuscirci:
50, con il valore della radice, che è 42.50 è maggiore, capiamo che la radice e tutti i nodi alla sua sinistra contengono valori più piccoli. Di conseguenza, possiamo ignorarli.73. Dal confronto, risulta che 50 è minore di 73. Questo indica che tutti i nodi a destra del nodo 73 soddisfano il nostro criterio.73 non ha un figlio sinistro, la nostra ricerca si conclude lì.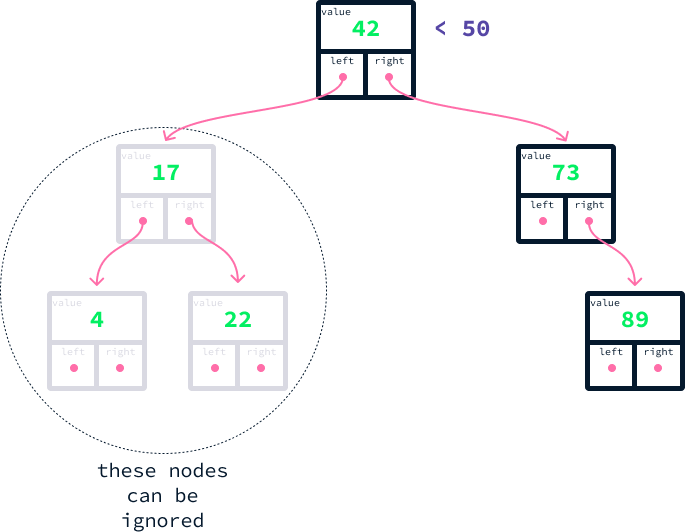
Possiamo già vedere come i BST possano velocizzare notevolmente le query. Anche in questo piccolo esempio, abbiamo evitato di esaminare metà dei dati.
In generale, individuare tutti i nodi in un BST che rientrano in un dato intervallo richiede di ispezionare un numero di nodi vicino al numero di risultati della query. Questo è un enorme vantaggio rispetto alla necessità di ispezionare ogni singolo dato. Immagina di avere 1.000.000 di annunci e una query che produce solo 10 risultati. Usando una lista, si dovrebbero ispezionare un milione di annunci per filtrare quelli fuori intervallo. Con un BST, ne basta ispezionare circa 10. Questo rappresenta un fattore di accelerazione di 100.000.
L'efficienza di un BST dipende fortemente dall'equilibrio dell'albero. Se aggiungiamo gli stessi valori di prima, dal più piccolo al più grande—4, 17, 22, 42, 73, seguito da 89—potremmo ritrovarci con un albero sbilanciato, come mostrato:
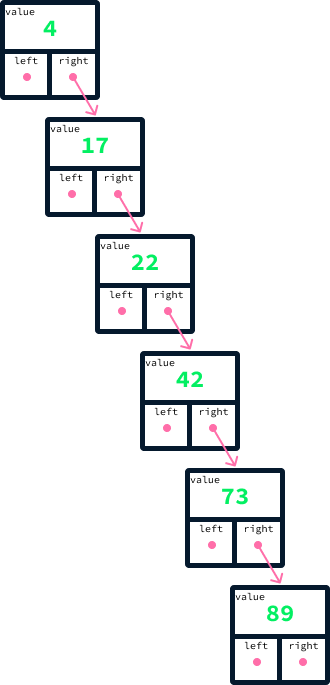
Ricorda che, per trovare il valore massimo in un BST, partiamo dalla radice e seguiamo i collegamenti a destra finché non arriviamo a un nodo che non ne ha. Nel caso di un albero sbilanciato, come quello illustrato sopra, questo processo richiede di esaminare ogni singolo nodo. Idealmente, vogliamo che i nodi siano distribuiti in modo uniforme tra lato sinistro e destro. Spiegare in dettaglio come ottenere costantemente questo bilanciamento esula dallo scopo di questo articolo. Un tipo di albero binario di ricerca noto per mantenere tale bilanciamento è chiamato albero AVL.
Il pacchetto avltree fornisce un'implementazione di un albero AVL. Il frammento di codice seguente mostra come possiamo usarlo su questo dataset di annunci immobiliari, un sottoinsieme ripulito di questo USA Real Estate Dataset.
import csv
from avltree import AvlTree as Tree

# Carica i dati CSV degli annunci
with open("listings.csv", "rt") as f:
    reader = csv.reader(f)
    listings = list(reader)

# Crea l'albero in base alla colonna del prezzo (indice colonna 2)
tree = Tree()
for listing in listings[1:]:
    price = float(listing[2])
    tree[price] = listing

# Mostra il prezzo dell'annuncio più economico
print("Cheapest:", tree.minimum())

# Mostra il prezzo dell'annuncio più costoso
print("Most expensive:", tree.maximum())

# Mostra il numero di annunci con prezzo tra 100.000 e 110.000
listings_in_range = list(tree.between(100000, 110000))
print("Num listings between 100000 and 110000:", len(listings_in_range))
Cheapest: 50017.0
Most expensive: 19999900.0
Num listings between 100000 and 110000: 403Per prima cosa usiamo il modulo csv per leggere il dataset listings.csv. Successivamente, creiamo un albero AVL basato sulla colonna del prezzo. Usiamo poi i metodi minimum(), maximum() e between() per determinare il prezzo minimo, il prezzo massimo e il numero di annunci con prezzo tra 100.000 e 110.000 $.
L'ultima struttura dati di cui parleremo in questo articolo è il grafo.
Mettiamo che tu stia analizzando i dati di una piattaforma social. Questi dati comprendono un elenco di utenti e le amicizie tra loro, e il tuo obiettivo è identificare le comunità all'interno del social network. Sebbene il concetto di comunità possa essere definito in vari modi, in generale si riferisce a un gruppo di utenti che hanno un numero significativo di amicizie all'interno del gruppo.
I grafi sono la struttura dati ideale per rappresentare dati quando abbiamo entità e relazioni tra coppie di queste entità. Nel nostro esempio, le entità sono gli utenti e le relazioni sono le loro amicizie.
I grafi sono strutture basate su nodi. Tuttavia, a differenza delle liste collegate e degli alberi, che presentano connessioni lineari o gerarchiche tra nodi, un grafo consente a qualsiasi nodo di connettersi a più altri nodi. Queste connessioni tra nodi, chiamate archi, indicano le relazioni tra di essi.
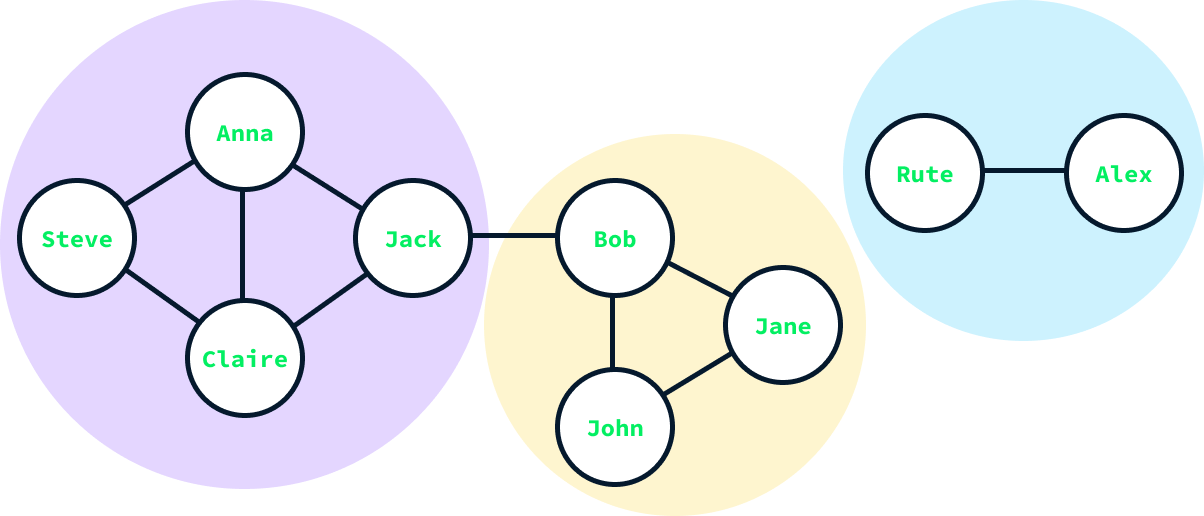
Nel nostro esempio di social network, ogni utente può essere visualizzato come un nodo. Un arco può essere tracciato tra due nodi per indicare un'amicizia tra gli utenti corrispondenti.
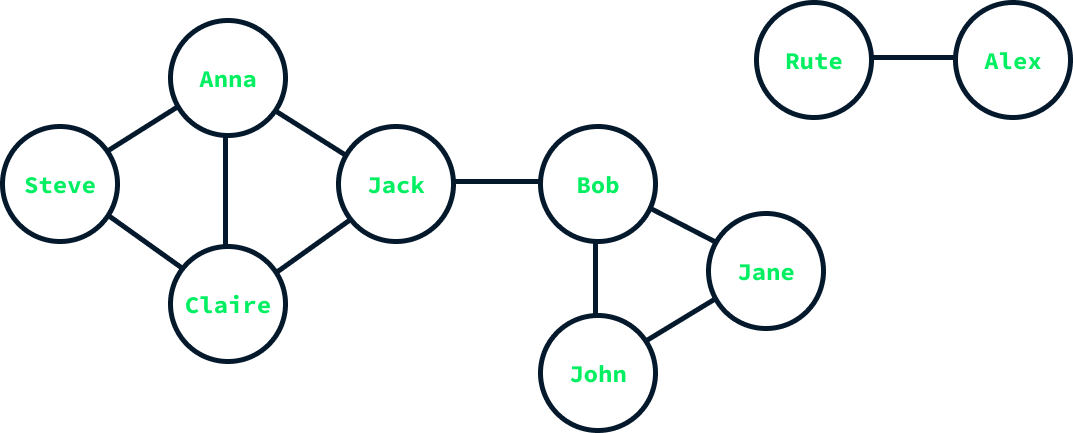
Il diagramma sopra illustra un grafo che rappresenta le amicizie all'interno di un piccolo social network. I nodi rappresentano gli utenti e sono etichettati con i loro nomi, mentre gli archi rappresentano le amicizie. Per esempio, Anna è amica di Steve, Claire e Jack, il che significa che ci sono archi che collegano il suo nodo ai nodi di queste persone.
Le operazioni che una struttura dati grafo dovrebbe supportare includono:
Un modo comune di implementare un grafo è usare una tabella hash e delle liste. Si crea una tabella hash con una voce per ogni nodo. La chiave di ciascuna voce è il nodo e il valore è una lista contenente tutti i nodi a cui quel nodo è connesso.
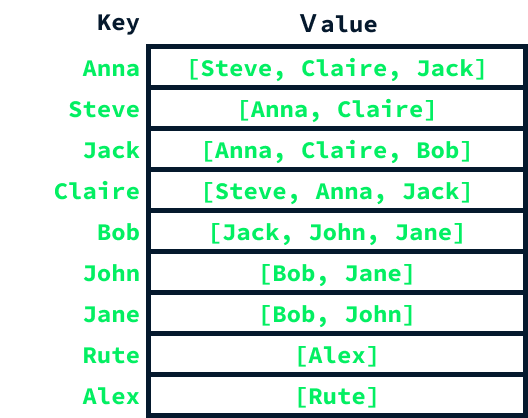
Il pacchetto networkx offre un'implementazione in Python per creare e manipolare grafi. Inoltre, la libreria networkx include un'ampia gamma di algoritmi sui grafi, inclusi quelli per il rilevamento delle comunità. Usiamola per costruire il grafo menzionato in precedenza e applicare un algoritmo di community detection diffuso per osservare i risultati.
Per iniziare a creare il grafo, importiamo la libreria networkx e inizializziamo un grafo vuoto:
import networkx as nx
G = nx.Graph()
I nodi possono essere aggiunti usando il metodo add_node().
G.add_node("Anna")
G.add_node("Steve")
G.add_node("Jack")
G.add_node("Claire")
G.add_node("Bob")
G.add_node("Jane")
G.add_node("John")
G.add_node("Rute")
G.add_node("Alex")
Gli archi possono essere aggiunti usando il metodo add_edge().
G.add_edge("Anna", "Steve")
G.add_edge("Anna", "Jack")
G.add_edge("Anna", "Claire")
G.add_edge("Steve", "Claire")
G.add_edge("Claire", "Jack")
G.add_edge("Jack", "Bob")
G.add_edge("Bob", "John")
G.add_edge("Bob", "Jane")
G.add_edge("John", "Jane")
G.add_edge("Rute", "Alex")
Creato il nostro grafo, possiamo calcolare le comunità al suo interno. Esistono diversi algoritmi per il rilevamento delle comunità e, in questo caso, useremo il metodo di Louvain. Gli algoritmi di community detection si trovano nel sottopacchetto community di networkx. In particolare, ci concentreremo sulla funzione louvain_communities().
Ecco come utilizzarla:
communities = nx.community.louvain_communities(G)
print(communities)
[{'Jack', 'Claire', 'Anna', 'Steve'}, {'Bob', 'John', 'Jane'}, {'Rute', 'Alex'}]L'output è una lista di insiemi, con ciascun insieme che rappresenta una comunità. Osserviamo che l'algoritmo ha individuato tre comunità, in linea con le nostre aspettative dato la struttura del grafo.
Per saperne di più sui grafi, scopri come implementare l'algoritmo di Dijkstra in Python.
Quando abbiamo presentato ciascuna struttura dati, abbiamo elencato le operazioni supportate. Queste operazioni fungono da linee guida su quando usare quella struttura dati, poiché è progettata per eseguirle in modo efficiente.
Per esempio, la list() di Python supporta anche operazioni aggiuntive, come la rimozione di elementi. Tuttavia, queste operazioni extra non sono ciò in cui eccelle una lista basata su array. In particolare, rimuovere un elemento dal mezzo di una lista richiede di copiare tutti i dati (tranne l'elemento rimosso) in una nuova lista, operazione che può richiedere molto tempo.
Quando i dati sono naturalmente indicizzati con numeri e il numero di voci è noto (per esempio, i giorni di un mese), un array è di solito la scelta preferita. Per un'indicizzazione più generica o dataset dinamici, i dizionari sono una buona soluzione alternativa.
Per elaborare i dati in sequenza, una voce alla volta, si usano spesso code o pile, a seconda dell'ordine desiderato di elaborazione.
Gli alberi sono di solito la risposta quando vogliamo eseguire query più complesse sui dati, come trovare tutte le voci in un dato intervallo o gli estremi.
Infine, quando esiste una relazione tra coppie di punti dati, un grafo è un modo efficace per memorizzare e rappresentare queste relazioni. Esistono algoritmi sui grafi che ci permettono di rispondere a domande comuni su dataset con questo tipo di relazione a coppie.
Le strutture dati costituiscono un dominio vasto, e qui abbiamo solo scalfito la superficie. In alcune situazioni, la soluzione è progettare una struttura dati completamente nuova, su misura per il problema. Tuttavia, conoscere le strutture dati discusse in questo articolo dovrebbe indirizzarti nella direzione giusta quando affronti problemi legati ai dati.
In questo articolo abbiamo visto che le strutture dati sono metodi per organizzare i dati in formati particolari per facilitare il recupero efficiente delle informazioni.
Esistono due tipi fondamentali di strutture dati: quelle basate su array (per esempio, le tabelle hash) e quelle basate su nodi (per esempio, i grafi).
Le strutture lineari, come array, code e pile, organizzano gli elementi in sequenza, uno dopo l'altro. Al contrario, le strutture non lineari, come tabelle hash, alberi e grafi, organizzano i dati in base alle relazioni all'interno dei dati.
La scelta della struttura dati appropriata dipende dalla natura delle interrogazioni da eseguire.
Se vuoi conoscere le varie strutture dati in Python, consulta questo tutorial sulle strutture dati in Python.
Impara Python con questi corsi!
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



