


课程
Python 中级
4 小时
1.4M
Dropout 正则化是一种用于神经网络的技术,用来防止过拟合——即模型学习了训练数据中的噪声而非真实模式的情况。
2012 年,图灵奖得主 Geoffrey Hinton 及其同事在 一篇研究论文中提出了该技术,此后被广泛用于训练深度学习模型。
本教程将介绍 Dropout 正则化的概念,重申我们为何需要它,并介绍在 PyTorch 中帮助实现它的函数。您还将通过动手示例了解实现细节,并获取在未来深度学习项目中有效使用 Dropout 的进阶技巧。
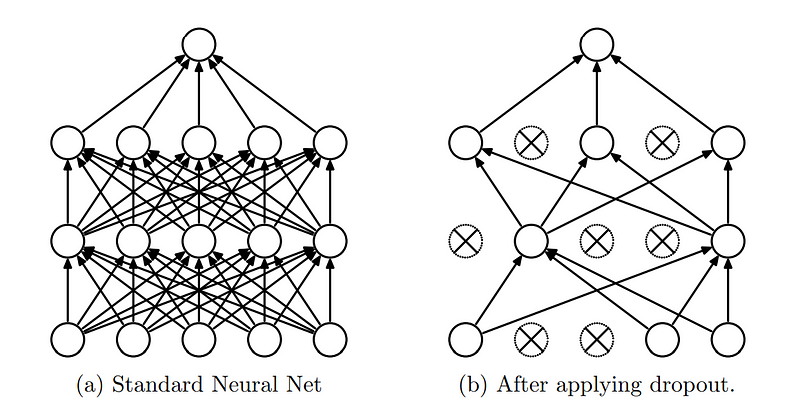
Dropout 的核心思想是在训练阶段随机“丢弃”(设为 0)网络中一部分神经元。也就是说,在每一次前向和反向传播中,会有一定比例的神经元被忽略或“丢弃”,使得网络的结构对每个训练批次而言都是动态变化的。
Dropout 正则化。(来源)
由于其带来的益处,Dropout 层已成为神经网络中的关键一层:
既然我们理解了 Dropout 的概念,接下来看看如何实现它。
主流深度学习库如 Tensorflow 和 PyTorch 都提供了简化的模块与函数,因此在神经网络模型中实现 Dropout 正则化十分直接。
如标题所示,本教程侧重使用 PyTorch 实现 Dropout 正则化;若您选择在 Tensorflow 中实现,可参考 Tensorflow 官方文档。
PyTorch 是由 Facebook(现 Meta)的 AI 研究实验室(FAIR)开发的开源机器学习库,广泛用于深度学习和人工智能应用。在 PyTorch 中,可使用 torch.nn.Dropout 类来实现 Dropout。
torch.nn.Dropout 类的语法如下:
torch.nn.Dropout(p=0.5, inplace=False)其中:
在该函数中,训练期间 Dropout 层会以概率 p 随机将输入张量的一些元素置零。被置零的元素在每次前向调用时独立选择,并从伯努利分布中采样。每个通道在每次前向调用时都会被独立地置零。
在评估阶段,Dropout 层会被关闭,即该层计算恒等函数。这确保所有神经元均处于激活状态,且不进行缩放。
既然我们了解了 Dropout 正则化的工作原理以及在 PyTorch 中使用的函数,接下来通过一个动手示例把它们结合起来。
我们将使用流行的 MNIST 数据集,构建一个简单的卷积神经网络,从图像中识别手写数字。随后,我们将学习如何向神经网络添加 Dropout 层并考察其影响。
首先,如果您尚未安装 Python,可在 Python 官方网站找到安装说明。安装完成后,您可以使用包管理器 pip 来安装 PyTorch 库。
打开终端并运行以下命令:
pip install torch torchvision请注意,PyTorch 库依赖于您的环境和 CUDA 版本。 官方安装文档根据您的环境设置提供了清晰的安装指引。
如果您急于测试代码并希望跳过环境搭建,您可以 打开一个新的 Google Collab 笔记本(已预装 PyTorch)以便立即动手实践。
由于 MNIST(美国国家标准与技术研究院修改版)数据集可直接在 PyTorch 库中获取,我们无需另行下载。
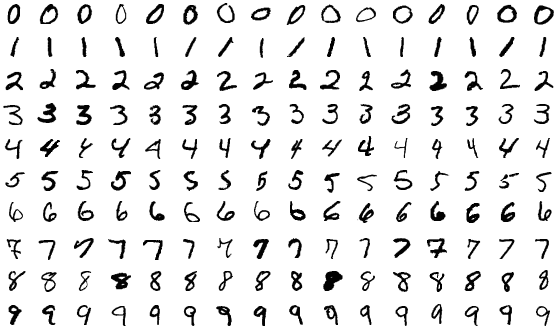
MNIST 是一个大型手写数字集合,常用于训练和测试。它包含 70,000 张灰度数字图像(0–9),其中 60,000 张为训练图像,10,000 张为测试图像。每张图像都标注了其对应的数字,是一个有监督学习数据集。
MNIST 数据集。
我们将加载相关库并读取数据集。
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader, random_split
import matplotlib.pyplot as plt

# Transformation to normalize the data
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# Loading the MNIST dataset
full_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)

# Splitting the dataset into training and validation sets
train_size = int(0.8 * len(full_dataset))
val_size = len(full_dataset) - train_size
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])

train_loader = DataLoader(dataset=train_dataset, batch_size=100, shuffle=True)
val_loader = DataLoader(dataset=val_dataset, batch_size=100, shuffle=False)
test_loader = DataLoader(dataset=test_dataset, batch_size=100, shuffle=False)
在本示例中,我们将 20% 的训练图像划分为验证集。接下来检查数据集的维度:
# Inspecting the train dataset
train_data_iter = iter(train_loader)
train_images, train_labels = next(train_data_iter)
print(f"Train Images Shape: {train_images.shape}")
print(f"Train Labels Shape: {train_labels.shape}")
print("-----------------------------------------")

# Inspecting the val dataset
val_data_iter = iter(val_loader)
val_images, val_labels = next(val_data_iter)
print(f"Validation Images Shape: {val_images.shape}")
print(f"Validation Labels Shape: {val_labels.shape}")
print("-----------------------------------------")

# Inspecting the test dataset
test_data_iter = iter(test_loader)
test_images, test_labels = next(test_data_iter)
print(f"Test Images Shape: {test_images.shape}")
print(f"Test Labels Shape: {test_labels.shape}")
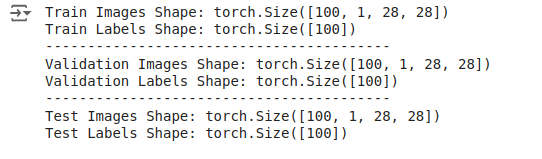
输出如下所示:
输出:数据集的维度。
这些输出表明,每个批次包含 100 张图像,每张图像为单通道,尺寸为 28x28 像素。标签是大小为 100 的一维张量,对应于批次中每张图像的标签。
在加载并转换数据后,我们定义一个简单的卷积神经网络模型,首个模型不使用 Dropout。
# Define the CNN Without Dropout
class CNNWithoutDropout(nn.Module):
   def __init__(self):
       super(CNNWithoutDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = torch.relu(self.fc1(x))
       x = self.fc2(x)
       return x

model_without_dropout = CNNWithoutDropout()
在定义模型之后,我们定义优化器和损失函数。
criterion = nn.CrossEntropyLoss()
optimizer_without_dropout = optim.SGD(model_without_dropout.parameters(), lr=0.01, momentum=0.9)接下来,我们在不使用 Dropout 的情况下训练模型,记录训练和验证指标。我们将代码写成函数,便于后续复用。
def train_validate_model(model, train_loader, val_loader, criterion, optimizer, num_epochs=10):
   train_losses = []
   val_losses = []
   train_accuracies = []
   val_accuracies = []

   for epoch in range(num_epochs):
       model.train()
       running_loss = 0.0
       correct = 0
       total = 0

       for images, labels in train_loader:
           outputs = model(images)
           loss = criterion(outputs, labels)

           optimizer.zero_grad()
           loss.backward()
           optimizer.step()

           running_loss += loss.item()
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

       epoch_loss = running_loss / len(train_loader)
       epoch_accuracy = 100 * correct / total
       train_losses.append(epoch_loss)
       train_accuracies.append(epoch_accuracy)

       # Validation Phase
       model.eval()
       val_loss = 0.0
       correct = 0
       total = 0

       with torch.no_grad():
           for images, labels in val_loader:
               outputs = model(images)
               loss = criterion(outputs, labels)
               val_loss += loss.item()
               _, predicted = torch.max(outputs.data, 1)
               total += labels.size(0)
               correct += (predicted == labels).sum().item()

       val_loss /= len(val_loader)
       val_accuracy = 100 * correct / total
       val_losses.append(val_loss)
       val_accuracies.append(val_accuracy)

       print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {epoch_loss:.4f}, Accuracy: {epoch_accuracy:.2f}%, Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2f}%')
   return train_losses, val_losses, train_accuracies, val_accuracies
现在,我们可以用训练集和验证集来调用该函数。
train_losses_without_dropout, val_losses_without_dropout, train_accuracies_without_dropout, val_accuracies_without_dropout = train_validate_model(
   model_without_dropout, train_loader, val_loader, criterion, optimizer_without_dropout
)
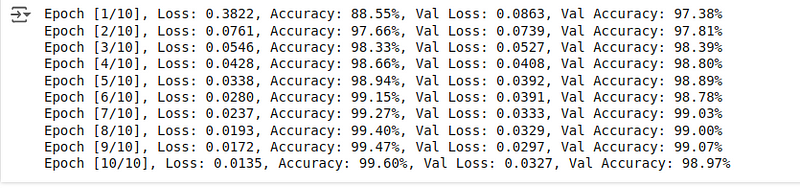
您将看到如下训练与验证指标:
输出:训练和验证指标。
验证准确率略低于训练准确率。即便没有使用 Dropout,模型在训练和验证阶段的表现也相当出色,在训练集和验证集上均取得了较高准确率。
训练完成后,我们可以在测试图像上评估模型表现,得到测试准确率分数,作为添加 Dropout 层前的基线分数。
def evaluate_model(model, test_loader, criterion):
   model.eval()
   correct = 0
   total = 0

   with torch.no_grad():
       for images, labels in test_loader:
           outputs = model(images)
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

   accuracy = 100 * correct / total
   return accuracy

accuracy_without_dropout = evaluate_model(model_without_dropout, test_loader, criterion)
print(f'Accuracy of the model without dropout on the test images: {accuracy_without_dropout:.2f}%')
最终准确率如下所示:
输出:测试图像上的准确率。
99.07% 的准确率非常高,略低于训练准确率,但优于验证准确率。接下来看看在添加 Dropout 层后,模型的表现会怎样——这会让学习手写数字的任务变得更难。
我们已了解如何定义、训练和评估一个简单的神经网络。现在重复该流程,从模型定义开始并添加一个 Dropout 层。
# Define the CNN With Dropout
class CNNWithDropout(nn.Module):
   def __init__(self):
       super(CNNWithDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.dropout = nn.Dropout(p=0.5)  # Dropout layer with 50% probability
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = self.dropout(torch.relu(self.fc1(x)))  # Apply dropout after ReLU activation
       x = self.fc2(x)
       return x

model_with_dropout = CNNWithDropout()
注意代码变化:新增了两行代码,为模型定义添加了 Dropout 层。没错,借助 PyTorch 提供的相关函数,添加 Dropout 层就是如此简单的几行代码。
我们保持损失函数和优化器与基线模型一致。
criterion = nn.CrossEntropyLoss()
optimizer_with_dropout = optim.SGD(model_with_dropout.parameters(), lr=0.01, momentum=0.9)接下来,复用之前编写的函数来训练含 Dropout 的模型,并记录训练与验证指标。
train_losses_with_dropout, val_losses_with_dropout, train_accuracies_with_dropout, val_accuracies_with_dropout = train_validate_model(
   model_with_dropout, train_loader, val_loader, criterion, optimizer_with_dropout
)
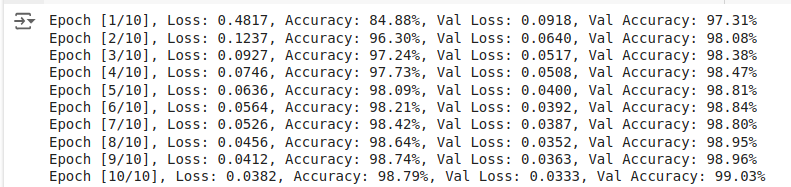
得到的训练和验证分数如下:
输出:训练和验证指标。
与含 Dropout 的模型相比,不含 Dropout 的模型取得了更高的训练准确率和更低的训练损失,这是预期之中的,因为 Dropout 在训练中引入了噪声,使模型更难完美拟合训练数据。
尽管训练分数有所下降,但含 Dropout 的模型在验证集上的准确率有所提升。
在评估阶段(包括验证),Dropout 层会被停用。这意味着所有单元都处于激活状态,不会有输入被丢弃。
在 PyTorch 中,通过 model.train() 与 model.eval() 在训练模式与评估模式之间切换:
model.train():将模型设为训练模式,激活 Dropout 以及批归一化等训练特定行为。model.eval():将模型设为评估模式,停用 Dropout,并使用完整的网络进行预测。我们来计算测试准确率:
accuracy_with_dropout = evaluate_model(model_with_dropout, test_loader, criterion)
print(f'Accuracy of the model with dropout on the test images: {accuracy_with_dropout:.2f}%')
得到的准确率如下:
输出:测试图像上的准确率。
我们得到 99.12% 的准确率,略高于不使用 Dropout 的模型。
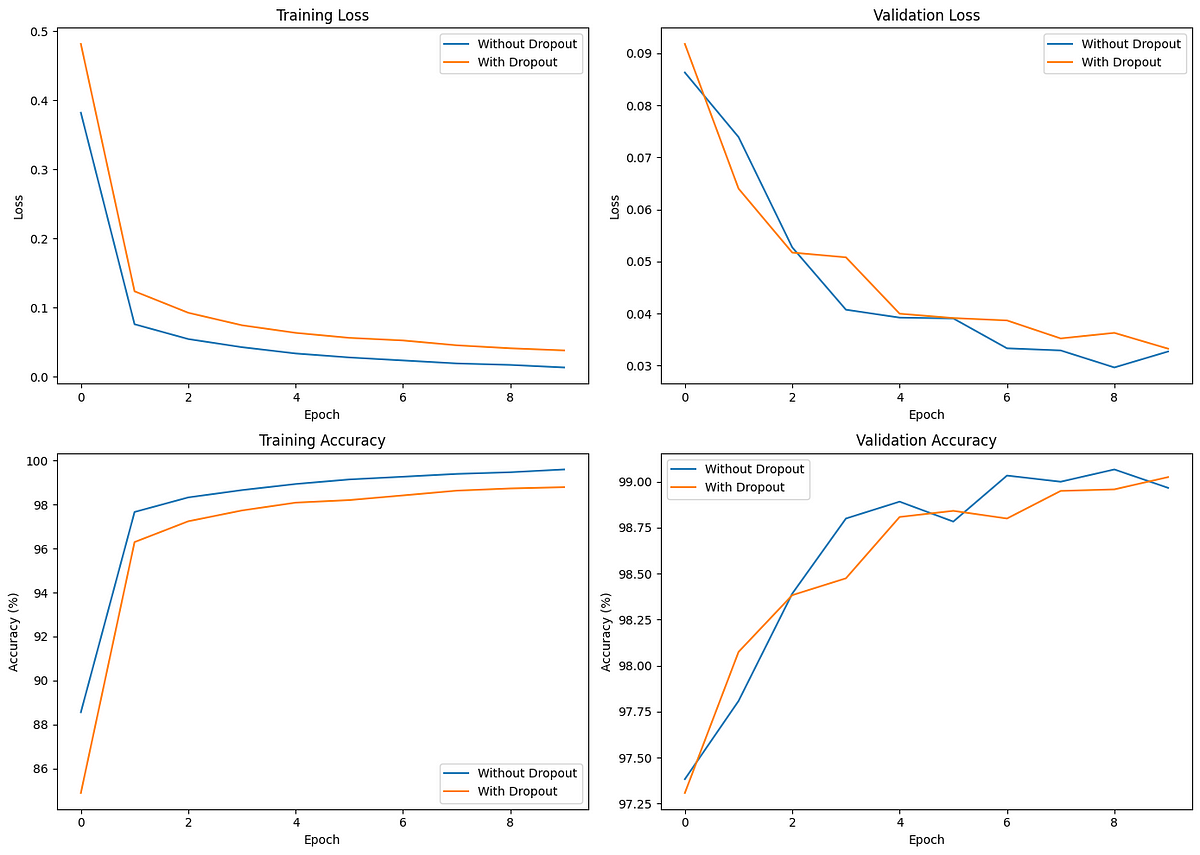
由于我们在训练、验证和评估阶段都存储了各项指标,现在使用 Matplotlib 将它们绘制为图表,以便更好地分析。
绘图代码如下:
# Plotting the Results
plt.figure(figsize=(14, 10))

# Plot training loss
plt.subplot(2, 2, 1)
plt.plot(train_losses_without_dropout, label='Without Dropout')
plt.plot(train_losses_with_dropout, label='With Dropout')
plt.title('Training Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot validation loss
plt.subplot(2, 2, 2)
plt.plot(val_losses_without_dropout, label='Without Dropout')
plt.plot(val_losses_with_dropout, label='With Dropout')
plt.title('Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot training accuracy
plt.subplot(2, 2, 3)
plt.plot(train_accuracies_without_dropout, label='Without Dropout')
plt.plot(train_accuracies_with_dropout, label='With Dropout')
plt.title('Training Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

# Plot validation accuracy
plt.subplot(2, 2, 4)
plt.plot(val_accuracies_without_dropout, label='Without Dropout')
plt.plot(val_accuracies_with_dropout, label='With Dropout')
plt.title('Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

plt.tight_layout()
plt.show()
比较图如下:
比较 Dropout 对训练与验证的影响。
不含 Dropout 的模型初始训练损失更低,表明收敛更快。然而,含 Dropout 的模型在验证损失与准确率方面更为稳定,显示出更好的泛化能力。
从这些图中可以看到,尽管含 Dropout 的模型在训练准确率上低于不含 Dropout 的模型,但其验证准确率(以及测试准确率)略高于后者。
Dropout 有助于防止过拟合,这体现在训练与验证表现之间较小的差距。尽管在我们的示例中差异不大,但在训练更复杂、更大型的模型时,这种差异会愈发重要。
以下是您在使用 Dropout 训练深度学习模型时的一些实用建议:
如果您是深度学习实践者,值得一读原始论文“Improving Neural Networks by Preventing Co-adaptation of Feature Detectors”。作者基于其实验讨论了多条额外的实用指南。
在神经网络中,尤其是在对大型模型进行高轮次训练时,训练数据过拟合是常见问题。诸如 Dropout 等正则化技术可防止神经网络记忆训练数据,帮助其更好地学习数据中的有用模式。
本教程介绍了 Dropout 正则化的概念,解释了其必要性,并通过一个示例用例展示了如何在 PyTorch 中实现。我们还学习了一些在深度神经网络中高效使用 Dropout 的高级最佳实践与技巧。
如需进一步学习如何使用 PyTorch 完成深度学习任务,请查看对初学者友好的 Introduction to Deep Learning with PyTorch 课程,以及 Intermediate Deep Learning with PyTorch 课程,按此顺序学习。
与 DataCamp 一起学习 PyTorch
课程
学习路径
学习路径