


Kurs
Python für Fortgeschrittene
4 Std.
1.4M
Die Dropout-Regularisierung ist eine Technik in neuronalen Netzen, die Overfitting verhindert – also den Fall, dass ein Modell das Rauschen in den Trainingsdaten statt der eigentlichen Muster lernt.
2012 stellten Geoffrey Hinton (Turing-Preisträger) und Kolleg:innen die Technik in einer Forschungsarbeit vor, und seitdem wird sie breit eingesetzt, um Deep-Learning-Modelle zu trainieren.
Dieses Tutorial führt in das Konzept der Dropout-Regularisierung ein, erklärt, warum wir sie brauchen, und stellt die Funktionen zur Implementierung in PyTorch vor. Anhand praxisnaher Beispiele lernst du außerdem Implementierungsdetails sowie fortgeschrittene Tipps, um Dropout in künftigen Deep-Learning-Projekten effektiv einzusetzen.
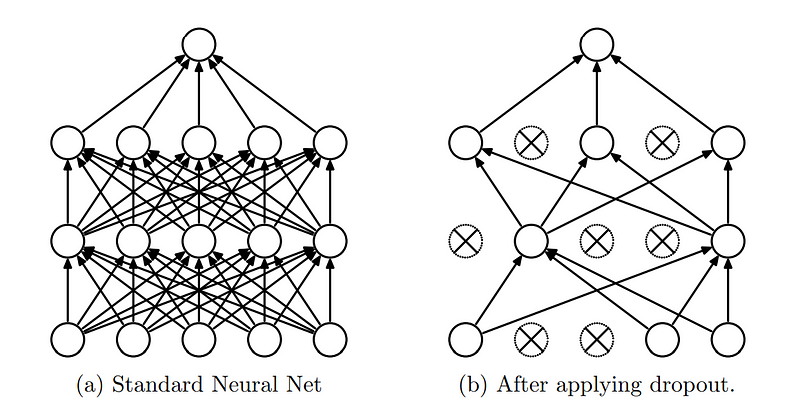
Die Kernidee von Dropout ist, während des Trainings zufällig einen Anteil der Neuronen im Netzwerk „auszuschalten“ (auf Null zu setzen). Das heißt: In jedem Vorwärts- und Rückwärtsdurchlauf wird ein gewisser Prozentsatz der Neuronen ignoriert oder „gedroppt“, wodurch sich die Architektur des Netzwerks für jedes Trainingsbatch dynamisch verändert.
Dropout-Regularisierung. (Quelle)
Die Dropout-Schicht ist in neuronalen Netzen zu einem Standardbaustein geworden – aus guten Gründen:
Da wir das Konzept verstanden haben, schauen wir uns jetzt die Umsetzung an.
Beliebte Deep-Learning-Bibliotheken wie Tensorflow und PyTorch bieten fertige Module und Funktionen. Dadurch lässt sich Dropout in neuronalen Netzen sehr einfach implementieren.
Wie der Titel verrät, konzentriert sich dieses Tutorial auf PyTorch. Falls du es in Tensorflow umsetzen möchtest, findest du die Anleitung in der offiziellen Tensorflow-Dokumentation.
PyTorch ist eine Open-Source-Bibliothek für Machine Learning, entwickelt im AI Research Lab (FAIR) von Facebook (heute Meta), und wird breit für Deep Learning und KI-Anwendungen genutzt. In PyTorch lässt sich Dropout mit der torch.nn.Dropout Class implementieren.
Die Syntax der torch.nn.Dropout-Klasse lautet:
torch.nn.Dropout(p=0.5, inplace=False)Dabei gilt:
Während des Trainings setzt die Dropout-Schicht zufällig Elemente des Eingangstensors mit Wahrscheinlichkeit p auf Null. Die Auswahl erfolgt bei jedem Forward-Pass unabhängig und wird aus einer Bernoulli-Verteilung gezogen. Jeder Kanal wird bei jedem Forward-Pass unabhängig genullt.
In der Evaluierungsphase ist Dropout deaktiviert, die Schicht wirkt also wie eine Identitätsfunktion. Dadurch sind alle Neuronen aktiv, ohne zusätzliche Skalierung.
Da wir nun wissen, wie Dropout funktioniert und welche PyTorch-Funktion wir nutzen, setzen wir es im nächsten Schritt praktisch ein.
Wir verwenden den bekannten MNIST-Datensatz und bauen ein einfaches Convolutional Neural Network, das handgeschriebene Ziffern in Bildern erkennt. Anschließend fügen wir Dropout-Schichten hinzu und betrachten den Effekt.
Falls Python noch nicht installiert ist, findest du die Anleitung auf der offiziellen Python-Website. Sobald Python installiert ist, kannst du mit dem Paketmanager pip die PyTorch-Bibliotheken installieren.
Öffne dein Terminal und führe folgenden Befehl aus:
pip install torch torchvisionBeachte, dass die PyTorch-Pakete von deiner Umgebung und der CUDA-Version abhängen. Die offizielle Installationsdokumentation bietet klare Anweisungen für verschiedene Setups.
Wenn du die Codes schnell testen willst und die Umgebungseinrichtung überspringen möchtest, kannst du ein neues Google Colab-Notebook mit vorinstalliertem PyTorch öffnen und direkt loslegen.
Da der MNIST (Modified National Institute of Standards and Technology)-Datensatz direkt in PyTorch verfügbar ist, müssen wir ihn nicht separat herunterladen.
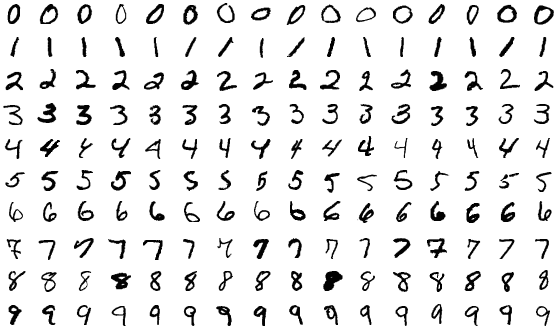
MNIST ist eine große Sammlung handgeschriebener Ziffern für Training und Tests. Er umfasst 70.000 Graustufenbilder der Ziffern 0–9, aufgeteilt in 60.000 Trainings- und 10.000 Testbilder. Jedes Bild ist mit der richtigen Ziffer beschriftet und eignet sich somit für überwachtes Lernen.
Der MNIST-Datensatz.
Als Nächstes laden wir die relevanten Bibliotheken und lesen den Datensatz ein.
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader, random_split
import matplotlib.pyplot as plt

# Transformation zur Normalisierung der Daten
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# Laden des MNIST-Datensatzes
full_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)

# Aufteilen in Trainings- und Validierungsdaten
train_size = int(0.8 * len(full_dataset))
val_size = len(full_dataset) - train_size
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])

train_loader = DataLoader(dataset=train_dataset, batch_size=100, shuffle=True)
val_loader = DataLoader(dataset=val_dataset, batch_size=100, shuffle=False)
test_loader = DataLoader(dataset=test_dataset, batch_size=100, shuffle=False)
In diesem Beispiel teilen wir 20% der Trainingsbilder als Validierungsdaten ab. Prüfen wir die Dimensionen der Datensätze:
# Inspizieren des Trainingsdatensatzes
train_data_iter = iter(train_loader)
train_images, train_labels = next(train_data_iter)
print(f"Train Images Shape: {train_images.shape}")
print(f"Train Labels Shape: {train_labels.shape}")
print("-----------------------------------------")

# Inspizieren des Validierungsdatensatzes
val_data_iter = iter(val_loader)
val_images, val_labels = next(val_data_iter)
print(f"Validation Images Shape: {val_images.shape}")
print(f"Validation Labels Shape: {val_labels.shape}")
print("-----------------------------------------")

# Inspizieren des Testdatensatzes
test_data_iter = iter(test_loader)
test_images, test_labels = next(test_data_iter)
print(f"Test Images Shape: {test_images.shape}")
print(f"Test Labels Shape: {test_labels.shape}")
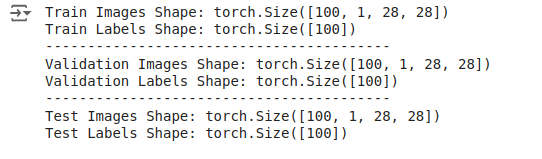
Die Ausgabe sieht wie folgt aus:
Ausgabe: Die Dimensionen des Datensatzes.
Die Batches enthalten 100 Bilder, jeweils mit einem Kanal und einer Größe von 28×28 Pixeln. Die Labels sind ein 1D-Tensor der Länge 100 und entsprechen den Beschriftungen jedes Bildes im Batch.
Nachdem die Daten geladen und transformiert sind, definieren wir ein einfaches Convolutional Neural Network – zunächst ohne Dropout.
# Definiere das CNN ohne Dropout
class CNNWithoutDropout(nn.Module):
   def __init__(self):
       super(CNNWithoutDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = torch.relu(self.fc1(x))
       x = self.fc2(x)
       return x

model_without_dropout = CNNWithoutDropout()
Nach der Modelldefinition legen wir Optimierer und Verlustfunktion fest.
criterion = nn.CrossEntropyLoss()
optimizer_without_dropout = optim.SGD(model_without_dropout.parameters(), lr=0.01, momentum=0.9)Jetzt trainieren wir das Modell ohne Dropout und zeichnen Trainings- und Validierungsmetriken auf. Wir schreiben die Codes als Funktionen, um sie später wiederzuverwenden.
def train_validate_model(model, train_loader, val_loader, criterion, optimizer, num_epochs=10):
   train_losses = []
   val_losses = []
   train_accuracies = []
   val_accuracies = []

   for epoch in range(num_epochs):
       model.train()
       running_loss = 0.0
       correct = 0
       total = 0

       for images, labels in train_loader:
           outputs = model(images)
           loss = criterion(outputs, labels)

           optimizer.zero_grad()
           loss.backward()
           optimizer.step()

           running_loss += loss.item()
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

       epoch_loss = running_loss / len(train_loader)
       epoch_accuracy = 100 * correct / total
       train_losses.append(epoch_loss)
       train_accuracies.append(epoch_accuracy)

       # Validierungsphase
       model.eval()
       val_loss = 0.0
       correct = 0
       total = 0

       with torch.no_grad():
           for images, labels in val_loader:
               outputs = model(images)
               loss = criterion(outputs, labels)
               val_loss += loss.item()
               _, predicted = torch.max(outputs.data, 1)
               total += labels.size(0)
               correct += (predicted == labels).sum().item()

       val_loss /= len(val_loader)
       val_accuracy = 100 * correct / total
       val_losses.append(val_loss)
       val_accuracies.append(val_accuracy)

       print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {epoch_loss:.4f}, Accuracy: {epoch_accuracy:.2f}%, Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2f}%')
   return train_losses, val_losses, train_accuracies, val_accuracies
Nun rufen wir die Funktion mit Trainings- und Validierungsdaten auf.
train_losses_without_dropout, val_losses_without_dropout, train_accuracies_without_dropout, val_accuracies_without_dropout = train_validate_model(
   model_without_dropout, train_loader, val_loader, criterion, optimizer_without_dropout
)
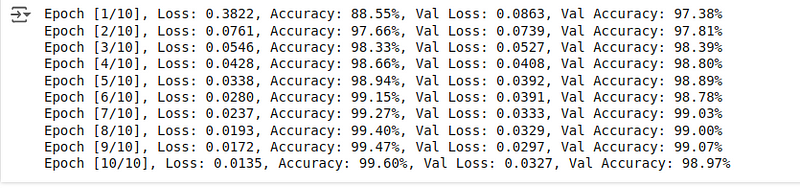
Du siehst anschließend folgende Trainings- und Validierungsmetriken:
Ausgabe: Trainings- und Validierungsmetriken.
Die Validierungsgenauigkeit liegt leicht unter der Trainingsgenauigkeit. Selbst ohne Dropout performt das Modell in Training und Validierung sehr gut und erreicht hohe Genauigkeit in beiden Sets.
Nach dem Training prüfen wir die Leistung auf den Testbildern, um den Test-Accuracy-Wert als Baseline vor dem Hinzufügen von Dropout zu erhalten.
def evaluate_model(model, test_loader, criterion):
   model.eval()
   correct = 0
   total = 0

   with torch.no_grad():
       for images, labels in test_loader:
           outputs = model(images)
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

   accuracy = 100 * correct / total
   return accuracy

accuracy_without_dropout = evaluate_model(model_without_dropout, test_loader, criterion)
print(f'Accuracy of the model without dropout on the test images: {accuracy_without_dropout:.2f}%')
Die finale Genauigkeit lautet:
Ausgabe: Genauigkeit auf den Testbildern.
99,07% Genauigkeit ist hervorragend – etwas unter der Trainingsgenauigkeit, aber besser als die Validierungsgenauigkeit. Schauen wir nun, wie sich das Modell verhält, wenn wir Dropout-Schichten hinzufügen, die das Lernen der Ziffern erschweren.
Wir wissen nun, wie man ein einfaches Netz definiert, trainiert und evaluiert. Wiederholen wir den Ablauf – diesmal mit einer Dropout-Schicht.
# Definiere das CNN mit Dropout
class CNNWithDropout(nn.Module):
   def __init__(self):
       super(CNNWithDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.dropout = nn.Dropout(p=0.5)  # Dropout-Schicht mit 50% Wahrscheinlichkeit
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = self.dropout(torch.relu(self.fc1(x)))  # Dropout nach ReLU anwenden
       x = self.fc2(x)
       return x

model_with_dropout = CNNWithDropout()
Beachte die Änderung: Zwei neue Codezeilen fügen dem Modell Dropout hinzu. Ja, mit der passenden PyTorch-Funktion ist das Hinzufügen von Dropout in wenigen Zeilen erledigt.
Wir verwenden dieselbe Verlustfunktion und denselben Optimierer wie im Basismodell.
criterion = nn.CrossEntropyLoss()
optimizer_with_dropout = optim.SGD(model_with_dropout.parameters(), lr=0.01, momentum=0.9)Als Nächstes trainieren wir das Modell mit Dropout, nutzen die zuvor geschriebenen Funktionen und protokollieren Trainings- und Validierungsmetriken.
train_losses_with_dropout, val_losses_with_dropout, train_accuracies_with_dropout, val_accuracies_with_dropout = train_validate_model(
   model_with_dropout, train_loader, val_loader, criterion, optimizer_with_dropout
)
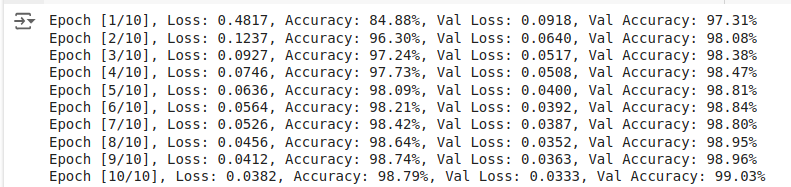
Die resultierenden Trainings- und Validierungswerte sind:
Ausgabe: Trainings- und Validierungsmetriken.
Im Vergleich erzielt das Modell ohne Dropout eine höhere Trainingsgenauigkeit und niedrigeren Trainingsverlust – erwartbar, da Dropout Rauschen einbringt und das perfekte Anpassen an die Trainingsdaten erschwert.
Trotz geringerer Trainingswerte steigt die Validierungsgenauigkeit des Modells mit Dropout.
Während Evaluierungsphasen (inklusive Validierung) sind Dropout-Schichten deaktiviert. Das bedeutet: Alle Einheiten sind aktiv, es wird nichts gedroppt.
In PyTorch wechselst du mit model.train() bzw. model.eval() zwischen Trainings- und Evaluierungsmodus:
model.train(): Aktiviert den Trainingsmodus, inklusive Dropout und trainingsspezifischen Verhaltensweisen wie Batch-Normalisierung.model.eval(): Schaltet in den Evaluierungsmodus, deaktiviert Dropout und nutzt das vollständige Netz für Vorhersagen.Berechnen wir die Testgenauigkeit:
accuracy_with_dropout = evaluate_model(model_with_dropout, test_loader, criterion)
print(f'Accuracy of the model with dropout on the test images: {accuracy_with_dropout:.2f}%')
Die resultierende Genauigkeit lautet:
Ausgabe: Genauigkeit auf den Testbildern.
Wir erhalten 99,12% Genauigkeit – leicht besser als beim Modell ohne Dropout.
Da wir alle Metriken während Training, Validierung und Evaluation gespeichert haben, visualisieren wir sie mit Matplotlib, um sie besser zu analysieren.
Der Code dafür lautet:
# Ergebnisse plotten
plt.figure(figsize=(14, 10))

# Trainingsverlust
plt.subplot(2, 2, 1)
plt.plot(train_losses_without_dropout, label='Without Dropout')
plt.plot(train_losses_with_dropout, label='With Dropout')
plt.title('Training Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Validierungsverlust
plt.subplot(2, 2, 2)
plt.plot(val_losses_without_dropout, label='Without Dropout')
plt.plot(val_losses_with_dropout, label='With Dropout')
plt.title('Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Trainingsgenauigkeit
plt.subplot(2, 2, 3)
plt.plot(train_accuracies_without_dropout, label='Without Dropout')
plt.plot(train_accuracies_with_dropout, label='With Dropout')
plt.title('Training Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

# Validierungsgenauigkeit
plt.subplot(2, 2, 4)
plt.plot(val_accuracies_without_dropout, label='Without Dropout')
plt.plot(val_accuracies_with_dropout, label='With Dropout')
plt.title('Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

plt.tight_layout()
plt.show()
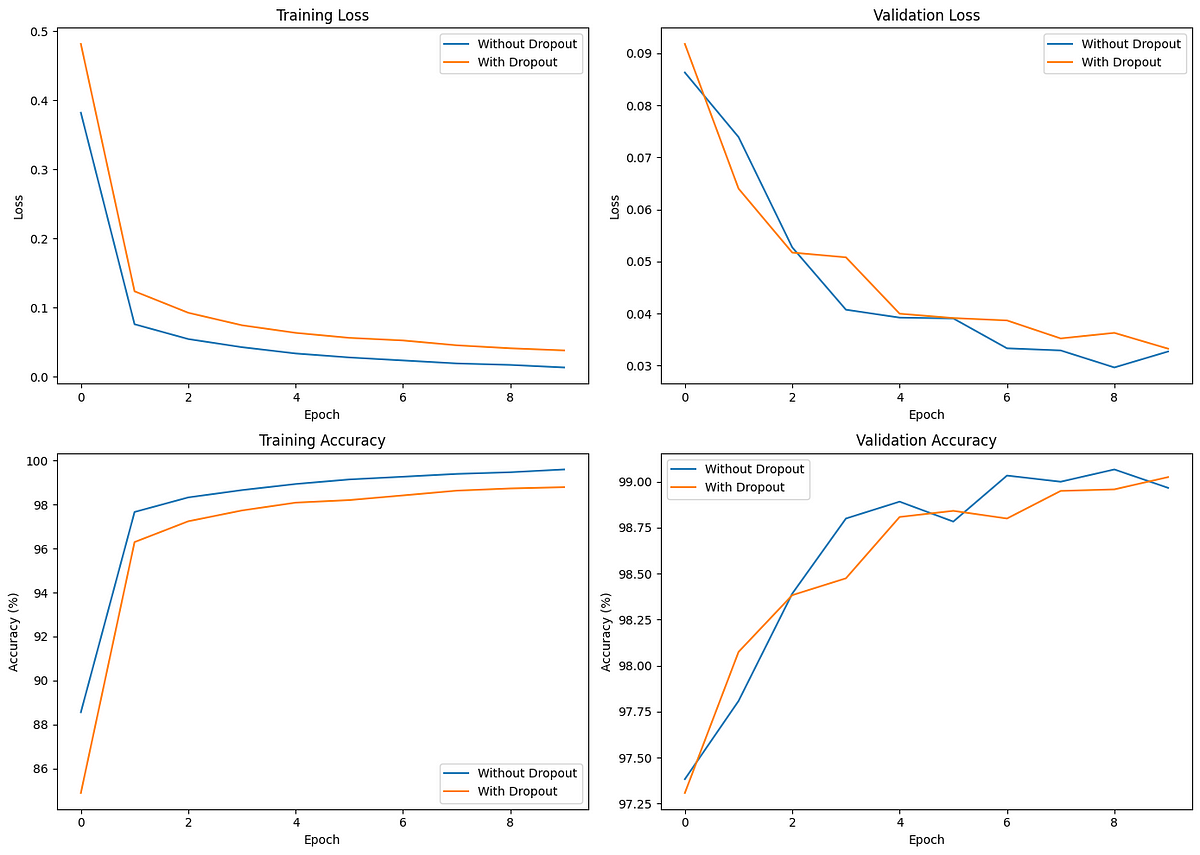
Die Vergleichsgrafiken sehen so aus:
Vergleich: Effekt von Dropout auf Training und Validierung.
Anfangs konvergiert das Modell ohne Dropout schneller (niedrigerer Trainingsverlust). Das Modell mit Dropout zeigt jedoch stabilere Validierungsverluste und -genauigkeiten – ein Zeichen für bessere Generalisierung.
In der Betrachtung erreicht das Modell mit Dropout eine leicht höhere Validierungs- (und Test-)Genauigkeit als das Modell ohne Dropout, obwohl die Trainingsgenauigkeit geringer ist.
Dropout hilft, Overfitting zu vermeiden – erkennbar an der kleineren Lücke zwischen Trainings- und Validierungsleistung. In unserem Beispiel ist der Unterschied klein, bei komplexeren, größeren Modellen wird er umso wichtiger.
Hier ein paar hilfreiche Hinweise, wenn du Deep-Learning-Modelle mit Dropout trainierst:
Wenn du Deep Learning praktisch einsetzt, lohnt sich die Lektüre der Originalarbeit „Improving Neural Networks by Preventing Co-adaptation of Feature Detectors“. Die Autor:innen geben dort weitere hilfreiche Empfehlungen aus ihren Experimenten.
Overfitting ist ein häufiges Problem in neuronalen Netzen, insbesondere bei großen Modellen und vielen Trainingsiterationen. Regularisierungstechniken wie Dropout verhindern, dass Netze Trainingsdaten auswendig lernen, und fördern das Erkennen wirklich nützlicher Muster.
Dieses Tutorial hat das Konzept der Dropout-Regularisierung vorgestellt, den Nutzen erklärt und die Umsetzung in PyTorch anhand eines Beispiels gezeigt. Außerdem hast du fortgeschrittene Best Practices und Tipps kennengelernt, um Dropout in tiefen Netzen wirkungsvoll einzusetzen.
Wenn du mehr über PyTorch für Deep-Learning-Aufgaben lernen willst, schau dir den einsteigerfreundlichen Kurs Introduction to Deep Learning with PyTorch sowie den Kurs Intermediate Deep Learning with PyTorch an – in dieser Reihenfolge.
Lerne PyTorch mit DataCamp
Kurs
Lernpfad
Lernpfad