


Kurs
Orta Seviye Python
4 sa
1.4M
Dropout düzenlileştirme, bir modelin eğitim verisindeki asıl deseni değil de gürültüyü öğrenmesiyle ortaya çıkan aşırı uyumun (overfitting) önüne geçmek için sinir ağlarında kullanılan bir tekniktir.
2012 yılında, Geoffrey Hinton (Turing Ödülü sahibi) ve çalışma arkadaşları bu tekniği bir araştırma makalesinde tanıttılar ve o zamandan beri derin öğrenme modellerini eğitmek için yaygın biçimde benimsendi.
Bu öğreticide dropout düzenlileştirme kavramını tanıtacak, neden ihtiyaç duyduğumuzu pekiştirecek ve PyTorch’ta bunu uygulamaya yardımcı olan işlevleri tanıtacağız. Ayrıca uygulamalı örneklerle uygulama ayrıntılarını öğrenecek ve gelecekteki derin öğrenme projelerinizde dropout’u etkili şekilde kullanmaya yönelik gelişmiş ipuçları edineceksiniz.
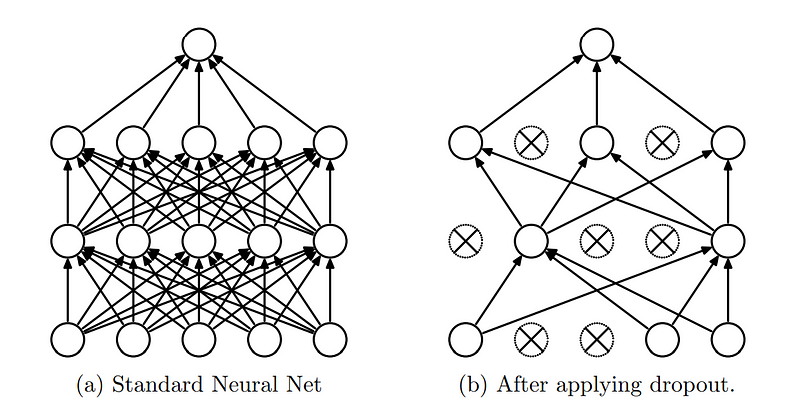
Dropout’un temel fikri, eğitim aşamasında ağdaki nöronların bir kısmını rastgele “devre dışı bırakmak” (sıfıra ayarlamak)tır. Bu, her ileri ve geri yayılımda belirli bir yüzde nöronun yok sayıldığı ya da “düşürüldüğü” anlamına gelir; böylece her eğitim yığınında ağın mimarisi dinamik olarak farklılaşır.
Dropout düzenlileştirme. (Kaynak)
Dropout katmanı, sağladığı faydalar nedeniyle sinir ağlarında temel bir katman haline geldi:
Dropout kavramını anladığımıza göre, şimdi bunun nasıl uygulanacağına geçelim.
Popüler derin öğrenme kütüphaneleri olan Tensorflow ve PyTorch, basitleştirilmiş modül ve işlevler sunduğundan sinir ağı modellerinde dropout düzenlileştirmeyi uygulamak oldukça kolaydır.
Başlıktan da anlaşılacağı üzere bu öğretici, dropout düzenlileştirmeyi PyTorch kullanarak uygulamaya odaklanıyor; ancak Tensorflow ile yapmak isterseniz yönergeler Tensorflow resmi dokümantasyonunda mevcuttur.
PyTorch, Facebook’un (şimdiki Meta) Yapay Zeka Araştırma Laboratuvarı (FAIR) tarafından geliştirilen, derin öğrenme ve yapay zekâ uygulamalarında yaygın olarak kullanılan açık kaynaklı bir makine öğrenmesi kütüphanesidir. PyTorch’ta dropout, torch.nn.Dropout Class kullanılarak uygulanabilir.
torch.nn.Dropout Sınıfının söz dizimi aşağıdaki gibidir:
torch.nn.Dropout(p=0.5, inplace=False)Burada:
Bu işlevde, eğitim sırasında Dropout katmanı, giriş tensörünün bazı öğelerini p olasılığıyla rastgele sıfırlar. Sıfırlanan öğeler her ileri çağrı için bağımsız olarak seçilir ve Bernoulli dağılımından örneklenir. Her kanal, her ileri çağrıda bağımsız olarak sıfırlanır.
Değerlendirme sırasında dropout katmanı kapatılır; yani katman bir özdeşlik fonksiyonu hesaplar. Bu, tüm nöronların etkin olduğu ve herhangi bir ölçekleme uygulanmadığı anlamına gelir.
Dropout düzenlileştirmenin nasıl çalıştığını ve PyTorch’ta kullanılan işlevi anladığımıza göre, bunu bir uygulamalı örnekle birleştirelim.
Popüler MNIST veri setini alacak ve el yazısı rakamları görüntülerden tespit etmek için basit bir evrişimsel sinir ağı kuracağız. Ardından ağa dropout katmanları eklemeyi öğrenecek ve etkisini inceleyeceğiz.
Öncelikle Python kurulu değilse kurulum talimatlarını resmi Python web sitesinde bulabilirsiniz. Python yüklendikten sonra paket yöneticisi pip ile PyTorch kütüphanelerini kurabilirsiniz.
Terminalinizi açın ve aşağıdaki komutu çalıştırın:
pip install torch torchvisionLütfen PyTorch kütüphanelerinin ortamınıza ve CUDA sürümünüze bağlı olduğunu unutmayın. resmi kurulum dokümantasyonu, ortam ayarınıza göre net kurulum talimatları sunar.
Kodları hızla test etmek istiyor ve ortam kurulumunu atlamak istiyorsanız, PyTorch ön yüklü olarak yeni bir Google Collab defteri açabilir ve hemen uygulamaya geçebilirsiniz.
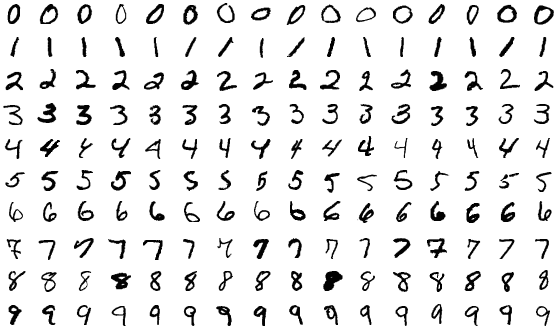
MNIST (Modified National Institute of Standards and Technology) veri seti doğrudan PyTorch kütüphanesinde mevcut olduğundan başka bir yerden indirmemize gerek yok.
MNIST, eğitim ve test için yaygın olarak kullanılan büyük bir el yazısı rakam koleksiyonudur. 70.000 gri tonlamalı rakam (0–9) görüntüsünden oluşur; 60.000’i eğitim, 10.000’i test görüntüsüdür. Her görüntü temsil ettiği rakamla etiketlenmiştir; bu nedenle gözetimli öğrenme veri setidir.
MNIST veri seti.
İlgili kütüphaneleri yükleyip veri setini okuyalım.
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader, random_split
import matplotlib.pyplot as plt

# Transformation to normalize the data
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# Loading the MNIST dataset
full_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)

# Splitting the dataset into training and validation sets
train_size = int(0.8 * len(full_dataset))
val_size = len(full_dataset) - train_size
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])

train_loader = DataLoader(dataset=train_dataset, batch_size=100, shuffle=True)
val_loader = DataLoader(dataset=val_dataset, batch_size=100, shuffle=False)
test_loader = DataLoader(dataset=test_dataset, batch_size=100, shuffle=False)
Bu örnekte, eğitim görüntülerinin %20’si doğrulama olarak ayrılmıştır. Sırada veri setlerinin boyutlarını kontrol etmek var:
# Inspecting the train dataset
train_data_iter = iter(train_loader)
train_images, train_labels = next(train_data_iter)
print(f"Train Images Shape: {train_images.shape}")
print(f"Train Labels Shape: {train_labels.shape}")
print("-----------------------------------------")

# Inspecting the val dataset
val_data_iter = iter(val_loader)
val_images, val_labels = next(val_data_iter)
print(f"Validation Images Shape: {val_images.shape}")
print(f"Validation Labels Shape: {val_labels.shape}")
print("-----------------------------------------")

# Inspecting the test dataset
test_data_iter = iter(test_loader)
test_images, test_labels = next(test_data_iter)
print(f"Test Images Shape: {test_images.shape}")
print(f"Test Labels Shape: {test_labels.shape}")
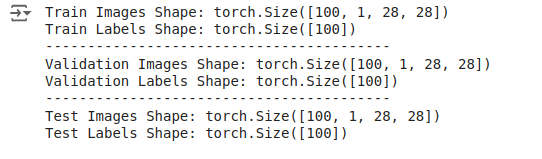
Çıktıyı şu şekilde görüyoruz:
Çıktı: Veri setinin boyutları.
Bu çıktılar, yığınların 100 görüntü içerdiğini; her birinin tek kanallı ve 28x28 piksel boyutunda olduğunu gösterir. Etiketler, yığındaki her görüntünün etiketine karşılık gelen, boyutu 100 olan 1D bir tensördür.
Veriyi yükleyip dönüştürdükten sonra, ilki dropout kullanmayan olmak üzere basit bir evrişimsel sinir ağı modeli tanımlıyoruz.
# Define the CNN Without Dropout
class CNNWithoutDropout(nn.Module):
   def __init__(self):
       super(CNNWithoutDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = torch.relu(self.fc1(x))
       x = self.fc2(x)
       return x

model_without_dropout = CNNWithoutDropout()
Model tanımından sonra, eniyileyiciyi ve kayıp fonksiyonunu tanımlıyoruz.
criterion = nn.CrossEntropyLoss()
optimizer_without_dropout = optim.SGD(model_without_dropout.parameters(), lr=0.01, momentum=0.9)Sonraki adımda, dropout olmadan modeli eğitip eğitim ve doğrulama metriklerini kaydediyoruz. Kodları daha sonra tekrar kullanabilmek için işlevler halinde yazalım.
def train_validate_model(model, train_loader, val_loader, criterion, optimizer, num_epochs=10):
   train_losses = []
   val_losses = []
   train_accuracies = []
   val_accuracies = []

   for epoch in range(num_epochs):
       model.train()
       running_loss = 0.0
       correct = 0
       total = 0

       for images, labels in train_loader:
           outputs = model(images)
           loss = criterion(outputs, labels)

           optimizer.zero_grad()
           loss.backward()
           optimizer.step()

           running_loss += loss.item()
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

       epoch_loss = running_loss / len(train_loader)
       epoch_accuracy = 100 * correct / total
       train_losses.append(epoch_loss)
       train_accuracies.append(epoch_accuracy)

       # Validation Phase
       model.eval()
       val_loss = 0.0
       correct = 0
       total = 0

       with torch.no_grad():
           for images, labels in val_loader:
               outputs = model(images)
               loss = criterion(outputs, labels)
               val_loss += loss.item()
               _, predicted = torch.max(outputs.data, 1)
               total += labels.size(0)
               correct += (predicted == labels).sum().item()

       val_loss /= len(val_loader)
       val_accuracy = 100 * correct / total
       val_losses.append(val_loss)
       val_accuracies.append(val_accuracy)

       print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {epoch_loss:.4f}, Accuracy: {epoch_accuracy:.2f}%, Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2f}%')
   return train_losses, val_losses, train_accuracies, val_accuracies
Artık bu işlevi eğitim ve doğrulama veri setleriyle çağırabiliriz.
train_losses_without_dropout, val_losses_without_dropout, train_accuracies_without_dropout, val_accuracies_without_dropout = train_validate_model(
   model_without_dropout, train_loader, val_loader, criterion, optimizer_without_dropout
)
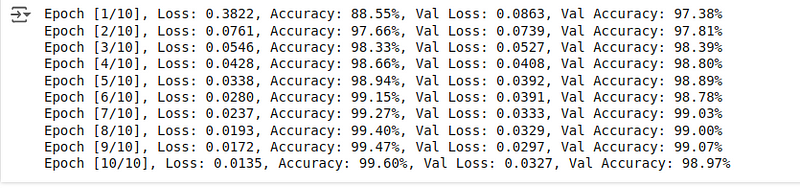
Aşağıda eğitim ve doğrulama metriklerini göreceksiniz:
Çıktı: Eğitim ve doğrulama metrikleri.
Doğrulama doğruluğu, eğitim doğruluğundan biraz daha düşüktür. Dropout olmadan bile model, eğitim ve doğrulama aşamalarında son derece iyi performans göstermekte; her iki kümede de yüksek doğruluk sergilemektedir.
Eğitim tamamlandıktan sonra, test doğruluk puanını elde etmek için modelin test görüntülerindeki performansını değerlendirebiliriz; bu puan, dropout katmanlarını eklemeden önceki temel puanımızdır.
def evaluate_model(model, test_loader, criterion):
   model.eval()
   correct = 0
   total = 0

   with torch.no_grad():
       for images, labels in test_loader:
           outputs = model(images)
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

   accuracy = 100 * correct / total
   return accuracy

accuracy_without_dropout = evaluate_model(model_without_dropout, test_loader, criterion)
print(f'Accuracy of the model without dropout on the test images: {accuracy_without_dropout:.2f}%')
Elde edilen nihai doğruluk şu şekildedir:
Çıktı: Test görüntülerindeki doğruluk.
%99,07 doğruluk son derece iyidir; eğitim doğruluğundan biraz düşük, ancak doğrulama doğruluğundan daha yüksektir. Şimdi, el yazısı rakamları öğrenmeyi zorlaştıran dropout katmanları eklediğimizde modelin nasıl davrandığını görelim.
Artık basit bir sinir ağını nasıl tanımlayıp eğiteceğimizi ve değerlendireceğimizi biliyoruz. Prosedürü, bir model tanımıyla başlayıp bir dropout katmanı ekleyerek tekrarlayalım.
# Define the CNN With Dropout
class CNNWithDropout(nn.Module):
   def __init__(self):
       super(CNNWithDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.dropout = nn.Dropout(p=0.5)  # Dropout layer with 50% probability
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = self.dropout(torch.relu(self.fc1(x)))  # Apply dropout after ReLU activation
       x = self.fc2(x)
       return x

model_with_dropout = CNNWithDropout()
Kod değişikliğine dikkat edin: Model tanımına dropout katmanlarını ekleyen iki yeni satır eklendi. Evet, PyTorch’ta ilgili işlevi kullanarak dropout katmanları eklemek birkaç satır kadar basittir.
Kayıp fonksiyonunu ve eniyileyiciyi, temel modeldekiyle aynı tutuyoruz.
criterion = nn.CrossEntropyLoss()
optimizer_with_dropout = optim.SGD(model_with_dropout.parameters(), lr=0.01, momentum=0.9)Sonraki adımda, önceden yazdığımız işlevleri yeniden kullanarak dropout’lu modeli eğitiyor ve eğitim ile doğrulama metriklerini kaydediyoruz.
train_losses_with_dropout, val_losses_with_dropout, train_accuracies_with_dropout, val_accuracies_with_dropout = train_validate_model(
   model_with_dropout, train_loader, val_loader, criterion, optimizer_with_dropout
)
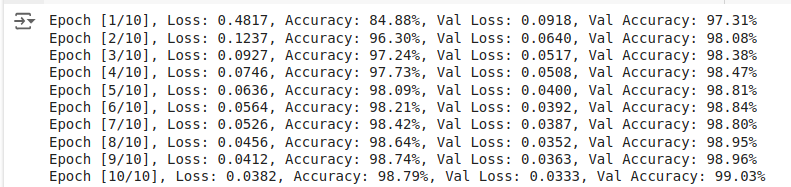
Ortaya çıkan eğitim ve doğrulama puanları şöyledir:
Çıktı: Eğitim ve doğrulama metrikleri.
Dropout’lu modelle karşılaştırıldığında, dropout olmadan model daha yüksek eğitim doğruluğu ve daha düşük eğitim kaybı elde eder; bu beklenir çünkü dropout eğitime gürültü katar ve modelin eğitim verisine kusursuz şekilde uyum sağlamasını zorlaştırır.
Eğitim puanlarındaki düşüşe rağmen, dropout’lu modelin doğrulama doğruluğu artmıştır.
Değerlendirme aşamalarında (doğrulama dahil) dropout katmanları devre dışı bırakılır. Bu, tüm birimlerin etkin olduğu ve hiçbir girdinin düşürülmediği anlamına gelir.
PyTorch’ta eğitim ve değerlendirme modları arasında geçiş sırasıyla model.train() ve model.eval() ile yapılır:
model.train(): Modeli eğitim moduna alır; dropout ve toplu normalizasyon gibi eğitime özgü davranışları etkinleştirir.model.eval(): Modeli değerlendirme moduna alır; dropout’u devre dışı bırakır ve tahminler için ağın tamamını kullanır.Test doğruluğunu hesaplayalım:
accuracy_with_dropout = evaluate_model(model_with_dropout, test_loader, criterion)
print(f'Accuracy of the model with dropout on the test images: {accuracy_with_dropout:.2f}%')
Elde edilen doğruluk aşağıdaki gibidir:
Çıktı: Test görüntülerindeki doğruluk.
%99,12 doğruluk elde ediyoruz; dropout olmayan modele kıyasla biraz daha iyi.
Eğitim, doğrulama ve değerlendirme aşamalarında tüm metrikleri sakladığımıza göre, bunları daha iyi analiz etmek için Matplotlib kullanarak grafiğe dökelim.
Bunun için kullanılacak kod aşağıdaki gibidir:
# Plotting the Results
plt.figure(figsize=(14, 10))

# Plot training loss
plt.subplot(2, 2, 1)
plt.plot(train_losses_without_dropout, label='Without Dropout')
plt.plot(train_losses_with_dropout, label='With Dropout')
plt.title('Training Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot validation loss
plt.subplot(2, 2, 2)
plt.plot(val_losses_without_dropout, label='Without Dropout')
plt.plot(val_losses_with_dropout, label='With Dropout')
plt.title('Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot training accuracy
plt.subplot(2, 2, 3)
plt.plot(train_accuracies_without_dropout, label='Without Dropout')
plt.plot(train_accuracies_with_dropout, label='With Dropout')
plt.title('Training Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

# Plot validation accuracy
plt.subplot(2, 2, 4)
plt.plot(val_accuracies_without_dropout, label='Without Dropout')
plt.plot(val_accuracies_with_dropout, label='With Dropout')
plt.title('Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

plt.tight_layout()
plt.show()
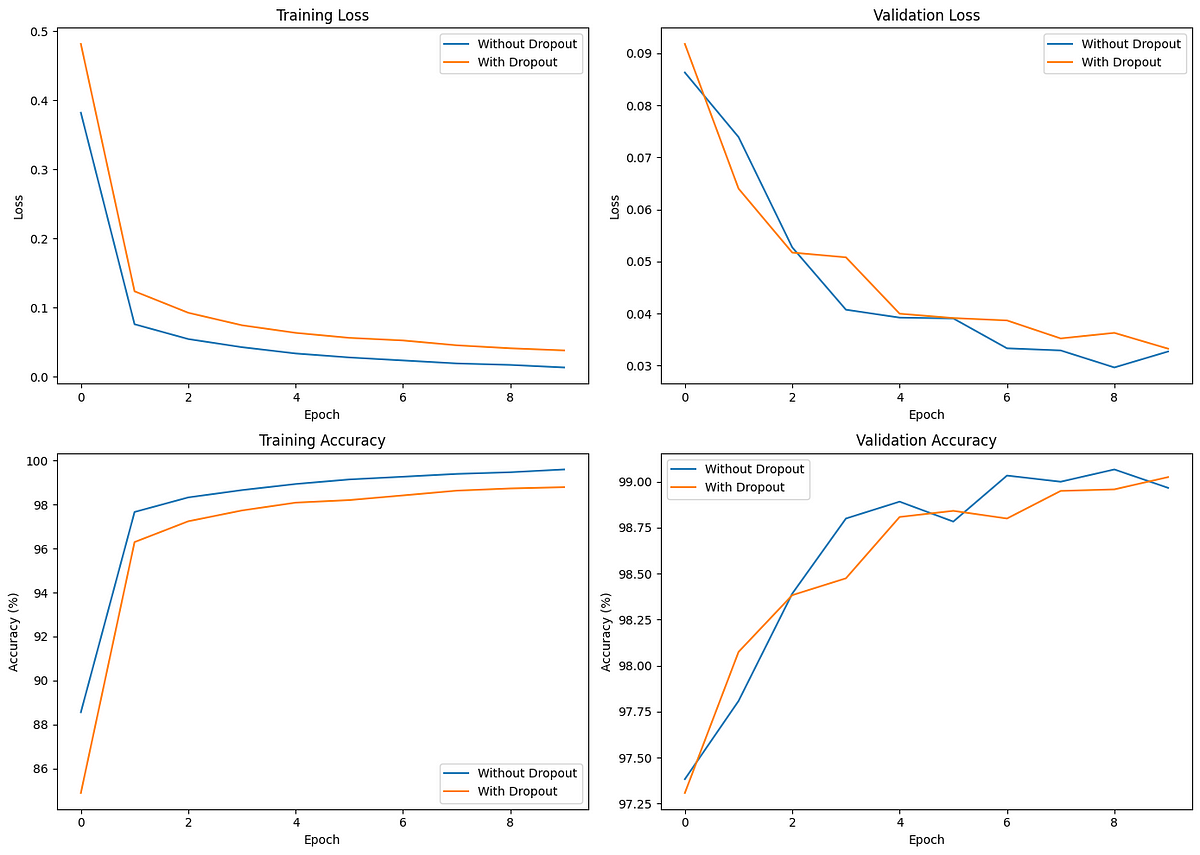
Karşılaştırma grafikleri aşağıdaki gibidir:
Eğitim ve doğrulama üzerinde dropout etkisinin karşılaştırılması.
Başlangıçtaki eğitim kaybı, dropout olmayan model için daha düşüktür; bu da daha hızlı yakınsamaya işaret eder. Ancak dropout’lu model, daha tutarlı doğrulama kaybı ve doğruluğu göstererek daha iyi genelleme sağlar.
Bu grafikleri incelerken, dropout’lu modelin, dropout olmayan modele kıyasla daha düşük eğitim doğruluğuna sahip olmasına rağmen biraz daha yüksek doğrulama doğruluğu (ve test doğruluğu) elde ettiğini görüyoruz.
Dropout, eğitim ve doğrulama performansı arasındaki farkın daha küçük olmasından da görüldüğü üzere, aşırı uyumu önlemeye yardımcı olur. Bizim örneğimizde fark önemsiz görünse de, daha karmaşık ve büyük modeller eğitilirken giderek daha kritik hale gelir.
Dropout kullanarak derin öğrenme modelleri eğitirken işinize yarayacak bazı ipuçları:
Bir derin öğrenme uygulayıcısıysanız, özgün “Improving Neural Networks by Preventing Co-adaptation of Feature Detectors” araştırma makalesini okumanız faydalı olacaktır. Yazarlar, deneylerine dayanan çeşitli ek yararlı yönergeleri burada tartışmaktadır.
Eğitim verisine aşırı uyum, özellikle daha yüksek yinelemelerle eğitilen daha büyük modellerde sinir ağlarında yaygın bir sorundur. Dropout gibi düzenlileştirme teknikleri, sinir ağlarının eğitim verisini ezberlemesini engeller ve verideki yararlı desenleri daha iyi öğrenmelerine yardımcı olur.
Bu öğretici, dropout düzenlileştirme kavramını tanıttı, neden ihtiyaç duyduğumuzu açıkladı ve bir örnek kullanım üzerinden PyTorch ile nasıl uygulanacağını gösterdi. Ayrıca derin sinir ağlarında dropout’u etkili kullanmaya yönelik bazı gelişmiş en iyi uygulamaları ve ipuçlarını öğrendik.
PyTorch’u derin öğrenme görevlerinde kullanmayı daha fazla öğrenmek için, yeni başlayanlar için uygun Introduction to Deep Learning with PyTorch kursuna ve ardından Intermediate Deep Learning with PyTorch kursuna göz atın.
DataCamp ile PyTorch Öğrenin
Kurs
Program
Program
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




