


Corso
Python - Livello Intermedio
4 ore
1.4M
La regolarizzazione con dropout è una tecnica usata nelle reti neurali per prevenire l’overfitting, che si verifica quando un modello impara il rumore nei dati di training invece del reale pattern.
Nel 2012 Geoffrey Hinton (premio Turing) e i suoi colleghi hanno introdotto la tecnica in un articolo di ricerca, e da allora è stata ampiamente adottata per addestrare modelli di deep learning.
Questo tutorial introdurrà il concetto di regolarizzazione con dropout, ribadirà perché ci serve e presenterà le funzioni che aiutano a implementarlo in PyTorch. Imparerai anche i dettagli d’implementazione attraverso esempi pratici, con consigli avanzati per usare il dropout in modo efficace nei tuoi futuri progetti di deep learning.
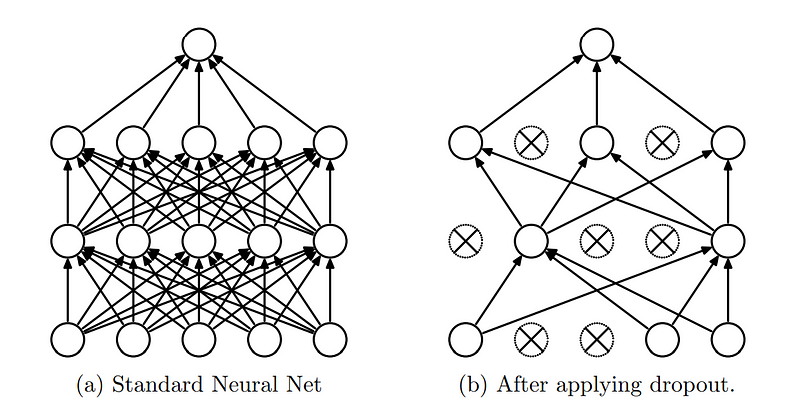
L’idea alla base del dropout è “disattivare” a caso (impostare a zero) una frazione dei neuroni della rete durante la fase di training. Ciò significa che una certa percentuale di neuroni viene ignorata o “eliminata” a ogni passaggio forward e backward, rendendo l’architettura della rete dinamicamente diversa per ciascun batch di training.
Regolarizzazione con dropout. (Fonte)
Il layer di dropout è diventato essenziale nelle reti neurali per i benefici che offre:
Ora che abbiamo capito il concetto di dropout, passiamo alla sua implementazione.
Librerie di deep learning popolari come Tensorflow e PyTorch offrono moduli e funzioni semplificate, quindi implementare la regolarizzazione con dropout nei modelli di reti neurali è immediato.
Come suggerisce il titolo, questo tutorial è incentrato sull’implementazione del dropout in PyTorch, ma se preferisci farlo in Tensorflow, le istruzioni sono disponibili nella documentazione ufficiale di Tensorflow.
PyTorch è una libreria open source per il machine learning sviluppata dal laboratorio di ricerca sull’IA di Facebook (ora Meta), FAIR, ampiamente usata per applicazioni di deep learning e intelligenza artificiale. In PyTorch, il dropout può essere implementato usando la torch.nn.Dropout Class.
La sintassi della Classe torch.nn.Dropout è la seguente:
torch.nn.Dropout(p=0.5, inplace=False)Dove:
In questa funzione, durante il training, il layer Dropout azzera casualmente alcuni elementi del tensore di input con probabilità p. Gli elementi azzerati sono scelti in modo indipendente a ogni chiamata forward e sono campionati da una distribuzione di Bernoulli. Ogni canale viene azzerato indipendentemente a ogni chiamata forward.
Durante la valutazione, il layer di dropout è disattivato, cioè il layer calcola una funzione identità. Questo assicura che tutti i neuroni siano attivi e non venga applicato alcun scaling.
Avendo compreso come funziona la regolarizzazione con dropout e la funzione usata in PyTorch, mettiamo tutto insieme con un esempio pratico.
Useremo il popolare dataset MNIST e costruiremo una semplice rete neurale convoluzionale per riconoscere cifre scritte a mano da immagini. Poi impareremo ad aggiungere layer di dropout alla rete neurale ed esamineremo il suo impatto.
Per prima cosa, se non hai installato Python, trovi le istruzioni di installazione sul sito ufficiale di Python. Una volta installato Python, puoi usare il gestore pacchetti pip per installare le librerie PyTorch.
Apri il terminale ed esegui il seguente comando:
pip install torch torchvisionNota che le librerie PyTorch dipendono dal tuo ambiente e dalla versione di CUDA. La documentazione ufficiale d’installazione fornisce istruzioni chiare in base alla tua configurazione.
Se hai fretta di testare il codice e preferisci saltare la configurazione dell’ambiente, puoi aprire un nuovo notebook Google Collab con PyTorch preinstallato per passare subito alla pratica.
Dato che il dataset MNIST (Modified National Institute of Standards and Technology) è disponibile direttamente nella libreria PyTorch, non dobbiamo scaricarlo altrove.
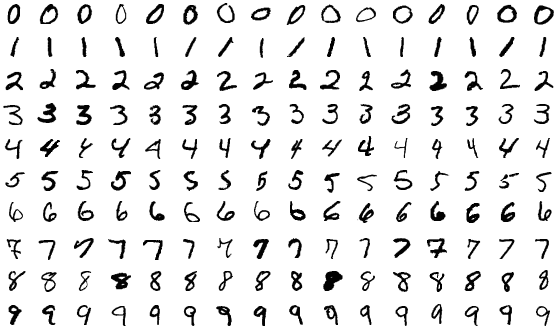
MNIST è una grande raccolta di cifre scritte a mano comunemente usata per addestrare e testare. Consiste di 70.000 immagini in scala di grigi di cifre (0–9), suddivise in 60.000 immagini di training e 10.000 di test. Ogni immagine è etichettata con la cifra che rappresenta, rendendolo un dataset di apprendimento supervisionato.
Il dataset MNIST.
Carichiamo le librerie rilevanti e leggiamo il dataset.
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader, random_split
import matplotlib.pyplot as plt

# Transformation to normalize the data
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# Loading the MNIST dataset
full_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)

# Splitting the dataset into training and validation sets
train_size = int(0.8 * len(full_dataset))
val_size = len(full_dataset) - train_size
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])

train_loader = DataLoader(dataset=train_dataset, batch_size=100, shuffle=True)
val_loader = DataLoader(dataset=val_dataset, batch_size=100, shuffle=False)
test_loader = DataLoader(dataset=test_dataset, batch_size=100, shuffle=False)
In questo esempio, il 20% delle immagini di training è stato separato per la validazione. Ora controlliamo le dimensioni dei dataset:
# Inspecting the train dataset
train_data_iter = iter(train_loader)
train_images, train_labels = next(train_data_iter)
print(f"Train Images Shape: {train_images.shape}")
print(f"Train Labels Shape: {train_labels.shape}")
print("-----------------------------------------")

# Inspecting the val dataset
val_data_iter = iter(val_loader)
val_images, val_labels = next(val_data_iter)
print(f"Validation Images Shape: {val_images.shape}")
print(f"Validation Labels Shape: {val_labels.shape}")
print("-----------------------------------------")

# Inspecting the test dataset
test_data_iter = iter(test_loader)
test_images, test_labels = next(test_data_iter)
print(f"Test Images Shape: {test_images.shape}")
print(f"Test Labels Shape: {test_labels.shape}")
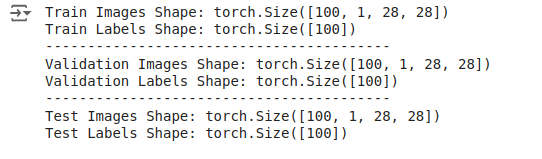
L’output è il seguente:
Output: le dimensioni del dataset.
Questi output indicano che i batch contengono 100 immagini, ciascuna con un canale e dimensioni 28x28 pixel. Le etichette sono semplicemente un tensore 1D di dimensione 100, corrispondente alle etichette di ciascuna immagine nel batch.
Dopo aver caricato e trasformato i dati, definiamo un semplice modello di rete neurale convoluzionale; il primo è il modello che non usa il dropout.
# Define the CNN Without Dropout
class CNNWithoutDropout(nn.Module):
   def __init__(self):
       super(CNNWithoutDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = torch.relu(self.fc1(x))
       x = self.fc2(x)
       return x

model_without_dropout = CNNWithoutDropout()
Dopo la definizione del modello, definiamo l’ottimizzatore e la funzione di loss.
criterion = nn.CrossEntropyLoss()
optimizer_without_dropout = optim.SGD(model_without_dropout.parameters(), lr=0.01, momentum=0.9)Ora addestriamo il modello senza dropout, registrando le metriche di training e validazione. Scriviamo il codice come funzioni così da poterlo riutilizzare più tardi.
def train_validate_model(model, train_loader, val_loader, criterion, optimizer, num_epochs=10):
   train_losses = []
   val_losses = []
   train_accuracies = []
   val_accuracies = []

   for epoch in range(num_epochs):
       model.train()
       running_loss = 0.0
       correct = 0
       total = 0

       for images, labels in train_loader:
           outputs = model(images)
           loss = criterion(outputs, labels)

           optimizer.zero_grad()
           loss.backward()
           optimizer.step()

           running_loss += loss.item()
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

       epoch_loss = running_loss / len(train_loader)
       epoch_accuracy = 100 * correct / total
       train_losses.append(epoch_loss)
       train_accuracies.append(epoch_accuracy)

       # Validation Phase
       model.eval()
       val_loss = 0.0
       correct = 0
       total = 0

       with torch.no_grad():
           for images, labels in val_loader:
               outputs = model(images)
               loss = criterion(outputs, labels)
               val_loss += loss.item()
               _, predicted = torch.max(outputs.data, 1)
               total += labels.size(0)
               correct += (predicted == labels).sum().item()

       val_loss /= len(val_loader)
       val_accuracy = 100 * correct / total
       val_losses.append(val_loss)
       val_accuracies.append(val_accuracy)

       print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {epoch_loss:.4f}, Accuracy: {epoch_accuracy:.2f}%, Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2f}%')
   return train_losses, val_losses, train_accuracies, val_accuracies
Ora possiamo chiamare questa funzione con i dataset di training e validazione.
train_losses_without_dropout, val_losses_without_dropout, train_accuracies_without_dropout, val_accuracies_without_dropout = train_validate_model(
   model_without_dropout, train_loader, val_loader, criterion, optimizer_without_dropout
)
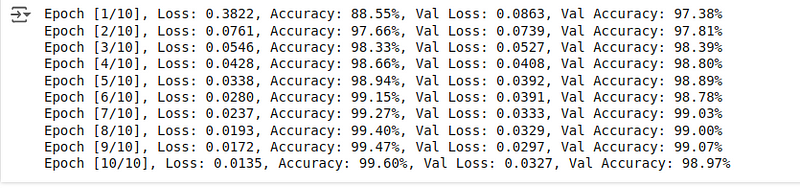
Vedrai le metriche di training e validazione qui sotto:
Output: metriche di training e validazione.
La validation accuracy è leggermente inferiore alla training accuracy. Anche senza dropout, il modello si comporta molto bene nelle fasi di training e validazione, mostrando un’alta accuratezza su entrambi i set.
Una volta completato l’addestramento, possiamo valutare come il modello si comporta sulle immagini di test per ottenere l’accuracy di test, che funge da baseline prima di aggiungere i layer di dropout.
def evaluate_model(model, test_loader, criterion):
   model.eval()
   correct = 0
   total = 0

   with torch.no_grad():
       for images, labels in test_loader:
           outputs = model(images)
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

   accuracy = 100 * correct / total
   return accuracy

accuracy_without_dropout = evaluate_model(model_without_dropout, test_loader, criterion)
print(f'Accuracy of the model without dropout on the test images: {accuracy_without_dropout:.2f}%')
L’accuracy finale risultante è:
Output: accuratezza sulle immagini di test.
Il 99,07% di accuratezza è estremamente buono, leggermente inferiore alla training accuracy ma migliore della validation accuracy. Vediamo come si comporta il modello quando aggiungiamo i layer di dropout, che rendono più difficile apprendere le cifre scritte a mano.
Ora sappiamo come definire, addestrare e valutare una semplice rete neurale. Ripetiamo la procedura partendo dalla definizione del modello e aggiungendo un layer di dropout.
# Define the CNN With Dropout
class CNNWithDropout(nn.Module):
   def __init__(self):
       super(CNNWithDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.dropout = nn.Dropout(p=0.5)  # Dropout layer with 50% probability
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = self.dropout(torch.relu(self.fc1(x)))  # Apply dropout after ReLU activation
       x = self.fc2(x)
       return x

model_with_dropout = CNNWithDropout()
Nota la modifica al codice: sono state aggiunte due nuove righe che introducono i layer di dropout nella definizione del modello. Sì, aggiungere i layer di dropout è semplice come poche righe di codice usando la funzione appropriata disponibile in PyTorch.
Manteniamo la funzione di loss e l’ottimizzatore uguali a quelli del modello di base.
criterion = nn.CrossEntropyLoss()
optimizer_with_dropout = optim.SGD(model_with_dropout.parameters(), lr=0.01, momentum=0.9)Ora addestriamo il modello con dropout riutilizzando le funzioni scritte in precedenza e registrando le metriche di training e validazione.
train_losses_with_dropout, val_losses_with_dropout, train_accuracies_with_dropout, val_accuracies_with_dropout = train_validate_model(
   model_with_dropout, train_loader, val_loader, criterion, optimizer_with_dropout
)
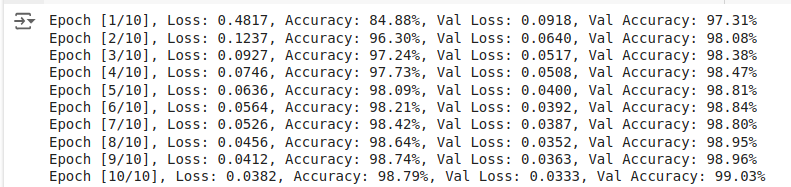
Le metriche di training e validazione risultanti sono:
Output: metriche di training e validazione.
Rispetto al modello con dropout, il modello senza dropout ottiene una training accuracy più alta e una training loss più bassa, come previsto, perché il dropout introduce rumore durante il training, rendendo più difficile per il modello adattarsi perfettamente ai dati di training.
Nonostante la riduzione dei punteggi in training, la validation accuracy del modello con dropout è aumentata.
Durante le fasi di valutazione (inclusa la validazione), i layer di dropout sono disattivati. Significa che tutte le unità sono attive e nessun input viene eliminato.
In PyTorch, il passaggio tra modalità training e valutazione si effettua usando rispettivamente model.train() e model.eval():
model.train(): imposta il modello in modalità training, attivando il dropout e altri comportamenti specifici del training come la batch normalization.model.eval(): imposta il modello in modalità valutazione, disattivando il dropout e usando l’intera rete per le predizioni.Calcoliamo l’accuracy di test:
accuracy_with_dropout = evaluate_model(model_with_dropout, test_loader, criterion)
print(f'Accuracy of the model with dropout on the test images: {accuracy_with_dropout:.2f}%')
L’accuracy risultante è la seguente:
Output: accuratezza sulle immagini di test.
Otteniamo un’accuracy del 99,12%, leggermente migliore di quella del modello senza dropout.
Dal momento che abbiamo salvato tutte le metriche durante le fasi di training, validazione e valutazione, tracciamole in grafici con Matplotlib per analizzarle meglio.
Il codice è il seguente:
# Plotting the Results
plt.figure(figsize=(14, 10))

# Plot training loss
plt.subplot(2, 2, 1)
plt.plot(train_losses_without_dropout, label='Without Dropout')
plt.plot(train_losses_with_dropout, label='With Dropout')
plt.title('Training Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot validation loss
plt.subplot(2, 2, 2)
plt.plot(val_losses_without_dropout, label='Without Dropout')
plt.plot(val_losses_with_dropout, label='With Dropout')
plt.title('Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot training accuracy
plt.subplot(2, 2, 3)
plt.plot(train_accuracies_without_dropout, label='Without Dropout')
plt.plot(train_accuracies_with_dropout, label='With Dropout')
plt.title('Training Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

# Plot validation accuracy
plt.subplot(2, 2, 4)
plt.plot(val_accuracies_without_dropout, label='Without Dropout')
plt.plot(val_accuracies_with_dropout, label='With Dropout')
plt.title('Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

plt.tight_layout()
plt.show()
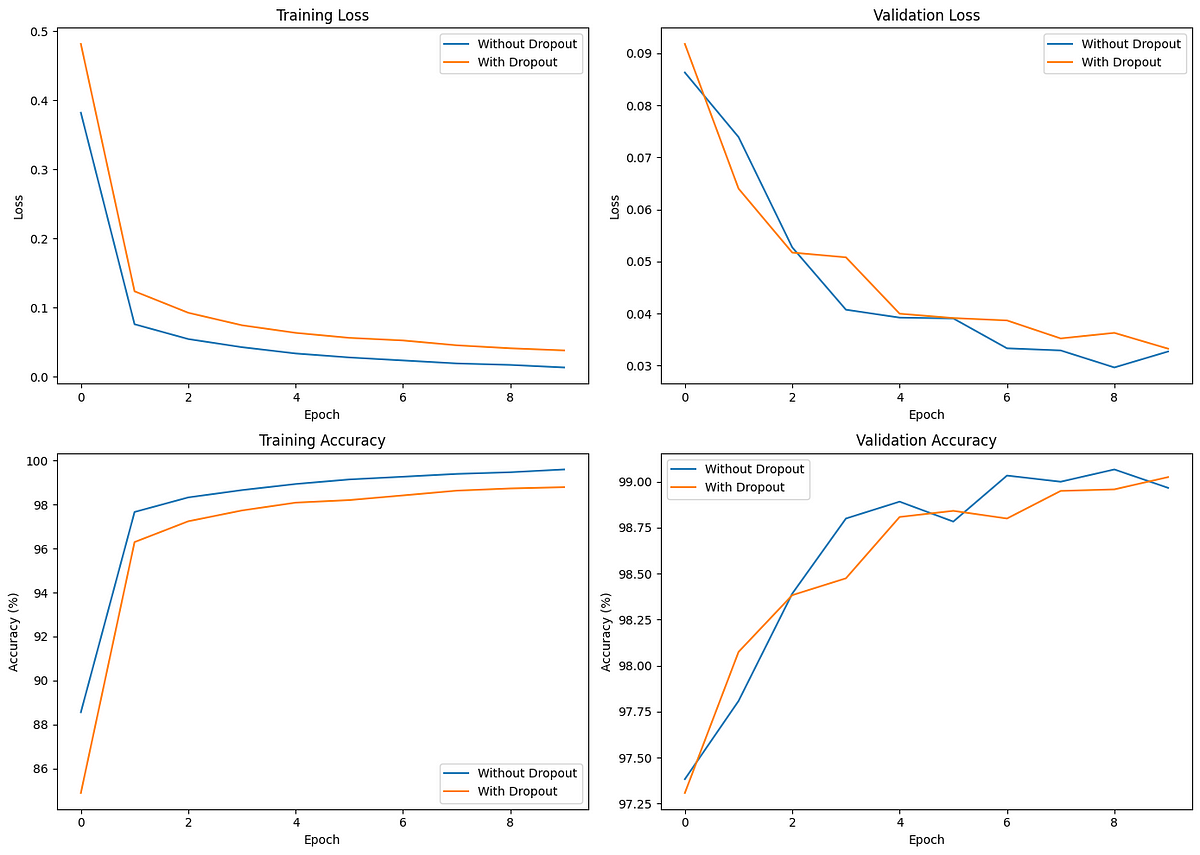
I grafici di confronto sono i seguenti:
Confronto dell’effetto del dropout su training e validazione.
La training loss iniziale è più bassa per il modello senza dropout, indicando una convergenza più rapida. Tuttavia, il modello con dropout mostra una loss e un’accuracy di validazione più consistenti, segno di una migliore generalizzazione.
Analizzando questi grafici, il modello con dropout ottiene una validation accuracy (e test accuracy) leggermente superiore rispetto al modello senza dropout, nonostante abbia una training accuracy inferiore.
Il dropout aiuta a prevenire l’overfitting, come mostra il divario minore tra prestazioni in training e validazione. Anche se nel nostro esempio la differenza è minima, diventa sempre più cruciale quando si addestrano modelli più complessi e di maggiori dimensioni.
Ecco alcuni consigli utili quando addestri modelli di deep learning usando il Dropout:
Se pratichi il deep learning, vale la pena leggere l’articolo originale “Improving Neural Networks by Preventing Co-adaptation of Feature Detectors.” Gli autori vi discutono ulteriori linee guida utili basate sui loro esperimenti.
L’overfitting dei dati di training è un problema comune nelle reti neurali, soprattutto nei modelli più grandi addestrati per più iterazioni. Le tecniche di regolarizzazione, come il dropout, impediscono alle reti neurali di memorizzare i dati di training e le aiutano a imparare meglio i pattern utili presenti nei dati.
Questo tutorial ha introdotto il concetto di regolarizzazione con dropout, spiegato perché serve e l’ha implementato in PyTorch attraverso un caso d’uso. Abbiamo anche visto alcune buone pratiche e consigli avanzati per usare efficacemente il dropout nelle reti neurali profonde.
Per saperne di più sull’uso di PyTorch nei task di deep learning, dai un’occhiata al corso per principianti Introduction to Deep Learning with PyTorch e al corso Intermediate Deep Learning with PyTorch, in quest’ordine.
Impara PyTorch con DataCamp
Corso
Programma
Programma
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



