


Khóa học
Python nâng cao
4 giờ
1.4M
Chuẩn hóa dropout là một kỹ thuật dùng trong mạng nơ-ron để ngăn quá khớp (overfitting), hiện tượng xảy ra khi mô hình học cả nhiễu trong dữ liệu huấn luyện thay vì mẫu hình thực sự.
Năm 2012, Geoffrey Hinton (người nhận giải Turing) và các cộng sự đã giới thiệu kỹ thuật này trong một bài báo nghiên cứu, và kể từ đó nó đã được ứng dụng rộng rãi để huấn luyện các mô hình học sâu.
Hướng dẫn này sẽ giới thiệu khái niệm chuẩn hóa dropout, nhấn mạnh vì sao chúng ta cần nó, và giới thiệu các hàm hỗ trợ triển khai trong PyTorch. Bạn cũng sẽ học các chi tiết triển khai qua ví dụ thực hành, kèm các mẹo nâng cao để dùng dropout hiệu quả trong các dự án học sâu về sau.
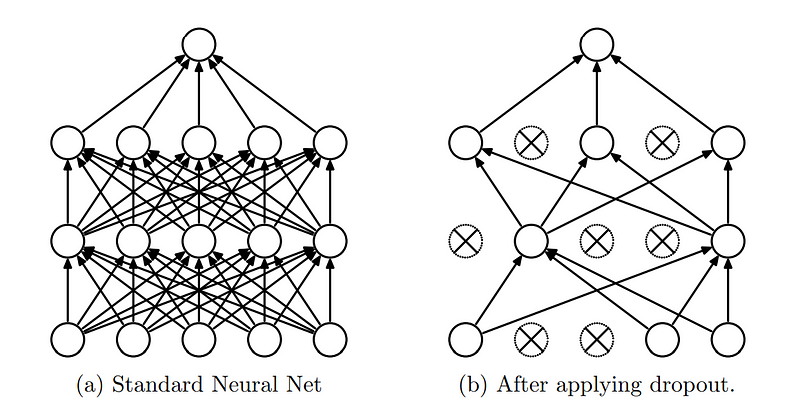
Ý tưởng cốt lõi của dropout là ngẫu nhiên “loại bỏ” (gán bằng không) một phần nơ-ron trong mạng trong giai đoạn huấn luyện. Điều này có nghĩa là một tỷ lệ nơ-ron nhất định bị bỏ qua hay “dropout” trong mỗi lần lan truyền xuôi và ngược, khiến kiến trúc mạng thay đổi linh hoạt theo từng batch huấn luyện.
Chuẩn hóa dropout. (Nguồn)
Lớp dropout đã trở thành một lớp thiết yếu trong mạng nơ-ron nhờ các lợi ích sau:
Vì đã nắm khái niệm dropout, hãy đi sâu vào cách triển khai.
Các thư viện học sâu phổ biến như Tensorflow và PyTorch đã cung cấp các mô-đun và hàm đơn giản, giúp triển khai chuẩn hóa dropout trong các mô hình mạng nơ-ron trở nên dễ dàng.
Đúng như tiêu đề, hướng dẫn này tập trung triển khai chuẩn hóa dropout bằng PyTorch, nhưng nếu bạn muốn làm với Tensorflow, hướng dẫn có sẵn trong tài liệu chính thức của Tensorflow.
PyTorch là thư viện máy học mã nguồn mở do Phòng nghiên cứu AI của Facebook (nay là Meta) phát triển, được dùng rộng rãi cho học sâu và ứng dụng trí tuệ nhân tạo. Trong PyTorch, có thể triển khai dropout bằng torch.nn.Dropout Class.
Cú pháp của lớp torch.nn.Dropout như sau:
torch.nn.Dropout(p=0.5, inplace=False)Trong đó:
Trong hàm này, khi huấn luyện, lớp Dropout sẽ ngẫu nhiên đặt về 0 một số phần tử của tensor đầu vào với xác suất p. Các phần tử bị đặt về 0 được chọn độc lập trong mỗi lần gọi forward và được lấy mẫu từ phân phối Bernoulli. Mỗi kênh được đưa về 0 độc lập trong mọi lần gọi forward.
Khi đánh giá, lớp dropout bị tắt, nghĩa là lớp thực hiện hàm đồng nhất. Điều này đảm bảo tất cả nơ-ron đều hoạt động và không có phép co giãn nào được áp dụng.
Vì đã hiểu cách hoạt động của chuẩn hóa dropout và hàm dùng trong PyTorch, hãy tổng hợp lại qua một ví dụ thực hành.
Chúng ta sẽ dùng bộ dữ liệu MNIST nổi tiếng và xây dựng một mạng nơ-ron tích chập đơn giản để nhận dạng chữ số viết tay từ ảnh. Sau đó, ta sẽ học cách thêm các lớp dropout vào mạng và xem xét tác động của chúng.
Trước hết, nếu bạn chưa cài Python, hướng dẫn cài đặt có tại trang web chính thức của Python. Sau khi cài Python, bạn có thể dùng trình quản lý gói pip để cài đặt các thư viện PyTorch.
Mở terminal và chạy lệnh sau:
pip install torch torchvisionLưu ý rằng các thư viện PyTorch phụ thuộc vào môi trường và phiên bản CUDA của bạn. Tài liệu cài đặt chính thức cung cấp hướng dẫn rõ ràng dựa trên cấu hình môi trường của bạn.
Nếu bạn muốn thử mã ngay và bỏ qua bước thiết lập môi trường, bạn có thể mở một sổ tay Google Collab mới với PyTorch đã được cài sẵn để bắt tay thực hành ngay.
Vì bộ dữ liệu MNIST (Modified National Institute of Standards and Technology) có sẵn trực tiếp trong thư viện PyTorch, chúng ta không cần tải ở nơi khác.
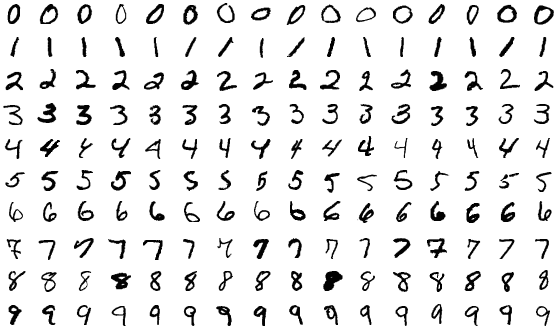
MNIST là tập dữ liệu lớn gồm các chữ số viết tay, thường dùng để huấn luyện và kiểm thử. Nó gồm 70.000 ảnh thang xám của các chữ số (0–9), chia thành 60.000 ảnh huấn luyện và 10.000 ảnh kiểm thử. Mỗi ảnh có nhãn là chữ số tương ứng, nên đây là tập dữ liệu học có giám sát.
Bộ dữ liệu MNIST.
Chúng ta sẽ nạp các thư viện liên quan và đọc bộ dữ liệu.
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader, random_split
import matplotlib.pyplot as plt

# Transformation to normalize the data
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# Loading the MNIST dataset
full_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)

# Splitting the dataset into training and validation sets
train_size = int(0.8 * len(full_dataset))
val_size = len(full_dataset) - train_size
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])

train_loader = DataLoader(dataset=train_dataset, batch_size=100, shuffle=True)
val_loader = DataLoader(dataset=val_dataset, batch_size=100, shuffle=False)
test_loader = DataLoader(dataset=test_dataset, batch_size=100, shuffle=False)
Trong ví dụ này, 20% ảnh huấn luyện được tách làm ảnh xác thực. Tiếp theo, ta kiểm tra kích thước các tập dữ liệu:
# Inspecting the train dataset
train_data_iter = iter(train_loader)
train_images, train_labels = next(train_data_iter)
print(f"Train Images Shape: {train_images.shape}")
print(f"Train Labels Shape: {train_labels.shape}")
print("-----------------------------------------")

# Inspecting the val dataset
val_data_iter = iter(val_loader)
val_images, val_labels = next(val_data_iter)
print(f"Validation Images Shape: {val_images.shape}")
print(f"Validation Labels Shape: {val_labels.shape}")
print("-----------------------------------------")

# Inspecting the test dataset
test_data_iter = iter(test_loader)
test_images, test_labels = next(test_data_iter)
print(f"Test Images Shape: {test_images.shape}")
print(f"Test Labels Shape: {test_labels.shape}")
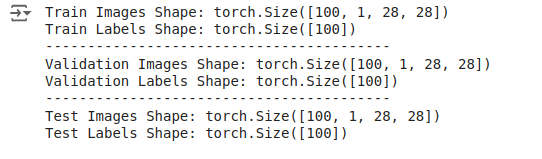
Chúng ta thấy đầu ra như sau:
Đầu ra: Kích thước của tập dữ liệu.
Các đầu ra này cho thấy mỗi batch gồm 100 ảnh, mỗi ảnh có một kênh và kích thước 28x28 pixel. Nhãn là tensor 1 chiều kích thước 100, tương ứng với nhãn của từng ảnh trong batch.
Sau khi tải và biến đổi dữ liệu, ta định nghĩa một mô hình CNN đơn giản, đầu tiên là mô hình không dùng dropout.
# Define the CNN Without Dropout
class CNNWithoutDropout(nn.Module):
   def __init__(self):
       super(CNNWithoutDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = torch.relu(self.fc1(x))
       x = self.fc2(x)
       return x

model_without_dropout = CNNWithoutDropout()
Sau khi định nghĩa mô hình, ta thiết lập bộ tối ưu và hàm mất mát.
criterion = nn.CrossEntropyLoss()
optimizer_without_dropout = optim.SGD(model_without_dropout.parameters(), lr=0.01, momentum=0.9)Tiếp theo, ta huấn luyện mô hình không có dropout, ghi nhận các chỉ số huấn luyện và xác thực. Hãy viết mã thành hàm để tái sử dụng sau.
def train_validate_model(model, train_loader, val_loader, criterion, optimizer, num_epochs=10):
   train_losses = []
   val_losses = []
   train_accuracies = []
   val_accuracies = []

   for epoch in range(num_epochs):
       model.train()
       running_loss = 0.0
       correct = 0
       total = 0

       for images, labels in train_loader:
           outputs = model(images)
           loss = criterion(outputs, labels)

           optimizer.zero_grad()
           loss.backward()
           optimizer.step()

           running_loss += loss.item()
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

       epoch_loss = running_loss / len(train_loader)
       epoch_accuracy = 100 * correct / total
       train_losses.append(epoch_loss)
       train_accuracies.append(epoch_accuracy)

       # Validation Phase
       model.eval()
       val_loss = 0.0
       correct = 0
       total = 0

       with torch.no_grad():
           for images, labels in val_loader:
               outputs = model(images)
               loss = criterion(outputs, labels)
               val_loss += loss.item()
               _, predicted = torch.max(outputs.data, 1)
               total += labels.size(0)
               correct += (predicted == labels).sum().item()

       val_loss /= len(val_loader)
       val_accuracy = 100 * correct / total
       val_losses.append(val_loss)
       val_accuracies.append(val_accuracy)

       print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {epoch_loss:.4f}, Accuracy: {epoch_accuracy:.2f}%, Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2f}%')
   return train_losses, val_losses, train_accuracies, val_accuracies
Giờ ta có thể gọi hàm này với tập huấn luyện và xác thực.
train_losses_without_dropout, val_losses_without_dropout, train_accuracies_without_dropout, val_accuracies_without_dropout = train_validate_model(
   model_without_dropout, train_loader, val_loader, criterion, optimizer_without_dropout
)
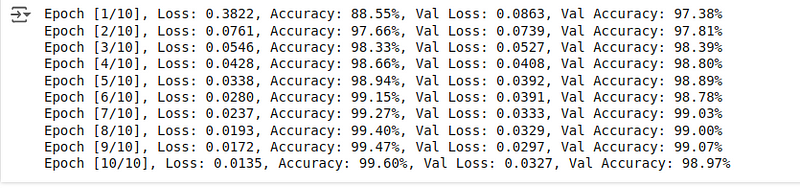
Bạn sẽ thấy các chỉ số huấn luyện và xác thực như bên dưới:
Đầu ra: Chỉ số huấn luyện và xác thực.
Độ chính xác trên tập xác thực thấp hơn một chút so với tập huấn luyện. Ngay cả khi không dùng dropout, mô hình vẫn hoạt động rất tốt trong giai đoạn huấn luyện và xác thực, thể hiện độ chính xác cao trên cả hai tập.
Sau khi huấn luyện xong, ta có thể đánh giá mô hình trên ảnh kiểm thử để lấy điểm độ chính xác, làm mốc nền tảng trước khi thêm các lớp dropout.
def evaluate_model(model, test_loader, criterion):
   model.eval()
   correct = 0
   total = 0

   with torch.no_grad():
       for images, labels in test_loader:
           outputs = model(images)
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

   accuracy = 100 * correct / total
   return accuracy

accuracy_without_dropout = evaluate_model(model_without_dropout, test_loader, criterion)
print(f'Accuracy of the model without dropout on the test images: {accuracy_without_dropout:.2f}%')
Độ chính xác cuối cùng thu được như sau:
Đầu ra: Độ chính xác trên ảnh kiểm thử.
Độ chính xác 99,07% là cực kỳ tốt, hơi thấp hơn độ chính xác huấn luyện nhưng cao hơn độ chính xác xác thực. Hãy xem mô hình thay đổi thế nào khi thêm các lớp dropout, vốn khiến việc học chữ số viết tay trở nên khó hơn.
Giờ chúng ta đã hiểu cách định nghĩa, huấn luyện và đánh giá một mạng nơ-ron đơn giản. Hãy lặp lại quy trình, bắt đầu từ định nghĩa mô hình và thêm một lớp dropout.
# Define the CNN With Dropout
class CNNWithDropout(nn.Module):
   def __init__(self):
       super(CNNWithDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.dropout = nn.Dropout(p=0.5)  # Dropout layer with 50% probability
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = self.dropout(torch.relu(self.fc1(x)))  # Apply dropout after ReLU activation
       x = self.fc2(x)
       return x

model_with_dropout = CNNWithDropout()
Lưu ý thay đổi trong mã: Hai dòng mới được thêm vào để bổ sung các lớp dropout vào định nghĩa mô hình. Đúng vậy, thêm lớp dropout chỉ đơn giản là vài dòng mã nhờ hàm sẵn có trong PyTorch.
Chúng ta giữ nguyên hàm mất mát và bộ tối ưu như mô hình nền tảng.
criterion = nn.CrossEntropyLoss()
optimizer_with_dropout = optim.SGD(model_with_dropout.parameters(), lr=0.01, momentum=0.9)Tiếp theo, ta huấn luyện mô hình có dropout bằng cách tái sử dụng các hàm đã viết và ghi nhận các chỉ số huấn luyện, xác thực.
train_losses_with_dropout, val_losses_with_dropout, train_accuracies_with_dropout, val_accuracies_with_dropout = train_validate_model(
   model_with_dropout, train_loader, val_loader, criterion, optimizer_with_dropout
)
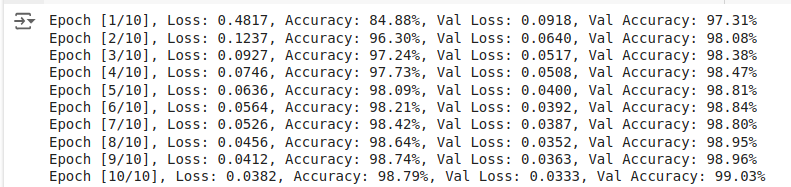
Các điểm số huấn luyện và xác thực thu được như sau:
Đầu ra: Chỉ số huấn luyện và xác thực.
So với mô hình có dropout, mô hình không dropout đạt độ chính xác huấn luyện cao hơn và mất mát huấn luyện thấp hơn, điều này dễ hiểu vì dropout đưa nhiễu vào quá trình huấn luyện, khiến mô hình khó khớp hoàn hảo với dữ liệu huấn luyện.
Dù điểm số huấn luyện giảm, độ chính xác xác thực của mô hình có dropout lại tăng.
Trong các giai đoạn đánh giá (bao gồm xác thực), các lớp dropout bị vô hiệu. Nghĩa là tất cả đơn vị đều hoạt động và không có đầu vào nào bị loại.
Trong PyTorch, chuyển đổi giữa chế độ huấn luyện và đánh giá được thực hiện bằng model.train() và model.eval(), tương ứng:
model.train(): Đặt mô hình sang chế độ huấn luyện, kích hoạt dropout và các hành vi đặc thù huấn luyện như batch normalization.model.eval(): Đặt mô hình sang chế độ đánh giá, vô hiệu dropout và dùng toàn bộ mạng để dự đoán.Hãy tính độ chính xác trên tập kiểm thử:
accuracy_with_dropout = evaluate_model(model_with_dropout, test_loader, criterion)
print(f'Accuracy of the model with dropout on the test images: {accuracy_with_dropout:.2f}%')
Độ chính xác thu được như sau:
Đầu ra: Độ chính xác trên ảnh kiểm thử.
Chúng ta đạt độ chính xác 99,12%, nhỉnh hơn một chút so với mô hình không dùng dropout.
Vì chúng ta đã lưu lại tất cả các chỉ số trong giai đoạn huấn luyện, xác thực và đánh giá, hãy vẽ chúng thành đồ thị bằng Matplotlib để phân tích rõ hơn.
Mã để thực hiện như sau:
# Plotting the Results
plt.figure(figsize=(14, 10))

# Plot training loss
plt.subplot(2, 2, 1)
plt.plot(train_losses_without_dropout, label='Without Dropout')
plt.plot(train_losses_with_dropout, label='With Dropout')
plt.title('Training Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot validation loss
plt.subplot(2, 2, 2)
plt.plot(val_losses_without_dropout, label='Without Dropout')
plt.plot(val_losses_with_dropout, label='With Dropout')
plt.title('Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot training accuracy
plt.subplot(2, 2, 3)
plt.plot(train_accuracies_without_dropout, label='Without Dropout')
plt.plot(train_accuracies_with_dropout, label='With Dropout')
plt.title('Training Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

# Plot validation accuracy
plt.subplot(2, 2, 4)
plt.plot(val_accuracies_without_dropout, label='Without Dropout')
plt.plot(val_accuracies_with_dropout, label='With Dropout')
plt.title('Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

plt.tight_layout()
plt.show()
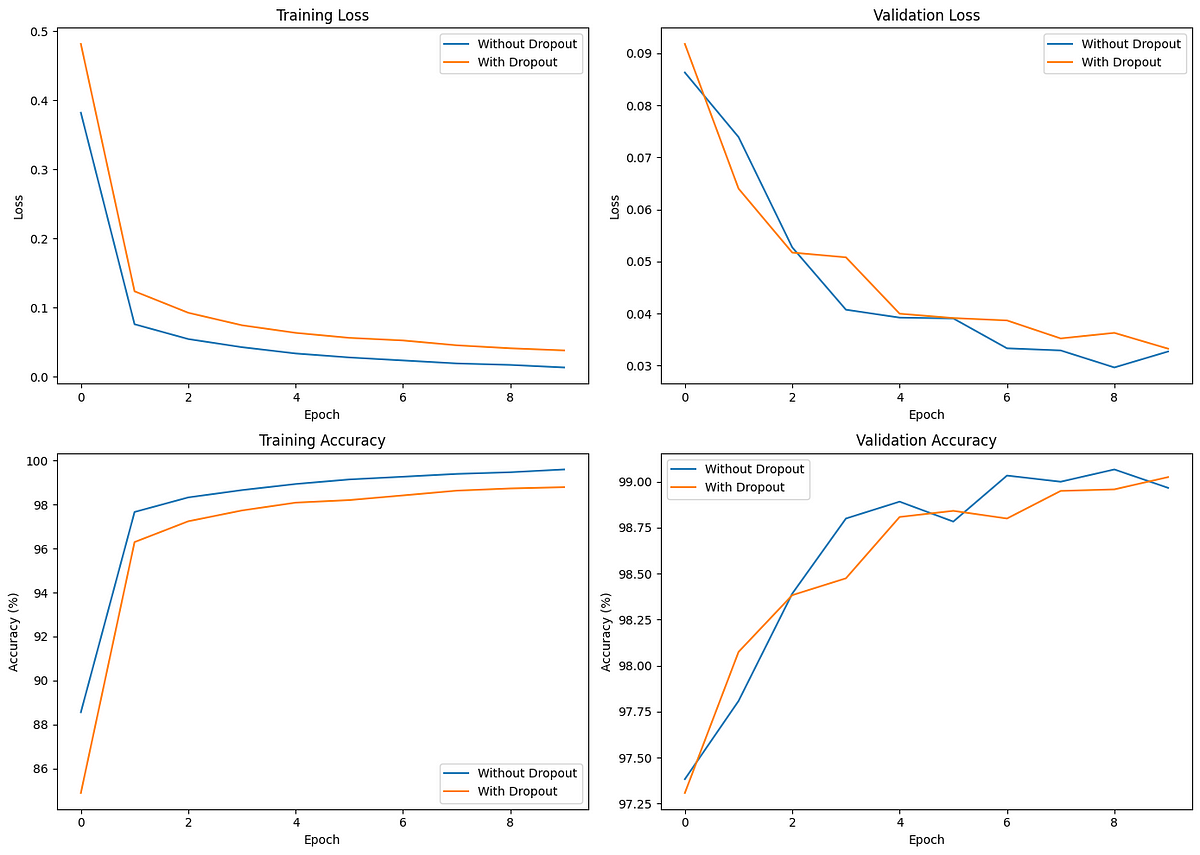
Các đồ thị so sánh như sau:
So sánh tác động của dropout lên huấn luyện và xác thực.
Mất mát huấn luyện ban đầu thấp hơn với mô hình không dropout, biểu thị hội tụ nhanh hơn. Tuy nhiên, mô hình có dropout cho thấy mất mát và độ chính xác xác thực ổn định hơn, thể hiện khả năng tổng quát hóa tốt hơn.
Khi phân tích các đồ thị này, mô hình có dropout đạt độ chính xác xác thực (và kiểm thử) nhỉnh hơn một chút so với mô hình không dropout, dù độ chính xác huấn luyện của mô hình có dropout thấp hơn.
Dropout giúp ngăn quá khớp, thể hiện qua khoảng cách nhỏ hơn giữa hiệu năng huấn luyện và xác thực. Dù trong ví dụ của chúng ta sự khác biệt không lớn, nhưng điều này càng quan trọng khi huấn luyện các mô hình phức tạp và lớn hơn.
Dưới đây là vài mẹo hữu ích khi bạn huấn luyện các mô hình học sâu với Dropout:
Nếu bạn là người thực hành học sâu, đáng để đọc bài báo gốc “Improving Neural Networks by Preventing Co-adaptation of Feature Detectors.” Trong đó, các tác giả thảo luận nhiều hướng dẫn hữu ích dựa trên thí nghiệm của họ.
Quá khớp dữ liệu huấn luyện là vấn đề phổ biến trong mạng nơ-ron, đặc biệt với các mô hình lớn huấn luyện trong nhiều vòng lặp. Các kỹ thuật chuẩn hóa như dropout giúp ngăn mạng nơ-ron ghi nhớ dữ liệu huấn luyện và giúp chúng học tốt hơn các mẫu hình hữu ích trong dữ liệu.
Hướng dẫn này đã giới thiệu khái niệm chuẩn hóa dropout, giải thích vì sao cần dùng, và triển khai nó bằng PyTorch qua một tình huống ví dụ. Chúng ta cũng học một số thực hành tốt và mẹo nâng cao để dùng dropout hiệu quả trong các mạng nơ-ron sâu.
Để học thêm về sử dụng PyTorch cho các tác vụ học sâu, hãy xem khóa học cho người mới bắt đầu Introduction to Deep Learning with PyTorch và khóa học Intermediate Deep Learning with PyTorch, theo thứ tự đó.
Học PyTorch cùng DataCamp
Khóa học
Lộ trình
Lộ trình
blog
Matt Crabtree
10 phút
