


कोर्स
इंटरमीडिएट Python
4 घंटा
1.4M
ड्रॉपआउट रेग्युलराइज़ेशन न्यूरल नेटवर्क में ओवरफिटिंग को रोकने के लिए उपयोग की जाने वाली तकनीक है। ओवरफिटिंग तब होता है जब मॉडल वास्तविक पैटर्न की जगह प्रशिक्षण डेटा के शोर को सीख लेता है।
2012 में, ज्योफ्री हिंटन (ट्यूरिंग अवॉर्ड विजेता) और उनके सहलेखकों ने इस तकनीक को एक शोध-पत्र में प्रस्तुत किया, और तब से यह डीप लर्निंग मॉडल्स को प्रशिक्षित करने के लिए व्यापक रूप से अपनाई गई है।
यह ट्यूटोरियल ड्रॉपआउट रेग्युलराइज़ेशन की अवधारणा बताएगा, इसकी आवश्यकता को मज़बूत करेगा, और PyTorch में इसे लागू करने में मदद करने वाले फ़ंक्शन्स का परिचय देगा। आप हैंड्स-ऑन उदाहरणों के माध्यम से इम्प्लीमेंटेशन विवरण भी सीखेंगे, साथ ही भविष्य की डीप लर्निंग परियोजनाओं में ड्रॉपआउट का प्रभावी उपयोग करने के लिए उन्नत टिप्स भी जानेंगे।
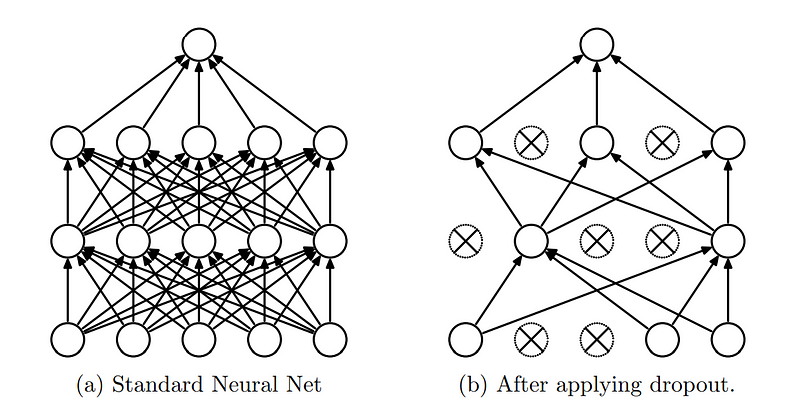
ड्रॉपआउट का मूल विचार यह है कि प्रशिक्षण चरण के दौरान नेटवर्क में कुछ न्यूरॉन्स को यादृच्छिक रूप से “ड्रॉप आउट” (शून्य पर सेट) कर दिया जाए। इसका अर्थ है कि प्रत्येक फॉरवर्ड और बैकवर्ड पास में एक निश्चित प्रतिशत न्यूरॉन्स को नज़रअंदाज़ किया जाता है या “ड्रॉप आउट” कर दिया जाता है, जिससे हर प्रशिक्षण बैच के लिए नेटवर्क की संरचना गतिशील रूप से भिन्न हो जाती है।
ड्रॉपआउट रेग्युलराइज़ेशन। (स्रोत)
ड्रॉपआउट लेयर इसके द्वारा मिलने वाले लाभों के कारण न्यूरल नेटवर्क्स में एक आवश्यक लेयर बन गया है:
अब जबकि हम ड्रॉपआउट की अवधारणा समझ गए हैं, आइए इसके इम्प्लीमेंटेशन में उतरते हैं।
Tensorflow Tensorflow और PyTorch जैसे लोकप्रिय डीप लर्निंग लाइब्रेरीज़ ने सरल मॉड्यूल्स और फ़ंक्शन्स उपलब्ध कराए हैं, जिससे न्यूरल नेटवर्क मॉडल्स में ड्रॉपआउट रेग्युलराइज़ेशन को लागू करना सीधा-सादा हो जाता है।
जैसा कि शीर्षक से स्पष्ट है, यह ट्यूटोरियल PyTorch का उपयोग करके ड्रॉपआउट रेग्युलराइज़ेशन को लागू करने पर केंद्रित है, पर यदि आप इसे Tensorflow में करना चाहें, तो निर्देश Tensorflow के आधिकारिक दस्तावेज़ में उपलब्ध हैं।
PyTorch एक ओपन-सोर्स मशीन लर्निंग लाइब्रेरी है, जिसे Facebook (अब Meta) की AI Research Lab (FAIR) ने विकसित किया है, और यह डीप लर्निंग व आर्टिफिशियल इंटेलिजेंस अनुप्रयोगों में व्यापक रूप से उपयोग होती है। PyTorch में ड्रॉपआउट को torch.nn.Dropout Class का उपयोग करके लागू किया जा सकता है।
torch.nn.Dropout क्लास का सिंटैक्स इस प्रकार है:
torch.nn.Dropout(p=0.5, inplace=False)जहाँ:
प्रशिक्षण के दौरान, इस फ़ंक्शन में Dropout लेयर इनपुट टेन्सर के कुछ तत्वों को संभावना p के साथ यादृच्छिक रूप से शून्य कर देती है। शून्य किए गए तत्व हर फॉरवर्ड कॉल के लिए स्वतंत्र रूप से चुने जाते हैं और बर्नौली वितरण से सैंपल होते हैं। हर फॉरवर्ड कॉल पर प्रत्येक चैनल को स्वतंत्र रूप से शून्य किया जाता है।
मूल्यांकन के दौरान, ड्रॉपआउट लेयर बंद रहती है, यानी लेयर एक आइडेंटिटी फ़ंक्शन की तरह काम करती है। इससे सुनिश्चित होता है कि सभी न्यूरॉन्स सक्रिय रहें और कोई स्केलिंग लागू न हो।
अब जब हमने समझ लिया है कि ड्रॉपआउट रेग्युलराइज़ेशन कैसे काम करता है और PyTorch में कौन-सा फ़ंक्शन उपयोग होता है, तो आइए इसे एक हैंड्स-ऑन उदाहरण से जोड़ते हैं।
हम लोकप्रिय MNIST डेटासेट लेंगे और तस्वीरों से हस्तलिखित अंकों का पता लगाने के लिए एक सरल कॉन्वोल्यूशनल न्यूरल नेटवर्क बनाएंगे। फिर हम नेटवर्क में ड्रॉपआउट लेयर्स जोड़ना सीखेंगे और इसके प्रभाव का परीक्षण करेंगे।
सबसे पहले, यदि आपने Python इंस्टॉल नहीं किया है, तो इंस्टॉलेशन निर्देश आधिकारिक Python वेबसाइट पर मिल सकते हैं। Python इंस्टॉल होने के बाद आप पैकेज मैनेजर pip का उपयोग करके PyTorch लाइब्रेरी इंस्टॉल कर सकते हैं।
अपने टर्मिनल को खोलें और निम्न कमांड चलाएँ:
pip install torch torchvisionकृपया ध्यान दें कि PyTorch लाइब्रेरी आपके एनवायरनमेंट और CUDA वर्ज़न पर निर्भर करती हैं। आधिकारिक इंस्टॉलेशन दस्तावेज़ आपके एनवायरनमेंट के अनुसार स्पष्ट इंस्टॉलेशन निर्देश प्रदान करता है।
यदि आप कोड्स को जल्दी आज़माना चाहते हैं और एनवायरनमेंट सेटअप छोड़ना पसंद करते हैं, तो आप नया Google Collab नोटबुक खोल सकते हैं जिसमें PyTorch पहले से इंस्टॉल होता है, और तुरंत हैंड्स-ऑन हो सकते हैं।
क्योंकि MNIST (Modified National Institute of Standards and Technology) डेटासेट PyTorch लाइब्रेरी में सीधे उपलब्ध है, हमें इसे कहीं और से डाउनलोड नहीं करना पड़ता।
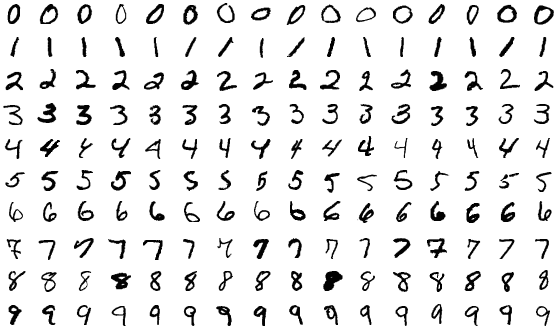
MNIST डेटासेट हस्तलिखित अंकों का बड़ा संग्रह है, जो सामान्यतः प्रशिक्षण और परीक्षण के लिए उपयोग होता है। इसमें 70,000 ग्रेस्केल इमेजेज़ (0–9) हैं, जिनमें 60,000 प्रशिक्षण और 10,000 परीक्षण इमेजेज़ शामिल हैं। प्रत्येक इमेज अपने संबंधित अंक के साथ लेबल की गई है, जिससे यह एक सुपरवाइज़्ड लर्निंग डेटासेट बनता है।
MNIST डेटासेट।
हम संबंधित लाइब्रेरीज़ लोड करेंगे और डेटासेट पढ़ेंगे।
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader, random_split
import matplotlib.pyplot as plt

# Transformation to normalize the data
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# Loading the MNIST dataset
full_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)

# Splitting the dataset into training and validation sets
train_size = int(0.8 * len(full_dataset))
val_size = len(full_dataset) - train_size
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])

train_loader = DataLoader(dataset=train_dataset, batch_size=100, shuffle=True)
val_loader = DataLoader(dataset=val_dataset, batch_size=100, shuffle=False)
test_loader = DataLoader(dataset=test_dataset, batch_size=100, shuffle=False)
इस उदाहरण में, प्रशिक्षण इमेजेज़ के 20% को वैलिडेशन इमेजेज़ में विभाजित किया गया है। अगला कदम डेटासेट्स के आयामों की जाँच करना है:
# Inspecting the train dataset
train_data_iter = iter(train_loader)
train_images, train_labels = next(train_data_iter)
print(f"Train Images Shape: {train_images.shape}")
print(f"Train Labels Shape: {train_labels.shape}")
print("-----------------------------------------")

# Inspecting the val dataset
val_data_iter = iter(val_loader)
val_images, val_labels = next(val_data_iter)
print(f"Validation Images Shape: {val_images.shape}")
print(f"Validation Labels Shape: {val_labels.shape}")
print("-----------------------------------------")

# Inspecting the test dataset
test_data_iter = iter(test_loader)
test_images, test_labels = next(test_data_iter)
print(f"Test Images Shape: {test_images.shape}")
print(f"Test Labels Shape: {test_labels.shape}")
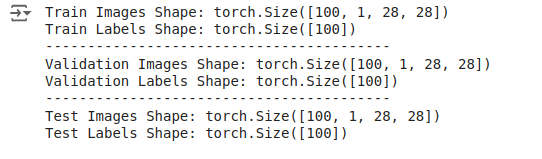
आउटपुट हमें इस प्रकार दिखाई देता है:
आउटपुट: डेटासेट के आयाम।
ये आउटपुट इंगित करते हैं कि बैचों में 100 इमेजेज़ होती हैं, प्रत्येक में एक चैनल और 28x28 पिक्सेल का आयाम होता है। लेबल 100 साइज का एक 1D टेन्सर है, जो बैच की प्रत्येक इमेज के लेबल के अनुरूप है।
डेटा लोड और ट्रांसफ़ॉर्म करने के बाद, हम एक सरल कॉन्वोल्यूशनल न्यूरल नेटवर्क मॉडल परिभाषित करते हैं — पहला मॉडल जिसमें ड्रॉपआउट का उपयोग नहीं किया गया है।
# Define the CNN Without Dropout
class CNNWithoutDropout(nn.Module):
   def __init__(self):
       super(CNNWithoutDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = torch.relu(self.fc1(x))
       x = self.fc2(x)
       return x

model_without_dropout = CNNWithoutDropout()
मॉडल परिभाषा के बाद, हम ऑप्टिमाइज़र और लॉस फ़ंक्शन परिभाषित करते हैं।
criterion = nn.CrossEntropyLoss()
optimizer_without_dropout = optim.SGD(model_without_dropout.parameters(), lr=0.01, momentum=0.9)अगला कदम ड्रॉपआउट के बिना मॉडल को प्रशिक्षित करना है, और प्रशिक्षण व वैलिडेशन मेट्रिक्स रिकॉर्ड करना है। चलिए कोड को फ़ंक्शन्स के रूप में लिखते हैं ताकि हम उन्हें बाद में पुनः उपयोग कर सकें।
def train_validate_model(model, train_loader, val_loader, criterion, optimizer, num_epochs=10):
   train_losses = []
   val_losses = []
   train_accuracies = []
   val_accuracies = []

   for epoch in range(num_epochs):
       model.train()
       running_loss = 0.0
       correct = 0
       total = 0

       for images, labels in train_loader:
           outputs = model(images)
           loss = criterion(outputs, labels)

           optimizer.zero_grad()
           loss.backward()
           optimizer.step()

           running_loss += loss.item()
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

       epoch_loss = running_loss / len(train_loader)
       epoch_accuracy = 100 * correct / total
       train_losses.append(epoch_loss)
       train_accuracies.append(epoch_accuracy)

       # Validation Phase
       model.eval()
       val_loss = 0.0
       correct = 0
       total = 0

       with torch.no_grad():
           for images, labels in val_loader:
               outputs = model(images)
               loss = criterion(outputs, labels)
               val_loss += loss.item()
               _, predicted = torch.max(outputs.data, 1)
               total += labels.size(0)
               correct += (predicted == labels).sum().item()

       val_loss /= len(val_loader)
       val_accuracy = 100 * correct / total
       val_losses.append(val_loss)
       val_accuracies.append(val_accuracy)

       print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {epoch_loss:.4f}, Accuracy: {epoch_accuracy:.2f}%, Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2f}%')
   return train_losses, val_losses, train_accuracies, val_accuracies
अब हम इस फ़ंक्शन को ट्रेन और वैलिडेशन डेटासेट्स के साथ कॉल कर सकते हैं।
train_losses_without_dropout, val_losses_without_dropout, train_accuracies_without_dropout, val_accuracies_without_dropout = train_validate_model(
   model_without_dropout, train_loader, val_loader, criterion, optimizer_without_dropout
)
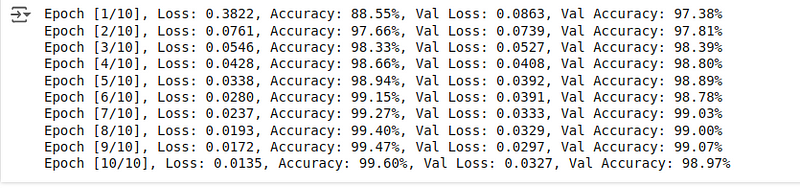
आप नीचे प्रशिक्षण और वैलिडेशन मेट्रिक्स देखेंगे:
आउटपुट: प्रशिक्षण और वैलिडेशन मेट्रिक्स।
वैलिडेशन एक्युरेसी प्रशिक्षण एक्युरेसी से थोड़ी कम है। ड्रॉपआउट के बिना भी, मॉडल प्रशिक्षण और वैलिडेशन दोनों चरणों में बहुत अच्छा प्रदर्शन करता है, और दोनों सेट्स पर उच्च एक्युरेसी दिखाता है।
प्रशिक्षण पूरा होने पर, हम टेस्ट इमेजेज़ पर मॉडल का प्रदर्शन जाँच सकते हैं ताकि टेस्ट एक्युरेसी स्कोर प्राप्त हो — जो ड्रॉपआउट लेयर जोड़ने से पहले हमारा बेसलाइन स्कोर होगा।
def evaluate_model(model, test_loader, criterion):
   model.eval()
   correct = 0
   total = 0

   with torch.no_grad():
       for images, labels in test_loader:
           outputs = model(images)
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

   accuracy = 100 * correct / total
   return accuracy

accuracy_without_dropout = evaluate_model(model_without_dropout, test_loader, criterion)
print(f'Accuracy of the model without dropout on the test images: {accuracy_without_dropout:.2f}%')
अंतिम एक्युरेसी हमें इस प्रकार मिलती है:
आउटपुट: टेस्ट इमेजेज़ पर एक्युरेसी।
99.07% एक्युरेसी अत्यंत उत्तम है, जो प्रशिक्षण एक्युरेसी से थोड़ी कम और वैलिडेशन एक्युरेसी से बेहतर है। आइए देखें कि जब हम ड्रॉपआउट लेयर्स जोड़ते हैं — जो हस्तलिखित अंकों को सीखना कठिन बनाती हैं — तो मॉडल का व्यवहार कैसा होता है।
अब हम समझ गए हैं कि एक सरल न्यूरल नेटवर्क को कैसे परिभाषित, प्रशिक्षित और मूल्यांकित किया जाए। आइए इसी प्रक्रिया को दोहराएँ, मॉडल परिभाषा से शुरू करते हुए और एक ड्रॉपआउट लेयर जोड़ते हुए।
# Define the CNN With Dropout
class CNNWithDropout(nn.Module):
   def __init__(self):
       super(CNNWithDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.dropout = nn.Dropout(p=0.5)  # Dropout layer with 50% probability
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = self.dropout(torch.relu(self.fc1(x)))  # Apply dropout after ReLU activation
       x = self.fc2(x)
       return x

model_with_dropout = CNNWithDropout()
कोड में बदलाव पर ध्यान दें: दो नई पंक्तियाँ जोड़ी गई हैं, जो मॉडल परिभाषा में ड्रॉपआउट लेयर्स जोड़ती हैं। हाँ, PyTorch में उपलब्ध संबंधित फ़ंक्शन का उपयोग करके ड्रॉपआउट लेयर्स जोड़ना कुछ ही पंक्तियों का काम है।
हम अपना लॉस फ़ंक्शन और ऑप्टिमाइज़र बेसलाइन मॉडल जैसा ही रखते हैं।
criterion = nn.CrossEntropyLoss()
optimizer_with_dropout = optim.SGD(model_with_dropout.parameters(), lr=0.01, momentum=0.9)अब हम पहले से लिखे गए फ़ंक्शन्स का पुनः उपयोग करते हुए ड्रॉपआउट वाले मॉडल को प्रशिक्षित करेंगे और प्रशिक्षण व वैलिडेशन मेट्रिक्स रिकॉर्ड करेंगे।
train_losses_with_dropout, val_losses_with_dropout, train_accuracies_with_dropout, val_accuracies_with_dropout = train_validate_model(
   model_with_dropout, train_loader, val_loader, criterion, optimizer_with_dropout
)
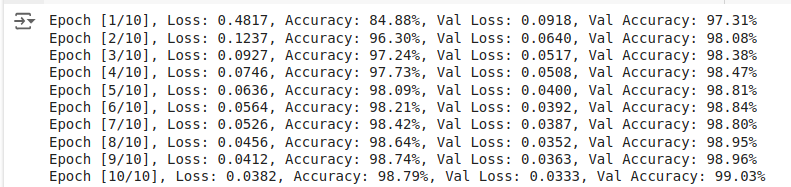
प्राप्त प्रशिक्षण और वैलिडेशन स्कोर्स इस प्रकार हैं:
आउटपुट: प्रशिक्षण और वैलिडेशन मेट्रिक्स।
ड्रॉपआउट वाले मॉडल की तुलना में, ड्रॉपआउट के बिना मॉडल उच्च प्रशिक्षण एक्युरेसी और कम प्रशिक्षण लॉस हासिल करता है — जो अपेक्षित है क्योंकि ड्रॉपआउट प्रशिक्षण के दौरान शोर जोड़ता है और मॉडल के लिए प्रशिक्षण डेटा को पूर्णतः फिट करना कठिन बनाता है।
प्रशिक्षण स्कोर्स में कमी के बावजूद, ड्रॉपआउट वाले मॉडल की वैलिडेशन एक्युरेसी बढ़ी है।
मूल्यांकन चरणों (वैलिडेशन सहित) के दौरान ड्रॉपआउट लेयर्स निष्क्रिय रहती हैं। इसका मतलब है कि सभी यूनिट्स सक्रिय रहती हैं और कोई इनपुट ड्रॉप नहीं होता।
PyTorch में प्रशिक्षण और मूल्यांकन मोड के बीच स्विचिंग क्रमशः model.train() और model.eval() का उपयोग करके की जाती है:
model.train(): मॉडल को प्रशिक्षण मोड में सेट करता है, जिससे ड्रॉपआउट और बैच नॉर्मलाइज़ेशन जैसी प्रशिक्षण-विशिष्ट व्यवहार सक्रिय होते हैं।model.eval(): मॉडल को मूल्यांकन मोड में सेट करता है, ड्रॉपआउट को निष्क्रिय करता है और भविष्यवाणी के लिए पूरे नेटवर्क का उपयोग करता है।आइए टेस्ट एक्युरेसी की गणना करें:
accuracy_with_dropout = evaluate_model(model_with_dropout, test_loader, criterion)
print(f'Accuracy of the model with dropout on the test images: {accuracy_with_dropout:.2f}%')
प्राप्त एक्युरेसी इस प्रकार है:
आउटपुट: टेस्ट इमेजेज़ पर एक्युरेसी।
हमें 99.12% एक्युरेसी मिलती है, जो ड्रॉपआउट के बिना मॉडल की तुलना में थोड़ी बेहतर है।
हमने प्रशिक्षण, वैलिडेशन और मूल्यांकन चरणों के दौरान सभी मेट्रिक्स सहेज लिए हैं, तो आइए उन्हें बेहतर विश्लेषण के लिए Matplotlib का उपयोग करके ग्राफ़ में प्लॉट करें।
इसके लिए कोड इस प्रकार है:
# Plotting the Results
plt.figure(figsize=(14, 10))

# Plot training loss
plt.subplot(2, 2, 1)
plt.plot(train_losses_without_dropout, label='Without Dropout')
plt.plot(train_losses_with_dropout, label='With Dropout')
plt.title('Training Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot validation loss
plt.subplot(2, 2, 2)
plt.plot(val_losses_without_dropout, label='Without Dropout')
plt.plot(val_losses_with_dropout, label='With Dropout')
plt.title('Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot training accuracy
plt.subplot(2, 2, 3)
plt.plot(train_accuracies_without_dropout, label='Without Dropout')
plt.plot(train_accuracies_with_dropout, label='With Dropout')
plt.title('Training Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

# Plot validation accuracy
plt.subplot(2, 2, 4)
plt.plot(val_accuracies_without_dropout, label='Without Dropout')
plt.plot(val_accuracies_with_dropout, label='With Dropout')
plt.title('Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

plt.tight_layout()
plt.show()
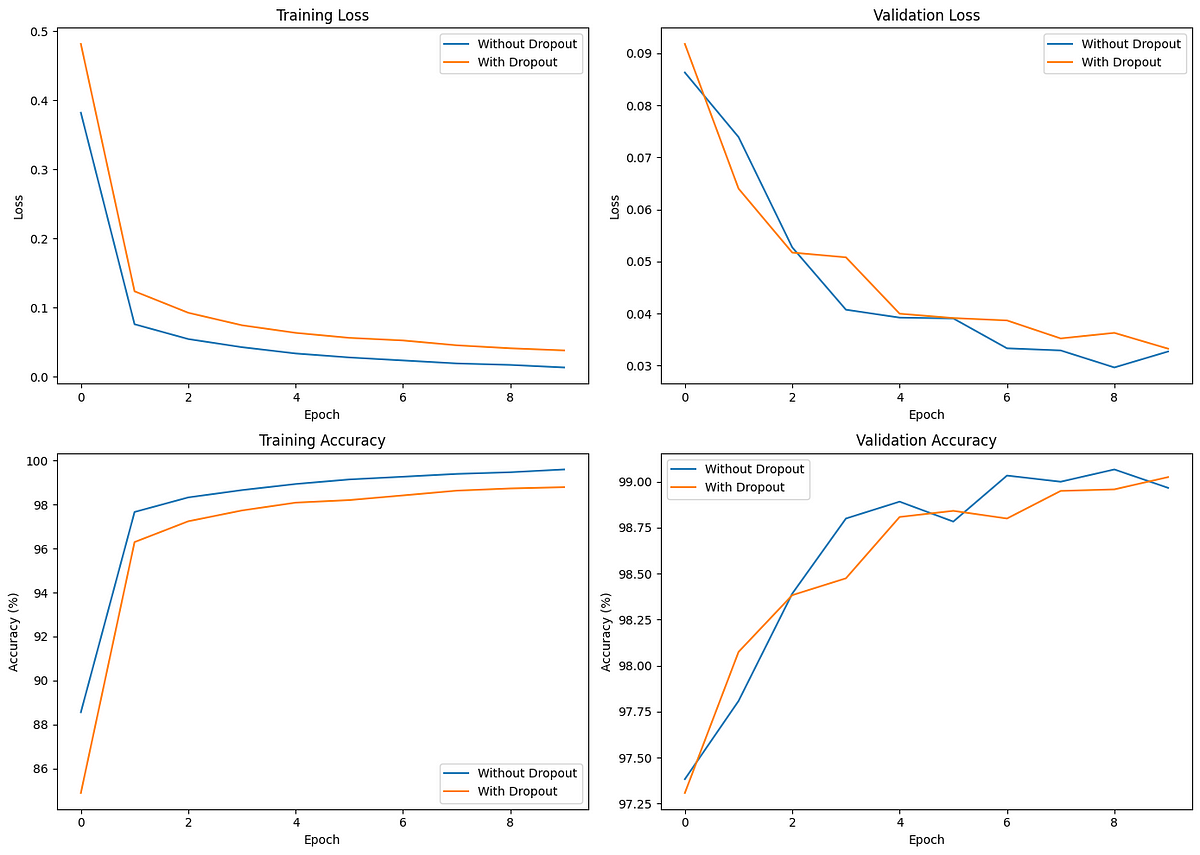
तुलनात्मक प्लॉट्स इस प्रकार हैं:
प्रशिक्षण और वैलिडेशन पर ड्रॉपआउट के प्रभाव की तुलना।
शुरुआती प्रशिक्षण लॉस ड्रॉपआउट के बिना मॉडल के लिए कम है, जो तेज़ कन्वर्जेन्स दर्शाता है। हालाँकि, ड्रॉपआउट वाला मॉडल अधिक सुसंगत वैलिडेशन लॉस और एक्युरेसी दिखाता है, जो बेहतर जनरलाइज़ेशन की ओर इशारा करता है।
इन प्लॉट्स का विश्लेषण करते समय, ड्रॉपआउट वाला मॉडल वैलिडेशन (और टेस्ट) एक्युरेसी में ड्रॉपआउट-रहित मॉडल से थोड़ा बेहतर प्रदर्शन करता है, भले ही प्रशिक्षण एक्युरेसी ड्रॉपआउट-रहित मॉडल की तुलना में कम हो।
ड्रॉपआउट ओवरफिटिंग को रोकने में मदद करता है, जैसा कि प्रशिक्षण और वैलिडेशन प्रदर्शन के बीच छोटे गैप से स्पष्ट है। हमारे उदाहरण में फ़र्क छोटा है, लेकिन जटिल और बड़े मॉडलों को प्रशिक्षित करते समय यह और अधिक महत्वपूर्ण हो जाता है।
ड्रॉपआउट के साथ डीप लर्निंग मॉडल प्रशिक्षित करते समय कुछ उपयोगी सुझाव:
यदि आप डीप-लर्निंग प्रैक्टिशनर हैं, तो मूल शोध-पत्र “Improving Neural Networks by Preventing Co-adaptation of Feature Detectors” पढ़ना लाभकारी होगा। इसमें लेखक अपने प्रयोगों के आधार पर कई अतिरिक्त उपयोगी दिशानिर्देशों पर चर्चा करते हैं।
प्रशिक्षण डेटा पर ओवरफिटिंग न्यूरल नेटवर्क्स में एक आम समस्या है, विशेष रूप से बड़े मॉडलों में जिन्हें अधिक iterations तक प्रशिक्षित किया जाता है। ड्रॉपआउट जैसी रेग्युलराइज़ेशन तकनीकें न्यूरल नेटवर्क्स को प्रशिक्षण डेटा रटने से रोकती हैं और डेटा में उपयोगी पैटर्न बेहतर तरीके से सीखने में मदद करती हैं।
इस ट्यूटोरियल में हमने ड्रॉपआउट रेग्युलराइज़ेशन की अवधारणा का परिचय दिया, इसकी आवश्यकता समझाई, और PyTorch का उपयोग करके एक उदाहरण के माध्यम से इसे लागू किया। हमने डीप न्यूरल नेटवर्क्स में ड्रॉपआउट का प्रभावी उपयोग करने के लिए कुछ उन्नत श्रेष्ठ अभ्यास और टिप्स भी सीखे।
PyTorch के साथ डीप लर्निंग कार्यों पर अधिक जानने के लिए, शुरुआती-अनुकूल Introduction to Deep Learning with PyTorch कोर्स और Intermediate Deep Learning with PyTorch कोर्स देखें — इसी क्रम में।
DataCamp के साथ PyTorch सीखें
कोर्स
लर्निंग पाथ
लर्निंग पाथ