


{count, plural, one {Kursus} other {Kursus}}
Python Tingkat Menengah
{hours} jam
1.4M
Regularisasi dropout adalah teknik yang digunakan pada jaringan saraf untuk mencegah overfitting, yaitu ketika model mempelajari derau pada data pelatihan alih-alih polanya yang sebenarnya.
Pada tahun 2012, Geoffrey Hinton (penerima Turing Award) dan rekan-rekannya memperkenalkan teknik ini dalam sebuah makalah riset, dan sejak itu telah banyak diadopsi untuk melatih model deep learning.
Tutorial ini akan memperkenalkan konsep regularisasi dropout, menegaskan mengapa kita membutuhkannya, dan memperkenalkan fungsi-fungsi yang membantu mengimplementasikannya di PyTorch. Anda juga akan mempelajari detail implementasi melalui contoh praktik langsung, beserta kiat lanjutan untuk menggunakan dropout secara efektif pada proyek deep learning Anda di masa mendatang.
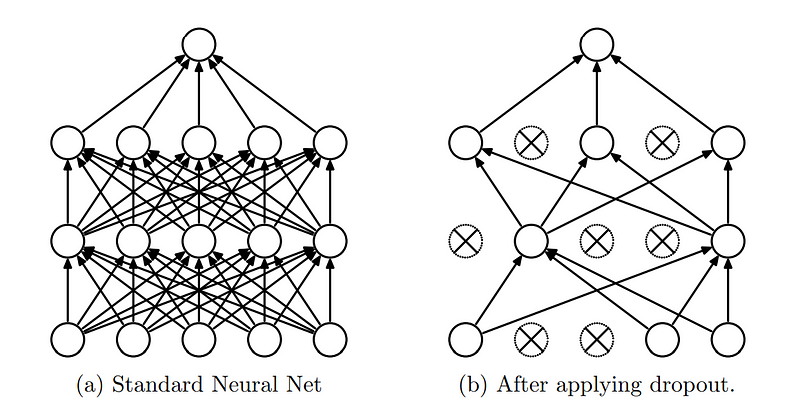
Inti gagasan dropout adalah secara acak “menghapus” (mengatur ke nol) sebagian neuron dalam jaringan selama fase pelatihan. Artinya, persentase tertentu neuron diabaikan atau “dihilangkan” selama setiap forward dan backward pass, sehingga arsitektur jaringan menjadi dinamis berbeda untuk setiap batch pelatihan.
Regularisasi dropout. (Sumber)
Lapisan dropout telah menjadi lapisan esensial dalam jaringan saraf karena manfaat yang diberikannya:
Setelah memahami konsep dropout, mari kita masuk ke implementasinya.
Pustaka deep learning populer seperti Tensorflow dan PyTorch menyediakan modul dan fungsi yang disederhanakan, sehingga mengimplementasikan regularisasi dropout dalam model jaringan saraf menjadi mudah.
Sesuai judulnya, tutorial ini berfokus pada implementasi regularisasi dropout menggunakan PyTorch, namun jika Anda memilih melakukannya di Tensorflow, instruksinya tersedia di dokumentasi resmi Tensorflow.
PyTorch adalah pustaka machine learning sumber terbuka yang dikembangkan oleh AI Research Lab (FAIR) milik Facebook (kini Meta), yang banyak digunakan untuk aplikasi deep learning dan kecerdasan buatan. Di PyTorch, dropout dapat diimplementasikan menggunakan torch.nn.Dropout Class.
Sintaks dari Kelas torch.nn.Dropout adalah sebagai berikut:
torch.nn.Dropout(p=0.5, inplace=False)Di mana:
Dalam fungsi ini, selama pelatihan, lapisan Dropout secara acak mengubah menjadi nol beberapa elemen dari tensor masukan dengan probabilitas p. Elemen yang diubah menjadi nol dipilih secara independen untuk setiap pemanggilan forward dan diambil dari distribusi Bernoulli. Setiap kanal diubah menjadi nol secara independen pada setiap pemanggilan forward.
Selama evaluasi, lapisan dropout dimatikan, artinya lapisan menghitung fungsi identitas. Ini memastikan semua neuron aktif dan tidak ada penskalaan yang diterapkan.
Setelah memahami cara kerja regularisasi dropout dan fungsi yang digunakan di PyTorch, mari kita satukan semuanya melalui contoh praktik berikutnya.
Kita akan menggunakan dataset MNIST yang populer dan membangun convolutional neural network sederhana untuk mendeteksi angka tulisan tangan dari gambar. Lalu kita akan menambahkan lapisan dropout ke jaringan saraf dan mengamati dampaknya.
Pertama, jika Anda belum memasang Python, instruksi pemasangan dapat ditemukan di situs resmi Python. Setelah Python terpasang, Anda dapat menggunakan manajer paket pip untuk memasang pustaka PyTorch.
Buka terminal Anda dan jalankan perintah berikut:
pip install torch torchvisionPerlu dicatat bahwa pustaka PyTorch bergantung pada lingkungan dan versi CUDA Anda. Dokumentasi pemasangan resmi menyediakan instruksi pemasangan yang jelas berdasarkan pengaturan lingkungan Anda.
Jika Anda ingin segera menguji kode dan melewati penyiapan lingkungan, Anda bisa membuka notebook Google Collab baru dengan PyTorch yang sudah terpasang untuk langsung praktik.
Karena dataset MNIST (Modified National Institute of Standards and Technology) tersedia langsung di pustaka PyTorch, kita tidak perlu mengunduhnya dari tempat lain.
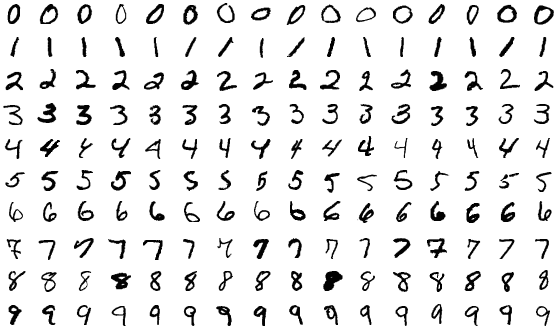
Dataset MNIST adalah kumpulan besar digit tulisan tangan yang umum digunakan untuk pelatihan dan pengujian. Terdiri dari 70.000 gambar skala abu-abu digit (0–9), dibagi menjadi 60.000 gambar pelatihan dan 10.000 gambar pengujian. Setiap gambar diberi label dengan digit yang diwakilinya, sehingga merupakan dataset pembelajaran terawasi.
Dataset MNIST.
Kita akan memuat pustaka yang relevan dan membaca datasetnya.
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader, random_split
import matplotlib.pyplot as plt

# Transformation to normalize the data
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# Loading the MNIST dataset
full_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)

# Splitting the dataset into training and validation sets
train_size = int(0.8 * len(full_dataset))
val_size = len(full_dataset) - train_size
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])

train_loader = DataLoader(dataset=train_dataset, batch_size=100, shuffle=True)
val_loader = DataLoader(dataset=val_dataset, batch_size=100, shuffle=False)
test_loader = DataLoader(dataset=test_dataset, batch_size=100, shuffle=False)
Untuk contoh ini, 20% dari gambar pelatihan dipisahkan menjadi gambar validasi. Selanjutnya, kita periksa dimensi datasetnya:
# Inspecting the train dataset
train_data_iter = iter(train_loader)
train_images, train_labels = next(train_data_iter)
print(f"Train Images Shape: {train_images.shape}")
print(f"Train Labels Shape: {train_labels.shape}")
print("-----------------------------------------")

# Inspecting the val dataset
val_data_iter = iter(val_loader)
val_images, val_labels = next(val_data_iter)
print(f"Validation Images Shape: {val_images.shape}")
print(f"Validation Labels Shape: {val_labels.shape}")
print("-----------------------------------------")

# Inspecting the test dataset
test_data_iter = iter(test_loader)
test_images, test_labels = next(test_data_iter)
print(f"Test Images Shape: {test_images.shape}")
print(f"Test Labels Shape: {test_labels.shape}")
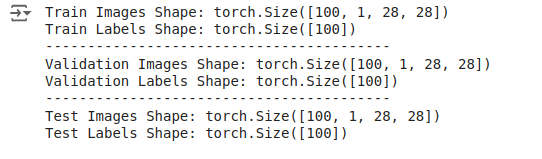
Kita melihat keluaran sebagai berikut:
Output: Dimensi dataset.
Output ini menunjukkan bahwa setiap batch berisi 100 gambar, masing-masing dengan satu kanal dan berukuran 28x28 piksel. Labelnya berupa tensor 1D berukuran 100, sesuai dengan label untuk setiap gambar dalam batch.
Setelah memuat dan mentransformasi data, kita mendefinisikan model convolutional neural network sederhana, yang pertama adalah model tanpa dropout.
# Define the CNN Without Dropout
class CNNWithoutDropout(nn.Module):
   def __init__(self):
       super(CNNWithoutDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = torch.relu(self.fc1(x))
       x = self.fc2(x)
       return x

model_without_dropout = CNNWithoutDropout()
Setelah definisi model, kita mendefinisikan optimizer dan fungsi loss.
criterion = nn.CrossEntropyLoss()
optimizer_without_dropout = optim.SGD(model_without_dropout.parameters(), lr=0.01, momentum=0.9)Selanjutnya, kita melatih model tanpa dropout, mencatat metrik pelatihan dan validasi. Mari tulis kodenya sebagai fungsi agar bisa digunakan kembali nanti.
def train_validate_model(model, train_loader, val_loader, criterion, optimizer, num_epochs=10):
   train_losses = []
   val_losses = []
   train_accuracies = []
   val_accuracies = []

   for epoch in range(num_epochs):
       model.train()
       running_loss = 0.0
       correct = 0
       total = 0

       for images, labels in train_loader:
           outputs = model(images)
           loss = criterion(outputs, labels)

           optimizer.zero_grad()
           loss.backward()
           optimizer.step()

           running_loss += loss.item()
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

       epoch_loss = running_loss / len(train_loader)
       epoch_accuracy = 100 * correct / total
       train_losses.append(epoch_loss)
       train_accuracies.append(epoch_accuracy)

       # Validation Phase
       model.eval()
       val_loss = 0.0
       correct = 0
       total = 0

       with torch.no_grad():
           for images, labels in val_loader:
               outputs = model(images)
               loss = criterion(outputs, labels)
               val_loss += loss.item()
               _, predicted = torch.max(outputs.data, 1)
               total += labels.size(0)
               correct += (predicted == labels).sum().item()

       val_loss /= len(val_loader)
       val_accuracy = 100 * correct / total
       val_losses.append(val_loss)
       val_accuracies.append(val_accuracy)

       print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {epoch_loss:.4f}, Accuracy: {epoch_accuracy:.2f}%, Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2f}%')
   return train_losses, val_losses, train_accuracies, val_accuracies
Kini kita dapat memanggil fungsi ini dengan dataset pelatihan dan validasi.
train_losses_without_dropout, val_losses_without_dropout, train_accuracies_without_dropout, val_accuracies_without_dropout = train_validate_model(
   model_without_dropout, train_loader, val_loader, criterion, optimizer_without_dropout
)
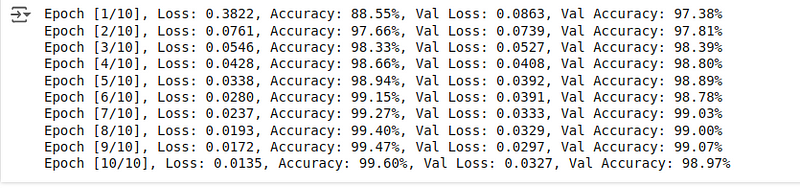
Anda akan melihat metrik pelatihan dan validasi di bawah ini:
Output: Metrik pelatihan dan validasi.
Akurasi validasi sedikit lebih rendah daripada akurasi pelatihan. Bahkan tanpa dropout, model berkinerja sangat baik selama fase pelatihan dan validasi, menunjukkan akurasi tinggi pada kedua set.
Setelah pelatihan selesai, kita dapat mengevaluasi kinerja model pada gambar uji untuk mendapatkan skor akurasi uji, yang menjadi skor baseline sebelum kita menambahkan lapisan dropout.
def evaluate_model(model, test_loader, criterion):
   model.eval()
   correct = 0
   total = 0

   with torch.no_grad():
       for images, labels in test_loader:
           outputs = model(images)
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

   accuracy = 100 * correct / total
   return accuracy

accuracy_without_dropout = evaluate_model(model_without_dropout, test_loader, criterion)
print(f'Accuracy of the model without dropout on the test images: {accuracy_without_dropout:.2f}%')
Akurasi akhir yang dihasilkan, seperti yang terlihat, adalah:
Output: Akurasi pada gambar uji.
Akurasi 99,07% sangat baik, sedikit lebih rendah dari akurasi pelatihan tetapi lebih baik dari akurasi validasi. Mari kita lihat bagaimana perilaku model saat kita menambahkan lapisan dropout, yang membuat pembelajaran digit tulisan tangan menjadi lebih sulit.
Sekarang kita memahami cara mendefinisikan, melatih, dan mengevaluasi jaringan saraf sederhana. Mari ulangi prosedurnya, dimulai dengan definisi model dan menambahkan lapisan dropout.
# Define the CNN With Dropout
class CNNWithDropout(nn.Module):
   def __init__(self):
       super(CNNWithDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.dropout = nn.Dropout(p=0.5)  # Dropout layer with 50% probability
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = self.dropout(torch.relu(self.fc1(x)))  # Apply dropout after ReLU activation
       x = self.fc2(x)
       return x

model_with_dropout = CNNWithDropout()
Perhatikan perubahan kode: Dua baris kode baru ditambahkan, yang menambahkan lapisan dropout ke definisi model. Ya, menambahkan lapisan dropout semudah beberapa baris kode menggunakan fungsi terkait yang tersedia di PyTorch.
Kita mempertahankan fungsi loss dan optimizer yang sama seperti pada model baseline.
criterion = nn.CrossEntropyLoss()
optimizer_with_dropout = optim.SGD(model_with_dropout.parameters(), lr=0.01, momentum=0.9)Selanjutnya, kita melatih model dengan dropout menggunakan kembali fungsi yang telah ditulis sebelumnya dan mencatat metrik pelatihan serta validasi.
train_losses_with_dropout, val_losses_with_dropout, train_accuracies_with_dropout, val_accuracies_with_dropout = train_validate_model(
   model_with_dropout, train_loader, val_loader, criterion, optimizer_with_dropout
)
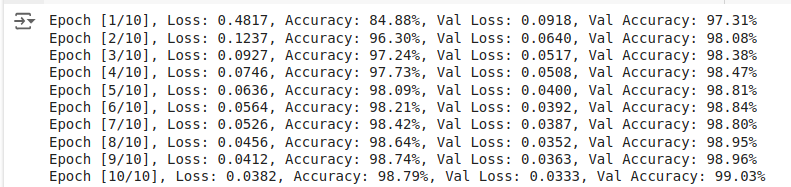
Skor pelatihan dan validasi yang dihasilkan adalah:
Output: Metrik pelatihan dan validasi.
Dibandingkan dengan model yang menggunakan dropout, model tanpa dropout meraih akurasi pelatihan yang lebih tinggi dan loss pelatihan yang lebih rendah, yang memang diharapkan karena dropout menambahkan derau saat pelatihan, sehingga membuat model lebih sulit untuk menyesuaikan data pelatihan secara sempurna.
Terlepas dari penurunan skor pelatihan, akurasi validasi dari model dengan dropout meningkat.
Selama fase evaluasi (termasuk validasi), lapisan dropout dinonaktifkan. Artinya semua unit aktif, dan tidak ada masukan yang dihilangkan.
Di PyTorch, beralih antara mode pelatihan dan evaluasi dilakukan menggunakan model.train() dan model.eval(), masing-masing:
model.train(): Mengatur model ke mode pelatihan, mengaktifkan dropout dan perilaku khusus pelatihan lainnya seperti batch normalization.model.eval(): Mengatur model ke mode evaluasi, menonaktifkan dropout dan menggunakan seluruh jaringan untuk prediksi.Mari hitung akurasi uji:
accuracy_with_dropout = evaluate_model(model_with_dropout, test_loader, criterion)
print(f'Accuracy of the model with dropout on the test images: {accuracy_with_dropout:.2f}%')
Akurasi yang dihasilkan adalah sebagai berikut:
Output: Akurasi pada gambar uji.
Kita memperoleh akurasi sebesar 99,12%, sedikit lebih baik dibandingkan yang kita dapatkan dengan model tanpa dropout.
Karena kita telah menyimpan semua metrik selama fase pelatihan, validasi, dan evaluasi, mari kita plot ke dalam grafik menggunakan Matplotlib untuk menganalisisnya lebih baik.
Kodenya sebagai berikut:
# Plotting the Results
plt.figure(figsize=(14, 10))

# Plot training loss
plt.subplot(2, 2, 1)
plt.plot(train_losses_without_dropout, label='Without Dropout')
plt.plot(train_losses_with_dropout, label='With Dropout')
plt.title('Training Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot validation loss
plt.subplot(2, 2, 2)
plt.plot(val_losses_without_dropout, label='Without Dropout')
plt.plot(val_losses_with_dropout, label='With Dropout')
plt.title('Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot training accuracy
plt.subplot(2, 2, 3)
plt.plot(train_accuracies_without_dropout, label='Without Dropout')
plt.plot(train_accuracies_with_dropout, label='With Dropout')
plt.title('Training Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

# Plot validation accuracy
plt.subplot(2, 2, 4)
plt.plot(val_accuracies_without_dropout, label='Without Dropout')
plt.plot(val_accuracies_with_dropout, label='With Dropout')
plt.title('Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

plt.tight_layout()
plt.show()
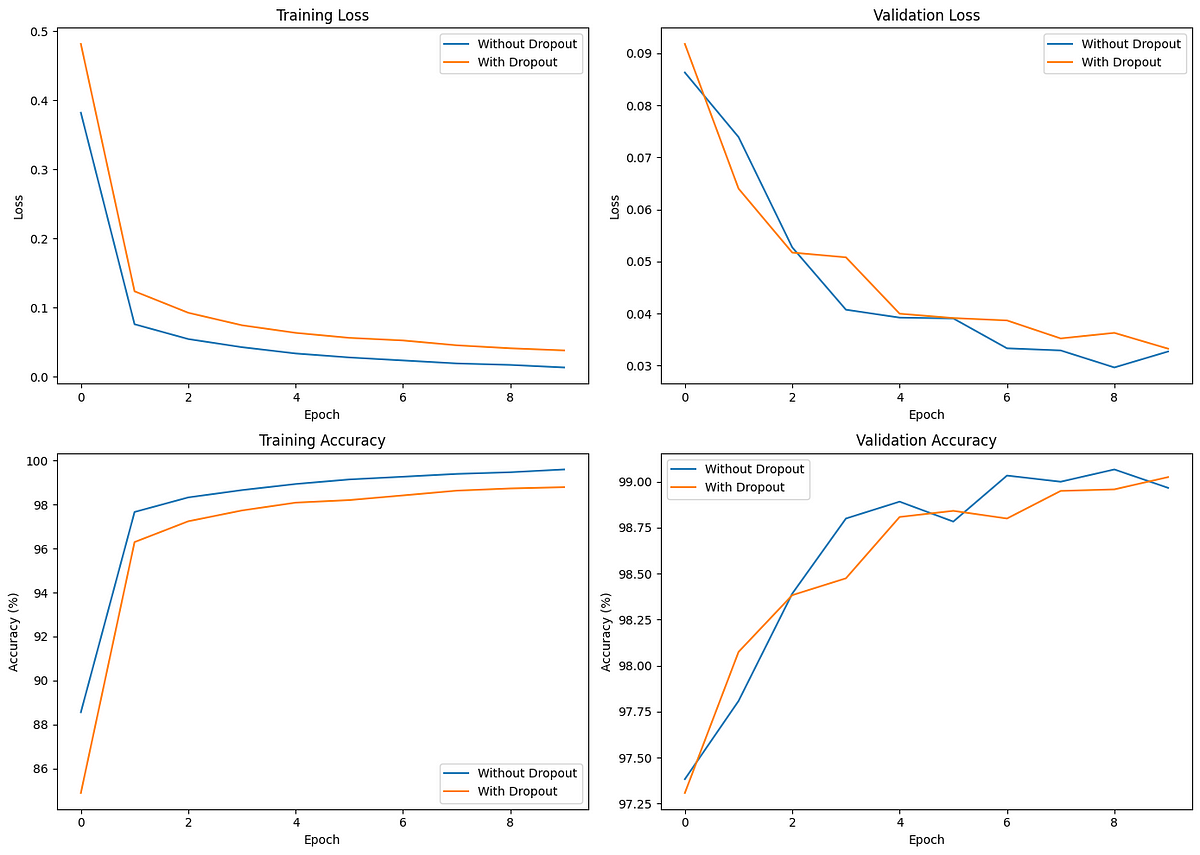
Perbandingan plotnya adalah sebagai berikut:
Membandingkan efek dropout pada pelatihan dan validasi.
Loss pelatihan awal lebih rendah untuk model tanpa dropout, menunjukkan konvergensi yang lebih cepat. Namun, model dengan dropout menunjukkan loss dan akurasi validasi yang lebih konsisten, menandakan generalisasi yang lebih baik.
Saat menganalisis plot ini, model dengan dropout mencapai akurasi validasi (dan akurasi uji) yang sedikit lebih tinggi daripada model tanpa dropout, meskipun model dengan dropout memiliki akurasi pelatihan yang lebih rendah dibanding model tanpa dropout.
Dropout membantu mencegah overfitting, seperti terlihat dari selisih yang lebih kecil antara performa pelatihan dan validasi. Walau perbedaannya tidak signifikan pada contoh kita, perbedaan ini menjadi semakin krusial saat melatih model yang lebih kompleks dan lebih besar.
Berikut beberapa kiat bermanfaat saat Anda melatih model deep learning menggunakan Dropout:
Jika Anda seorang praktisi deep learning, ada baiknya membaca makalah riset asli “Improving Neural Networks by Preventing Co-adaptation of Feature Detectors.” Di dalamnya, para penulis membahas sejumlah pedoman tambahan yang bermanfaat berdasarkan eksperimen mereka.
Overfitting terhadap data pelatihan adalah masalah umum pada jaringan saraf, terutama pada model yang lebih besar dan dilatih dalam iterasi tinggi. Teknik regularisasi, seperti dropout, mencegah jaringan saraf menghafal data pelatihan dan membantu mereka lebih baik mempelajari pola berguna dalam data.
Tutorial ini memperkenalkan konsep regularisasi dropout, menjelaskan mengapa kita membutuhkannya, dan mengimplementasikannya menggunakan PyTorch melalui contoh kasus. Kita juga mempelajari praktik terbaik dan kiat lanjutan untuk menggunakan dropout secara efektif pada jaringan saraf dalam.
Untuk mempelajari lebih lanjut tentang penggunaan PyTorch untuk tugas deep learning, lihat Introduction to Deep Learning with PyTorch untuk pemula dan Intermediate Deep Learning with PyTorch, secara berurutan.
Belajar PyTorch Bersama DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



