


Cours
Python intermédiaire
4 h
1.4M
La régularisation par dropout est une technique utilisée dans les réseaux de neurones pour prévenir le surapprentissage (overfitting), qui survient lorsqu'un modèle apprend le bruit des données d'entraînement plutôt que les véritables motifs.
En 2012, Geoffrey Hinton (lauréat du prix Turing) et ses collègues ont présenté cette technique dans un article de recherche, et elle a depuis été largement adoptée pour entraîner des modèles de deep learning.
Ce tutoriel présente le concept de régularisation par dropout, explique pourquoi nous en avons besoin et introduit les fonctions permettant de l'implémenter dans PyTorch. Vous verrez également des détails d'implémentation à travers des exemples pratiques, ainsi que des conseils avancés pour utiliser efficacement le dropout dans vos futurs projets de deep learning.
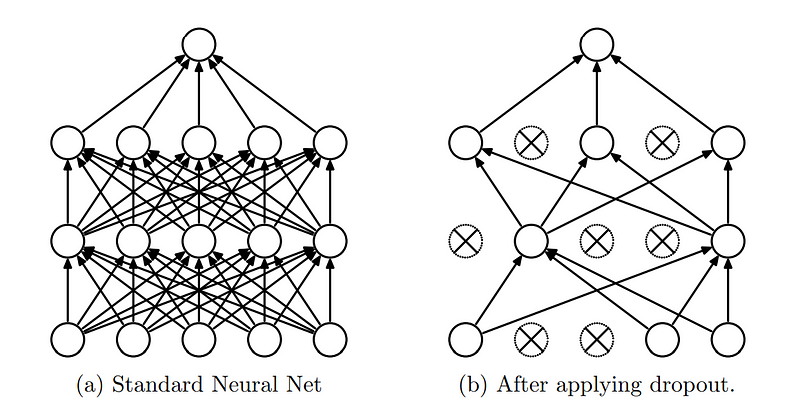
L'idée centrale du dropout consiste à « éteindre » aléatoirement (mettre à zéro) une fraction des neurones du réseau pendant l'entraînement. Autrement dit, un certain pourcentage de neurones est ignoré à chaque passe avant et arrière, ce qui rend l'architecture du réseau dynamiquement différente pour chaque lot d'entraînement.
Régularisation par dropout. (Source)
La couche de dropout est devenue essentielle dans les réseaux de neurones en raison des bénéfices qu'elle apporte :
Maintenant que le concept de dropout est clair, passons à son implémentation.
Les bibliothèques de deep learning populaires comme Tensorflow et PyTorch proposent des modules et fonctions simplifiés, ce qui rend l'implémentation du dropout très directe dans les modèles de réseaux de neurones.
Comme l'indique le titre, ce tutoriel se concentre sur l'implémentation du dropout avec PyTorch, mais si vous préférez Tensorflow, les consignes sont disponibles dans la documentation officielle de Tensorflow.
PyTorch est une bibliothèque open source de machine learning développée par le laboratoire FAIR de Facebook (désormais Meta), très utilisée pour les applications d'intelligence artificielle et de deep learning. Dans PyTorch, le dropout s'implémente via la torch.nn.Dropout Class.
La syntaxe de la classe torch.nn.Dropout est la suivante :
torch.nn.Dropout(p=0.5, inplace=False)Où :
Avec cette fonction, pendant l'entraînement, la couche Dropout met aléatoirement à zéro certains éléments du tenseur d'entrée avec une probabilité p. Les éléments mis à zéro sont choisis indépendamment à chaque passe avant, selon une loi de Bernoulli. Chaque canal est neutralisé indépendamment à chaque passe avant.
En phase d'évaluation, la couche de dropout est désactivée : elle se comporte comme une fonction identité. Tous les neurones sont donc actifs et aucun redimensionnement n'est appliqué.
Maintenant que nous avons vu le fonctionnement du dropout et sa fonction dans PyTorch, passons à un exemple pratique.
Nous allons utiliser le jeu de données MNIST et construire un simple réseau de neurones convolutif pour reconnaître des chiffres manuscrits sur des images. Nous ajouterons ensuite des couches de dropout au réseau et analyserons leur impact.
Si Python n'est pas encore installé, suivez les instructions sur le site officiel de Python. Une fois Python installé, utilisez le gestionnaire de paquets pip pour installer les bibliothèques PyTorch.
Ouvrez votre terminal et exécutez la commande suivante :
pip install torch torchvisionNotez que les bibliothèques PyTorch dépendent de votre environnement et de la version de CUDA. La documentation d'installation officielle détaille les étapes adaptées à votre configuration.
Si vous souhaitez tester le code tout de suite et ignorer la configuration locale, vous pouvez ouvrir un nouveau notebook Google Colab avec PyTorch préinstallé pour passer immédiatement à la pratique.
Comme le jeu de données MNIST (Modified National Institute of Standards and Technology) est disponible directement dans PyTorch, il n'est pas nécessaire de le télécharger ailleurs.
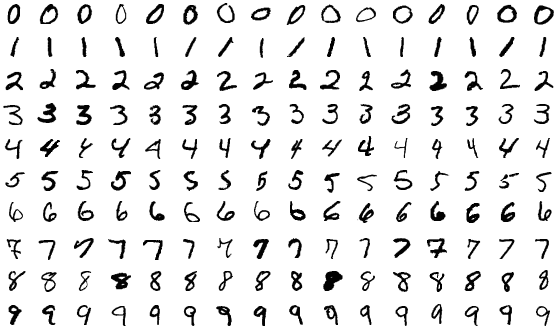
MNIST est un large corpus d'images de chiffres manuscrits couramment utilisé pour l'entraînement et les tests. Il contient 70 000 images en niveaux de gris (chiffres 0–9), réparties en 60 000 images d'entraînement et 10 000 images de test. Chaque image est étiquetée par le chiffre correspondant, ce qui en fait un jeu de données supervisé.
Le jeu de données MNIST.
Chargeons les bibliothèques utiles et lisons le jeu de données.
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader, random_split
import matplotlib.pyplot as plt

# Transformation pour normaliser les données
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# Chargement du jeu de données MNIST
full_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)

# Division du jeu de données en ensembles d'entraînement et de validation
train_size = int(0.8 * len(full_dataset))
val_size = len(full_dataset) - train_size
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])

train_loader = DataLoader(dataset=train_dataset, batch_size=100, shuffle=True)
val_loader = DataLoader(dataset=val_dataset, batch_size=100, shuffle=False)
test_loader = DataLoader(dataset=test_dataset, batch_size=100, shuffle=False)
Dans cet exemple, 20 % des images d'entraînement sont réservées à la validation. Vérifions ensuite les dimensions des jeux de données :
# Inspection de l'ensemble d'entraînement
train_data_iter = iter(train_loader)
train_images, train_labels = next(train_data_iter)
print(f"Train Images Shape: {train_images.shape}")
print(f"Train Labels Shape: {train_labels.shape}")
print("-----------------------------------------")

# Inspection de l'ensemble de validation
val_data_iter = iter(val_loader)
val_images, val_labels = next(val_data_iter)
print(f"Validation Images Shape: {val_images.shape}")
print(f"Validation Labels Shape: {val_labels.shape}")
print("-----------------------------------------")

# Inspection de l'ensemble de test
test_data_iter = iter(test_loader)
test_images, test_labels = next(test_data_iter)
print(f"Test Images Shape: {test_images.shape}")
print(f"Test Labels Shape: {test_labels.shape}")
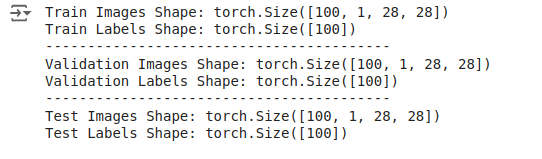
La sortie observée est la suivante :
Sortie : les dimensions du jeu de données.
Ces sorties indiquent que les lots contiennent 100 images, chacune avec un canal et des dimensions de 28×28 pixels. Les étiquettes sont un tenseur 1D de taille 100 correspondant aux labels de chaque image du lot.
Une fois les données chargées et transformées, définissons un petit réseau de neurones convolutif, dans une première version sans dropout.
# Définition du CNN sans Dropout
class CNNWithoutDropout(nn.Module):
   def __init__(self):
       super(CNNWithoutDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = torch.relu(self.fc1(x))
       x = self.fc2(x)
       return x

model_without_dropout = CNNWithoutDropout()
Après la définition du modèle, définissons l'optimiseur et la fonction de perte.
criterion = nn.CrossEntropyLoss()
optimizer_without_dropout = optim.SGD(model_without_dropout.parameters(), lr=0.01, momentum=0.9)Entraînons ensuite le modèle sans dropout en enregistrant les métriques d'entraînement et de validation. Écrivons le code sous forme de fonctions pour pouvoir les réutiliser plus tard.
def train_validate_model(model, train_loader, val_loader, criterion, optimizer, num_epochs=10):
   train_losses = []
   val_losses = []
   train_accuracies = []
   val_accuracies = []

   for epoch in range(num_epochs):
       model.train()
       running_loss = 0.0
       correct = 0
       total = 0

       for images, labels in train_loader:
           outputs = model(images)
           loss = criterion(outputs, labels)

           optimizer.zero_grad()
           loss.backward()
           optimizer.step()

           running_loss += loss.item()
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

       epoch_loss = running_loss / len(train_loader)
       epoch_accuracy = 100 * correct / total
       train_losses.append(epoch_loss)
       train_accuracies.append(epoch_accuracy)

       # Phase de validation
       model.eval()
       val_loss = 0.0
       correct = 0
       total = 0

       with torch.no_grad():
           for images, labels in val_loader:
               outputs = model(images)
               loss = criterion(outputs, labels)
               val_loss += loss.item()
               _, predicted = torch.max(outputs.data, 1)
               total += labels.size(0)
               correct += (predicted == labels).sum().item()

       val_loss /= len(val_loader)
       val_accuracy = 100 * correct / total
       val_losses.append(val_loss)
       val_accuracies.append(val_accuracy)

       print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {epoch_loss:.4f}, Accuracy: {epoch_accuracy:.2f}%, Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2f}%')
   return train_losses, val_losses, train_accuracies, val_accuracies
Nous pouvons maintenant appeler cette fonction avec les ensembles d'entraînement et de validation.
train_losses_without_dropout, val_losses_without_dropout, train_accuracies_without_dropout, val_accuracies_without_dropout = train_validate_model(
   model_without_dropout, train_loader, val_loader, criterion, optimizer_without_dropout
)
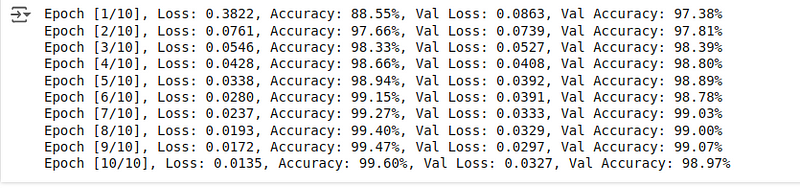
Vous verrez ci-dessous les métriques d'entraînement et de validation :
Sortie : métriques d'entraînement et de validation.
La précision en validation est légèrement inférieure à celle d'entraînement. Même sans dropout, le modèle se comporte très bien sur les phases d'entraînement et de validation, avec une haute précision sur les deux ensembles.
Une fois l'entraînement terminé, évaluons la performance du modèle sur les images de test pour obtenir la précision de référence avant d'ajouter des couches de dropout.
def evaluate_model(model, test_loader, criterion):
   model.eval()
   correct = 0
   total = 0

   with torch.no_grad():
       for images, labels in test_loader:
           outputs = model(images)
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

   accuracy = 100 * correct / total
   return accuracy

accuracy_without_dropout = evaluate_model(model_without_dropout, test_loader, criterion)
print(f'Accuracy of the model without dropout on the test images: {accuracy_without_dropout:.2f}%')
La précision finale obtenue est :
Sortie : précision sur les images de test.
99,07 % de précision, c'est excellent : légèrement inférieur à la précision d'entraînement mais supérieur à celle de validation. Voyons comment le modèle se comporte quand nous ajoutons des couches de dropout, ce qui rend l'apprentissage des chiffres manuscrits plus difficile.
Nous savons désormais définir, entraîner et évaluer un réseau de neurones simple. Reprenons la même démarche en ajoutant une couche de dropout.
# Définition du CNN avec Dropout
class CNNWithDropout(nn.Module):
   def __init__(self):
       super(CNNWithDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.dropout = nn.Dropout(p=0.5)  # Couche de dropout avec 50% de probabilité
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = self.dropout(torch.relu(self.fc1(x)))  # Dropout après l'activation ReLU
       x = self.fc2(x)
       return x

model_with_dropout = CNNWithDropout()
Remarquez le changement : deux lignes de code suffisent à ajouter des couches de dropout à la définition du modèle. Avec PyTorch, c'est aussi simple que cela.
Nous conservons la même fonction de perte et le même optimiseur que pour le modèle de base.
criterion = nn.CrossEntropyLoss()
optimizer_with_dropout = optim.SGD(model_with_dropout.parameters(), lr=0.01, momentum=0.9)Entraînons maintenant le modèle avec dropout en réutilisant les fonctions écrites précédemment et enregistrons les métriques d'entraînement et de validation.
train_losses_with_dropout, val_losses_with_dropout, train_accuracies_with_dropout, val_accuracies_with_dropout = train_validate_model(
   model_with_dropout, train_loader, val_loader, criterion, optimizer_with_dropout
)
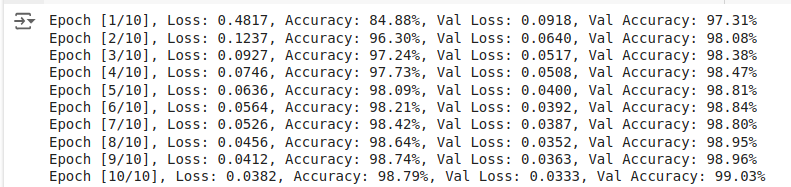
Les scores d'entraînement et de validation obtenus sont :
Sortie : métriques d'entraînement et de validation.
Comparé au modèle avec dropout, le modèle sans dropout atteint une précision d'entraînement plus élevée et une perte plus faible, ce qui est attendu : le dropout introduit du bruit pendant l'apprentissage et rend l'ajustement parfait des données d'entraînement plus difficile.
Malgré cette baisse en entraînement, la précision en validation du modèle avec dropout augmente.
En phase d'évaluation (y compris en validation), les couches de dropout sont désactivées. Toutes les unités sont donc actives et aucune entrée n'est supprimée.
Dans PyTorch, le passage entre les modes entraînement et évaluation se fait avec model.train() et model.eval(), respectivement :
model.train() : active le mode entraînement, ce qui active le dropout et d'autres comportements spécifiques comme la batch normalization.model.eval() : active le mode évaluation, désactive le dropout et utilise l'intégralité du réseau pour la prédiction.Calculons la précision sur le test :
accuracy_with_dropout = evaluate_model(model_with_dropout, test_loader, criterion)
print(f'Accuracy of the model with dropout on the test images: {accuracy_with_dropout:.2f}%')
La précision obtenue est la suivante :
Sortie : précision sur les images de test.
Nous obtenons 99,12 % de précision, légèrement mieux que le modèle sans dropout.
Comme nous avons enregistré toutes les métriques lors de l'entraînement, de la validation et de l'évaluation, traçons-les avec Matplotlib pour une analyse plus fine.
Le code correspondant est le suivant :
# Visualisation des résultats
plt.figure(figsize=(14, 10))

# Courbe de perte d'entraînement
plt.subplot(2, 2, 1)
plt.plot(train_losses_without_dropout, label='Without Dropout')
plt.plot(train_losses_with_dropout, label='With Dropout')
plt.title('Training Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Courbe de perte de validation
plt.subplot(2, 2, 2)
plt.plot(val_losses_without_dropout, label='Without Dropout')
plt.plot(val_losses_with_dropout, label='With Dropout')
plt.title('Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Précision d'entraînement
plt.subplot(2, 2, 3)
plt.plot(train_accuracies_without_dropout, label='Without Dropout')
plt.plot(train_accuracies_with_dropout, label='With Dropout')
plt.title('Training Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

# Précision de validation
plt.subplot(2, 2, 4)
plt.plot(val_accuracies_without_dropout, label='Without Dropout')
plt.plot(val_accuracies_with_dropout, label='With Dropout')
plt.title('Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

plt.tight_layout()
plt.show()
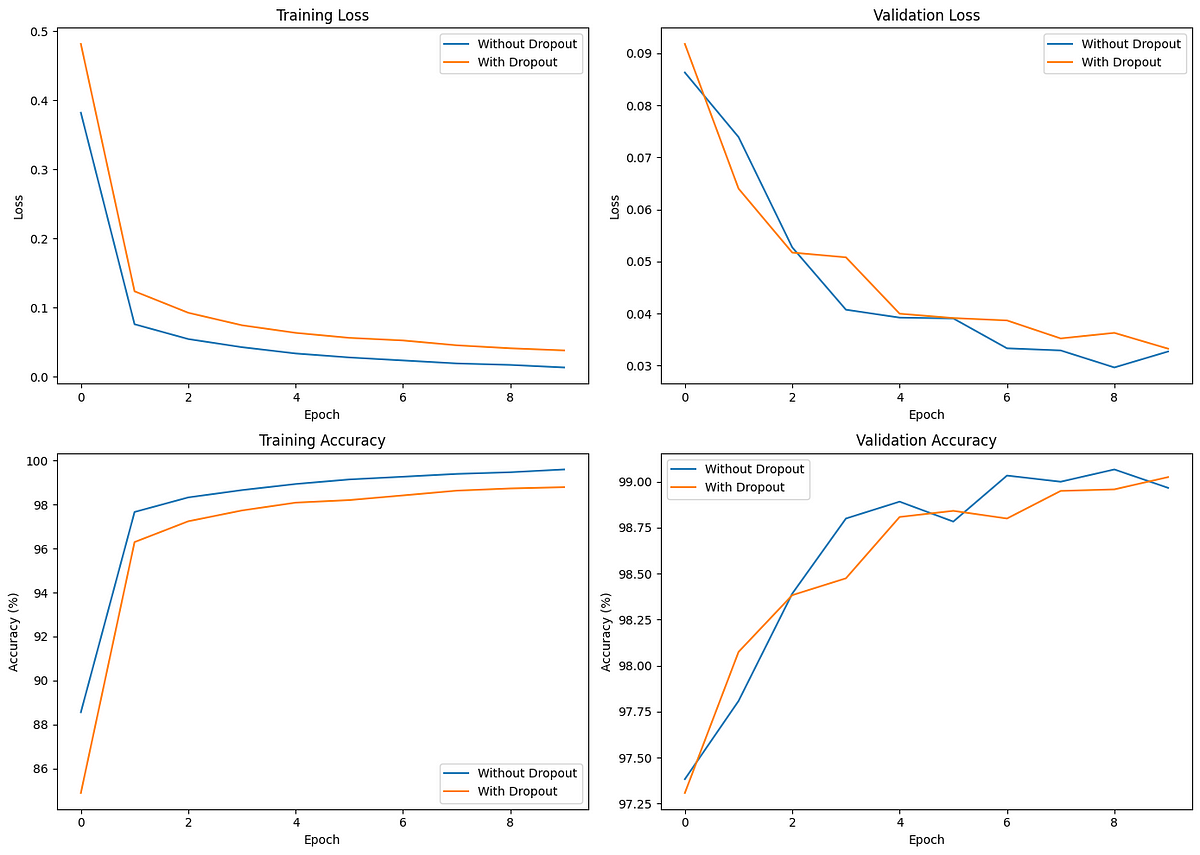
Les graphiques de comparaison sont les suivants :
Comparer l'effet du dropout sur l'entraînement et la validation.
La perte initiale est plus faible pour le modèle sans dropout, signe d'une convergence plus rapide. Cependant, le modèle avec dropout présente une perte et une précision de validation plus stables, signe d'une meilleure généralisation.
En analysant ces courbes, le modèle avec dropout atteint une précision de validation (et de test) légèrement supérieure à celle du modèle sans dropout, malgré une précision d'entraînement inférieure.
Le dropout aide à éviter le surapprentissage, comme en témoigne l'écart plus réduit entre les performances d'entraînement et de validation. Bien que marginal dans notre exemple, cet effet devient crucial pour des modèles plus complexes et volumineux.
Voici quelques conseils utiles lorsque vous entraînez des modèles de deep learning avec du Dropout :
Si vous pratiquez le deep learning, la lecture de l'article original « Improving Neural Networks by Preventing Co-adaptation of Feature Detectors » vaut le détour. Les auteurs y proposent d'autres recommandations utiles issues de leurs expériences.
Le surapprentissage des données d'entraînement est fréquent dans les réseaux de neurones, surtout pour des modèles volumineux entraînés longtemps. Les techniques de régularisation, comme le dropout, évitent que les réseaux mémorisent les données et les aident à apprendre des motifs utiles.
Ce tutoriel a présenté le concept de régularisation par dropout, ses enjeux, et son implémentation dans PyTorch via un cas pratique. Nous avons également passé en revue des bonnes pratiques et conseils avancés pour l'utiliser efficacement dans des réseaux profonds.
Pour aller plus loin avec PyTorch en deep learning, consultez le cours pour débuter Introduction to Deep Learning with PyTorch puis le cours Intermediate Deep Learning with PyTorch, dans cet ordre.
Apprenez PyTorch avec DataCamp
Cours
Cursus
Cursus