


Cursus
Python voor gemiddeld niveau
4 uur
1.4M
Dropout-regularisatie is een techniek in neurale netwerken om overfitting te voorkomen: het probleem waarbij een model de ruis in de trainingsdata leert in plaats van het werkelijke patroon.
In 2012 introduceerden Geoffrey Hinton (een Turing Award-winnaar) en zijn collega’s de techniek in een onderzoekspaper, en sindsdien wordt het op grote schaal toegepast om deep-learningmodellen te trainen.
In deze tutorial introduceren we het concept van dropout-regularisatie, leggen we nog eens uit waarom we het nodig hebben en bekijken we de functies om het in PyTorch te implementeren. Je leert ook implementatiedetails aan de hand van praktische voorbeelden, plus geavanceerde tips om dropout effectief te gebruiken in je toekomstige deep-learningprojecten.
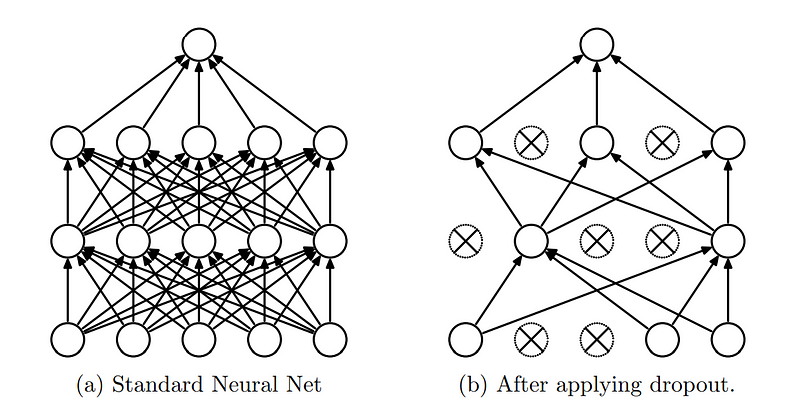
Het kernidee van dropout is om tijdens het trainen willekeurig een fractie van de neuronen te “druppelen” (op nul te zetten). Dat betekent dat bij elke voorwaartse en achterwaartse stap een bepaald percentage neuronen wordt genegeerd of “gedropt”, waardoor de architectuur van het netwerk voor elke trainingsbatch dynamisch anders is.
Dropout-regularisatie. (Bron)
De dropout-laag is een essentiële laag in neurale netwerken geworden door de voordelen die ze biedt:
Nu we het concept van dropout begrijpen, gaan we door naar de implementatie.
Populaire deep-learningbibliotheken zoals Tensorflow en PyTorch bieden vereenvoudigde modules en functies, waardoor het implementeren van dropout-regularisatie in neurale netwerkmodellen eenvoudig is.
Zoals de titel aangeeft, richt deze tutorial zich op de implementatie van dropout-regularisatie met PyTorch. Kies je voor Tensorflow, dan vind je de instructies in de officiële Tensorflow-documentatie.
PyTorch is een open-source machinelearningbibliotheek ontwikkeld door de AI Research Lab (FAIR) van Facebook (nu Meta) en wordt veel gebruikt voor deep learning en AI-toepassingen. In PyTorch kun je dropout implementeren met de torch.nn.Dropout Class.
De syntaxis van de torch.nn.Dropout-klasse is als volgt:
torch.nn.Dropout(p=0.5, inplace=False)Waarbij:
In deze functie worden tijdens het trainen door de Dropout-laag willekeurig enkele elementen van de input-tensor op nul gezet met kans p. De op nul gezette elementen worden bij elke forward call onafhankelijk gekozen en gesampled uit een Bernoulli-verdeling. Elk kanaal wordt bij iedere forward call onafhankelijk op nul gezet.
Tijdens evaluatie staat de dropout-laag uit, wat betekent dat de laag een identiteitsfunctie berekent. Zo zijn alle neuronen actief en wordt er geen schaling toegepast.
Nu we begrijpen hoe dropout-regularisatie werkt en welke functie in PyTorch wordt gebruikt, brengen we het samen in een praktisch voorbeeld.
We nemen de populaire MNIST-dataset en bouwen een simpel convolutioneel neuraal netwerk om handgeschreven cijfers in afbeeldingen te detecteren. Vervolgens voegen we dropout-lagen toe aan het netwerk en bekijken we het effect.
Als je Python nog niet hebt geïnstalleerd, vind je de installatie-instructies op de officiële Python-website. Als Python is geïnstalleerd, kun je de pakketmanager pip gebruiken om de PyTorch-bibliotheken te installeren.
Open je terminal en voer het volgende commando uit:
pip install torch torchvisionHoud er rekening mee dat de PyTorch-bibliotheken afhangen van je omgeving en CUDA-versie. De officiële installatiedocumentatie geeft heldere installatie-instructies op basis van jouw omgeving.
Als je snel de code wilt testen en de omgevingssetup liever overslaat, kun je een nieuwe Google Collab-notebook openen met PyTorch al vooraf geïnstalleerd om meteen hands-on aan de slag te gaan.
Omdat de MNIST (Modified National Institute of Standards and Technology)-dataset direct beschikbaar is in de PyTorch-bibliotheek, hoeven we deze niet elders te downloaden.
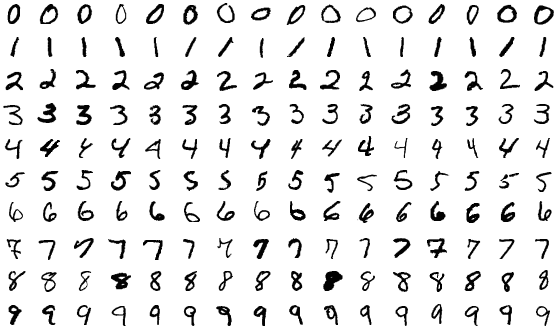
De MNIST-dataset is een grote verzameling handgeschreven cijfers die vaak wordt gebruikt voor training en testen. Hij bestaat uit 70.000 grijswaardenafbeeldingen van cijfers (0–9), verdeeld in 60.000 trainingsafbeeldingen en 10.000 testafbeeldingen. Elke afbeelding is gelabeld met het cijfer dat deze voorstelt, wat het een supervised-learningdataset maakt.
De MNIST-dataset.
We laden de relevante bibliotheken en lezen de dataset in.
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader, random_split
import matplotlib.pyplot as plt

# Transformation to normalize the data
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# Loading the MNIST dataset
full_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)

# Splitting the dataset into training and validation sets
train_size = int(0.8 * len(full_dataset))
val_size = len(full_dataset) - train_size
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])

train_loader = DataLoader(dataset=train_dataset, batch_size=100, shuffle=True)
val_loader = DataLoader(dataset=val_dataset, batch_size=100, shuffle=False)
test_loader = DataLoader(dataset=test_dataset, batch_size=100, shuffle=False)
In dit voorbeeld is 20% van de trainingsafbeeldingen gebruikt als validatiebeelden. Vervolgens controleren we de dimensies van de datasets:
# Inspecting the train dataset
train_data_iter = iter(train_loader)
train_images, train_labels = next(train_data_iter)
print(f"Train Images Shape: {train_images.shape}")
print(f"Train Labels Shape: {train_labels.shape}")
print("-----------------------------------------")

# Inspecting the val dataset
val_data_iter = iter(val_loader)
val_images, val_labels = next(val_data_iter)
print(f"Validation Images Shape: {val_images.shape}")
print(f"Validation Labels Shape: {val_labels.shape}")
print("-----------------------------------------")

# Inspecting the test dataset
test_data_iter = iter(test_loader)
test_images, test_labels = next(test_data_iter)
print(f"Test Images Shape: {test_images.shape}")
print(f"Test Labels Shape: {test_labels.shape}")
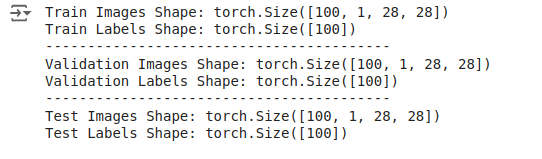
We zien de uitvoer als volgt:
Uitvoer: de dimensies van de dataset.
Deze uitvoer geeft aan dat de batches 100 afbeeldingen bevatten, elk met één kanaal en afmetingen van 28x28 pixels. De labels zijn simpelweg een 1D-tensor van grootte 100, overeenkomend met de labels voor elke afbeelding in de batch.
Nadat we de data hebben geladen en getransformeerd, definiëren we een eenvoudig convolutioneel neuraal netwerk. Als eerste het model zonder dropout.
# Define the CNN Without Dropout
class CNNWithoutDropout(nn.Module):
   def __init__(self):
       super(CNNWithoutDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = torch.relu(self.fc1(x))
       x = self.fc2(x)
       return x

model_without_dropout = CNNWithoutDropout()
Na de modeldefinitie definiëren we de optimizer en de verliesfunctie.
criterion = nn.CrossEntropyLoss()
optimizer_without_dropout = optim.SGD(model_without_dropout.parameters(), lr=0.01, momentum=0.9)Vervolgens trainen we het model zonder dropout en leggen we de trainings- en validatiemetrics vast. We schrijven de code als functies zodat we ze later kunnen hergebruiken.
def train_validate_model(model, train_loader, val_loader, criterion, optimizer, num_epochs=10):
   train_losses = []
   val_losses = []
   train_accuracies = []
   val_accuracies = []

   for epoch in range(num_epochs):
       model.train()
       running_loss = 0.0
       correct = 0
       total = 0

       for images, labels in train_loader:
           outputs = model(images)
           loss = criterion(outputs, labels)

           optimizer.zero_grad()
           loss.backward()
           optimizer.step()

           running_loss += loss.item()
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

       epoch_loss = running_loss / len(train_loader)
       epoch_accuracy = 100 * correct / total
       train_losses.append(epoch_loss)
       train_accuracies.append(epoch_accuracy)

       # Validation Phase
       model.eval()
       val_loss = 0.0
       correct = 0
       total = 0

       with torch.no_grad():
           for images, labels in val_loader:
               outputs = model(images)
               loss = criterion(outputs, labels)
               val_loss += loss.item()
               _, predicted = torch.max(outputs.data, 1)
               total += labels.size(0)
               correct += (predicted == labels).sum().item()

       val_loss /= len(val_loader)
       val_accuracy = 100 * correct / total
       val_losses.append(val_loss)
       val_accuracies.append(val_accuracy)

       print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {epoch_loss:.4f}, Accuracy: {epoch_accuracy:.2f}%, Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2f}%')
   return train_losses, val_losses, train_accuracies, val_accuracies
We kunnen deze functie nu aanroepen met de train- en validatiedatasets.
train_losses_without_dropout, val_losses_without_dropout, train_accuracies_without_dropout, val_accuracies_without_dropout = train_validate_model(
   model_without_dropout, train_loader, val_loader, criterion, optimizer_without_dropout
)
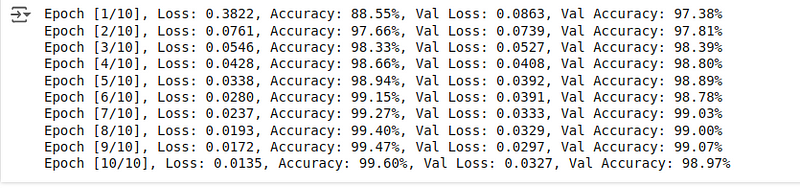
Je ziet hieronder de trainings- en validatiemetrics:
Uitvoer: trainings- en validatiemetrics.
De validatienauwkeurigheid is iets lager dan de trainingsnauwkeurigheid. Zelfs zonder dropout presteert het model uitzonderlijk goed tijdens training en validatie, met hoge nauwkeurigheid op beide sets.
Na het trainen kunnen we beoordelen hoe het model presteert op de testafbeeldingen om de testnauwkeurigheid te bepalen. Dit is onze basisscore voordat we dropouts toevoegen.
def evaluate_model(model, test_loader, criterion):
   model.eval()
   correct = 0
   total = 0

   with torch.no_grad():
       for images, labels in test_loader:
           outputs = model(images)
           _, predicted = torch.max(outputs.data, 1)
           total += labels.size(0)
           correct += (predicted == labels).sum().item()

   accuracy = 100 * correct / total
   return accuracy

accuracy_without_dropout = evaluate_model(model_without_dropout, test_loader, criterion)
print(f'Accuracy of the model without dropout on the test images: {accuracy_without_dropout:.2f}%')
De uiteindelijke nauwkeurigheid is als volgt:
Uitvoer: nauwkeurigheid op de testafbeeldingen.
99,07% nauwkeurigheid is extreem goed, iets lager dan de trainingsnauwkeurigheid maar beter dan de validatienauwkeurigheid. Laten we kijken hoe het model zich gedraagt wanneer we dropout-lagen toevoegen, waardoor het lastiger wordt om handgeschreven cijfers te leren.
We weten nu hoe we een eenvoudig neuraal netwerk definiëren, trainen en evalueren. We herhalen de procedure en beginnen met een modeldefinitie waarin we een dropout-laag toevoegen.
# Define the CNN With Dropout
class CNNWithDropout(nn.Module):
   def __init__(self):
       super(CNNWithDropout, self).__init__()
       self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
       self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
       self.dropout = nn.Dropout(p=0.5)  # Dropout layer with 50% probability
       self.fc1 = nn.Linear(64 * 7 * 7, 128)
       self.fc2 = nn.Linear(128, 10)

   def forward(self, x):
       x = self.pool(torch.relu(self.conv1(x)))
       x = self.pool(torch.relu(self.conv2(x)))
       x = x.view(-1, 64 * 7 * 7)
       x = self.dropout(torch.relu(self.fc1(x)))  # Apply dropout after ReLU activation
       x = self.fc2(x)
       return x

model_with_dropout = CNNWithDropout()
Let op de codewijziging: er zijn twee nieuwe regels toegevoegd die de dropout-lagen aan de modeldefinitie toevoegen. Ja, het toevoegen van dropout-lagen is zo simpel als een paar regels code met de relevante functie in PyTorch.
We houden de verliesfunctie en optimizer hetzelfde als bij het basismodel.
criterion = nn.CrossEntropyLoss()
optimizer_with_dropout = optim.SGD(model_with_dropout.parameters(), lr=0.01, momentum=0.9)Vervolgens trainen we het model met dropout door de eerder geschreven functies te hergebruiken en leggen we de trainings- en validatiemetrics vast.
train_losses_with_dropout, val_losses_with_dropout, train_accuracies_with_dropout, val_accuracies_with_dropout = train_validate_model(
   model_with_dropout, train_loader, val_loader, criterion, optimizer_with_dropout
)
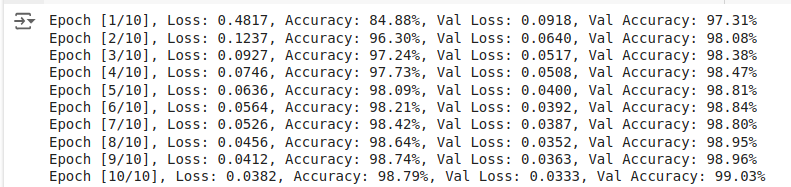
De resulterende trainings- en validatiescores zijn:
Uitvoer: trainings- en validatiemetrics.
Vergeleken met het model met dropout behaalt het model zonder dropout een hogere trainingsnauwkeurigheid en lagere training loss. Dat is te verwachten, omdat dropout tijdens het trainen ruis introduceert, waardoor het lastiger wordt voor het model om de trainingsdata perfect te fitten.
Ondanks de daling in trainingsscores is de validatienauwkeurigheid van het model met dropout toegenomen.
Tijdens evaluatiefases (inclusief validatie) staan dropout-lagen uit. Dat betekent dat alle units actief zijn en er geen inputs worden gedropt.
In PyTorch schakel je tussen train- en eval-modus met respectievelijk model.train() en model.eval():
model.train(): zet het model in trainingsmodus en activeert dropout en andere trainingsspecifieke gedragingen zoals batch-normalisatie.model.eval(): zet het model in evaluatiemodus, deactiveert dropout en gebruikt het volledige netwerk voor voorspellingen.Laten we de testnauwkeurigheid berekenen:
accuracy_with_dropout = evaluate_model(model_with_dropout, test_loader, criterion)
print(f'Accuracy of the model with dropout on the test images: {accuracy_with_dropout:.2f}%')
De resulterende nauwkeurigheid is als volgt:
Uitvoer: nauwkeurigheid op de testafbeeldingen.
We behalen 99,12% nauwkeurigheid, net iets beter dan bij het model zonder dropout.
Omdat we alle metrics tijdens onze training-, validatie- en evaluatiefase hebben opgeslagen, zetten we ze met Matplotlib in grafieken om ze beter te analyseren.
De code daarvoor is als volgt:
# Plotting the Results
plt.figure(figsize=(14, 10))

# Plot training loss
plt.subplot(2, 2, 1)
plt.plot(train_losses_without_dropout, label='Without Dropout')
plt.plot(train_losses_with_dropout, label='With Dropout')
plt.title('Training Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot validation loss
plt.subplot(2, 2, 2)
plt.plot(val_losses_without_dropout, label='Without Dropout')
plt.plot(val_losses_with_dropout, label='With Dropout')
plt.title('Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()

# Plot training accuracy
plt.subplot(2, 2, 3)
plt.plot(train_accuracies_without_dropout, label='Without Dropout')
plt.plot(train_accuracies_with_dropout, label='With Dropout')
plt.title('Training Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

# Plot validation accuracy
plt.subplot(2, 2, 4)
plt.plot(val_accuracies_without_dropout, label='Without Dropout')
plt.plot(val_accuracies_with_dropout, label='With Dropout')
plt.title('Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy (%)')
plt.legend()

plt.tight_layout()
plt.show()
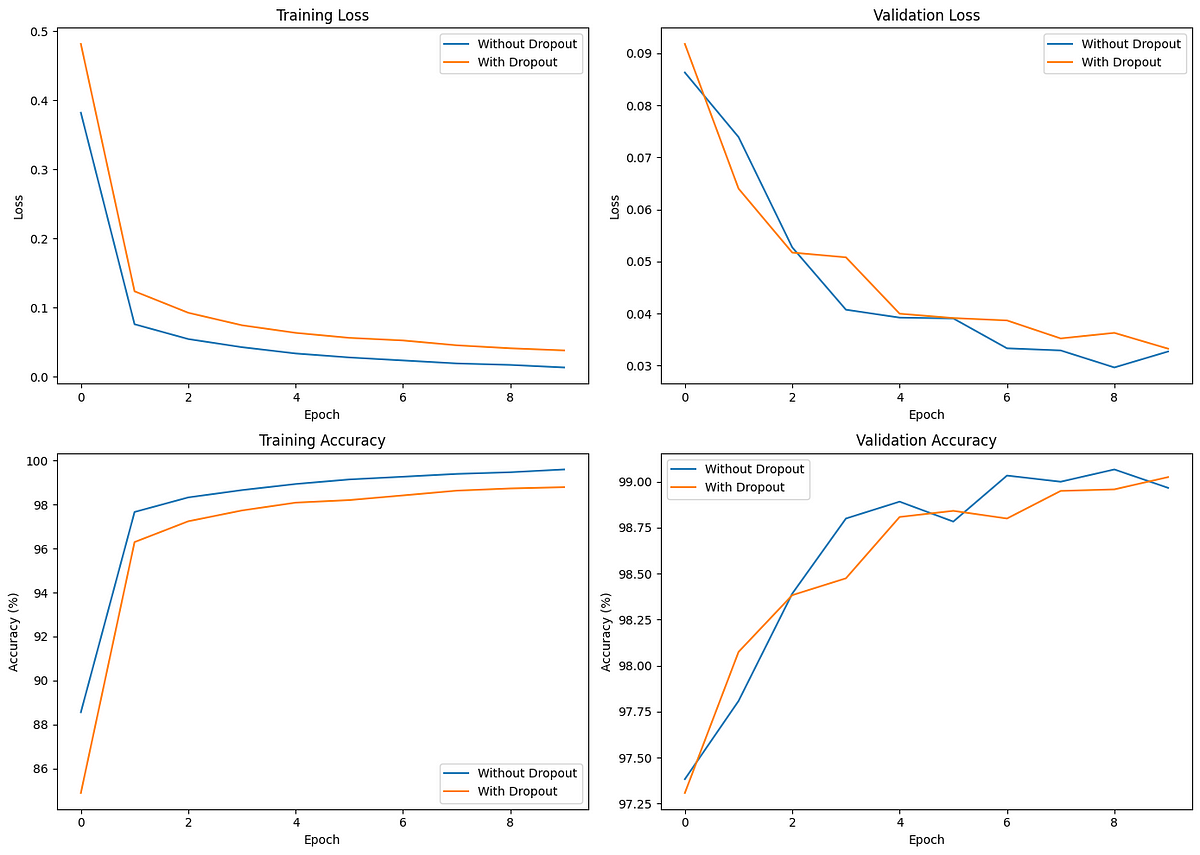
De vergelijkingsplots zijn als volgt:
Het effect van dropout op training en validatie vergelijken.
Het initiële trainingverlies is lager voor het model zonder dropout, wat wijst op snellere convergentie. Het model met dropout laat echter consistentere validatie-loss en -nauwkeurigheid zien, wat wijst op betere generalisatie.
Uit deze grafieken blijkt dat het model met dropout een iets hogere validatienauwkeurigheid (en testnauwkeurigheid) behaalt dan het model zonder dropout, ondanks de lagere trainingsnauwkeurigheid van het model met dropout.
Dropout helpt overfitting te voorkomen, zoals te zien is aan het kleinere gat tussen training- en validatieprestaties. Hoewel het verschil in ons voorbeeld klein is, wordt het steeds belangrijker bij het trainen van complexere en grotere modellen.
Hier zijn enkele handige tips wanneer je deep-learningmodellen traint met Dropout:
Als je met deep learning werkt, is het de moeite waard om het originele onderzoek “Improving Neural Networks by Preventing Co-adaptation of Feature Detectors” te lezen. De auteurs bespreken daarin meerdere aanvullende, nuttige richtlijnen op basis van hun experimenten.
Overfitting op de trainingsdata is een veelvoorkomend probleem in neurale netwerken, vooral bij grotere modellen die langer worden getraind. Regularisatietechnieken, zoals dropout, voorkomen dat neurale netwerken de trainingsdata uit het hoofd leren en helpen ze om nuttige patronen in de data beter te leren.
Deze tutorial introduceerde het concept van dropout-regularisatie, legde uit waarom we het nodig hebben en implementeerde het met PyTorch aan de hand van een voorbeeld. We hebben ook enkele geavanceerde best practices en tips geleerd om dropout effectief te gebruiken in deep neural networks.
Wil je meer leren over het gebruik van PyTorch voor deep-learningtaken, bekijk dan de beginnersvriendelijke cursus Introduction to Deep Learning with PyTorch en daarna de cursus Intermediate Deep Learning with PyTorch.
Leer PyTorch met DataCamp
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min

