
Cours
Créer des agents IA avec Google ADK
1 h
7.5K
Même si les modèles de génération d’images ont énormément progressé, ils pêchaient jusqu’ici sur un point : l’édition d’images. Apporter des modifications précises au texte, remplacer des couleurs, changer de style, varier les angles de prise de vue ou conserver des personnages cohérents d’une génération à l’autre : autant de cas d’usage très demandés, qu’aucun modèle ne maîtrisait vraiment de bout en bout. Jusqu’à ce que Google publie le modèle Gemini 2.5 Flash Image et change la donne avec une approche d’édition conversationnelle.
Dans ce tutoriel, vous allez apprendre à configurer et utiliser Gemini 2.5 Flash Image en Python, à maîtriser des techniques de prompt spécifiques selon les styles visuels, et à exploiter des fonctionnalités avancées comme la composition multi‑images et la cohérence des personnages. À la fin, vous disposerez d’outils concrets pour des workflows de génération d’images professionnels.
Mise à jour : entre‑temps, Google a publié une version actualisée du modèle. Nous vous recommandons vivement de consulter notre guide Nano Banana 2 pour découvrir les nouveautés.
Si vous souhaitez explorer d’autres outils Google de génération d’images par l’IA, consultez aussi notre guide complet d’Imagen 3, qui présente une API alternative avec d’autres atouts et une tarification différente. Vous pouvez également lire notre guide Gemini 2.5 Computer Use pour voir comment le modèle peut « voir » votre écran et y agir de manière autonome, ainsi que les dernières infos sur Gemini 3 Pro.
Enfin, consultez aussi notre guide ChatGPT Images, un nouveau concurrent de Nano Banana Pro.
La plupart des modèles de génération d’images produisent d’excellents visuels à partir de prompts textuels, mais peinent à les modifier. Si vous voulez changer l’éclairage d’une photo, vous devez souvent repartir de zéro. Si vous avez besoin d’un même personnage dans différentes scènes, la plupart des modèles peinent à conserver une apparence cohérente. Résultat : ces outils sont moins pratiques pour des projets réels où des retouches et itérations sont nécessaires.
Gemini 2.5 Flash Image résout ces problèmes d’édition. Google a conçu ce modèle avec des fonctionnalités pensées pour les tâches qui posent problème aux autres :
Ces capacités s’articulent pour offrir un système de génération d’images plus flexible. Voici comment la cohérence des personnages fonctionne en pratique :
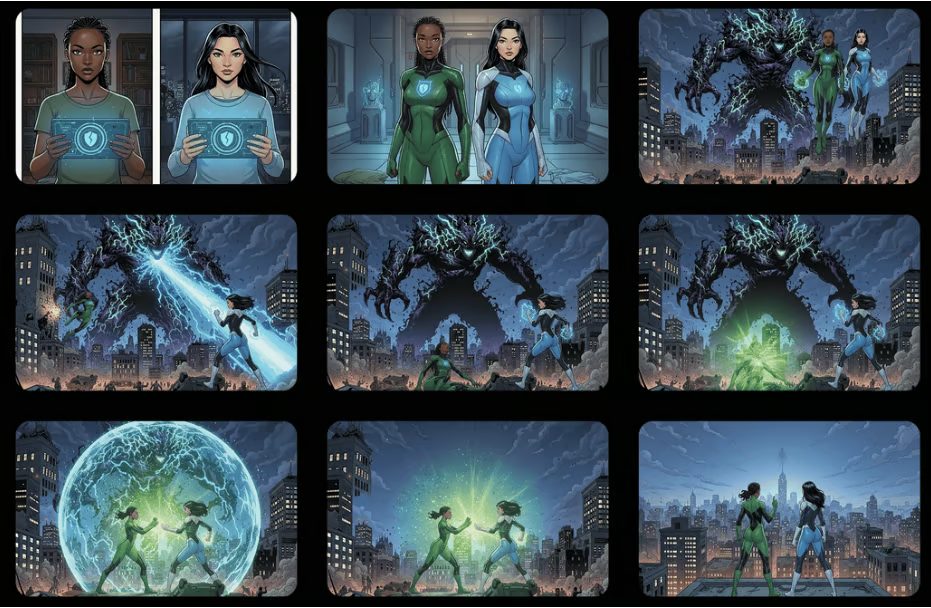
Cohérence des personnages : les mêmes personnages de dessin animé apparaissent de façon cohérente dans différentes scènes, préservant leur identité visuelle tout en s’adaptant à de nouveaux contextes.
Google a évalué ce modèle sur les benchmarks LMArena, où l’équipe l’appelait en interne « nano banana ». Les résultats montrent de meilleures performances que les modèles leaders, notamment sur l’édition d’images. Le modèle génère aussi des images plus vite que la plupart des concurrents. La vitesse varie selon la complexité de l’image et des retouches demandées.
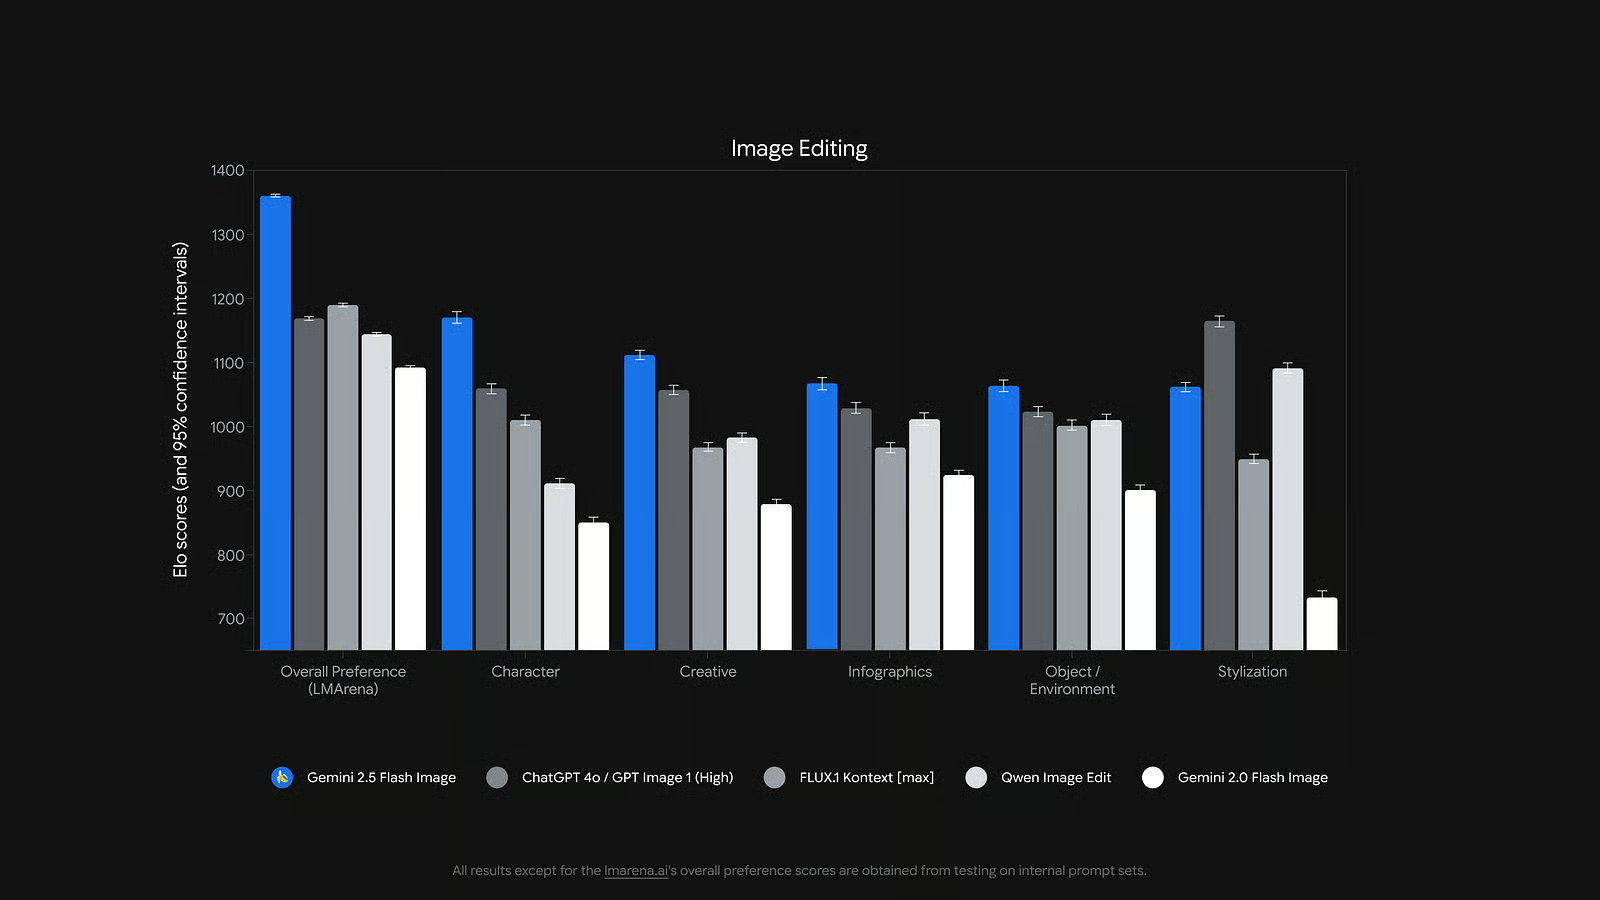
Benchmarks de performance : Gemini 2.5 Flash Image affiche des performances supérieures sur les tâches d’édition d’images par rapport aux principaux modèles de génération d’images par l’IA.
La tarification fonctionne différemment des autres modèles d’images. Au lieu de payer à l’image, vous payez au token. Chaque image consomme environ 1 290 tokens, pour un coût proche de 0,039 $. Le tarif est de 30 $ par million de tokens. La génération d’une nouvelle image et l’édition consomment la même quantité de tokens, ce qui rend le coût prévisible, que vous partiez de zéro ou effectuiez des modifications.
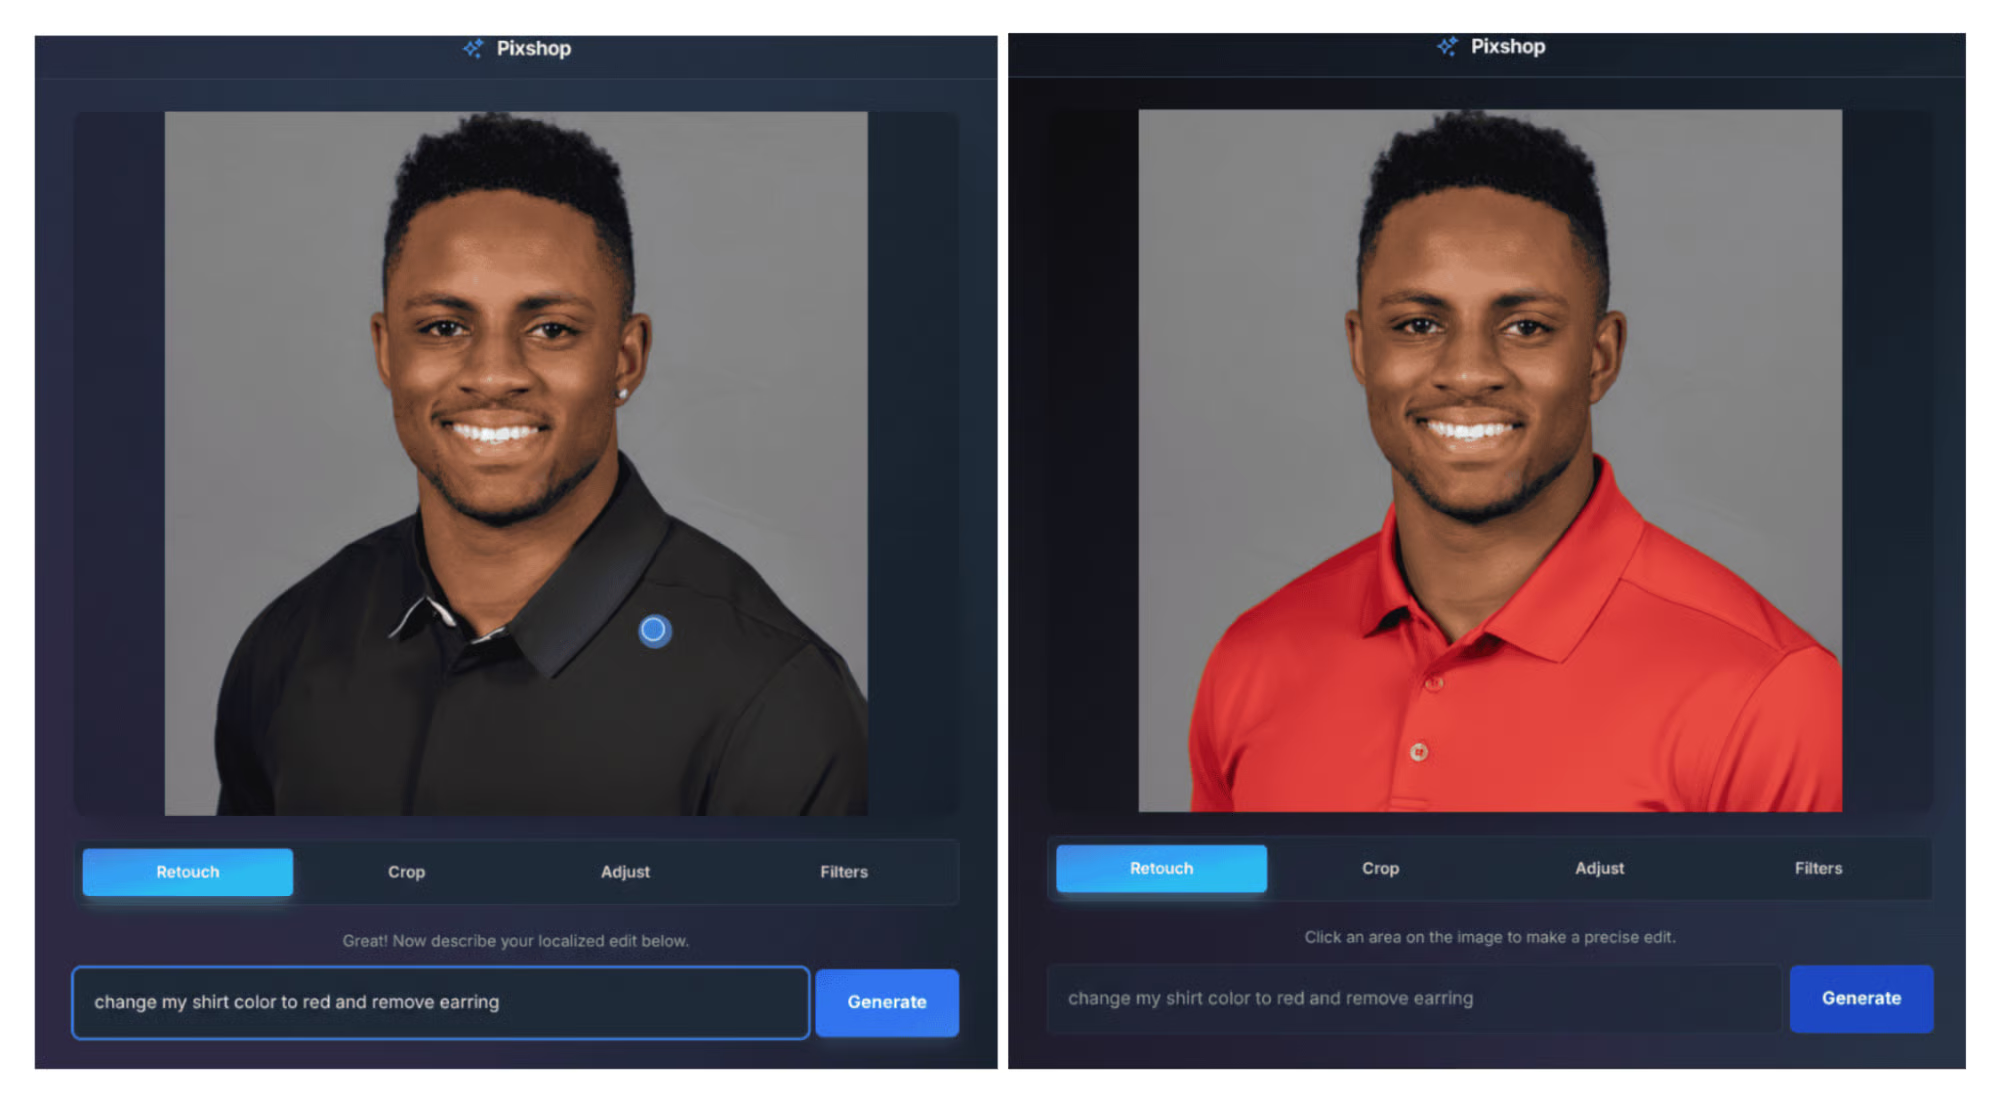
Workflow d’édition conversationnelle : exemples de modifications précises réalisées via des instructions en langage naturel, illustrant la capacité du modèle à apporter des changements ciblés sans régénération complète.
Maintenant que vous savez ce qui distingue Gemini 2.5 Flash Image, passons à la prise en main. L’étape suivante consiste à préparer votre environnement de développement pour pouvoir l’utiliser.
Bien que ce guide porte principalement sur l’accès à Gemini 2.5 Flash Image via l’API, vous pouvez aussi générer des images avec l’outil en utilisant simplement votre compte Google.
Une fois connecté, vous pouvez accéder au modèle Nano Banana soit via Gemini, soit dans Google AI Studio. Attention : via Gemini, un filigrane apparaîtra sur vos images.
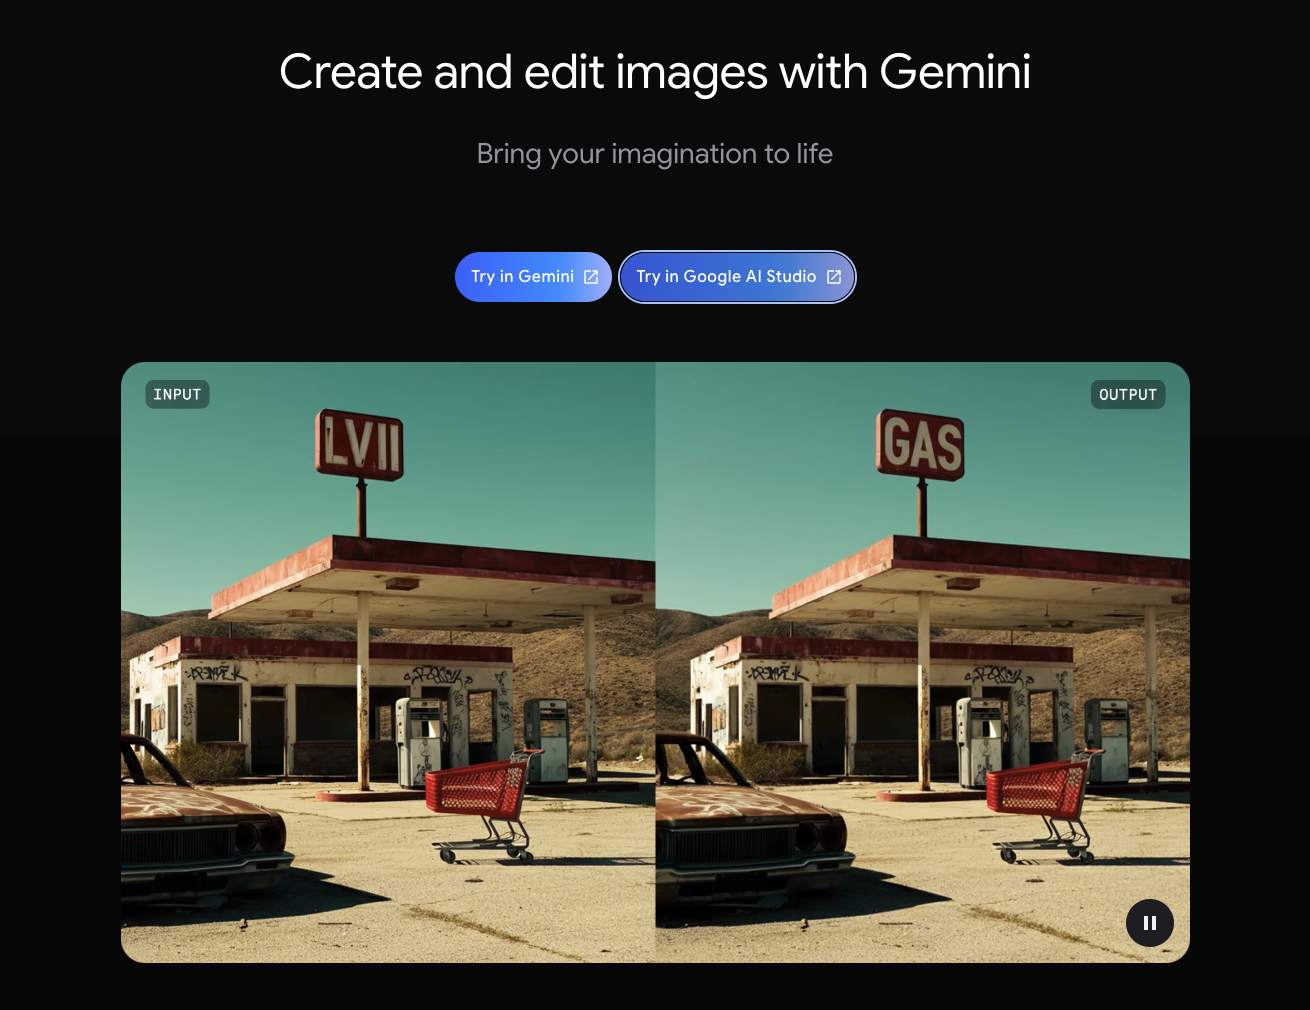
Avant de commencer à générer des images avec Gemini 2.5 Flash Image, vous devez configurer votre environnement de développement. Le processus est simple, mais l’authentification doit être correctement réalisée pour des raisons de sécurité.
Voici ce qu’il vous faut :
python --versionPour utiliser Gemini 2.5 Flash Image, vous avez besoin d’une clé API Google. Cette clé fonctionne comme un mot de passe pour accéder au service. Voici comment l’obtenir :
Google AI Studio vous demandera alors de choisir un projet. Les projets permettent d’organiser l’usage de l’API et de suivre vos quotas. Deux options s’offrent à vous :
La plupart des utilisateurs choisiront la création d’un nouveau projet. Cliquez, et Google créera automatiquement le projet et votre clé API.
4. Copiez immédiatement la clé générée — vous ne verrez plus la clé complète ensuite
5. Conservez‑la en lieu sûr — vous en aurez besoin pour la suite
Note de sécurité : traitez votre clé API comme un mot de passe. Ne la partagez pas publiquement et ne l’enregistrez pas dans du code accessible à d’autres.
Maintenant que vous avez votre clé API, configurons l’environnement Python. Créez un nouveau dossier pour ce tutoriel et installez les paquets nécessaires :
# Create project directory
mkdir gemini-image-tutorial
cd gemini-image-tutorial

# Initialize UV project
uv init

# Add required packages
uv add google-genai python-dotenv pillow
Voici le rôle de chaque paquet :
google-genai : client officiel pour dialoguer avec Geminipython-dotenv : sécurise l’utilisation de votre clé APIpillow : gère les fichiers imageVous devez stocker votre clé API de façon sécurisée tout en permettant à votre code d’y accéder. La meilleure méthode consiste à utiliser des variables d’environnement via un fichier .env.
Créez un fichier .env dans le répertoire du projet :
# Create .env file
touch .env
Ouvrez le fichier .env dans un éditeur de texte et ajoutez votre clé API :
GEMINI_API_KEY=your_api_key_hereRemplacez your_api_key_here par la clé copiée depuis Google AI Studio.
Créez ensuite un fichier .gitignore pour éviter de partager par erreur votre clé si vous utilisez Git :
# Create .gitignore
echo ".env" >> .gitignore
echo "__pycache__/" >> .gitignore
echo "*.pyc" >> .gitignoreVérifions que tout fonctionne en créant un petit test. Créez un fichier nommé test_setup.py :
import os
from dotenv import load_dotenv
from google import genai

# Load environment variables
load_dotenv()

# Initialize the client
client = genai.Client(apikey=os.getenv("GEMINIAPI_KEY"))

# Test with a simple text generation
try:
   response = client.models.generate_content(
       model="gemini-2.5-flash",
       contents="Say hello in exactly 3 words"
   )
   print("✅ Setup successful!")
   print(f"Response: {response.text}")
except Exception as e:
   print("❌ Setup failed:")
   print(f"Error: {e}")
Exécutez maintenant le script de test pour valider la configuration :
uv run python test_setup.pySi tout est en ordre, vous verrez un message de succès et une courte réponse du modèle. La sortie devrait ressembler à ceci :
✅ Setup successful!
Response: Hello there everyone.
En cas d’erreur, voici les correctifs les plus courants :
.env contient bien GEMINI_API_KEY=your_actual_keyVotre clé API gratuite comporte les limites suivantes :
Ces limites conviennent parfaitement à ce tutoriel et aux petits projets. Vous pouvez suivre votre consommation à tout moment depuis le tableau de bord d’usage de Google AI Studio.
Votre environnement est prêt et testé : passons à la génération d’images. La section suivante vous guide pour créer votre première image avec Gemini 2.5 Flash Image.
Votre environnement est prêt : créons votre première image avec Gemini 2..5 Flash Image. Nous allons commencer simplement et monter en puissance pas à pas.
Chargeons d’abord les bibliothèques nécessaires et établissons la connexion à Gemini :
import os
from dotenv import load_dotenv
from google import genai
from PIL import Image
from io import BytesIO

# Load your API key from the .env file
load_dotenv()

# Create a client to talk to Gemini
client = genai.Client(apikey=os.getenv("GEMINIAPI_KEY"))
Voici le rôle de chaque import :
os : gestion des variables d’environnementload_dotenv() : lit votre clé API depuis le fichier .env genai : bibliothèque principale pour communiquer avec GeminiPIL Image et BytesIO : enregistrent les fichiers image renvoyésL’objet client est l’interface pour envoyer des requêtes à Gemini. Pensez‑y comme à votre connexion aux serveurs de Google.
Créons une image simple avec un prompt clair et descriptif :
# Write a prompt describing what you want
prompt = "A cozy coffee shop with wooden furniture and warm lighting"

# Ask Gemini to create the image
response = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[prompt]
)
La fonction generate_content() est la principale façon d’interagir avec Gemini. Explications :
model="gemini-2.5-flash-image-preview" : indique à Gemini quel modèle utiliser pour la génération d’imagescontents=[prompt] : contient votre description textuelleQuand Gemini renvoie une réponse, l’image arrive sous forme de données brutes qu’il faut convertir en fichier image. Voici comment l’extraire et l’enregistrer :
# Look through the response to find the image
for part in response.candidates[0].content.parts:
   if part.inline_data is not None:
       # Convert the raw data into an image
       image = Image.open(BytesIO(part.inline_data.data))
       # Save it as a PNG file
       image.save("myfirstimage.png")
       print("Image saved!")
Ce code réalise plusieurs opérations clés :
response.candidates[0] : récupère la première (et généralement unique) réponse de Geminicontent.parts : Gemini peut renvoyer plusieurs éléments : texte, images, etc.part.inline_data : contient les données binaires de l’imageBytesIO() : convertit les octets en flux lisible par PILimage.save() : enregistre l’image sur votre ordinateurMettons tout cela ensemble et exécutons le code complet. En suivant ces étapes, vous devriez voir une sortie du type :
✅ Image saved as https://cdn-images-1.medium.com/proxy/1*Hhy7vMKOurXDOPVQ6Ps0gQ.png
📏 Image size: (1024, 1024)
🎨 Image mode: RGB
Voici l’image effectivement générée à partir de notre prompt « coffee shop » :
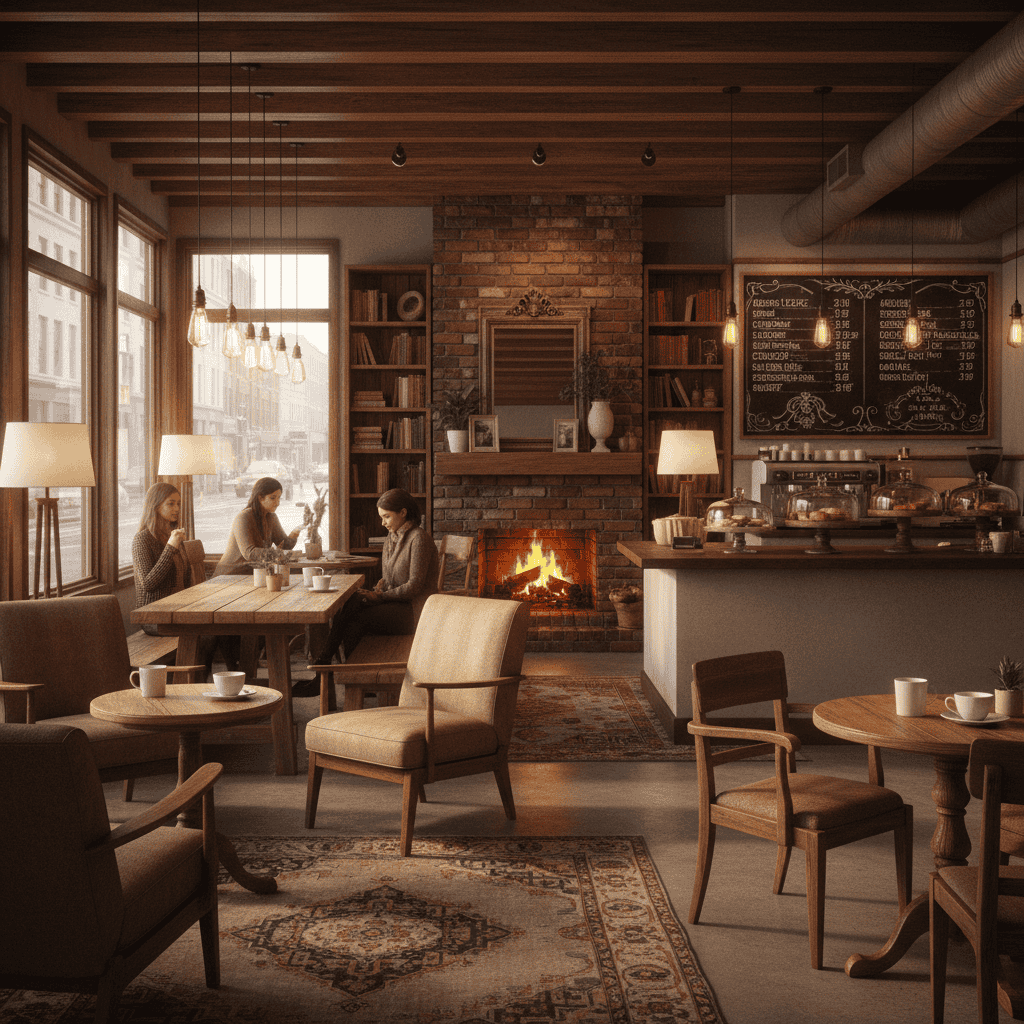
Intérieur de café chaleureux avec poutres en bois, éclairage doux, assises confortables et atmosphère accueillante, conforme à la description du prompt.
À chaque génération, Gemini vous renvoie :
La réponse peut aussi inclure du texte si Gemini souhaite expliquer des choix concernant l’image générée.
Maintenant que vous avez vu le workflow de base, testons quelques prompts pour observer la réaction du modèle selon les descriptions :
# Simple object descriptions work great
"A red bicycle in a sunny park"

# You can add details about style and mood
"A modern kitchen with clean white cabinets and natural light"

# Describe the setting and atmosphere
"A peaceful lake surrounded by mountains at sunset"
Voyons ce que ces prompts produisent concrètement :
Vélo rouge dans un parc ensoleillé :
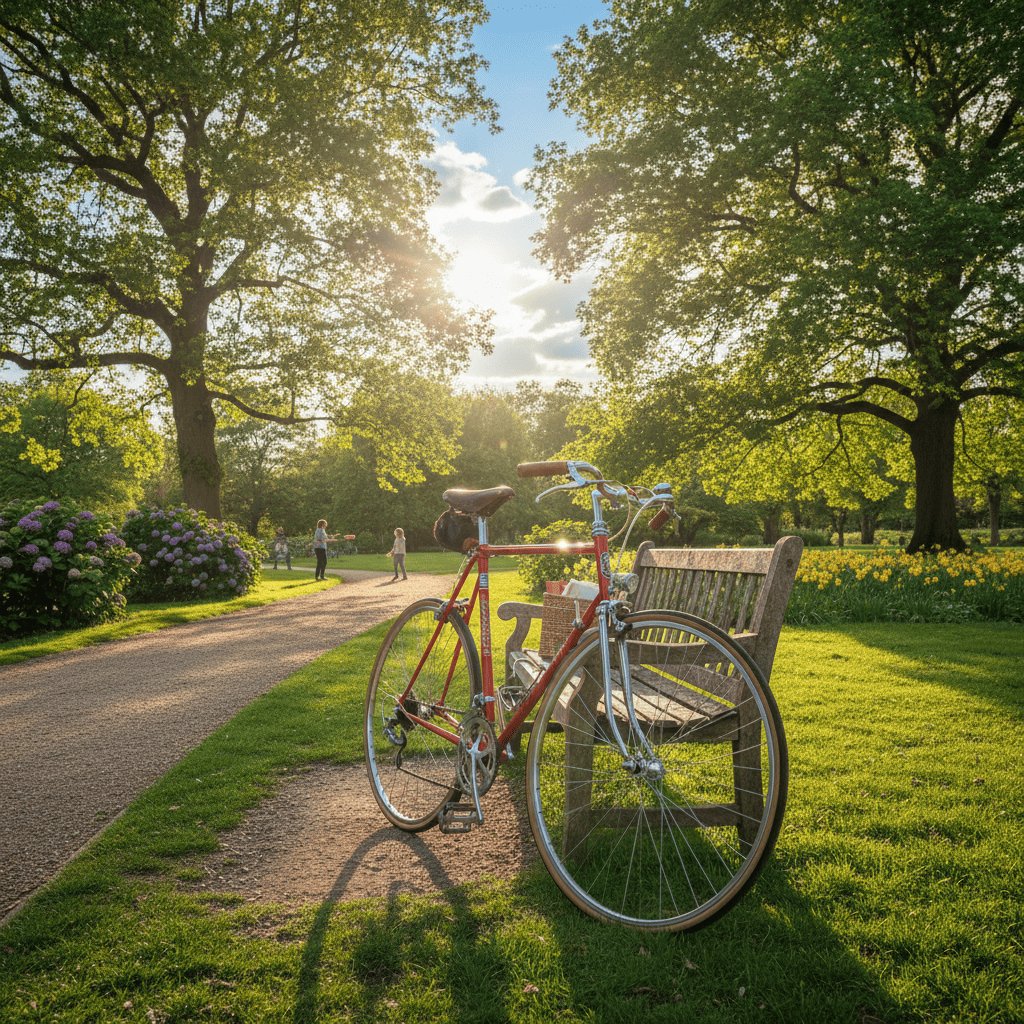
Un vélo rouge parfaitement placé dans un beau parc baigné d’une lumière dorée, avec une végétation luxuriante et un banc paisible. Notez les ombres : comme sur une vraie photo, elles se déforment lorsque la surface passe du sol à l’herbe.
Cuisine moderne aux placards blancs :
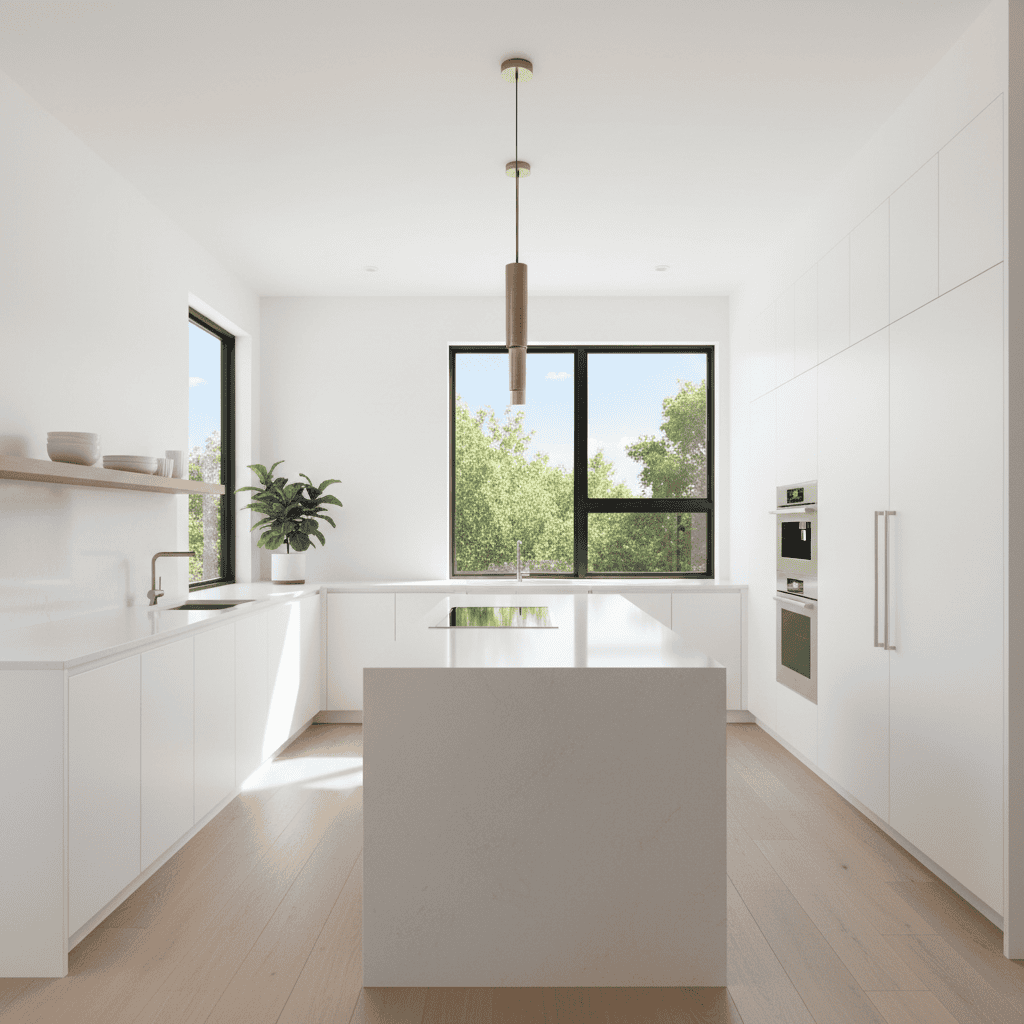
Une cuisine contemporaine élégante : placards blancs immaculés, équipements modernes, et lumière naturelle entrant par de grandes fenêtres. Observez les reflets des fenêtres sur la surface du plateau central.
Lac paisible entouré de montagnes :
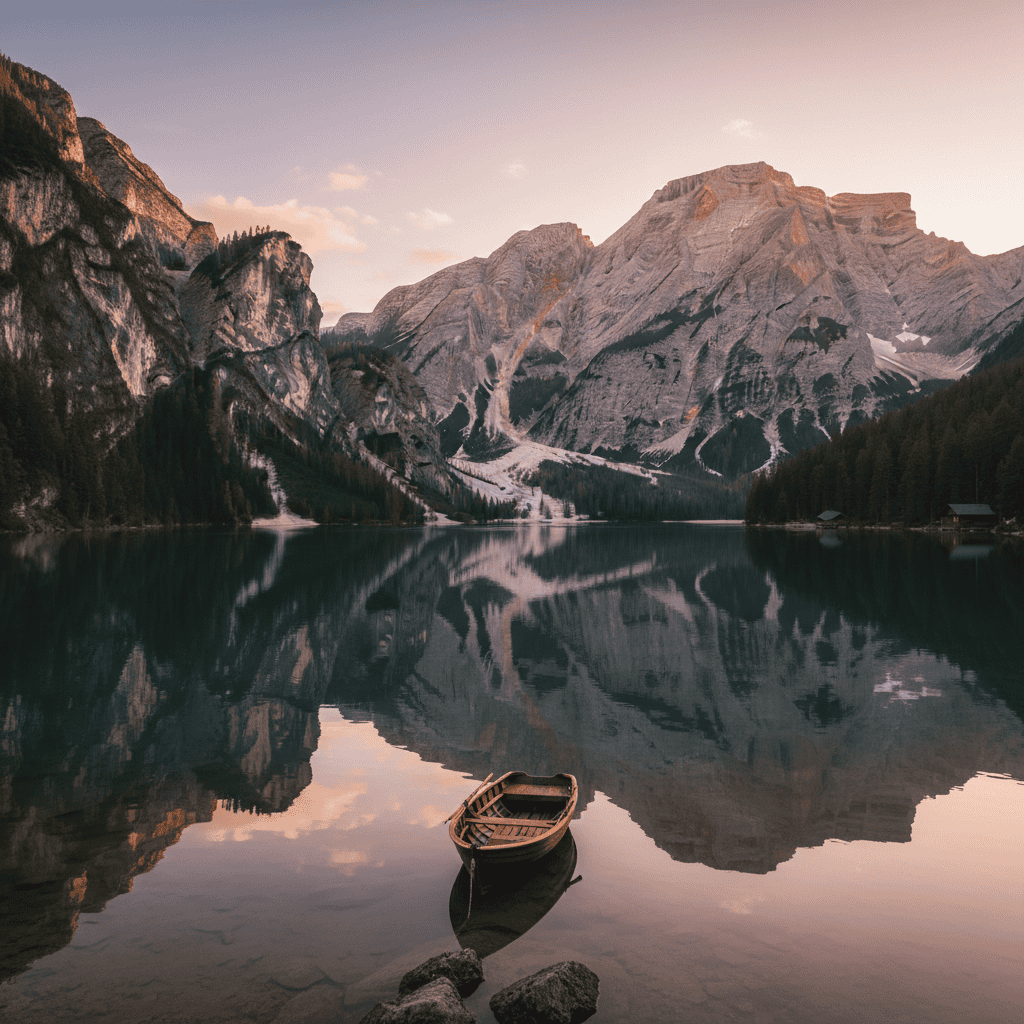
Un lac de montagne au coucher du soleil, avec des reflets parfaits, entouré de sommets dramatiques et un charmant bateau en bois au premier plan. Là encore, les reflets sur l’eau sont d’un réalisme remarquable.
Commencez par des descriptions claires et simples. Vous pourrez toujours affiner au fil de votre prise en main du modèle.
Ces exemples illustrent le flux standard, mais vous pourriez rencontrer quelques soucis. Voici comment traiter les problèmes les plus fréquents :
La prochaine section vous apprendra à rédiger de meilleurs prompts pour contrôler plus finement vos résultats.
Maintenant que vous savez générer des images, apprenons à écrire des prompts qui vous donnent davantage de contrôle. L’essentiel : être précis sur ce que vous voulez, et comprendre comment chaque technique influence le rendu final.
Pour aller plus loin sur les fondamentaux du prompt engineering, tous modèles confondus, notre guide complet du prompt engineering pour 2025 couvre les dernières techniques et stratégies pour le texte comme pour le visuel.
Le processus manuel de la section précédente convient pour débuter, mais le répéter à chaque image devient vite fastidieux. Avant d’aborder les techniques, créons une fonction utilitaire qui simplifie tout :
def generateandsave_image(prompt, filename):
   """
   Generate an image and save it to the images folder

   Args:
       prompt (str): Description of what you want to create
       filename (str): Name for the saved image file

   Returns:
       bool: True if successful, False otherwise
   """
   try:
       response = client.models.generate_content(
           model="gemini-2.5-flash-image-preview",
           contents=[prompt]
       )

       # Find and save the image
       for part in response.candidates[0].content.parts:
           if part.inline_data is not None:
               image = Image.open(BytesIO(part.inline_data.data))
               image.save(f"images/{filename}")
               print(f"✅ Image saved as images/{filename}")
               return True

   except Exception as e:
       print(f"❌ Error: {e}")
       return False

   return False
Cette fonction se charge pour vous de générer et d’enregistrer l’image. Vous pouvez ainsi vous concentrer sur l’écriture de meilleurs prompts au lieu de répéter le même code.
Utilisation :
# Simple function call
generateandsave_image("A cozy reading nook", "readingnook.png")
Beaucoup plus propre que de réécrire le code complet à chaque fois !
Le meilleur moyen d’améliorer vos prompts : ajouter des détails précis. Comparons un prompt générique et un prompt détaillé.
Prompt générique :
generateandsave_image("A kitchen", "generickitchen.png")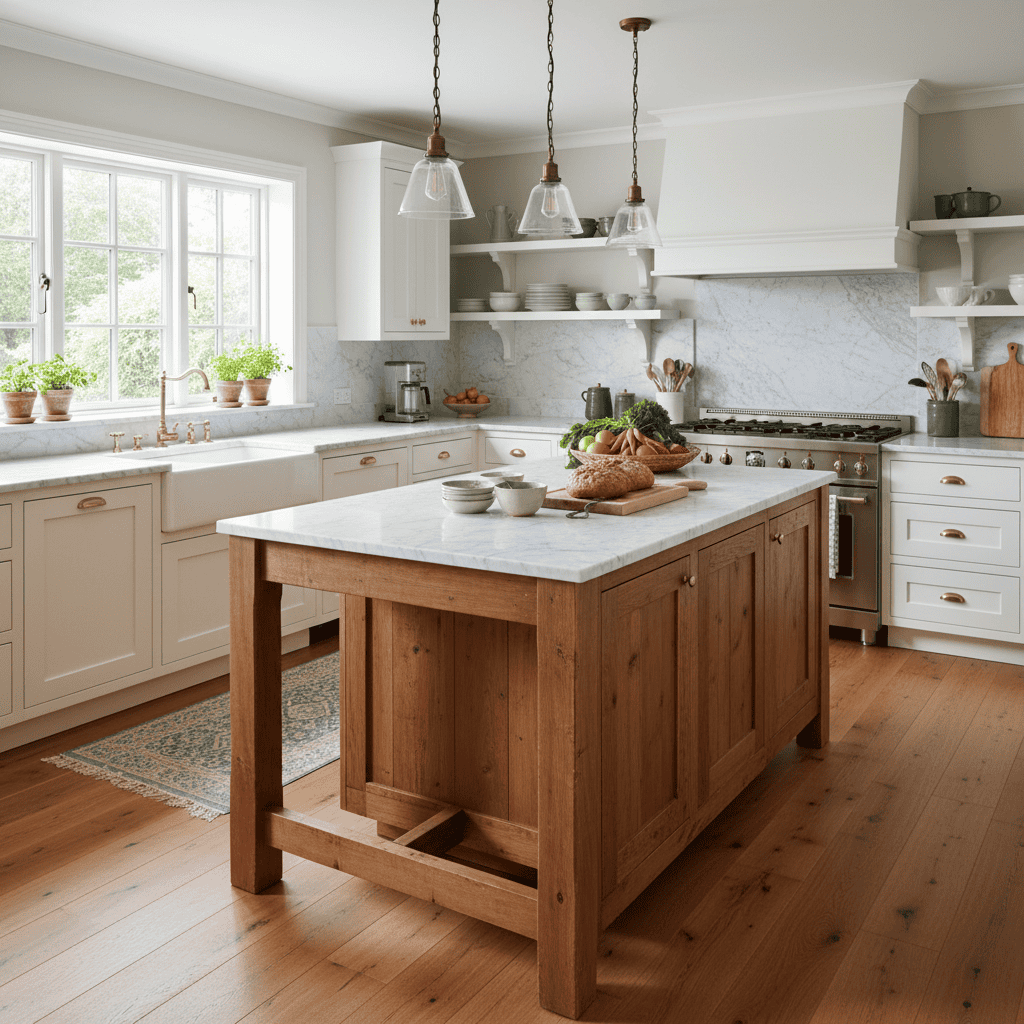
Résultat d’un prompt générique : une cuisine basique, standardisée, sans caractère distinctif.
Essayons maintenant le même concept avec des détails précis :
generateandsave_image(
   "Modern minimalist kitchen, white quartz countertops, stainless steel appliances, pendant lights, natural oak floors",
   "specific_kitchen.png"
)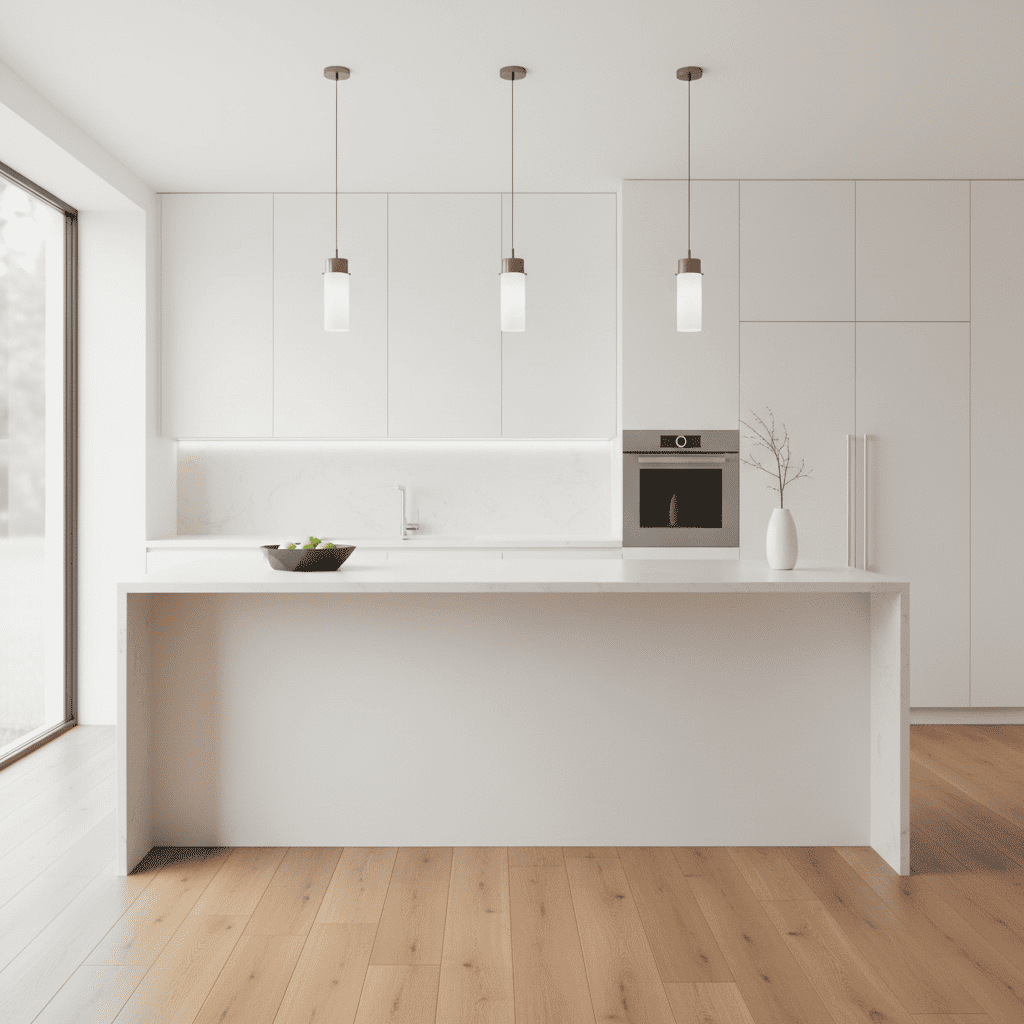
Résultat d’un prompt spécifique : une cuisine précisément conçue, avec exactement les éléments demandés, pour un rendu moderne et cohérent.
La différence est nette. Le prompt détaillé produit une cuisine professionnelle correspondant à votre description, tandis que le prompt générique reste imprévisible.
Si vous travaillez aussi avec d’autres modèles de génération d’images, notre guide des techniques Stable Diffusion présente des stratégies complémentaires pour améliorer vos résultats sur différentes plateformes d’IA.
Vous pouvez contrôler le cadrage avec des termes de photographie. Cela vous donne une maîtrise fine de la composition et de la perspective.
Plans grand angle : capturent davantage de la scène :
generateandsave_image(
   "Wide angle shot of modern living room, leather sofa, glass coffee table, floor to ceiling windows",
   "wideangleroom.png"
)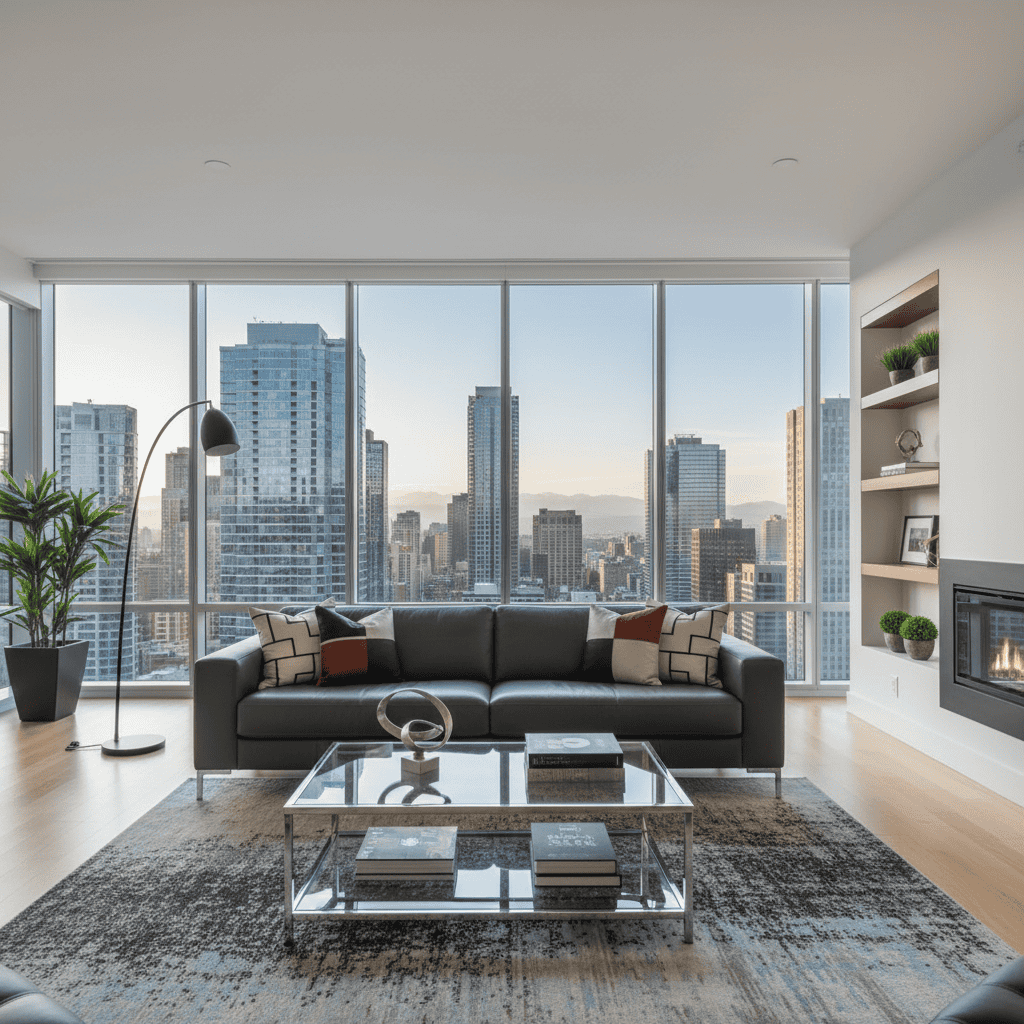
Un grand angle qui met en valeur l’ampleur de la pièce et la vue sur la ville, pour un effet plus ouvert et spectaculaire.
Macro : se concentre sur les détails :
generateandsave_image(
   "Macro shot of vintage pocket watch on mahogany desk, brass details, Roman numerals, soft lighting",
   "macro_watch.png"
)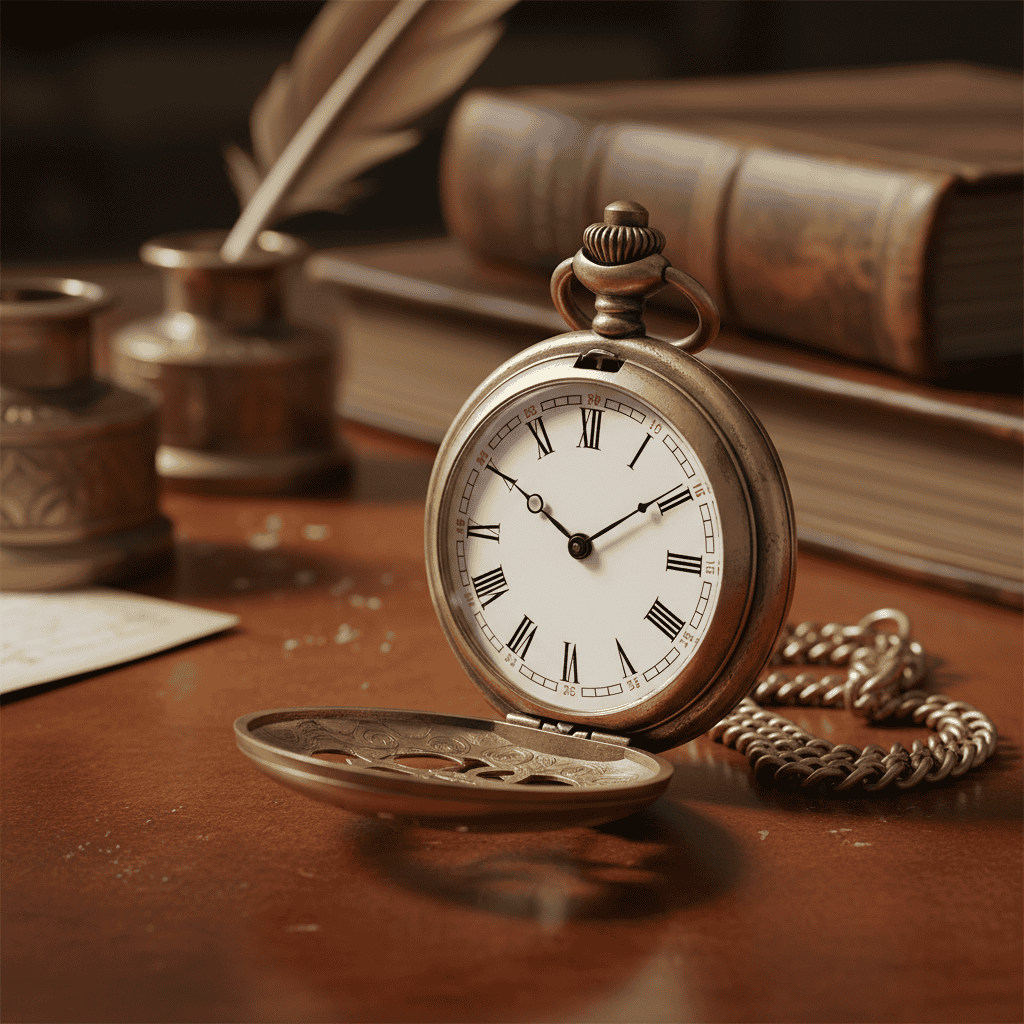
La photographie macro révèle les détails du cadran, de la chaîne et des livres anciens autour, pour une composition intime et fouillée.
Autres termes utiles :
"Low angle shot" – contre‑plongée"Bird's eye view" – vue en plongée/à vol d’oiseau"85mm portrait lens" – profondeur de champ réduite"Dutch angle" – angle incliné pour plus de tension dramatiqueLes descriptions d’éclairage transforment radicalement l’atmosphère. Voici comment créer des ambiances spécifiques.
Lumière dorée de fin de journée : chaleur et douceur :
generateandsave_image(
   "Empty park bench at golden hour, warm sunlight, long shadows, autumn leaves scattered, peaceful atmosphere",
   "goldenhourbench.png"
)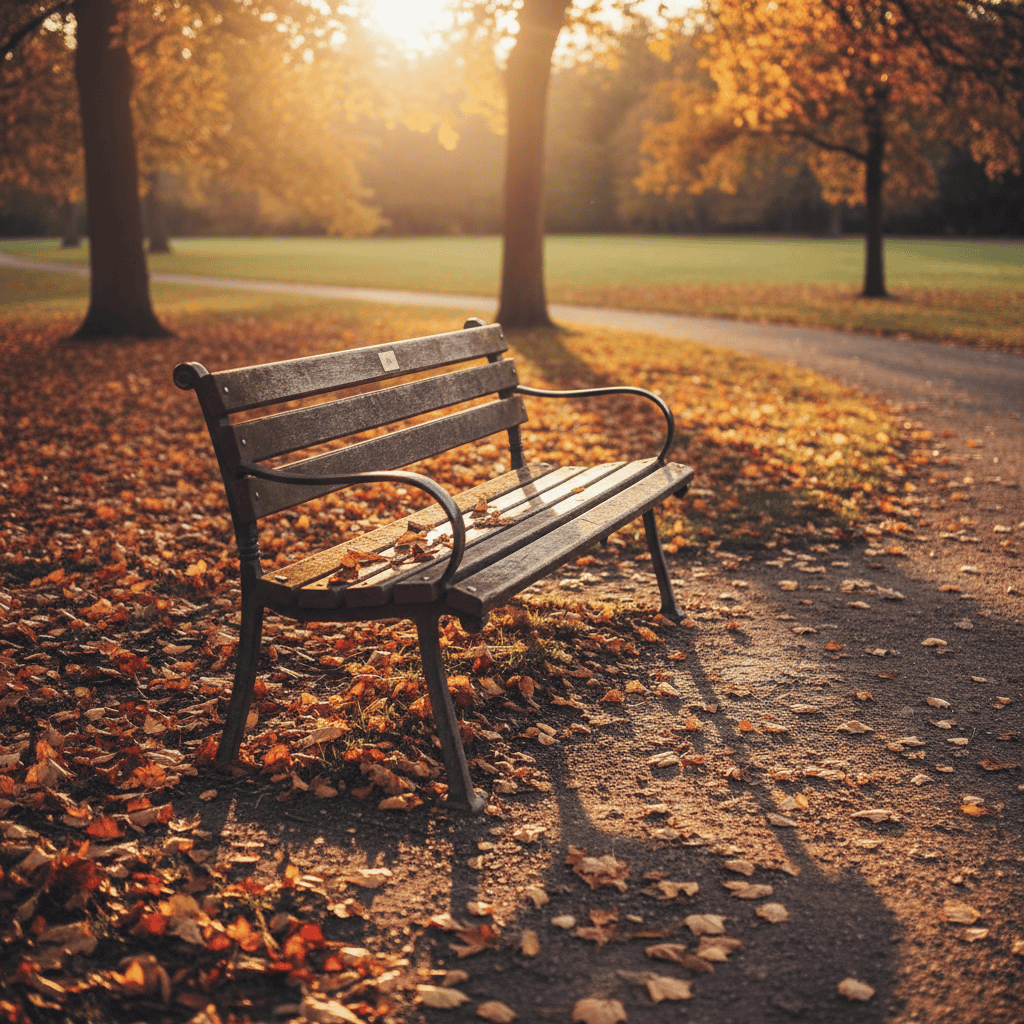
La golden hour transforme un simple banc en une scène chaleureuse, propice à la contemplation.
Éclairage dramatique : intensité et tension :
generateandsave_image(
   "Dark stormy sky over empty lighthouse, dramatic lighting, waves crashing on rocks, moody atmosphere",
   "dramatic_lighthouse.png"
)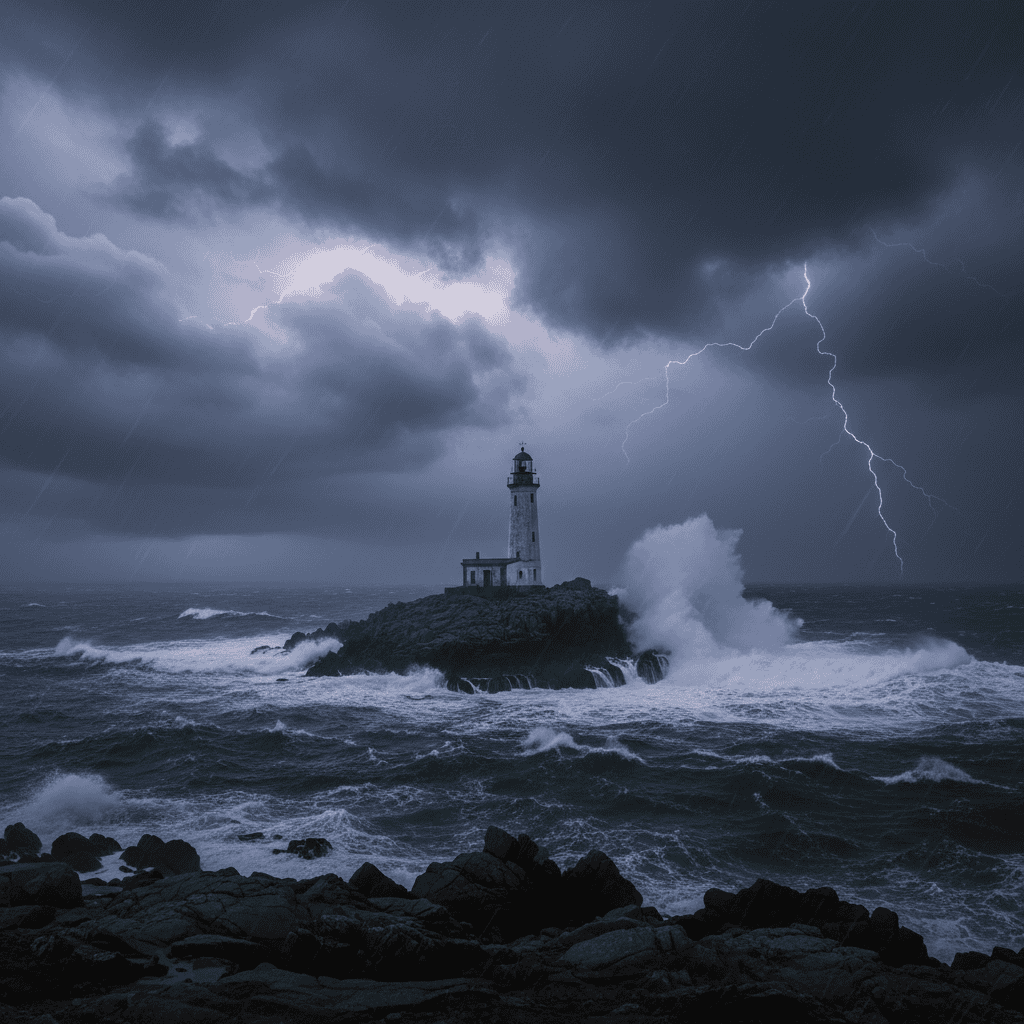
Un ciel d’orage et un éclairage dramatique créent une scène puissante, empreinte de solitude et de force.
Termes utiles pour l’éclairage :
"Soft natural light" – lumière naturelle douce et homogène"Harsh shadows" – ombres marquées, fort contraste"Backlit" – contre‑jour"Studio lighting" – éclairage studio propre et maîtriséVous pouvez guider le style artistique en intégrant des descripteurs esthétiques précis dans vos prompts.
Style minimaliste :
generateandsave_image(
   "Minimalist bedroom design, white walls, simple wooden bed frame, single potted plant, clean lines, natural light",
   "minimalist_bedroom.png"
)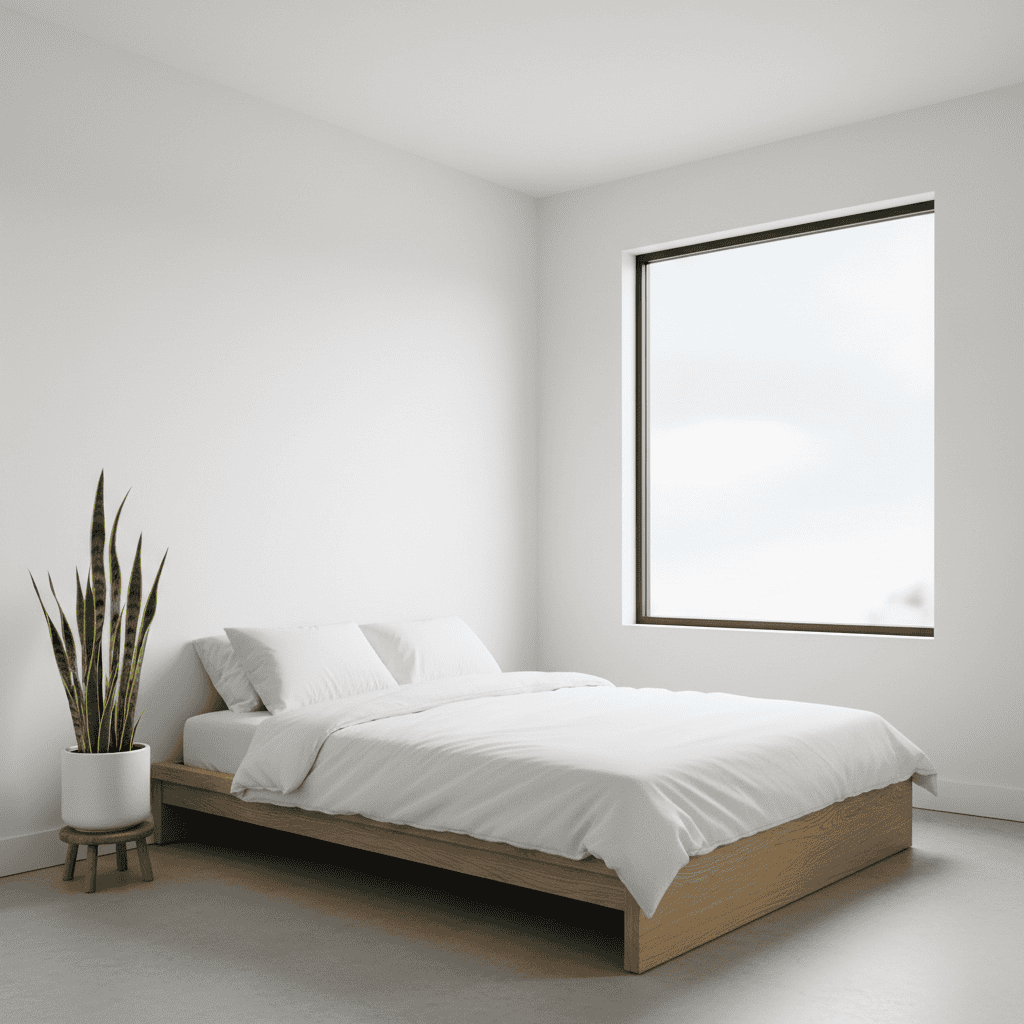
Les principes du minimalisme créent un espace apaisant, épuré, à la fois moderne et intemporel.
Style vintage :
generateandsave_image(
   "Vintage coffee shop interior, exposed brick walls, antique furniture, Edison bulb lighting, weathered wood tables, nostalgic atmosphere",
   "vintagecoffeeshop.png"
)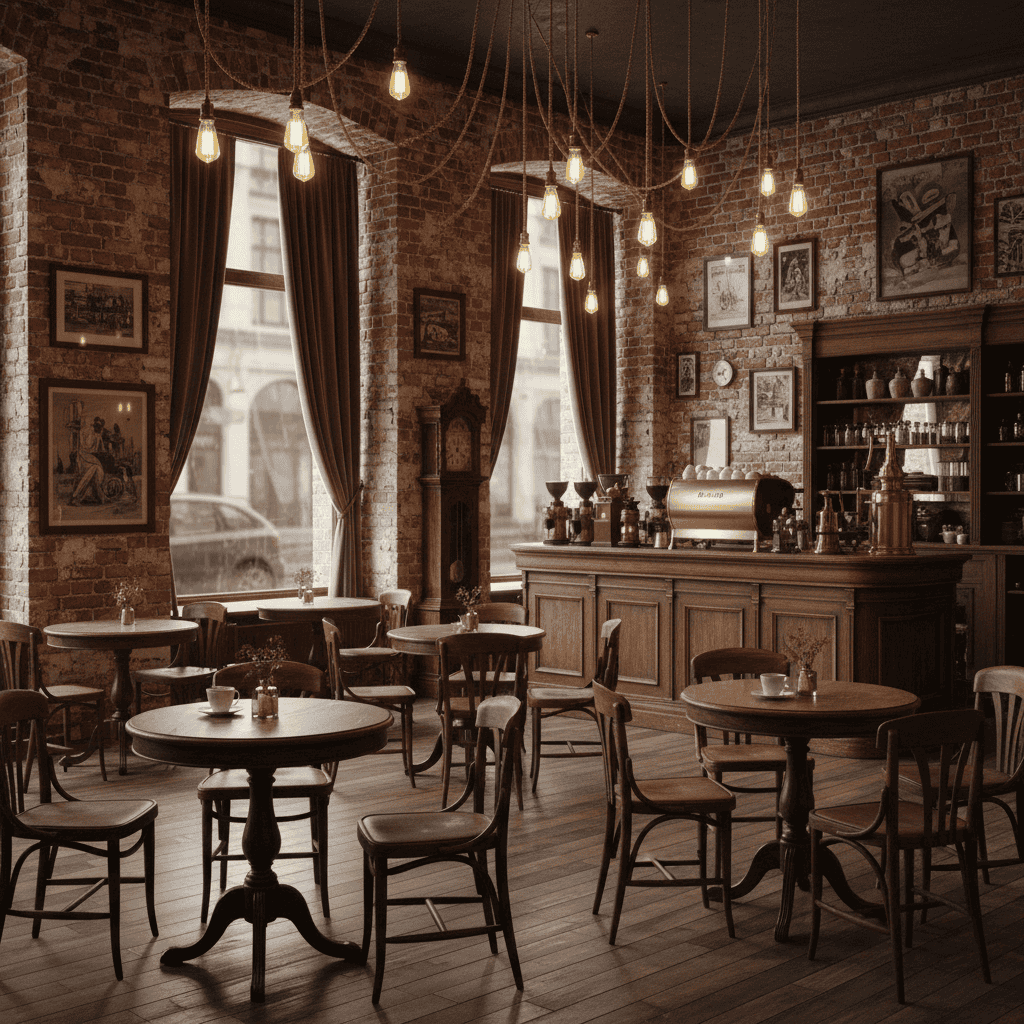
Des codes vintage cohérents pour une ambiance nostalgique et authentique.
Orientations stylistiques populaires :
"Industrial design" – matériaux bruts, éléments apparents"Scandinavian style" – bois clairs, lignes épurées, textures chaleureuses"Art deco" – motifs géométriques, accents métalliques"Rustic charm" – matériaux naturels, textures patinéesGemini 2.5 Flash Image excelle pour intégrer du texte lisible directement dans l’image. Gardez le texte court (moins de 25 caractères fonctionne le mieux) pour un rendu net.
generateandsave_image(
   "Restaurant menu board with 'DAILY SPECIALS' text, chalk lettering on black board, wooden frame, warm lighting",
   "menuboardtext.png"
)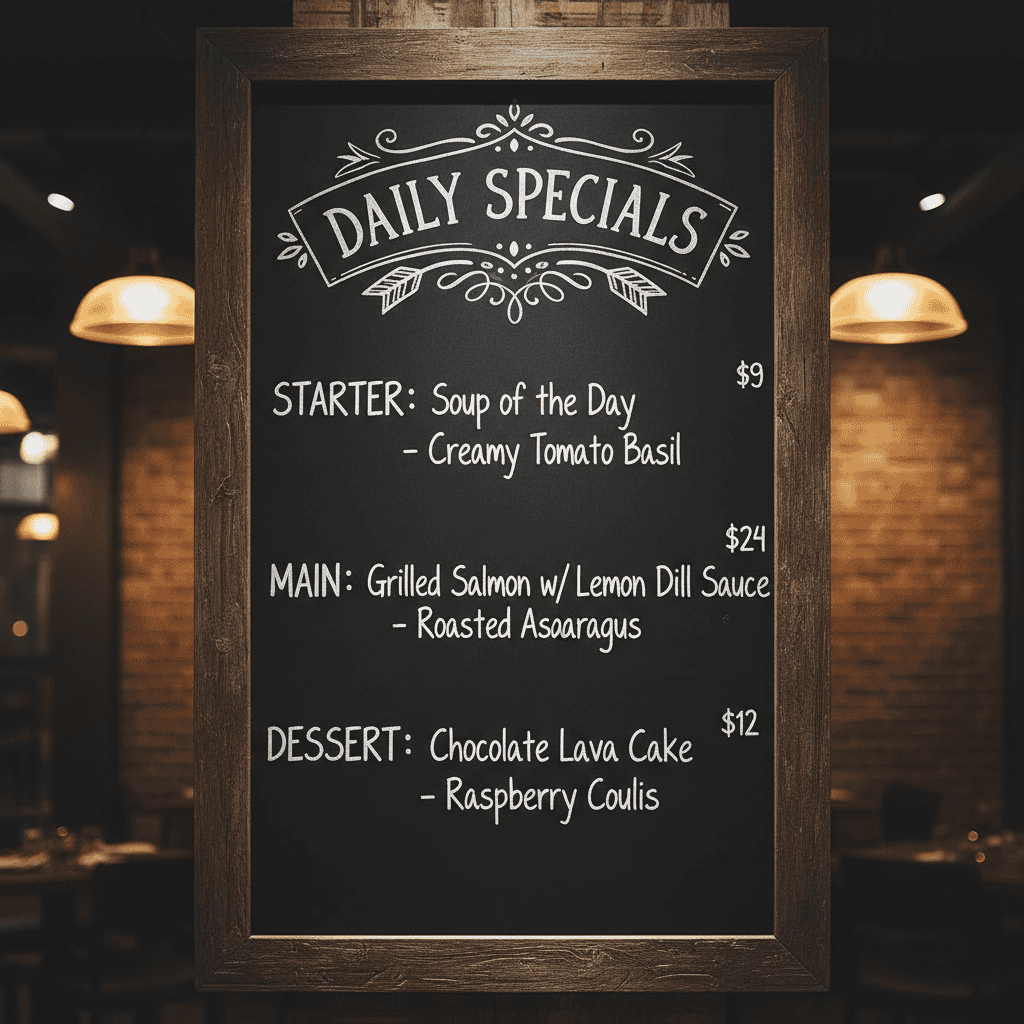
Intégration textuelle parfaite avec éléments décoratifs et prix, montrant la capacité du modèle à gérer à la fois la typographie et la mise en page du menu.
Le modèle a automatiquement ajouté des plats et des tarifs pour crédibiliser la scène. Preuve qu’il comprend le contexte et crée des compositions logiques et complètes.
Les prompts les plus puissants combinent plusieurs techniques. Voici comment superposer différents éléments :
# Combining camera control + lighting + style + specific details
generateandsave_image(
   "Low angle shot of modern office lobby, dramatic uplighting, marble floors, geometric ceiling, professional atmosphere",
   "professional_lobby.png"
)
Voici l’image résultante, qui illustre la combinaison de ces techniques :
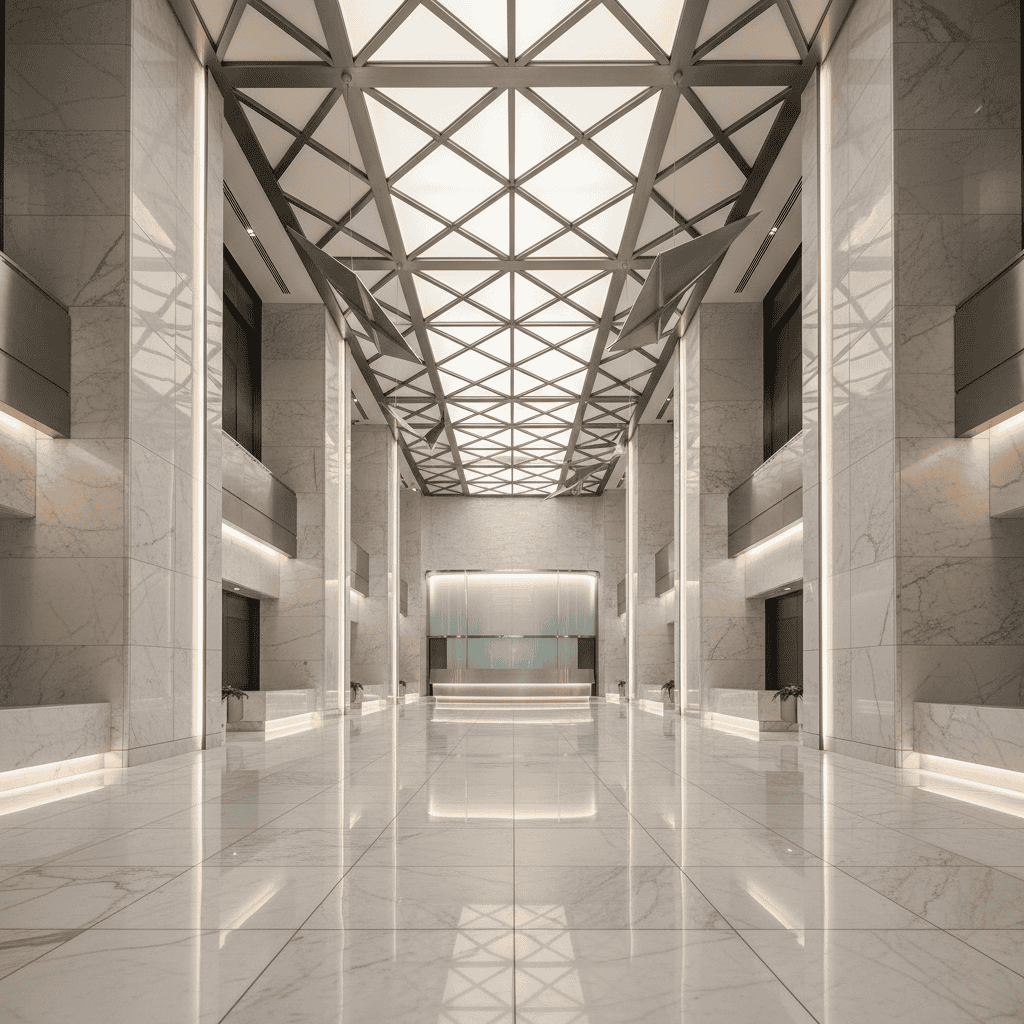
Ce prompt combine :
N’oubliez pas que vous pouvez toujours affiner vos images en décrivant les ajustements souhaités. Gemini est excellent pour les améliorations itératives — ce qui nous amène aux fonctionnalités avancées qui font sa particularité.
Si vous souhaitez situer Gemini 2.5 Flash Image par rapport aux autres outils Google, notre tutoriel Gemini 2.0 Flash explore les capacités plus larges du dernier système multimodal de Google.
Les techniques de prompt que vous venez d’apprendre constituent le socle pour des opérations plus avancées. Appliquons‑les maintenant aux fonctionnalités les plus puissantes de Gemini, celles qui le distinguent des autres modèles :
L’une des fonctions majeures est la combinaison de plusieurs images pour en créer une nouvelle. Ce n’est pas un simple « fondu » : Gemini comprend les objets et le contexte de chaque image, et les fusionne intelligemment.
Dans cet exemple, supposons que vous ayez déjà généré les éléments de base via les techniques vues plus haut. Voici comment les combiner :
# Load the base images for composition
gemstone_img = Image.open("https://cdn-images-1.medium.com/proxy/1*zy36GlKisNwsmJ0PwwHODw.png")
setting_img = Image.open("https://cdn-images-1.medium.com/proxy/1*fpNU31VkSznr1NTHbUx-mA.png")

# Compose them with specific instructions
response = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Mount the rare tanzanite gemstone perfectly into the platinum Art Nouveau setting, creating an exquisite luxury engagement ring, professional jewelry photography with dramatic lighting",
       gemstone_img,
       setting_img
   ]
)
Images de base utilisées pour la composition :
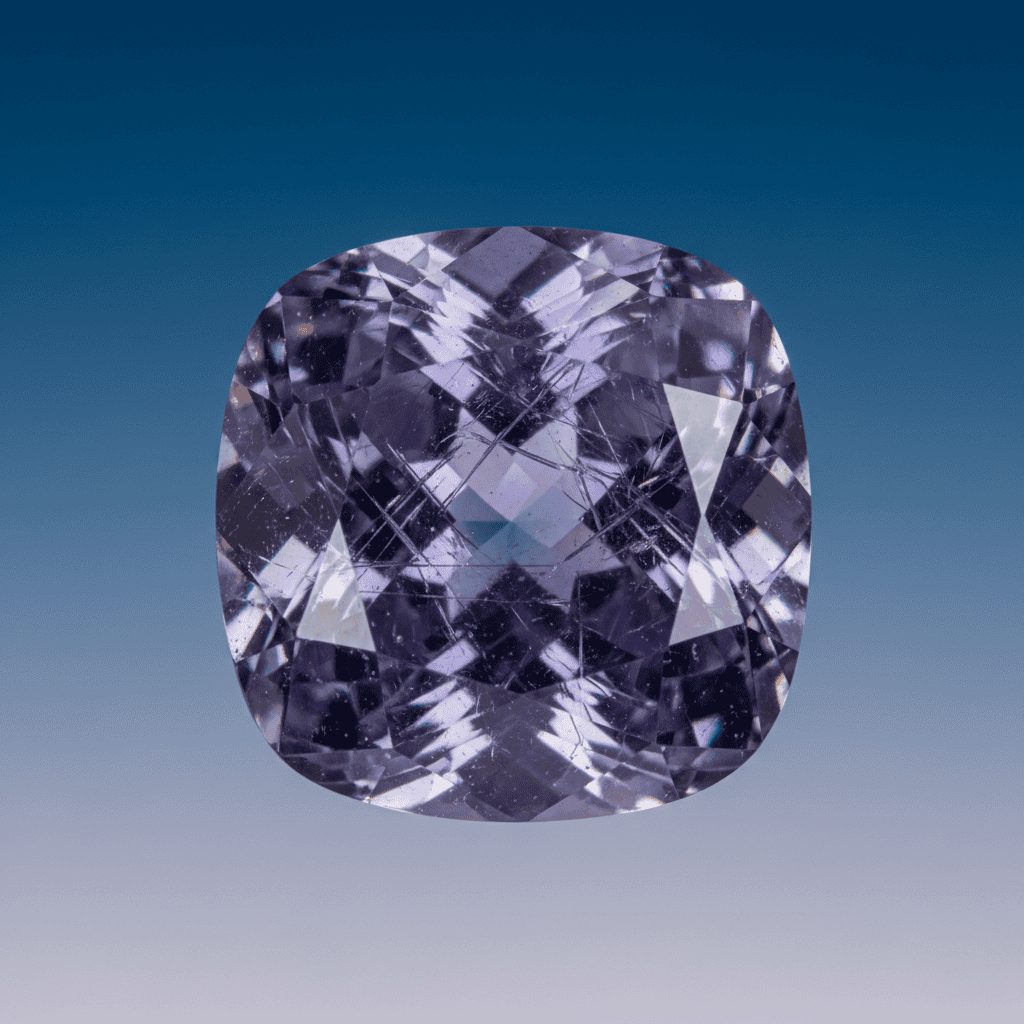
Composant 1 : tanzanite rare d’une clarté exceptionnelle, aux structures prismatiques internes.
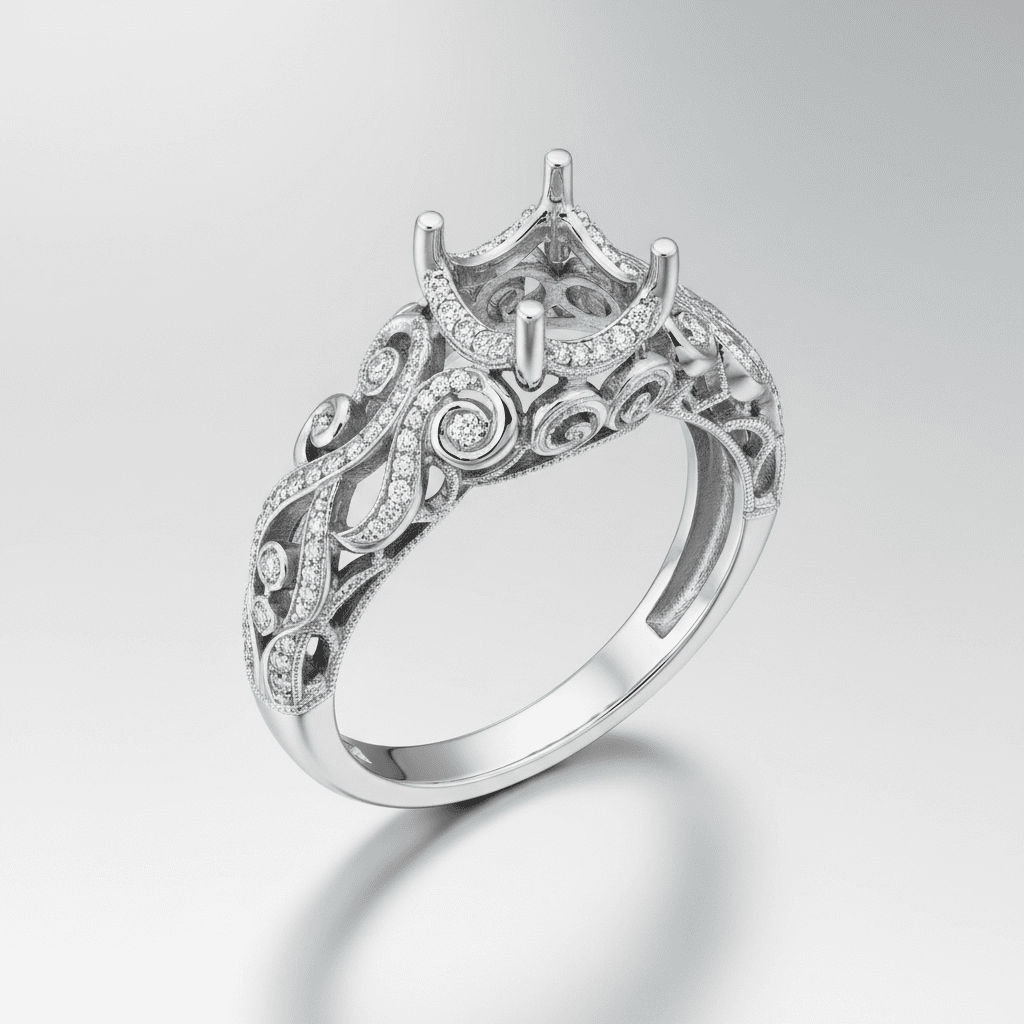
Composant 2 : monture en platine Art nouveau, au filigrane d’exception.
Résultat composé :
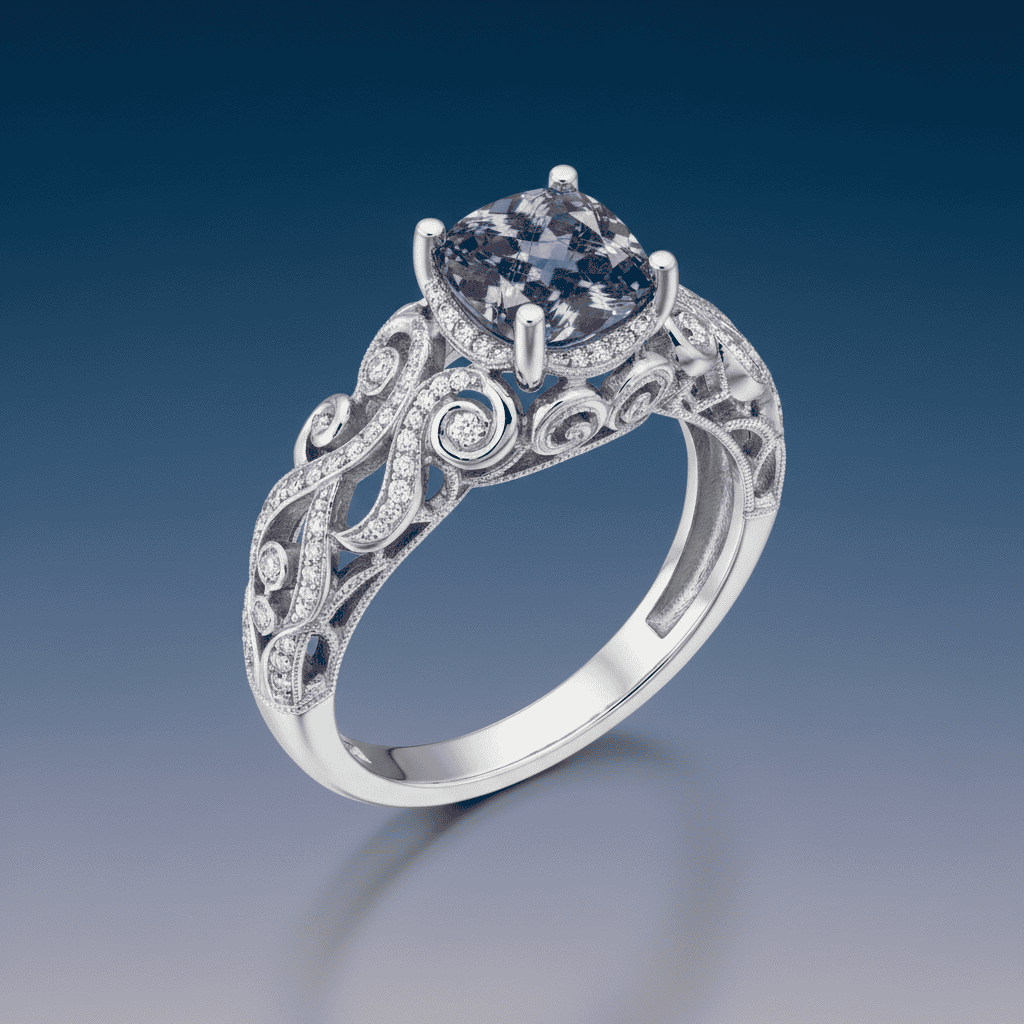
Composition finale : la pierre et la monture sont combinées de manière homogène en une pièce de joaillerie haut de gamme, avec un éclairage qui sublime chaque élément.
Le secret d’une composition professionnelle : être précis sur :
Cette technique est idéale pour :
Contrairement à la plupart des modèles qui imposent de repartir de zéro, Gemini 2.5 Flash Image permet des améliorations progressives par conversation. Idéal pour les workflows de design professionnel où l’on fait évoluer des concepts.
Exemple : développement d’équipements audio haut de gamme :
# Step 1: Start with concept design
concept_img = Image.open("https://cdn-images-1.medium.com/proxy/1*2qw1o9vPjUMHCwYnvHiYbA.png")

# Step 2: First refinement - luxury materials
response1 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Refine this speaker with premium ebony wood veneer finish, hand-polished surfaces, subtle gold accent lines, maintaining same proportions",
       concept_img
   ]
)

# Step 3: Second refinement - high-tech features
luxuryimg = Image.open("https://cdn-images-1.medium.com/proxy/1*kytHi4QRCmbor1e35Nyyw.png")

response2 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Add sophisticated LED indicators, premium fabric grille, wireless connectivity features, maintaining all luxury finishes",
       luxury_img
   ]
)
Étape 1 : concept initial
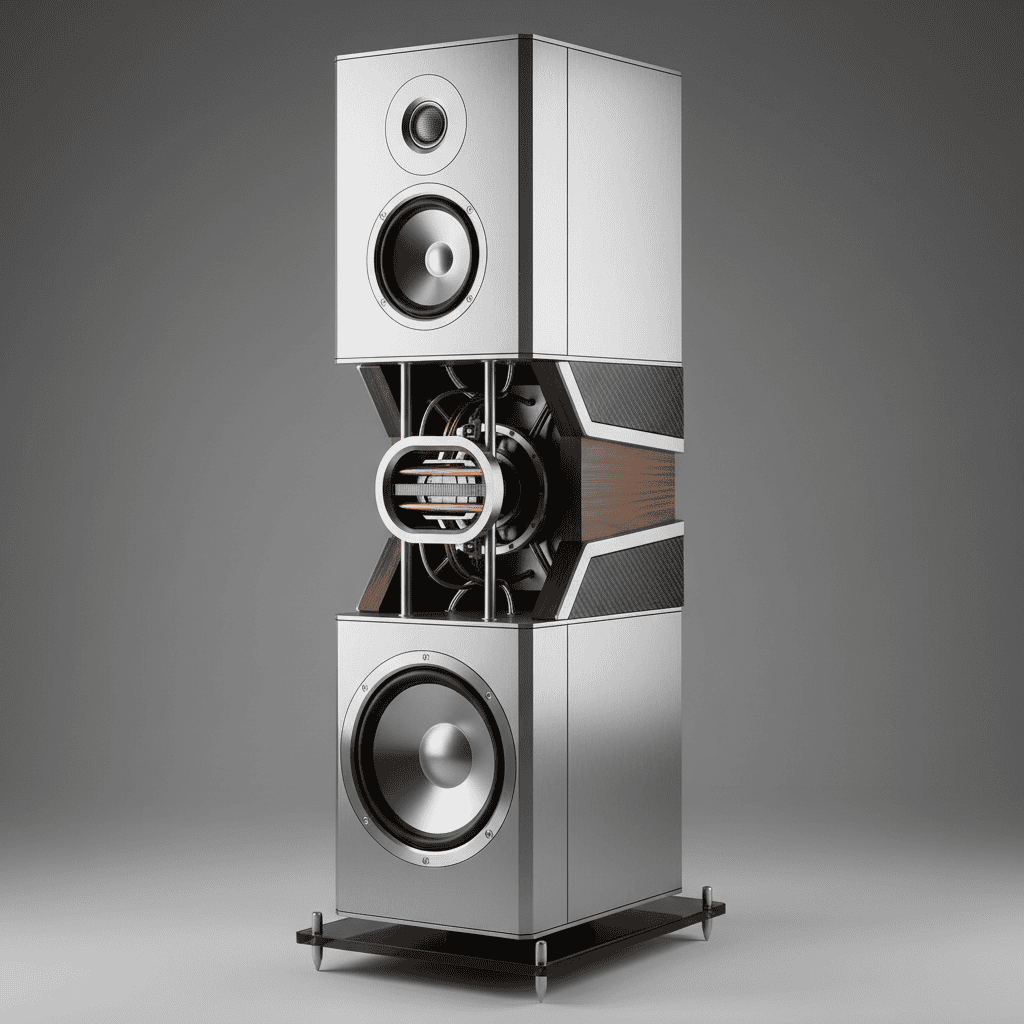
Concept de départ : design géométrique épuré, montrant une ingénierie soignée et des matériaux premium.
Étape 2 : matériaux luxueux
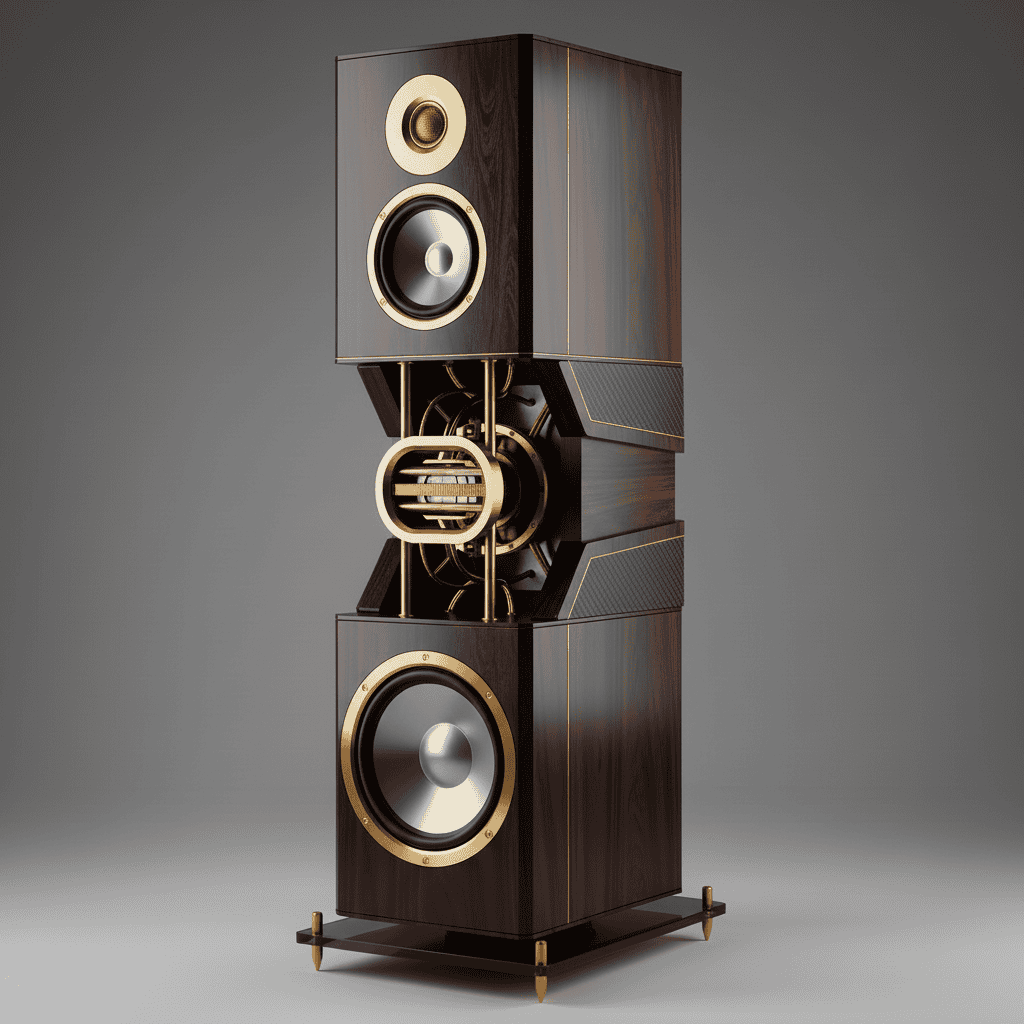
Première itération : ajout d’un placage ébène premium et d’accents or poli, en préservant les proportions d’origine.
Étape 3 : intégration high‑tech
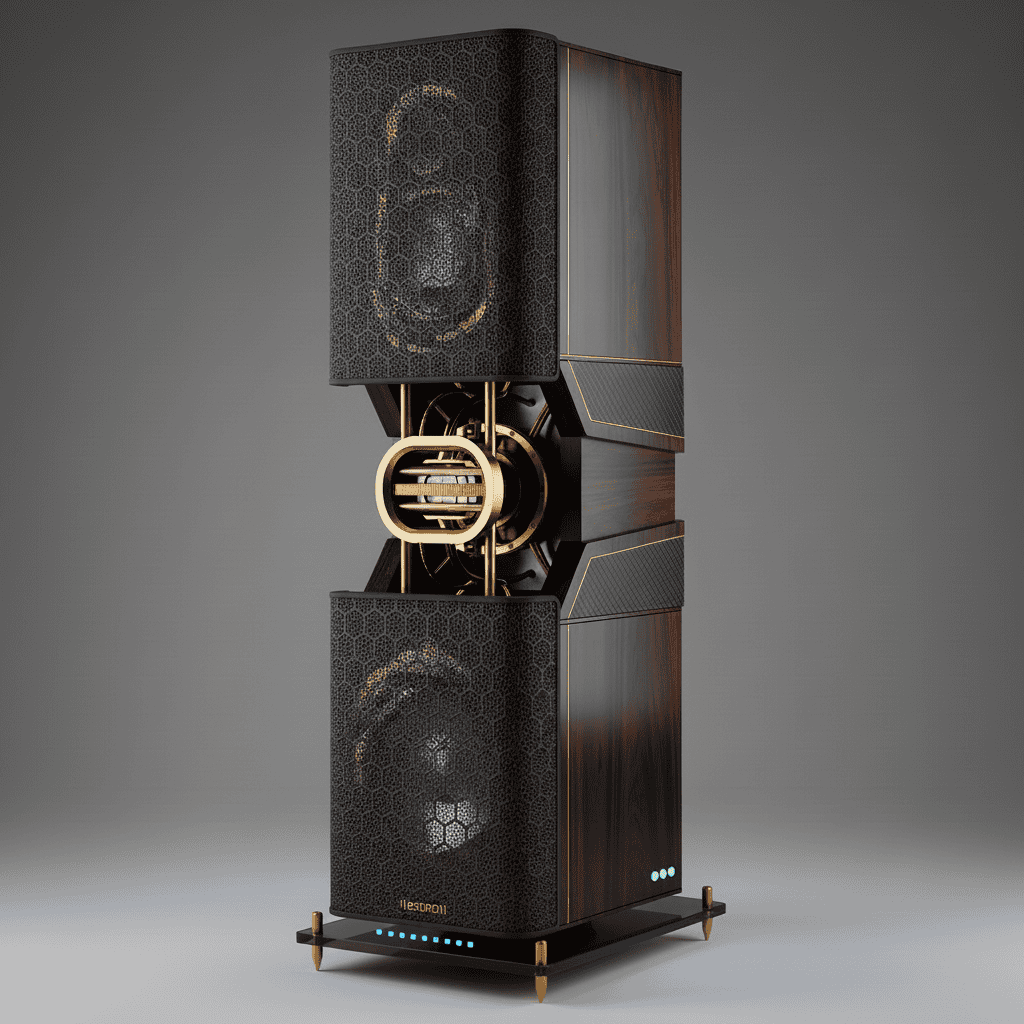
Itération finale : ajout d’indicateurs LED sophistiqués et d’une grille en tissu premium tout en conservant les finitions luxueuses.
Bonnes pratiques pour l’affinage itératif professionnel :
Conserver des personnages cohérents dans différents contextes est essentiel pour le développement de marques de luxe et des campagnes marketing ambitieuses. Gemini y parvient en comprenant l’ADN visuel des personnages et en le préservant dans des applications professionnelles variées.
Voici comment créer une mascotte de marque sophistiquée :
# After creating your base character
basemascot = Image.open("https://cdn-images-1.medium.com/proxy/1*Szx9SZ9UPl7zsa5NKUDVg.png")

# Generate consistent applications
response1 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Show this exact crystal mascot in an upscale jewelry boutique, maintaining identical facets and rose-gold glow",
       base_mascot
   ]
)

response2 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Show this exact crystal mascot on luxury packaging design, maintaining identical geometric form and internal glow",
       base_mascot
   ]
)
Étape 1 : définir le personnage de marque
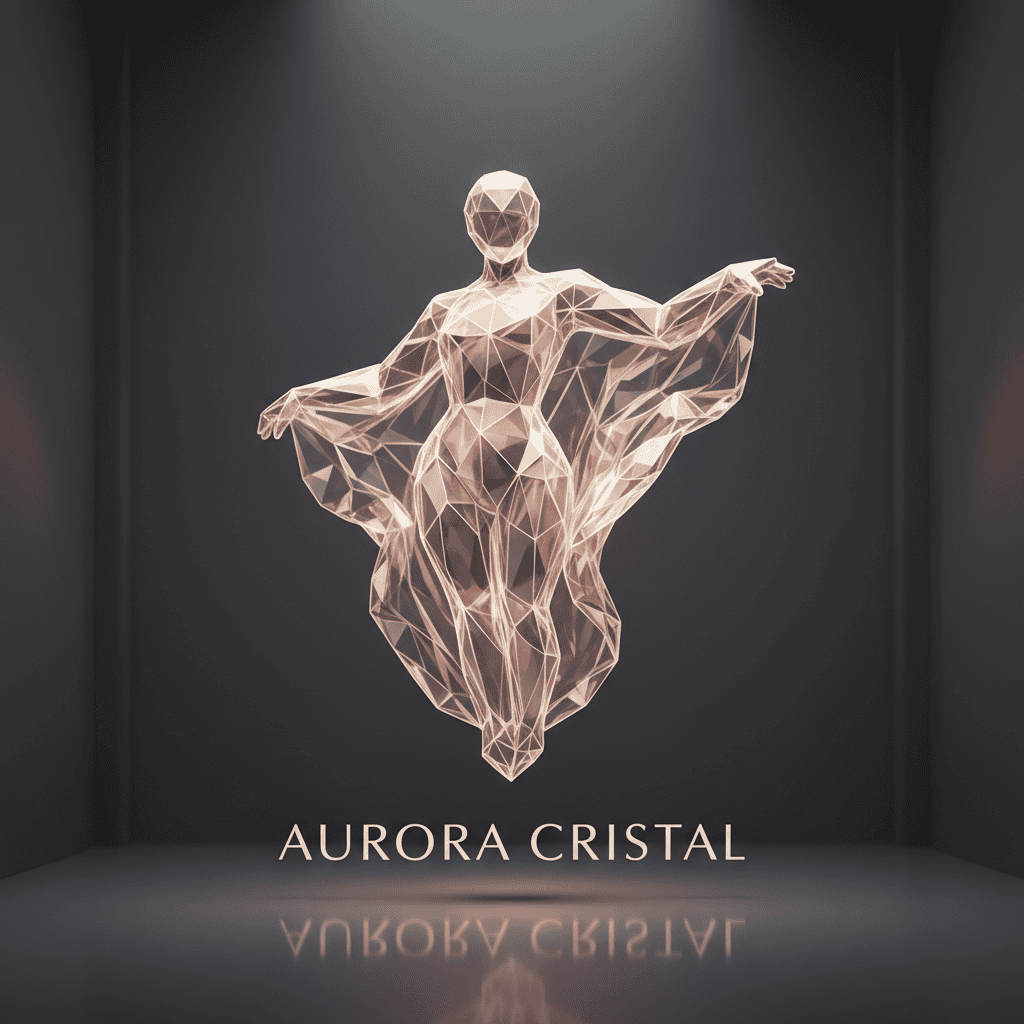
Fondation de la mascotte : être cristallin sophistiqué aux facettes géométriques distinctives et à la lueur interne rose‑or.
Étape 2 : application en boutique
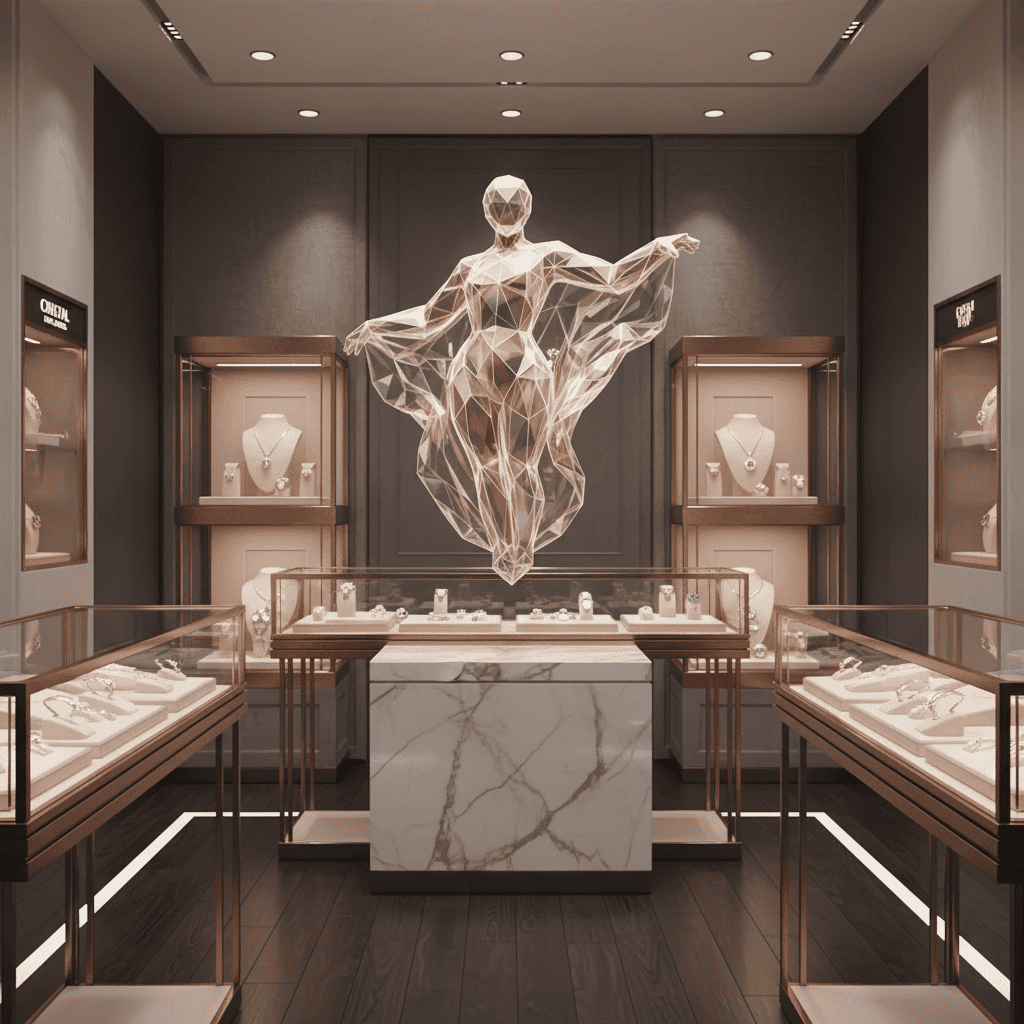
Application retail : le personnage conserve ses facettes et sa lueur exactes tout en s’adaptant à un environnement de luxe.
Étape 3 : intégration au packaging
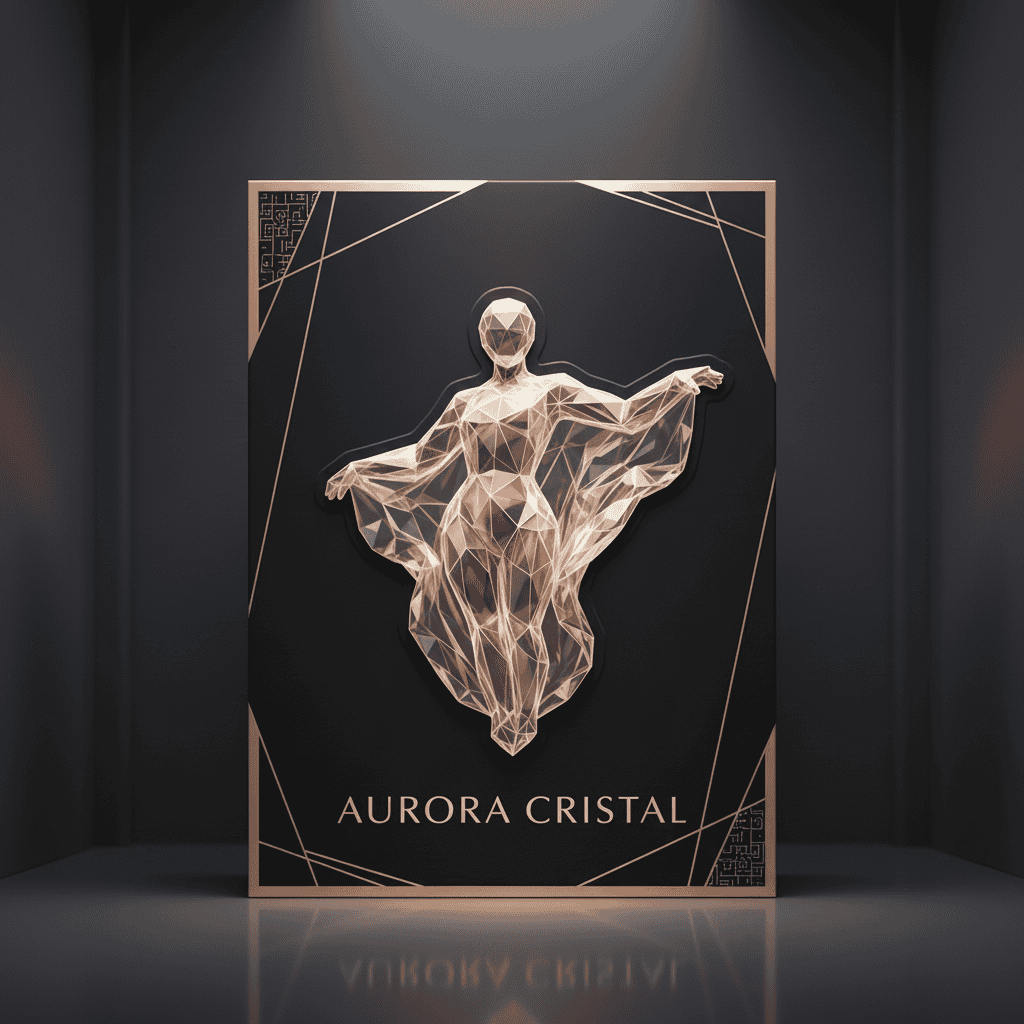
Packaging : personnage identique, adapté à une esthétique premium avec identité visuelle constante.
Étape 4 : présence en interface digitale
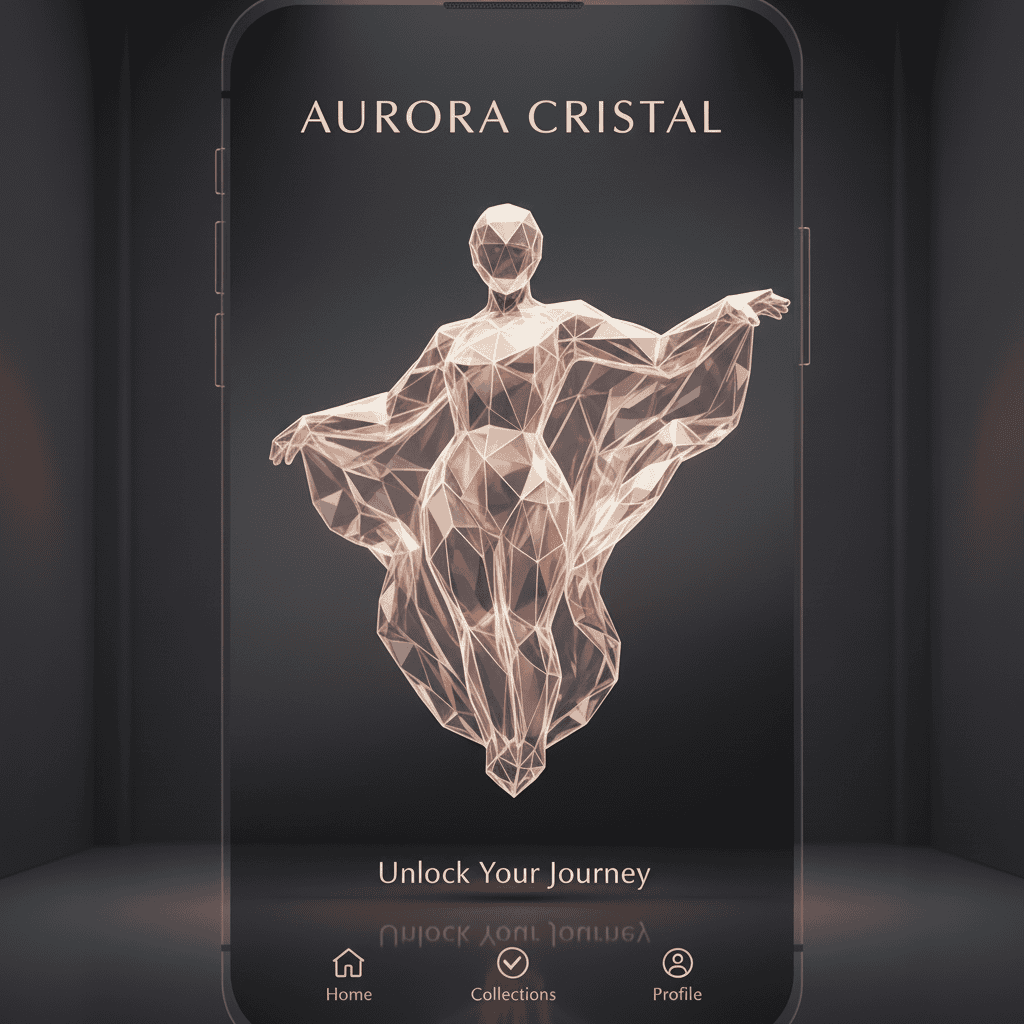
Digital : cohérence du personnage sur les plateformes numériques, avec propriétés géométriques identiques.
La formule pour une vraie cohérence : « this exact [character] » associé à des attributs précis : « maintaining identical facets », « same geometric form », « identical rose‑gold glow ».
Pour une cohérence professionnelle des personnages, privilégiez :
Cette fonctionnalité est précieuse pour :
Au‑delà du contenu, vous pouvez transformer totalement l’esthétique d’un objet tout en conservant sa structure. Parfait pour tester rapidement différentes pistes de design.
Objet de base pour les tests de style :
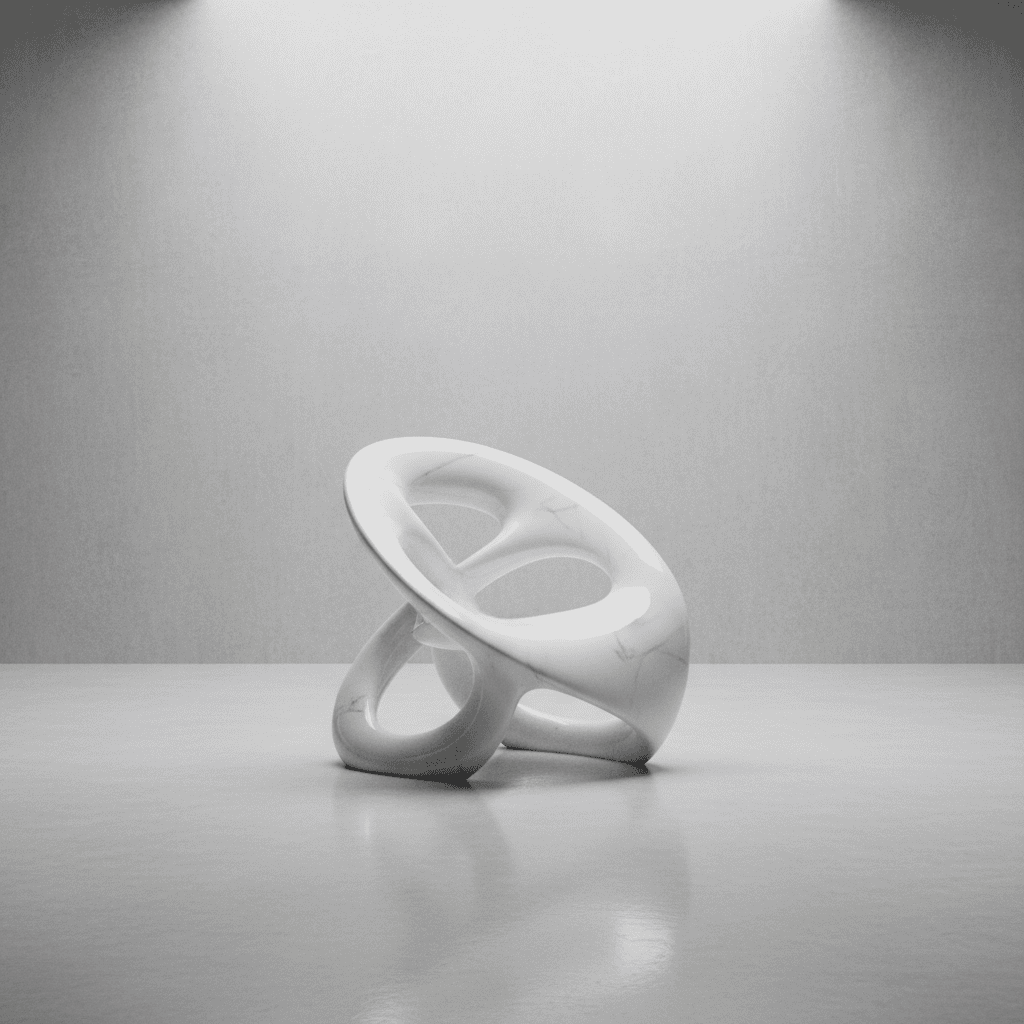
Point de départ : une chaise sculpturale sophistiquée que nous allons décliner en styles très différents.
Transformation cyberpunk :
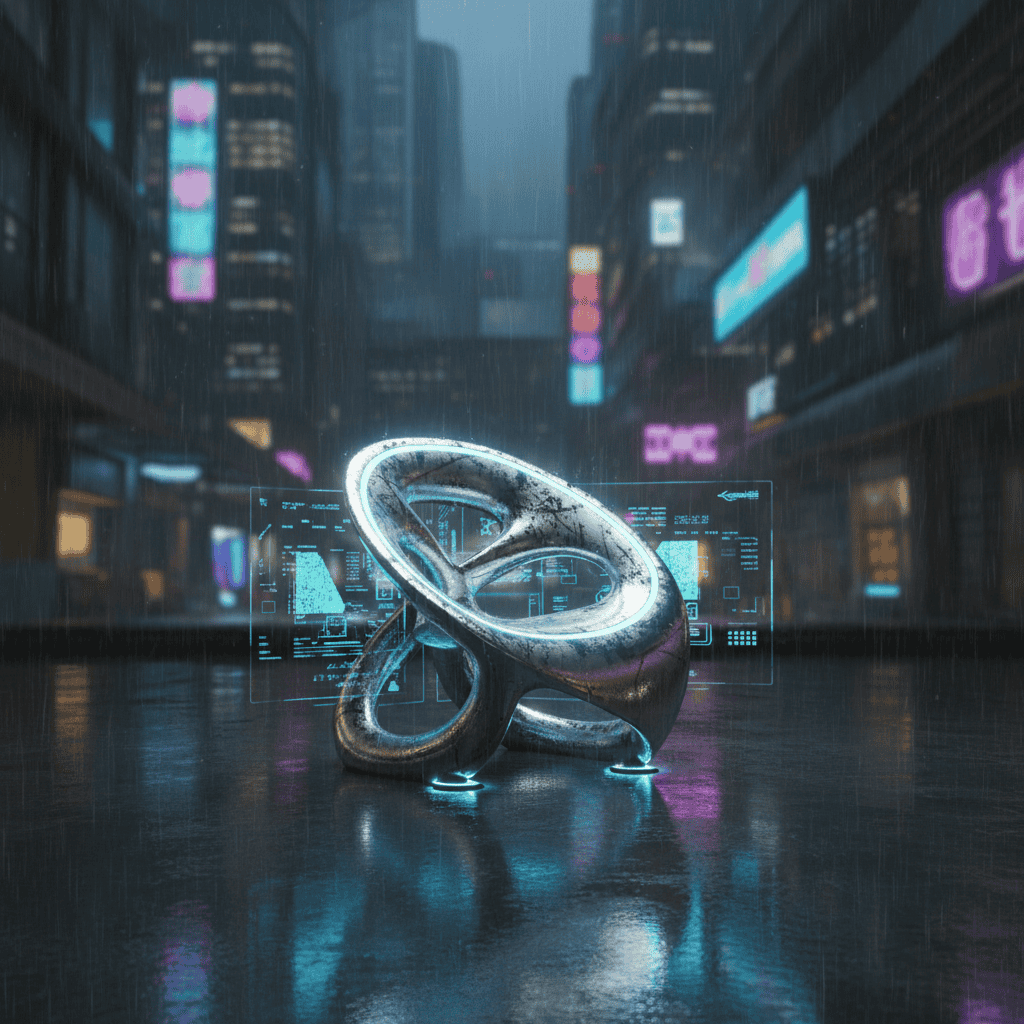
Version cyberpunk : esthétique futuriste high‑tech avec accents néon et finitions métalliques, tout en préservant la forme de base.
Transformation baroque victorienne :
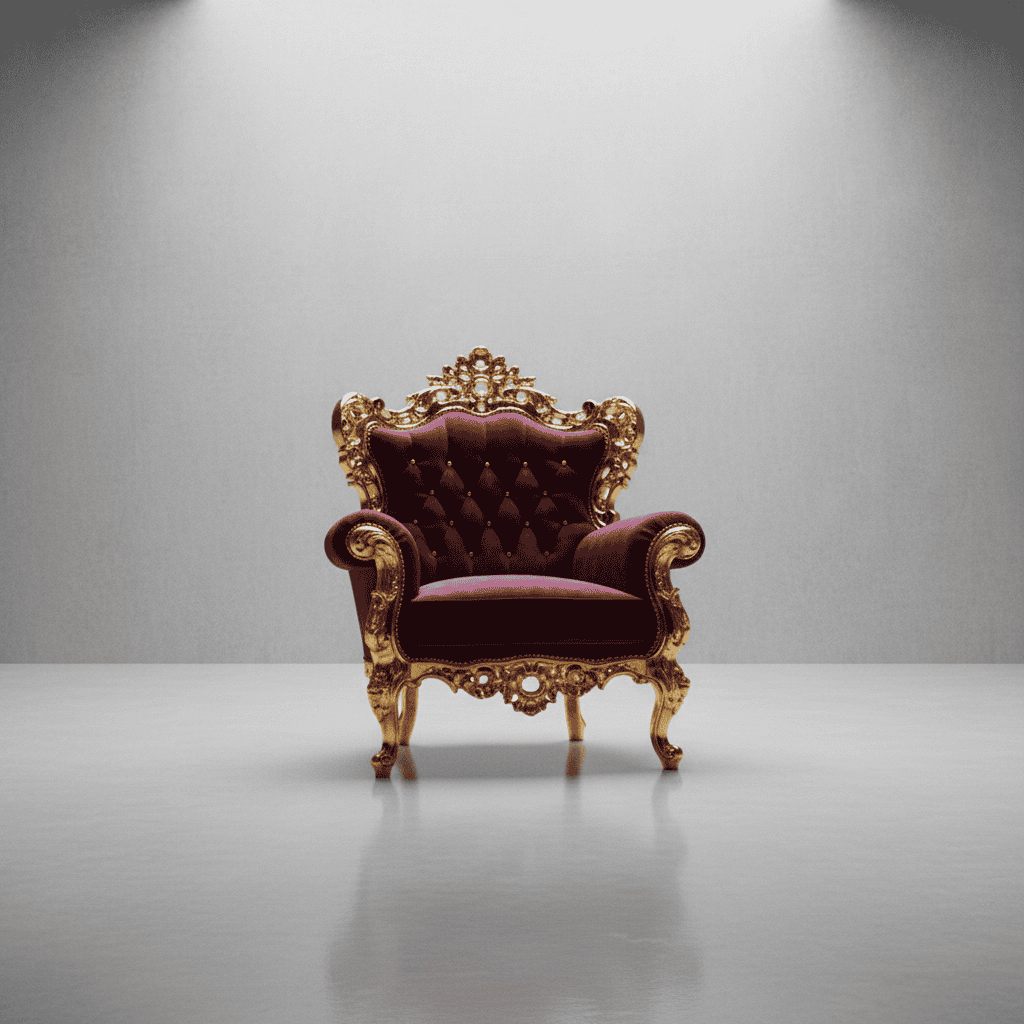
Style baroque : design classique riche et ornementé, avec matériaux luxueux et détails ouvragés, tout en conservant la structure sous‑jacente.
Modèle de prompt pour le transfert de style :
# Load your base object
base_object = Image.open("https://cdn-images-1.medium.com/proxy/1*TWO2meqMNnS1-6XSO6yv7Q.png")

# Apply style transformations
response = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Change this chair into cyberpunk style with neon LED strips, chrome frame, futuristic aesthetic",
       base_object
   ]
)
Applications du transfert de style :
Ces fonctionnalités avancées — composition multi‑images, affinage itératif, cohérence des personnages et transfert de style — sont les atouts majeurs qui font de Gemini 2.5 Flash Image un outil particulièrement puissant pour les workflows professionnels.
Gemini 2.5 Flash Image adopte une approche différente de la génération d’images : vous pouvez éditer par conversation plutôt que de tout régénérer à chaque modification. La cohérence des personnages garantit une identité visuelle stable d’une scène à l’autre, et la composition multi‑images vous permet d’assembler des éléments de façon naturelle plutôt que forcée.
La tarification à base de tokens vous offre des coûts prévisibles pour planifier vos projets. Lorsque vous serez prêt à aller plus loin, la documentation officielle couvre des fonctionnalités supplémentaires et reste à jour des nouvelles versions. Les techniques de ce tutoriel constituent une base solide pour intégrer la génération d’images conversationnelle à votre workflow.
Si vous souhaitez enrichir votre boîte à outils IA au‑delà de Gemini, notre guide pratique de l’édition d’images avec Gemini explore des capacités d’édition supplémentaires, tandis que notre tutoriel DALL‑E 3 présente l’approche alternative d’OpenAI pour la génération d’images.
Les meilleurs cours DataCamp
Cours
Cours
Cursus