
Curso
Criando agentes de IA com o Google ADK
1 h
7.5K
Apesar de os modelos de geração de imagens terem evoluído muito recentemente, sempre houve um ponto fraco: a edição. Fazer mudanças precisas em textos, trocar cores, transformar o estilo, usar ângulos de câmera diferentes ou manter personagens consistentes entre gerações — tudo isso era desejado, mas nenhum modelo de imagem era consistentemente bom nessas tarefas. Até que o Google lançou o modelo Gemini 2.5 Flash Image e mudou o jogo com uma abordagem de edição conversacional.
Neste tutorial, você vai aprender a configurar e usar o Gemini 2.5 Flash Image em Python, dominar técnicas específicas de engenharia de prompts para estilos visuais diferentes e trabalhar com recursos avançados como composição multi-imagem e consistência de personagens. No final, você terá ferramentas práticas para fluxos de trabalho profissionais de geração de imagens.
Atualização: Nesse meio tempo, o Google lançou a versão atualizada do modelo. Recomendo muito conferir nosso guia do Nano Banana 2 para ver o que há de novo!
Se você quer explorar outras ferramentas de geração de imagens do Google, também vale conferir nosso guia completo do Imagen 3, que cobre a API alternativa do Google, com pontos fortes e preços diferentes. Você também pode ver nosso guia de Gemini 2.5 Computer Use para entender como o modelo enxerga sua tela e age de forma autônoma, e acompanhar as novidades do Gemini 3 Pro.
Por fim, confira também nosso guia de ChatGPT Images, um novo concorrente do Nano Banana Pro.
A maioria dos modelos de geração de imagens cria ótimos visuais a partir de prompts de texto. Mas eles sofrem na edição. Se você quer mudar a iluminação de uma foto, normalmente precisa começar do zero. Se precisa do mesmo personagem em cenas diferentes, a maioria dos modelos não mantém a consistência visual. Isso dificulta o uso em projetos reais que exigem ajustes e revisões.
O Gemini 2.5 Flash Image resolve esses problemas de edição. O Google construiu o modelo com recursos específicos para lidar com tarefas em que outros modelos tropeçam:
Esses recursos trabalham juntos para criar um sistema de geração de imagens mais flexível. Veja como a consistência de personagens funciona na prática:
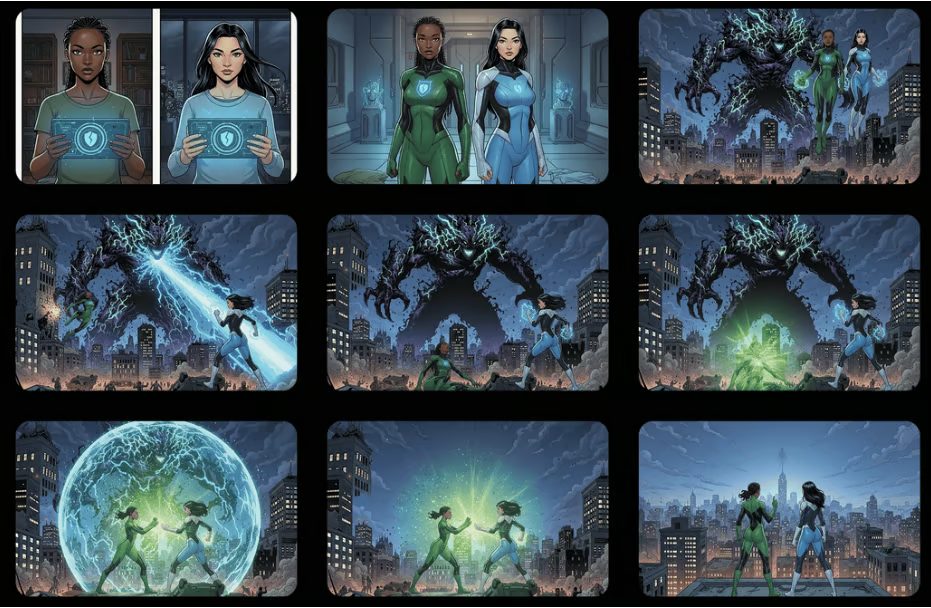
Consistência de personagens em ação: os mesmos personagens de desenho aparecem de forma consistente em diferentes cenas, mantendo a identidade visual enquanto se adaptam a novos ambientes e contextos.
O Google testou o modelo em benchmarks do LMArena, onde a equipe se referia internamente a ele como “nano banana”. Os resultados mostram desempenho superior a outros modelos líderes, especialmente em tarefas de edição de imagens. O modelo também gera imagens mais rápido que a maioria dos concorrentes. A velocidade pode variar conforme a complexidade da imagem e das edições.
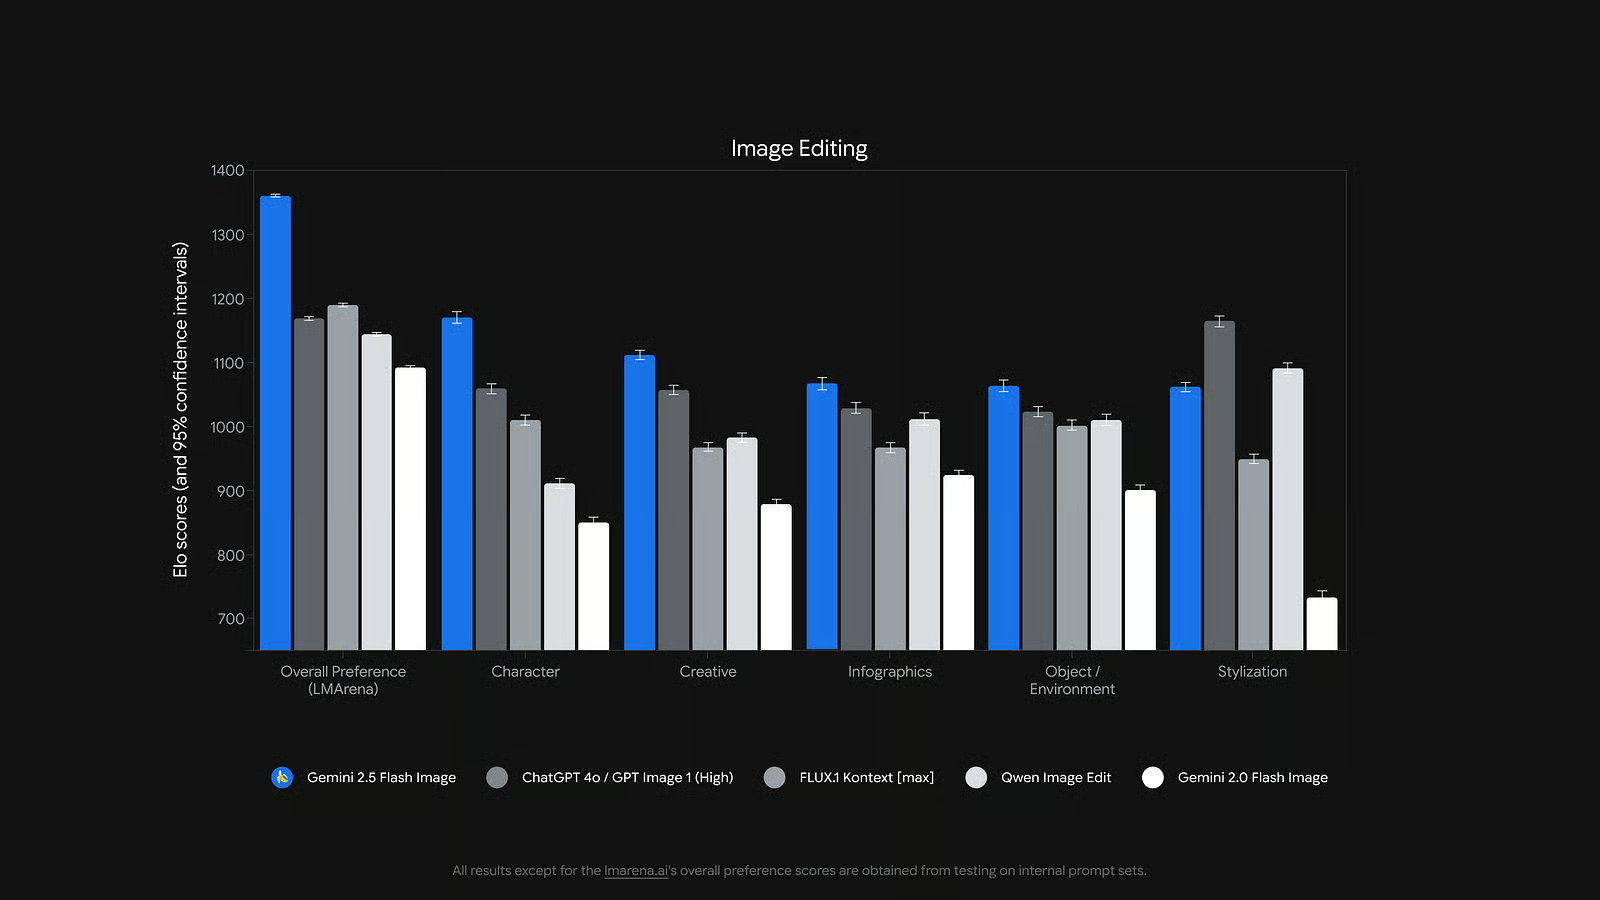
Benchmarks de desempenho: o Gemini 2.5 Flash Image apresenta performance superior em tarefas de edição de imagem quando comparado a outros modelos líderes de geração de imagens com IA.
A precificação funciona de modo diferente de outros modelos. Em vez de pagar por imagem, você paga por tokens. Cada imagem usa cerca de 1.290 tokens, custando aproximadamente US$ 0,039. A taxa cheia é de US$ 30 por milhão de tokens. Tanto gerar imagens novas quanto editar existentes consome a mesma quantidade de tokens, mantendo o custo previsível, seja do zero ou com ajustes.
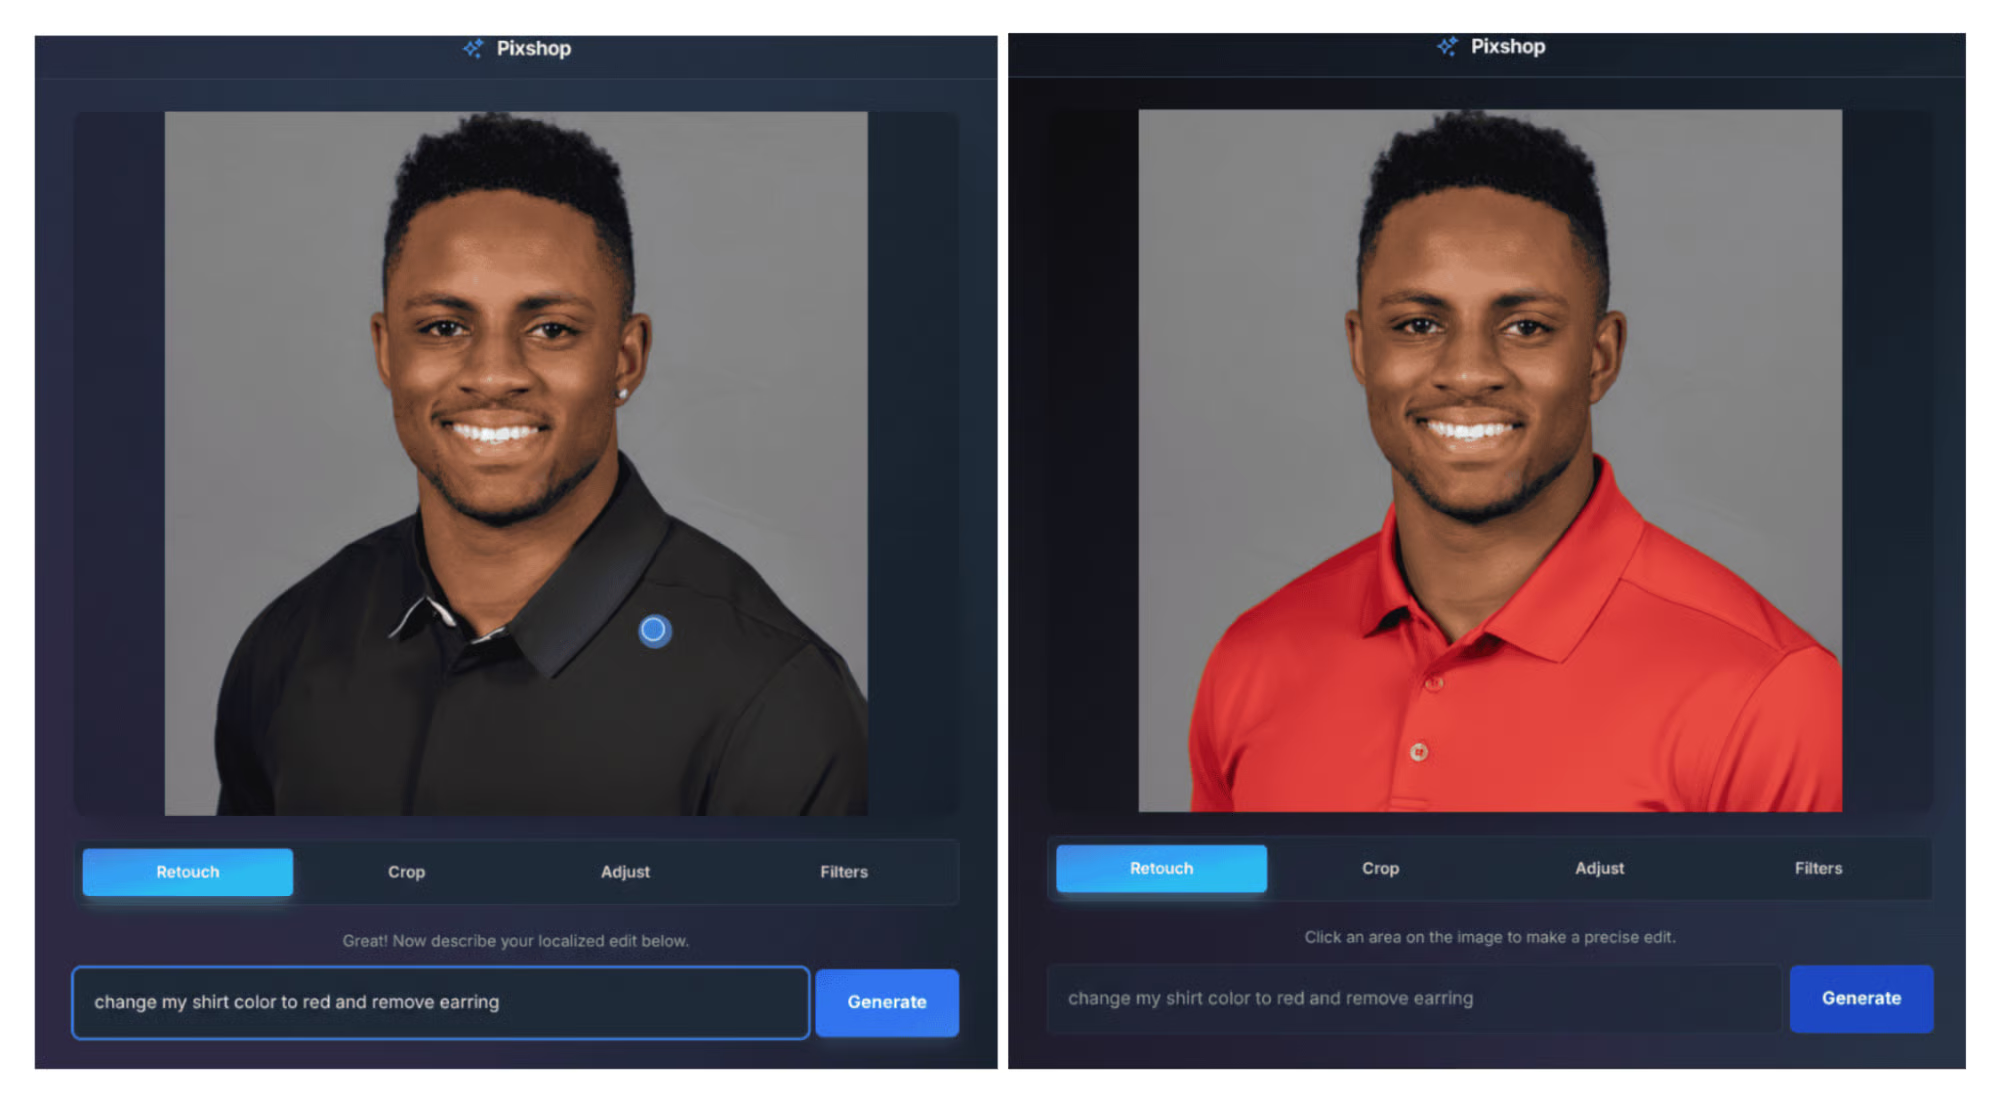
Fluxo de edição conversacional: exemplos de modificações precisas feitas por prompts em linguagem natural, mostrando a capacidade de realizar mudanças pontuais sem regenerar tudo.
Agora que você entendeu o que diferencia o Gemini 2.5 Flash Image, vamos colocar a mão na massa. O próximo passo é configurar seu ambiente de desenvolvimento para começar a usar a tecnologia.
Embora este guia foque no acesso ao Gemini 2.5 Flash Image via API, você também pode gerar imagens usando apenas sua conta Google.
Depois de fazer login, você pode acessar o modelo Nano Banana tanto pelo Gemini quanto pelo Google AI Studio. No entanto, usando via Gemini, suas imagens terão uma marca d’água.
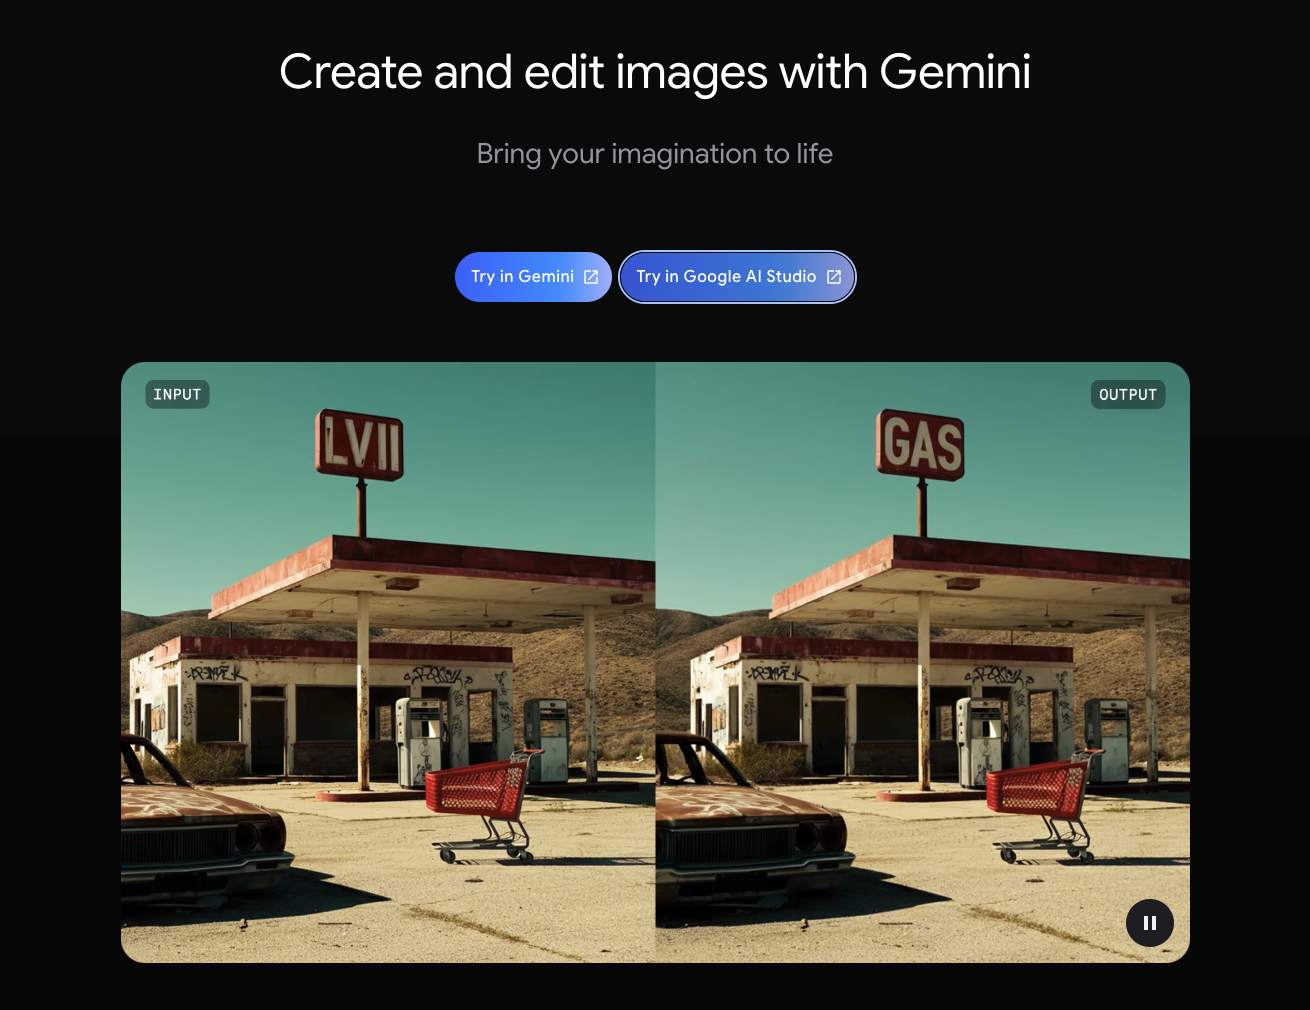
Antes de começar a gerar imagens com o Gemini 2.5 Flash Image, você precisa configurar seu ambiente de desenvolvimento. O processo é direto, mas acertar a autenticação é importante para a segurança.
Você vai precisar de alguns itens antes de começar:
python --versionPara usar o Gemini 2.5 Flash Image, você precisa de uma chave de API do Google. Essa chave funciona como sua senha de acesso ao serviço. Veja como obter:
Nesse ponto, o Google AI Studio vai pedir para você escolher um projeto. Projetos ajudam a organizar o uso da API e acompanhar suas cotas. Você tem duas opções:
A maioria deve escolher criar um novo projeto. Clique e o Google criará o projeto e sua chave de API automaticamente.
4. Copie a chave gerada na hora — você não verá a chave completa novamente
5. Guarde em local seguro — você vai precisar dela nos próximos passos
Nota de segurança: trate sua chave de API como uma senha. Não compartilhe publicamente nem salve em código acessível a terceiros.
Com a chave de API em mãos, vamos configurar o ambiente Python. Crie um novo diretório para este tutorial e instale os pacotes necessários:
# Create project directory
mkdir gemini-image-tutorial
cd gemini-image-tutorial

# Initialize UV project
uv init

# Add required packages
uv add google-genai python-dotenv pillow
Veja para que serve cada pacote:
google-genai: cliente oficial para conversar com o Geminipython-dotenv: mantém sua chave de API segurapillow: lida com arquivos de imagemVocê precisa armazenar a chave de forma segura e acessível pelo código. A melhor forma é usar variáveis de ambiente com um arquivo .env.
Crie um arquivo .env no diretório do projeto:
# Create .env file
touch .env
Abra o .env em qualquer editor de texto e adicione sua chave de API:
GEMINI_API_KEY=your_api_key_hereSubstitua your_api_key_here pela chave copiada do Google AI Studio.
Em seguida, crie um .gitignore para não compartilhar sua chave por engano se você usar Git:
# Create .gitignore
echo ".env" >> .gitignore
echo "__pycache__/" >> .gitignore
echo "*.pyc" >> .gitignoreVamos garantir que tudo funciona criando um teste simples. Crie um arquivo chamado test_setup.py:
import os
from dotenv import load_dotenv
from google import genai

# Load environment variables
load_dotenv()

# Initialize the client
client = genai.Client(apikey=os.getenv("GEMINIAPI_KEY"))

# Test with a simple text generation
try:
   response = client.models.generate_content(
       model="gemini-2.5-flash",
       contents="Say hello in exactly 3 words"
   )
   print("✅ Setup successful!")
   print(f"Response: {response.text}")
except Exception as e:
   print("❌ Setup failed:")
   print(f"Error: {e}")
Agora rode o script de teste para confirmar que tudo está ok:
uv run python test_setup.pySe deu tudo certo, você verá uma mensagem de sucesso e uma resposta curta do modelo. A saída deve ser algo como:
✅ Setup successful!
Response: Hello there everyone.
Se aparecer algum erro, aqui vão as correções mais comuns:
.env tem GEMINI_API_KEY=your_actual_keySua chave de API gratuita tem estes limites:
Esses limites são ideais para este tutorial e projetos pequenos. Você pode acompanhar o consumo no painel de uso do Google AI Studio.
Com o ambiente configurado e testado, você já pode começar a gerar imagens. A seguir, vamos criar sua primeira imagem com o Gemini 2.5 Flash Image.
Com o ambiente pronto, vamos criar sua primeira imagem com o Gemini 2..5 Flash Image. Vamos começar simples e evoluir passo a passo.
Primeiro, vamos importar as bibliotecas necessárias e configurar a conexão com o Gemini:
import os
from dotenv import load_dotenv
from google import genai
from PIL import Image
from io import BytesIO

# Load your API key from the .env file
load_dotenv()

# Create a client to talk to Gemini
client = genai.Client(apikey=os.getenv("GEMINIAPI_KEY"))
Vamos entender o que cada import faz:
os: ajuda a trabalhar com variáveis de ambienteload_dotenv(): lê sua chave de API do arquivo .env genai: a biblioteca principal para conversar com o GeminiPIL Image e BytesIO: ajudam a salvar os arquivos de imagem retornadosO objeto client é como enviamos requisições ao Gemini. Pense nele como sua conexão com os servidores do Google.
Agora vamos criar uma imagem simples com um prompt claro e descritivo:
# Write a prompt describing what you want
prompt = "A cozy coffee shop with wooden furniture and warm lighting"

# Ask Gemini to create the image
response = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[prompt]
)
A função generate_content() é a principal forma de conversar com o Gemini. Veja o que cada parte significa:
model="gemini-2.5-flash-image-preview": informa qual modelo usar para gerar a imagemcontents=[prompt]: onde vai a sua descrição em textoQuando o Gemini retorna a resposta, a imagem vem como dados brutos que precisamos converter em arquivo de imagem. Veja como extrair e salvar:
# Look through the response to find the image
for part in response.candidates[0].content.parts:
   if part.inline_data is not None:
       # Convert the raw data into an image
       image = Image.open(BytesIO(part.inline_data.data))
       # Save it as a PNG file
       image.save("myfirstimage.png")
       print("Image saved!")
Esse código faz alguns pontos importantes:
response.candidates[0]: pega a primeira (geralmente única) resposta do Geminicontent.parts: o Gemini pode retornar várias partes — texto, imagens etc.part.inline_data: onde ficam os dados da imagemBytesIO(): converte os bytes brutos em algo que o PIL consegue lerimage.save(): salva a imagem no seu computadorVamos juntar tudo e rodar o código completo. Executando os comandos em sequência, você deve ver uma saída como esta:
✅ Image saved as https://cdn-images-1.medium.com/proxy/1*Hhy7vMKOurXDOPVQ6Ps0gQ.png
📏 Image size: (1024, 1024)
🎨 Image mode: RGB
Aqui está a imagem gerada a partir do nosso prompt da cafeteria:
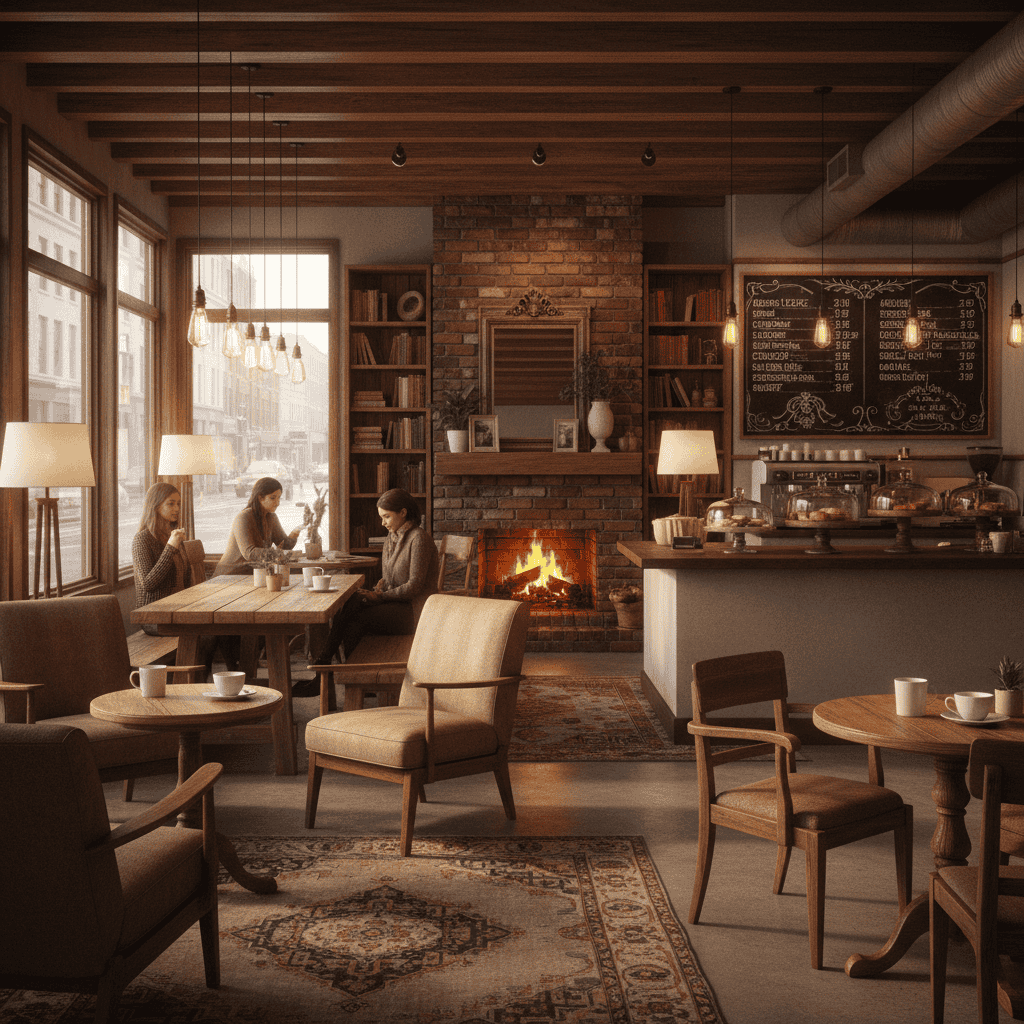
Uma cafeteria aconchegante com vigas de madeira, luz quente, assentos confortáveis e um clima acolhedor — exatamente como descrito no prompt.
Sempre que você gera uma imagem, o Gemini retorna:
A resposta também pode incluir texto, caso o Gemini queira explicar algo sobre a imagem criada.
Depois de entender o fluxo básico, vamos testar alguns prompts para ver como o modelo reage a descrições variadas:
# Simple object descriptions work great
"A red bicycle in a sunny park"

# You can add details about style and mood
"A modern kitchen with clean white cabinets and natural light"

# Describe the setting and atmosphere
"A peaceful lake surrounded by mountains at sunset"
Veja o que esses prompts geram na prática:
Bicicleta vermelha em um parque ensolarado:
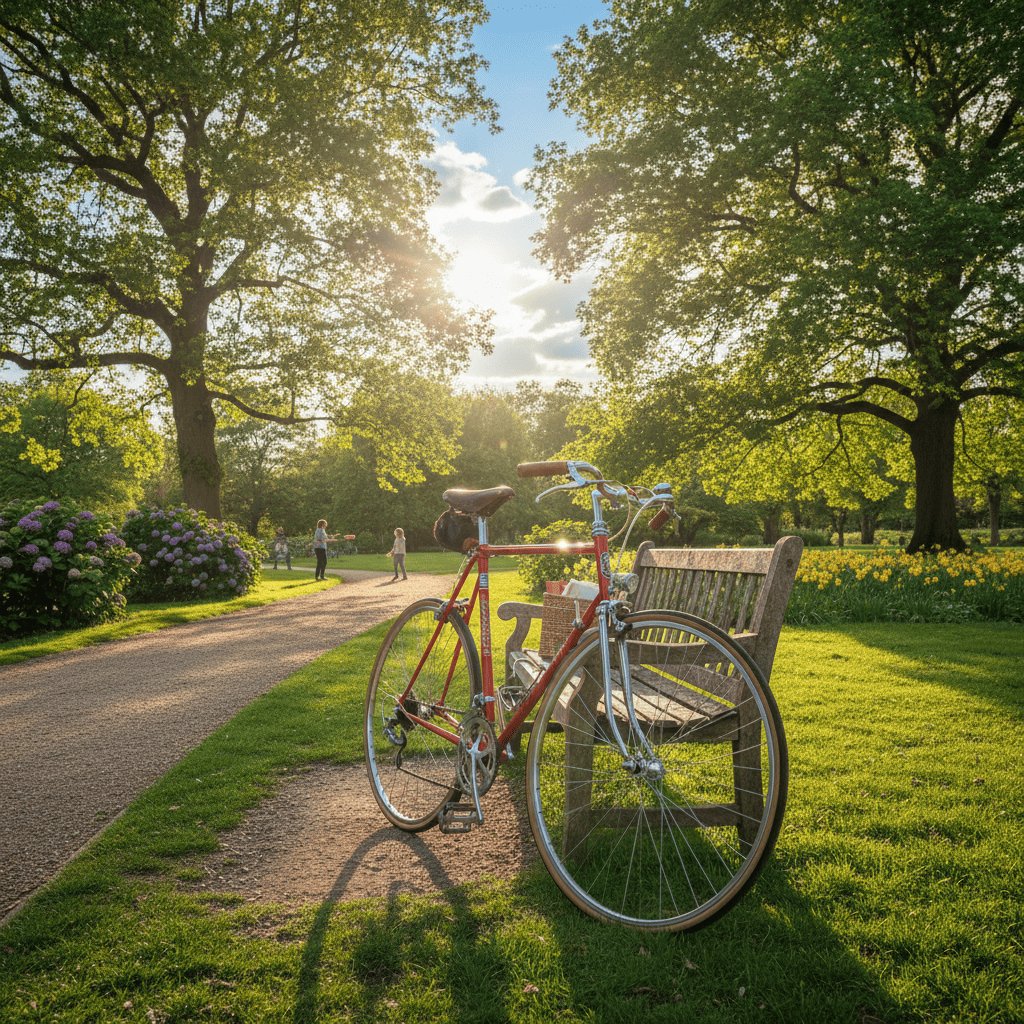
Uma bicicleta vermelha perfeitamente posicionada em um lindo parque com luz dourada, muito verde e um banco tranquilo. Repare nas sombras — como em uma foto real, elas se distorcem ao sair do piso para a grama.
Cozinha moderna com armários brancos:
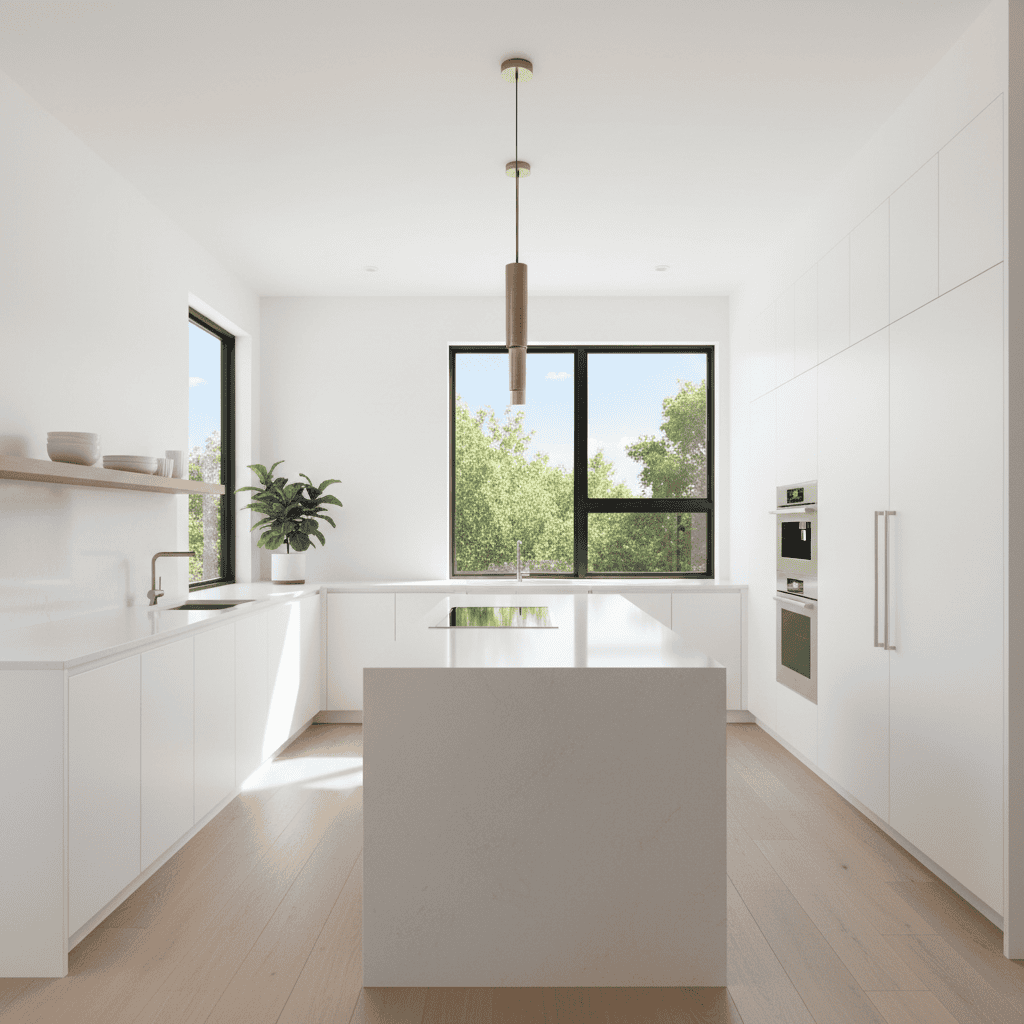
Uma cozinha contemporânea elegante com armários brancos impecáveis, acabamentos modernos e luz natural entrando por grandes janelas. Note o reflexo das janelas na superfície lisa da mesa central.
Lago tranquilo cercado por montanhas:
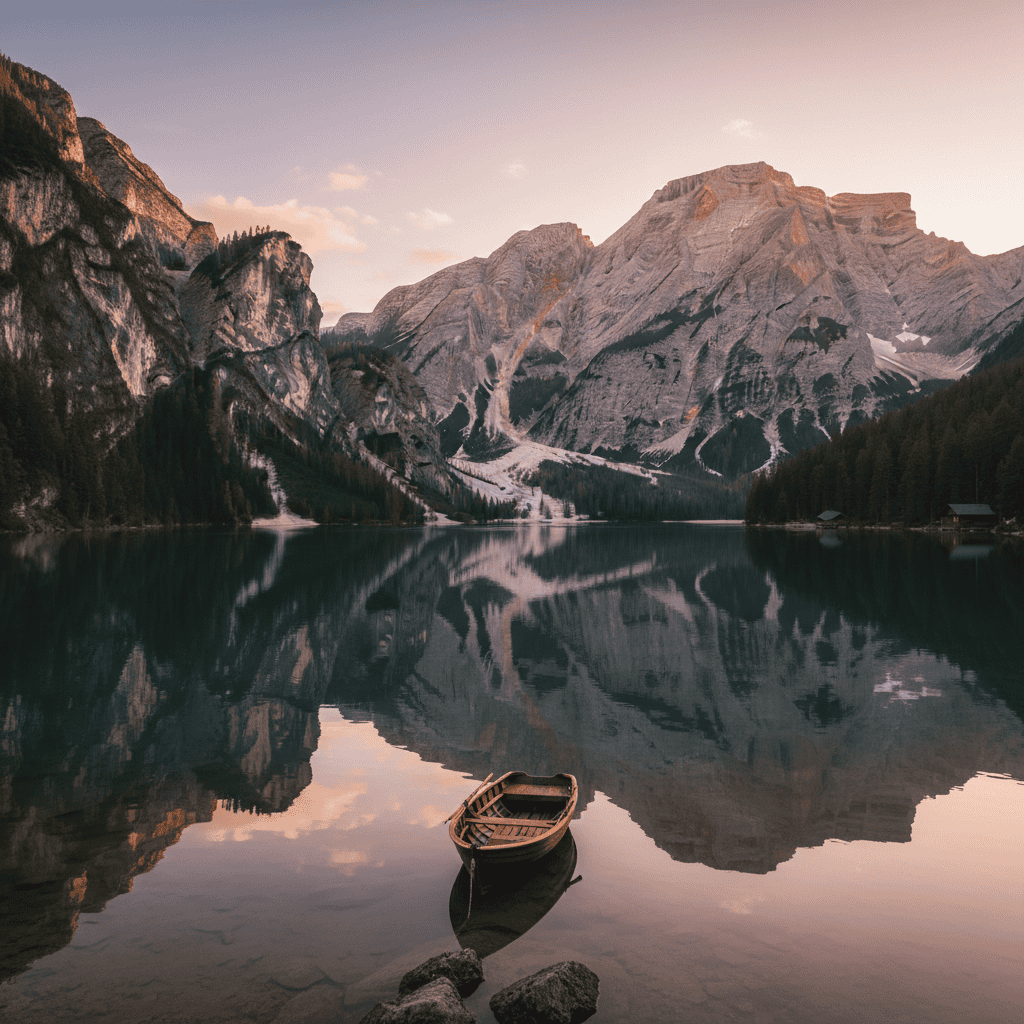
Um lago de montanha ao pôr do sol com reflexos perfeitos, cercado por picos dramáticos e um charmoso barco de madeira em primeiro plano. Mais uma vez, destaque para os reflexos detalhados na água.
Comece com descrições claras e simples. Você pode detalhar mais conforme entender o comportamento do modelo.
Estes exemplos mostram o fluxo típico, mas podem surgir problemas. Veja como lidar com os mais comuns:
Na próxima seção, você vai aprender a escrever prompts melhores para ter mais controle sobre os resultados.
Agora que você já gera imagens básicas, vamos aprender a escrever prompts que dão mais controle sobre o resultado. O segredo é ser específico sobre o que você quer e entender como diferentes técnicas afetam a imagem final.
Para se aprofundar nos fundamentos de prompt engineering em todos os modelos de IA, nosso guia completo de prompt engineering para 2025 cobre as técnicas mais atuais, aplicáveis a IA de texto e visual.
O processo manual que usamos antes funciona para aprender, mas repetir o mesmo código para cada imagem fica chato. Antes de mergulhar nas técnicas, vamos criar uma função auxiliar para simplificar:
def generateandsave_image(prompt, filename):
   """
   Generate an image and save it to the images folder

   Args:
       prompt (str): Description of what you want to create
       filename (str): Name for the saved image file

   Returns:
       bool: True if successful, False otherwise
   """
   try:
       response = client.models.generate_content(
           model="gemini-2.5-flash-image-preview",
           contents=[prompt]
       )

       # Find and save the image
       for part in response.candidates[0].content.parts:
           if part.inline_data is not None:
               image = Image.open(BytesIO(part.inline_data.data))
               image.save(f"images/{filename}")
               print(f"✅ Image saved as images/{filename}")
               return True

   except Exception as e:
       print(f"❌ Error: {e}")
       return False

   return False
Essa função cuida da geração e do salvamento da imagem. Agora, podemos focar em escrever melhores prompts em vez de repetir código.
Veja como usá-la:
# Simple function call
generateandsave_image("A cozy reading nook", "readingnook.png")
Bem mais limpo do que escrever tudo toda vez!
A maior melhoria nos seus prompts vem de adicionar detalhes específicos. Vamos ver a diferença entre prompts genéricos e detalhados.
Aqui vai um prompt genérico:
generateandsave_image("A kitchen", "generickitchen.png")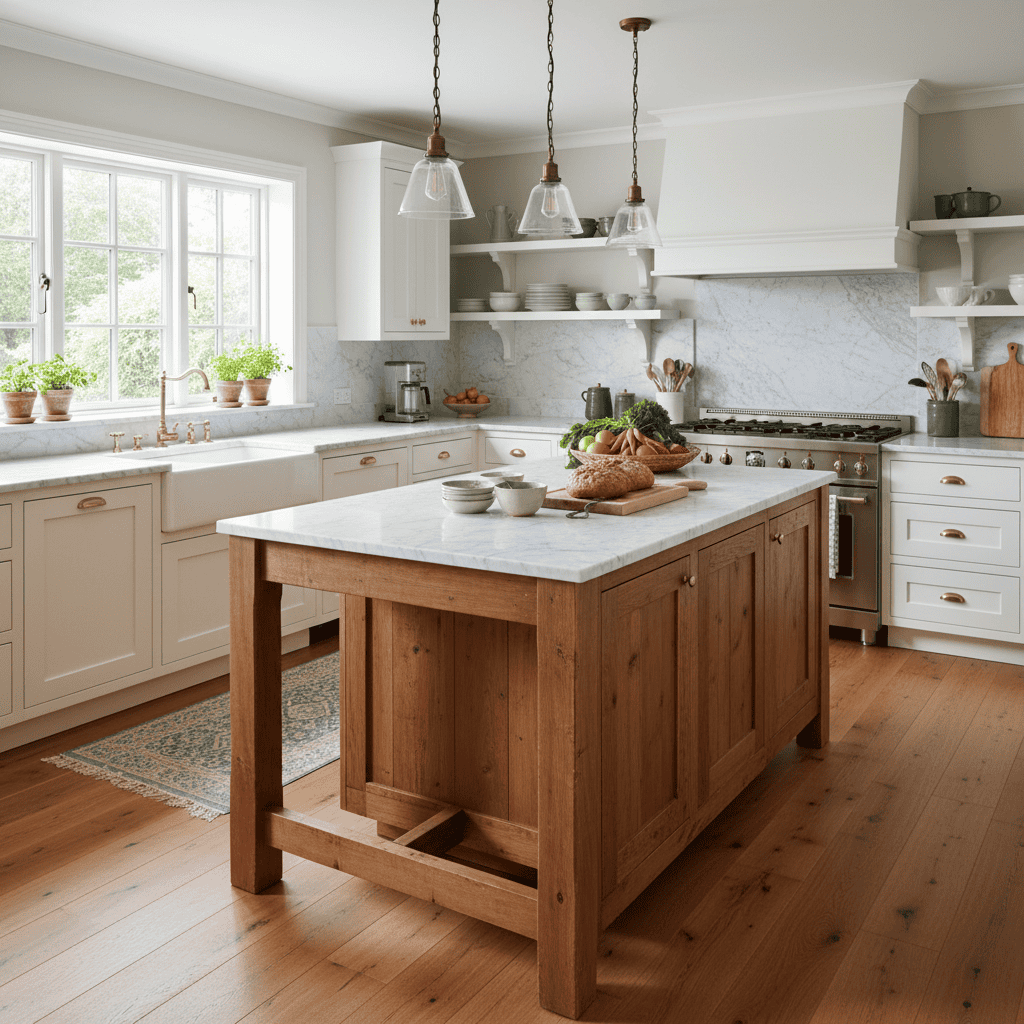
Resultado genérico: uma cozinha básica que poderia ser de qualquer lugar, com recursos padrão e sem personalidade.
Agora, o mesmo conceito com detalhes específicos:
generateandsave_image(
   "Modern minimalist kitchen, white quartz countertops, stainless steel appliances, pendant lights, natural oak floors",
   "specific_kitchen.png"
)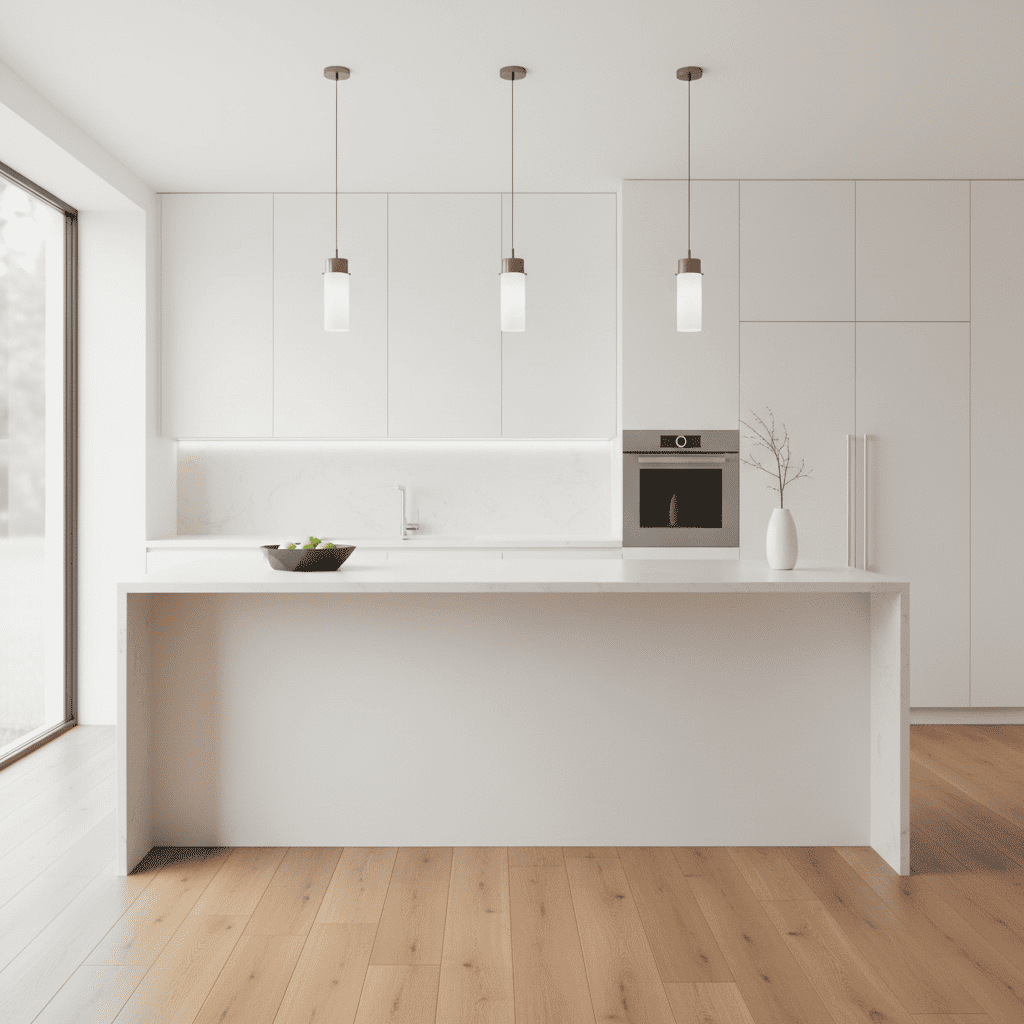
Resultado específico: uma cozinha com os elementos exatos solicitados, criando uma estética moderna coesa.
A diferença é grande. O prompt específico traz um resultado profissional que bate com a sua descrição. O genérico até funciona, mas é bem mais imprevisível.
Se você também trabalha com outros modelos de geração de imagens, nosso guia de técnicas do Stable Diffusion cobre estratégias complementares de prompting que melhoram seus resultados em diferentes plataformas de IA.
Você pode controlar o enquadramento usando termos de fotografia. Isso dá precisão na composição e na perspectiva.
Grande angular captura mais da cena:
generateandsave_image(
   "Wide angle shot of modern living room, leather sofa, glass coffee table, floor to ceiling windows",
   "wideangleroom.png"
)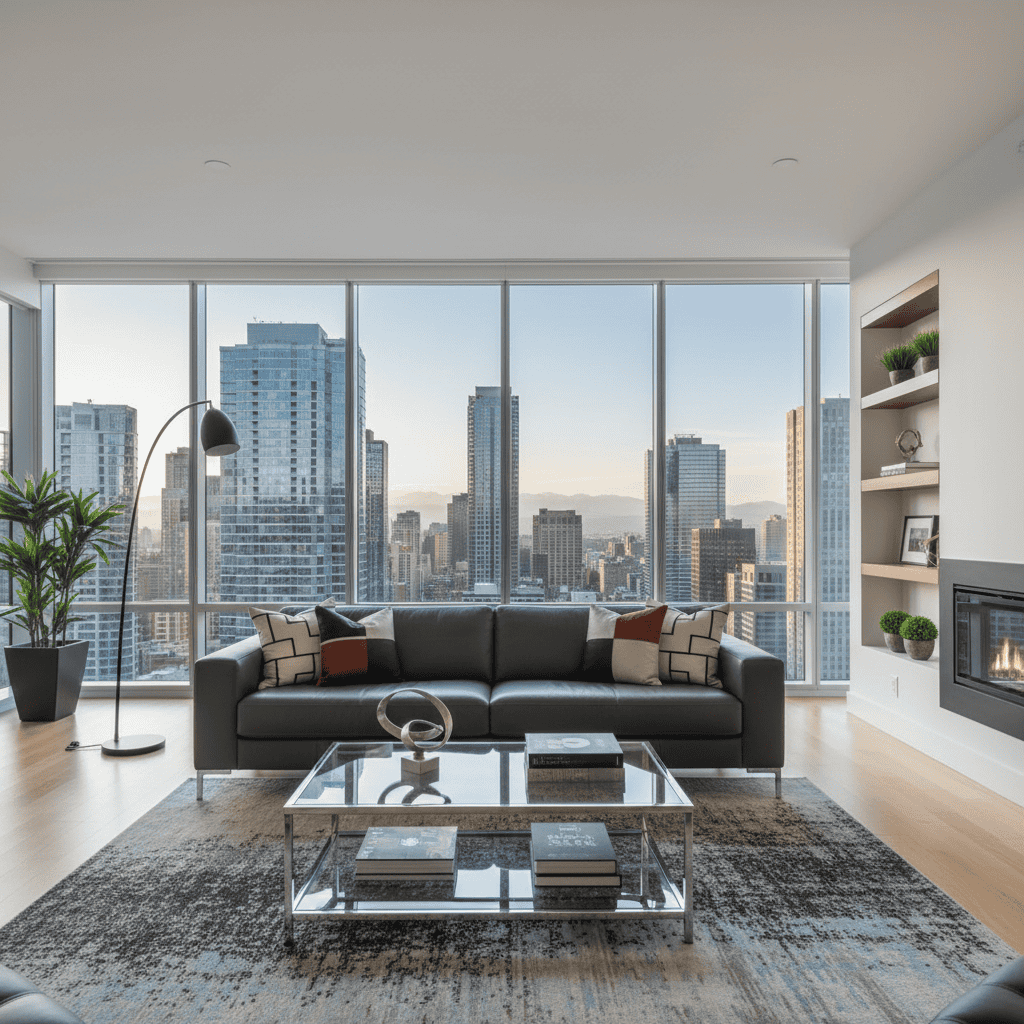
Uma perspectiva grande-angular que valoriza o espaço e a vista da cidade, deixando o ambiente maior e mais dramático.
Macro foca nos detalhes:
generateandsave_image(
   "Macro shot of vintage pocket watch on mahogany desk, brass details, Roman numerals, soft lighting",
   "macro_watch.png"
)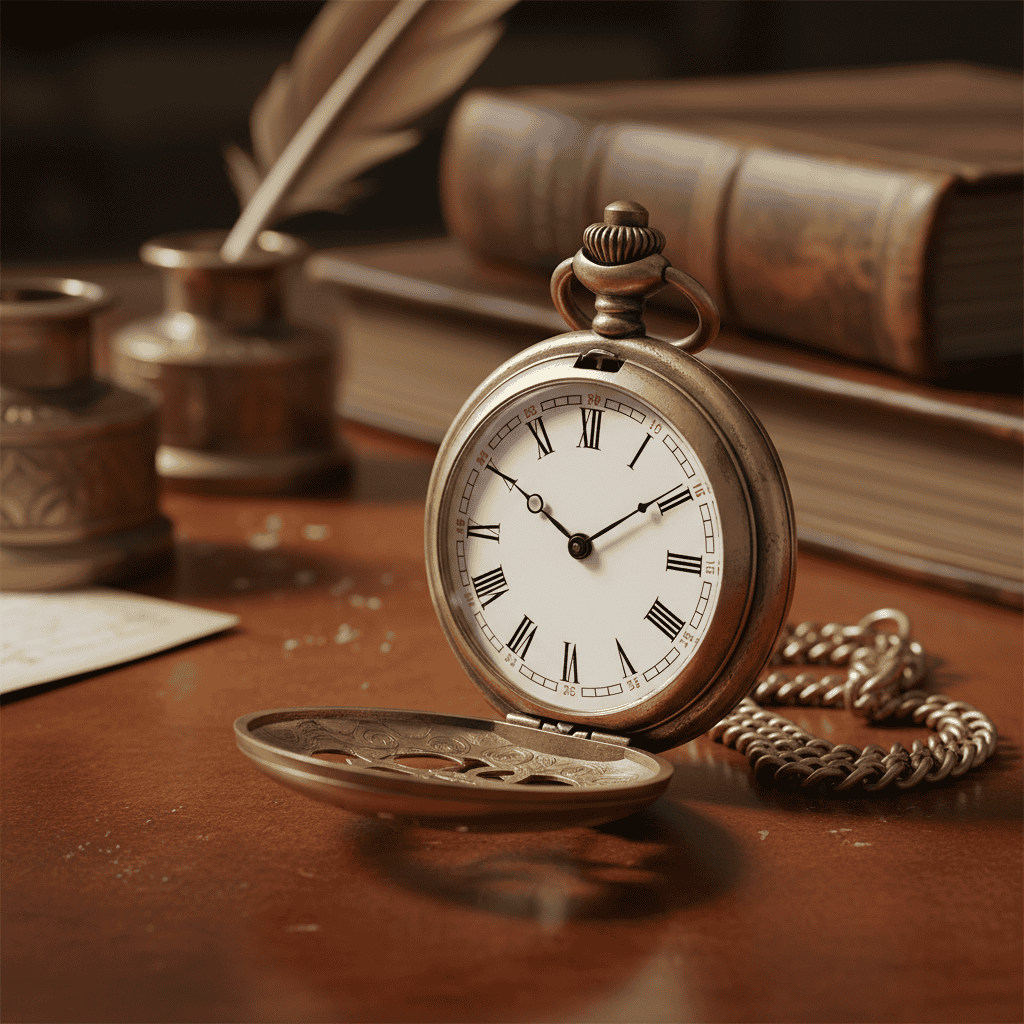
A macro revela os detalhes do mostrador, da corrente e dos livros antigos, criando uma composição íntima e detalhada.
Outros termos úteis de câmera:
"Low angle shot" — de baixo para cima"Bird's eye view" — visão de cima"85mm portrait lens" — cria baixa profundidade de campo"Dutch angle" — perspectiva inclinada para dramatizarDescrições de luz mudam completamente a sensação da imagem. Veja como usar iluminação para criar climas específicos.
Golden hour cria calor e aconchego:
generateandsave_image(
   "Empty park bench at golden hour, warm sunlight, long shadows, autumn leaves scattered, peaceful atmosphere",
   "goldenhourbench.png"
)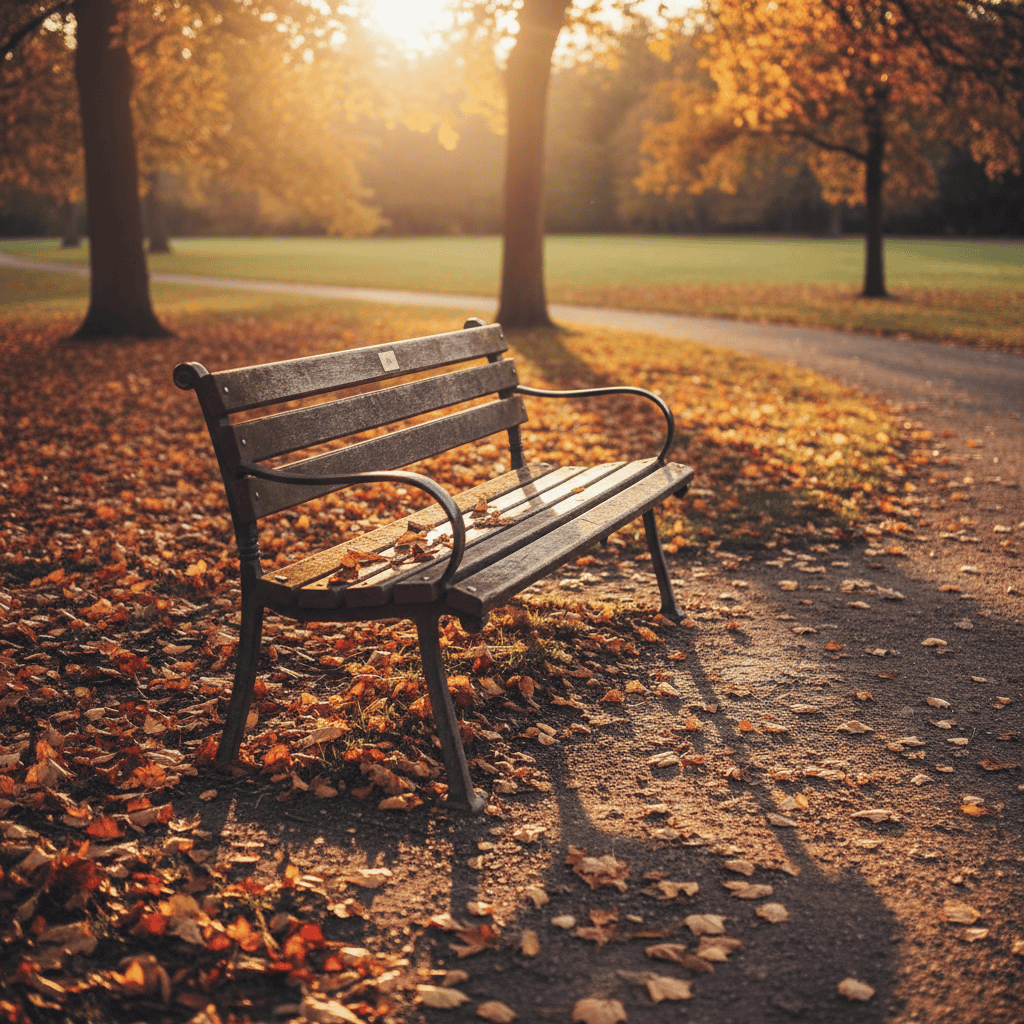
A luz da golden hour transforma um banco simples em uma cena quente e convidativa, perfeita para contemplação.
Iluminação dramática adiciona intensidade:
generateandsave_image(
   "Dark stormy sky over empty lighthouse, dramatic lighting, waves crashing on rocks, moody atmosphere",
   "dramatic_lighthouse.png"
)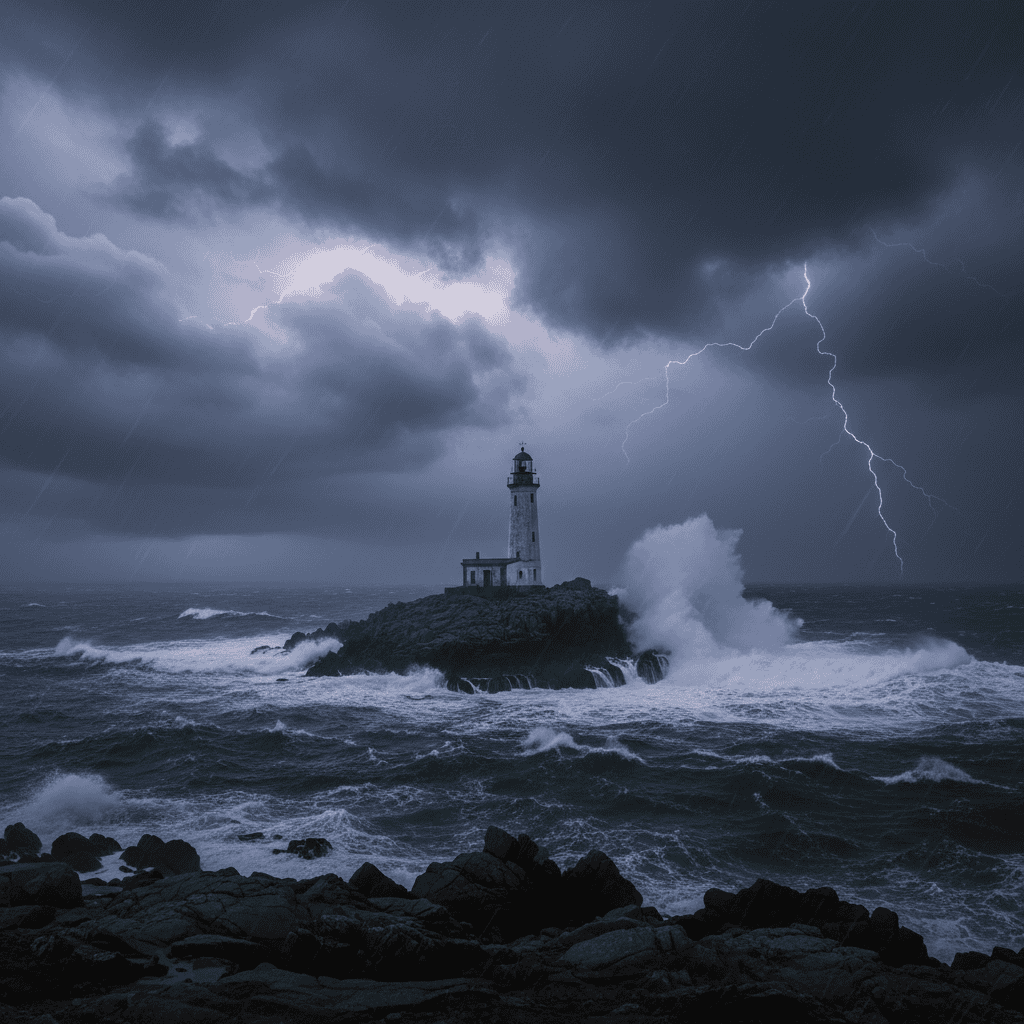
Luz dramática e clima tempestuoso criam uma cena poderosa, melancólica, que evoca força e solidão.
Termos úteis de iluminação:
"Soft natural light" — iluminação suave e uniforme"Harsh shadows" — contraste forte e drama"Backlit" — luz vindo por trás do sujeito"Studio lighting" — setup limpo e profissionalVocê pode direcionar o estilo artístico incluindo descrições estéticas específicas no prompt.
Estilo minimalista:
generateandsave_image(
   "Minimalist bedroom design, white walls, simple wooden bed frame, single potted plant, clean lines, natural light",
   "minimalist_bedroom.png"
)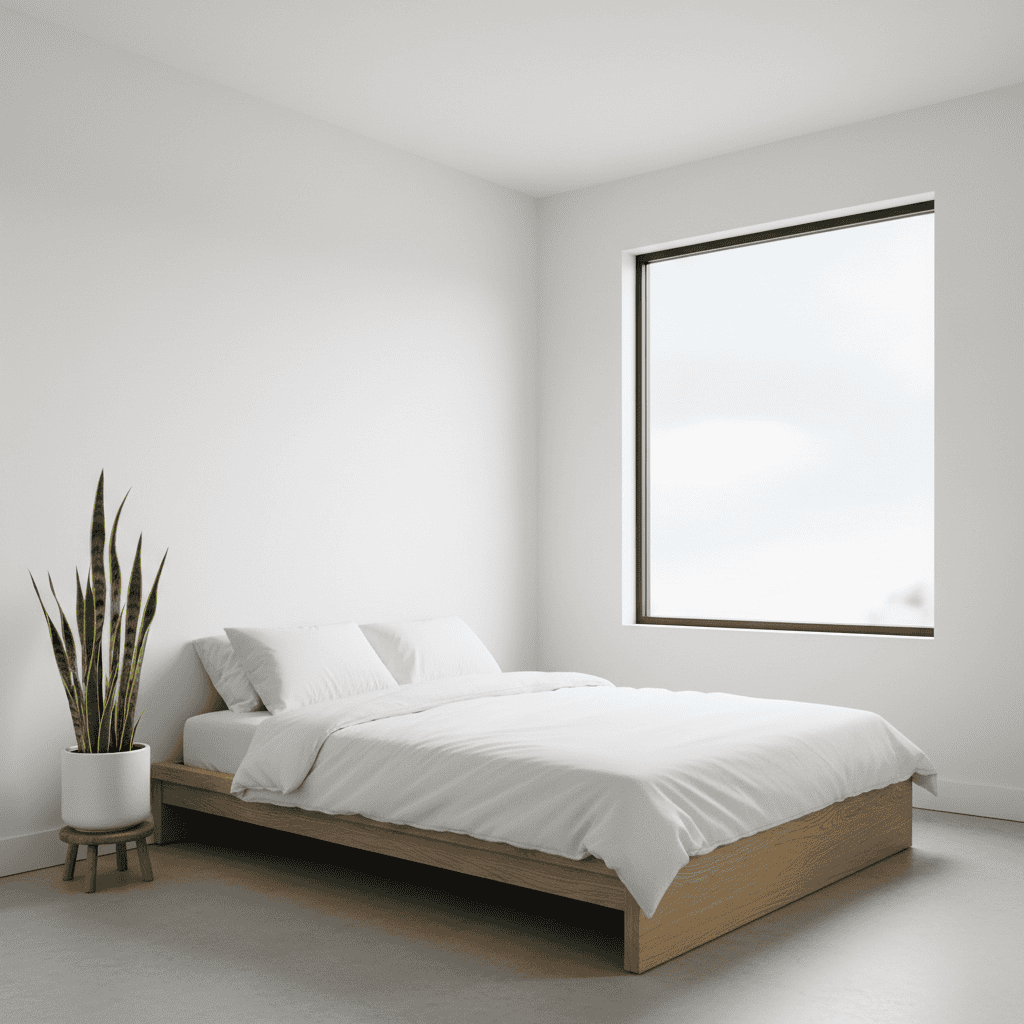
Princípios minimalistas criam um espaço calmo, sem excessos, ao mesmo tempo moderno e atemporal.
Estilo vintage:
generateandsave_image(
   "Vintage coffee shop interior, exposed brick walls, antique furniture, Edison bulb lighting, weathered wood tables, nostalgic atmosphere",
   "vintagecoffeeshop.png"
)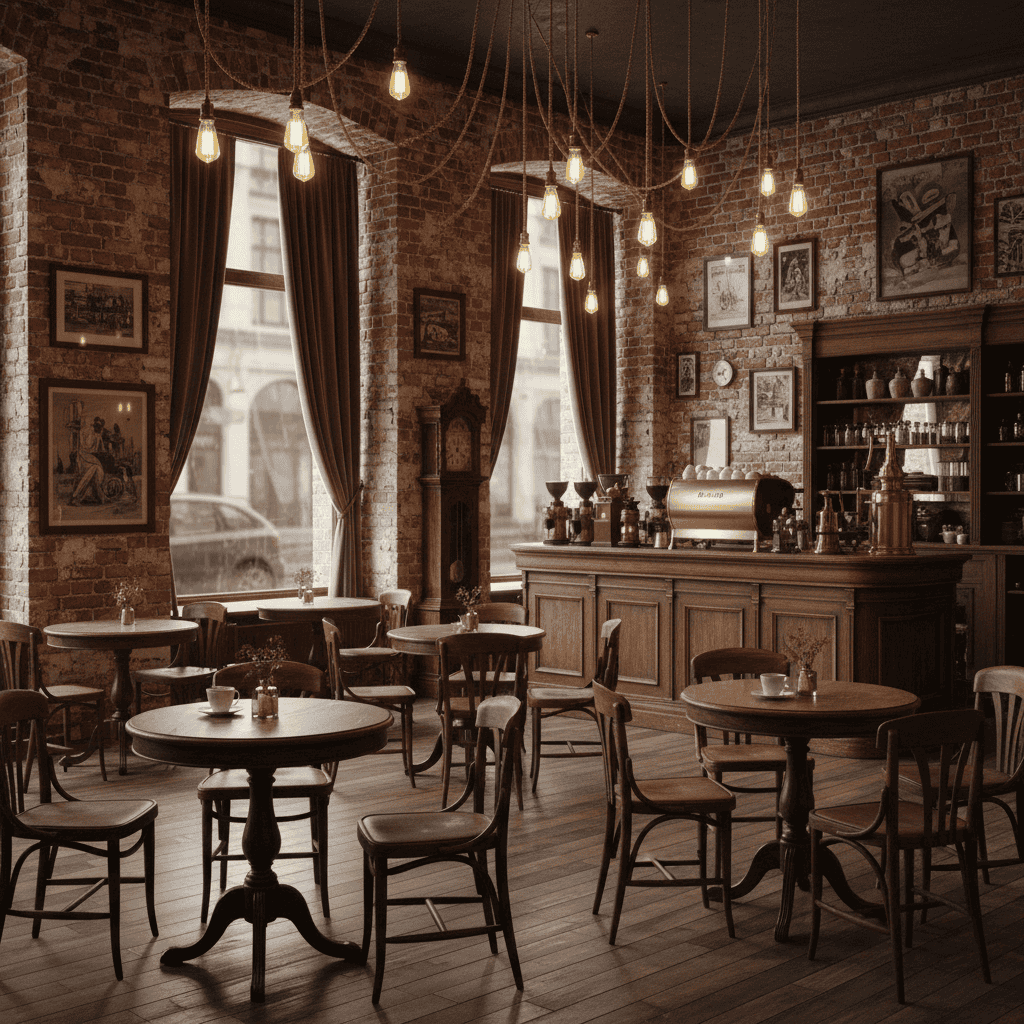
Elementos vintage se combinam para criar uma cafeteria nostálgica, com cara de lugar vivido e autêntico.
Direções de estilo populares:
"Industrial design" — materiais brutos, elementos expostos"Scandinavian style" — madeiras claras, linhas limpas, texturas aconchegantes"Art deco" — padrões geométricos, toques metálicos"Rustic charm" — materiais naturais, texturas desgastadasO Gemini 2.5 Flash Image se destaca em inserir texto legível diretamente nas imagens. Mantenha textos curtos (menos de 25 caracteres funciona melhor) para resultados limpos.
generateandsave_image(
   "Restaurant menu board with 'DAILY SPECIALS' text, chalk lettering on black board, wooden frame, warm lighting",
   "menuboardtext.png"
)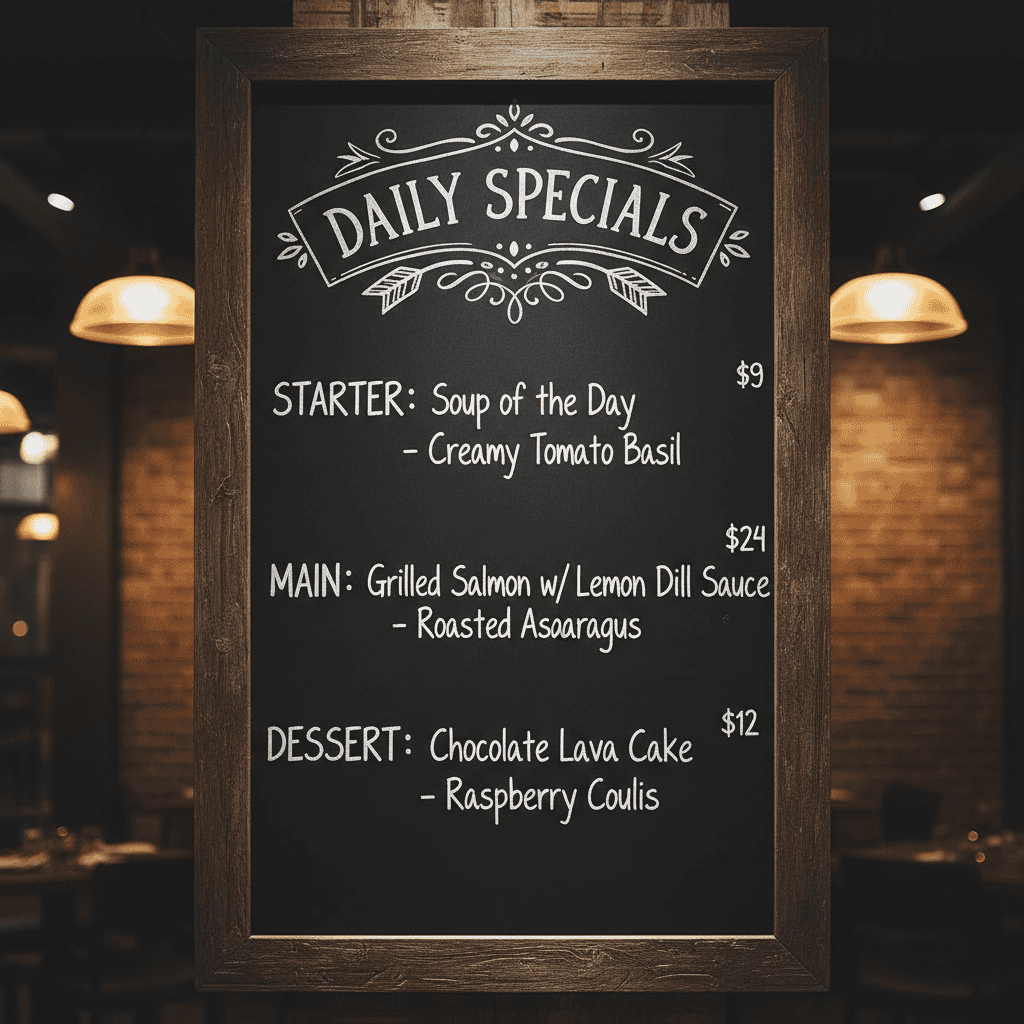
Integração perfeita do texto com elementos decorativos e preços, mostrando como o modelo lida naturalmente com tipografia e layout de menu.
O modelo adicionou itens e preços automaticamente para deixar a cena mais realista. Isso mostra como o Gemini entende contexto e cria composições completas e lógicas.
Os prompts mais poderosos combinam várias técnicas. Veja como sobrepor elementos:
# Combining camera control + lighting + style + specific details
generateandsave_image(
   "Low angle shot of modern office lobby, dramatic uplighting, marble floors, geometric ceiling, professional atmosphere",
   "professional_lobby.png"
)
Veja a imagem resultante com todas as técnicas juntas:
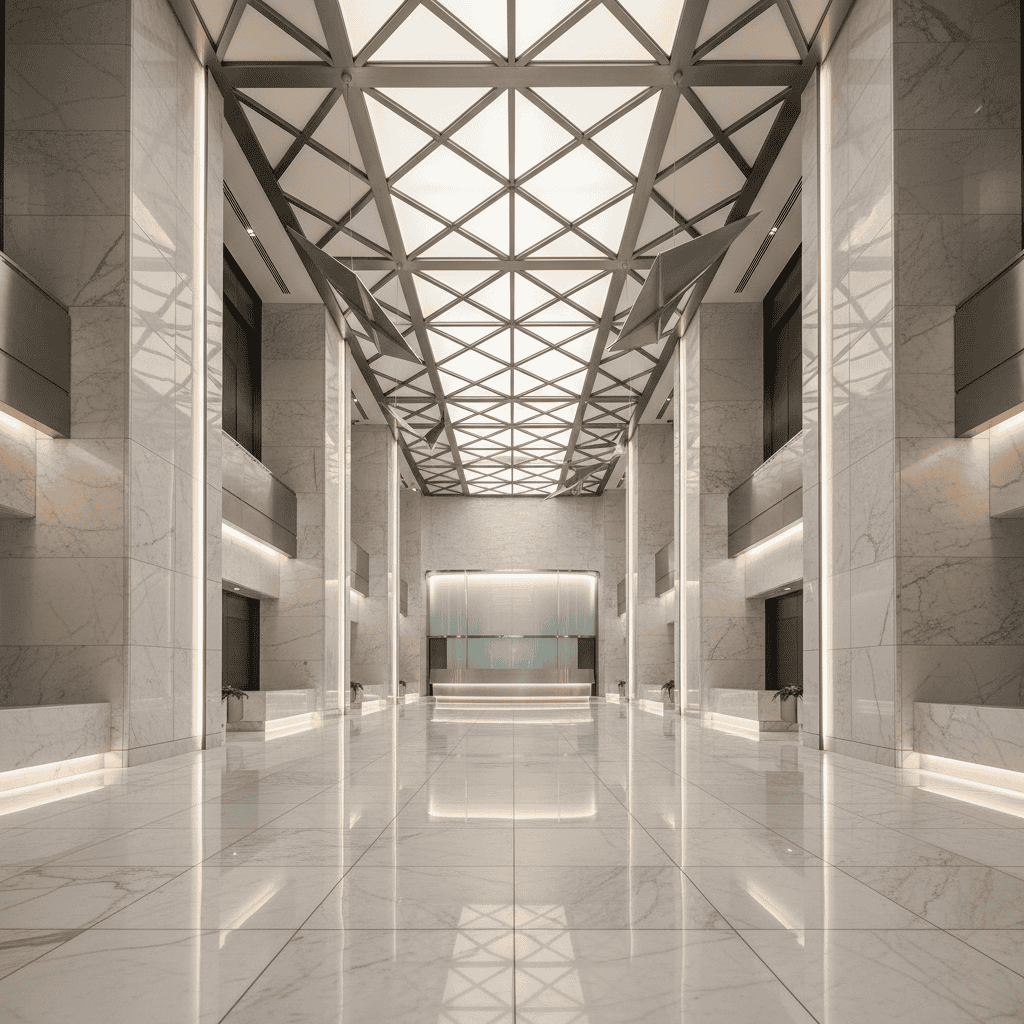
Este prompt combina:
Lembre que você sempre pode refinar suas imagens descrevendo as mudanças desejadas. O Gemini é ótimo em melhorias iterativas, o que nos leva aos recursos avançados que tornam esse modelo especial.
Para quem quer entender como o Gemini 2.5 Flash Image se compara a outras ferramentas do Google, nosso tutorial do Gemini 2.0 Flash explora as capacidades mais amplas do sistema multimodal do Google.
As técnicas de prompting que você aprendeu são a base para operações mais avançadas. Agora vamos aplicá-las aos recursos mais poderosos do Gemini — aqueles que o destacam de outros modelos:
Um dos recursos mais fortes é combinar várias imagens para criar algo novo. Isso é diferente de simples mescla — o Gemini entende os objetos e contextos em cada imagem e consegue uni-los de forma inteligente.
Neste exemplo, vamos supor que você já gerou os componentes base usando as técnicas anteriores. Veja como combiná-los:
# Load the base images for composition
gemstone_img = Image.open("https://cdn-images-1.medium.com/proxy/1*zy36GlKisNwsmJ0PwwHODw.png")
setting_img = Image.open("https://cdn-images-1.medium.com/proxy/1*fpNU31VkSznr1NTHbUx-mA.png")

# Compose them with specific instructions
response = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Mount the rare tanzanite gemstone perfectly into the platinum Art Nouveau setting, creating an exquisite luxury engagement ring, professional jewelry photography with dramatic lighting",
       gemstone_img,
       setting_img
   ]
)
Imagens base usadas na composição:
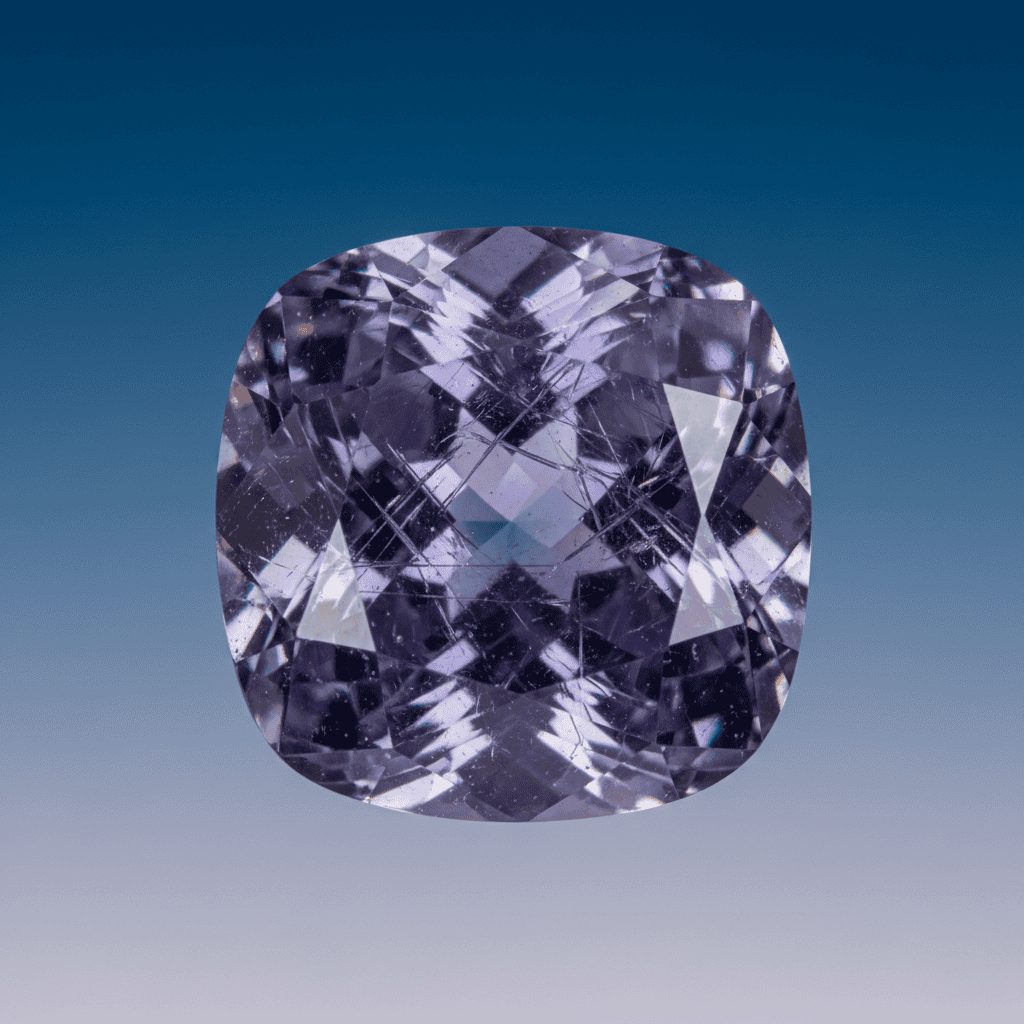
Componente base 1: tanzanita rara com clareza excepcional e estruturas prismáticas internas.
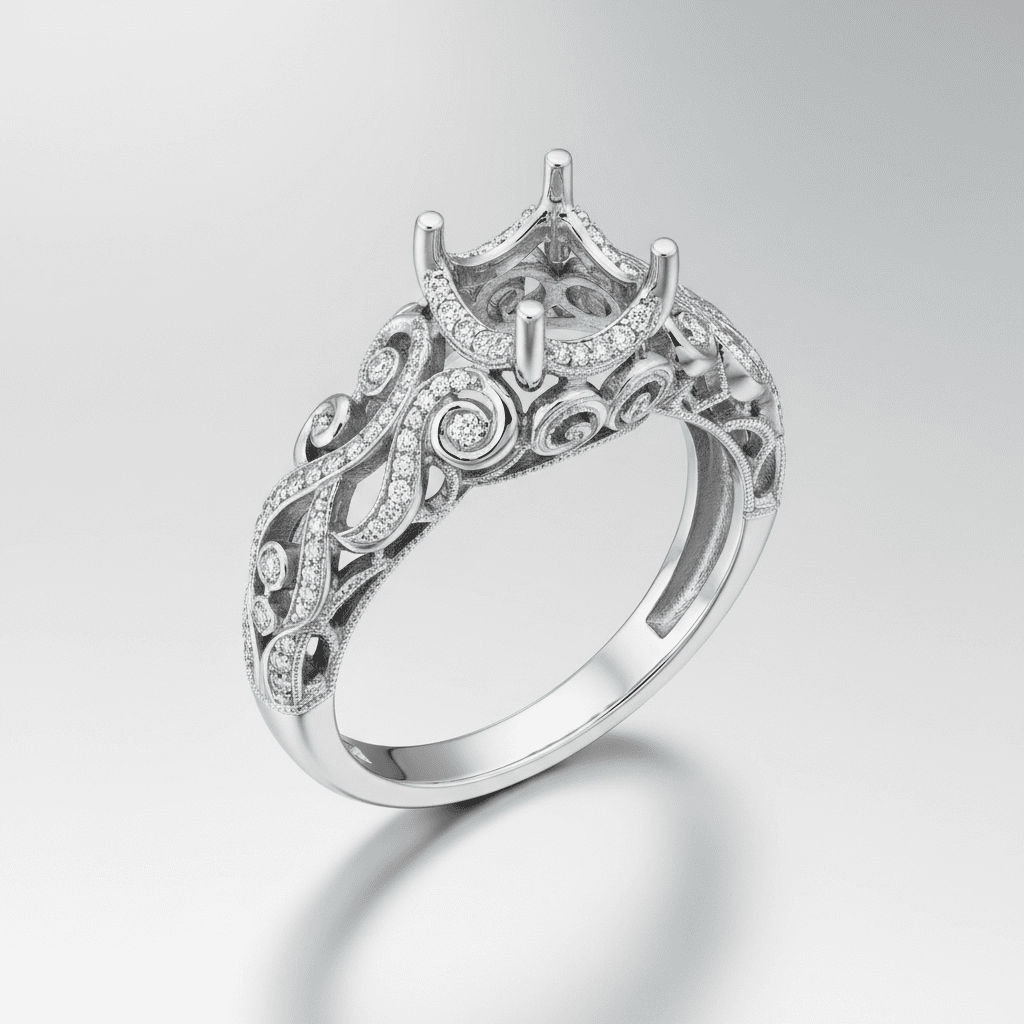
Componente base 2: aro em platina estilo Art Nouveau com filigrana primorosa.
Resultado composto:
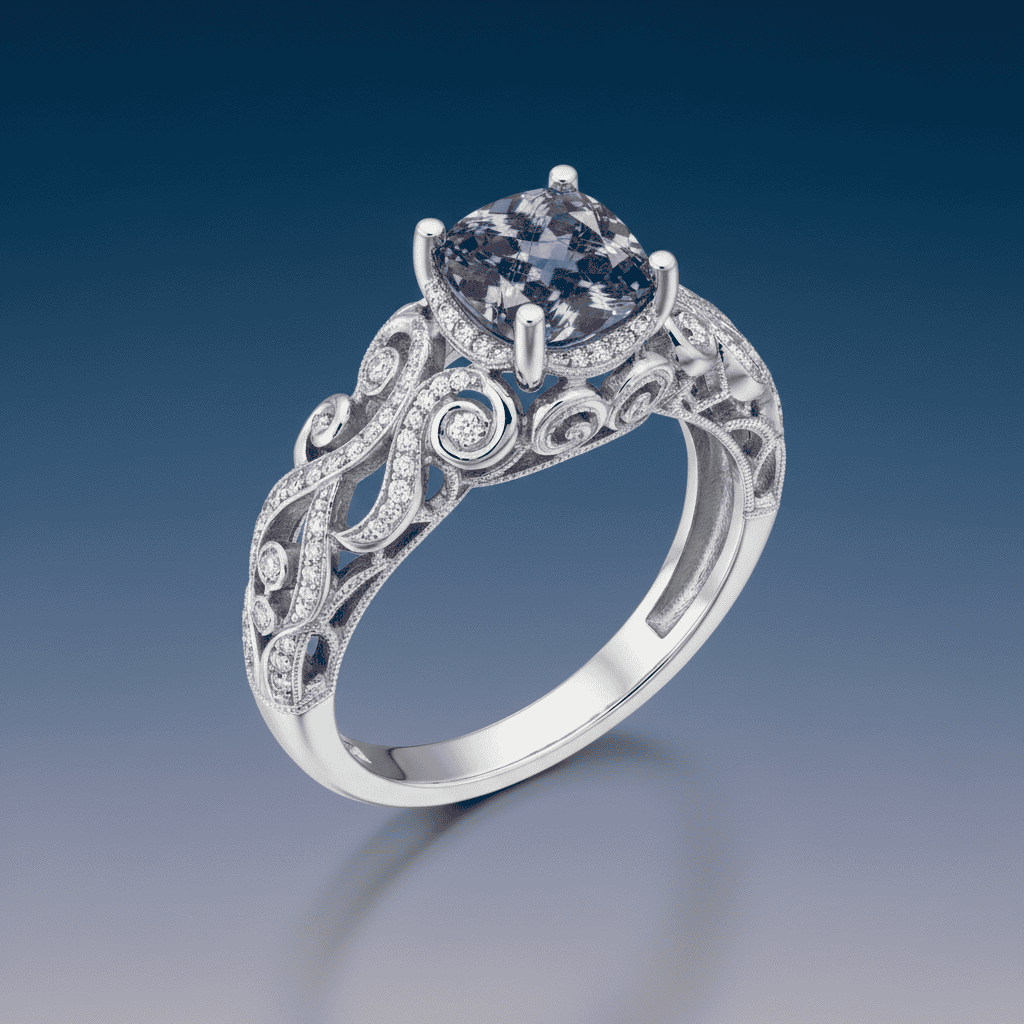
Composição final: gema e aro combinados de forma perfeita em uma peça de luxo, com iluminação que valoriza ambos os elementos.
O segredo para uma composição profissional é ser específico sobre:
Essa técnica funciona bem para:
Diferente da maioria dos modelos que exigem recomeçar para cada mudança, o Gemini 2.5 Flash Image permite melhorias progressivas por conversa. Isso é perfeito para fluxos de design profissionais, nos quais você precisa desenvolver conceitos.
Vamos trabalhar um desenvolvimento de equipamento de áudio premium:
# Step 1: Start with concept design
concept_img = Image.open("https://cdn-images-1.medium.com/proxy/1*2qw1o9vPjUMHCwYnvHiYbA.png")

# Step 2: First refinement - luxury materials
response1 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Refine this speaker with premium ebony wood veneer finish, hand-polished surfaces, subtle gold accent lines, maintaining same proportions",
       concept_img
   ]
)

# Step 3: Second refinement - high-tech features
luxuryimg = Image.open("https://cdn-images-1.medium.com/proxy/1*kytHi4QRCmbor1e35Nyyw.png")

response2 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Add sophisticated LED indicators, premium fabric grille, wireless connectivity features, maintaining all luxury finishes",
       luxury_img
   ]
)
Etapa 1: conceito
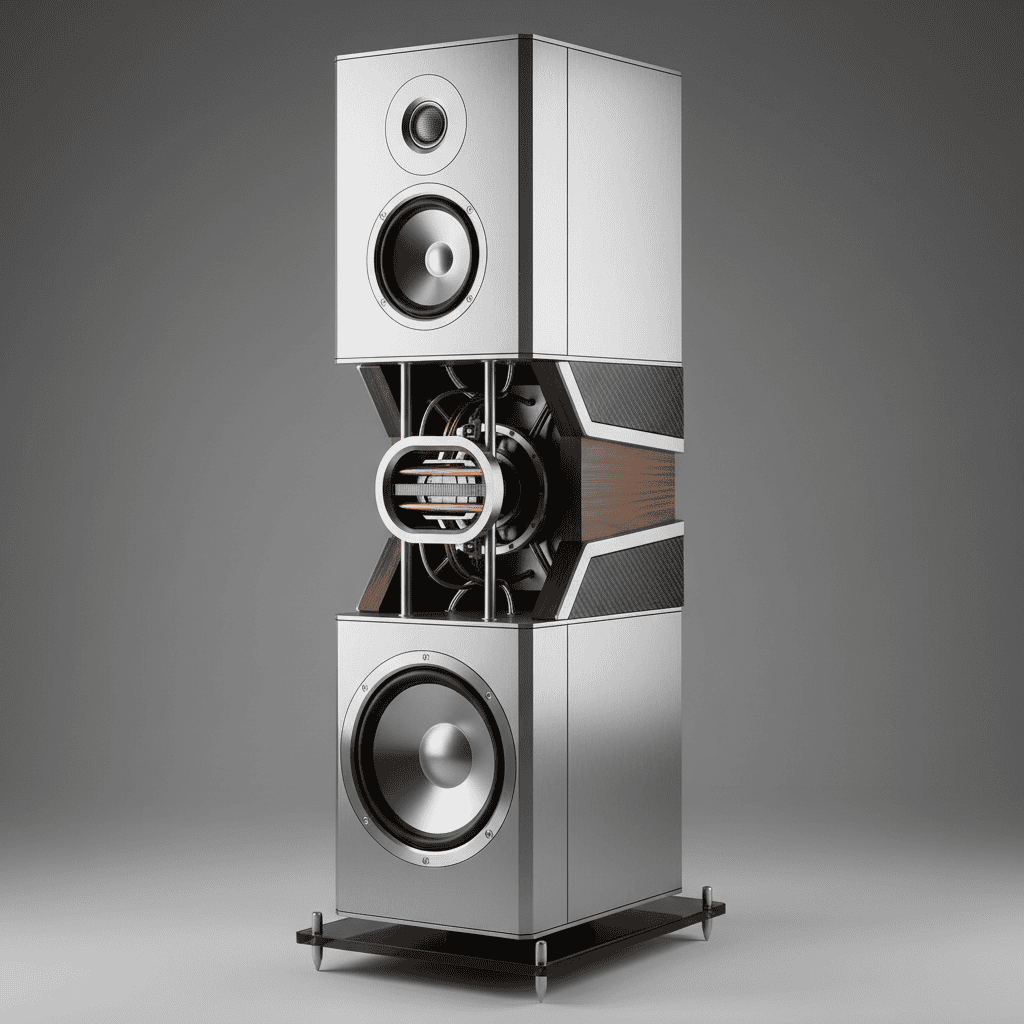
Conceito inicial: design geométrico limpo mostrando engenharia sofisticada e base de materiais premium.
Etapa 2: refinamento com materiais de luxo
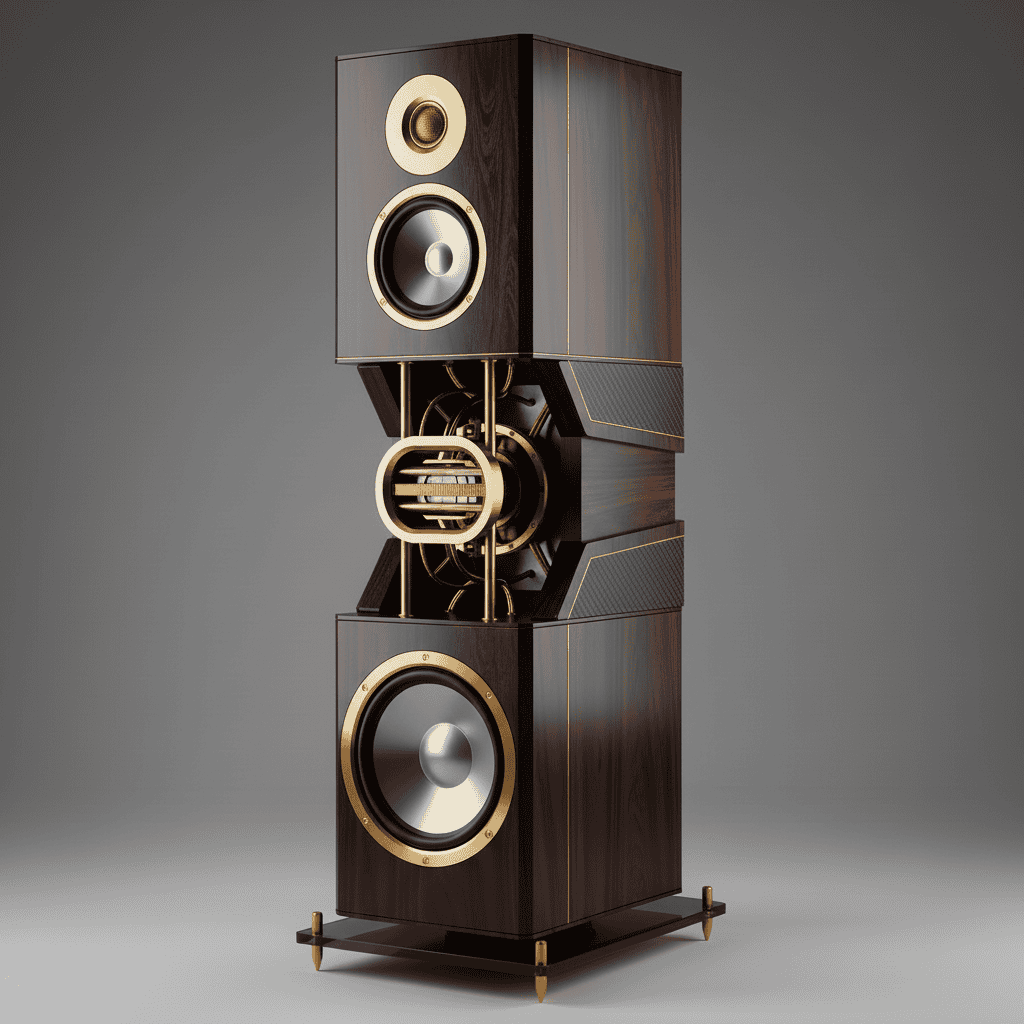
Primeira iteração: adição de lâmina de ébano premium e detalhes dourados polidos à mão, preservando as proporções originais.
Etapa 3: integração high-tech
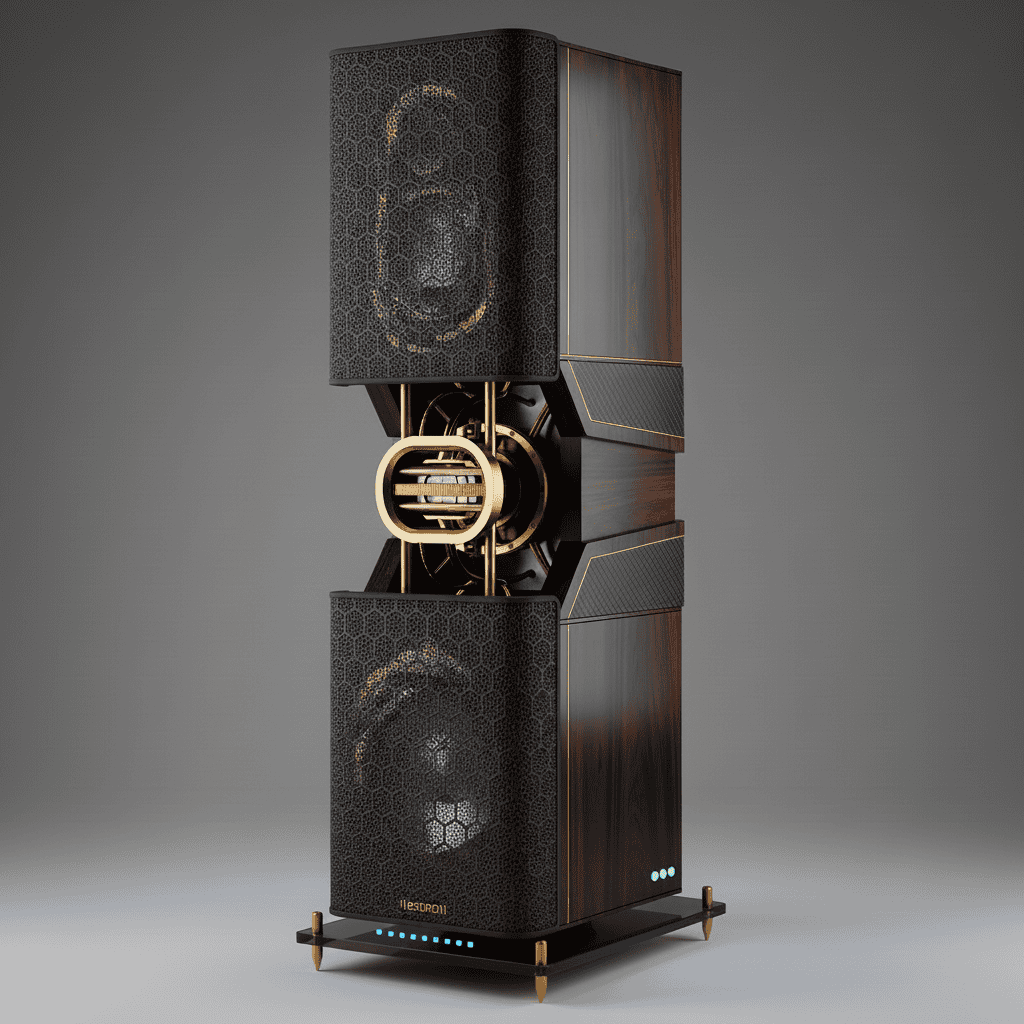
Iteração final: integração de indicadores de LED sofisticados e grade em tecido premium, mantendo todos os acabamentos de luxo.
Boas práticas para refinamento profissional iterativo:
Manter personagens consistentes em múltiplos contextos é importante para desenvolvimento de marcas de luxo e campanhas de marketing sofisticadas. O Gemini faz isso entendendo o “DNA visual” dos personagens e preservando-o em diferentes aplicações profissionais.
Veja como desenvolver um mascote de marca sofisticado:
# After creating your base character
basemascot = Image.open("https://cdn-images-1.medium.com/proxy/1*Szx9SZ9UPl7zsa5NKUDVg.png")

# Generate consistent applications
response1 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Show this exact crystal mascot in an upscale jewelry boutique, maintaining identical facets and rose-gold glow",
       base_mascot
   ]
)

response2 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Show this exact crystal mascot on luxury packaging design, maintaining identical geometric form and internal glow",
       base_mascot
   ]
)
Etapa 1: estabeleça o personagem da marca
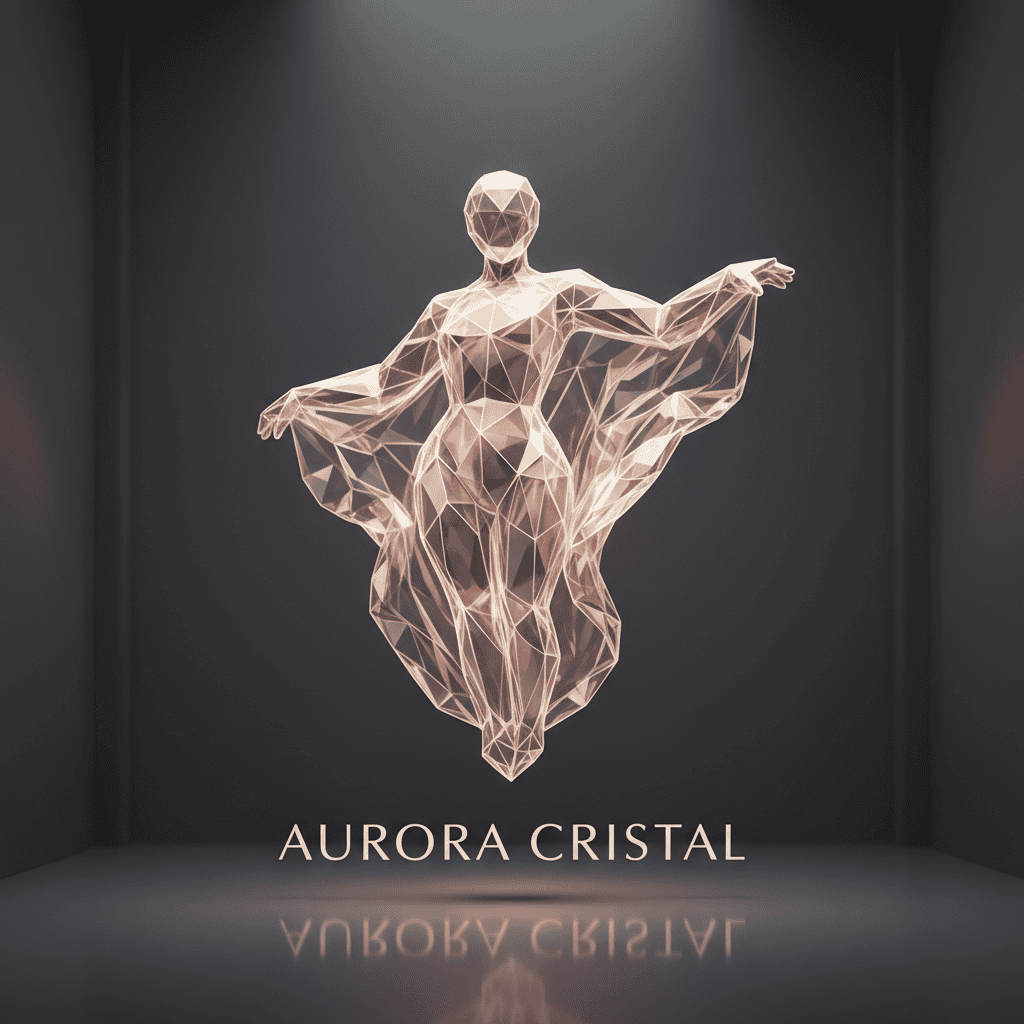
Base do personagem: ser cristalino sofisticado com facetas geométricas distintas e brilho interno em tom rose-gold.
Etapa 2: aplicação no varejo
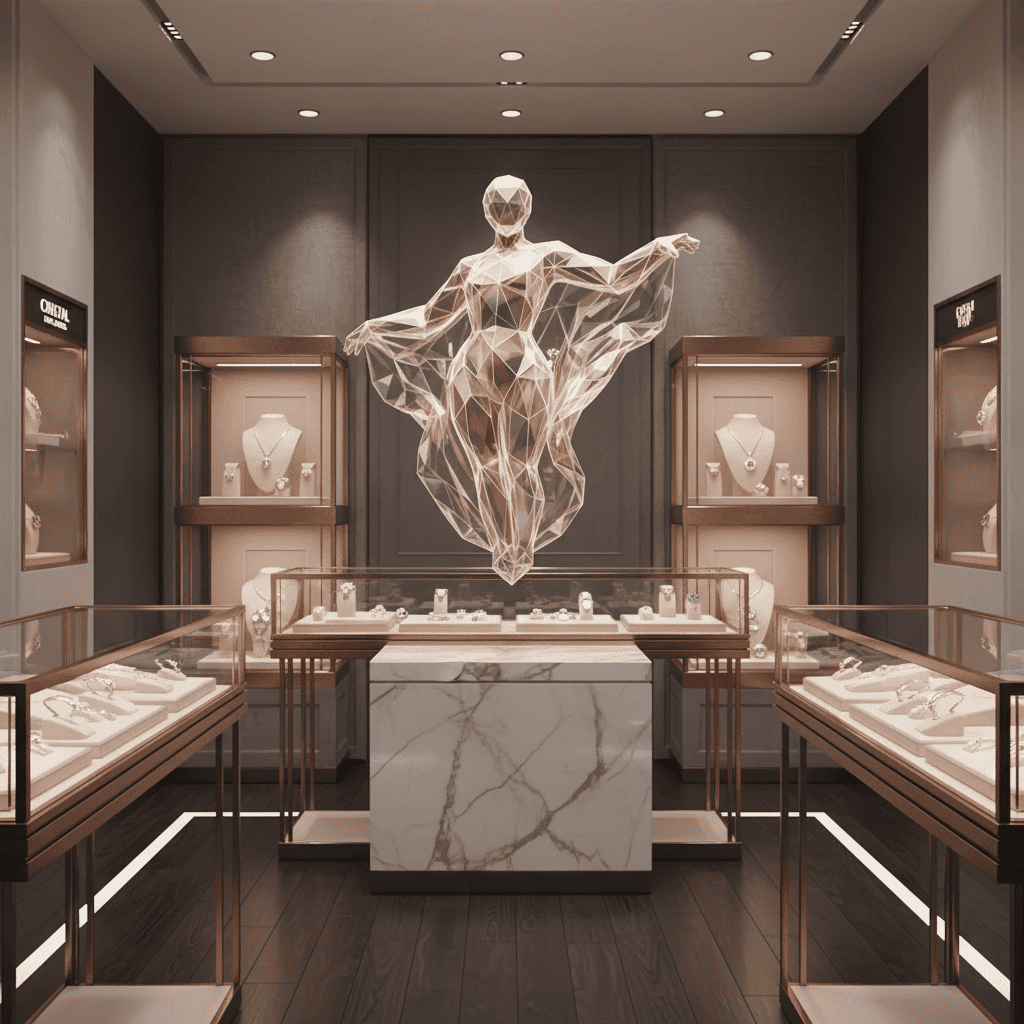
Aplicação em boutique: o personagem mantém facetas e brilho idênticos enquanto se adapta ao contexto de luxo.
Etapa 3: integração em embalagens
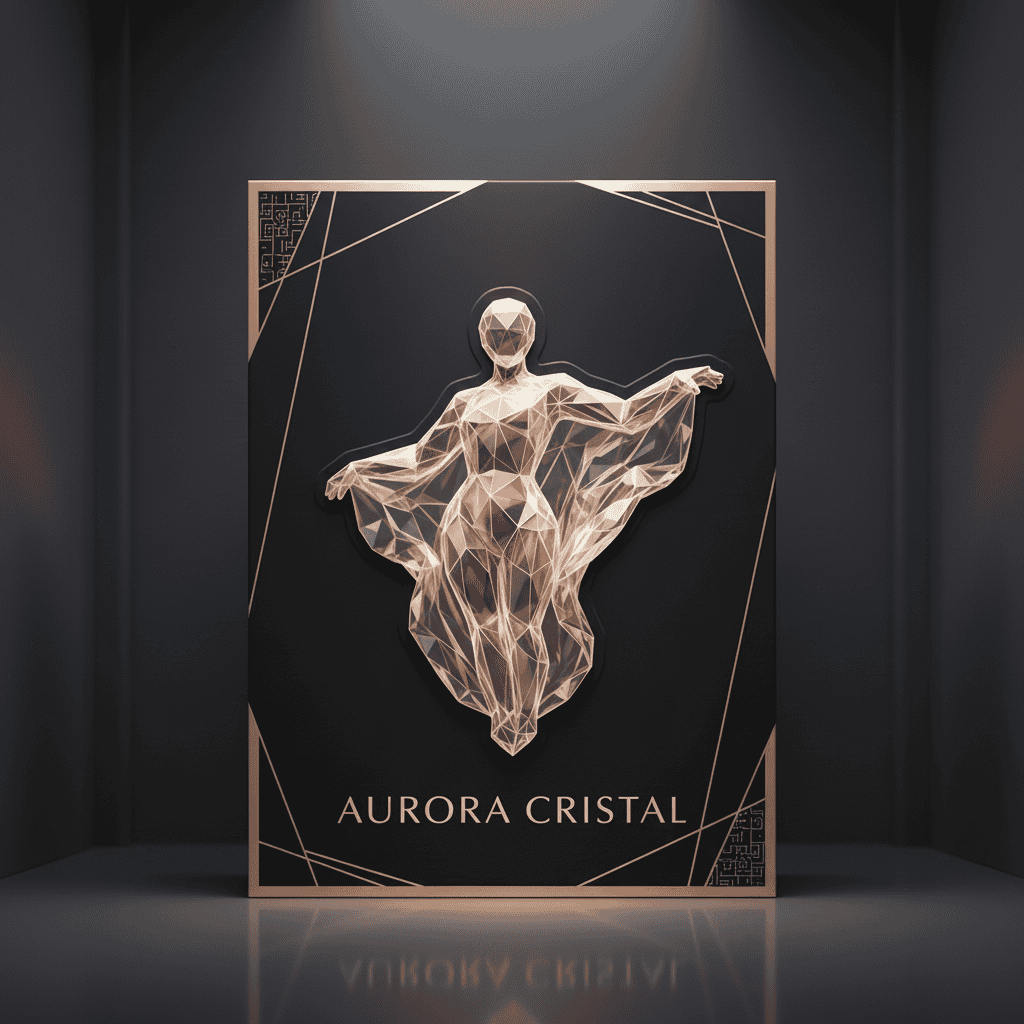
Integração em embalagem: personagem idêntico adaptado à estética premium da embalagem, com identidade visual consistente.
Etapa 4: presença em interfaces digitais
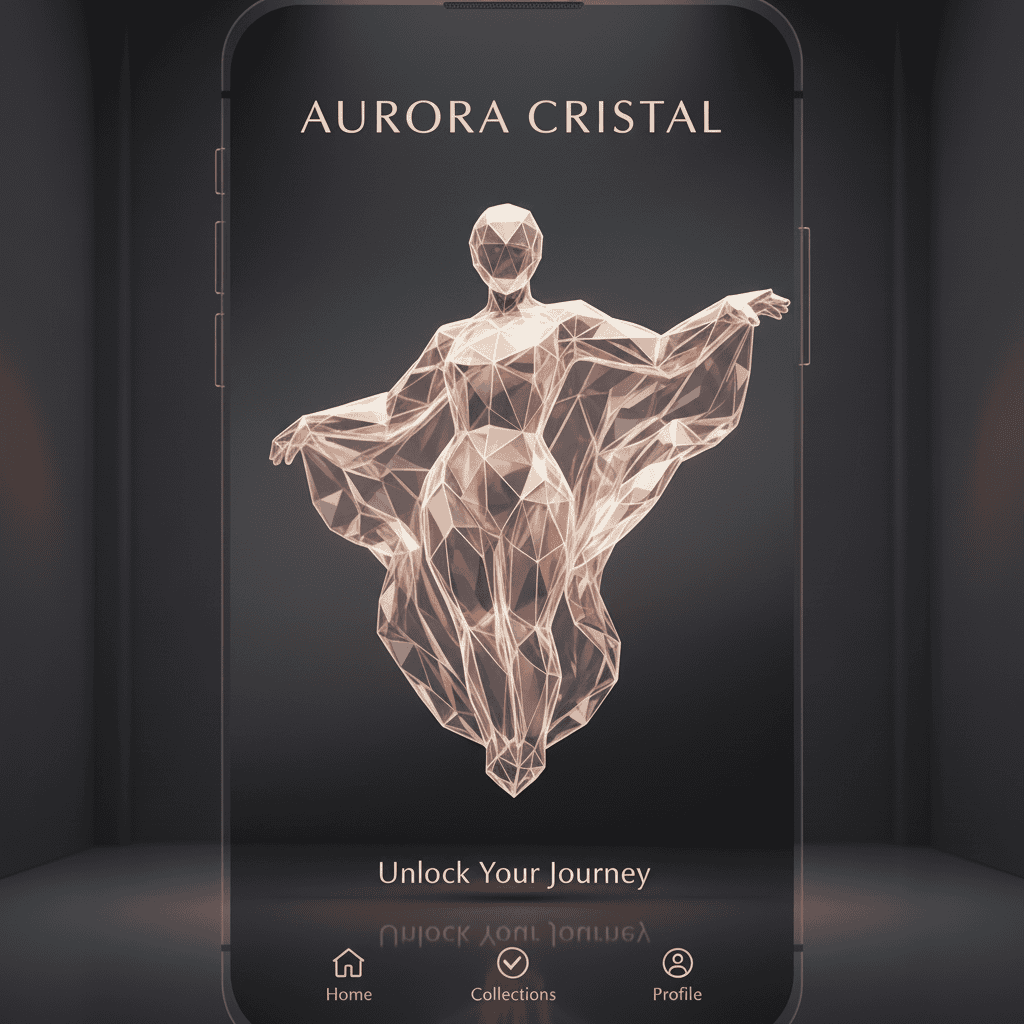
Aplicação digital: consistência do personagem mantida em plataformas digitais, com propriedades geométricas idênticas.
A frase-chave para consistência profissional é “this exact [character]” combinada a descrições específicas: “maintaining identical facets”, “same geometric form”, “identical rose-gold glow”.
Para uma consistência profissional, é melhor quando você:
Esse recurso é valioso para:
Além de editar conteúdo, você pode mudar completamente a estética dos objetos preservando a estrutura principal. Isso é poderoso para testar direções de design rapidamente.
Objeto base para testes de estilo:
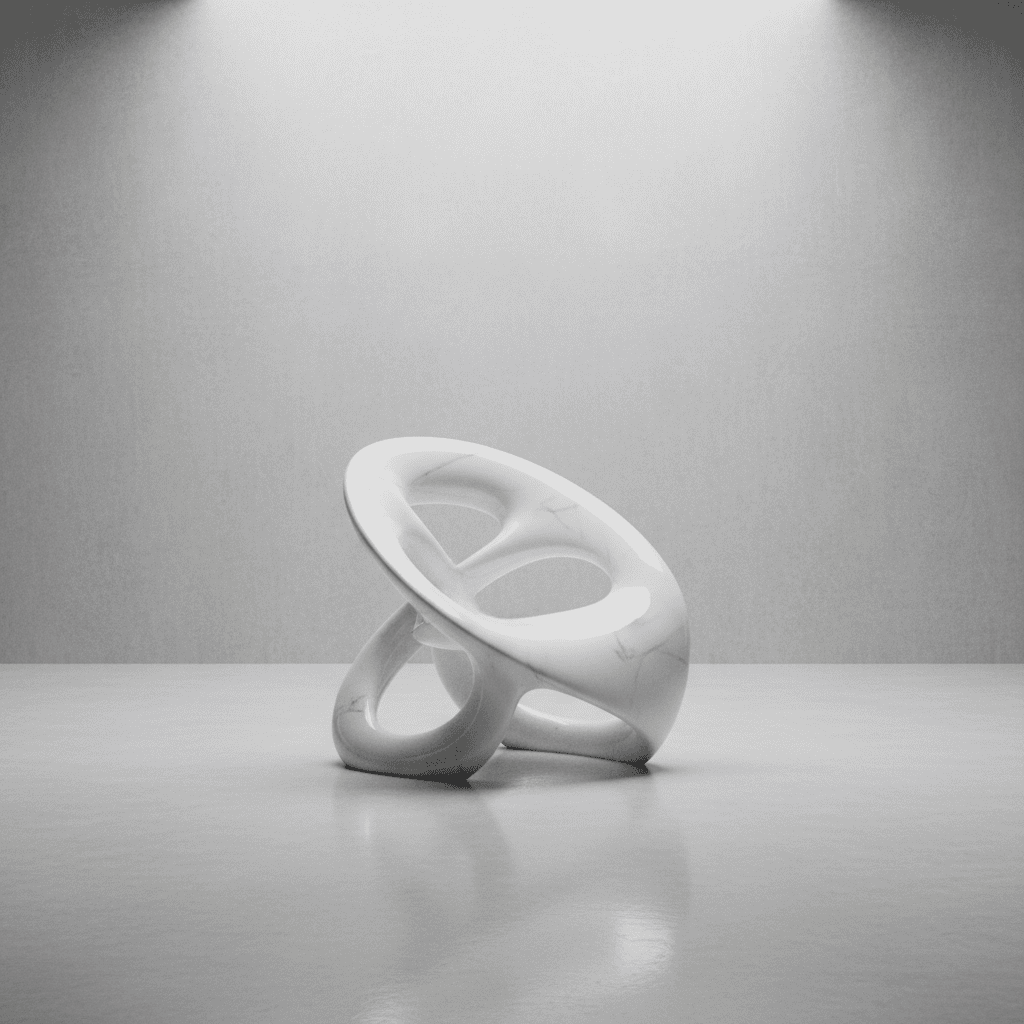
Ponto de partida: uma cadeira escultural sofisticada que vamos transformar em estilos completamente diferentes.
Transformação cyberpunk:
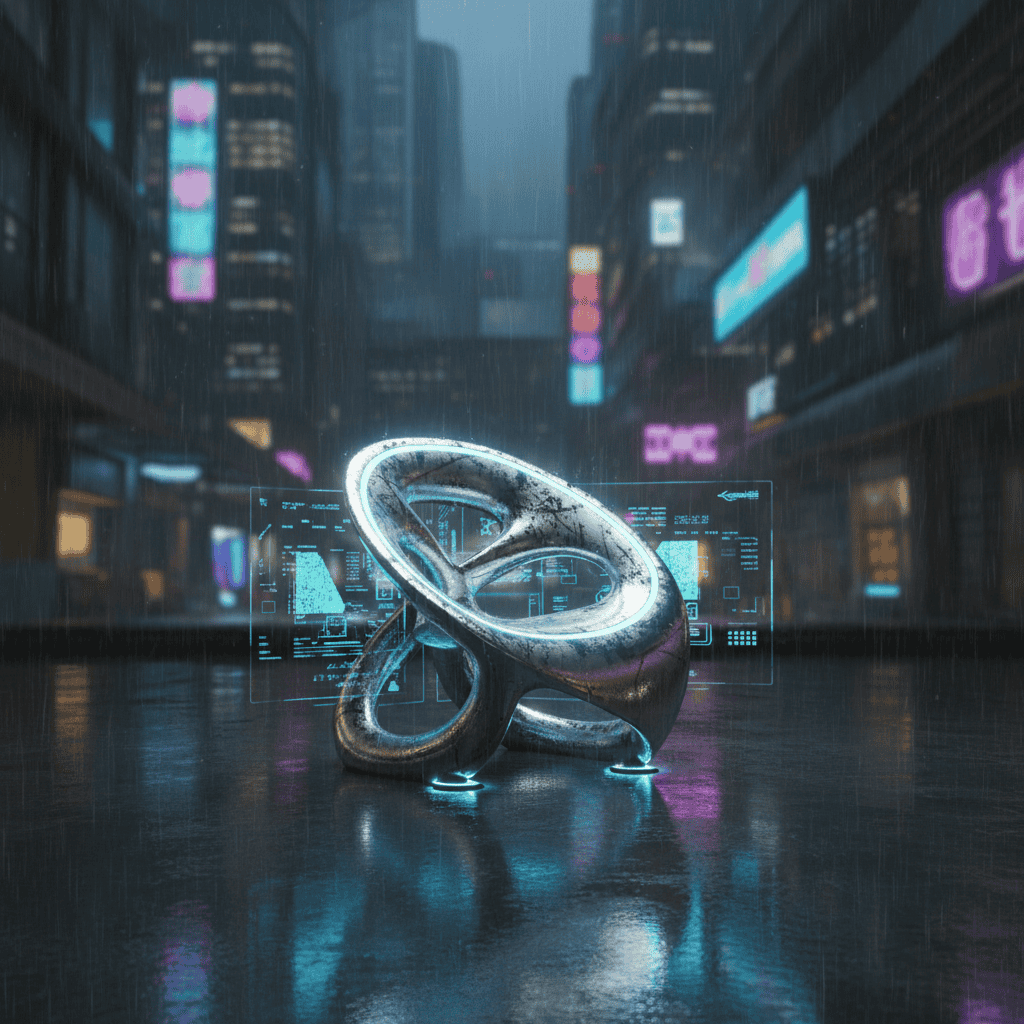
Versão cyberpunk: estética futurista de alta tecnologia com neon e acabamento metálico, preservando a forma básica da cadeira.
Transformação vitoriana barroca:
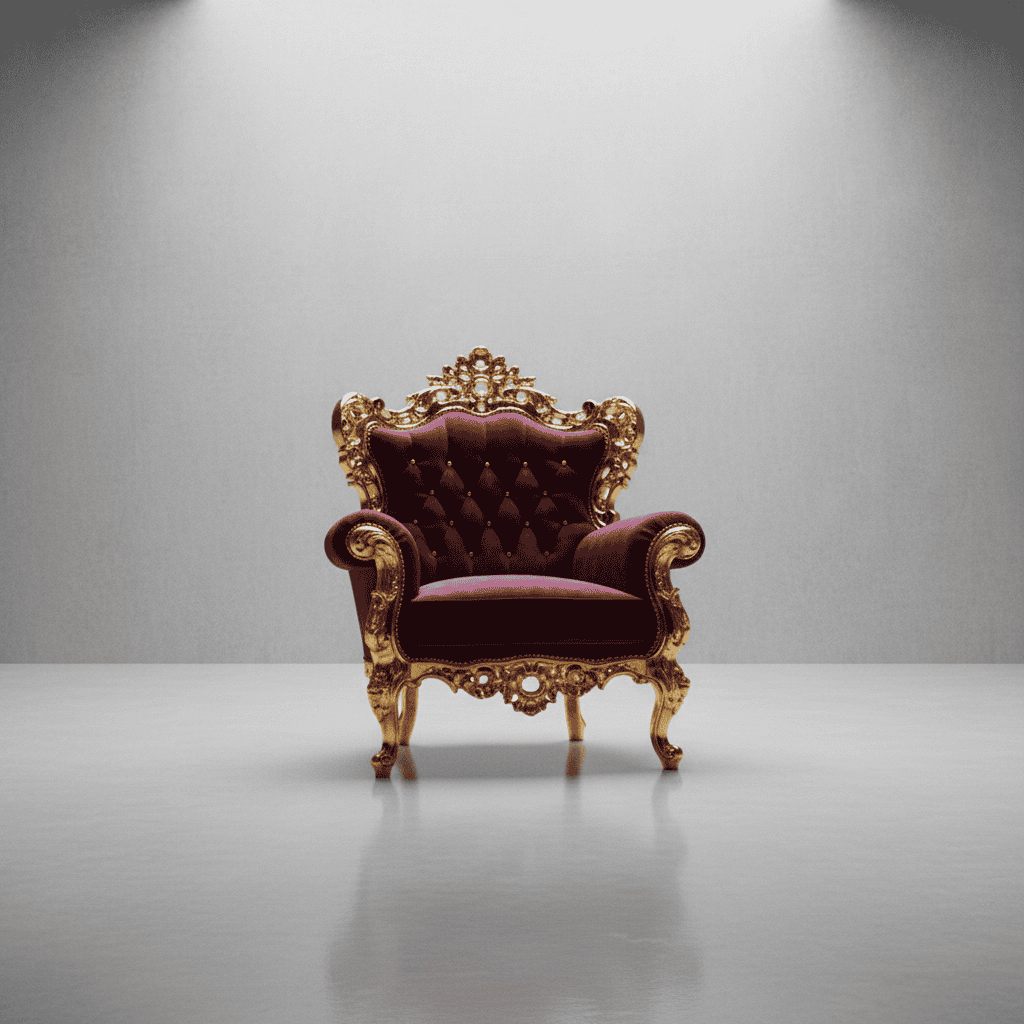
Estilo barroco: design clássico rico e ornamentado, com materiais luxuosos e detalhes intrincados, mantendo a estrutura subjacente.
O padrão para transferência de estilo:
# Load your base object
base_object = Image.open("https://cdn-images-1.medium.com/proxy/1*TWO2meqMNnS1-6XSO6yv7Q.png")

# Apply style transformations
response = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Change this chair into cyberpunk style with neon LED strips, chrome frame, futuristic aesthetic",
       base_object
   ]
)
Aplicações de transferência de estilo:
Esses recursos avançados — composição multi-imagem, refinamento iterativo, consistência de personagens e transferência de estilo — representam as vantagens centrais que tornam o Gemini 2.5 Flash Image especialmente poderoso para fluxos de trabalho profissionais.
O Gemini 2.5 Flash Image traz uma abordagem diferente para geração de imagens. Você pode editar por conversa, sem precisar recomeçar a cada mudança. O recurso de consistência de personagens mantém elementos visuais iguais em cenas distintas, e a composição multi-imagem permite combinar elementos de forma natural, sem parecer forçado.
A precificação por tokens dá previsibilidade de custos para o planejamento de projetos. Quando quiser ir além do básico, a documentação oficial cobre recursos adicionais e se mantém atualizada com novos lançamentos. As técnicas deste tutorial dão uma base sólida para incorporar geração de imagens conversacional ao seu fluxo de trabalho.
Para ampliar seu kit de ferramentas de IA além do Gemini, nosso guia prático de edição de imagens com o Gemini explora outras capacidades de edição, enquanto nosso tutorial de DALL-E 3 cobre a abordagem alternativa da OpenAI para geração de imagens com IA.
Principais cursos da DataCamp
Curso
Curso
Programa