
课程
使用 LangChain 开发 LLM 应用
3 小时
51.3K
在检索增强生成(RAG)时代,LangChain 等框架因开发 AI 应用而广受欢迎。然而,随着行业转向 Agentic AI 工作流,像 Haystack AI 这样的框架因其灵活性、模块化以及在处理广泛用例方面的有效性而愈发受到重视。
在本教程中,我们将了解 Haystack AI,探索其关键组件和使用场景,并学习如何构建可集成多种工具的 AI Agentic 工作流。Agentic 工作流指的是让语言模型能够根据用户查询,自主调用工具和组件以达成目标的系统。
如果您是新手,建议先阅读我们的 Agentic AI 与 Agentic RAG 教程。
我们通过每周五免费通讯 The Median,帮读者了解一周内 AI 领域的重点资讯。订阅它,只需每周花几分钟即可快速掌握要点:
Haystack 是一款开源框架,用于构建高度可定制、可用于生产环境的 大语言模型(LLM)应用。它使开发者能够创建多种 AI 系统,包括 RAG 管道、基于智能体的工作流、先进搜索系统,甚至完全自治的 AI 应用。
Haystack 的模块化架构允许开发者集成主流的 AI 技术与工具,包括 OpenAI、Hugging Face Transformers、Chroma、MCP 工具、Elasticsearch 等。
它比 Langchain 更简洁,并提供了大量工具,助您用寥寥数行代码就能创建组件与智能体。
Haystack 的核心由组件与管道组成,并与 LLM 提供商、文档存储、工具、智能体以及丰富的生态集成协同工作。这些构件为开发者提供了设计、定制与部署端到端 AI 系统的能力。
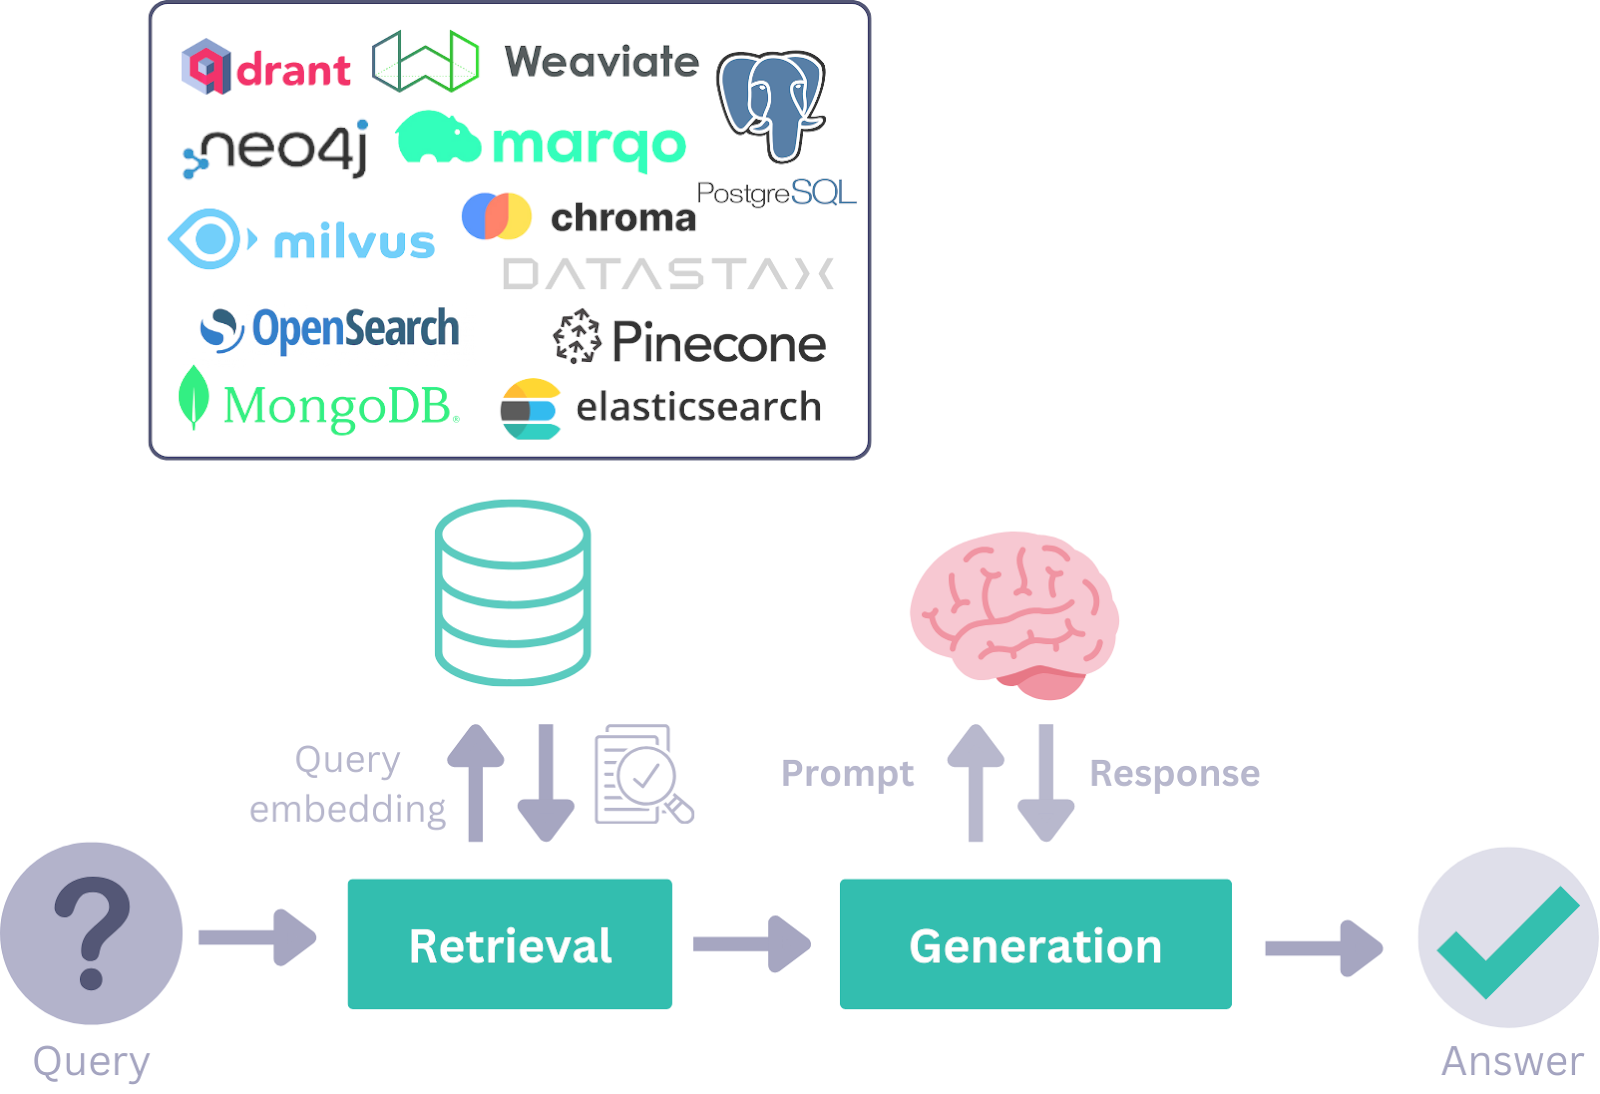
借助以下 Haystack 组件,您可以构建稳健的 RAG 工作流、Agentic 管道,或二者结合以实现更高级的 AI 应用。
Haystack 为特定任务(如检索、生成或文档存储)提供了多种组件。这些组件是带有可调用方法的 Python 类,通过参数初始化,并通过 run() 方法执行。
组件 API 简化了自定义组件的创建流程,包括对第三方 API 和数据库的支持。
生成器负责根据接收到的提示生成文本响应。在后端,这些生成器利用 LLM 提供商的 API,并可根据特定需求进行定制。
生成器分为两类:
1. 聊天生成器:面向对话场景,通过处理一系列消息实现聊天补全。
2. 非聊天生成器:用于较为简单的文本生成任务,如翻译或摘要。
根据用户查询从文档存储中检索相关文档。该系统可针对特定文档存储进行定制,利用自定义参数以满足独特的数据库需求。例如,Elasticsearch 文档存储同时提供检索器与文档存储包。
Haystack 的文档存储接口可高效管理文档。它包含 write_documents () 与 delete_documents () 等函数用于数据管理。组件可轻松与文档存储交互以读写文档。对于更复杂的工作流,可使用 DocumentWriter 组件将数据写入文档存储。
数据类以简洁、模块化的方式简化组件间的通信。在管道中,信息以输入或输出的形式在系统内交换。
数据类分为两种:
管道将组件、文档存储与各类集成组合为可定制的工作流。它们支持并行流程、独立组件、循环,以及预处理、索引与查询步骤。管道可保存为 YAML 或 TOML 格式,以便复用或分享。
AI 智能体 是利用大语言模型进行决策并处理复杂任务的自主系统。您可以构建工具以连接 API,将其赋予智能体,然后提出问题。智能体会分析您的查询,并基于问题使用合适的工具。
本节将应用 Haystack 的关键组件,构建一个 AI Agentic 工作流,并根据用户查询选择使用 RAG 或网页访问工具。
本指南将使用 DataLab 作为编码环境。我们将安装以下 Python 包:Haystack、OpenAI、Tavil 和 itertools。各包用途如下:
!pip install -qU \
    "haystack-ai[agentst]" \
    tavily-python \
    openai \
    more_itertools
要使用 OpenAI 与 Tavily,请将其 API 密钥设置为环境变量。如果您在使用 DataLab,可通过进入 Environment 选项卡并选择 Environment Variables 来添加环境变量。
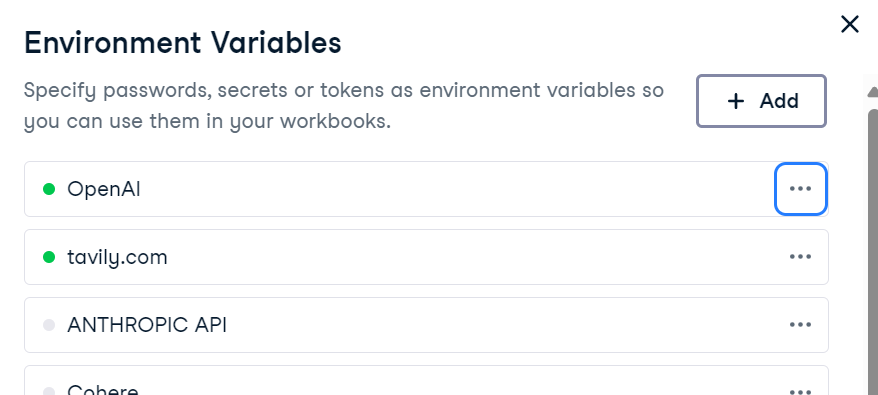
或者,您也可以在 Python 中以编程方式设置:
import os

os.environ["OPENAI_API_KEY"]  = "sk-..."   # ← paste your OpenAI key
os.environ["TAVILY_API_KEY"] = "tvly-..." # ← paste your Tavily key我们将使用 Haystack 的 Document 数据类创建一个知识库。该知识库将包含关于伊斯兰堡市的信息。
from haystack.dataclasses import Document
from typing import List, Any, Dict


docs: List[Document] = [
    Document(content="Islamabad experiences a humid subtropical climate with hot summers and mild winters."),
    Document(content="Peak tourist season in Islamabad is during spring (March to May) and autumn (September to November) due to pleasant weather."),
    Document(content="Faisal Mosque, one of the largest mosques in the world, is an iconic landmark in Islamabad designed by Turkish architect Vedat Dalokay."),
    Document(content="Islamabad was purpose-built as the capital of Pakistan in the 1960s, designed by Greek architect Constantinos Apostolos Doxiadis."),
    Document(content="The city is known for its well-planned infrastructure, wide roads, and green spaces, making it one of the most organized cities in Pakistan."),
]文档存储充当向量库,存储文本嵌入,并支持基于用户查询的高效检索。
我们将完成以下步骤:
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.embedders import OpenAIDocumentEmbedder
from haystack.components.writers import DocumentWriter
from haystack import Pipeline, component

document_store = InMemoryDocumentStore(embedding_similarity_function="cosine")

indexing_pipeline = Pipeline()
indexing_pipeline.add_component("embedder", OpenAIDocumentEmbedder(model="text-embedding-3-small"))
indexing_pipeline.add_component("writer", DocumentWriter(document_store=document_store))
indexing_pipeline.connect("embedder", "writer")

indexing_pipeline.run({"embedder": {"documents": docs}})
运行管道后,文档已成功存储为嵌入:
Calculating embeddings: 1it [00:00,  1.34it/s]


{'embedder': {'meta': {'model': 'text-embedding-3-small',
   'usage': {'prompt_tokens': 128, 'total_tokens': 128}}},
'writer': {'documents_written': 5}}在文档存储填充完成后,我们将创建一个自定义的 RAG 搜索工具。
该工具将:
from haystack.tools import ComponentTool
from haystack.components.embedders import OpenAIDocumentEmbedder, OpenAITextEmbedder
from haystack.components.retrievers.in_memory import InMemoryEmbeddingRetriever

@component()
class RagSearcher:
    """Query ‑> top‑k docs from the private store"""
    def __init__(self, document_store, top_k: int = 3):
        self.text_embedder = OpenAITextEmbedder(model="text-embedding-3-small")
        self.retriever = InMemoryEmbeddingRetriever(document_store=document_store, top_k=top_k)

    @component.output_types(documents=List[Document])
    def run(self, text: str) -> Dict[str, Any]:
        emb_out = self.text_embedder.run(text=text)
        docs_out = self.retriever.run(query_embedding=emb_out["embedding"])
        return {"documents": docs_out["documents"]}

rag_tool = ComponentTool(
    component=RagSearcher(document_store),
    name="rag_search",
    description="Semantic search over the Islamabad knowledge base."
)由于 Tavily 尚无原生 Haystack 组件,我们将使用 Tavily API 创建一个自定义网页搜索工具。该工具将获取实时网页搜索结果,并以 Document 对象形式返回。
import os
import requests
from haystack import component
from haystack.dataclasses import Document
from typing import List

@component
class TavilyWebSearch:
    def __init__(self, api_key: str, top_k: int = 3):
        self.api_key = api_key
        self.top_k   = top_k

    def run(self, query: str):
        resp = requests.post(
            "https://api.tavily.com/search",
            json={
                "api_key": self.api_key,
                "query": query,
                "max_results": self.top_k,
                "include_answer": True,
            },
            timeout=15,
        )
        resp.raise_for_status()
        data = resp.json()

        docs: List[Document] = []
        if answer := data.get("answer"):
            docs.append(Document(content=answer, meta={"source": "tavily:direct_answer"}))

        for hit in data.get("results", []):
            docs.append(
                Document(
                    content=hit["content"],
                    meta={
                        "title": hit["title"],
                        "url": hit["url"],
                    },
                )
            )
        return {"documents": docs}


web_tool = ComponentTool(
    component=TavilyWebSearch(api_key=os.environ["TAVILY_API_KEY"], top_k=3),
    name="web_search",
    description="Live web search via Tavily ."
)我们将使用 OpenAI 的函数与最新的 gpt-4.1-mini 模型创建生成器。首先编写系统提示,帮助智能体判断针对特定用户请求应使用哪些工具。最后,使用生成器、系统提示和工具列表来创建智能体。
基于系统提示,智能体将首先通过 RAG 搜索检查信息。若用户的问题涉及最新资讯、天气或突发新闻,智能体将直接使用网页搜索工具。
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.agents import Agent

generator = OpenAIChatGenerator(model="gpt-4.1-mini")

system_prompt = """
You are a helpful assistant.
- Use rag_search first to retrieve information from the knowledge base.
- Use web_search only when the query requires fresh, real-time, or external information (e.g., weather, breaking news).
"""

agent = Agent(
    chat_generator=generator,
    system_prompt=system_prompt,
    tools=[rag_tool, web_tool],
)我们将提出一个关于伊斯兰堡的问题,以触发 RAG 工具作答。
from haystack.dataclasses import ChatMessage

msg = ChatMessage.from_user("What is the peak tourist season in Islamabad?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
我们得到了高度贴合语境的答案,但如何确认它确实使用了 RAG 工具来回答?
The peak tourist season in Islamabad is during spring (March to May) and autumn (September to November).为检查调用了哪些工具,我们将创建一个函数来提取相关信息。
def tools_used(run_output: dict) -> list[str]:
    seen, ordered = set(), []

    for msg in run_output["messages"]:
        for call in msg.tool_calls:
            if call.tool_name not in seen:
                ordered.append(call.tool_name)
                seen.add(call.tool_name)
    return ordered
print("Tools invoked →", tools_used(resp))
在第一次测试中,智能体仅使用了 rag_search 工具来回答问题。
Tools invoked → ['rag_search']现在我们来询问伊斯兰堡的天气。它将不再调用 RAG 工具,而是使用网页搜索工具作答。
msg = ChatMessage.from_user("What is the temperature in Islamabad now?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
print("Tools invoked →", tools_used(resp))
答案非常准确,而且它确实使用了网页搜索工具来回答问题。
The current temperature in Islamabad is 31°C with a real-feel temperature of 32°C.
Tools invoked → ['web_search']
如果您在运行上述代码时遇到问题,请参考 Datalab 笔记本:Haystack AI 教程 — DataLab。
我们已经介绍了 Haystack AI 框架的基础。下一步,您可以创建一个功能完备的 AI 应用。以下是开发者正在探索的一些用例:
在使用过众多 LLM 框架后,我认为 Haystack 是最直观、最灵活的选择之一。它更自然易用,复杂度更低,并能让您对工作流拥有更强的掌控力。
其一大亮点是,您可以非常轻松地为管道创建自定义组件,从而适配广泛的用例。
我尤其喜欢尝试智能体与工具,并学习如何高效调用各自功能。与系统提示配合使用,也让我理解了如何单独或按顺序使用这些工具。
此外,系统提示可以轻松自定义以加入更多细节,例如展示来源与文档 ID——这对您的应用可能非常重要。
如果您刚接触 AI 智能体,欢迎查看以下资源以进一步了解:
Top DataCamp Courses
课程
课程
课程