
Last chance! 50% off DataCamp Premium
Sale ends in
Durante l’era della Retrieval-Augmented Generation (RAG), framework come LangChain sono diventati popolari per lo sviluppo di applicazioni di AI. Tuttavia, mentre il mondo si sposta verso workflow di Agentic AI, framework come Haystack AI stanno emergendo grazie alla loro flessibilità, modularità ed efficacia nel gestire un’ampia gamma di casi d’uso.
In questo tutorial conosceremo Haystack AI, esploreremo i suoi componenti chiave e i casi d’uso e impareremo a creare un workflow agentico di AI che integri più strumenti. Un workflow agentico si riferisce a sistemi in cui i modelli linguistici richiamano autonomamente tool e componenti in base alle query dell’utente per raggiungere un obiettivo.
Se sei alle prime armi con l’argomento, dai un’occhiata ai nostri tutorial su Agentic AI e Agentic RAG.
Teniamo aggiornatɜ le/gli iscrittɜ sulle novità dell’AI con The Median, la nostra newsletter gratuita del venerdì che riassume le storie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
Haystack è un framework open source progettato per creare applicazioni altamente personalizzabili e pronte per la produzione, basate su Large Language Models (LLM). Permette agli sviluppatori di creare un’ampia gamma di sistemi guidati dall’AI, tra cui pipeline RAG, workflow basati su agent, sistemi di ricerca all’avanguardia e persino applicazioni di AI completamente autonome.
L’architettura modulare di Haystack consente di integrare tecnologie e tool AI leader, tra cui OpenAI, Hugging Face Transformers, Chroma, strumenti MCP, Elasticsearch e altro.
È più semplice di Langchain e offre una vasta gamma di tool per creare i tuoi componenti e agent con poche righe di codice.
Alla base, Haystack è strutturato attorno a componenti e pipeline, che lavorano insieme a provider LLM, document store, tool, agent e a un ricco ecosistema di integrazioni. Questi mattoni consentono agli sviluppatori di progettare, personalizzare e distribuire sistemi di AI end-to-end.
Fonte: Panoramica dei concetti di Haystack
Usando i seguenti componenti di Haystack, puoi costruire workflow RAG robusti, pipeline agentiche o persino combinarli per applicazioni di AI avanzate.
Haystack offre vari componenti per compiti specifici come retrieval, generazione o archiviazione dei documenti. Questi componenti sono classi Python con metodi richiamabili che vengono inizializzati con parametri ed eseguiti tramite il metodo run().
La Component API semplifica la creazione di componenti personalizzati, inclusi quelli per API e database di terze parti.
I generator si occupano di produrre risposte testuali in base ai prompt ricevuti. In backend, sfruttano le API fornite dai provider di LLM e sono adattati a requisiti specifici.
Esistono due tipi di generator:
1. Chat generator: progettati per contesti conversazionali, abilitano chat completions interagendo con una serie di messaggi.
2. Non‑chat generator: usati per compiti di generazione testuale più semplici, come traduzione o sintesi.
Recuperano documenti pertinenti da un document store in base alle query dell’utente. Questo sistema è personalizzato per specifici document store, permettendo di gestire requisiti unici del database con parametri ad hoc. Ad esempio, per Elasticsearch sono disponibili sia i pacchetti del retriever sia del document store.
L’interfaccia di archiviazione documenti in Haystack gestisce efficacemente i documenti. Include funzioni come write_documents () e delete_documents () per la gestione dei dati. I componenti possono interagire facilmente con il Document Store per leggere o scrivere documenti. Un componente DocumentWriter può essere utilizzato per scrivere dati nei Document Store in workflow più complessi.
Le data class semplificano la comunicazione tra componenti in modo semplice e modulare. Le informazioni vengono scambiate all’interno del sistema come input o output nelle pipeline.
Esistono due tipi di data class:
Le pipeline combinano componenti, document store e integrazioni in workflow personalizzabili. Supportano funzionalità come flussi simultanei, componenti standalone, loop, oltre a fasi di preprocessing, indicizzazione e query. Le pipeline possono essere salvate in formati come YAML o TOML per il riuso o la condivisione.
Gli agent di AI sono sistemi autonomi che usano large language model per prendere decisioni e affrontare compiti complessi. Puoi costruire tool per connetterti a un’API, fornirli all’agent e poi fare una domanda. L’agent analizzerà la query e userà gli strumenti appropriati in base alla tua richiesta.
In questa sezione applicheremo i componenti chiave di Haystack per costruire un workflow agentico di AI che, a seconda della query dell’utente, utilizzerà lo strumento RAG e l’accesso al web.
Per questa guida useremo DataLab come ambiente di sviluppo. Per iniziare, installeremo i seguenti pacchetti Python: Haystack, OpenAI, Tavil e itertools. Ecco a cosa serve ciascun pacchetto:
!pip install -qU \
    "haystack-ai[agentst]" \
    tavily-python \
    openai \
    more_itertools
Per usare OpenAI e Tavily, imposta le relative chiavi API come variabili d’ambiente. Se usi DataLab, puoi aggiungere le variabili d’ambiente andando alla scheda Environment e selezionando l’opzione Environment Variables.
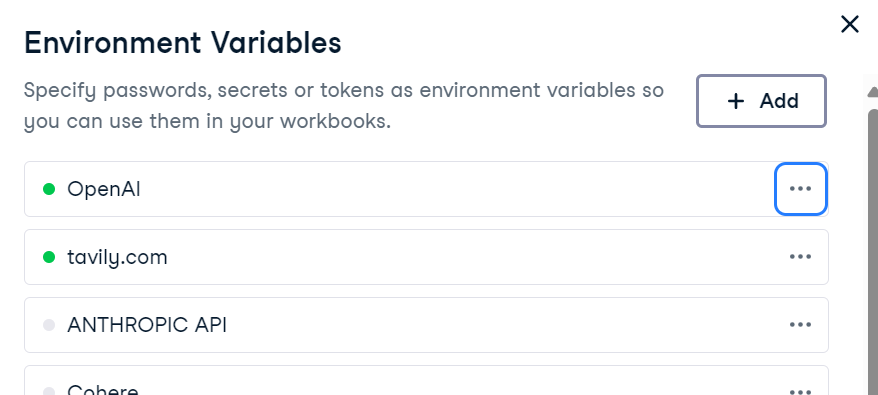
In alternativa, puoi impostarle in modo programmatico in Python:
import os

os.environ["OPENAI_API_KEY"]  = "sk-..."   # ← paste your OpenAI key
os.environ["TAVILY_API_KEY"] = "tvly-..." # ← paste your Tavily keyCreeremo una base di conoscenza usando la data class Document di Haystack. Questa knowledge base conterrà informazioni sulla città di Islamabad.
from haystack.dataclasses import Document
from typing import List, Any, Dict


docs: List[Document] = [
    Document(content="Islamabad experiences a humid subtropical climate with hot summers and mild winters."),
    Document(content="Peak tourist season in Islamabad is during spring (March to May) and autumn (September to November) due to pleasant weather."),
    Document(content="Faisal Mosque, one of the largest mosques in the world, is an iconic landmark in Islamabad designed by Turkish architect Vedat Dalokay."),
    Document(content="Islamabad was purpose-built as the capital of Pakistan in the 1960s, designed by Greek architect Constantinos Apostolos Doxiadis."),
    Document(content="The city is known for its well-planned infrastructure, wide roads, and green spaces, making it one of the most organized cities in Pakistan."),
]Il document store funge da vector store, memorizzando gli embedding testuali e permettendo un recupero efficiente basato sulle query dell’utente.
Qui faremo:
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.embedders import OpenAIDocumentEmbedder
from haystack.components.writers import DocumentWriter
from haystack import Pipeline, component

document_store = InMemoryDocumentStore(embedding_similarity_function="cosine")

indexing_pipeline = Pipeline()
indexing_pipeline.add_component("embedder", OpenAIDocumentEmbedder(model="text-embedding-3-small"))
indexing_pipeline.add_component("writer", DocumentWriter(document_store=document_store))
indexing_pipeline.connect("embedder", "writer")

indexing_pipeline.run({"embedder": {"documents": docs}})
Dopo l’esecuzione della pipeline, i documenti sono stati archiviati con successo come embedding:
Calculating embeddings: 1it [00:00,  1.34it/s]


{'embedder': {'meta': {'model': 'text-embedding-3-small',
   'usage': {'prompt_tokens': 128, 'total_tokens': 128}}},
'writer': {'documents_written': 5}}Una volta popolato il document store, creeremo un tool personalizzato di ricerca RAG.
Questo tool:
from haystack.tools import ComponentTool
from haystack.components.embedders import OpenAIDocumentEmbedder, OpenAITextEmbedder
from haystack.components.retrievers.in_memory import InMemoryEmbeddingRetriever

@component()
class RagSearcher:
    """Query ‑> top‑k docs from the private store"""
    def __init__(self, document_store, top_k: int = 3):
        self.text_embedder = OpenAITextEmbedder(model="text-embedding-3-small")
        self.retriever = InMemoryEmbeddingRetriever(document_store=document_store, top_k=top_k)

    @component.output_types(documents=List[Document])
    def run(self, text: str) -> Dict[str, Any]:
        emb_out = self.text_embedder.run(text=text)
        docs_out = self.retriever.run(query_embedding=emb_out["embedding"])
        return {"documents": docs_out["documents"]}

rag_tool = ComponentTool(
    component=RagSearcher(document_store),
    name="rag_search",
    description="Semantic search over the Islamabad knowledge base."
)Poiché Tavily non ha componenti nativi per Haystack, creeremo un tool personalizzato di ricerca web usando l’API Tavily. Questo strumento recupererà risultati di ricerca live dal web e li restituirà come oggetti Document.
import os
import requests
from haystack import component
from haystack.dataclasses import Document
from typing import List

@component
class TavilyWebSearch:
    def __init__(self, api_key: str, top_k: int = 3):
        self.api_key = api_key
        self.top_k   = top_k

    def run(self, query: str):
        resp = requests.post(
            "https://api.tavily.com/search",
            json={
                "api_key": self.api_key,
                "query": query,
                "max_results": self.top_k,
                "include_answer": True,
            },
            timeout=15,
        )
        resp.raise_for_status()
        data = resp.json()

        docs: List[Document] = []
        if answer := data.get("answer"):
            docs.append(Document(content=answer, meta={"source": "tavily:direct_answer"}))

        for hit in data.get("results", []):
            docs.append(
                Document(
                    content=hit["content"],
                    meta={
                        "title": hit["title"],
                        "url": hit["url"],
                    },
                )
            )
        return {"documents": docs}


web_tool = ComponentTool(
    component=TavilyWebSearch(api_key=os.environ["TAVILY_API_KEY"], top_k=3),
    name="web_search",
    description="Live web search via Tavily ."
)Creeremo un generator usando le funzioni OpenAI e il modello più recente gpt-4.1-mini. Per prima cosa, svilupperemo il system prompt che aiuterà l’Agent a determinare quali tool usare per specifiche richieste dell’utente. Infine, creeremo l’Agent con il generator, il system prompt e un elenco di tool.
In base al system prompt, l’Agent verificherà prima le informazioni usando la ricerca RAG. Se la domanda dell’utente riguarda ultime notizie, meteo o breaking news, l’Agent userà direttamente lo strumento di ricerca web.
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.agents import Agent

generator = OpenAIChatGenerator(model="gpt-4.1-mini")

system_prompt = """
You are a helpful assistant.
- Use rag_search first to retrieve information from the knowledge base.
- Use web_search only when the query requires fresh, real-time, or external information (e.g., weather, breaking news).
"""

agent = Agent(
    chat_generator=generator,
    system_prompt=system_prompt,
    tools=[rag_tool, web_tool],
)Faremo una domanda su Islamabad per richiamare il tool RAG e ottenere la risposta.
from haystack.dataclasses import ChatMessage

msg = ChatMessage.from_user("What is the peak tourist season in Islamabad?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
Otteniamo risposte con un’ottima consapevolezza del contesto, ma come facciamo a sapere che ha usato i tool RAG per rispondere?
The peak tourist season in Islamabad is during spring (March to May) and autumn (September to November).Per verificare quali tool sono stati richiamati, creeremo una funzione che estrarrà le informazioni sugli strumenti.
def tools_used(run_output: dict) -> list[str]:
    seen, ordered = set(), []

    for msg in run_output["messages"]:
        for call in msg.tool_calls:
            if call.tool_name not in seen:
                ordered.append(call.tool_name)
                seen.add(call.tool_name)
    return ordered
print("Tools invoked →", tools_used(resp))
Nel primo test, l’agent ha usato solo il tool rag_search per rispondere alla domanda.
Tools invoked → ['rag_search']Ora chiederemo informazioni sul meteo a Islamabad. Invece di richiamare il tool RAG, userà lo strumento di ricerca web per rispondere alla domanda.
msg = ChatMessage.from_user("What is the temperature in Islamabad now?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
print("Tools invoked →", tools_used(resp))
La risposta è molto accurata e ha usato lo strumento di ricerca web per rispondere alla domanda.
The current temperature in Islamabad is 31°C with a real-feel temperature of 32°C.
Tools invoked → ['web_search']
Se riscontri problemi nell’eseguire il codice sopra, fai riferimento al Datalab Notebook: Tutorial Haystack AI — DataLab.
Abbiamo coperto le basi del framework Haystack AI. Il prossimo passo nel tuo percorso è creare un’applicazione di AI pienamente funzionante. Ecco alcuni casi d’uso che gli sviluppatori stanno esplorando:
Avendo lavorato con molti framework per LLM, trovo che Haystack sia tra le opzioni più intuitive e flessibili disponibili. È più naturale da usare, meno complesso e offre un maggiore controllo sui tuoi workflow.
Una delle sue caratteristiche di spicco è la facilità con cui puoi creare componenti personalizzati per le tue pipeline, rendendolo altamente adattabile a un’ampia gamma di casi d’uso.
Mi sono divertito in particolare a sperimentare con agent e tool e a capire come richiamare ciascuno in modo efficace. Lavorare con il system prompt mi ha aiutato a comprendere come usare gli strumenti singolarmente e in sequenza.
Inoltre, il system prompt può essere facilmente personalizzato per includere dettagli aggiuntivi, come la visualizzazione delle fonti e degli ID dei documenti, che possono essere importanti per la tua applicazione.
Se sei nuovo nel mondo degli agent di AI, consulta le risorse qui sotto per saperne di più:
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




