
Last chance! 50% off DataCamp Premium
Sale ends in
Retrieval-Augmented Generation (RAG) के दौर में, LangChain जैसे फ़्रेमवर्क AI एप्लिकेशन विकसित करने के लिए लोकप्रिय हुए। लेकिन जैसे-जैसे दुनिया Agentic AI वर्कफ़्लो की ओर बढ़ रही है, Haystack AI जैसे फ़्रेमवर्क अपनी लचीलेपन, मॉड्युलैरिटी, और विविध उपयोग मामलों को प्रभावी ढंग से संभालने की क्षमता के कारण प्रमुखता प्राप्त कर रहे हैं।
इस ट्यूटोरियल में, हम Haystack AI के बारे में जानेंगे, इसके प्रमुख घटकों और उपयोग मामलों की पड़ताल करेंगे, और कई टूल्स को एकीकृत करने वाला AI एजेंटिक वर्कफ़्लो बनाना सीखेंगे। एजेंटिक वर्कफ़्लो ऐसे सिस्टम को संदर्भित करता है जहाँ भाषा मॉडल उपयोगकर्ता की क्वेरी के आधार पर स्वतः टूल्स और कॉम्पोनेंट्स को इनवोक कर लक्ष्य प्राप्त करते हैं।
यदि आप इस विषय में नए हैं, तो हमारे Agentic AI और Agentic RAG पर हमारे ट्यूटोरियल अवश्य देखें।
हम अपने पाठकों को AI की ताज़ा खबरों से अपडेट रखते हैं The Median के माध्यम से—यह हमारा निःशुल्क शुक्रवार न्यूज़लेटर है जो हफ्ते की प्रमुख कहानियों को सरलता से समझाता है। सब्सक्राइब करें और हर सप्ताह कुछ ही मिनटों में अपडेट रहें:
Haystack एक ओपन-सोर्स फ़्रेमवर्क है जिसे Large Language Models (LLMs) द्वारा संचालित अत्यधिक अनुकूलन योग्य, प्रोडक्शन-रेडी एप्लिकेशन बनाने के लिए डिज़ाइन किया गया है। यह डेवलपर्स को RAG पाइपलाइंस, एजेंट-आधारित वर्कफ़्लो, अत्याधुनिक सर्च सिस्टम, और यहाँ तक कि पूरी तरह स्वायत्त AI एप्लिकेशन जैसी विभिन्न प्रणालियाँ बनाने में सक्षम बनाता है।
Haystack की मॉड्युलर आर्किटेक्चर डेवलपर्स को OpenAI, Hugging Face Transformers, Chroma, MCP टूल्स, Elasticsearch, और अन्य अग्रणी AI तकनीकों और टूल्स को एकीकृत करने देती है।
यह Langchain से सरल है और केवल कुछ पंक्तियों के कोड के साथ अपने कॉम्पोनेंट्स और एजेंट्स बनाने के लिए टूल्स का व्यापक सेट प्रदान करता है।
मूल रूप से, Haystack कॉम्पोनेंट्स और पाइपलाइंस के इर्द-गिर्द संरचित है, जो LLM प्रदाताओं, डॉक्यूमेंट स्टोर्स, टूल्स, एजेंट्स, और समृद्ध इंटेग्रेशंस इकोसिस्टम के साथ मिलकर काम करते हैं। ये बिल्डिंग ब्लॉक्स डेवलपर्स को एंड-टू-एंड AI सिस्टम डिज़ाइन, कस्टमाइज़ और डिप्लॉय करने की क्षमता देते हैं।
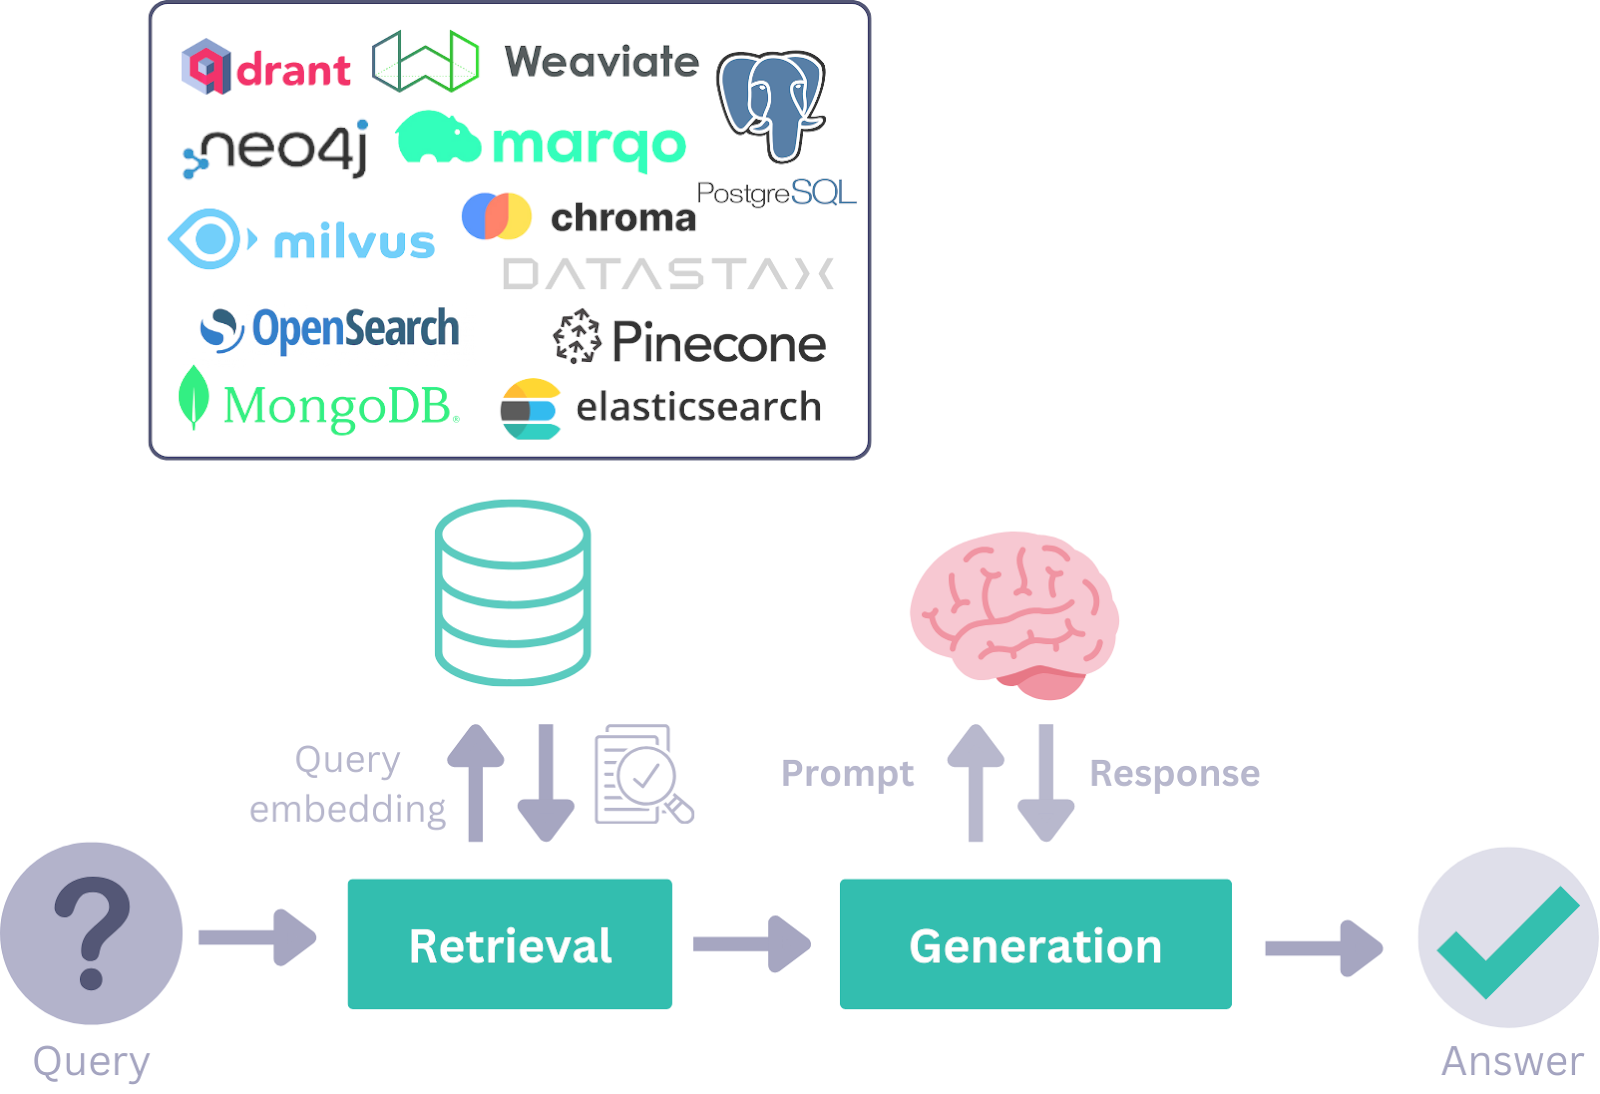
स्रोत: Haystack Concepts Overview
निम्नलिखित Haystack कॉम्पोनेंट्स का उपयोग करके, आप मज़बूत RAG वर्कफ़्लो, एजेंटिक पाइपलाइंस, या दोनों को मिलाकर उन्नत AI एप्लिकेशन बना सकते हैं।
Haystack विभिन्न विशिष्ट कार्यों—जैसे रिट्रीवल, जनरेशन, या डॉक्यूमेंट स्टोरेज—के लिए कॉम्पोनेंट्स प्रदान करता है। ये कॉम्पोनेंट्स Python क्लासेस होती हैं जिनमें कॉल करने योग्य मेथड्स होते हैं, जिन्हें पैरामीटर्स के साथ इनिशियलाइज़ किया जाता है और run() मेथड से निष्पादित किया जाता है।
कॉम्पोनेंट API कस्टम कॉम्पोनेंट्स बनाने की प्रक्रिया को सरल बनाता है, जिनमें थर्ड-पार्टी APIs और डेटाबेस के लिए कॉम्पोनेंट्स भी शामिल हैं।
जनरेटर्स प्राप्त प्रॉम्प्ट्स के आधार पर टेक्स्ट प्रतिक्रियाएँ उत्पन्न करने के लिए ज़िम्मेदार होते हैं। बैकएंड में, ये जनरेटर्स LLM प्रदाताओं द्वारा उपलब्ध कराए गए APIs का लाभ उठाते हैं और विशिष्ट आवश्यकताओं के अनुरूप ढाले जाते हैं।
जनरेटर्स दो प्रकार के होते हैं:
1. चैट जनरेटर्स: ये वार्तालाप संदर्भों के लिए बने होते हैं और संदेशों की शृंखला के साथ इंटरैक्ट करके चैट कम्प्लीशन सक्षम करते हैं।
2. नॉन-चैट जनरेटर्स: ये सरल टेक्स्ट जनरेशन कार्यों, जैसे अनुवाद या सार-संक्षेपण, के लिए उपयोग किए जाते हैं।
उपयोगकर्ता की क्वेरी के आधार पर डॉक्यूमेंट स्टोर से संबंधित दस्तावेज़ प्राप्त करें। यह सिस्टम विशिष्ट डॉक्यूमेंट स्टोर्स के लिए अनुकूलित है, जिससे वे कस्टम पैरामीटर्स के साथ अद्वितीय डेटाबेस आवश्यकताओं को संभाल सकें। उदाहरण के लिए, Elasticsearch डॉक्यूमेंट स्टोर के लिए रिट्रीवर और डॉक्यूमेंट स्टोर—दोनों पैकेज उपलब्ध हैं।
Haystack में डॉक्यूमेंट स्टोरेज इंटरफ़ेस दस्तावेज़ों का प्रभावी प्रबंधन करता है। इसमें डेटा प्रबंधन के लिए write_documents () और delete_documents () जैसी फ़ंक्शंस शामिल हैं। कॉम्पोनेंट्स आसानी से डॉक्यूमेंट स्टोर के साथ इंटरैक्ट कर दस्तावेज़ पढ़ या लिख सकते हैं। अधिक जटिल वर्कफ़्लो के लिए DocumentWriter कॉम्पोनेंट का इस्तेमाल करके डॉक्यूमेंट स्टोर्स में डेटा लिखा जा सकता है।
डेटा क्लासेस कॉम्पोनेंट्स के बीच संचार को सरल और मॉड्युलर तरीके से सरल बनाती हैं। जानकारी पाइपलाइंस में इनपुट्स या आउटपुट्स के रूप में सिस्टम के भीतर आदान-प्रदान होती है।
डेटा क्लासेस दो प्रकार की होती हैं:
पाइपलाइंस कॉम्पोनेंट्स, डॉक्यूमेंट स्टोर्स और इंटेग्रेशंस को जोड़कर कस्टमाइज़ेबल वर्कफ़्लोज़ बनाती हैं। ये समानांतर फ़्लो, स्टैंडअलोन कॉम्पोनेंट्स, लूप्स, साथ ही प्रीप्रोसेसिंग, इंडेक्सिंग और क्वेरींग स्टेप्स जैसी क्षमताओं का समर्थन करती हैं। पाइपलाइंस को YAML या TOML जैसे फ़ॉर्मैट में सेव किया जा सकता है ताकि उन्हें पुन: उपयोग या साझा किया जा सके।
AI एजेंट्स स्वायत्त सिस्टम होते हैं जो बड़े भाषा मॉडल्स का उपयोग कर निर्णय लेते हैं और जटिल कार्यों को अंजाम देते हैं। आप किसी API से कनेक्ट होने वाले टूल्स बना सकते हैं, उन्हें एजेंट को दे सकते हैं, और फिर प्रश्न पूछ सकते हैं। एजेंट क्वेरी का विश्लेषण करेगा और आपके प्रश्न के आधार पर उपयुक्त टूल्स का उपयोग करेगा।
इस खंड में, हम Haystack के प्रमुख कॉम्पोनेंट्स को लागू करके एक AI एजेंटिक वर्कफ़्लो बनाएंगे, जो उपयोगकर्ता की क्वेरी के अनुसार RAG और वेब एक्सेस टूल का उपयोग करेगा।
इस गाइड के लिए, हम अपने कोडिंग एनवायरनमेंट के रूप में DataLab का उपयोग करेंगे। शुरुआत करने के लिए, हम निम्न Python पैकेज इंस्टॉल करेंगे: Haystack, OpenAI, Tavil, और itertools। प्रत्येक पैकेज का उपयोग इस प्रकार है:
!pip install -qU \
    "haystack-ai[agentst]" \
    tavily-python \
    openai \
    more_itertools
OpenAI और Tavily का उपयोग करने के लिए, उनकी API keys को environment variables के रूप में सेट करें। यदि आप DataLab का उपयोग कर रहे हैं, तो Environment टैब में जाएँ और Environment Variables विकल्प चुनें।
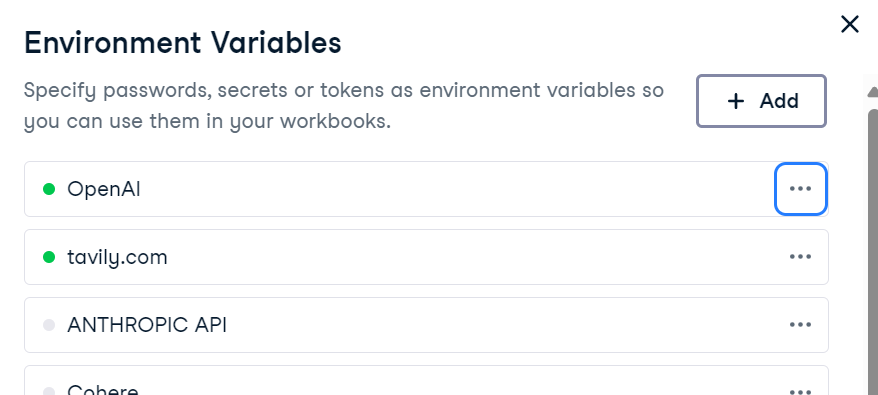
वैकल्पिक रूप से, आप उन्हें Python में प्रोग्रामेटिक तरीके से सेट कर सकते हैं:
import os

os.environ["OPENAI_API_KEY"]  = "sk-..."   # ← paste your OpenAI key
os.environ["TAVILY_API_KEY"] = "tvly-..." # ← paste your Tavily keyहम Haystack के Document डेटा क्लास का उपयोग करके एक नॉलेज बेस बनाएँगे। इस नॉलेज बेस में इस्लामाबाद शहर के बारे में जानकारी होगी।
from haystack.dataclasses import Document
from typing import List, Any, Dict


docs: List[Document] = [
    Document(content="Islamabad experiences a humid subtropical climate with hot summers and mild winters."),
    Document(content="Peak tourist season in Islamabad is during spring (March to May) and autumn (September to November) due to pleasant weather."),
    Document(content="Faisal Mosque, one of the largest mosques in the world, is an iconic landmark in Islamabad designed by Turkish architect Vedat Dalokay."),
    Document(content="Islamabad was purpose-built as the capital of Pakistan in the 1960s, designed by Greek architect Constantinos Apostolos Doxiadis."),
    Document(content="The city is known for its well-planned infrastructure, wide roads, and green spaces, making it one of the most organized cities in Pakistan."),
]डॉक्यूमेंट स्टोर एक वेक्टर स्टोर के रूप में काम करता है, जो टेक्स्ट एम्बेडिंग्स को स्टोर करता है और उपयोगकर्ता क्वेरी के आधार पर कुशल रिट्रीवल सक्षम करता है।
यहाँ हम यह करेंगे:
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.embedders import OpenAIDocumentEmbedder
from haystack.components.writers import DocumentWriter
from haystack import Pipeline, component

document_store = InMemoryDocumentStore(embedding_similarity_function="cosine")

indexing_pipeline = Pipeline()
indexing_pipeline.add_component("embedder", OpenAIDocumentEmbedder(model="text-embedding-3-small"))
indexing_pipeline.add_component("writer", DocumentWriter(document_store=document_store))
indexing_pipeline.connect("embedder", "writer")

indexing_pipeline.run({"embedder": {"documents": docs}})
पाइपलाइन चलाने के बाद, दस्तावेज़ सफलतापूर्वक एम्बेडिंग्स के रूप में स्टोर हो जाते हैं:
Calculating embeddings: 1it [00:00,  1.34it/s]


{'embedder': {'meta': {'model': 'text-embedding-3-small',
   'usage': {'prompt_tokens': 128, 'total_tokens': 128}}},
'writer': {'documents_written': 5}}डॉक्यूमेंट स्टोर भर जाने के बाद, हम एक कस्टम RAG सर्च टूल बनाएँगे।
यह टूल यह करेगा:
from haystack.tools import ComponentTool
from haystack.components.embedders import OpenAIDocumentEmbedder, OpenAITextEmbedder
from haystack.components.retrievers.in_memory import InMemoryEmbeddingRetriever

@component()
class RagSearcher:
    """Query ‑> top‑k docs from the private store"""
    def __init__(self, document_store, top_k: int = 3):
        self.text_embedder = OpenAITextEmbedder(model="text-embedding-3-small")
        self.retriever = InMemoryEmbeddingRetriever(document_store=document_store, top_k=top_k)

    @component.output_types(documents=List[Document])
    def run(self, text: str) -> Dict[str, Any]:
        emb_out = self.text_embedder.run(text=text)
        docs_out = self.retriever.run(query_embedding=emb_out["embedding"])
        return {"documents": docs_out["documents"]}

rag_tool = ComponentTool(
    component=RagSearcher(document_store),
    name="rag_search",
    description="Semantic search over the Islamabad knowledge base."
)क्योंकि Tavily के नैटिव Haystack कॉम्पोनेंट्स नहीं हैं, हम Tavily API का उपयोग करके एक कस्टम वेब सर्च टूल बनाएँगे। यह टूल लाइव वेब सर्च परिणाम लाएगा और उन्हें Document ऑब्जेक्ट्स के रूप में लौटाएगा।
import os
import requests
from haystack import component
from haystack.dataclasses import Document
from typing import List

@component
class TavilyWebSearch:
    def __init__(self, api_key: str, top_k: int = 3):
        self.api_key = api_key
        self.top_k   = top_k

    def run(self, query: str):
        resp = requests.post(
            "https://api.tavily.com/search",
            json={
                "api_key": self.api_key,
                "query": query,
                "max_results": self.top_k,
                "include_answer": True,
            },
            timeout=15,
        )
        resp.raise_for_status()
        data = resp.json()

        docs: List[Document] = []
        if answer := data.get("answer"):
            docs.append(Document(content=answer, meta={"source": "tavily:direct_answer"}))

        for hit in data.get("results", []):
            docs.append(
                Document(
                    content=hit["content"],
                    meta={
                        "title": hit["title"],
                        "url": hit["url"],
                    },
                )
            )
        return {"documents": docs}


web_tool = ComponentTool(
    component=TavilyWebSearch(api_key=os.environ["TAVILY_API_KEY"], top_k=3),
    name="web_search",
    description="Live web search via Tavily ."
)हम OpenAI फंक्शंस और नवीनतम gpt-4.1-mini मॉडल का उपयोग करके एक जनरेटर बनाएँगे। पहले, हम सिस्टम प्रॉम्प्ट विकसित करेंगे जो एजेंट को बताएगा कि किन उपयोगकर्ता अनुरोधों के लिए किन टूल्स का उपयोग करना है। अंत में, हम जनरेटर, सिस्टम प्रॉम्प्ट और टूल्स की सूची के साथ एजेंट बनाएँगे।
सिस्टम प्रॉम्प्ट के आधार पर, एजेंट पहले RAG सर्च का उपयोग करके जानकारी जाँचेगा। यदि उपयोगकर्ता का प्रश्न नवीनतम समाचार, मौसम या ब्रेकिंग न्यूज़ से संबंधित है, तो एजेंट सीधे वेब सर्च टूल का उपयोग करेगा।
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.agents import Agent

generator = OpenAIChatGenerator(model="gpt-4.1-mini")

system_prompt = """
You are a helpful assistant.
- Use rag_search first to retrieve information from the knowledge base.
- Use web_search only when the query requires fresh, real-time, or external information (e.g., weather, breaking news).
"""

agent = Agent(
    chat_generator=generator,
    system_prompt=system_prompt,
    tools=[rag_tool, web_tool],
)हम इस्लामाबाद के बारे में एक प्रश्न पूछेंगे ताकि RAG टूल को उत्तर देने के लिए इनवोक किया जा सके।
from haystack.dataclasses import ChatMessage

msg = ChatMessage.from_user("What is the peak tourist season in Islamabad?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
हमें अत्यधिक संदर्भित उत्तर मिलते हैं, लेकिन हमें कैसे पता चले कि उत्तर देने के लिए RAG टूल्स का उपयोग हुआ है?
The peak tourist season in Islamabad is during spring (March to May) and autumn (September to November).यह जाँचने के लिए कि कौन-से टूल्स इनवोक हुए, हम एक फ़ंक्शन बनाएँगे जो टूल्स के बारे में जानकारी निकालेगा।
def tools_used(run_output: dict) -> list[str]:
    seen, ordered = set(), []

    for msg in run_output["messages"]:
        for call in msg.tool_calls:
            if call.tool_name not in seen:
                ordered.append(call.tool_name)
                seen.add(call.tool_name)
    return ordered
print("Tools invoked →", tools_used(resp))
पहले परीक्षण में, एजेंट ने केवल rag_search टूल का उपयोग करके प्रश्न का उत्तर दिया।
Tools invoked → ['rag_search']अब हम इस्लामाबाद के मौसम के बारे में पूछेंगे। RAG टूल को इनवोक करने के बजाय, यह प्रश्न का उत्तर देने के लिए वेब सर्च टूल का उपयोग करेगा।
msg = ChatMessage.from_user("What is the temperature in Islamabad now?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
print("Tools invoked →", tools_used(resp))
उत्तर काफी सटीक है, और प्रश्न का उत्तर देने के लिए वेब सर्च टूल का उपयोग किया गया है।
The current temperature in Islamabad is 31°C with a real-feel temperature of 32°C.
Tools invoked → ['web_search']
यदि आपको ऊपर दिया गया कोड चलाने में समस्या आ रही है, तो कृपया Datalab Notebook देखें: Haystack AI Tutorial — DataLab.
हमने Haystack AI फ़्रेमवर्क की बुनियादी बातें कवर कर ली हैं। आपकी सीखने की अगली कड़ी एक पूर्णतः कार्यशील AI एप्लिकेशन बनाना है। यहाँ कुछ उपयोग मामले हैं जिनकी डेवलपर्स पड़ताल कर रहे हैं:
कई LLM फ़्रेमवर्क्स के साथ काम करने के बाद, मुझे Haystack सबसे सहज और लचीले विकल्पों में से एक लगता है। इसका उपयोग अधिक स्वाभाविक महसूस होता है, कम जटिल है, और आपके वर्कफ़्लोज़ पर अधिक नियंत्रण देता है।
इसके प्रमुख आकर्षणों में से एक है—अपनी पाइपलाइंस के लिए कस्टम कॉम्पोनेंट्स बेहद आसानी से बनाना, जिससे यह विभिन्न उपयोग मामलों के लिए बेहद अनुकूल बन जाता है।
मुझे विशेष रूप से एजेंट्स और टूल्स के साथ प्रयोग करना और समझना अच्छा लगा कि प्रत्येक को प्रभावी ढंग से कैसे इनवोक किया जाए। सिस्टम प्रॉम्प्ट के साथ काम करने से मुझे टूल्स को अलग-अलग और क्रम में उपयोग करने की समझ मिली।
इसके अलावा, सिस्टम प्रॉम्प्ट को आसानी से कस्टमाइज़ किया जा सकता है ताकि स्रोतों और डॉक्यूमेंट IDs जैसे अतिरिक्त विवरण दिखाए जा सकें, जो आपकी एप्लिकेशन के लिए महत्वपूर्ण हो सकते हैं।
यदि आप AI एजेंट्स की दुनिया में नए हैं, तो अधिक जानने के लिए नीचे दिए गए संसाधन देखें:
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स
