
Cursus
LLM-toepassingen ontwikkelen met LangChain
3 uur
51.9K
Tijdens het Retrieval-Augmented Generation (RAG)-tijdperk werden frameworks zoals LangChain populair voor het ontwikkelen van AI-toepassingen. Maar nu de wereld verschuift naar agentische AI-workflows, komen frameworks zoals Haystack AI naar voren dankzij hun flexibiliteit, modulariteit en effectiviteit bij het afhandelen van uiteenlopende use-cases.
In deze tutorial leer je Haystack AI kennen, verken je de belangrijkste componenten en use-cases, en leer je hoe je een agentische AI-workflow bouwt die meerdere tools integreert. Een agentische workflow verwijst naar systemen waarin taalmodellen autonoom tools en componenten aanroepen op basis van gebruikersvragen om een doel te bereiken.
Als je nieuw bent met dit onderwerp, bekijk dan zeker onze tutorials over Agentic AI en Agentic RAG.
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week samenvat. Abonneer je en blijf scherp in een paar minuten per week:
Haystack is een open-sourceframework voor het bouwen van zeer aanpasbare, productieklare applicaties op basis van Large Language Models (LLM’s). Het stelt ontwikkelaars in staat om een breed scala aan AI-gedreven systemen te maken, waaronder RAG-pipelines, agentgebaseerde workflows, state-of-the-art zoeksystemen en zelfs volledig autonome AI-toepassingen.
Dankzij de modulaire architectuur kun je in Haystack toonaangevende AI-technologieën en -tools integreren, waaronder OpenAI, Hugging Face Transformers, Chroma, MCP-tools, Elasticsearch en meer.
Het is eenvoudiger dan Langchain en biedt een breed scala aan tools om je componenten en agents te maken met slechts een paar regels code.
In de kern is Haystack opgebouwd rond componenten en pipelines, die samenwerken met LLM-providers, document stores, tools, agents en een rijk ecosysteem aan integraties. Met deze bouwstenen kunnen ontwikkelaars end-to-end AI-systemen ontwerpen, aanpassen en uitrollen.
Bron: Haystack Concepts Overview
Met de volgende Haystack-componenten kun je robuuste RAG-workflows, agentische pipelines of een combinatie van beide bouwen voor geavanceerde AI-toepassingen.
Haystack biedt verschillende componenten voor specifieke taken zoals retrieval, generatie of documentopslag. Deze componenten zijn Python-klassen met aanroepbare methoden die worden geïnitialiseerd met parameters en worden uitgevoerd met de methode run().
De Component API stroomlijnt het maken van aangepaste componenten, ook voor externe API’s en databases.
Generators zijn verantwoordelijk voor het produceren van tekstreacties op basis van de prompts die ze ontvangen. Onder de motorkap maken deze generators gebruik van API’s van LLM-providers en worden ze afgestemd op specifieke vereisten.
Er zijn twee soorten generators:
1. Chatgenerators: Deze zijn ontworpen voor conversatiecontexten en maken chat-completions mogelijk door met een reeks berichten te interageren.
2. Niet-chatgenerators: Deze worden gebruikt voor eenvoudigere tekstgeneratietaken, zoals vertalen of samenvatten.
Haal relevante documenten op uit een document store op basis van gebruikersvragen. Dit systeem is aangepast voor specifieke document stores, zodat ze unieke databasevereisten aankunnen met aangepaste parameters. Zo heeft de Elasticsearch document store zowel retriever- als documentstore-pakketten beschikbaar.
De interface voor documentopslag in Haystack beheert documenten effectief. Het bevat functies als write_documents () en delete_documents () voor databeheer. Componenten kunnen eenvoudig met de Document Store communiceren om documenten te lezen of te schrijven. Voor complexere workflows kun je een DocumentWriter-component gebruiken om data in Document Stores te schrijven.
Dataclasses vereenvoudigen de communicatie tussen componenten op een duidelijke en modulaire manier. Informatie wordt binnen het systeem uitgewisseld als inputs of outputs in pipelines.
Er zijn twee soorten dataclasses:
Pipelines combineren componenten, document stores en integraties in aanpasbare workflows. Ze ondersteunen functies zoals parallelle flows, zelfstandige componenten, lussen, evenals preprocessing-, indexerings- en query-stappen. Pipelines kunnen worden opgeslagen in formaten zoals YAML of TOML voor hergebruik of delen.
AI-agents zijn autonome systemen die grote taalmodellen gebruiken om beslissingen te nemen en complexe taken aan te pakken. Je kunt tools bouwen om met een API te verbinden, deze aan de agent geven en vervolgens een vraag stellen. De agent analyseert de vraag en gebruikt de juiste tools op basis van je vraag.
In deze sectie passen we de belangrijkste componenten van Haystack toe om een agentische AI-workflow te bouwen die, afhankelijk van de gebruikersvraag, de RAG- en webtoegangstool gebruikt.
Voor deze gids gebruiken we DataLab als onze programmeeromgeving. Om te beginnen installeren we de volgende Python-pakketten: Haystack, OpenAI, Tavil en itertools. Dit is waar elk pakket voor wordt gebruikt:
!pip install -qU \
    "haystack-ai[agentst]" \
    tavily-python \
    openai \
    more_itertools
Om OpenAI en Tavily te gebruiken, stel je hun API-sleutels in als omgevingsvariabelen. Gebruik je DataLab, dan kun je omgevingsvariabelen toevoegen via het tabblad Environment en de optie Environment Variables te selecteren.
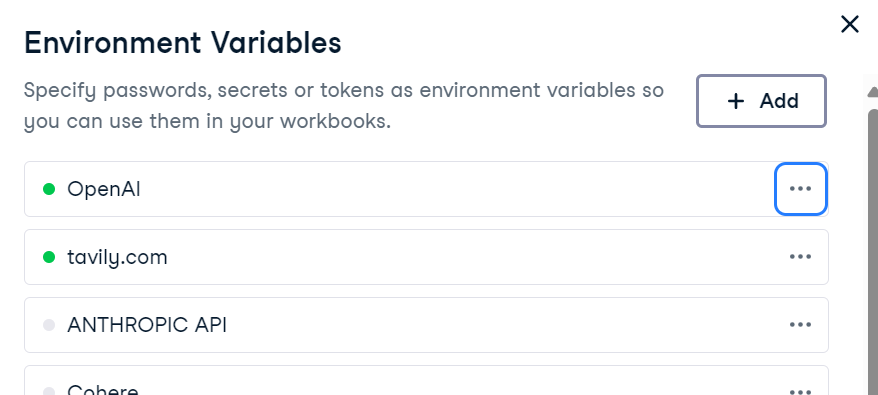
Je kunt ze ook programmatisch instellen in Python:
import os

os.environ["OPENAI_API_KEY"]  = "sk-..."   # ← paste your OpenAI key
os.environ["TAVILY_API_KEY"] = "tvly-..." # ← paste your Tavily keyWe maken een kennisbank met de Document-dataclass van Haystack. Deze kennisbank bevat informatie over de stad Islamabad.
from haystack.dataclasses import Document
from typing import List, Any, Dict


docs: List[Document] = [
    Document(content="Islamabad experiences a humid subtropical climate with hot summers and mild winters."),
    Document(content="Peak tourist season in Islamabad is during spring (March to May) and autumn (September to November) due to pleasant weather."),
    Document(content="Faisal Mosque, one of the largest mosques in the world, is an iconic landmark in Islamabad designed by Turkish architect Vedat Dalokay."),
    Document(content="Islamabad was purpose-built as the capital of Pakistan in the 1960s, designed by Greek architect Constantinos Apostolos Doxiadis."),
    Document(content="The city is known for its well-planned infrastructure, wide roads, and green spaces, making it one of the most organized cities in Pakistan."),
]De document store fungeert als een vectorstore, slaat tekstdembeddings op en maakt efficiënte retrieval mogelijk op basis van gebruikersvragen.
Hier zullen we:
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.embedders import OpenAIDocumentEmbedder
from haystack.components.writers import DocumentWriter
from haystack import Pipeline, component

document_store = InMemoryDocumentStore(embedding_similarity_function="cosine")

indexing_pipeline = Pipeline()
indexing_pipeline.add_component("embedder", OpenAIDocumentEmbedder(model="text-embedding-3-small"))
indexing_pipeline.add_component("writer", DocumentWriter(document_store=document_store))
indexing_pipeline.connect("embedder", "writer")

indexing_pipeline.run({"embedder": {"documents": docs}})
Na het uitvoeren van de pipeline zijn de documenten succesvol opgeslagen als embeddings:
Calculating embeddings: 1it [00:00,  1.34it/s]


{'embedder': {'meta': {'model': 'text-embedding-3-small',
   'usage': {'prompt_tokens': 128, 'total_tokens': 128}}},
'writer': {'documents_written': 5}}Zodra de document store gevuld is, maken we een aangepaste RAG-zoektool.
Deze tool zal:
from haystack.tools import ComponentTool
from haystack.components.embedders import OpenAIDocumentEmbedder, OpenAITextEmbedder
from haystack.components.retrievers.in_memory import InMemoryEmbeddingRetriever

@component()
class RagSearcher:
    """Query ‑> top‑k docs from the private store"""
    def __init__(self, document_store, top_k: int = 3):
        self.text_embedder = OpenAITextEmbedder(model="text-embedding-3-small")
        self.retriever = InMemoryEmbeddingRetriever(document_store=document_store, top_k=top_k)

    @component.output_types(documents=List[Document])
    def run(self, text: str) -> Dict[str, Any]:
        emb_out = self.text_embedder.run(text=text)
        docs_out = self.retriever.run(query_embedding=emb_out["embedding"])
        return {"documents": docs_out["documents"]}

rag_tool = ComponentTool(
    component=RagSearcher(document_store),
    name="rag_search",
    description="Semantic search over the Islamabad knowledge base."
)Omdat Tavily geen native Haystack-componenten heeft, maken we een aangepaste webzoektool met de Tavily API. Deze tool haalt live webzoekresultaten op en geeft die terug als Document-objecten.
import os
import requests
from haystack import component
from haystack.dataclasses import Document
from typing import List

@component
class TavilyWebSearch:
    def __init__(self, api_key: str, top_k: int = 3):
        self.api_key = api_key
        self.top_k   = top_k

    def run(self, query: str):
        resp = requests.post(
            "https://api.tavily.com/search",
            json={
                "api_key": self.api_key,
                "query": query,
                "max_results": self.top_k,
                "include_answer": True,
            },
            timeout=15,
        )
        resp.raise_for_status()
        data = resp.json()

        docs: List[Document] = []
        if answer := data.get("answer"):
            docs.append(Document(content=answer, meta={"source": "tavily:direct_answer"}))

        for hit in data.get("results", []):
            docs.append(
                Document(
                    content=hit["content"],
                    meta={
                        "title": hit["title"],
                        "url": hit["url"],
                    },
                )
            )
        return {"documents": docs}


web_tool = ComponentTool(
    component=TavilyWebSearch(api_key=os.environ["TAVILY_API_KEY"], top_k=3),
    name="web_search",
    description="Live web search via Tavily ."
)We maken een generator met de OpenAI-functies en het nieuwste model gpt-4.1-mini. Eerst ontwikkelen we de system prompt die de Agent helpt te bepalen welke tools te gebruiken voor specifieke gebruikersverzoeken. Tot slot maken we de Agent met de generator, de system prompt en een lijst met tools.
Op basis van de system prompt controleert de Agent eerst de informatie via de RAG-zoekfunctie. Als de vraag van de gebruiker betrekking heeft op het laatste nieuws, het weer of breaking news, gebruikt de Agent direct de webzoektool.
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.agents import Agent

generator = OpenAIChatGenerator(model="gpt-4.1-mini")

system_prompt = """
You are a helpful assistant.
- Use rag_search first to retrieve information from the knowledge base.
- Use web_search only when the query requires fresh, real-time, or external information (e.g., weather, breaking news).
"""

agent = Agent(
    chat_generator=generator,
    system_prompt=system_prompt,
    tools=[rag_tool, web_tool],
)We stellen een vraag over Islamabad om de RAG-tool aan te roepen voor het antwoord.
from haystack.dataclasses import ChatMessage

msg = ChatMessage.from_user("What is the peak tourist season in Islamabad?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
We hebben antwoorden met veel contextbewustzijn, maar hoe weten we dat de RAG-tools zijn gebruikt om te antwoorden?
The peak tourist season in Islamabad is during spring (March to May) and autumn (September to November).Om te controleren welke tools zijn aangeroepen, maken we een functie die informatie over de tools extraheert.
def tools_used(run_output: dict) -> list[str]:
    seen, ordered = set(), []

    for msg in run_output["messages"]:
        for call in msg.tool_calls:
            if call.tool_name not in seen:
                ordered.append(call.tool_name)
                seen.add(call.tool_name)
    return ordered
print("Tools invoked →", tools_used(resp))
Bij de eerste test gebruikte de agent alleen de tool rag_search om de vraag te beantwoorden.
Tools invoked → ['rag_search']We vragen nu naar het weer in Islamabad. In plaats van de RAG-tool aan te roepen, gebruikt het de webzoektool om de vraag te beantwoorden.
msg = ChatMessage.from_user("What is the temperature in Islamabad now?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
print("Tools invoked →", tools_used(resp))
Het antwoord is zeer accuraat en het heeft de webzoektool gebruikt om de vraag te beantwoorden.
The current temperature in Islamabad is 31°C with a real-feel temperature of 32°C.
Tools invoked → ['web_search']
Als je problemen ondervindt bij het uitvoeren van de bovenstaande code, raadpleeg dan de Datalab-notebook: Haystack AI Tutorial — DataLab.
We hebben de basis van het Haystack AI-framework behandeld. De volgende stap in je leertraject is het bouwen van een volledig functionele AI-applicatie. Dit zijn enkele use-cases die ontwikkelaars verkennen:
Na met veel LLM-frameworks te hebben gewerkt, vind ik Haystack een van de meest intuïtieve en flexibele opties. Het voelt natuurlijker in gebruik, is minder complex en biedt meer controle over je workflows.
Een van de opvallendste features is hoe eenvoudig je aangepaste componenten voor je pipelines kunt maken, waardoor het zeer goed is aan te passen aan uiteenlopende use-cases.
Ik vond het bijzonder leuk om te experimenteren met agents en tools en te begrijpen hoe je elk daarvan effectief aanroept. Werken met de system prompt hielp me te begrijpen hoe je de tools afzonderlijk en in volgorde gebruikt.
Bovendien is de system prompt eenvoudig aan te passen met extra details, zoals het tonen van bronnen en document-ID’s, wat belangrijk kan zijn voor je applicatie.
Als je nieuw bent in de wereld van AI-agents, bekijk dan de onderstaande bronnen om meer te leren:
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

