
Kursus
Mengembangkan Aplikasi LLM dengan LangChain
3 jam
51.2K
Selama era Retrieval-Augmented Generation (RAG), kerangka kerja seperti LangChain menjadi populer untuk pengembangan aplikasi AI. Namun, seiring dunia beralih ke alur kerja Agentic AI, kerangka kerja seperti Haystack AI semakin menonjol karena fleksibilitas, modularitas, dan keefektifannya dalam menangani beragam kasus penggunaan.
Dalam tutorial ini, kita akan mempelajari Haystack AI, menjelajahi komponen utamanya dan kasus penggunaannya, serta mempelajari cara membangun alur kerja AI bersifat agentic yang mengintegrasikan banyak alat. Alur kerja agentic mengacu pada sistem di mana model bahasa secara otonom memanggil alat dan komponen berdasarkan kueri pengguna untuk mencapai tujuan.
Jika Anda baru pada topik ini, pastikan untuk melihat tutorial kami tentang Agentic AI dan Agentic RAG.
Kami membuat pembaca tetap diperbarui tentang perkembangan terbaru di AI melalui The Median, buletin gratis setiap Jumat yang merangkum kisah-kisah utama pekan ini. Berlangganan dan tetap tajam hanya dalam beberapa menit per minggu:
Haystack adalah kerangka kerja open-source yang dirancang untuk membangun aplikasi siap produksi yang sangat dapat disesuaikan dan didukung oleh Large Language Models (LLM). Ini memungkinkan pengembang membuat beragam sistem berbasis AI, termasuk pipeline RAG, alur kerja berbasis agen, sistem pencarian mutakhir, dan bahkan aplikasi AI yang sepenuhnya otonom.
Arsitektur modular Haystack memungkinkan pengembang mengintegrasikan teknologi dan alat AI terkemuka, termasuk OpenAI, Hugging Face Transformers, Chroma, alat MCP, Elasticsearch, dan lainnya.
Ini lebih sederhana dibanding Langchain dan menawarkan beragam alat untuk membuat komponen dan agen hanya dengan beberapa baris kode.
Pada intinya, Haystack disusun berdasarkan komponen dan pipeline, yang bekerja bersama penyedia LLM, document store, alat, agen, serta ekosistem integrasi yang kaya. Kepingan penyusun ini memberi pengembang kemampuan untuk merancang, menyesuaikan, dan menerapkan sistem AI end-to-end.
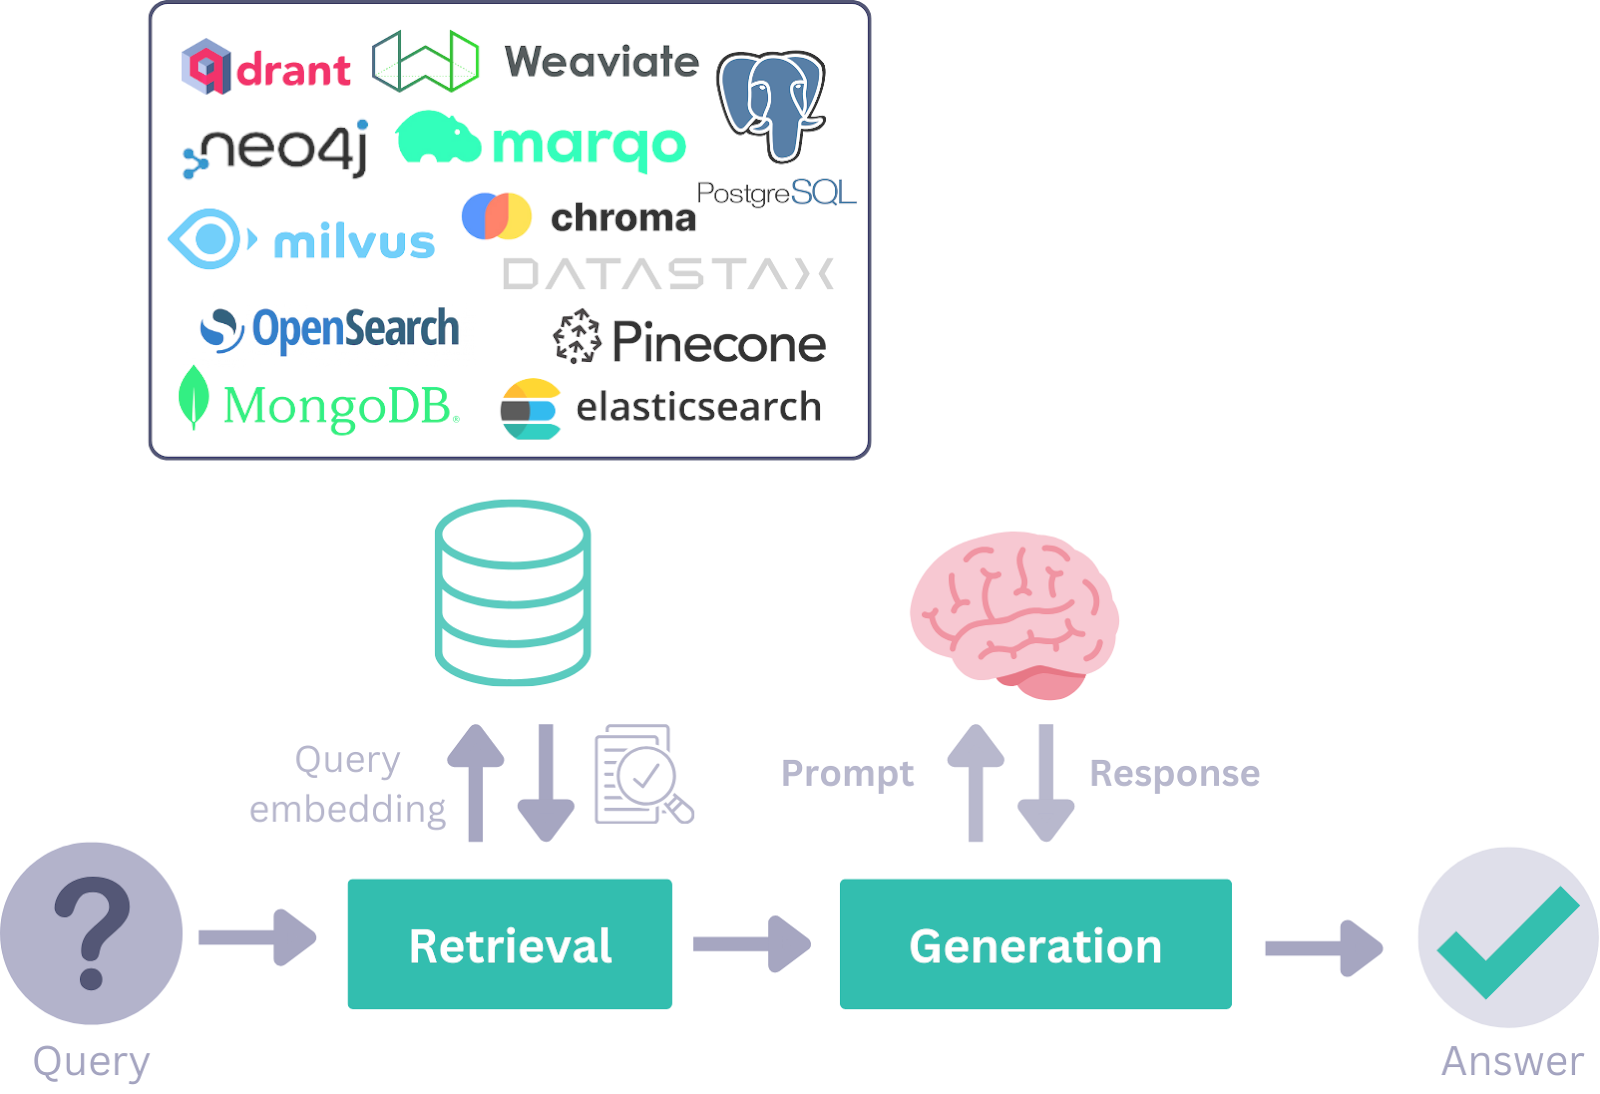
Sumber: Ikhtisar Konsep Haystack
Dengan komponen Haystack berikut, Anda dapat membangun alur kerja RAG yang tangguh, pipeline agentic, atau bahkan menggabungkan keduanya untuk aplikasi AI tingkat lanjut.
Haystack menawarkan berbagai komponen untuk tugas spesifik seperti retrieval, generation, atau penyimpanan dokumen. Komponen ini adalah kelas Python dengan metode callable yang diinisialisasi menggunakan parameter dan dijalankan dengan metode run().
Component API menyederhanakan proses pembuatan komponen kustom, termasuk untuk API dan basis data pihak ketiga.
Generator bertanggung jawab menghasilkan respons teks berdasarkan prompt yang diterima. Di backend, generator ini memanfaatkan API yang disediakan oleh penyedia LLM dan disesuaikan untuk memenuhi kebutuhan spesifik.
Ada dua jenis generator:
1. Chat generators: Dirancang untuk konteks percakapan dan memungkinkan chat completion dengan berinteraksi melalui serangkaian pesan.
2. Non-chat generators: Digunakan untuk tugas generasi teks yang lebih sederhana, seperti terjemahan atau peringkasan.
Mengambil dokumen yang relevan dari document store berdasarkan kueri pengguna. Sistem ini dikustomisasi untuk document store tertentu, sehingga dapat menangani kebutuhan basis data yang unik dengan parameter kustom. Misalnya, document store Elasticsearch memiliki paket retriever dan document store yang tersedia.
Antarmuka penyimpanan dokumen di Haystack secara efektif mengelola dokumen. Ini mencakup fungsi seperti write_documents () dan delete_documents () untuk menangani manajemen data. Komponen dapat dengan mudah berinteraksi dengan Document Store untuk membaca atau menulis dokumen. Komponen DocumentWriter dapat digunakan untuk menulis data ke Document Store untuk alur kerja yang lebih kompleks.
Data class menyederhanakan komunikasi antar komponen secara lugas dan modular. Informasi dipertukarkan dalam sistem sebagai input atau output di dalam pipeline.
Ada dua jenis data class:
Pipeline menggabungkan komponen, document store, dan integrasi menjadi alur kerja yang dapat disesuaikan. Pipeline mendukung fitur seperti aliran simultan, komponen mandiri, loop, serta langkah prapemrosesan, pengindeksan, dan kueri. Pipeline dapat disimpan dalam format seperti YAML atau TOML untuk digunakan kembali atau dibagikan.
Agen AI adalah sistem otonom yang menggunakan model bahasa besar untuk mengambil keputusan dan menyelesaikan tugas yang kompleks. Anda dapat membangun alat untuk terhubung dengan sebuah API, memberikannya kepada agen, lalu mengajukan pertanyaan. Agen akan menganalisis kueri dan menggunakan alat yang sesuai berdasarkan pertanyaan Anda.
Di bagian ini, kita akan menerapkan komponen utama Haystack untuk membangun alur kerja AI Agentic yang akan digunakan dengan alat RAG dan akses web, bergantung pada kueri pengguna.
Untuk panduan ini, kita akan menggunakan DataLab sebagai lingkungan pengkodean. Untuk memulai, kita akan memasang paket Python berikut: Haystack, OpenAI, Tavil, dan itertools. Berikut kegunaan masing-masing paket:
!pip install -qU \
    "haystack-ai[agentst]" \
    tavily-python \
    openai \
    more_itertools
Untuk menggunakan OpenAI dan Tavily, setel kunci API keduanya sebagai variabel lingkungan. Jika Anda menggunakan DataLab, Anda dapat menambahkan variabel lingkungan dengan menavigasi ke tab Environment dan memilih opsi Environment Variables.
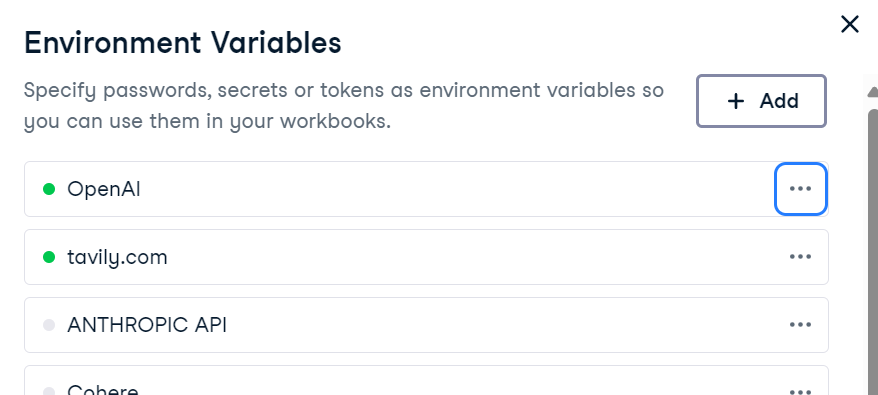
Sebagai alternatif, Anda dapat menyetelnya secara terprogram di Python:
import os

os.environ["OPENAI_API_KEY"]  = "sk-..."   # ← paste your OpenAI key
os.environ["TAVILY_API_KEY"] = "tvly-..." # ← paste your Tavily keyKita akan membuat basis pengetahuan menggunakan data class Document milik Haystack. Basis pengetahuan ini akan memuat informasi tentang kota Islamabad.
from haystack.dataclasses import Document
from typing import List, Any, Dict


docs: List[Document] = [
    Document(content="Islamabad experiences a humid subtropical climate with hot summers and mild winters."),
    Document(content="Peak tourist season in Islamabad is during spring (March to May) and autumn (September to November) due to pleasant weather."),
    Document(content="Faisal Mosque, one of the largest mosques in the world, is an iconic landmark in Islamabad designed by Turkish architect Vedat Dalokay."),
    Document(content="Islamabad was purpose-built as the capital of Pakistan in the 1960s, designed by Greek architect Constantinos Apostolos Doxiadis."),
    Document(content="The city is known for its well-planned infrastructure, wide roads, and green spaces, making it one of the most organized cities in Pakistan."),
]Document store bertindak sebagai vector store, menyimpan embedding teks dan memungkinkan pengambilan yang efisien berdasarkan kueri pengguna.
Di sini, kita akan:
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.embedders import OpenAIDocumentEmbedder
from haystack.components.writers import DocumentWriter
from haystack import Pipeline, component

document_store = InMemoryDocumentStore(embedding_similarity_function="cosine")

indexing_pipeline = Pipeline()
indexing_pipeline.add_component("embedder", OpenAIDocumentEmbedder(model="text-embedding-3-small"))
indexing_pipeline.add_component("writer", DocumentWriter(document_store=document_store))
indexing_pipeline.connect("embedder", "writer")

indexing_pipeline.run({"embedder": {"documents": docs}})
Setelah menjalankan pipeline, dokumen berhasil disimpan sebagai embedding:
Calculating embeddings: 1it [00:00,  1.34it/s]


{'embedder': {'meta': {'model': 'text-embedding-3-small',
   'usage': {'prompt_tokens': 128, 'total_tokens': 128}}},
'writer': {'documents_written': 5}}Setelah document store terisi, kita akan membuat alat pencarian RAG kustom.
Alat ini akan:
from haystack.tools import ComponentTool
from haystack.components.embedders import OpenAIDocumentEmbedder, OpenAITextEmbedder
from haystack.components.retrievers.in_memory import InMemoryEmbeddingRetriever

@component()
class RagSearcher:
    """Query ‑> top‑k docs from the private store"""
    def __init__(self, document_store, top_k: int = 3):
        self.text_embedder = OpenAITextEmbedder(model="text-embedding-3-small")
        self.retriever = InMemoryEmbeddingRetriever(document_store=document_store, top_k=top_k)

    @component.output_types(documents=List[Document])
    def run(self, text: str) -> Dict[str, Any]:
        emb_out = self.text_embedder.run(text=text)
        docs_out = self.retriever.run(query_embedding=emb_out["embedding"])
        return {"documents": docs_out["documents"]}

rag_tool = ComponentTool(
    component=RagSearcher(document_store),
    name="rag_search",
    description="Semantic search over the Islamabad knowledge base."
)Karena Tavily tidak memiliki komponen Haystack asli, kita akan membuat alat pencarian web kustom menggunakan Tavily API. Alat ini akan mengambil hasil penelusuran web langsung dan mengembalikannya sebagai objek Document.
import os
import requests
from haystack import component
from haystack.dataclasses import Document
from typing import List

@component
class TavilyWebSearch:
    def __init__(self, api_key: str, top_k: int = 3):
        self.api_key = api_key
        self.top_k   = top_k

    def run(self, query: str):
        resp = requests.post(
            "https://api.tavily.com/search",
            json={
                "api_key": self.api_key,
                "query": query,
                "max_results": self.top_k,
                "include_answer": True,
            },
            timeout=15,
        )
        resp.raise_for_status()
        data = resp.json()

        docs: List[Document] = []
        if answer := data.get("answer"):
            docs.append(Document(content=answer, meta={"source": "tavily:direct_answer"}))

        for hit in data.get("results", []):
            docs.append(
                Document(
                    content=hit["content"],
                    meta={
                        "title": hit["title"],
                        "url": hit["url"],
                    },
                )
            )
        return {"documents": docs}


web_tool = ComponentTool(
    component=TavilyWebSearch(api_key=os.environ["TAVILY_API_KEY"], top_k=3),
    name="web_search",
    description="Live web search via Tavily ."
)Kita akan membuat generator menggunakan fungsi OpenAI dan model gpt-4.1-mini terbaru. Pertama, kita akan mengembangkan system prompt yang membantu Agen menentukan alat mana yang digunakan untuk permintaan pengguna tertentu. Terakhir, kita akan membuat Agen dengan generator, system prompt, dan daftar alat.
Berdasarkan system prompt, Agen akan terlebih dahulu memeriksa informasi menggunakan pencarian RAG. Jika pertanyaan pengguna berkaitan dengan berita terbaru, cuaca, atau berita hangat, Agen akan langsung menggunakan alat pencarian web.
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.agents import Agent

generator = OpenAIChatGenerator(model="gpt-4.1-mini")

system_prompt = """
You are a helpful assistant.
- Use rag_search first to retrieve information from the knowledge base.
- Use web_search only when the query requires fresh, real-time, or external information (e.g., weather, breaking news).
"""

agent = Agent(
    chat_generator=generator,
    system_prompt=system_prompt,
    tools=[rag_tool, web_tool],
)Kita akan mengajukan pertanyaan tentang Islamabad untuk memanggil alat RAG agar menjawabnya.
from haystack.dataclasses import ChatMessage

msg = ChatMessage.from_user("What is the peak tourist season in Islamabad?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
Kita mendapatkan jawaban dengan kesadaran konteks yang tinggi, tetapi bagaimana kita tahu bahwa alat RAG telah digunakan untuk menjawab?
The peak tourist season in Islamabad is during spring (March to May) and autumn (September to November).Untuk memeriksa alat mana yang dipanggil, kita akan membuat fungsi yang mengekstrak informasi tentang alat tersebut.
def tools_used(run_output: dict) -> list[str]:
    seen, ordered = set(), []

    for msg in run_output["messages"]:
        for call in msg.tool_calls:
            if call.tool_name not in seen:
                ordered.append(call.tool_name)
                seen.add(call.tool_name)
    return ordered
print("Tools invoked →", tools_used(resp))
Untuk pengujian pertama, agen hanya menggunakan alat rag_search untuk menjawab pertanyaan.
Tools invoked → ['rag_search']Sekarang kita akan menanyakan cuaca di Islamabad. Alih-alih memanggil alat RAG, agen akan menggunakan alat pencarian web untuk menjawabnya.
msg = ChatMessage.from_user("What is the temperature in Islamabad now?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
print("Tools invoked →", tools_used(resp))
Jawabannya sangat akurat, dan agen telah menggunakan alat pencarian web untuk menjawab pertanyaan tersebut.
The current temperature in Islamabad is 31°C with a real-feel temperature of 32°C.
Tools invoked → ['web_search']
Jika Anda mengalami masalah saat menjalankan kode di atas, silakan merujuk ke Datalab Notebook: Tutorial Haystack AI — DataLab.
Kita telah membahas dasar-dasar kerangka kerja Haystack AI. Langkah berikutnya dalam perjalanan belajar Anda adalah membuat aplikasi AI yang sepenuhnya fungsional. Berikut beberapa kasus penggunaan yang sedang dieksplor pengembang:
Setelah bekerja dengan banyak kerangka kerja LLM, saya menemukan Haystack sebagai salah satu opsi paling intuitif dan fleksibel yang tersedia. Rasanya lebih alami digunakan, tidak terlalu kompleks, dan menawarkan kontrol lebih besar atas alur kerja Anda.
Salah satu fitur menonjolnya adalah kemudahan membuat komponen kustom untuk pipeline Anda, menjadikannya sangat adaptif untuk beragam kasus penggunaan.
Saya khususnya menikmati bereksperimen dengan agen dan alat, serta memahami cara memanggil masing-masing secara efektif. Bekerja dengan system prompt membantu saya memahami cara menggunakan alat secara individual dan berurutan.
Selain itu, system prompt dapat dengan mudah disesuaikan untuk menyertakan detail tambahan, seperti menampilkan sumber dan ID dokumen, yang bisa penting bagi aplikasi Anda.
Jika Anda baru di dunia agen AI, lihat sumber daya di bawah ini untuk mempelajari lebih lanjut:
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




