
Kurs
LangChain ile LLM Uygulamaları Geliştirme
3 sa
51.3K
Retrieval-Augmented Generation (RAG) döneminde, LangChain gibi çerçeveler yapay zeka uygulamaları geliştirmek için popüler hale geldi. Ancak dünya Aracısal Yapay Zeka iş akışlarına yöneldikçe, Haystack AI gibi çerçeveler esneklikleri, modüler yapıları ve geniş kullanım senaryolarını etkili bir şekilde ele almaları sayesinde öne çıkıyor.
Bu eğitimde Haystack AI’ı tanıyacak, temel bileşenlerini ve kullanım alanlarını keşfedecek ve birden çok aracı entegre eden bir yapay zeka aracısal iş akışını nasıl kuracağınızı öğreneceğiz. Aracısal iş akışı, dil modellerinin bir hedefe ulaşmak için kullanıcı sorgularına göre araçları ve bileşenleri özerk biçimde çağırdığı sistemleri ifade eder.
Konuya yeniyseniz, Aracısal Yapay Zeka ve Aracısal RAG ile ilgili eğitimlerimize mutlaka göz atın.
Okuyucularımızı yapay zekadaki en son gelişmelerden haberdar etmek için, haftanın öne çıkan haberlerini özetleyen ücretsiz Cuma bültenimiz The Median’i gönderiyoruz. Abone olun; haftada sadece birkaç dakikada gündemi yakalayın:
Haystack, Büyük Dil Modelleri (LLM’ler) ile çalışan, yüksek düzeyde özelleştirilebilir ve üretime hazır uygulamalar geliştirmek üzere tasarlanmış, açık kaynaklı bir çerçevedir. Geliştiricilerin RAG hatları, ajan tabanlı iş akışları, son teknoloji arama sistemleri ve hatta tamamen özerk yapay zeka uygulamaları dahil olmak üzere çok çeşitli yapay zeka odaklı sistemler oluşturmasını sağlar.
Haystack’in modüler mimarisi; OpenAI, Hugging Face Transformers, Chroma, MCP araçları, Elasticsearch ve daha fazlası dahil olmak üzere önde gelen yapay zeka teknolojilerini ve araçlarını entegre etmeye olanak tanır.
Langchain’den daha basittir ve yalnızca birkaç satır kodla kendi bileşenlerinizi ve ajanlarınızı oluşturmanız için geniş bir araç yelpazesi sunar.
Haystack, özünde LLM sağlayıcıları, doküman depoları, araçlar, ajanlar ve zengin bir entegrasyon ekosistemiyle birlikte çalışan bileşenler ve hatlar etrafında yapılandırılmıştır. Bu yapı taşları, geliştiricilere uçtan uca yapay zeka sistemleri tasarlama, özelleştirme ve dağıtma olanağı verir.
Kaynak: Haystack Kavramlarına Genel Bakış
Aşağıdaki Haystack bileşenlerini kullanarak sağlam RAG iş akışları, aracısal hatlar oluşturabilir veya her ikisini birleştirerek gelişmiş yapay zeka uygulamaları geliştirebilirsiniz.
Haystack, getirme, üretim veya doküman depolama gibi belirli görevler için çeşitli bileşenler sunar. Bu bileşenler, parametrelerle başlatılan ve run() yöntemiyle yürütülen, çağrılabilir yöntemlere sahip Python sınıflarıdır.
Component API, üçüncü taraf API’ler ve veritabanları için olanlar da dahil, özel bileşenler oluşturma sürecini kolaylaştırır.
Üreticiler, aldıkları yönlendirmelere (prompt) göre metin yanıtları üretmekten sorumludur. Arka planda bu üreticiler, LLM sağlayıcılarının sunduğu API’lerden yararlanır ve belirli gereksinimlere göre uyarlanır.
İki tür üretici vardır:
1. Sohbet üreticileri: Konuşma bağlamları için tasarlanmıştır ve bir dizi mesajla etkileşerek sohbet tamamlama sağlar.
2. Sohbet dışı üreticiler: Çeviri veya özetleme gibi daha basit metin üretim görevlerinde kullanılır.
Kullanıcı sorgularına göre bir doküman deposundan ilgili dokümanları getirir. Bu sistem, belirli doküman depolarına göre özelleştirilir; böylece benzersiz veritabanı gereksinimlerini özel parametrelerle karşılayabilir. Örneğin Elasticsearch doküman deposu için hem getirici hem de doküman deposu paketleri mevcuttur.
Haystack’teki doküman depolama arayüzü, dokümanları etkili biçimde yönetir. Veri yönetimi için write_documents () ve delete_documents () gibi işlevleri içerir. Bileşenler, Doküman Deposu ile kolayca etkileşime geçerek doküman okuyabilir veya yazabilir. Daha karmaşık iş akışları için bir DocumentWriter bileşeni, verileri Doküman Depolarına yazmak üzere kullanılabilir.
Veri sınıfları, bileşenler arasında iletişimi basit ve modüler bir şekilde kolaylaştırır. Bilgi, hatlar içinde giriş veya çıkış olarak sistem içinde değiş tokuş edilir.
İki tür veri sınıfı vardır:
Hatlar; bileşenleri, doküman depolarını ve entegrasyonları özelleştirilebilir iş akışlarında birleştirir. Eşzamanlı akışlar, bağımsız bileşenler, döngüler ile ön işleme, indeksleme ve sorgulama adımları gibi özellikleri destekler. Hatlar, yeniden kullanım veya paylaşım için YAML veya TOML formatlarında kaydedilebilir.
Yapay zeka ajanları, büyük dil modellerini kullanarak karar veren ve karmaşık görevlerin üstesinden gelen özerk sistemlerdir. Bir API’ye bağlanan araçlar geliştirebilir, bunları ajana verebilir ve bir soru sorabilirsiniz. Ajan, sorguyu analiz ederek sorunuza göre uygun araçları kullanır.
Bu bölümde, kullanıcı sorgusuna bağlı olarak RAG ve web erişim aracını kullanacak bir Yapay Zeka Aracısal iş akışı oluşturmak için Haystack’in temel bileşenlerini uygulayacağız.
Bu rehber için kodlama ortamı olarak DataLab kullanacağız. Başlamak için şu Python paketlerini kuracağız: Haystack, OpenAI, Tavily ve itertools. Her paketin kullanım amacı şudur:
!pip install -qU \
    "haystack-ai[agentst]" \
    tavily-python \
    openai \
    more_itertools
OpenAI ve Tavily’i kullanmak için, API anahtarlarını ortam değişkenleri olarak ayarlayın. DataLab kullanıyorsanız, Environment sekmesine gidip Environment Variables seçeneğini belirleyerek ortam değişkenleri ekleyebilirsiniz.
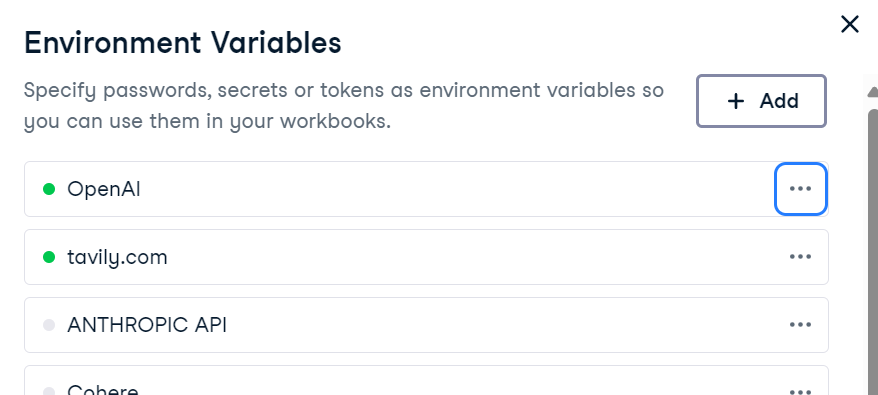
Alternatif olarak bunları Python içinde programatik olarak ayarlayabilirsiniz:
import os

os.environ["OPENAI_API_KEY"]  = "sk-..."   # ← paste your OpenAI key
os.environ["TAVILY_API_KEY"] = "tvly-..." # ← paste your Tavily keyHaystack’in Document veri sınıfını kullanarak bir bilgi tabanı oluşturacağız. Bu bilgi tabanı, İslamabad şehri hakkında bilgiler içerecek.
from haystack.dataclasses import Document
from typing import List, Any, Dict


docs: List[Document] = [
    Document(content="Islamabad experiences a humid subtropical climate with hot summers and mild winters."),
    Document(content="Peak tourist season in Islamabad is during spring (March to May) and autumn (September to November) due to pleasant weather."),
    Document(content="Faisal Mosque, one of the largest mosques in the world, is an iconic landmark in Islamabad designed by Turkish architect Vedat Dalokay."),
    Document(content="Islamabad was purpose-built as the capital of Pakistan in the 1960s, designed by Greek architect Constantinos Apostolos Doxiadis."),
    Document(content="The city is known for its well-planned infrastructure, wide roads, and green spaces, making it one of the most organized cities in Pakistan."),
]Doküman deposu bir vektör deposu olarak hareket eder; metin gömmelerini saklar ve kullanıcı sorgularına dayalı verimli getirme sağlar.
Burada şunları yapacağız:
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.embedders import OpenAIDocumentEmbedder
from haystack.components.writers import DocumentWriter
from haystack import Pipeline, component

document_store = InMemoryDocumentStore(embedding_similarity_function="cosine")

indexing_pipeline = Pipeline()
indexing_pipeline.add_component("embedder", OpenAIDocumentEmbedder(model="text-embedding-3-small"))
indexing_pipeline.add_component("writer", DocumentWriter(document_store=document_store))
indexing_pipeline.connect("embedder", "writer")

indexing_pipeline.run({"embedder": {"documents": docs}})
Hattı çalıştırdıktan sonra dokümanlar başarıyla gömme olarak depolandı:
Calculating embeddings: 1it [00:00,  1.34it/s]


{'embedder': {'meta': {'model': 'text-embedding-3-small',
   'usage': {'prompt_tokens': 128, 'total_tokens': 128}}},
'writer': {'documents_written': 5}}Doküman deposu doldurulduktan sonra özel bir RAG arama aracı oluşturacağız.
Bu araç şunları yapacak:
from haystack.tools import ComponentTool
from haystack.components.embedders import OpenAIDocumentEmbedder, OpenAITextEmbedder
from haystack.components.retrievers.in_memory import InMemoryEmbeddingRetriever

@component()
class RagSearcher:
    """Query ‑> top‑k docs from the private store"""
    def __init__(self, document_store, top_k: int = 3):
        self.text_embedder = OpenAITextEmbedder(model="text-embedding-3-small")
        self.retriever = InMemoryEmbeddingRetriever(document_store=document_store, top_k=top_k)

    @component.output_types(documents=List[Document])
    def run(self, text: str) -> Dict[str, Any]:
        emb_out = self.text_embedder.run(text=text)
        docs_out = self.retriever.run(query_embedding=emb_out["embedding"])
        return {"documents": docs_out["documents"]}

rag_tool = ComponentTool(
    component=RagSearcher(document_store),
    name="rag_search",
    description="Semantic search over the Islamabad knowledge base."
)Tavily’nin yerel Haystack bileşenleri olmadığı için, Tavily API’sini kullanarak özel bir web arama aracı oluşturacağız. Bu araç, canlı web arama sonuçlarını getirip bunları Document nesneleri olarak döndürecek.
import os
import requests
from haystack import component
from haystack.dataclasses import Document
from typing import List

@component
class TavilyWebSearch:
    def __init__(self, api_key: str, top_k: int = 3):
        self.api_key = api_key
        self.top_k   = top_k

    def run(self, query: str):
        resp = requests.post(
            "https://api.tavily.com/search",
            json={
                "api_key": self.api_key,
                "query": query,
                "max_results": self.top_k,
                "include_answer": True,
            },
            timeout=15,
        )
        resp.raise_for_status()
        data = resp.json()

        docs: List[Document] = []
        if answer := data.get("answer"):
            docs.append(Document(content=answer, meta={"source": "tavily:direct_answer"}))

        for hit in data.get("results", []):
            docs.append(
                Document(
                    content=hit["content"],
                    meta={
                        "title": hit["title"],
                        "url": hit["url"],
                    },
                )
            )
        return {"documents": docs}


web_tool = ComponentTool(
    component=TavilyWebSearch(api_key=os.environ["TAVILY_API_KEY"], top_k=3),
    name="web_search",
    description="Live web search via Tavily ."
)OpenAI işlevlerini ve en son gpt-4.1-mini modelini kullanarak bir üretici oluşturacağız. Önce, Ajana belirli kullanıcı istekleri için hangi araçların kullanılacağını belirlemede yardımcı olacak sistem istemini geliştireceğiz. Son olarak, üretici, sistem istemi ve araç listesini kullanarak Ajani oluşturacağız.
Sistem istemine göre Ajan, önce RAG aramasını kullanarak bilgileri kontrol edecek. Kullanıcının sorusu en son haberler, hava durumu veya flaş gelişmelerle ilgiliyse, Ajan doğrudan web arama aracını kullanacaktır.
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.agents import Agent

generator = OpenAIChatGenerator(model="gpt-4.1-mini")

system_prompt = """
You are a helpful assistant.
- Use rag_search first to retrieve information from the knowledge base.
- Use web_search only when the query requires fresh, real-time, or external information (e.g., weather, breaking news).
"""

agent = Agent(
    chat_generator=generator,
    system_prompt=system_prompt,
    tools=[rag_tool, web_tool],
)RAG aracının yanıt vermesini tetiklemek için İslamabad hakkında bir soru soracağız.
from haystack.dataclasses import ChatMessage

msg = ChatMessage.from_user("What is the peak tourist season in Islamabad?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
Bağlama son derece uygun yanıtlar aldık; peki yanıtlamak için RAG aracını kullandığını nasıl anlarız?
The peak tourist season in Islamabad is during spring (March to May) and autumn (September to November).Hangi araçların çağrıldığını görmek için, araçlarla ilgili bilgileri çıkaracak bir işlev oluşturacağız.
def tools_used(run_output: dict) -> list[str]:
    seen, ordered = set(), []

    for msg in run_output["messages"]:
        for call in msg.tool_calls:
            if call.tool_name not in seen:
                ordered.append(call.tool_name)
                seen.add(call.tool_name)
    return ordered
print("Tools invoked →", tools_used(resp))
İlk testte, ajan soruyu yanıtlamak için yalnızca rag_search aracını kullandı.
Tools invoked → ['rag_search']Şimdi İslamabad’ın hava durumunu soracağız. RAG aracını çağırmak yerine, soruyu yanıtlamak için web arama aracını kullanacaktır.
msg = ChatMessage.from_user("What is the temperature in Islamabad now?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
print("Tools invoked →", tools_used(resp))
Yanıt oldukça isabetli ve soruyu yanıtlamak için web arama aracını kullandı.
The current temperature in Islamabad is 31°C with a real-feel temperature of 32°C.
Tools invoked → ['web_search']
Yukarıdaki kodu çalıştırırken sorun yaşıyorsanız, lütfen Datalab Not Defteri’ne bakın: Haystack AI Eğitimi — DataLab.
Haystack AI çerçevesinin temellerini ele aldık. Öğrenme yolculuğunuzdaki bir sonraki adım, tamamen işlevsel bir yapay zeka uygulaması oluşturmaktır. İşte geliştiricilerin üzerinde çalıştığı bazı kullanım alanları:
Birçok LLM çerçevesiyle çalışmış biri olarak, Haystack’i en sezgisel ve esnek seçeneklerden biri olarak görüyorum. Kullanımı daha doğal, daha az karmaşık ve iş akışlarınız üzerinde daha fazla kontrol sunuyor.
Öne çıkan özelliklerinden biri, hatlarınız için özel bileşenleri çok kolay oluşturabilmeniz; bu da onu çok çeşitli kullanım alanlarına son derece uyarlanabilir kılıyor.
Özellikle ajanlar ve araçlarla denemeler yapmaktan ve her birini etkili şekilde nasıl çağıracağımı öğrenmekten keyif aldım. Sistem istemiyle çalışmak, araçları tek tek ve sıralı biçimde nasıl kullanacağımı anlamama yardımcı oldu.
Ayrıca, sistem istemi; kaynakların ve doküman kimliklerinin gösterilmesi gibi ilave ayrıntıları içerecek şekilde kolayca özelleştirilebilir; bu da uygulamanız için önemli olabilir.
Yapay zeka ajanları dünyasında yeniyseniz, daha fazla bilgi edinmek için aşağıdaki kaynaklara göz atın:
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



