
Khóa học
Phát triển ứng dụng LLM với LangChain
3 giờ
51.4K
Trong kỷ nguyên Retrieval-Augmented Generation (RAG), các framework như LangChain trở nên phổ biến để phát triển ứng dụng AI. Tuy nhiên, khi thế giới chuyển dần sang các quy trình Agentic AI, những framework như Haystack AI ngày càng nổi bật nhờ tính linh hoạt, mô-đun hóa và hiệu quả trong việc xử lý nhiều bài toán khác nhau.
Trong hướng dẫn này, chúng ta sẽ tìm hiểu về Haystack AI, khám phá các thành phần chính và tình huống sử dụng, đồng thời học cách xây dựng một quy trình agentic AI tích hợp nhiều công cụ. Quy trình agentic đề cập đến các hệ thống trong đó mô hình ngôn ngữ tự động gọi công cụ và thành phần dựa trên truy vấn của người dùng để đạt được mục tiêu.
Nếu bạn mới làm quen với chủ đề này, hãy xem các hướng dẫn của chúng tôi về Agentic AI và Agentic RAG.
Chúng tôi cập nhật cho độc giả những tin tức mới nhất về AI qua The Median, bản tin miễn phí mỗi thứ Sáu, tóm lược các câu chuyện đáng chú ý trong tuần. Đăng ký để luôn nắm bắt chỉ trong vài phút mỗi tuần:
Haystack là một framework mã nguồn mở được thiết kế để xây dựng các ứng dụng tùy biến cao, sẵn sàng chạy production, vận hành bởi các Mô hình Ngôn ngữ Lớn (LLM). Nó cho phép nhà phát triển tạo nhiều hệ thống AI, bao gồm pipeline RAG, quy trình dựa trên agent, hệ thống tìm kiếm hiện đại, và thậm chí các ứng dụng AI tự động hoàn toàn.
Kiến trúc mô-đun của Haystack cho phép tích hợp các công nghệ và công cụ AI hàng đầu, bao gồm OpenAI, Hugging Face Transformers, Chroma, công cụ MCP, Elasticsearch, và nhiều hơn nữa.
Nó đơn giản hơn Langchain và cung cấp nhiều công cụ để bạn tạo component và agent chỉ với vài dòng mã.
Cốt lõi của Haystack xoay quanh các component và pipeline, làm việc cùng nhà cung cấp LLM, document store, công cụ, agent và hệ sinh thái tích hợp phong phú. Những khối xây dựng này giúp nhà phát triển thiết kế, tùy biến và triển khai hệ thống AI end-to-end.
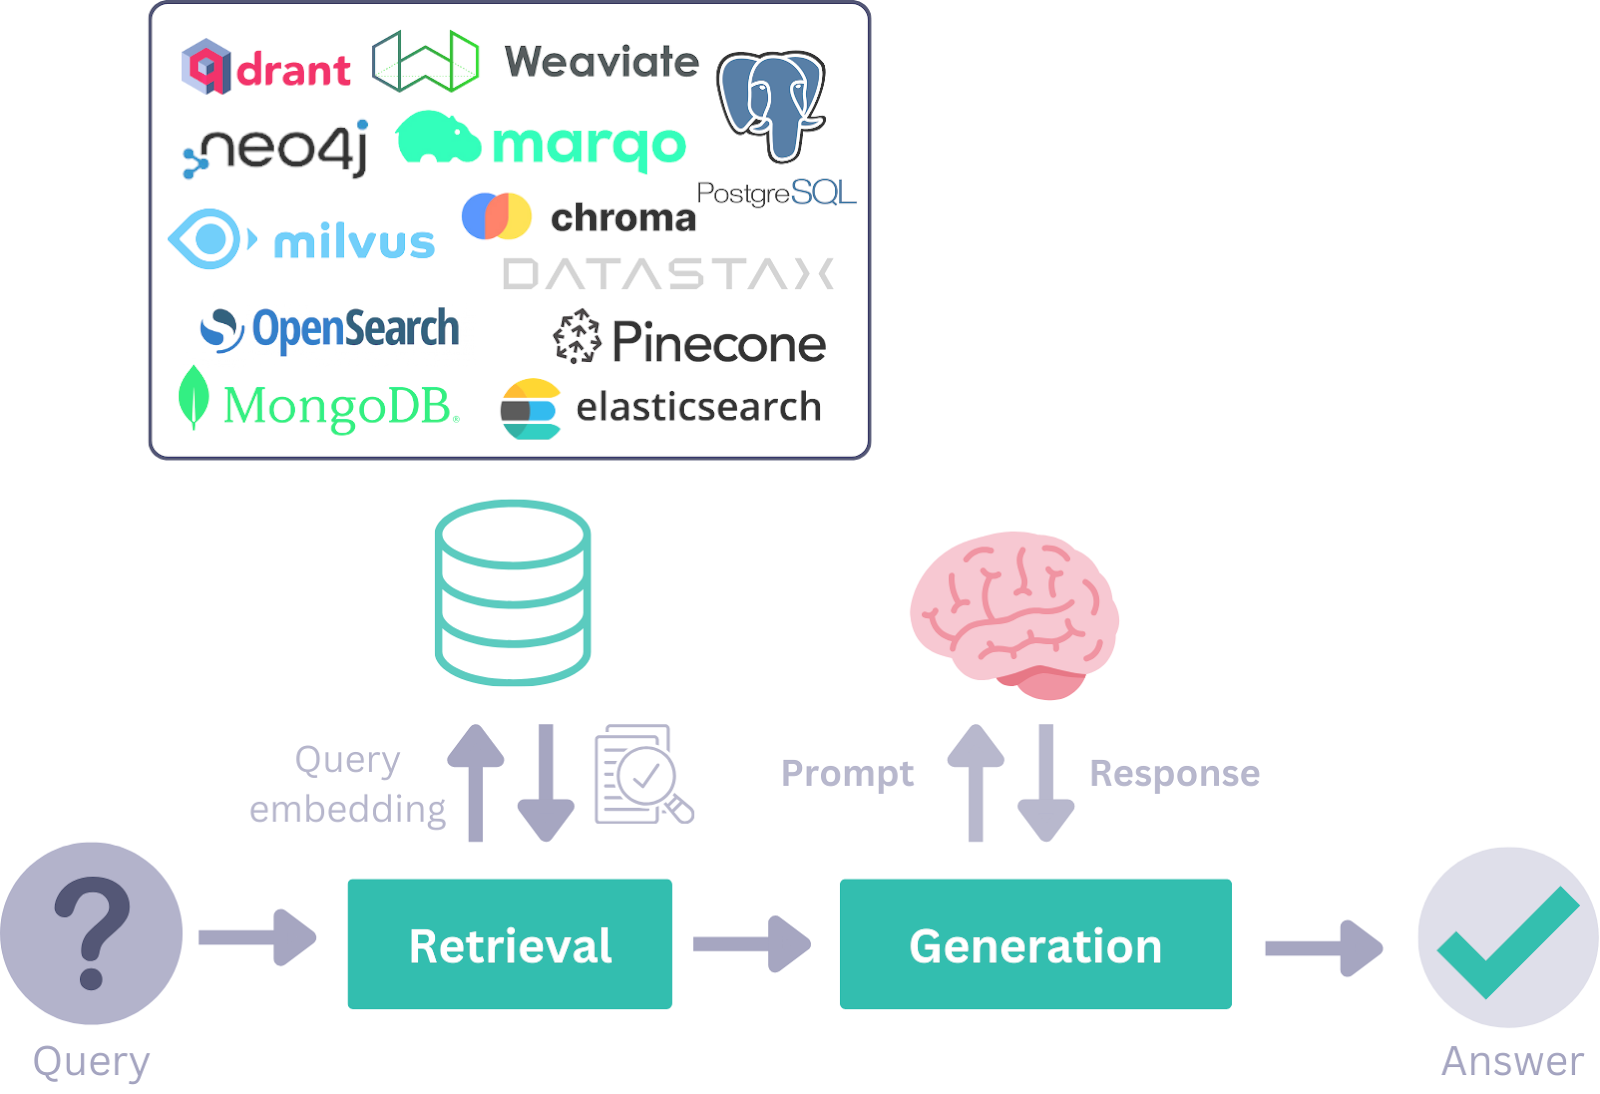
Nguồn: Haystack Concepts Overview
Với các thành phần Haystack sau đây, bạn có thể xây dựng quy trình RAG vững chắc, pipeline agentic, hoặc kết hợp cả hai cho các ứng dụng AI nâng cao.
Haystack cung cấp nhiều component cho các tác vụ cụ thể như truy xuất, sinh nội dung, hoặc lưu trữ tài liệu. Các component này là lớp Python với phương thức có thể gọi, được khởi tạo bằng tham số và thực thi qua phương thức run().
Component API giúp đơn giản hóa việc tạo component tùy chỉnh, bao gồm cả cho API và cơ sở dữ liệu bên thứ ba.
Generator chịu trách nhiệm tạo phản hồi văn bản dựa trên prompt nhận được. Ở backend, các generator này sử dụng API do nhà cung cấp LLM cung cấp và được điều chỉnh theo yêu cầu cụ thể.
Có hai loại generator:
1. Chat generator: Thiết kế cho ngữ cảnh hội thoại và cho phép hoàn tất hội thoại bằng cách tương tác với chuỗi tin nhắn.
2. Non-chat generator: Dùng cho các tác vụ sinh văn bản đơn giản, như dịch hoặc tóm tắt.
Truy xuất tài liệu phù hợp từ document store dựa trên truy vấn của người dùng. Hệ thống này được tùy chỉnh theo từng document store, cho phép xử lý yêu cầu cơ sở dữ liệu đặc thù bằng tham số riêng. Ví dụ, document store Elasticsearch có cả gói retriever và document store sẵn có.
Giao diện lưu trữ tài liệu trong Haystack quản lý tài liệu hiệu quả. Nó bao gồm các hàm như write_documents () và delete_documents () để xử lý dữ liệu. Các component có thể tương tác dễ dàng với Document Store để đọc hoặc ghi tài liệu. Component DocumentWriter có thể dùng để ghi dữ liệu vào Document Store cho quy trình phức tạp hơn.
Data class đơn giản hóa việc trao đổi giữa các component theo cách trực quan và mô-đun. Thông tin được trao đổi trong hệ thống dưới dạng đầu vào hoặc đầu ra trong pipeline.
Có hai loại data class:
Pipeline kết hợp component, document store và tích hợp thành các quy trình có thể tùy biến. Chúng hỗ trợ các luồng đồng thời, component độc lập, vòng lặp, cũng như các bước tiền xử lý, lập chỉ mục và truy vấn. Pipeline có thể lưu ở định dạng như YAML hoặc TOML để tái sử dụng hoặc chia sẻ.
AI agent là các hệ thống tự động sử dụng mô hình ngôn ngữ lớn để ra quyết định và xử lý các tác vụ phức tạp. Bạn có thể xây dựng công cụ để kết nối với API, cung cấp cho agent, rồi đặt câu hỏi. Agent sẽ phân tích truy vấn và dùng công cụ phù hợp dựa trên câu hỏi của bạn.
Trong phần này, chúng ta sẽ áp dụng các thành phần chính của Haystack để xây dựng một quy trình AI Agentic dùng kèm công cụ RAG và truy cập web, tùy theo truy vấn của người dùng.
Trong hướng dẫn này, chúng ta sẽ dùng DataLab làm môi trường lập trình. Để bắt đầu, chúng ta sẽ cài các gói Python sau: Haystack, OpenAI, Tavil và itertools. Công dụng của từng gói:
!pip install -qU \
    "haystack-ai[agentst]" \
    tavily-python \
    openai \
    more_itertools
Để dùng OpenAI và Tavily, hãy đặt khóa API của chúng làm biến môi trường. Nếu bạn dùng DataLab, bạn có thể thêm biến môi trường bằng cách đi tới thẻ Environment và chọn Environment Variables.
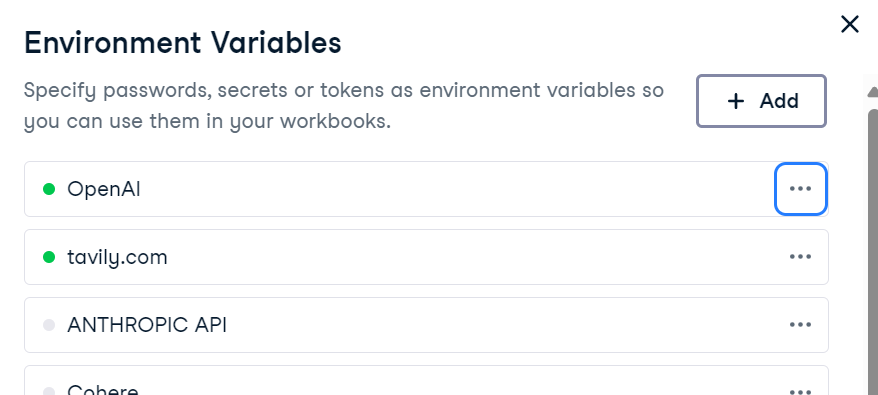
Ngoài ra, bạn có thể đặt bằng mã Python:
import os

os.environ["OPENAI_API_KEY"]  = "sk-..."   # ← paste your OpenAI key
os.environ["TAVILY_API_KEY"] = "tvly-..." # ← paste your Tavily keyChúng ta sẽ tạo một cơ sở tri thức bằng data class Document của Haystack. Cơ sở này sẽ chứa thông tin về thành phố Islamabad.
from haystack.dataclasses import Document
from typing import List, Any, Dict


docs: List[Document] = [
    Document(content="Islamabad experiences a humid subtropical climate with hot summers and mild winters."),
    Document(content="Peak tourist season in Islamabad is during spring (March to May) and autumn (September to November) due to pleasant weather."),
    Document(content="Faisal Mosque, one of the largest mosques in the world, is an iconic landmark in Islamabad designed by Turkish architect Vedat Dalokay."),
    Document(content="Islamabad was purpose-built as the capital of Pakistan in the 1960s, designed by Greek architect Constantinos Apostolos Doxiadis."),
    Document(content="The city is known for its well-planned infrastructure, wide roads, and green spaces, making it one of the most organized cities in Pakistan."),
]Document store đóng vai trò như một vector store, lưu trữ embedding văn bản và cho phép truy xuất hiệu quả theo truy vấn người dùng.
Tại đây, chúng ta sẽ:
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.embedders import OpenAIDocumentEmbedder
from haystack.components.writers import DocumentWriter
from haystack import Pipeline, component

document_store = InMemoryDocumentStore(embedding_similarity_function="cosine")

indexing_pipeline = Pipeline()
indexing_pipeline.add_component("embedder", OpenAIDocumentEmbedder(model="text-embedding-3-small"))
indexing_pipeline.add_component("writer", DocumentWriter(document_store=document_store))
indexing_pipeline.connect("embedder", "writer")

indexing_pipeline.run({"embedder": {"documents": docs}})
Sau khi chạy pipeline, các tài liệu đã được lưu thành embedding thành công:
Calculating embeddings: 1it [00:00,  1.34it/s]


{'embedder': {'meta': {'model': 'text-embedding-3-small',
   'usage': {'prompt_tokens': 128, 'total_tokens': 128}}},
'writer': {'documents_written': 5}}Sau khi document store được điền dữ liệu, chúng ta sẽ tạo một công cụ tìm kiếm RAG tùy chỉnh.
Công cụ này sẽ:
from haystack.tools import ComponentTool
from haystack.components.embedders import OpenAIDocumentEmbedder, OpenAITextEmbedder
from haystack.components.retrievers.in_memory import InMemoryEmbeddingRetriever

@component()
class RagSearcher:
    """Query ‑> top‑k docs from the private store"""
    def __init__(self, document_store, top_k: int = 3):
        self.text_embedder = OpenAITextEmbedder(model="text-embedding-3-small")
        self.retriever = InMemoryEmbeddingRetriever(document_store=document_store, top_k=top_k)

    @component.output_types(documents=List[Document])
    def run(self, text: str) -> Dict[str, Any]:
        emb_out = self.text_embedder.run(text=text)
        docs_out = self.retriever.run(query_embedding=emb_out["embedding"])
        return {"documents": docs_out["documents"]}

rag_tool = ComponentTool(
    component=RagSearcher(document_store),
    name="rag_search",
    description="Semantic search over the Islamabad knowledge base."
)Vì Tavily chưa có component Haystack gốc, chúng ta sẽ tạo công cụ tìm kiếm web tùy chỉnh bằng Tavily API. Công cụ này sẽ lấy kết quả tìm kiếm web thời gian thực và trả về dưới dạng đối tượng Document.
import os
import requests
from haystack import component
from haystack.dataclasses import Document
from typing import List

@component
class TavilyWebSearch:
    def __init__(self, api_key: str, top_k: int = 3):
        self.api_key = api_key
        self.top_k   = top_k

    def run(self, query: str):
        resp = requests.post(
            "https://api.tavily.com/search",
            json={
                "api_key": self.api_key,
                "query": query,
                "max_results": self.top_k,
                "include_answer": True,
            },
            timeout=15,
        )
        resp.raise_for_status()
        data = resp.json()

        docs: List[Document] = []
        if answer := data.get("answer"):
            docs.append(Document(content=answer, meta={"source": "tavily:direct_answer"}))

        for hit in data.get("results", []):
            docs.append(
                Document(
                    content=hit["content"],
                    meta={
                        "title": hit["title"],
                        "url": hit["url"],
                    },
                )
            )
        return {"documents": docs}


web_tool = ComponentTool(
    component=TavilyWebSearch(api_key=os.environ["TAVILY_API_KEY"], top_k=3),
    name="web_search",
    description="Live web search via Tavily ."
)Chúng ta sẽ tạo một generator dùng OpenAI functions và mẫu gpt-4.1-mini mới nhất. Trước tiên, chúng ta sẽ xây dựng system prompt giúp Agent quyết định công cụ nào sẽ dùng cho từng yêu cầu. Cuối cùng, chúng ta tạo Agent với generator, system prompt và danh sách công cụ.
Dựa trên system prompt, Agent sẽ kiểm tra thông tin qua tìm kiếm RAG trước. Nếu câu hỏi của người dùng liên quan đến tin tức mới nhất, thời tiết, hoặc tin nóng, Agent sẽ dùng trực tiếp công cụ tìm kiếm web.
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.agents import Agent

generator = OpenAIChatGenerator(model="gpt-4.1-mini")

system_prompt = """
You are a helpful assistant.
- Use rag_search first to retrieve information from the knowledge base.
- Use web_search only when the query requires fresh, real-time, or external information (e.g., weather, breaking news).
"""

agent = Agent(
    chat_generator=generator,
    system_prompt=system_prompt,
    tools=[rag_tool, web_tool],
)Chúng ta sẽ hỏi một câu về Islamabad để kích hoạt công cụ RAG trả lời.
from haystack.dataclasses import ChatMessage

msg = ChatMessage.from_user("What is the peak tourist season in Islamabad?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
Chúng ta có câu trả lời có tính ngữ cảnh cao, nhưng làm sao biết công cụ RAG đã được dùng để trả lời?
The peak tourist season in Islamabad is during spring (March to May) and autumn (September to November).Để kiểm tra công cụ nào được gọi, chúng ta sẽ tạo hàm để trích xuất thông tin về công cụ.
def tools_used(run_output: dict) -> list[str]:
    seen, ordered = set(), []

    for msg in run_output["messages"]:
        for call in msg.tool_calls:
            if call.tool_name not in seen:
                ordered.append(call.tool_name)
                seen.add(call.tool_name)
    return ordered
print("Tools invoked →", tools_used(resp))
Ở lần kiểm thử đầu tiên, agent chỉ dùng công cụ rag_search để trả lời câu hỏi.
Tools invoked → ['rag_search']Giờ chúng ta sẽ hỏi về thời tiết ở Islamabad. Thay vì gọi công cụ RAG, agent sẽ dùng công cụ tìm kiếm web để trả lời.
msg = ChatMessage.from_user("What is the temperature in Islamabad now?")
resp = agent.run(messages=[msg])
print(resp["messages"][-1].text)
print("Tools invoked →", tools_used(resp))
Câu trả lời rất chính xác, và nó đã dùng công cụ tìm kiếm web để trả lời câu hỏi.
The current temperature in Islamabad is 31°C with a real-feel temperature of 32°C.
Tools invoked → ['web_search']
Nếu bạn gặp vấn đề khi chạy mã trên, vui lòng tham khảo Datalab Notebook: Haystack AI Tutorial — DataLab.
Chúng ta đã điểm qua những điều cơ bản của framework Haystack AI. Bước tiếp theo trong lộ trình học của bạn là tạo một ứng dụng AI hoạt động đầy đủ. Dưới đây là một số trường hợp sử dụng mà các nhà phát triển đang khám phá:
Từng làm việc với nhiều framework LLM, tôi thấy Haystack là một trong những lựa chọn trực quan và linh hoạt nhất. Việc sử dụng cảm giác tự nhiên hơn, bớt phức tạp và cho bạn nhiều quyền kiểm soát quy trình hơn.
Một điểm nổi bật là dễ dàng tạo component tùy chỉnh cho pipeline, giúp nó thích ứng cao với nhiều trường hợp sử dụng.
Tôi đặc biệt thích thử nghiệm với agent và công cụ, cũng như hiểu cách gọi mỗi công cụ hiệu quả. Làm việc với system prompt giúp tôi nắm được cách dùng công cụ riêng lẻ và theo trình tự.
Hơn nữa, system prompt có thể dễ dàng tùy biến để bao gồm chi tiết bổ sung như hiển thị nguồn và ID tài liệu, điều này có thể quan trọng với ứng dụng của bạn.
Nếu bạn mới bước vào thế giới AI agent, hãy xem các tài nguyên dưới đây để tìm hiểu thêm:
Khóa học nổi bật trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
