

Excel 中置信区间函数概览
在 Microsoft Excel 中,CONFIDENCE 最初是用于返回总体均值的置信区间的函数。然而,该函数已被弃用,并根据用途被两个不同的函数所取代,这些新函数在精确性上更胜一筹。我们必须使用较新的函数,因为旧函数在未来版本的 Excel 中可能不存在。
CONFIDENCE.NORM 函数的语法与参数
CONFIDENCE.NORM 函数用于在假设正态分布的前提下,计算总体均值的置信区间。
\CONFIDENCE.NORM\ 函数的语法如下:
=CONFIDENCE.NORM(alpha, standard_dev, size)其参数为:
- alpha:显著性水平(1 — 置信水平)。例如,对于 95% 置信区间,alpha 为 0.05。
- standard_dev:样本的标准差。
- size:样本量。
CONFIDENCE.T 函数的语法与参数
CONFIDENCE.T 函数用于基于学生t 分布计算总体均值的置信区间。
\CONFIDENCE.T\ 函数的语法为:
=CONFIDENCE.T(alpha, standard_dev, size)其参数为:
- alpha:显著性水平(1 — 置信水平)。
- standard_dev:样本的标准差。
- size:样本量。
何时使用哪一个置信区间函数?
在实践中,如果我们不确定总体分布,或样本量较小,使用 CONFIDENCE.T 会更稳妥。当样本的标准差未知,即需要我们自行计算标准差时,最好使用 CONFIDENCE.T 函数。
通常在以下情况下使用 CONFIDENCE.NORM:
- 样本量较大。
- 已知总体标准差(且不是通过计算得到)。
- 我们有把握总体分布为正态,或正在应用中心极限定理。
这些指引可帮助您更好地判断该用哪一个函数。
既然我们已经了解了在 Excel 中计算置信区间的所有内容,下面用一个示例来动手实践。
如何在 Excel 中计算置信区间:示例
设想这样一个情境:作为数据分析师,您需要估计客户支持团队的平均响应时间(单位:小时)。高级利益相关者希望评估客户支持团队的有效性。
作为分析师,您针对 40 个随机客户咨询收集了响应时间数据。然后将数据在 Excel 表中进行如下汇总(单位:小时):
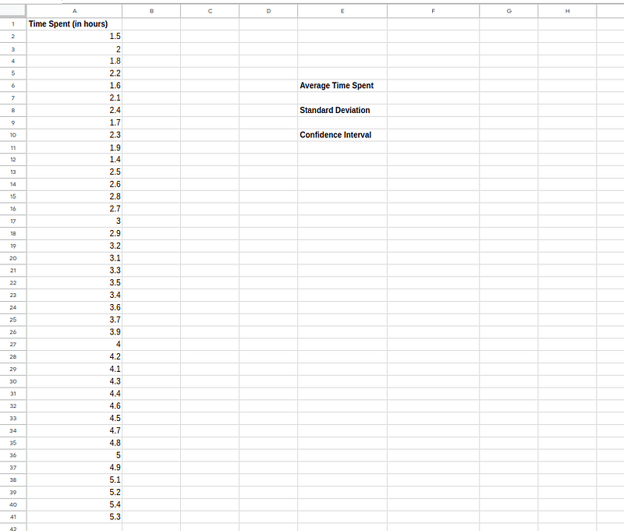
平均响应时间数据(本文及以下所有截图均由作者提供)
我们按步骤求出置信区间:
- 步骤 1:计算样本均值。在新单元格(如 F6)中,使用 AVERAGE 函数计算样本均值。
=AVERAGE(A2:A41)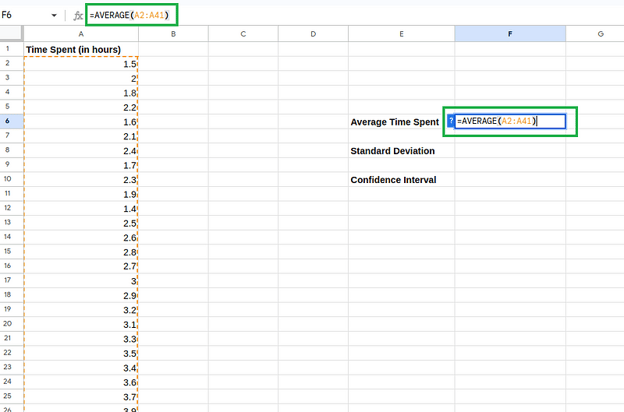 Calculating the sample mean.
- 步骤 2:计算标准差。在单元格 F8 中,使用 STDDEV.S 函数计算样本标准差。
=STDEV.S(A2:A41)之所以使用 STDEV.S(样本标准差)而非 STDEV.P(总体标准差),是因为我们处理的是样本数据(如场景所述),而非整个总体。
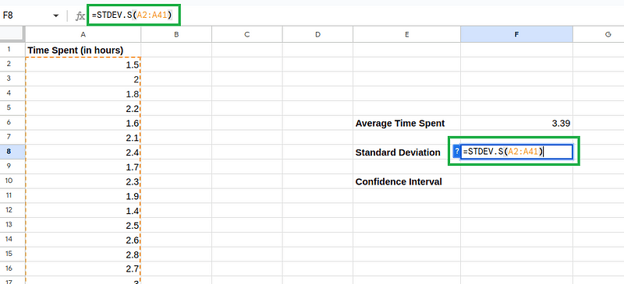
Calculating the sample deviation.
- 步骤 3:计算误差幅度。在单元格 F10 中,使用 CONFIDENCE.T 函数计算 95% 置信区间的误差幅度。
=CONFIDENCE.T(0.05, F8, 40)本示例使用 CONFIDENCE.T 的原因在于,我们在分析前并不知道总体标准差,需要自行进行计算。
我们也没有关于分布为正态的相关信息。因此,CONFIDENCE.T 是最适合本场景的函数。
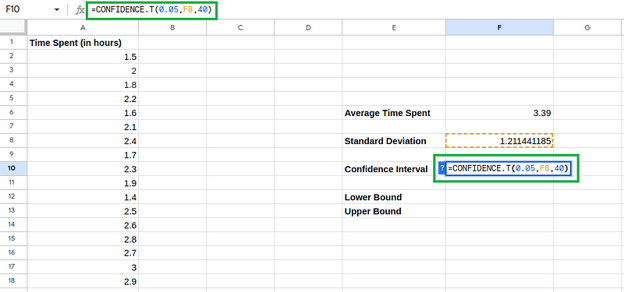
Calculating the margin of error.
- 步骤 4:确定置信区间。最终的置信区间需要分别求出下限与上限。
下限可按以下公式计算:
LOWER BOUND =(SAMPLE MEAN - MARGIN OF ERROR)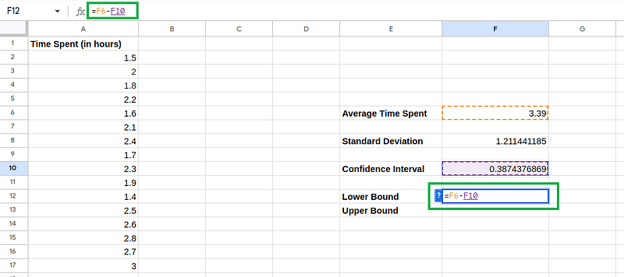
Calculating the upper bound.
同理,上限可按以下公式计算:
UPPER BOUND =(SAMPLE MEAN + MARGIN OF ERROR)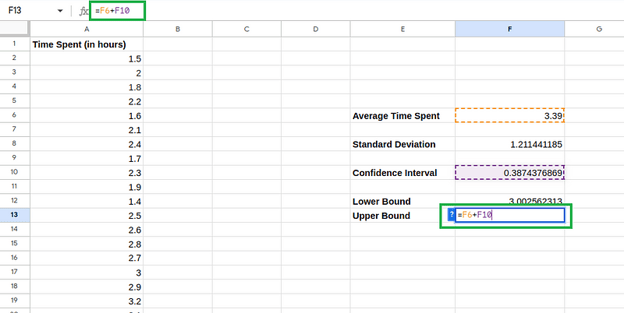
Calculating the lower bound
现在,我们可以报告称,在 95% 的置信水平下,客户支持团队的平均响应时间介于 3.00 小时与 3.77 小时之间,而不仅仅是给出 3.39 小时这一平均值。
该信息有助于管理层评估支持团队的绩效,并就人员配置、培训以及流程改进做出决策,从而更有把握地提升客户满意度。
常见错误及其解决方法
在 Excel 中使用 CONFIDENCE 函数(包括其变体 CONFIDENCE.NORM 和 CONFIDENCE.T)时,您可能会遇到以下典型问题:
#NUM! 错误
Excel 中的 #NUM! 错误表示公式存在数值问题。若出现以下情况会触发该错误:
- 标准差小于或等于零,
- 样本量小于 2,或
- alpha(显著性水平)小于等于 0 或大于等于 1。
标准差为零意味着所有数据点完全相同,这对于计算置信区间没有意义。负的标准差在数学上不可能。如果您使用的是预先计算的标准差,请确保其为正数。
当样本量小于 2 时,无法对总体均值或其变异性做出有意义的估计。因此,请确保输入了正确的样本量。
选择一个大于 0 且小于 1 的 alpha 值。常见选择包括 0.05(对应 95% 置信水平)、0.01(对应 99% 置信水平)等。请记住,alpha 通常较小,因为它是用 100% 减去置信水平后得到的。
#VALUE! 错误
Excel 中的 #VALUE! 错误表示公式中使用的值存在问题。针对置信函数,当提供给函数的任一参数为非数值时会出现该错误。
请检查所有参数(alpha、标准差和样本量)是否为数值;如果引用了单元格,请确认这些单元格内为数值数据。
当然,您遇到的错误也可能不同于上述情况且较为特殊——此时,最好的做法是查阅 Microsoft Answers 论坛中的已解答问题。您也可以在同一论坛发帖以解决您的特定错误。
结语
本教程向您介绍了置信区间的概念及其在数据分析中的重要性。随后,我们了解了 Excel 中可用的 CONFIDENCE 系列函数的语法,并通过一个可能的真实场景,逐步说明了何时使用它们。
这些函数未来可能会更新,因此微软官方文档是您获取信息的最佳来源。
最后,如需系统学习如何利用 Excel 提升数据分析技能,欢迎查看Excel Fundamentals 学习路径,从零基础起步,直至在 Excel 中构建客户流失分析项目。
我们还推荐查看我们的基础 Excel 公式教程以及Excel 公式速查表,便于快速查阅。

作为一名高级数据科学家,我设计、开发并部署大规模机器学习解决方案,帮助企业做出更明智的数据驱动决策。作为数据科学写作者,我分享所学心得、职业建议以及深入的实践型教程。
Microsoft Excel 在商业领域的广泛使用,使其成为清洗、整理和分析数据的最有价值工具之一。借助其内置函数和公式,数据分析师现在可以轻松应用统计技术,甚至用于预测未来趋势并辅助决策。
本教程将向您介绍 Excel 中的一个内置统计函数——CONFIDENCE,提供其变体的语法,并帮助您熟悉其用法。
这份循序渐进的指南包含截图、额外提示和资源,帮助您避免常见错误,提供使用 Excel 计算置信区间所需的一切。
什么是置信区间?
置信区间是在统计学中用于估计样本统计量不确定性的一个取值范围。
它提供了一种方式,来表达基于样本数据得到的估计值的精确度和可靠性。
置信区间通常与置信水平相关联,例如 95% 或 99%。该置信水平表示,如果我们抽取许多样本并以相同方式计算置信区间,那么其中有 95% 或 99% 的区间将包含真实的总体参数(如均值、比例或均值之差)。
例如,一个总体均值的 95% 置信区间可能被计算为 (20, 30)。这意味着我们有 95% 的把握认为总体的真实均值位于 20 到 30 之间。
需要注意的是,这并不意味着真实均值落在该区间内的概率为 95%;而是指如果我们抽取许多样本并用同样的方法计算置信区间,其中 95% 的区间会包含真实均值。
置信区间在数据分析中的重要性
置信区间帮助决策者理解总体参数真实值可能落入的范围,以及与该范围相关联的置信水平,从而为结果的确定性提供更多洞见。
设想这样一个场景:一位数据分析师正在开展调查,以估计人们每天在某社交媒体平台上花费的平均时长。收集了 100 名个体的样本数据后,分析师计算得出平均值为 3 小时,标准差为 1 小时。基于此信息,分析师计算得到平均使用时长的 95% 置信区间为 (2.8, 3.2) 小时。
这个置信区间告诉我们,分析师对整个群体在社交媒体上花费的真实平均时间位于 2.8 到 3.2 小时之间有 95% 的信心。该置信区间的重要性在于它能够量化估计的不确定性。它提供了真实平均值的一组可能取值范围,比单点估计更可靠。
决策者可以据此制定社交媒体相关策略或政策,同时了解对平台平均使用时长估计的信心水平。