如果我们从几乎任何类型的分布中随机抽取大量样本,会发生一件有趣的事。这些样本的平均值会开始呈现出一种正态分布——也就是大家熟悉的钟形曲线。这就是中心极限定理(CLT)的要义。
这在概率与统计中意义重大,因为它意味着即使我们只看小样本,也能对总体做出准确预测并得出结论。
CLT 之所以格外有用,还在于即便原始数据并不服从正态分布,它依然有效。接下来我们将详细探讨,并看看如何计算。
什么是中心极限定理?
中心极限定理(CLT)是统计学中的一个思想:如果我们从任意总体中抽取许多随机样本,并观察这些样本的平均值,那么这些平均值将开始形成一个正态的钟形曲线,即便原始总体看起来一点也不正态。
这与大数定律相关:大数定律告诉我们,随着数据增多,样本平均值会越来越接近总体的真实均值。CLT 更进一步——它告诉我们样本均值不仅更准确,而且这些均值的分布模式是可预测的。如果您想进一步探索,我们的统计学入门课程包含练习,帮助您熟悉 CLT 与大数定律之间的关系与差异。
一个很好的直观例子是掷骰子。若只掷一次,我们会得到 1 到 6 之间的随机数。但在足够多次掷骰后,平均值会稳定在 3.5(公平骰子的真实平均值)附近。重复这一过程,多次计算平均值后,这些平均值的分布会开始看起来像正态曲线。
中心极限定理公式
以下是中心极限定理的基本表达式:
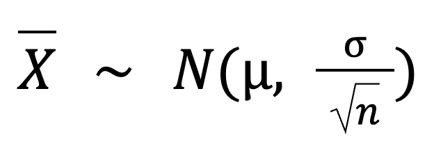
其中:
-
X 是样本均值的抽样分布,它服从正态分布。
-
N 是正态分布。
-
𝜇 是总体均值。
-
σ 是总体标准差。
-
n 是样本容量。
随着样本容量增大,抽样分布的标准差会变小。我们收集的数据越多,样本均值就越会紧密聚集在总体真实均值附近。
中心极限定理的条件
要让中心极限定理按预期发挥作用,需要考虑以下条件:
- 足够大的样本容量:样本容量要足够大。通常认为 n≥30 较为合适。但如果抽样的总体偏态较重或离群值很多,可能需要更大的样本才能显现出漂亮的钟形曲线。
- 独立同分布(i.i.d.)样本:样本需要独立同分布(i.i.d.)。这意味着每个样本是随机抽取且来自同一总体。若不满足,则结果可能不可靠。
- 有限的总体方差:我们抽样的总体必须具有有限方差。如果数据来自方差为无穷的分布(如柯西分布),CLT 不适用。
中心极限定理示例
假设我们想知道一家本地咖啡店每天卖出多少杯咖啡。多年下来看,每天的销量可能类似我这里展示的分布。大多数时候,他们会卖出 80 到 120 杯。但在假日或特殊活动等繁忙日子,会卖到 150 甚至 180 杯。在这种情况下,数据有些偏态(不对称)。
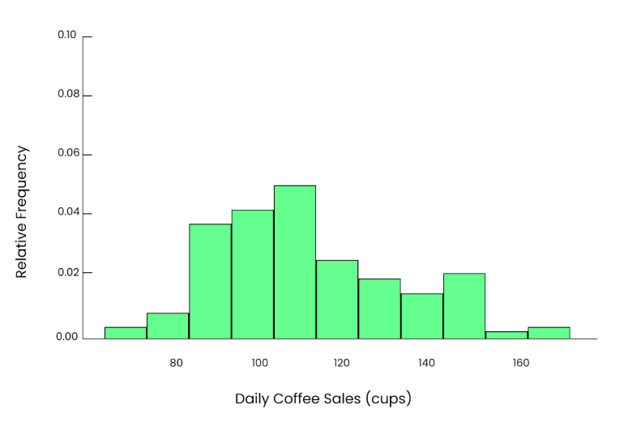
非对称图。图片作者自制。
设我们抽取一个小样本。随机选取一年中的 5 天,查看这些天分别卖了多少杯。
95, 102, 85, 110, 120技术支持
该样本得到的均值为:
Mean = 95+102+85+110+1205 = 102.4 cups技术支持
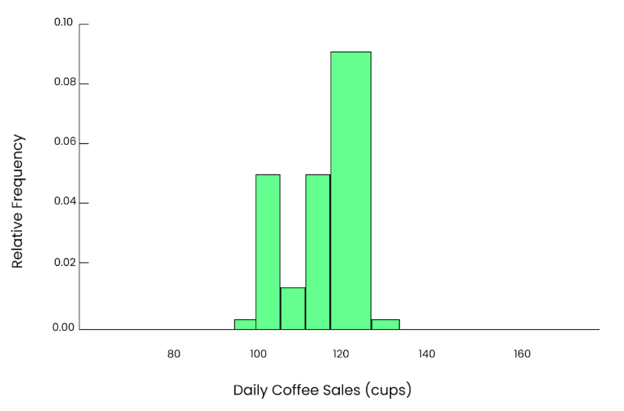
5 次样本图。图片作者自制。
这给出了总体均值的一个估计,但由于样本较小,可能不够精确。如果我们重复这一过程 10 次,每次随机选 5 天、计算均值并记录结果,10 个样本均值如下:
97.6, 105.8, 93.4, 110.2, 99.0, 102.4, 101.2, 107.5, 96.3, 94.1技术支持
如果将这些值绘制成直方图,会看到一个大致的钟形,但仍可能不够平滑。而且这些均值的离散程度小于总体的离散程度。
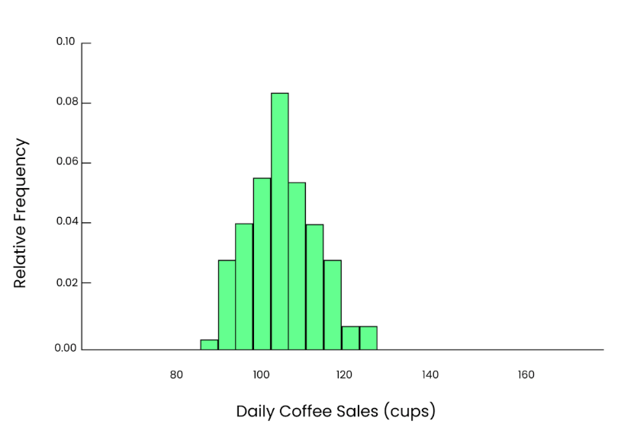
10 次样本图。图片作者自制。
现在,我们取一个更大的样本。这次随机选择 50 天并计算平均销量:
98, 104, 87, 112, 105, 100, 108, 95, 102, 106,
92, 115, 97, 101, 109, 103, 96, 110, 104, 98,
100, 102, 89, 107, 94, 111, 108, 90, 100, 103,
106, 99, 96, 112, 105, 97, 100, 104, 93, 110,
107, 102, 95, 101, 99, 103, 109, 98, 94, 100技术支持
计算该样本的均值,得到:
Mean = 101.2 cups技术支持
这个估计更接近总体均值 100,而且由于样本容量更大,估计也更精确。
如果多次重复这一过程,每次随机选 50 天、计算均值并将这些均值绘制成直方图,即便原始数据是偏态的,我们也会看到一个明显、平滑的钟形曲线。这就是中心极限定理的力量。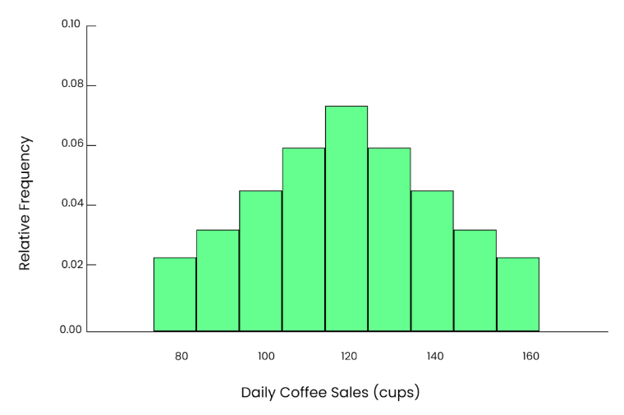
平滑图。图片作者自制。
我们甚至可以用下面的公式计算这种离散程度:
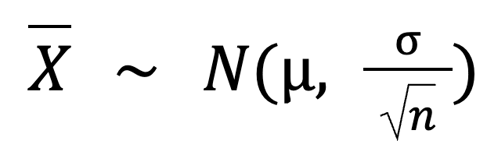 如下:
-
µ(总体均值)= 100
-
σ(总体标准差)= 15
-
n(样本容量)= 50
因此,我们的样本均值的标准差为:
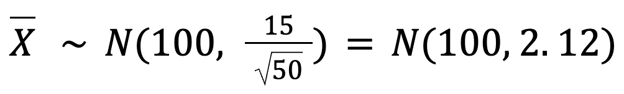
这告诉我们,样本均值将非常接近 100 杯,只会有很小的波动(约 2.12 杯)。
为何中心极限定理重要
现实世界中的数据可能怪异且不可预测。但中心极限定理为我们提供了一种可靠的方法去理解并据此做出更好的决策。下面更详细地看看它的重要性。
统计推断
在统计学中,中心极限定理是参数检验(如t 检验、方差分析(ANOVA)和回归)得以按预期运行的原因。这些检验基于这样一个思想:样本数据来自具有固定特征的总体。
没有中心极限定理,我们就无法信赖这些检验。正因为该定理,参数检验往往比不对数据分布作假设的非参数检验更有力。
行业应用
CLT 也广泛出现在真实业务场景中。在金融领域,分析师用它基于历史表现估计平均股票回报。在民调与问卷中,它通过抽取样本来预测整个总体的情况。在机器学习与大数据中,模型常在样本上训练。例如,一款电影应用可能用一部分用户行为样本来构建推荐系统。
中心极限定理计算器
标准差是一个衡量数值相对平均值分散程度的指标。当我们观察样本均值(不同样本的平均值)时,也希望了解这些平均值的波动幅度。为此可以使用这个公式:
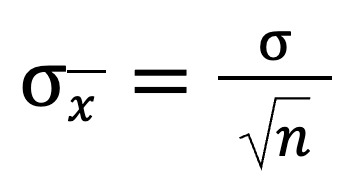
这表明:将总体标准差除以样本容量的平方根,就得到抽样分布的标准差。随着样本容量增大,该值会变小。
来看一个快速示例:
| 样本容量 (n) | 样本均值 (μₓ̄) | 标准差 (σₓ̄) |
|---|
| 5 | 17 | 1.788854 |
| 10 | 17 | 1.264911 |
| 25 | 17 | 0.800000 |
| 50 | 17 | 0.565685 |
| 100 | 17 | 0.400000 |
可以看到,均值保持不变,但标准差不断缩小。这说明样本越大,结果越准确、越稳定。
数据科学中的中心极限定理
在数据科学中,我们通常处理的是样本而非整个总体。CLT 帮助我们理解这些样本结果的行为,并告诉我们:只要取的样本足够多,它们的平均值就会开始呈现正态分布,即便原始数据完全不是正态的。
这在实际中也很有用。在机器学习中,我们常用自助法(Bootstrapping)来估计量。得益于 CLT,我们能更有把握地认为这些估计是准确的。
它也是A/B 测试中的关键角色。当公司尝试网页或功能的两个版本时,CLT 帮助我们判断结果到底有意义还是只是随机噪声。
甚至在强化学习中——系统通过试错进行学习——CLT 也能平滑随机性。随着数据不断积累,平均值会变得更稳定,从而帮助系统学习得更快、更好。
最后,您还会在假设检验与时间序列分析中看到 CLT。它帮助数据科学家更有信心地检验想法与追踪趋势。
结语
如果您是统计新手,中心极限定理可能听起来很技术,但它是我们能聪明地使用数据的重要原因之一。它把随机性变成可以理解和信赖的东西。事实上,它是统计建模的基石之一,也是任何与数据打交道的人必备的知识。
如果您想继续探索,可以阅读大数定律和概率分布——它们彼此关联。


如果我们从几乎任何类型的分布中随机抽取大量样本,会发生一件有趣的事。这些样本的平均值会开始呈现出一种正态分布——也就是大家熟悉的钟形曲线。这就是中心极限定理(CLT)的要义。
这在概率与统计中意义重大,因为它意味着即使我们只看小样本,也能对总体做出准确预测并得出结论。
CLT 之所以格外有用,还在于即便原始数据并不服从正态分布,它依然有效。接下来我们将详细探讨,并看看如何计算。
什么是中心极限定理?
中心极限定理(CLT)是统计学中的一个思想:如果我们从任意总体中抽取许多随机样本,并观察这些样本的平均值,那么这些平均值将开始形成一个正态的钟形曲线,即便原始总体看起来一点也不正态。
这与大数定律相关:大数定律告诉我们,随着数据增多,样本平均值会越来越接近总体的真实均值。CLT 更进一步——它告诉我们样本均值不仅更准确,而且这些均值的分布模式是可预测的。如果您想进一步探索,我们的统计学入门课程包含练习,帮助您熟悉 CLT 与大数定律之间的关系与差异。
一个很好的直观例子是掷骰子。若只掷一次,我们会得到 1 到 6 之间的随机数。但在足够多次掷骰后,平均值会稳定在 3.5(公平骰子的真实平均值)附近。重复这一过程,多次计算平均值后,这些平均值的分布会开始看起来像正态曲线。
中心极限定理公式
以下是中心极限定理的基本表达式:
其中:
X是样本均值的抽样分布,它服从正态分布。N是正态分布。𝜇是总体均值。σ是总体标准差。n是样本容量。随着样本容量增大,抽样分布的标准差会变小。我们收集的数据越多,样本均值就越会紧密聚集在总体真实均值附近。
中心极限定理的条件
要让中心极限定理按预期发挥作用,需要考虑以下条件:
中心极限定理示例
假设我们想知道一家本地咖啡店每天卖出多少杯咖啡。多年下来看,每天的销量可能类似我这里展示的分布。大多数时候,他们会卖出 80 到 120 杯。但在假日或特殊活动等繁忙日子,会卖到 150 甚至 180 杯。在这种情况下,数据有些偏态(不对称)。
非对称图。图片作者自制。
设我们抽取一个小样本。随机选取一年中的 5 天,查看这些天分别卖了多少杯。
该样本得到的均值为:
5 次样本图。图片作者自制。
这给出了总体均值的一个估计,但由于样本较小,可能不够精确。如果我们重复这一过程 10 次,每次随机选 5 天、计算均值并记录结果,10 个样本均值如下:
如果将这些值绘制成直方图,会看到一个大致的钟形,但仍可能不够平滑。而且这些均值的离散程度小于总体的离散程度。
10 次样本图。图片作者自制。
现在,我们取一个更大的样本。这次随机选择 50 天并计算平均销量:
计算该样本的均值,得到:
这个估计更接近总体均值 100,而且由于样本容量更大,估计也更精确。
如果多次重复这一过程,每次随机选 50 天、计算均值并将这些均值绘制成直方图,即便原始数据是偏态的,我们也会看到一个明显、平滑的钟形曲线。这就是中心极限定理的力量。
平滑图。图片作者自制。
我们甚至可以用下面的公式计算这种离散程度:
µ(总体均值)= 100σ(总体标准差)= 15n(样本容量)= 50因此,我们的样本均值的标准差为:
这告诉我们,样本均值将非常接近 100 杯,只会有很小的波动(约 2.12 杯)。
为何中心极限定理重要
现实世界中的数据可能怪异且不可预测。但中心极限定理为我们提供了一种可靠的方法去理解并据此做出更好的决策。下面更详细地看看它的重要性。
统计推断
在统计学中,中心极限定理是参数检验(如t 检验、方差分析(ANOVA)和回归)得以按预期运行的原因。这些检验基于这样一个思想:样本数据来自具有固定特征的总体。
没有中心极限定理,我们就无法信赖这些检验。正因为该定理,参数检验往往比不对数据分布作假设的非参数检验更有力。
行业应用
CLT 也广泛出现在真实业务场景中。在金融领域,分析师用它基于历史表现估计平均股票回报。在民调与问卷中,它通过抽取样本来预测整个总体的情况。在机器学习与大数据中,模型常在样本上训练。例如,一款电影应用可能用一部分用户行为样本来构建推荐系统。
中心极限定理计算器
标准差是一个衡量数值相对平均值分散程度的指标。当我们观察样本均值(不同样本的平均值)时,也希望了解这些平均值的波动幅度。为此可以使用这个公式:
这表明:将总体标准差除以样本容量的平方根,就得到抽样分布的标准差。随着样本容量增大,该值会变小。
来看一个快速示例:
可以看到,均值保持不变,但标准差不断缩小。这说明样本越大,结果越准确、越稳定。
数据科学中的中心极限定理
在数据科学中,我们通常处理的是样本而非整个总体。CLT 帮助我们理解这些样本结果的行为,并告诉我们:只要取的样本足够多,它们的平均值就会开始呈现正态分布,即便原始数据完全不是正态的。
这在实际中也很有用。在机器学习中,我们常用自助法(Bootstrapping)来估计量。得益于 CLT,我们能更有把握地认为这些估计是准确的。
它也是A/B 测试中的关键角色。当公司尝试网页或功能的两个版本时,CLT 帮助我们判断结果到底有意义还是只是随机噪声。
甚至在强化学习中——系统通过试错进行学习——CLT 也能平滑随机性。随着数据不断积累,平均值会变得更稳定,从而帮助系统学习得更快、更好。
最后,您还会在假设检验与时间序列分析中看到 CLT。它帮助数据科学家更有信心地检验想法与追踪趋势。
结语
如果您是统计新手,中心极限定理可能听起来很技术,但它是我们能聪明地使用数据的重要原因之一。它把随机性变成可以理解和信赖的东西。事实上,它是统计建模的基石之一,也是任何与数据打交道的人必备的知识。
如果您想继续探索,可以阅读大数定律和概率分布——它们彼此关联。