

Excel में Confidence Interval फ़ंक्शन का अवलोकन
Microsoft Excel में, CONFIDENCE मूल रूप से वह फ़ंक्शन था जो जनसंख्या औसत के लिए confidence interval लौटाता है। हालाँकि, इस फ़ंक्शन को अप्रचलित घोषित कर दिया गया है और इसे उद्देश्य के अनुसार अधिक सटीक दो अलग-अलग फ़ंक्शंस से बदल दिया गया है। हमें नए फ़ंक्शंस का उपयोग करना चाहिए क्योंकि पुराना फ़ंक्शन Excel के भविष्य के संस्करणों में हो भी न सकता है।
CONFIDENCE.NORM फ़ंक्शन का सिंटैक्स और पैरामीटर्स
CONFIDENCE.NORM फ़ंक्शन Excel में जनसंख्या औसत के लिए confidence interval की गणना करने के लिए उपयोग होता है, यह मानते हुए कि सामान्य वितरण है।
CONFIDENCE.NORM फ़ंक्शन का सिंटैक्स इस प्रकार है:
=CONFIDENCE.NORM(alpha, standard_dev, size)पैरामीटर्स इस प्रकार हैं:
- alpha: सिग्निफिकेंस स्तर (1 — confidence level)। उदाहरण के लिए, 95% confidence interval के लिए alpha 0.05 होगा।
- standard_dev: सैंपल का मानक विचलन।
- size: सैंपल का आकार।
CONFIDENCE.T फ़ंक्शन का सिंटैक्स और पैरामीटर्स
CONFIDENCE.T फ़ंक्शन Excel में जनसंख्या औसत के लिए confidence interval की गणना करने हेतु डिज़ाइन किया गया है, जिसमें छात्र की t-वितरण का उपयोग होता है।
CONFIDENCE.T फ़ंक्शन का सिंटैक्स है:
=CONFIDENCE.T(alpha, standard_dev, size)पैरामीटर्स इस प्रकार हैं:
- alpha: सिग्निफिकेंस स्तर (1 — confidence level)।
- standard_dev: सैंपल का मानक विचलन।
- size: सैंपल का आकार।
कौन-सा confidence interval फ़ंक्शन कब उपयोग करें?
व्यवहार में, यदि हमें अपनी जनसंख्या के वितरण के बारे में निश्चितता नहीं है या हमारा सैंपल आकार छोटा है, तो CONFIDENCE.T फ़ंक्शन का उपयोग करना अधिक सुरक्षित है। जब सैंपल का मानक विचलन ज्ञात नहीं है, यानी हमें स्वयं मानक विचलन निकालना पड़ता है, तो CONFIDENCE.T का उपयोग सर्वोत्तम है।
हम प्रायः CONFIDENCE.NORM फ़ंक्शन का उपयोग तब करते हैं जब:
- हमारा सैंपल आकार बड़ा हो।
- जनसंख्या का मानक विचलन ज्ञात हो (गणना करके न निकाला गया हो)।
- हमें यह विश्वास हो कि जनसंख्या का वितरण सामान्य है, या हम केन्द्रीय सीमा प्रमेय लागू कर रहे हों।
ये दिशानिर्देश आपको यह तय करने में बेहतर समझ देंगे कि किस स्थिति में कौन-सा फ़ंक्शन उपयोग करना है।
अब जब हमने Excel में confidence intervals की गणना के बारे में सब कुछ सीख लिया है, तो इसे एक उदाहरण के माध्यम से व्यवहार में लागू करते हैं।
Excel में Confidence Intervals कैसे गणना करें: एक उदाहरण
मान लीजिए, एक डेटा विश्लेषक के रूप में, आपको किसी ग्राहक सहायता टीम के औसत प्रतिक्रिया समय (घंटों में) का अनुमान लगाने का कार्य सौंपा गया है। वरिष्ठ हितधारक ग्राहक सहायता टीम की प्रभावशीलता का आकलन करना चाहते हैं।
विश्लेषक के रूप में, आप 40 यादृच्छिक ग्राहक प्रश्नों के प्रतिक्रिया समय का डेटा एकत्र करते हैं। फिर आप Excel शीट में डेटा को नीचे दिए अनुसार (घंटों में) दर्ज करते हैं:
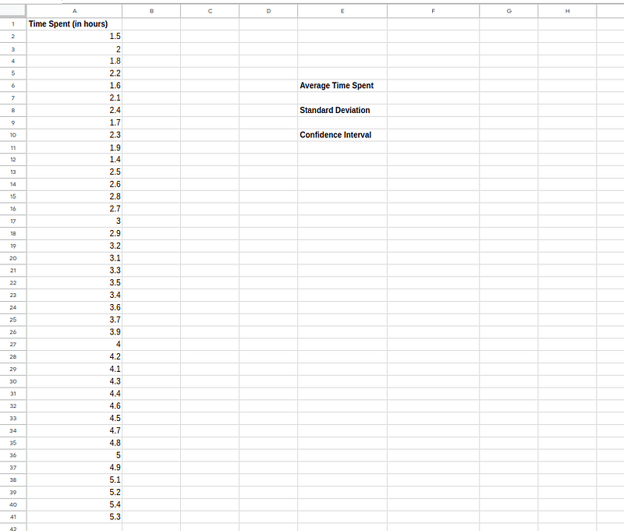
औसत प्रतिक्रिया समय डेटा (यह और आगे के सभी स्क्रीनशॉट लेखक द्वारा)
आइए चरण-दर-चरण confidence interval निकालते हैं:
- चरण 1: सैंपल औसत की गणना। एक नई सेल में, मान लीजिए F6, सैंपल औसत निकालने के लिए AVERAGE फ़ंक्शन का उपयोग करें।
=AVERAGE(A2:A41)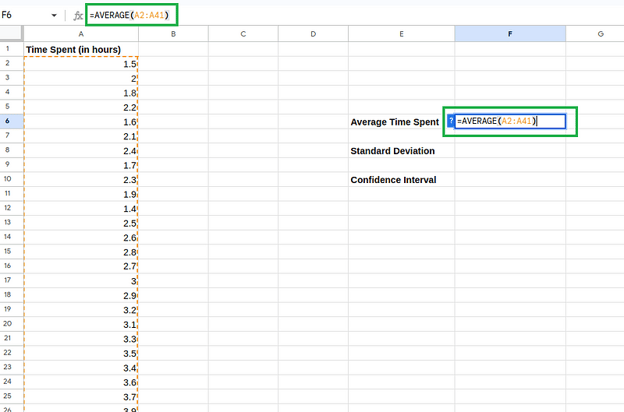 सैंपल औसत की गणना।
- चरण 2: मानक विचलन की गणना। मान लीजिए सेल F8 में, सैंपल मानक विचलन निकालने के लिए STDDEV.S फ़ंक्शन का उपयोग करें।
=STDEV.S(A2:A41)STDEV.S (सैंपल मानक विचलन) का उपयोग STDEV.P (जनसंख्या मानक विचलन) के बजाय इसलिए किया जाता है क्योंकि हम परिदृश्य के अनुसार संपूर्ण जनसंख्या नहीं, बल्कि सैंपल डेटा के साथ काम कर रहे हैं।
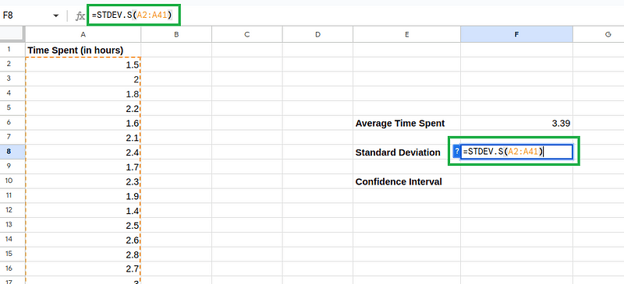
सैंपल विचलन की गणना।
- चरण 3: त्रुटि मार्जिन की गणना। मान लीजिए, सेल F10 में, 95% confidence interval के लिए त्रुटि मार्जिन निकालने हेतु CONFIDENCE.T फ़ंक्शन का उपयोग करें।
=CONFIDENCE.T(0.05, F8, 40)इस उदाहरण में CONFIDENCE.T फ़ंक्शन का उपयोग इसलिए किया गया है क्योंकि विश्लेषण से पहले हमें जनसंख्या का मानक विचलन ज्ञात नहीं था और हमें स्वयं इसकी गणना करनी पड़ी।
हमें यह जानकारी भी नहीं है कि वितरण सामान्य है। इसलिए, हमारे परिदृश्य के लिए CONFIDENCE.T सबसे उपयुक्त फ़ंक्शन है।
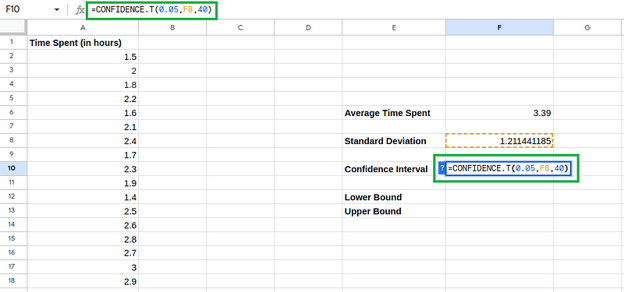
त्रुटि मार्जिन की गणना।
- चरण 4: Confidence interval निर्धारित करें। अंतिम confidence interval में निम्न सीमा और उच्च सीमा निकालना शामिल है।
निम्न सीमा इस प्रकार निकाली जा सकती है:
LOWER BOUND =(SAMPLE MEAN - MARGIN OF ERROR)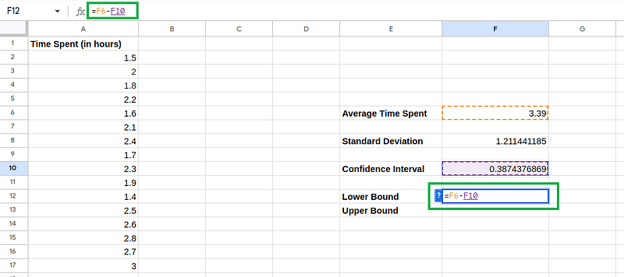
उच्च सीमा की गणना।
इसी प्रकार, उच्च सीमा इस प्रकार निकाली जा सकती है:
UPPER BOUND =(SAMPLE MEAN + MARGIN OF ERROR)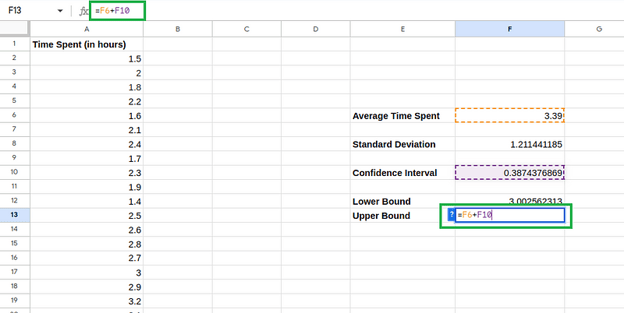
निम्न सीमा की गणना
अब, हम यह रिपोर्ट कर सकते हैं कि 95% विश्वास के साथ, ग्राहक सहायता टीम का औसत प्रतिक्रिया समय 3.00 घंटे और 3.77 घंटे के बीच है, बजाय केवल औसत मान 3.39 घंटे बताने के।
यह जानकारी प्रबंधन के लिए सहायता टीम के प्रदर्शन का आकलन करने और स्टाफिंग, प्रशिक्षण, तथा प्रक्रिया सुधारों से जुड़े निर्णय अधिक विश्वास के साथ लेने में सहायक है, जिससे ग्राहक संतुष्टि बढ़ाई जा सके।
आम त्रुटियाँ और उन्हें कैसे ठीक करें
Excel में CONFIDENCE फ़ंक्शन का उपयोग करते समय, इसके प्रकार CONFIDENCE.NORM और CONFIDENCE.T सहित, आपको निम्नलिखित सामान्य समस्याएँ मिल सकती हैं:
#NUM! त्रुटि
Excel में #NUM! त्रुटि फ़ॉर्मूला में किसी संख्यात्मक समस्या को दर्शाती है। यह त्रुटि तब आती है यदि:
- मानक विचलन शून्य से कम या बराबर हो,
- सैंपल का आकार 2 से कम हो, या
- alpha (सिग्निफिकेंस स्तर) शून्य से कम या बराबर हो या एक से अधिक या बराबर हो।
शून्य मानक विचलन का अर्थ है कि सभी डेटा बिंदु समान हैं, जो confidence interval की गणना के लिए सार्थक नहीं है। नकारात्मक मानक विचलन गणितीय रूप से असंभव है। यदि आप पहले से गणना किए गए मानक विचलन का उपयोग कर रहे हैं, तो सुनिश्चित करें कि वह धनात्मक संख्या है।
सैंपल आकार 2 से कम होने पर, जनसंख्या औसत या उसकी परिवर्तनशीलता का सार्थक अनुमान निकालना संभव नहीं है। इसलिए, सुनिश्चित करें कि आप सही सैंपल आकार दर्ज कर रहे हैं।
ऐसा alpha मान चुनें जो 0 से बड़ा और 1 से छोटा हो। सामान्य विकल्प 95% confidence level के लिए 0.05, 99% के लिए 0.01 आदि हैं। याद रखें कि alpha आम तौर पर छोटा मान होता है क्योंकि यह 100% में से confidence level घटाने के बाद प्राप्त होता है।
#VALUE! त्रुटि
Excel में #VALUE! त्रुटि यह संकेत देती है कि फ़ॉर्मूला में उपयोग किए जा रहे मानों में समस्या है। Confidence फ़ंक्शन के संदर्भ में, यह त्रुटि तब आती है जब फ़ंक्शन को दिए गए किसी भी तर्क (argument) का प्रकार संख्यात्मक नहीं होता।
सुनिश्चित करें कि सभी तर्क (alpha, मानक विचलन, और सैंपल आकार) संख्यात्मक मान हैं, और यदि आप सेल संदर्भों का उपयोग कर रहे हैं, तो यह भी देखें कि उन सेल्स में संख्यात्मक डेटा हो।
बेशक, आपको मिलने वाली त्रुटि उपरोक्त से भिन्न और विशिष्ट हो सकती है—ऐसे में, सबसे अच्छा विकल्प Microsoft Answers फ़ोरम में हल किए गए प्रश्नों को देखना है। आप इसी फ़ोरम में अपने विशिष्ट त्रुटियों को सुलझाने के लिए प्रश्न भी पूछ सकते हैं।
निष्कर्ष
इस ट्यूटोरियल ने आपको confidence intervals की अवधारणा और डेटा एनालिटिक्स में उनके महत्व से परिचित कराया। इसके बाद, हमने Excel में उपलब्ध CONFIDENCE फ़ंक्शंस का सिंटैक्स समझा और एक संभावित वास्तविक-जीवन परिदृश्य के चरण-दर-चरण मार्गदर्शन के माध्यम से यह देखा कि इन्हें कब उपयोग करना है।
भविष्य में फ़ंक्शंस अपडेट हो सकते हैं, इसलिए जानकारी का आपका सर्वोत्तम स्रोत आधिकारिक Microsoft दस्तावेज़ हैं।
अंत में, डेटा एनालिटिकल कौशल के लिए Excel का लाभ उठाने पर समग्र सीखने हेतु Excel Fundamentals ट्रैक देखें, जहाँ आप एकदम शुरुआत से लेकर Excel में अपना स्वयं का customer churn analytics प्रोजेक्ट बनाने तक जाएँगे।
हम अनुशंसा करते हैं कि आप हमारे बेसिक Excel फ़ॉर्मूला पर ट्यूटोरियल और हमारे Excel फ़ॉर्मूला चीट शीट को त्वरित संदर्भ के लिए देखें।

एक वरिष्ठ डेटा वैज्ञानिक के रूप में, मैं बड़े पैमाने पर मशीन‑लर्निंग समाधान डिज़ाइन, विकसित और परिनियोजित करता/करती हूँ ताकि व्यवसाय बेहतर डेटा‑आधारित निर्णय ले सकें। डेटा साइंस लेखक के रूप में, मैं अपने सीख, करियर सलाह, और गहन व्यावहारिक ट्यूटोरियल साझा करता/करती हूँ।
व्यापार जगत में Microsoft Excel का व्यापक उपयोग इसे डेटा को साफ़ करने, व्यवस्थित करने और विश्लेषण करने के लिए आपके सबसे मूल्यवान टूल्स में से एक बनाता है। इसकी बिल्ट-इन फ़ंक्शंस और फ़ॉर्मूला की मदद से, डेटा विश्लेषक अब सांख्यिकीय तकनीकों को आसानी से लागू कर सकते हैं—यहाँ तक कि भविष्य के रुझानों का अनुमान लगाने और निर्णय लेने में सहायता के लिए भी।
यह ट्यूटोरियल आपको Excel के ऐसे ही एक बिल्ट-इन सांख्यिकीय फ़ंक्शन—CONFIDENCE—से परिचित कराएगा, इसके प्रकारों का सिंटैक्स बताएगा, और इसके उपयोग से आपको परिचित करवाएगा।
यह चरण-दर-चरण मार्गदर्शिका स्क्रीनशॉट्स और अतिरिक्त सुझावों व संसाधनों के साथ आती है ताकि सामान्य त्रुटियों से बचा जा सके, और Excel का उपयोग करके confidence intervals की गणना सीखने के लिए आपको आवश्यक सब कुछ प्रदान करती है।
Confidence Intervals क्या हैं?
Confidence intervals सांख्यिकी में मानों की एक रेंज होती है, जिसका उपयोग किसी सैंपल सांख्यिकीय मान के आसपास की अनिश्चितता का अनुमान लगाने के लिए किया जाता है।
ये सैंपल डेटा से प्राप्त अनुमान की सटीकता और विश्वसनीयता व्यक्त करने का एक तरीका प्रदान करते हैं।
Confidence intervals आमतौर पर किसी confidence level, जैसे 95% या 99%, से जुड़े होते हैं। यह confidence level यह दर्शाता है कि यदि हम कई सैंपल लें और इसी प्रकार confidence intervals की गणना करें, तो इनमे से 95% या 99% इंटरवल्स वास्तविक जनसंख्या पैरामीटर (जैसे औसत, अनुपात, या औसतों के बीच का अंतर) को समाहित करेंगे।
उदाहरण के लिए, किसी जनसंख्या के औसत के लिए 95% confidence interval (20, 30) हो सकता है। इसका अर्थ है कि हमें 95% विश्वास है कि जनसंख्या का वास्तविक औसत 20 और 30 के बीच है।
यह ध्यान रखना महत्वपूर्ण है कि इसका यह अर्थ नहीं है कि वास्तविक औसत के इस इंटरवल में होने की 95% प्रायिकता है; बल्कि इसका मतलब यह है कि यदि हम कई सैंपल लें और उसी तरीके से confidence intervals की गणना करें, तो उनमें से 95% इंटरवल्स में वास्तविक औसत होगा।
डेटा एनालिटिक्स में Confidence Intervals का महत्व
Confidence intervals निर्णय-निर्माताओं को यह समझने में मदद करते हैं कि जनसंख्या पैरामीटर का वास्तविक मान किस रेंज में होने की संभावना है, और इस रेंज से जुड़ा confidence level क्या है—इस प्रकार परिणामों की निश्चितता के स्तर पर अतिरिक्त अंतर्दृष्टियाँ मिलती हैं।
मान लीजिए एक डेटा विश्लेषक यह अनुमान लगाने के लिए सर्वे कर रहा है कि लोग रोज़ाना किसी सोशल मीडिया प्लेटफ़ॉर्म पर औसतन कितने घंटे बिताते हैं। 100 व्यक्तियों के सैंपल से डेटा एकत्र करने के बाद, विश्लेषक औसत 3 घंटे और मानक विचलन 1 घंटा निकालता/निकालती है। इस जानकारी का उपयोग करते हुए, विश्लेषक 95% confidence interval की गणना करता/करती है, जो (2.8, 3.2) घंटे निकलता है।
यह confidence interval बताता है कि विश्लेषक को 95% विश्वास है कि पूरी जनसंख्या द्वारा सोशल मीडिया पर बिताए जाने वाले औसत समय का वास्तविक मान 2.8 और 3.2 घंटों के बीच है। इस confidence interval का महत्व इस बात में है कि यह अनुमान में मौजूद अनिश्चितता को परिमाणित करता है। यह वास्तविक औसत के संभावित मानों की एक रेंज प्रदान करता है, जो किसी एकल-बिंदु अनुमान की तुलना में अधिक विश्वसनीय समझ देता है।
निर्णय-निर्माता इस जानकारी का उपयोग सोशल मीडिया रणनीतियाँ या नीतियाँ विकसित करने के लिए कर सकते हैं, यह जानते हुए कि प्लेटफ़ॉर्म पर बिताए गए अनुमानित औसत समय के संबंध में उनका confidence स्तर क्या है।