
课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
11.1K
Kimi K2.7 Code 是 Moonshot 的旗舰级编码模型,专为实用型软件开发任务打造,例如编写与调试代码、导航大型代码库以及处理多步骤工程工作。
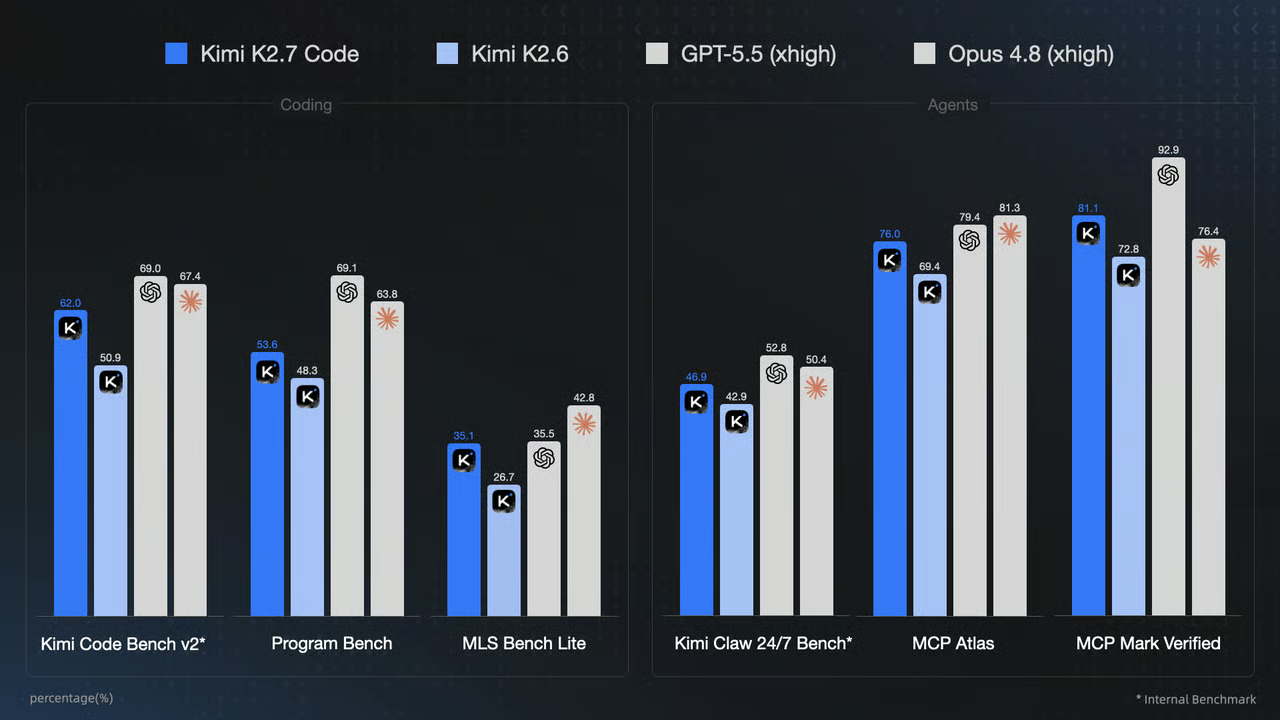
搭配 Pi——一款轻量且高度可扩展的编码代理,您可以构建灵活的本地开发环境,在不增加不必要复杂度的前提下,支持技能、软件包、命令行工具、持久化记忆和浏览器测试。
相比为每项任务都安装MCP,Pi 可以将 Kimi 的推理与 GitHub CLI、Vercel CLI、Hugging Face CLI、pytest、Ruff 和 uv 等可靠开发者工具结合起来。
这样一来,便可通过单一的编码代理工作流完成研究、构建、测试、部署和维护真实项目。
在本指南中,我将从头到尾演示如何将 Kimi K2.7 Code 与 Pi 进行配置。
您将配置 Moonshot API 密钥,添加用于研究的 Olostep、用于最新文档的 Context7、用于浏览器测试的 Webwright,以及用于跨会话上下文的 Hermes Memory。
您还将安装实用主题和工程技能,连接 GitHub、Vercel 和 Hugging Face 的 CLI,创建可复现的 Python 数据科学项目,并通过构建、验证和发布一个小型机器学习应用来测试完整流程。
我也建议查看我的本地运行 Kimi K2.7 Code 的指南。
Pi 是一款直接在您的终端中运行的轻量级编码代理。
它可以处理本地文件、运行命令、使用已安装的技能与软件包,并连接到您偏好的编码模型。
根据您的操作系统选择安装命令。
Windows PowerShell
powershell -c "irm https://pi.dev/install.ps1 | iex"macOS 或 Linux
curl -fsSL https://pi.dev/install.sh | sh您也可以通过 npm 安装 Pi:
npm install -g --ignore-scripts @earendil-works/pi-coding-agent在 Pi 中使用 Kimi K2.7 Code 之前,请将您的 Moonshot API 密钥添加为环境变量。
随后,当您选择 Moonshot 作为模型提供方时,Pi 会自动访问该密钥。
Windows PowerShell
setx MOONSHOT_API_KEY "your_moonshot_api_key"运行此命令后请关闭并重新打开 PowerShell。新的环境变量只会在新开启的终端会话中可用。
Git Bash、macOS 或 Linux
export MOONSHOT_API_KEY="your_moonshot_api_key"该命令仅对当前终端会话生效。若想在重启终端后仍可使用,请将同一行添加到您的 shell 配置文件,例如 ~/.bashrc 或 ~/.zshrc。
请妥善保管您的 API 密钥。不要将其添加到 Git 仓库、公开笔记本、截图、.env.example 文件或 AGENTS.md 中。
设置好密钥后,启动 Pi:
pi然后打开模型选择器:
/model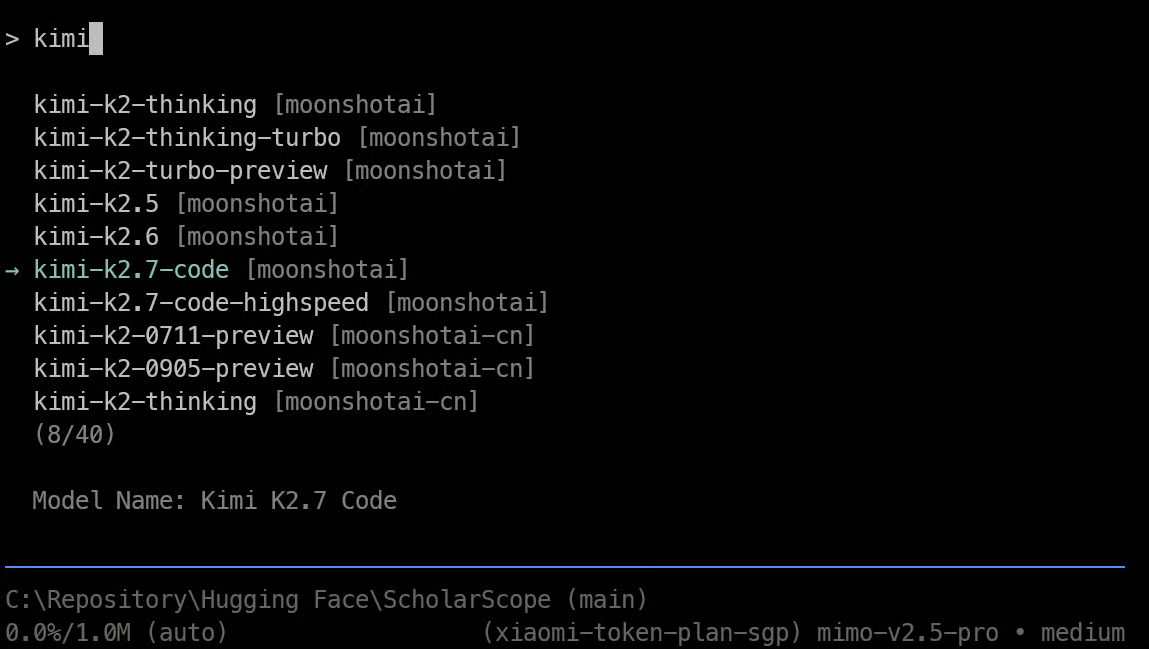
选择 moonshotai 作为提供方,并选择 kimi-k2.7-code。
Pi 应会自动检测 MOONSHOT_API_KEY 环境变量并用于认证。
Olostep 为 Pi 提供网页搜索、抓取、文档爬取、调试和结构化数据抽取等研究流程的访问能力。
当任务需要超出模型内置知识的信息时,它可帮助 Pi 获取最新资料。
继续之前,请创建Olostep 账户,生成 API 密钥,并在本地保存为名为 OLOSTEP_API_KEY 的环境变量。
这样 Pi 及其创建的任何脚本都可在不把密钥存入项目文件的情况下与 Olostep 进行认证。
接着,将 Olostep 技能直接安装到 Pi 的全局技能目录:
npx -y olostep-cli@latest add skills \
 --no-global \
 --agent-skills-dir ~/.pi/agent/skills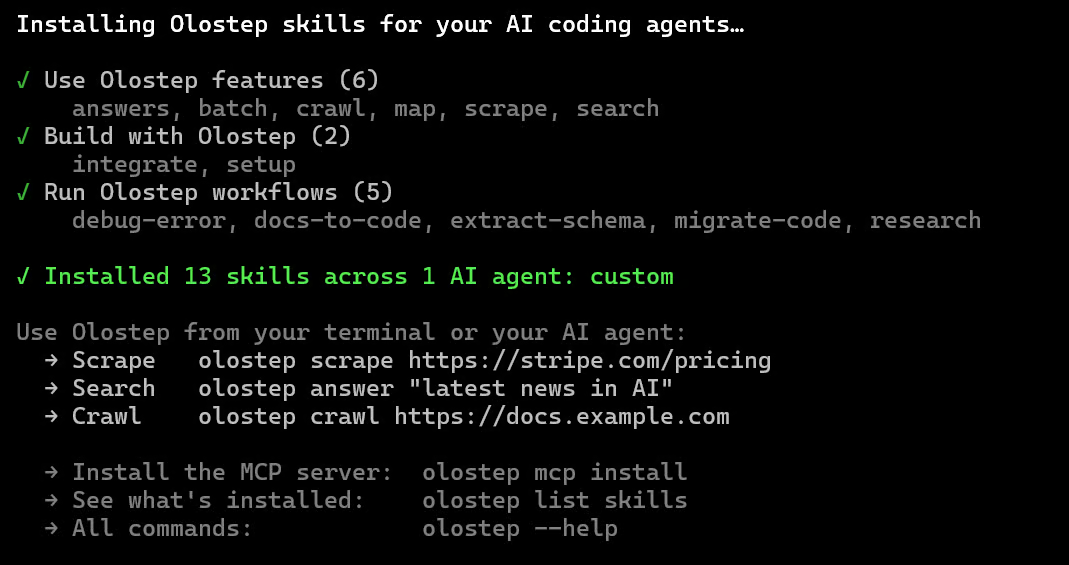
它会将 Olostep 技能安装到:
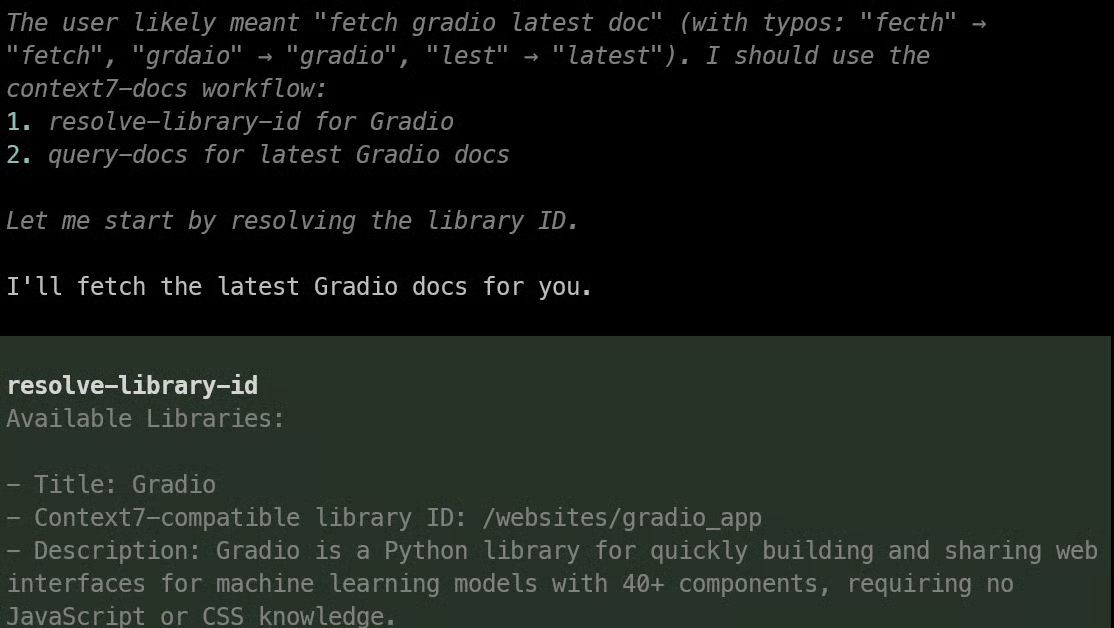
~/.pi/agent/skills/Context7 为 Pi 提供最新的、特定版本的库文档与代码示例。这有助于 Pi 在处理快速演进的框架、SDK 和 Python 包时避免使用过时 API。
安装前,请创建 Context7 账户,在 Context7 控制台生成 API 密钥,并在本地保存为名为 CONTEXT7_API_KEY 的环境变量。
请妥善保管密钥,不要将其提交到代码仓库,也不要包含在截图、笔记本或项目说明文件中。
为 Pi 安装官方 Context7 包:
pi install npm:@upstash/context7-pi这会添加 Context7 文档工具、一个在需要时引导 Pi 使用这些工具的技能,以及用于手动查询的 /c7-docs 命令。
重启 Pi 后,它可以在编写依赖外部库的代码前检索相关文档。
Pi 支持第三方主题包,方便在不改变代理行为的前提下改进终端界面。
@spences10/pi-themes 包含多款精致的暗色主题,包括 Catppuccin Mocha、Dracula、Gruvbox Dark、Nord、One Dark 和 Tokyo Night。
安装社区主题包:
pi install npm:@spences10/pi-themes然后打开 Pi:
pi打开设置菜单:
/settings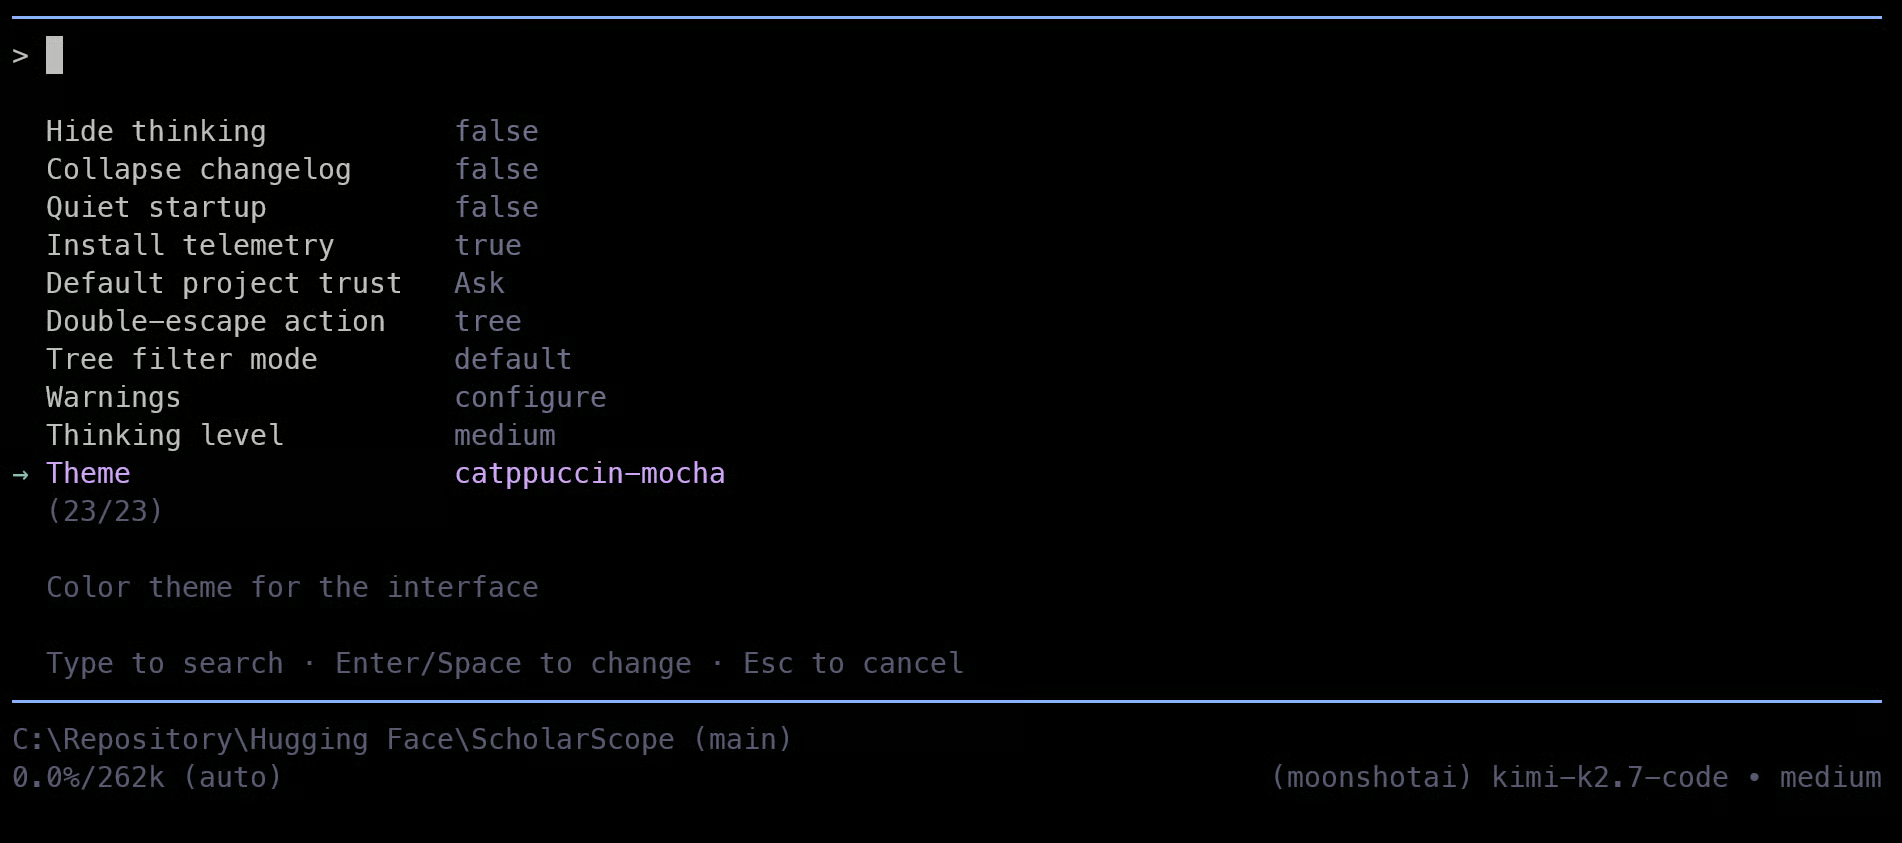
在可用主题中选择Catppuccin Mocha。该主题为清爽的暗色风格,对比强烈,适合作为长时间编码的默认选项。
您可随时通过 /settings 切换主题。Pi 也支持本地主题和基于包的主题,因此日后可以在不改变模型、工具或项目设置的前提下定制界面。
Pi 可通过可复用的工程工作流进行扩展,使其在规划、调试、测试、代码审查、文档编写以及交接或发布准备等方面更一致。
@barlevalon/skills 包为这些常见的软件工程任务提供可移植的 SKILL.md 工作流。
安装该技能包:
pi install npm:@barlevalon/skills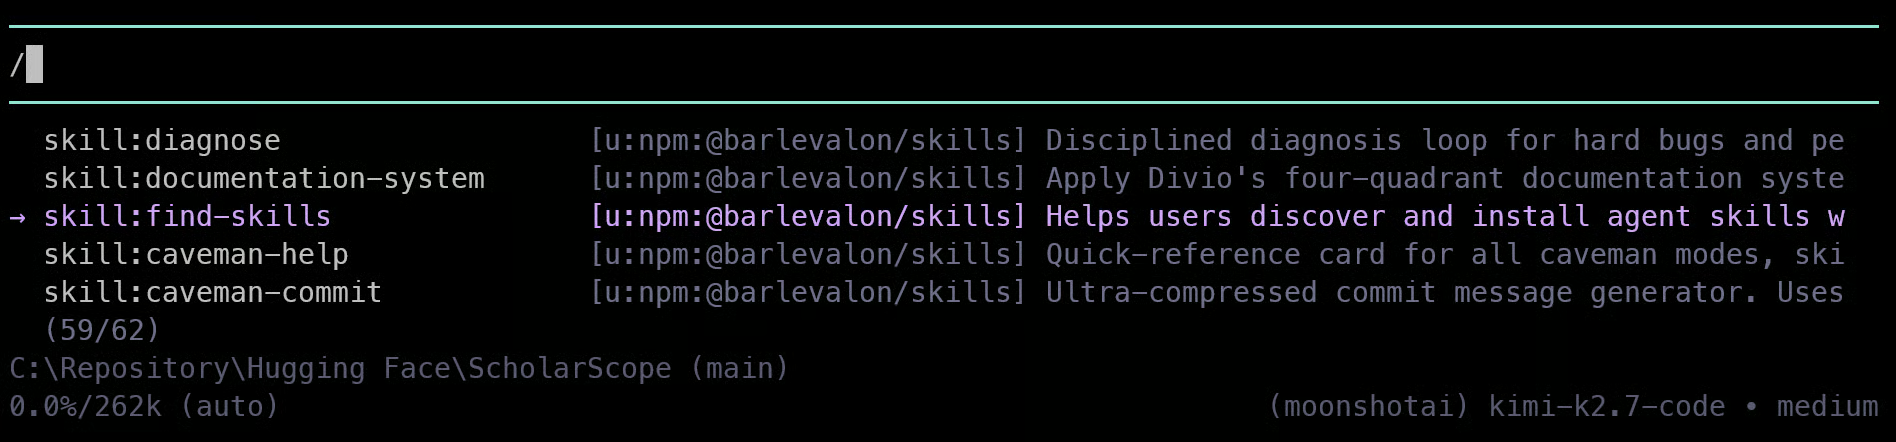
接下来安装 Hypa,防止冗长的终端输出占据 Pi 的上下文窗口:
pi install npm:@hypabolic/pi-hypaHypa 会通过本地压缩层自动重写受支持的 shell 命令。它保留关键信息(如错误和最终结果),同时减少软件包安装、测试套件、模型运行、构建与部署中的重复日志。
该 Pi 包也会将 Hypa 作为依赖安装,并创建尽力而为的本地 hypa 命令 shim。
您不必为每个服务都使用 MCP、扩展或软件包。
对于管理仓库、部署应用、查看日志或发布模型等常见工作流,经认证的命令行工具往往更简单、更可靠,也更便于 Pi 使用。
GitHub CLI 让 Pi 可直接在终端中操作仓库、拉取请求、议题、发布和 GitHub Actions。Windows 上的安装命令:
winget install --id GitHub.cli --source winget然后登录:
gh auth login当您希望 Pi 检查仓库、创建或审查拉取请求、查看工作流运行、管理议题,或将项目发布到 GitHub 时,请使用 GitHub CLI。
Vercel CLI 让 Pi 能从终端部署 Web 应用、检查项目、查看部署日志并管理环境变量。
npm install -g vercel
vercel login
使用 Vercel CLI 进行预览部署、生产发布、部署排障、项目关联以及环境变量检查。
当前 Hugging Face 命令行工具为 hf,随 huggingface_hub 包提供。通过以下方式安装:
pip install -U huggingface_hub然后进行认证:
hf auth login使用 Hugging Face CLI 创建和管理模型、数据集与 Space 仓库;上传项目文件;下载模型或数据集;并确认当前认证账户。
单元测试有助于检查 Python 逻辑,但它无法显示真实用户是否能顺利使用您的应用。
Webwright 允许 Pi 使用 Playwright 针对本地或已部署的应用运行基于浏览器的测试,包括 Streamlit、Gradio、FastAPI 前端、React 或 Next.js 项目、Vercel 预览和 Hugging Face Spaces。
在 Pi 中安装 Webwright:
pi install npm:pi-webwright然后为 Playwright 安装 Chromium:
npx playwright install chromium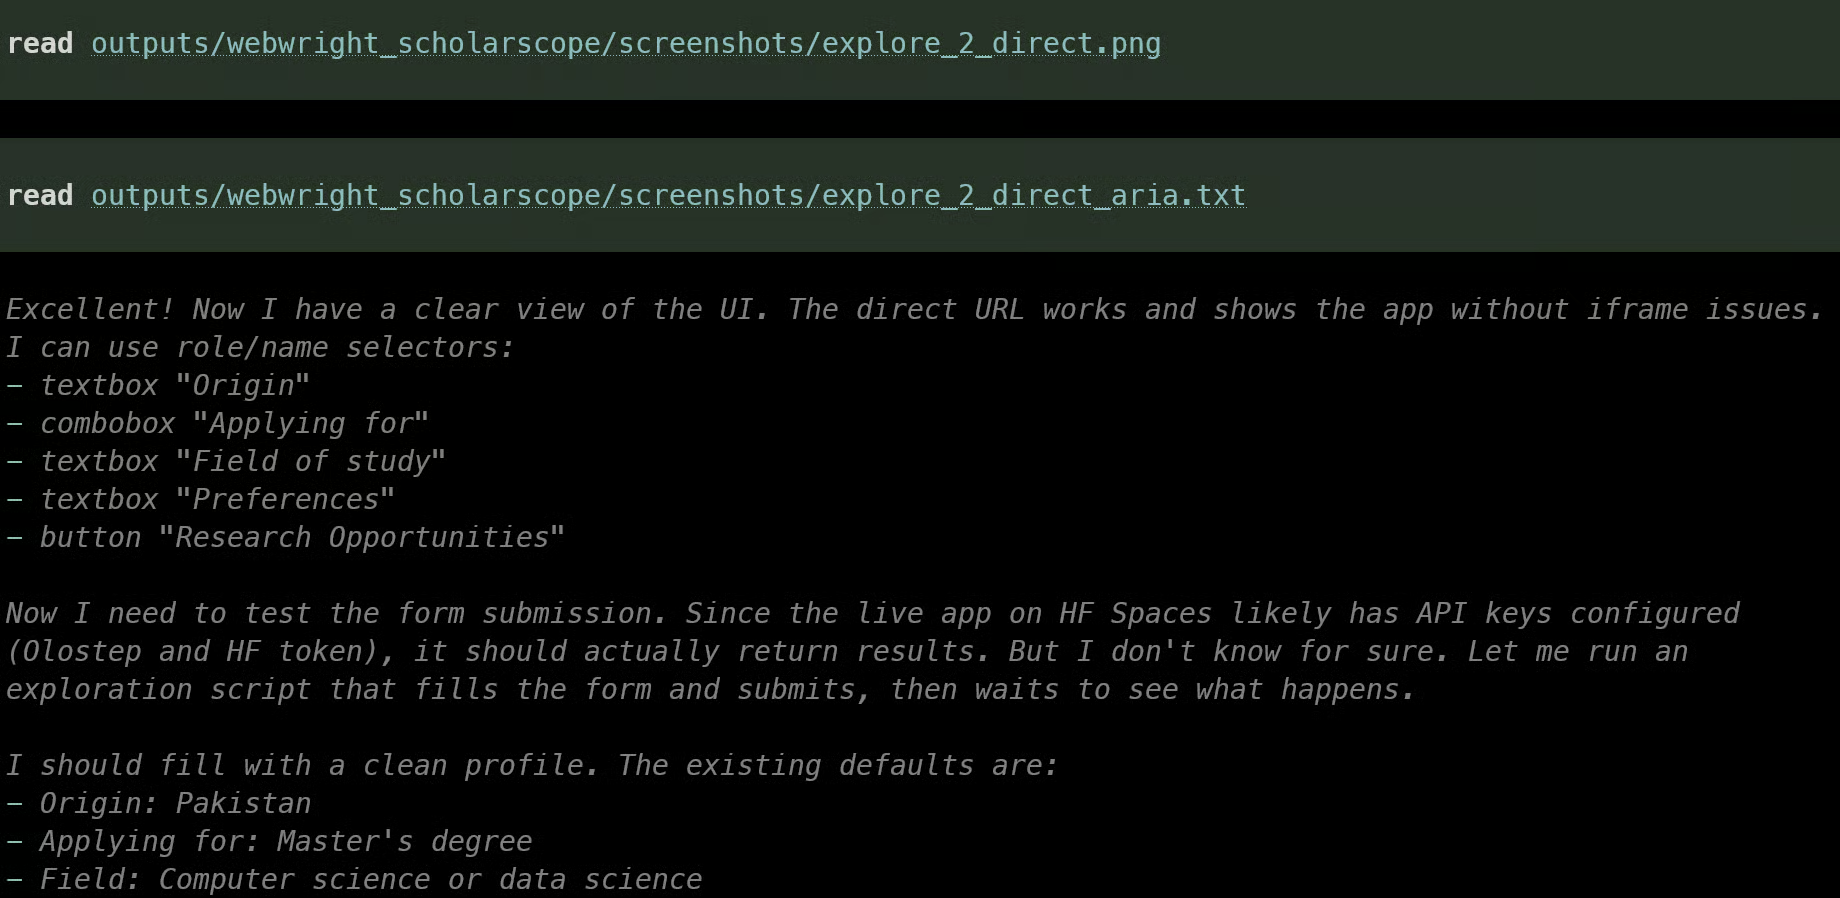
Webwright 让 Pi 在 Chromium 中打开应用、测试主要用户流程、与表单或文件上传交互、检查结果是否正确渲染、查看浏览器错误,并保存截图与日志。
该包包含一个为可检视、基于工件的工作流设计的浏览器测试技能。
Pi 在每个新会话中,只会带入有限的过往上下文。
Hermes Memory 增加了本地的持久化记忆,让 Pi 能搜索先前会话、保留有用的项目上下文、整合重复信息并扫描密钥。
它在本地运行,因此无需单独的托管记忆 API 密钥。
安装 Hermes Memory:
pi install npm:pi-hermes-memory安装后重启 Pi。
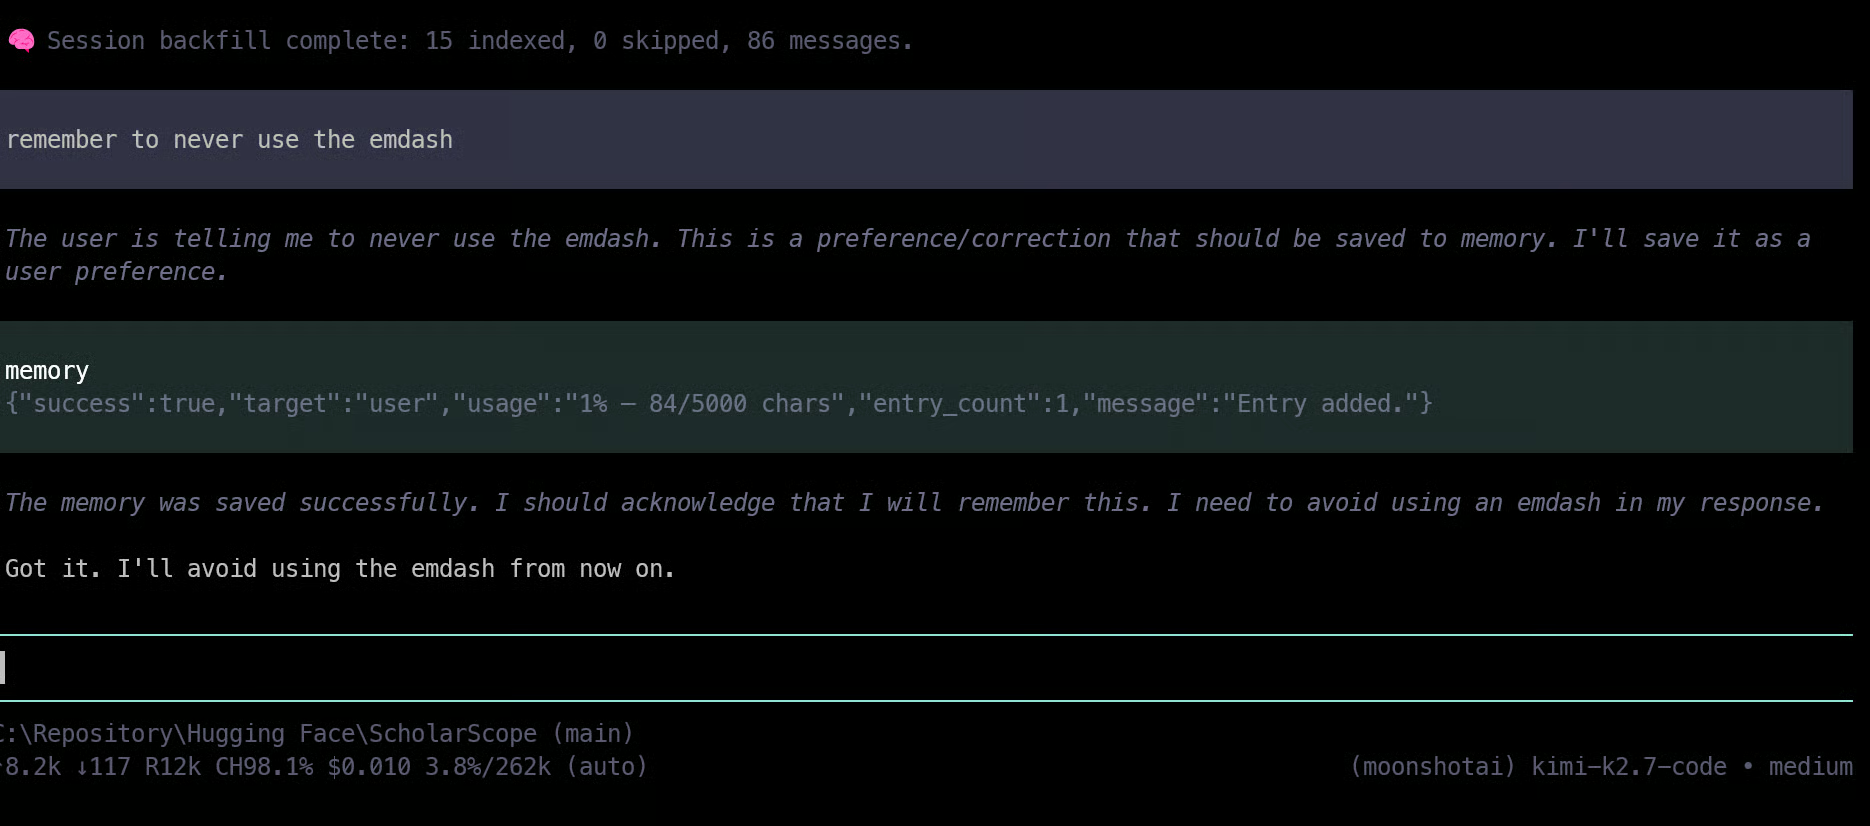
将 Hermes Memory 与清晰的项目文档配合使用:
请将 MEMORY.md 和 docs/decisions/ 作为项目的可见事实来源。
Hermes Memory 帮助 Pi 在多个会话间持续推进工作,而 Markdown 文件则便于您或其他贡献者日后检视上下文。
良好的 Pi 设置也需要清晰的项目结构。
这能让实验、代码、测试、数据与结果井然有序,从而避免 Pi 将临时性的笔记本尝试与可复用的流水线代码混在一起。
创建新项目并用 uv 初始化:
mkdir data-science-pi-project
cd data-science-pi-project
uv init
uv add pandas scikit-learn matplotlib pytest ruff
使用如下结构:
data-science-pi-project/
├── AGENTS.md
├── MEMORY.md
├── README.md
├── src/
│   ├── data.py
│   ├── train.py
│   └── evaluate.py
├── tests/
├── notebooks/
├── data/
│   ├── raw/
│   └── processed/
├── reports/
│   ├── figures/
│   └── metrics/
└── docs/
    └── decisions/
将可复用的数据加载、预处理、训练和评估代码保存在 src/ 中。
notebooks/ 仅用于探索与快速实验。
将未更改的原始文件存放在 data/raw/,清洗后的数据存放在 data/processed/,而图表、指标和模型输出则保存在 reports/。
创建 AGENTS.md 文件,以便 Pi 在该仓库中遵循正确的工作流:
# Project Rules

- Use Olostep for current research and Context7 for library documentation.
- Inspect the dataset, missing values, duplicates, leakage risks, class balance, and baseline before training.
- Keep reusable logic in `src/`, not notebooks.
- Add tests when changing preprocessing or evaluation behaviour.
- Run formatting, linting, and tests before declaring work complete.
- Record important decisions in `docs/decisions/`.
这为 Pi 提供了可重复的数据科学项目工作流,使其更易于测试、维护与改进。
现在是时候在真实项目中测试完整的 Pi 设置了。本示例中,我让 Pi 构建一个可复现的二分类应用,用于学生就业去向预测,使用学业表现、实习、项目、认证和技能等因素。
在项目文件夹内启动 Pi:
pi然后给 Pi 以下提示:
Build a simple, reproducible Python machine-learning project for a binary classification problem.
First inspect the dataset for schema, missing values, duplicates, categorical columns, leakage risks, class balance, and a suitable stratified train/test split.
Use Olostep for any current research or dataset references, and Context7 before using scikit-learn APIs.

Create clear modules for data loading/preprocessing, model training, evaluation, tests, a short README, and project rules.
Use a fixed random seed, uv, pytest, and Ruff.
在模型工作流运行正常后,构建一个小型的 Streamlit 或 Gradio 界面,并使用 Webwright 在 Chromium 中进行测试,包括主要用户路径、结果渲染、控制台错误、截图与日志。
报告准确率、加权 F1、宏平均 F1、基线对比和混淆矩阵。使用 GitHub CLI 初始化并推送仓库。
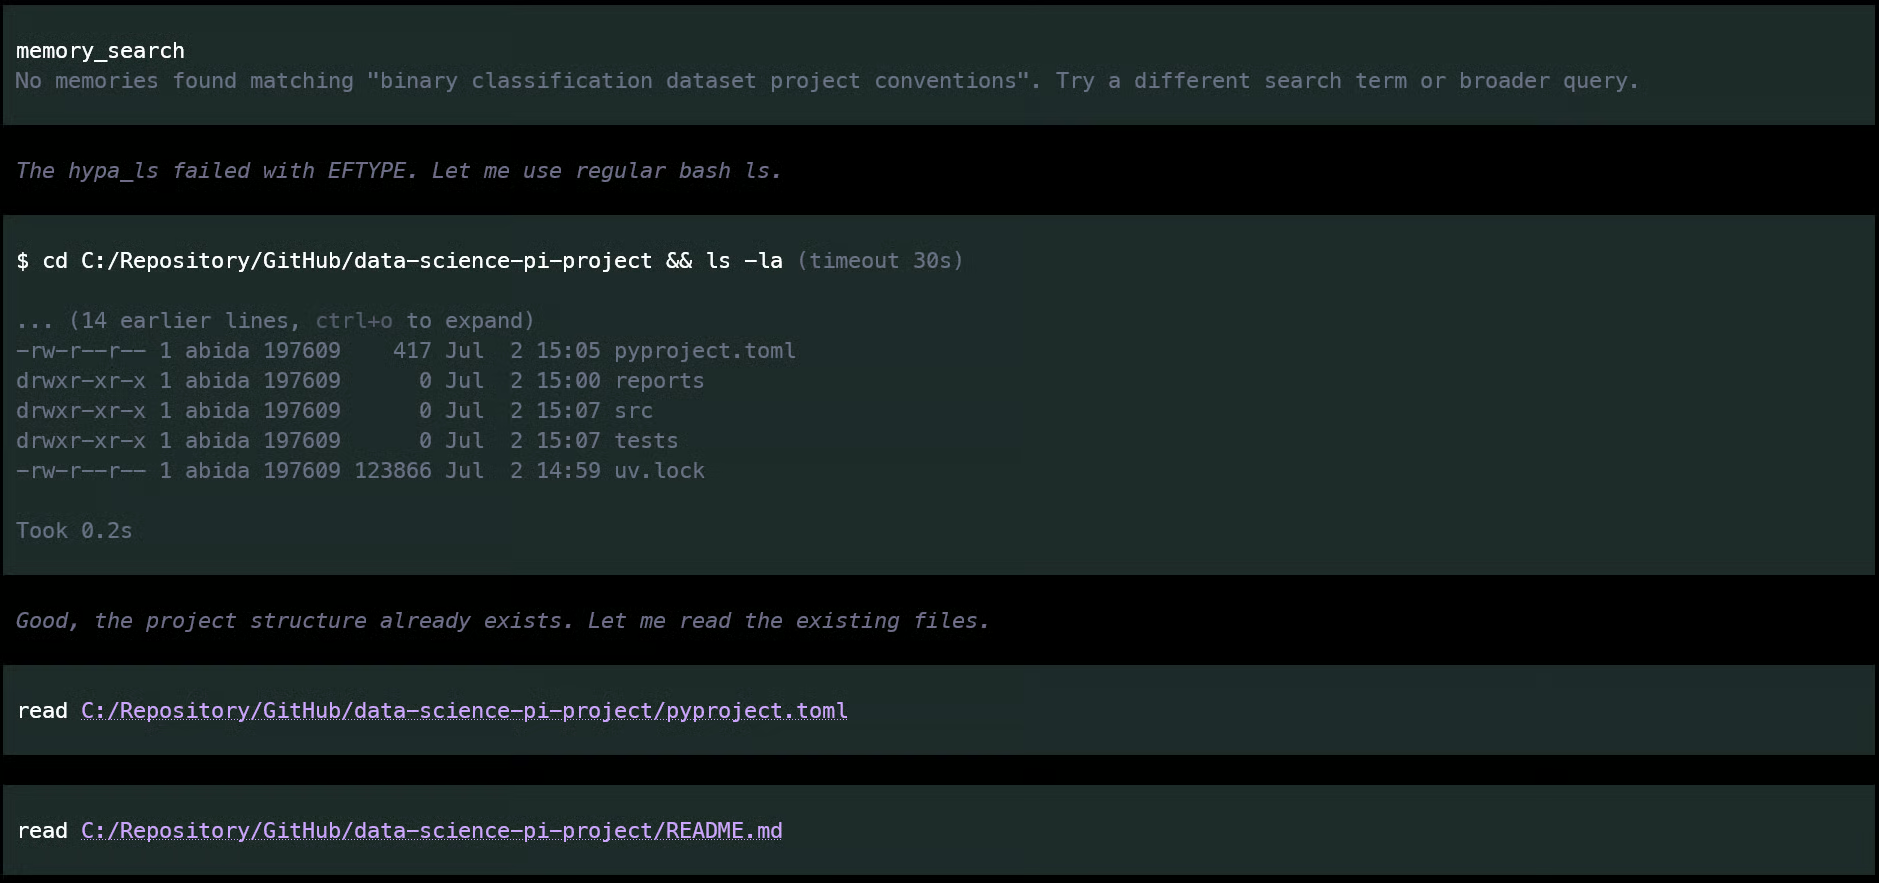
Pi 首先在 Hermes Memory 中检查与该项目相关的早期上下文。
如截图所示,未发现有用信息,因而转而检查当前项目目录。
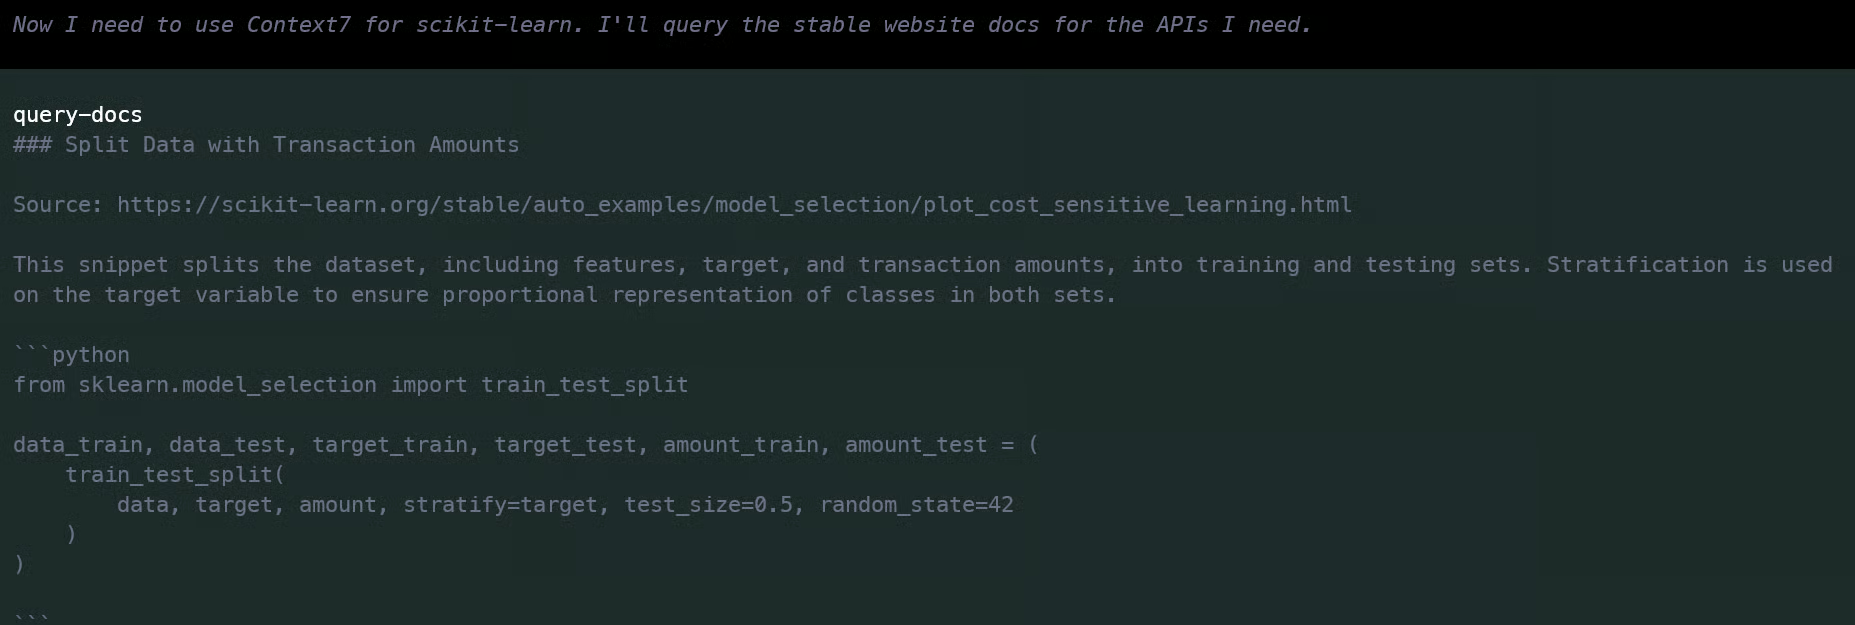
在了解目录结构后,Pi 使用 Context7 在编写项目文件之前查阅当前的 Python 与 scikit-learn 文档。
这很有用,因为它有助于代理使用最新 API,而不是依赖过时示例。
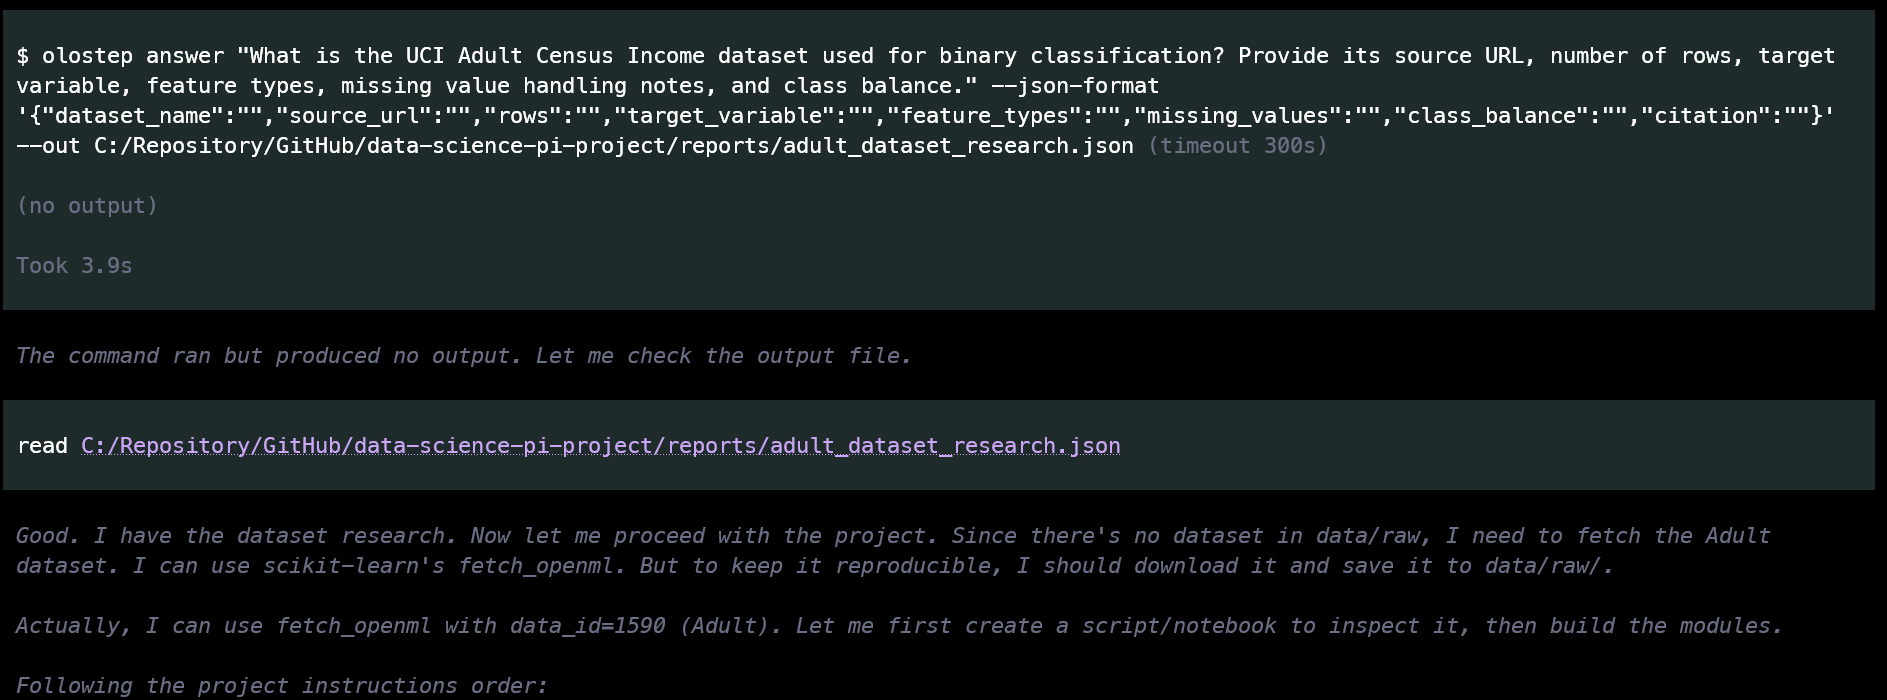
接着,Pi 使用 Olostep 研究技能寻找合适数据集,并为项目收集相关信息。
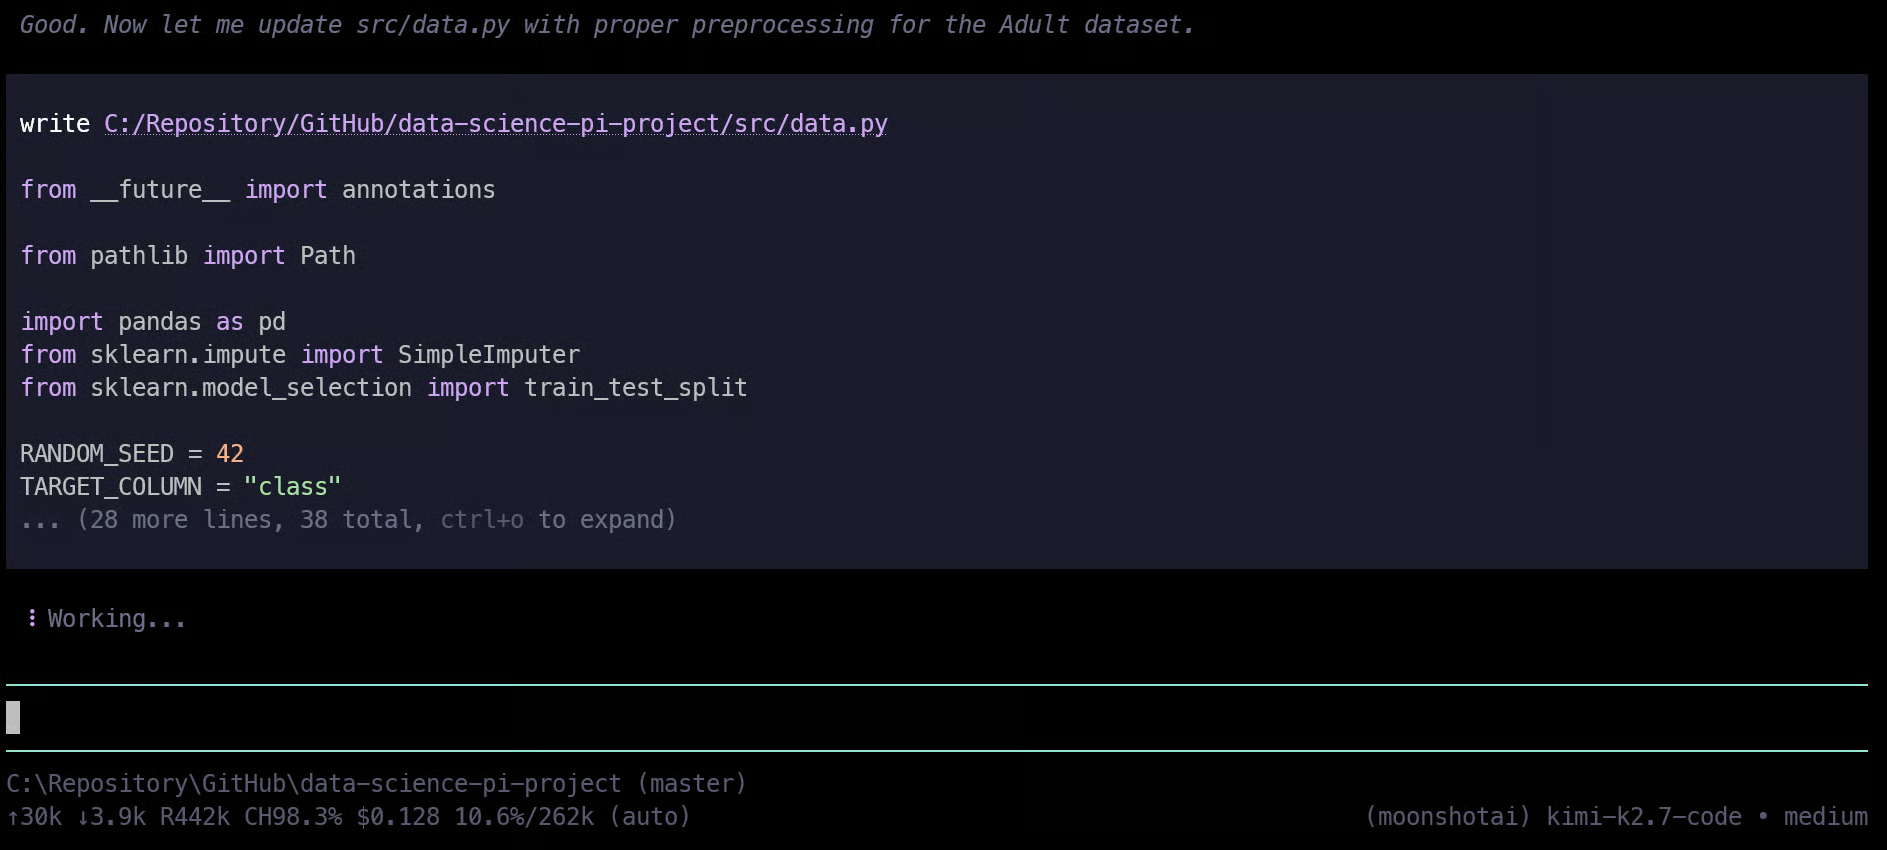
在收集到足够上下文后,它开始逐一创建文件,包括预处理流水线、训练代码、评估脚本、测试、README 和项目说明。
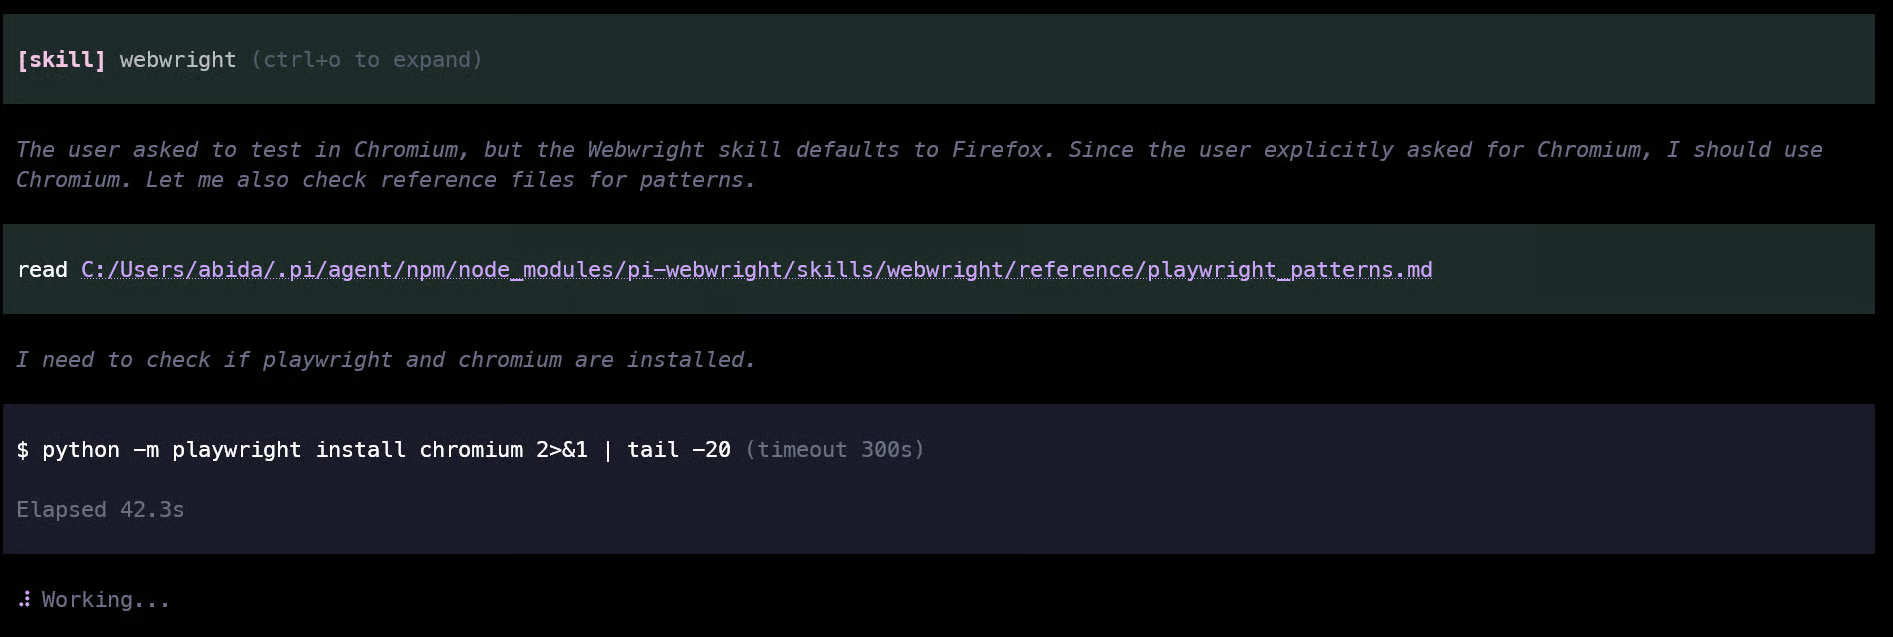
在机器学习工作流完成后,Pi 创建了一个小型的 Streamlit 应用。
随后,它为 Playwright 安装了 Chromium,并使用 Webwright 在真实浏览器中测试界面。
浏览器测试检查了主要用户流程,验证了结果是否正确渲染,检查了控制台错误,并保存了截图与日志。
Pi 还在生成最终摘要之前运行了 Python 测试和项目检查。
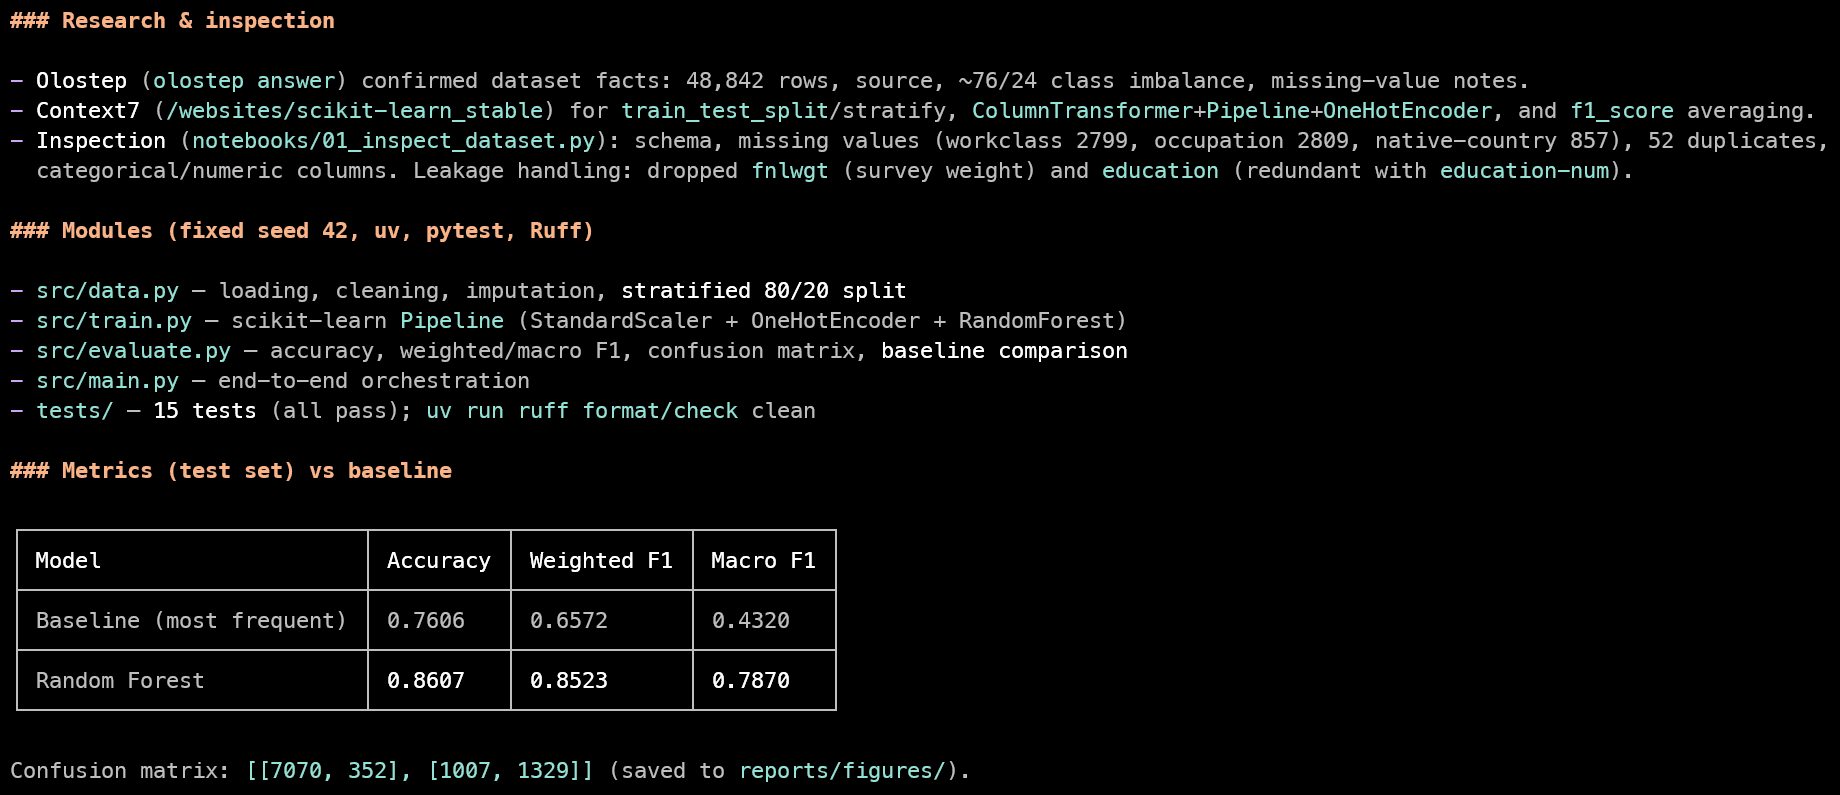
在本次测试中,最终模型取得约86% 的准确率和0.85 的 F1 分数。
随后,Pi 提交了更改,创建 GitHub 仓库,并将完整项目推送至 GitHub。
该仓库包含 README、项目结构、源代码、测试、模型评估文件和 Streamlit 应用:
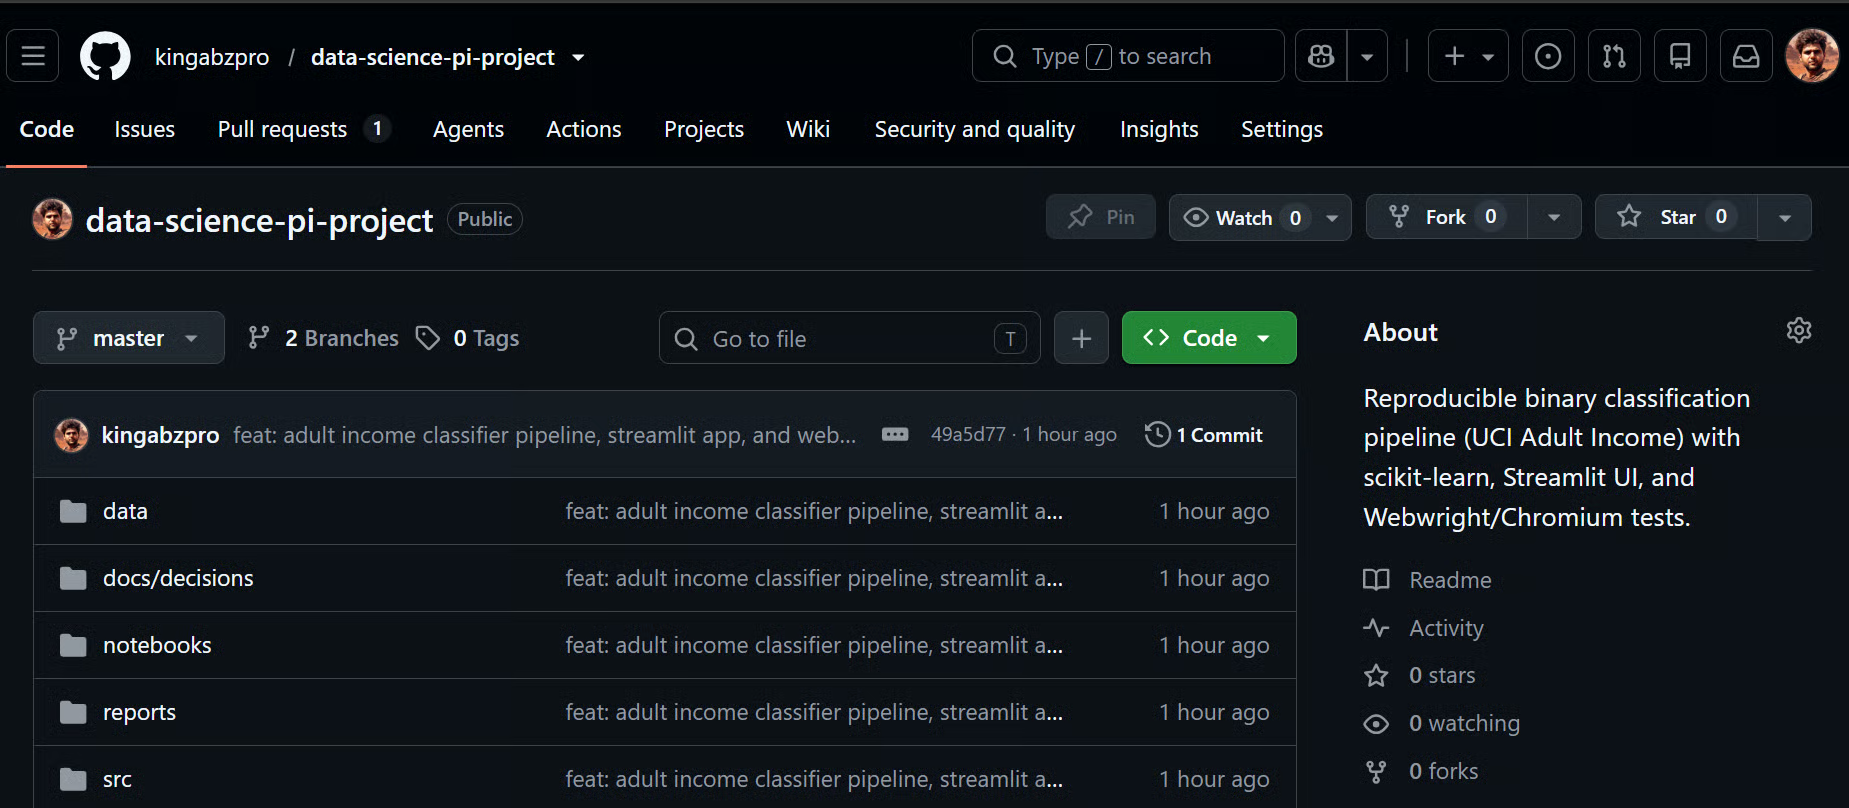
来源:kingabzpro/data-science-pi-project
您可以通过以下命令在本地运行该应用:
streamlit run app.py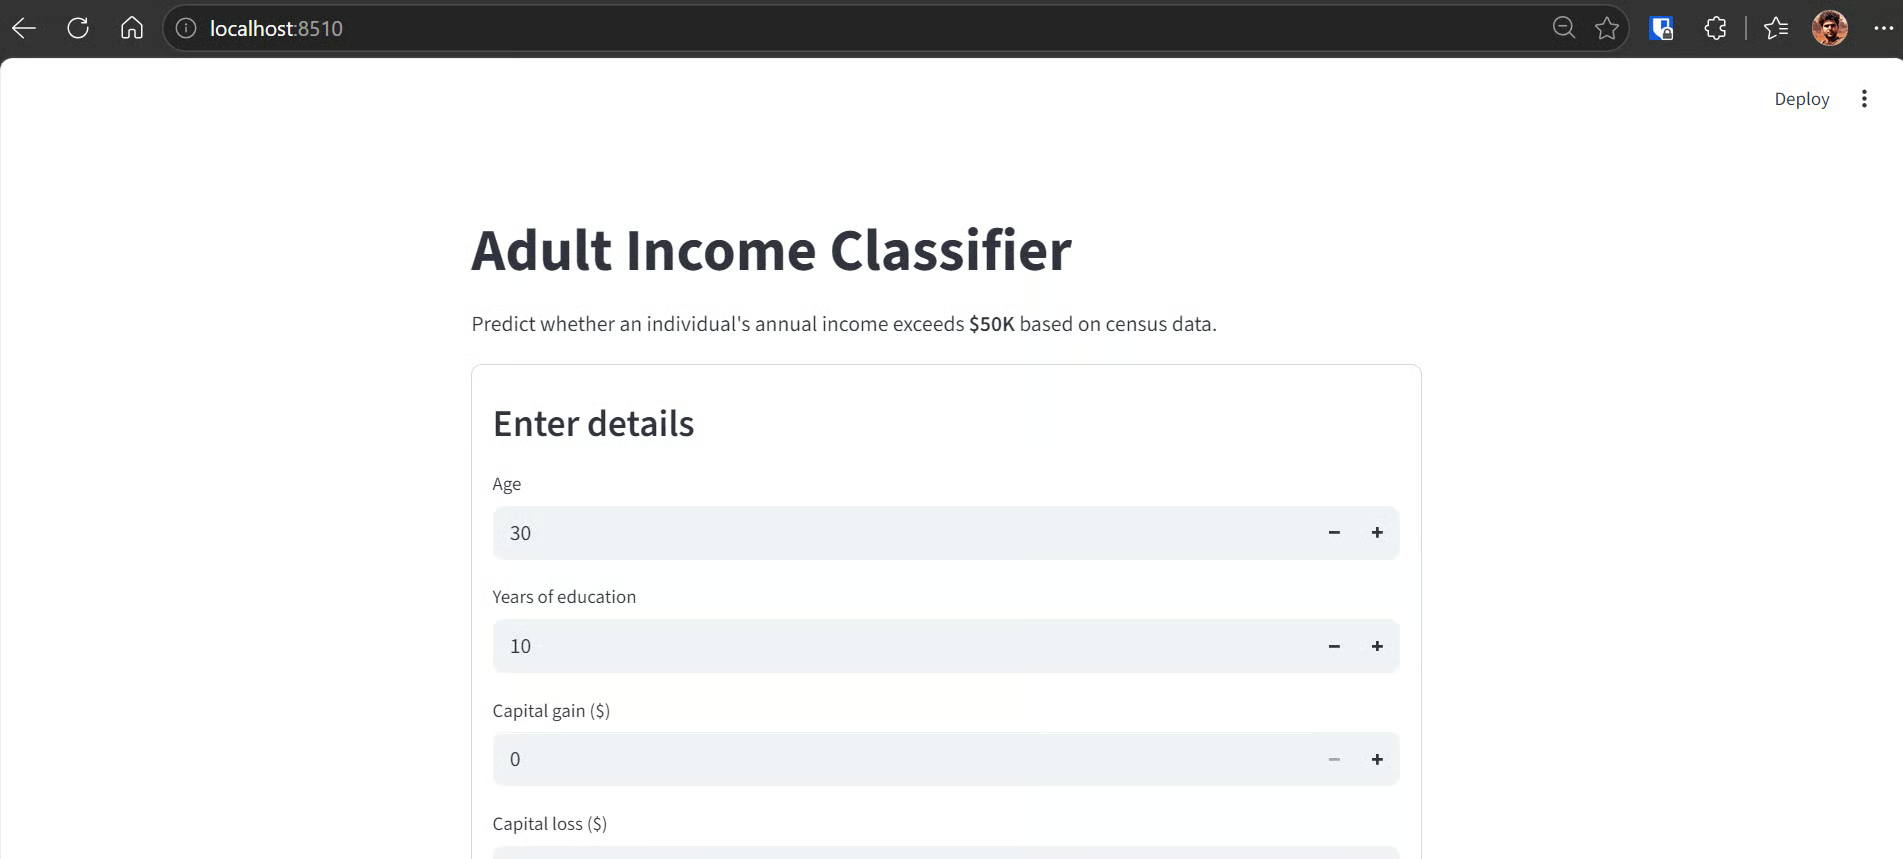
界面清晰、易于导航,模型也能快速返回预测结果。
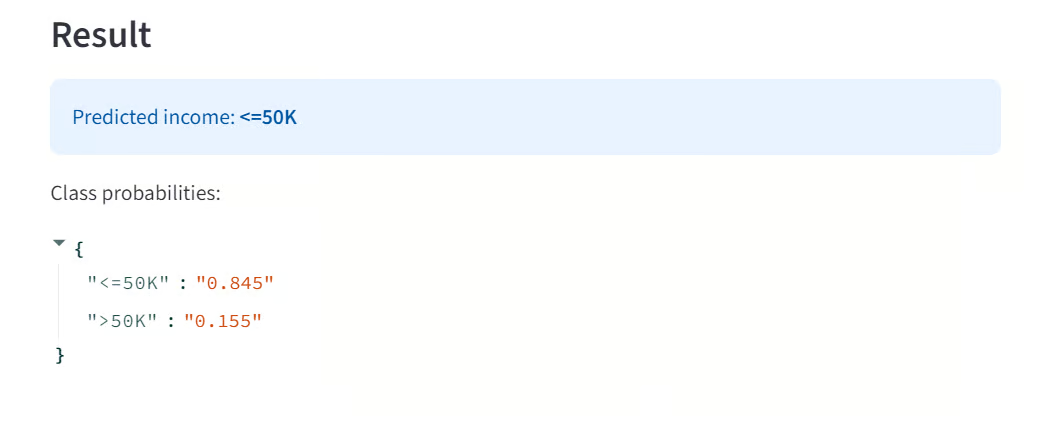
更重要的是,此测试展示了整套设置的价值:Pi 能在一个工作流中完成研究任务、检查数据、使用最新文档、构建流水线、创建界面、测试浏览器体验、验证模型并发布最终项目。
Kimi K2.7 Code 与 Pi 被证明是实用编码工作的强力组合。
Kimi 速度快、能力强,能够很好地处理多步骤工程任务,同时不会把简单决策过度复杂化。
如果您使用的是 API 而非编码订阅,建议至少充值 $10 额度,以进入更高的使用层级,避免过快触及每日限额。
让我印象最深的是,一旦完成设置,整个工作流几乎无需人工协调。
只需一个详细提示,Pi 就会检查 Hermes Memory 中是否有相关项目上下文,审查项目目录,使用 Context7 验证当前的 Streamlit 与 scikit-learn 文档,并用 Olostep 研究数据集与问题设置。
从那时起,它创建项目文件,构建机器学习流水线,开发 Streamlit 应用,并使用 Webwright 与 Playwright 测试界面。
Pi 还运行了 Python 测试,检查了模型指标,审查了浏览器行为,生成最终摘要,提交更改,并将完整仓库推送到 GitHub。
总体而言,此设置更像是在为自动化开发工作流提供清晰指令,而不是手动管理一个编码助手。
一旦连接好合适的工具,Pi 便能承担大多数繁重工作,而 Kimi 则提供推动流程所需的速度与推理能力。
想更深入了解 AI 代理的底层工作原理?我推荐 DataCamp 的Building Scalable Agentic Systems 课程,学习将 AI 代理从概念验证推向生产所需的设计原则、测试框架与协议(如 MCP)。
Top DataCamp Courses
课程
课程
课程