Curso
Codificação com IA para Desenvolvedores
1 h 30 min
11.2K
Kimi K2.7 Code é o modelo carro-chefe de codificação da Moonshot, criado para tarefas práticas de desenvolvimento de software, como escrever e depurar código, navegar por grandes bases de código e lidar com trabalhos de engenharia em várias etapas.
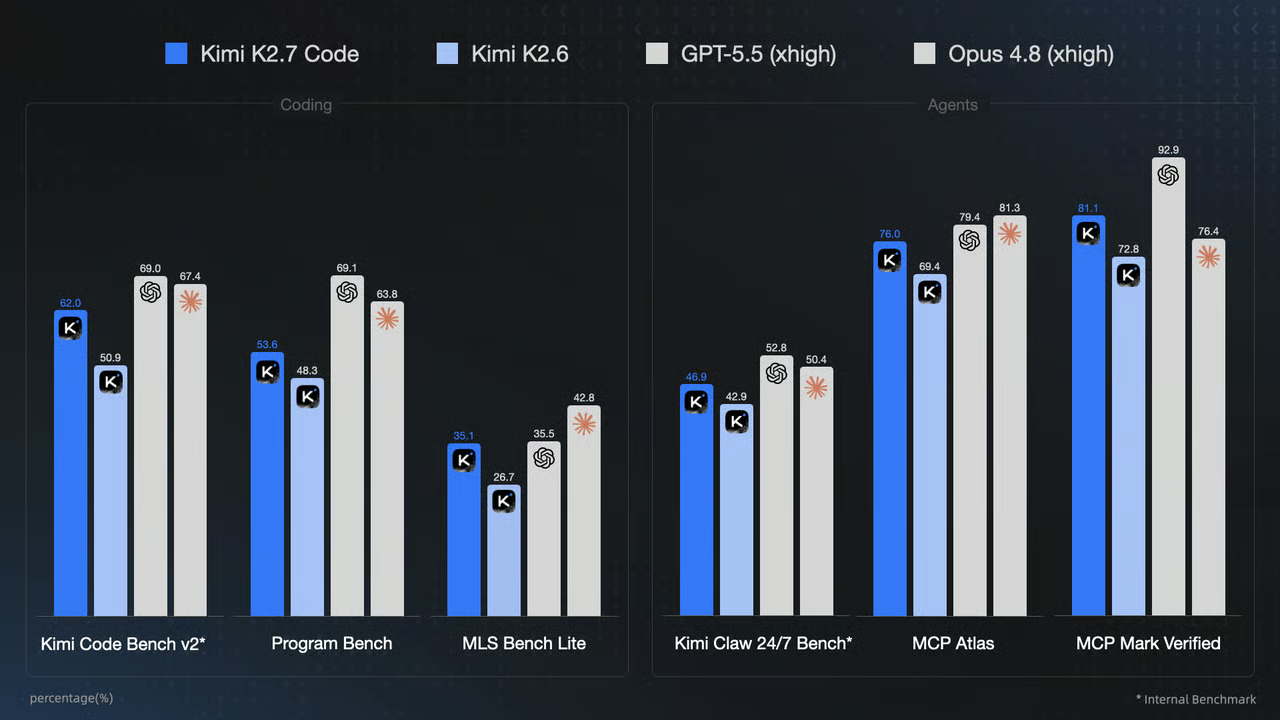
Fonte: Kimi K2.7 Code: Open-Source Agentic Coding Model
Junto com o Pi, um agente de codificação leve e altamente extensível, ele cria um ambiente local flexível de desenvolvimento que suporta skills, pacotes, ferramentas de linha de comando, memória persistente e testes em navegador — sem adicionar complexidade desnecessária.
Em vez de instalar um MCP para cada tarefa, o Pi combina o raciocínio do Kimi com ferramentas de desenvolvedor confiáveis como GitHub CLI, Vercel CLI, Hugging Face CLI, pytest, Ruff e uv.
Isso torna possível pesquisar, construir, testar, fazer deploy e manter projetos reais em um único fluxo de trabalho com agente de código.
Neste guia, vou mostrar como configurar o Kimi K2.7 Code com o Pi do zero ao final.
Você vai configurar sua chave de API da Moonshot, adicionar o Olostep para pesquisa, o Context7 para documentação atualizada, o Webwright para testes em navegador e o Hermes Memory para contexto entre sessões.
Também vai instalar temas e skills de engenharia úteis, conectar CLIs práticos para GitHub, Vercel e Hugging Face, criar um projeto reprodutível de data science em Python e testar o fluxo completo construindo, validando e publicando um pequeno aplicativo de machine learning.
Recomendo também conferir meu guia sobre como executar o Kimi K2.7 Code localmente.
O Pi é um agente de codificação leve que roda direto no seu terminal.
Ele trabalha com seus arquivos locais, executa comandos, usa skills e pacotes instalados e conecta ao seu modelo de codificação preferido.
Escolha o comando de instalação para o seu sistema operacional.
Windows PowerShell
powershell -c "irm https://pi.dev/install.ps1 | iex"macOS ou Linux
curl -fsSL https://pi.dev/install.sh | shVocê também pode instalar o Pi via npm:
npm install -g --ignore-scripts @earendil-works/pi-coding-agentAntes de usar o Kimi K2.7 Code no Pi, adicione sua chave de API da Moonshot como variável de ambiente.
Assim, o Pi acessa a chave automaticamente quando você selecionar a Moonshot como provedora do modelo.
Windows PowerShell
setx MOONSHOT_API_KEY "your_moonshot_api_key"Feche e reabra o PowerShell após executar este comando. A nova variável de ambiente só ficará disponível em sessões de terminal abertas depois disso.
Git Bash, macOS ou Linux
export MOONSHOT_API_KEY="your_moonshot_api_key"Esse comando só vale para a sessão atual do terminal. Para manter a chave disponível após reiniciar o terminal, adicione a mesma linha ao perfil do seu shell, como ~/.bashrc ou ~/.zshrc.
Mantenha sua chave de API em sigilo. Não a adicione a repositórios Git, notebooks públicos, capturas de tela, arquivos .env.example ou AGENTS.md.
Com a chave configurada, inicie o Pi:
piDepois, abra o seletor de modelos:
/model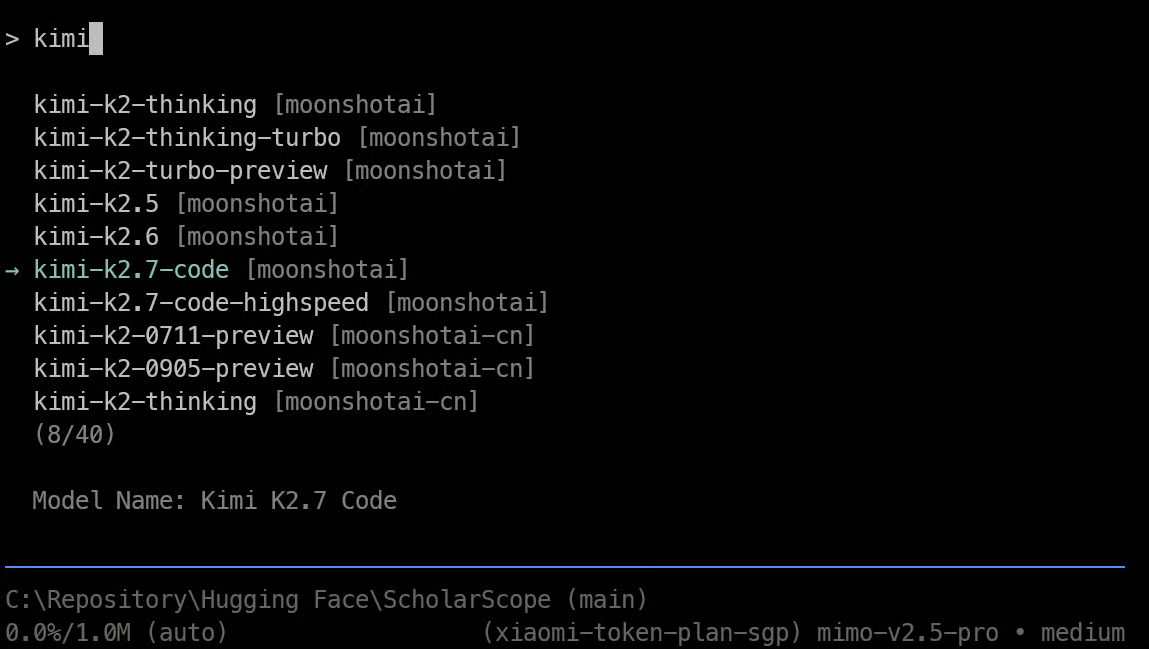
Escolha moonshotai como provedor e selecione kimi-k2.7-code.
O Pi deve detectar automaticamente a variável de ambiente MOONSHOT_API_KEY e usá-la para autenticação.
Olostep dá ao Pi acesso a fluxos de pesquisa para busca na web, scraping, varredura de documentação, depuração e extração estruturada de dados.
Isso ajuda o Pi a encontrar informações atualizadas quando a tarefa exige mais do que o conhecimento embutido no modelo.
Antes de continuar, crie uma conta no Olostep, gere uma chave de API e salve-a localmente como uma variável de ambiente chamada OLOSTEP_API_KEY.
Assim, o Pi e quaisquer scripts que ele criar conseguem se autenticar no Olostep sem armazenar segredos nos arquivos do projeto.
Em seguida, instale as skills do Olostep direto no diretório global de skills do Pi:
npx -y olostep-cli@latest add skills \
 --no-global \
 --agent-skills-dir ~/.pi/agent/skills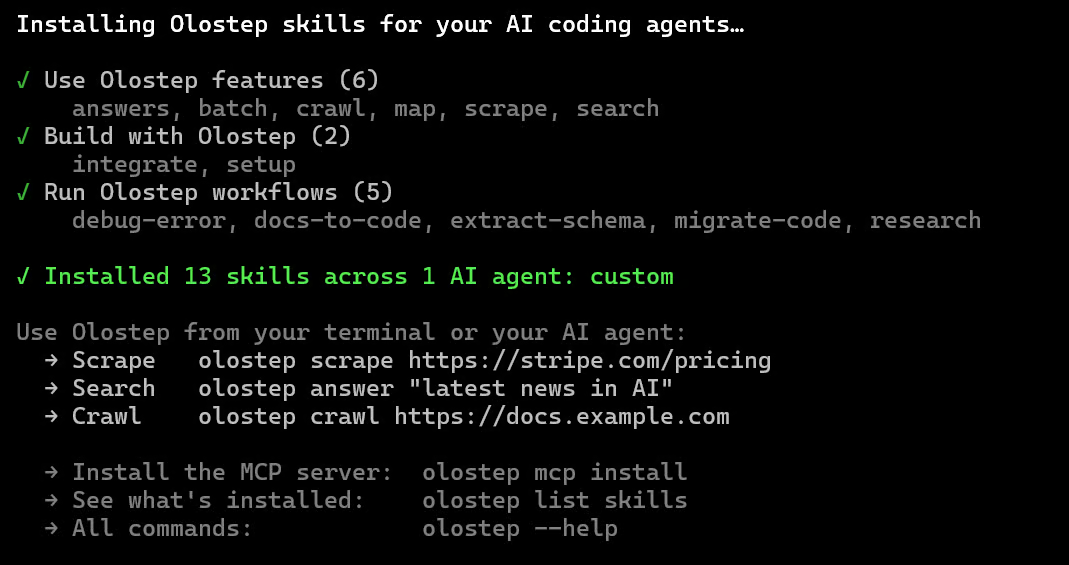
Isso instala as skills do Olostep em:
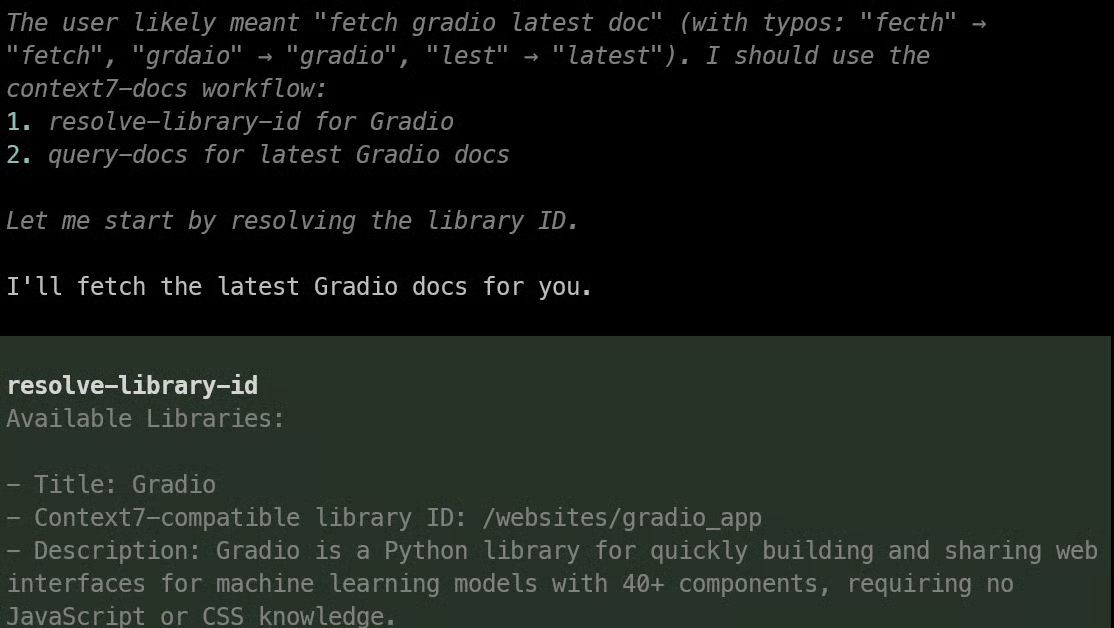
~/.pi/agent/skills/Context7 dá ao Pi acesso a documentação atualizada e específica por versão de bibliotecas e a exemplos de código. Isso ajuda a evitar o uso de APIs obsoletas quando o Pi trabalha com frameworks, SDKs e pacotes Python que evoluem rápido.
Antes de instalar, crie uma conta no Context7, gere uma chave de API no painel e salve-a localmente como variável de ambiente chamada CONTEXT7_API_KEY.
Mantenha a chave em sigilo e não a faça commit no repositório, nem a inclua em capturas de tela, notebooks ou arquivos de instrução do projeto.
Instale o pacote oficial do Context7 para o Pi:
pi install npm:@upstash/context7-piIsso adiciona ferramentas de documentação do Context7, uma skill que orienta o Pi a usá-las quando necessário e o comando /c7-docs para consultas manuais.
Depois de reiniciar o Pi, ele poderá recuperar documentação relevante antes de escrever código que dependa de bibliotecas externas.
O Pi suporta pacotes de temas de terceiros, facilitando melhorar a interface do terminal sem mudar como o agente funciona.
O pacote @spences10/pi-themes inclui vários temas escuros caprichados, como Catppuccin Mocha, Dracula, Gruvbox Dark, Nord, One Dark e Tokyo Night.
Instale o pacote de temas da comunidade:
pi install npm:@spences10/pi-themesDepois, abra o Pi:
piAbra o menu de configurações:
/settings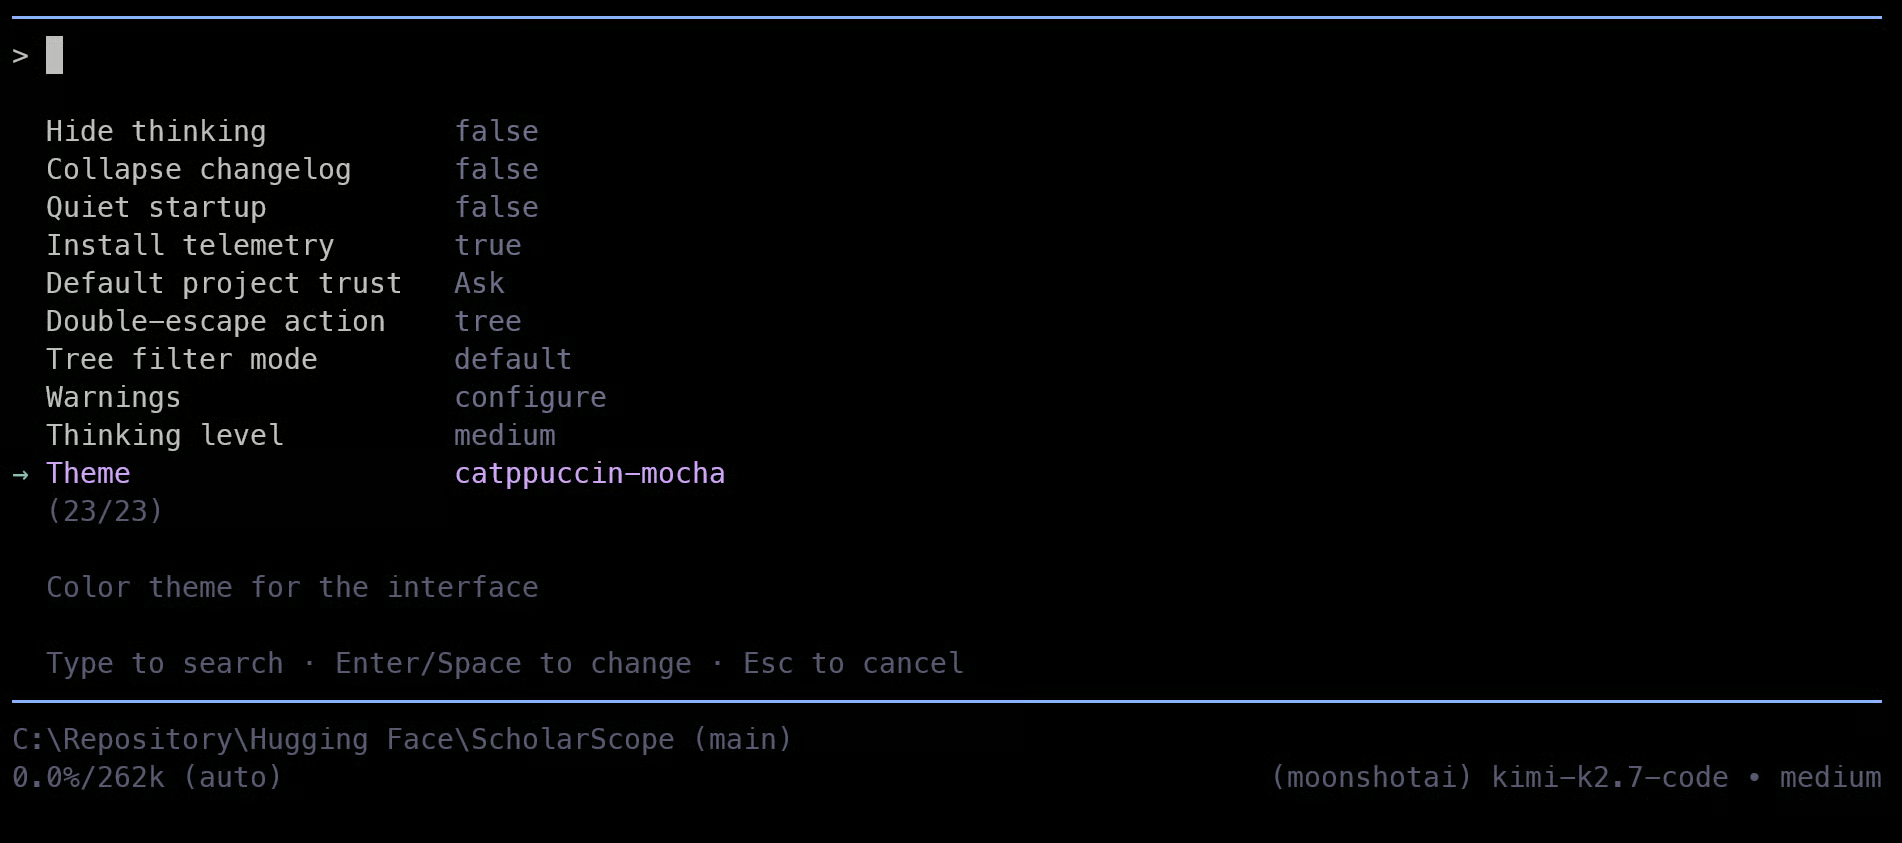
Selecione Catppuccin Mocha entre os temas disponíveis. É um tema escuro, limpo, com bom contraste — ótimo como padrão para sessões longas de código.
Você pode trocar de tema a qualquer momento pelo /settings. O Pi também suporta temas locais e baseados em pacotes, então dá para personalizar a interface depois sem mudar seu modelo, ferramentas ou configuração do projeto.
O Pi pode ser estendido com fluxos de engenharia reutilizáveis que o deixam mais consistente ao planejar, depurar, testar, revisar código, escrever documentação e preparar projetos para handoff ou release.
O pacote @barlevalon/skills fornece fluxos portáteis em SKILL.md para essas tarefas comuns de engenharia de software.
Instale o pacote de skills:
pi install npm:@barlevalon/skills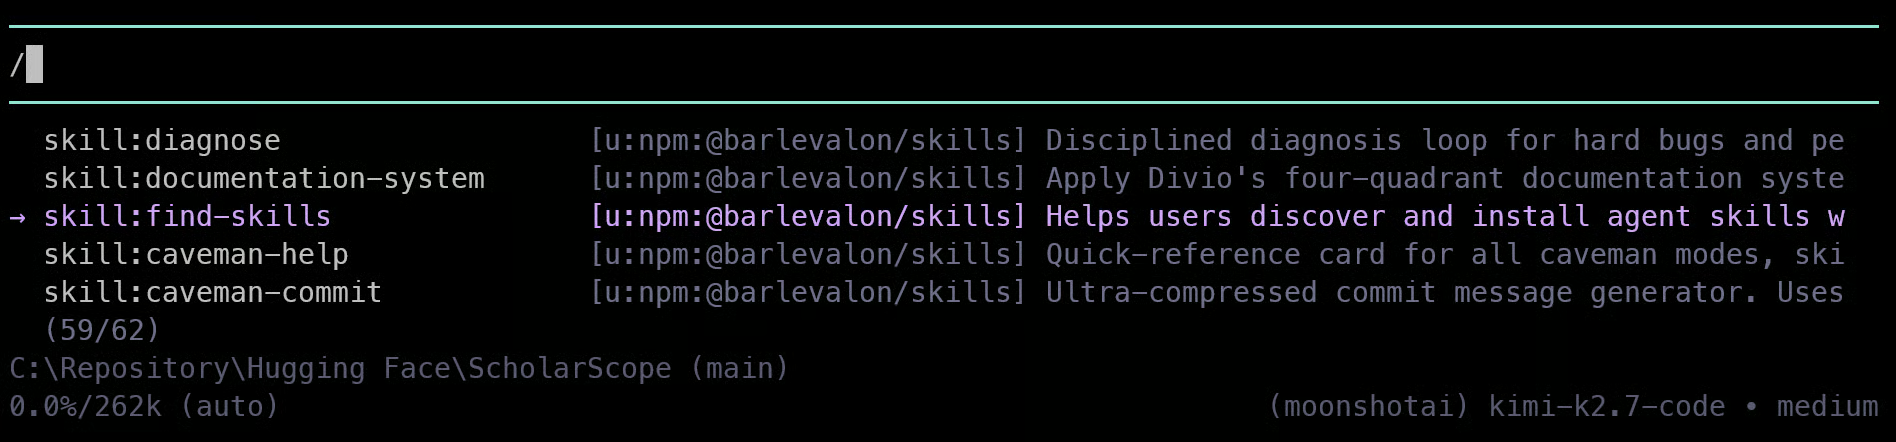
Depois, instale o Hypa para impedir que saídas longas do terminal ocupem a janela de contexto do Pi:
pi install npm:@hypabolic/pi-hypaO Hypa reescreve automaticamente comandos de shell suportados por meio de uma camada local de compressão. Ele preserva evidências importantes, como erros e resultados finais, reduzindo logs repetitivos de instalações de pacotes, suítes de teste, execuções de modelos, builds e deploys.
O pacote do Pi também instala o Hypa como dependência e cria um shim local do comando hypa (melhor esforço).
Você não precisa de um MCP, extensão ou pacote para cada serviço que usa.
Para fluxos comuns — como gerenciar repositórios, fazer deploy de uma aplicação, verificar logs ou publicar um modelo — uma ferramenta de linha de comando autenticada costuma ser mais simples, confiável e fácil para o Pi usar.
O GitHub CLI permite que o Pi trabalhe com repositórios, pull requests, issues, releases e GitHub Actions direto do terminal. Instale no Windows com:
winget install --id GitHub.cli --source wingetDepois, faça login:
gh auth loginUse o GitHub CLI quando quiser que o Pi inspecione um repositório, crie ou revise pull requests, verifique execuções de workflows, gerencie issues ou publique um projeto no GitHub.
O Vercel CLI permite que o Pi faça deploy de aplicações web, inspecione projetos, veja logs de deploy e gerencie variáveis de ambiente pelo terminal.
npm install -g vercel
vercel login
Use o Vercel CLI para deploys de preview, releases em produção, troubleshooting de deploy, vinculação de projetos e checagem de variáveis de ambiente.
A ferramenta de linha de comando atual da Hugging Face é o hf, incluída no pacote huggingface_hub. Instale com:
pip install -U huggingface_hubDepois, autentique:
hf auth loginUse o Hugging Face CLI para criar e gerenciar repositórios de modelos, datasets e Spaces; enviar arquivos do projeto; baixar modelos ou datasets; e confirmar qual conta está autenticada.
Testes unitários são úteis para validar a lógica em Python, mas não mostram se um usuário de verdade consegue usar sua aplicação.
O Webwright permite que o Pi rode testes baseados em navegador com Playwright em apps locais ou publicados, incluindo Streamlit, Gradio, front-ends FastAPI, projetos React ou Next.js, previews da Vercel e Spaces da Hugging Face.
Instale o Webwright no Pi:
pi install npm:pi-webwrightDepois, instale o Chromium para o Playwright:
npx playwright install chromium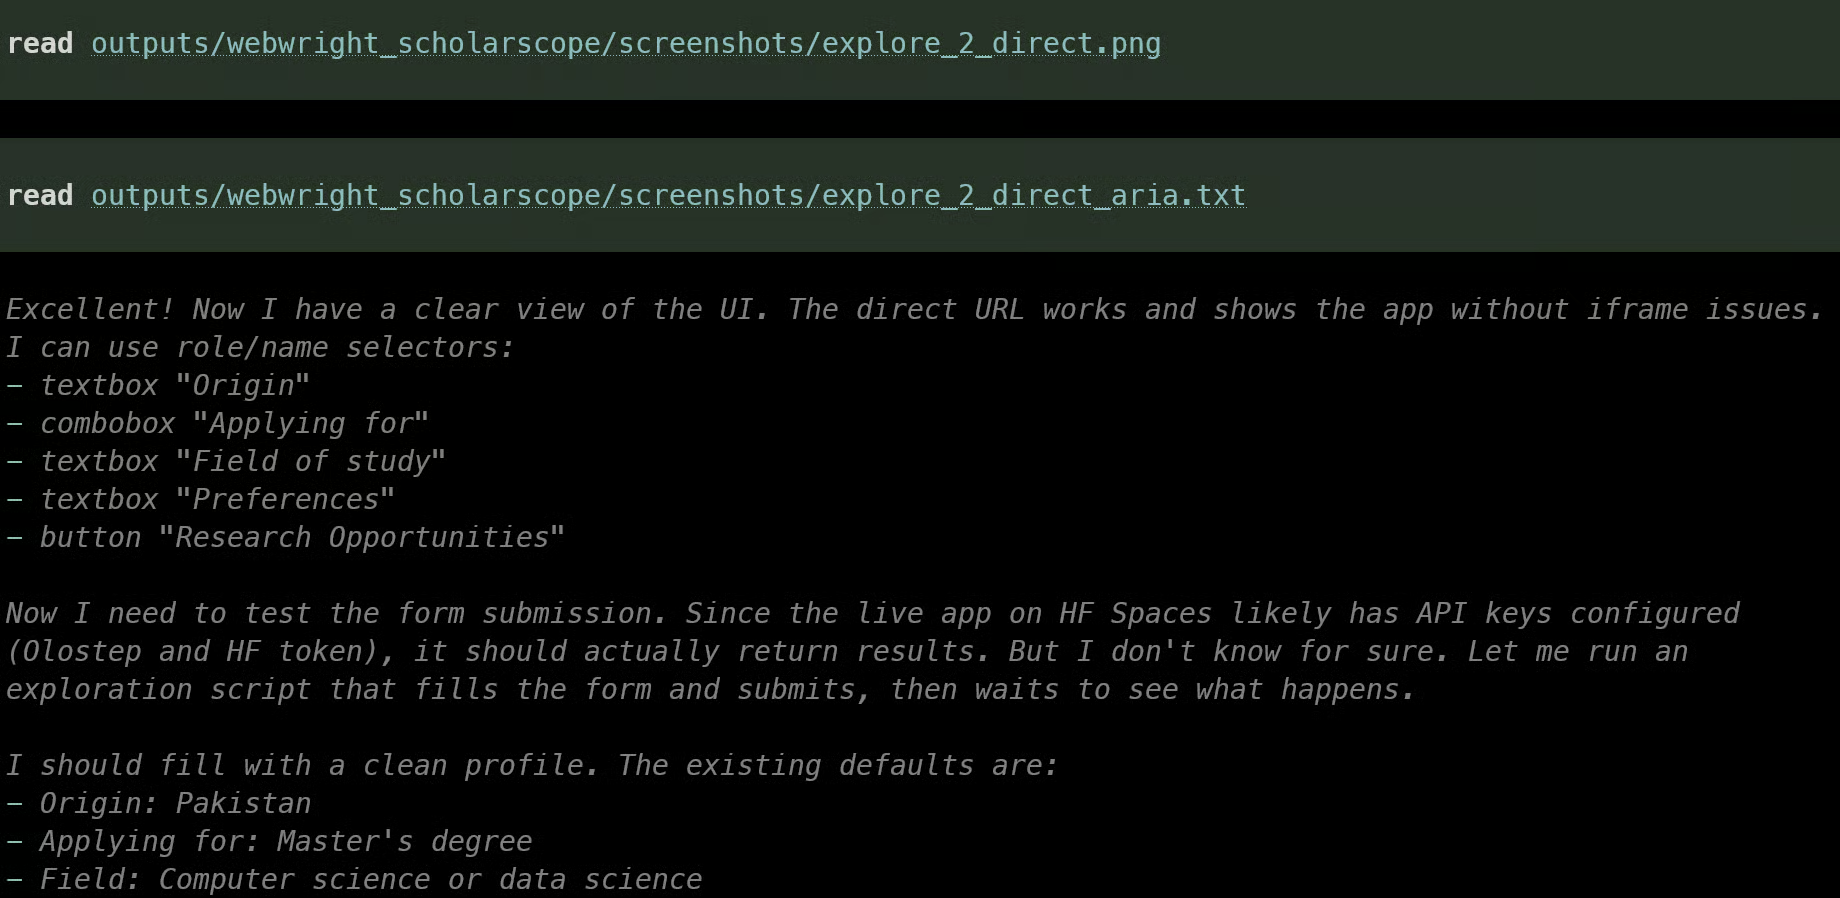
O Webwright permite que o Pi abra o app no Chromium, teste o fluxo principal do usuário, interaja com formulários ou uploads de arquivo, verifique se os resultados renderizam corretamente, inspecione erros do console e salve capturas de tela e logs.
O pacote inclui uma skill de testes em navegador pensada para fluxos inspecionáveis e baseados em artefatos.
O Pi inicia cada nova sessão com contexto limitado do trabalho anterior.
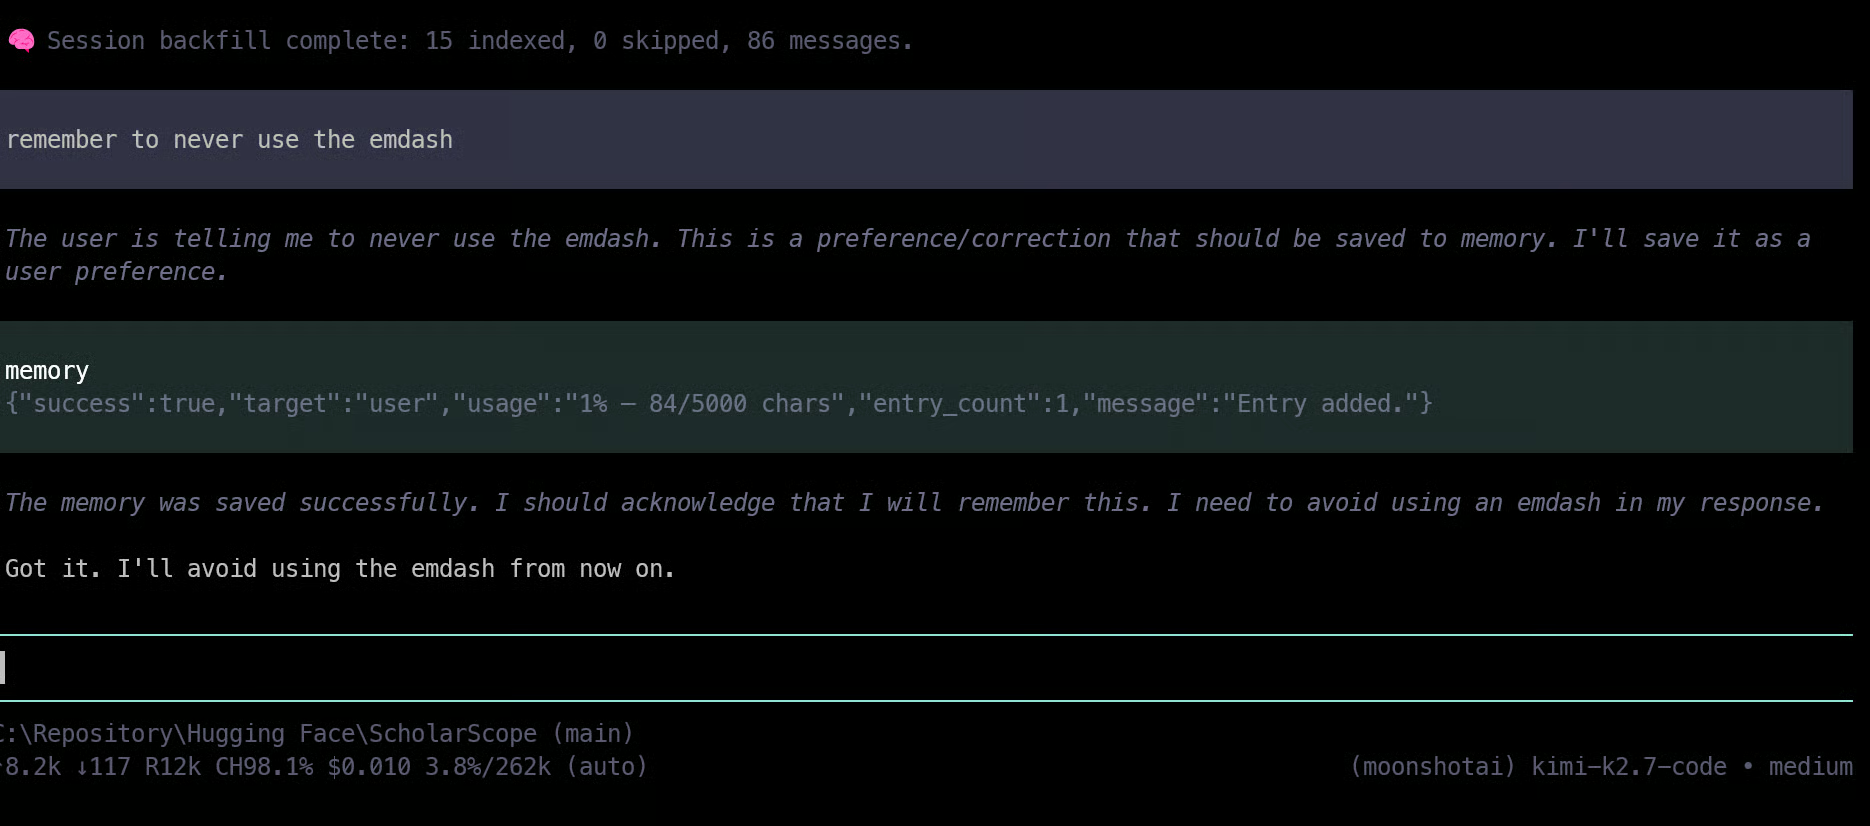
O Hermes Memory adiciona memória local e persistente para o Pi pesquisar sessões anteriores, reter contexto útil do projeto, consolidar informações repetidas e escanear por segredos.
Ele roda localmente, então você não precisa de uma chave de API de memória hospedada separada.
Instale o Hermes Memory:
pi install npm:pi-hermes-memoryReinicie o Pi após a instalação.
Use o Hermes Memory junto com documentação clara do projeto:
Mantenha MEMORY.md e docs/decisions/ como a fonte de verdade visível do seu projeto.
O Hermes Memory ajuda o Pi a continuar o trabalho entre sessões, enquanto os arquivos Markdown deixam o contexto fácil de inspecionar por você ou outro colaborador depois.
Uma boa configuração do Pi também precisa de uma estrutura clara de projeto.
Isso mantém seus experimentos, código, testes, dados e resultados organizados, para que o Pi faça mudanças sem misturar trabalho temporário de notebook com código reutilizável de pipeline.
Crie um novo projeto e inicialize com o uv:
mkdir data-science-pi-project
cd data-science-pi-project
uv init
uv add pandas scikit-learn matplotlib pytest ruff
Use esta estrutura:
data-science-pi-project/
├── AGENTS.md
├── MEMORY.md
├── README.md
├── src/
│   ├── data.py
│   ├── train.py
│   └── evaluate.py
├── tests/
├── notebooks/
├── data/
│   ├── raw/
│   └── processed/
├── reports/
│   ├── figures/
│   └── metrics/
└── docs/
    └── decisions/
Mantenha o código reutilizável de carregamento, pré-processamento, treino e avaliação em src/.
Use notebooks/ apenas para exploração e experimentos rápidos.
Armazene arquivos de origem inalterados em data/raw/, dados limpos em data/processed/ e salve gráficos, métricas e saídas de modelos em reports/.
Crie um arquivo AGENTS.md para o Pi seguir o fluxo correto ao trabalhar no repositório:
# Project Rules

- Use Olostep for current research and Context7 for library documentation.
- Inspect the dataset, missing values, duplicates, leakage risks, class balance, and baseline before training.
- Keep reusable logic in `src/`, not notebooks.
- Add tests when changing preprocessing or evaluation behaviour.
- Run formatting, linting, and tests before declaring work complete.
- Record important decisions in `docs/decisions/`.
Isso dá ao Pi um fluxo reproduzível para criar projetos de data science mais fáceis de testar, manter e evoluir.
Hora de testar a configuração completa do Pi em um projeto real. Neste exemplo, pedi ao Pi para construir um aplicativo reprodutível de classificação binária para prever colocação de estudantes usando fatores como desempenho acadêmico, estágios, projetos, certificações e habilidades.
Inicie o Pi dentro da pasta do seu projeto:
piDepois, envie este prompt para o Pi:
Build a simple, reproducible Python machine-learning project for a binary classification problem.
First inspect the dataset for schema, missing values, duplicates, categorical columns, leakage risks, class balance, and a suitable stratified train/test split.
Use Olostep for any current research or dataset references, and Context7 before using scikit-learn APIs.

Create clear modules for data loading/preprocessing, model training, evaluation, tests, a short README, and project rules.
Use a fixed random seed, uv, pytest, and Ruff.
Depois que o pipeline do modelo estiver funcionando, crie uma pequena interface em Streamlit ou Gradio e teste-a no Chromium com o Webwright, incluindo a jornada principal do usuário, renderização de resultados, erros de console, capturas de tela e logs.
Reporte acurácia, F1 ponderado, F1 macro, uma comparação com baseline e a matriz de confusão. Inicialize e faça push do repositório com o GitHub CLI.
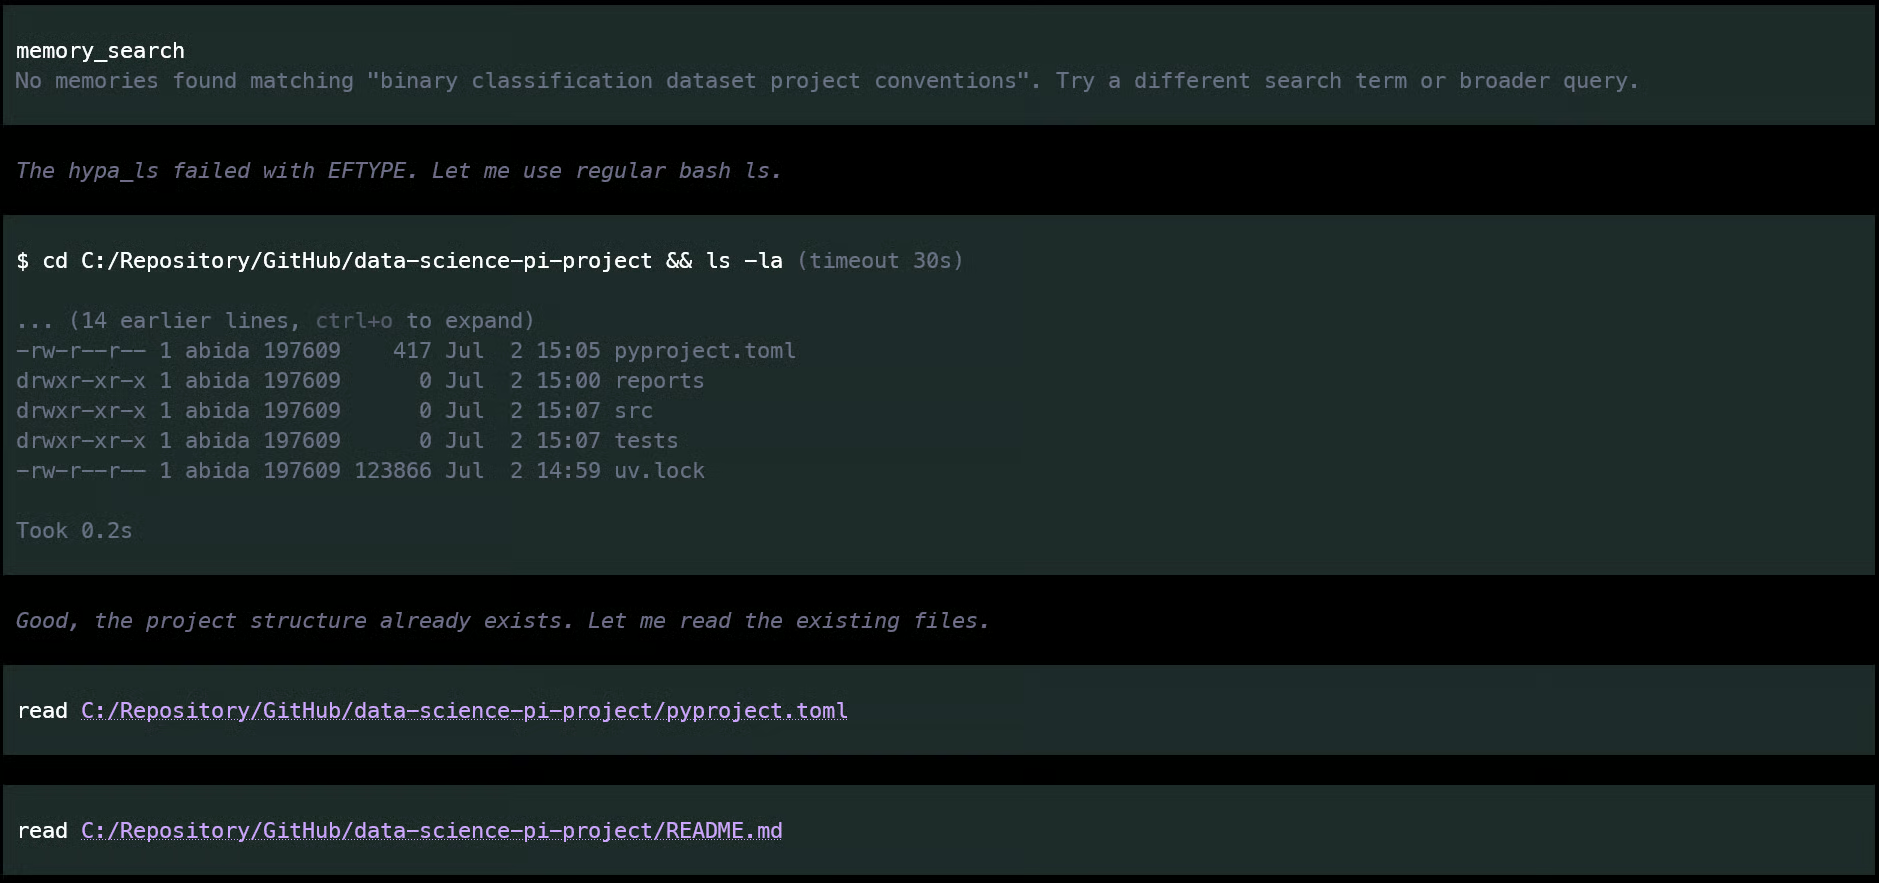
Primeiro, o Pi verificou o Hermes Memory para procurar qualquer contexto anterior relacionado ao projeto.
Como mostra a captura, não encontrou nada útil, então partiu para inspecionar o diretório atual do projeto.
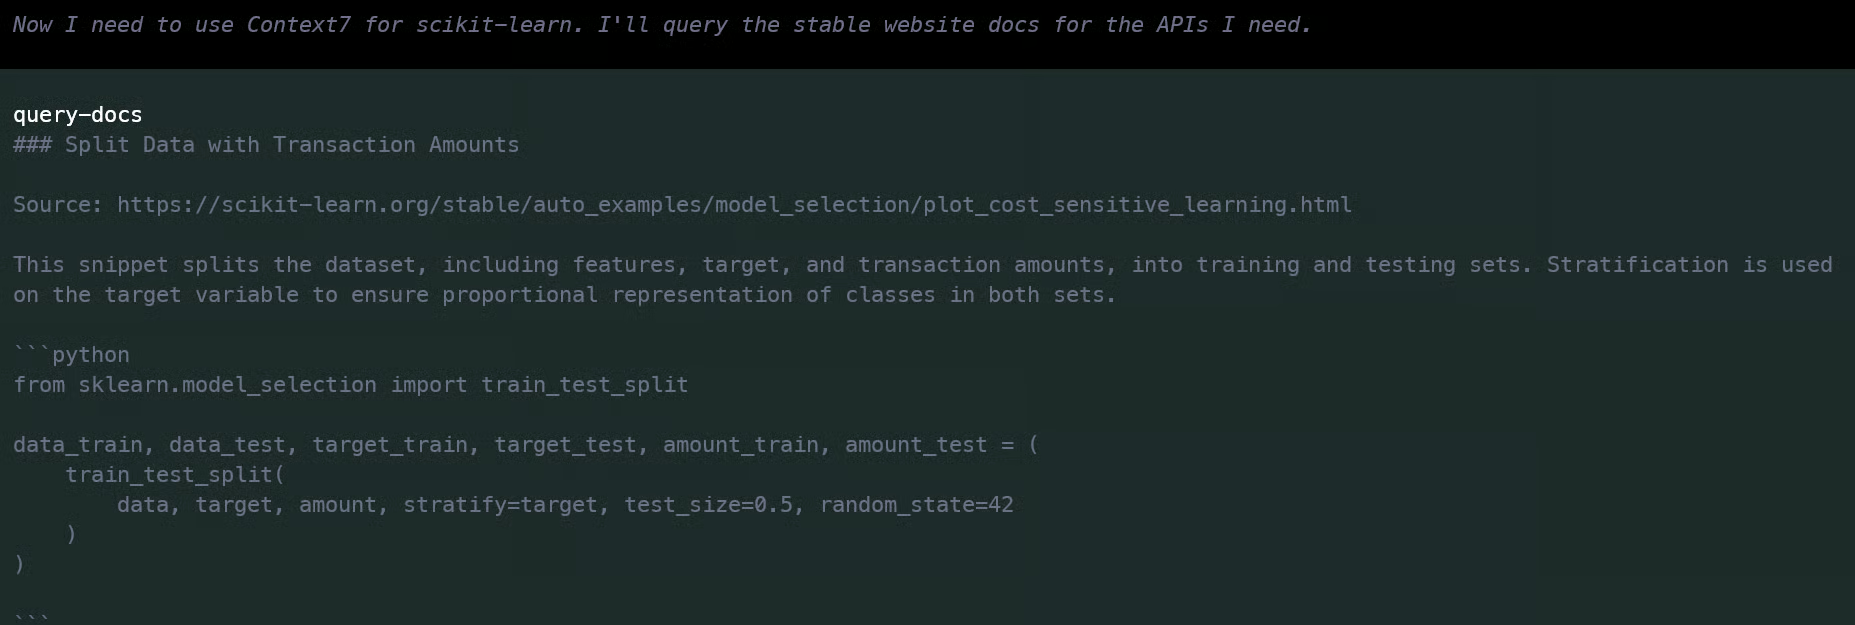
Depois de entender a estrutura do diretório, ele usou o Context7 para conferir a documentação atual de Python e scikit-learn antes de escrever os arquivos do projeto.
Isso é útil porque ajuda o agente a usar APIs atuais, em vez de depender de exemplos desatualizados.
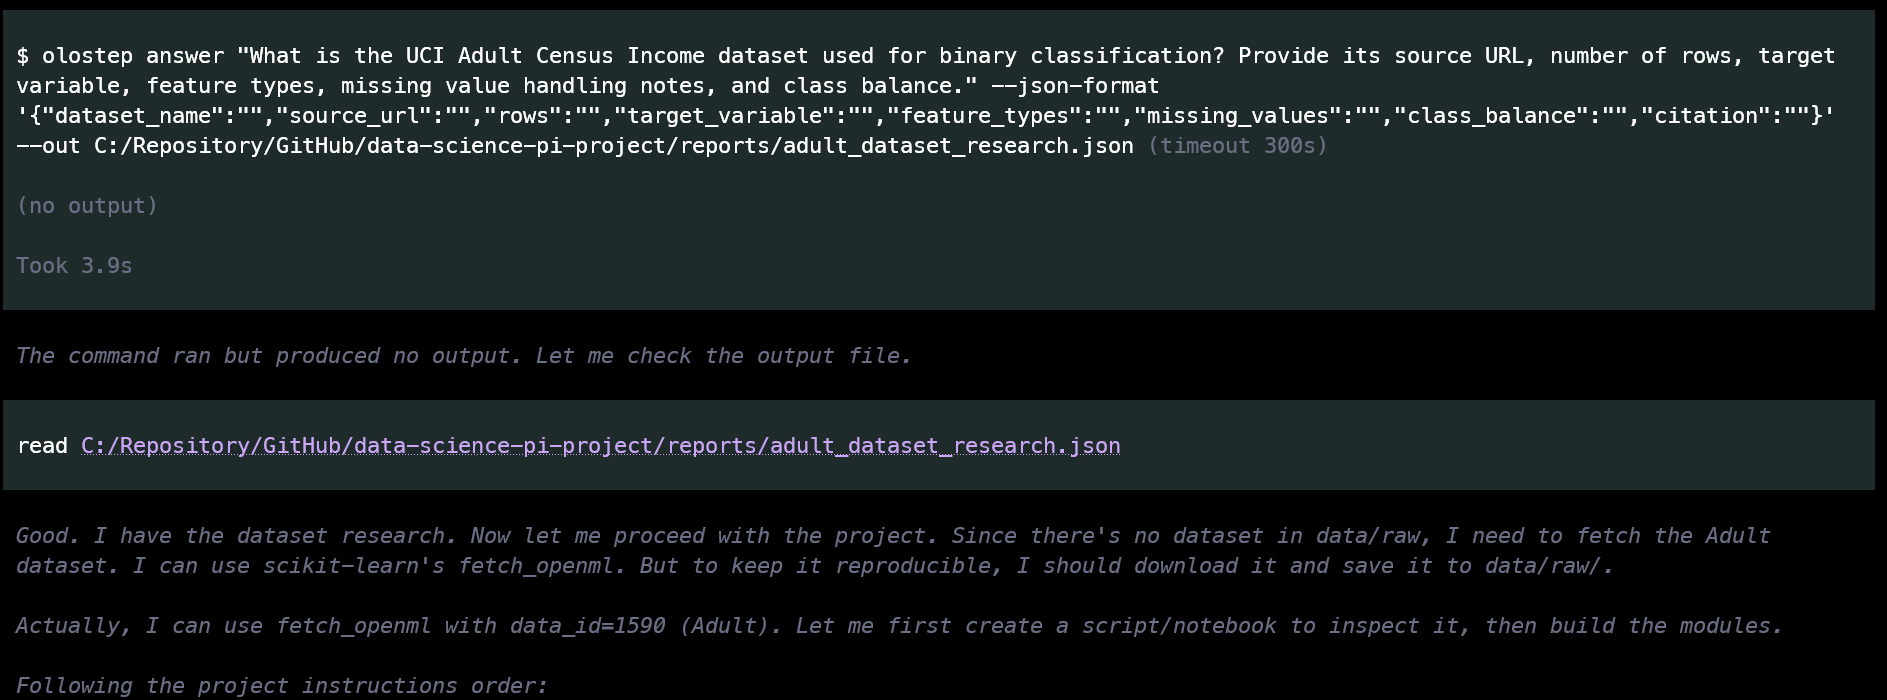
Em seguida, o Pi usou a skill de pesquisa do Olostep para procurar um dataset adequado e reunir informações relevantes para o projeto.
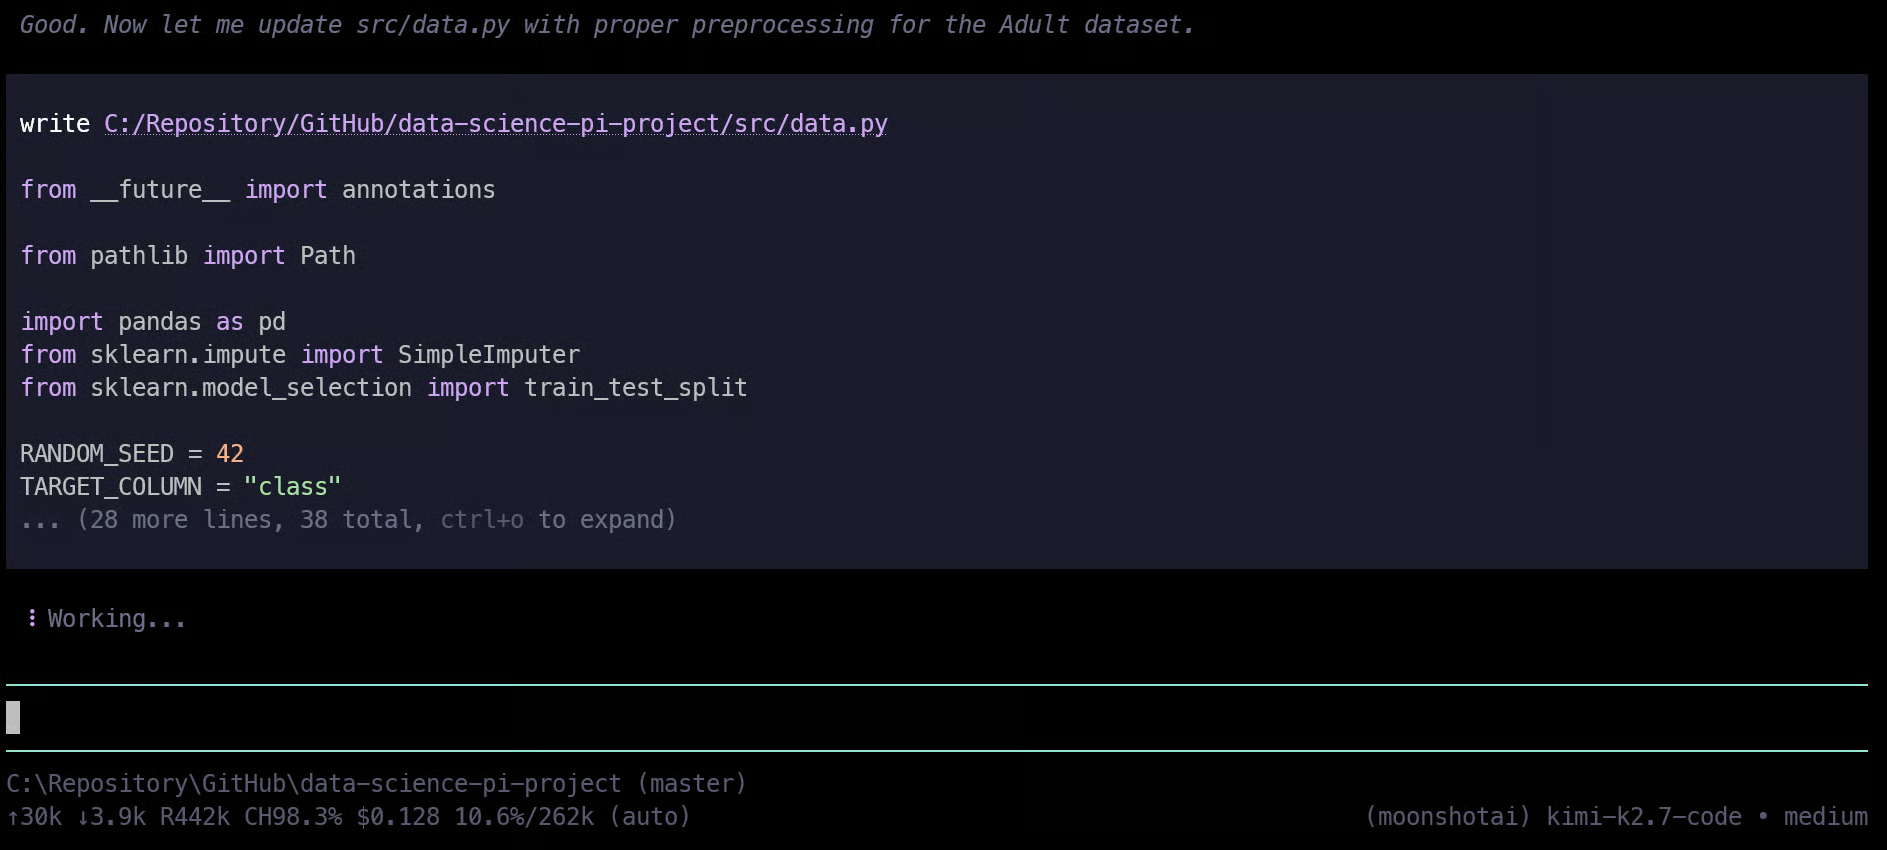
Após coletar contexto suficiente, começou a criar os arquivos um a um, incluindo o pipeline de pré-processamento, código de treino, script de avaliação, testes, README e instruções do projeto.
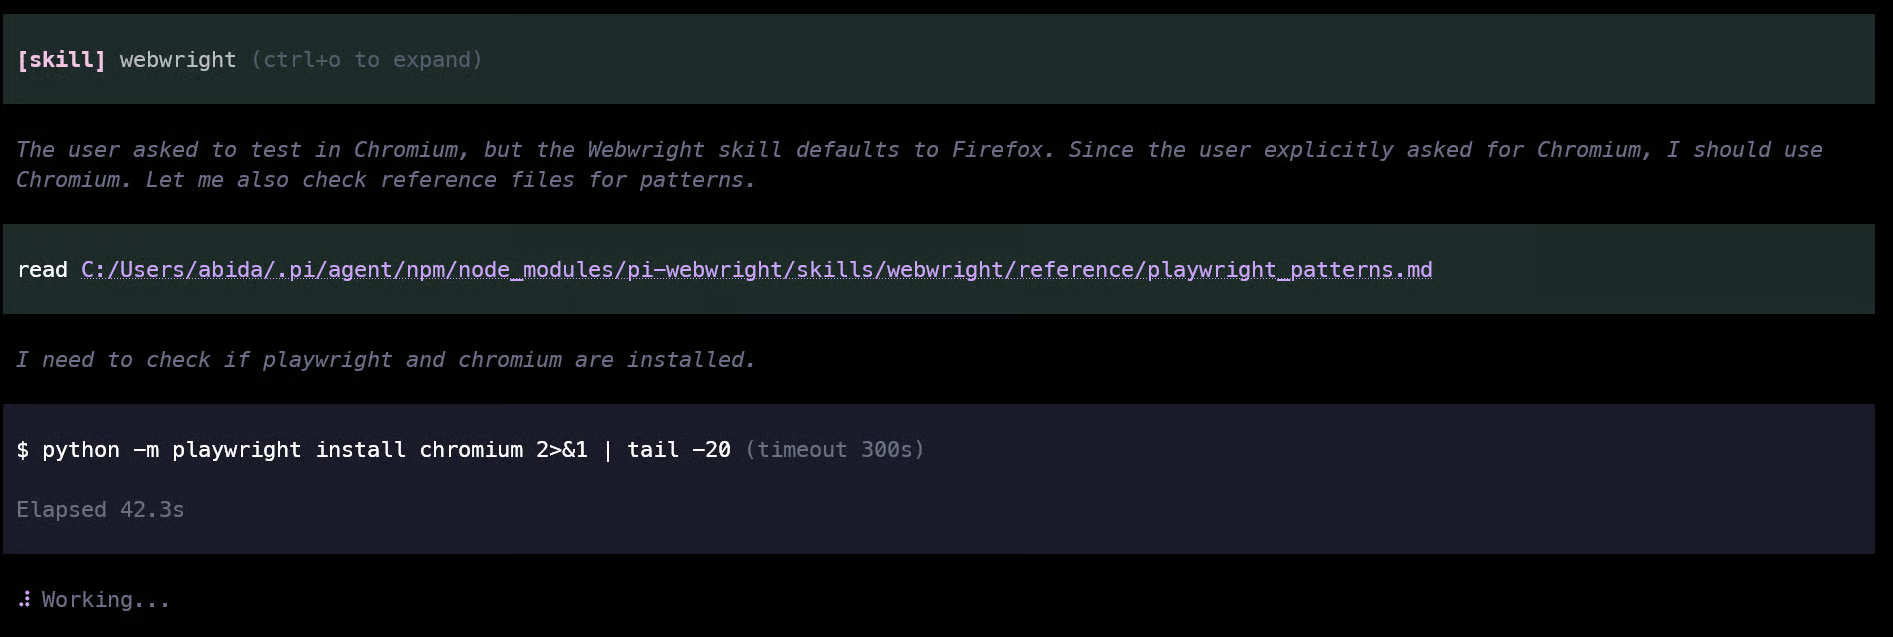
Com o workflow de ML finalizado, o Pi criou um pequeno aplicativo em Streamlit.
Depois, instalou o Chromium para o Playwright e usou o Webwright para testar a interface em um navegador real.
O teste em navegador verificou o fluxo principal do usuário, confirmou que os resultados renderizam corretamente, inspecionou erros de console e salvou prints e logs.
O Pi também rodou os testes em Python e as checagens do projeto antes de gerar o resumo final.
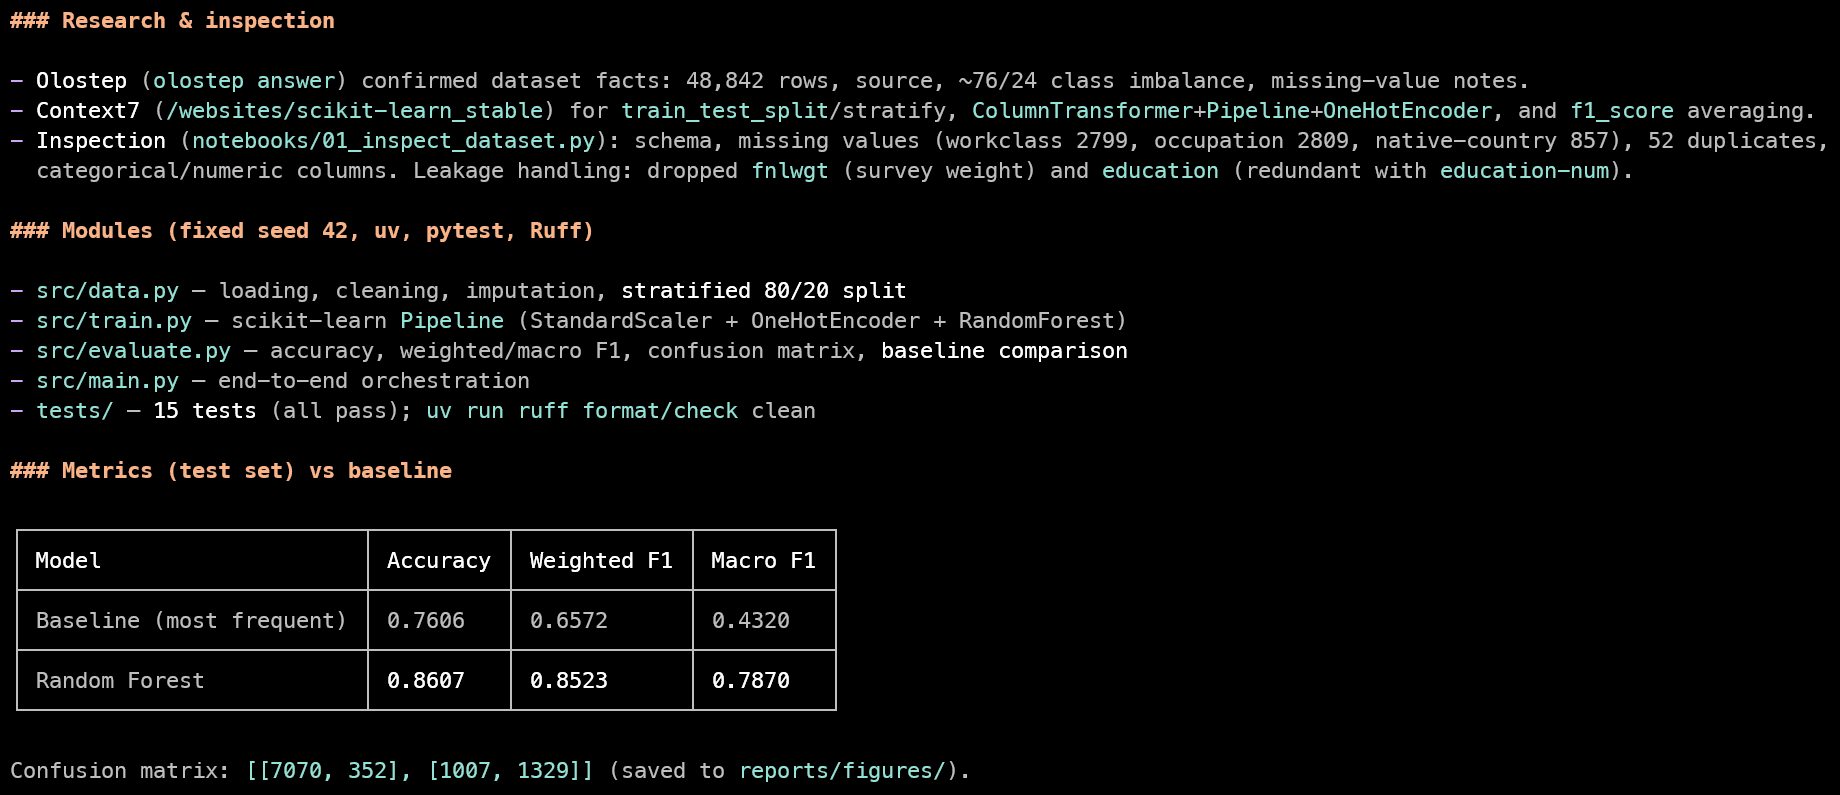
Neste teste, o modelo final alcançou cerca de 86% de acurácia e 0,85 de F1.
O Pi então fez commit das mudanças, criou um repositório no GitHub e fez push do projeto completo.
O repositório inclui o README, a estrutura do projeto, o código-fonte, os testes, os arquivos de avaliação do modelo e o aplicativo Streamlit:
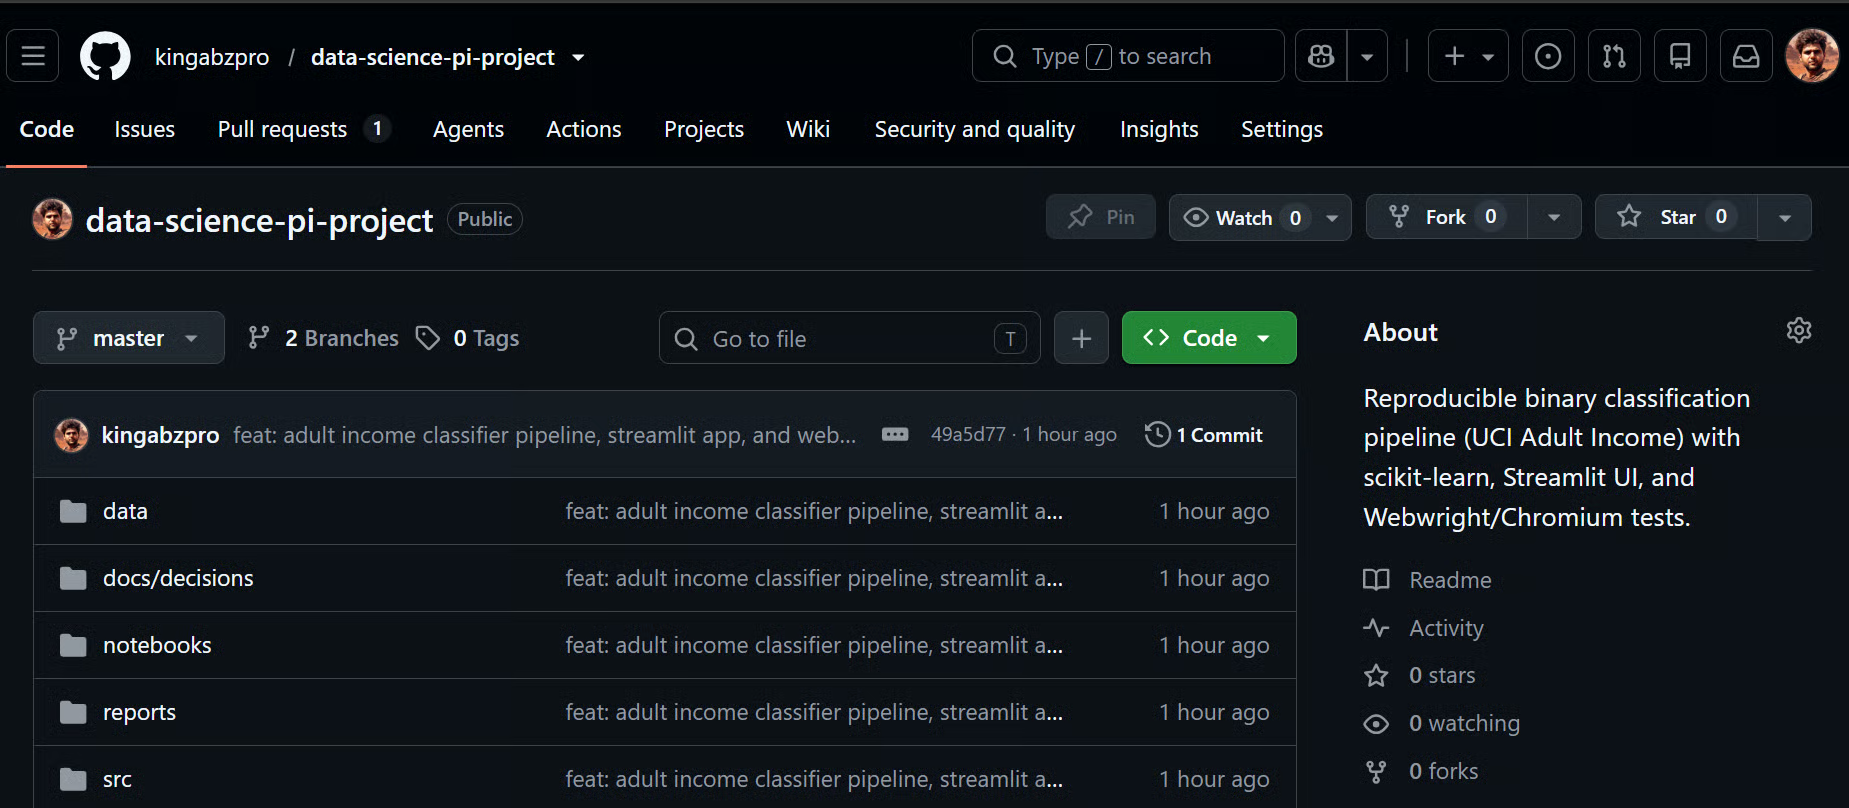
Fonte: kingabzpro/data-science-pi-project
Você pode rodar a aplicação localmente com:
streamlit run app.py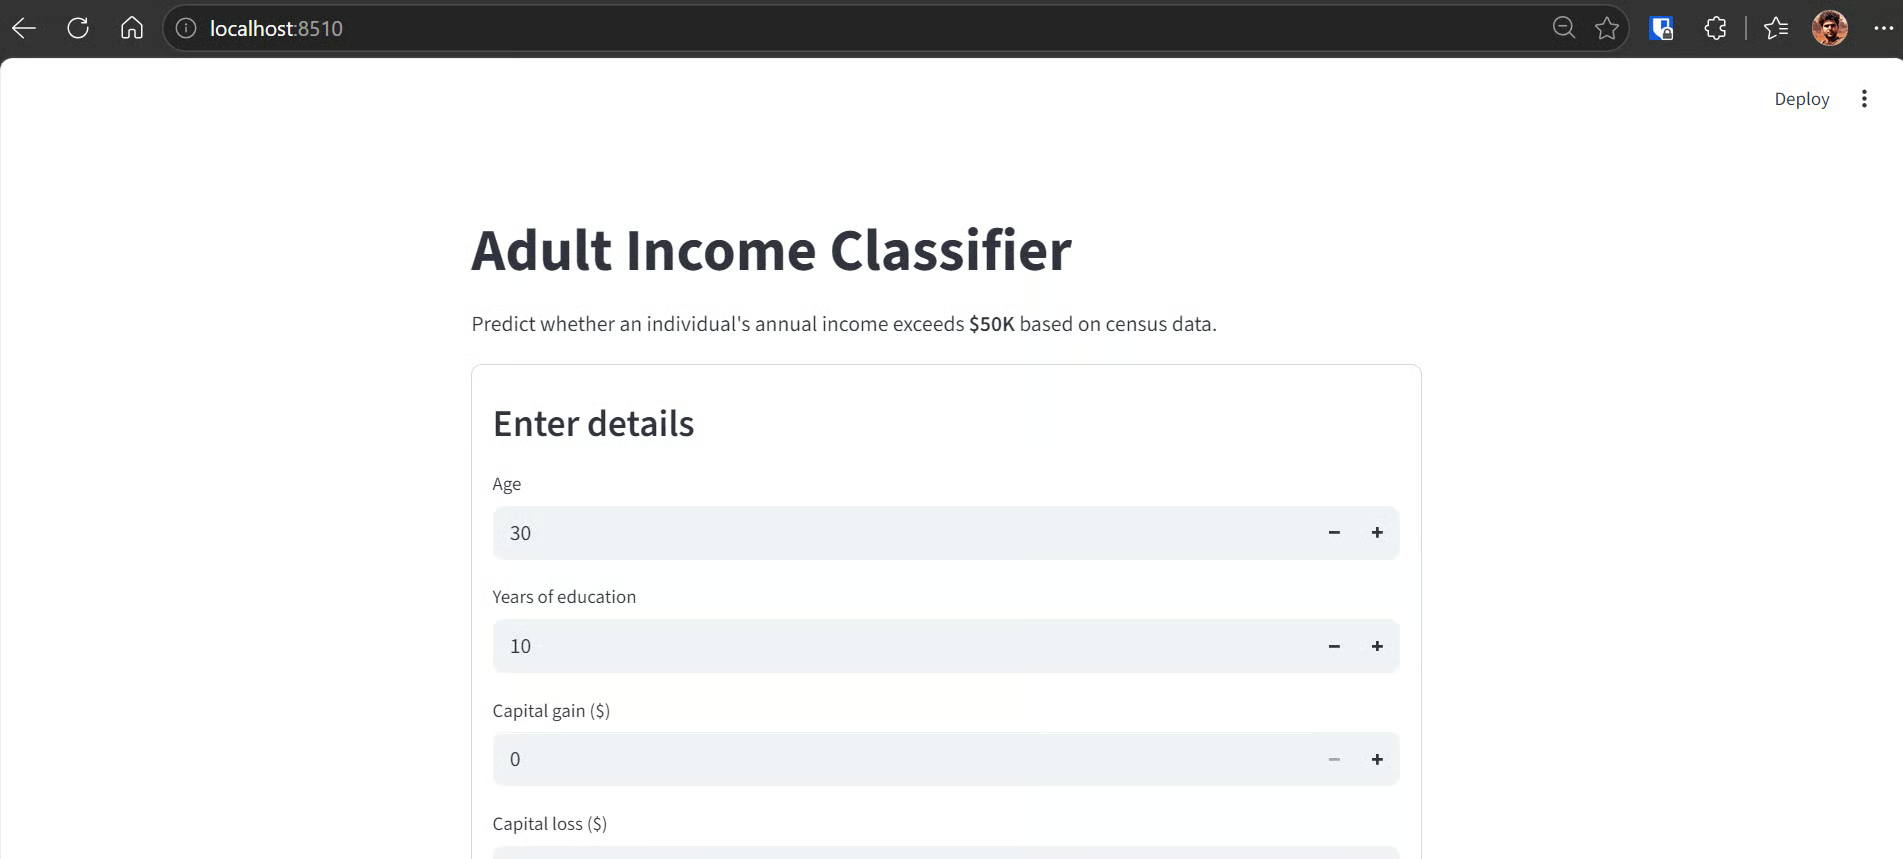
A interface é limpa e fácil de navegar, e o modelo retorna previsões rapidamente.
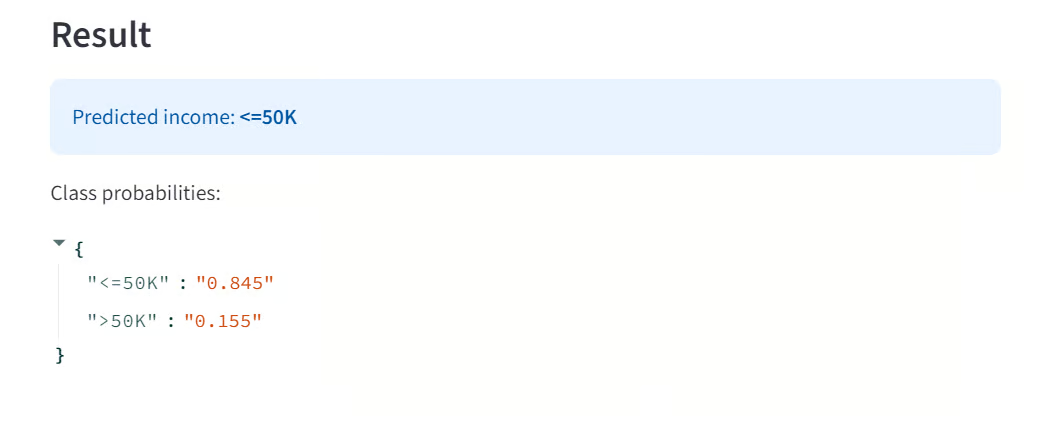
Mais importante: este teste mostra o valor do setup completo. O Pi consegue pesquisar a tarefa, inspecionar os dados, usar documentação atualizada, construir o pipeline, criar a interface, testar a experiência no navegador, validar o modelo e publicar o projeto finalizado — tudo em um só workflow.
Kimi K2.7 Code e Pi se mostraram uma combinação poderosa para trabalho prático de codificação.
O Kimi é rápido, capaz e lida bem com tarefas de engenharia em várias etapas, sem complicar decisões diretas.
Se você usa a API em vez de uma assinatura de coding, vale considerar adicionar pelo menos US$ 10 em créditos para acessar a faixa de uso superior e evitar atingir limites diários rápido demais.
O que mais me impressionou foi a pouca coordenação manual necessária depois que tudo estava configurado.
Com um prompt detalhado, o Pi verificou o Hermes Memory em busca de contexto relevante, revisou o diretório do projeto, usou o Context7 para checar a documentação atual de Streamlit e scikit-learn e recorreu ao Olostep para pesquisar o dataset e o problema.
A partir daí, criou os arquivos do projeto, construiu o pipeline de machine learning, desenvolveu o app em Streamlit e testou a interface com Webwright e Playwright.
O Pi também rodou os testes em Python, conferiu as métricas do modelo, revisou o comportamento no navegador, gerou um resumo final, fez commit das mudanças e publicou o repositório no GitHub.
No geral, a configuração pareceu menos como gerenciar manualmente um assistente de código e mais como dar direção clara a um fluxo automatizado de desenvolvimento.
Com as ferramentas certas conectadas, o Pi fez quase todo o trabalho pesado enquanto o Kimi trouxe velocidade e raciocínio para manter o processo fluindo.
Quer se aprofundar em como agentes de IA funcionam por baixo dos panos? Recomendo o curso da DataCamp Building Scalable Agentic Systems para aprender princípios de design, frameworks de teste e protocolos (como MCP) necessários para levar agentes de IA do protótipo à produção.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
8 min
blog
DataCamp Team
4 min
Tutorial
Tutorial
Moez Ali
11 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Zoumana Keita
14 min