
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
11.1K
Kimi K2.7 Code is Moonshot’s vlaggenschip-codeermodel, gebouwd voor praktische softwareontwikkelingstaken zoals code schrijven en debuggen, navigeren door grotere codebases en meerstaps engineeringwerk.
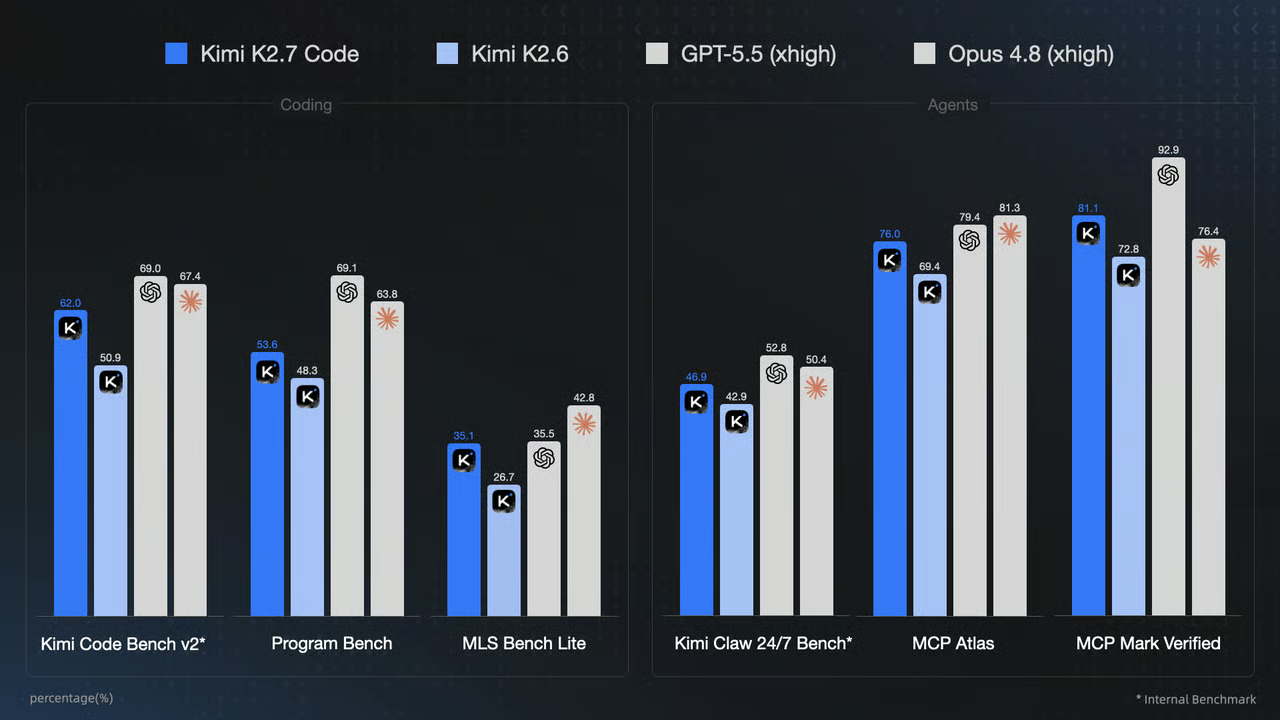
Bron: Kimi K2.7 Code: Open-Source Agentic Coding Model
Gekoppeld aan Pi, een lichtgewicht en zeer uitbreidbare coding-agent, ontstaat een flexibele lokale ontwikkelomgeving die skills, packages, commandlinetools, persistent geheugen en browsertests ondersteunt zonder onnodige complexiteit toe te voegen.
In plaats van voor elke taak een MCP te installeren, kan Pi Kimi’s redeneren combineren met betrouwbare ontwikkelaarstools zoals GitHub CLI, Vercel CLI, Hugging Face CLI, pytest, Ruff en uv.
Zo kun je vanuit één coding-agentworkflow echte projecten onderzoeken, bouwen, testen, deployen en onderhouden.
In deze gids laat ik je stap voor stap zien hoe je Kimi K2.7 Code met Pi instelt.
Je configureert je Moonshot API-sleutel, voegt Olostep toe voor research, Context7 voor actuele documentatie, Webwright voor browsertests en Hermes Memory voor context over sessies heen.
Je installeert ook handige thema’s en engineeringskills, koppelt praktische CLI’s voor GitHub, Vercel en Hugging Face, maakt een reproduceerbaar Python-datascienceproject en test de complete workflow door een kleine machinelearningapplicatie te bouwen, valideren en publiceren.
Ik raad ook aan om mijn gids te bekijken over hoe je Kimi K2.7 Code lokaal kunt draaien.
Pi is een lichtgewicht coding-agent die rechtstreeks in je terminal draait.
Hij kan met je lokale bestanden werken, commando’s uitvoeren, geïnstalleerde skills en packages gebruiken en verbinden met je favoriete codeermodel.
Kies het installatiecommando voor jouw besturingssysteem.
Windows PowerShell
powershell -c "irm https://pi.dev/install.ps1 | iex"macOS of Linux
curl -fsSL https://pi.dev/install.sh | shJe kunt Pi ook installeren via npm:
npm install -g --ignore-scripts @earendil-works/pi-coding-agentVoordat je Kimi K2.7 Code in Pi gebruikt, voeg je je Moonshot API-sleutel toe als omgevingsvariabele.
Pi kan de sleutel dan automatisch gebruiken zodra je Moonshot als modelprovider selecteert.
Windows PowerShell
setx MOONSHOT_API_KEY "your_moonshot_api_key"Sluit PowerShell na het uitvoeren van dit commando en open het opnieuw. De nieuwe omgevingsvariabele is alleen beschikbaar in nieuw geopende terminalsessies.
Git Bash, macOS of Linux
export MOONSHOT_API_KEY="your_moonshot_api_key"Dit commando geldt alleen voor de huidige terminalsessie. Wil je de sleutel behouden na het herstarten van je terminal, voeg dan dezelfde regel toe aan je shellprofiel, zoals ~/.bashrc of ~/.zshrc.
Houd je API-sleutel privé. Voeg hem niet toe aan Gitrepositories, openbare notebooks, screenshots, .env.example-bestanden of AGENTS.md.
Zodra de sleutel is ingesteld, start je Pi:
piOpen vervolgens de modelselector:
/model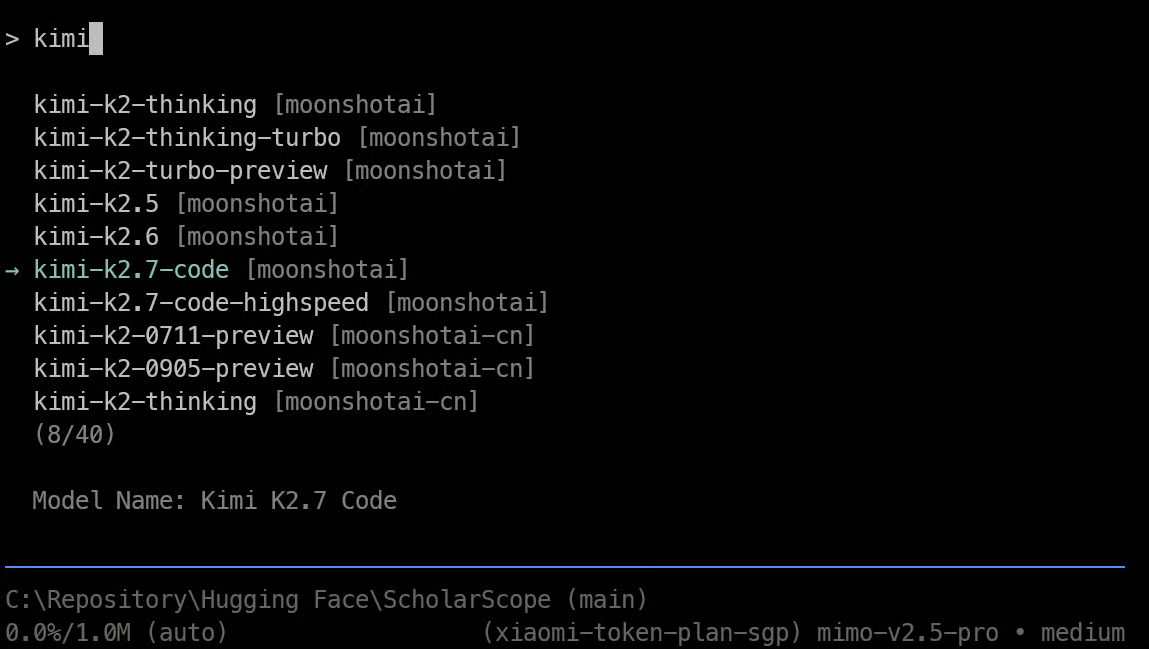
Kies moonshotai als provider en selecteer kimi-k2.7-code.
Pi zou de omgevingsvariabele MOONSHOT_API_KEY automatisch moeten detecteren en gebruiken voor authenticatie.
Olostep geeft Pi toegang tot onderzoeksworkflows voor webzoekopdrachten, scraping, documentatiecrawlen, debuggen en gestructureerde data-extractie.
Het helpt Pi actuele informatie te vinden wanneer een taak meer vereist dan de ingebouwde kennis van het model.
Maak voordat je doorgaat een Olostep-account, genereer een API-sleutel en sla deze lokaal op als een omgevingsvariabele met de naam OLOSTEP_API_KEY.
Hierdoor kunnen Pi en eventuele scripts die het maakt zich authenticeren bij Olostep zonder secrets op te slaan in je projectbestanden.
Installeer vervolgens de Olostep-skills rechtstreeks in Pi’s globale skillsmap:
npx -y olostep-cli@latest add skills \
 --no-global \
 --agent-skills-dir ~/.pi/agent/skills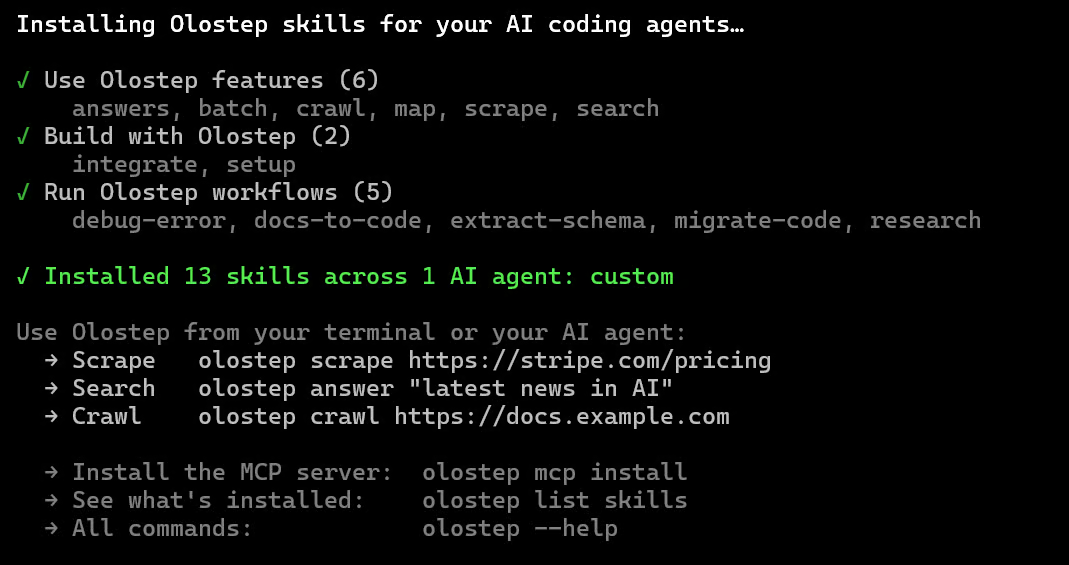
Dit installeert Olostep-skills in:
~/.pi/agent/skills/Context7 geeft Pi toegang tot actuele, versiespecifieke bibliotheekdocumentatie en codevoorbeelden. Dit helpt verouderd API-gebruik te voorkomen wanneer Pi met snel veranderende frameworks, SDK’s en Pythonpackages werkt.
Maak vóór installatie een Context7-account aan, genereer een API-sleutel via het Context7-dashboard en sla deze lokaal op als een omgevingsvariabele met de naam CONTEXT7_API_KEY.
Houd de sleutel privé en commit hem niet naar je repository en neem hem niet op in screenshots, notebooks of projectinstructiebestanden.
Installeer het officiële Context7-pakket voor Pi:
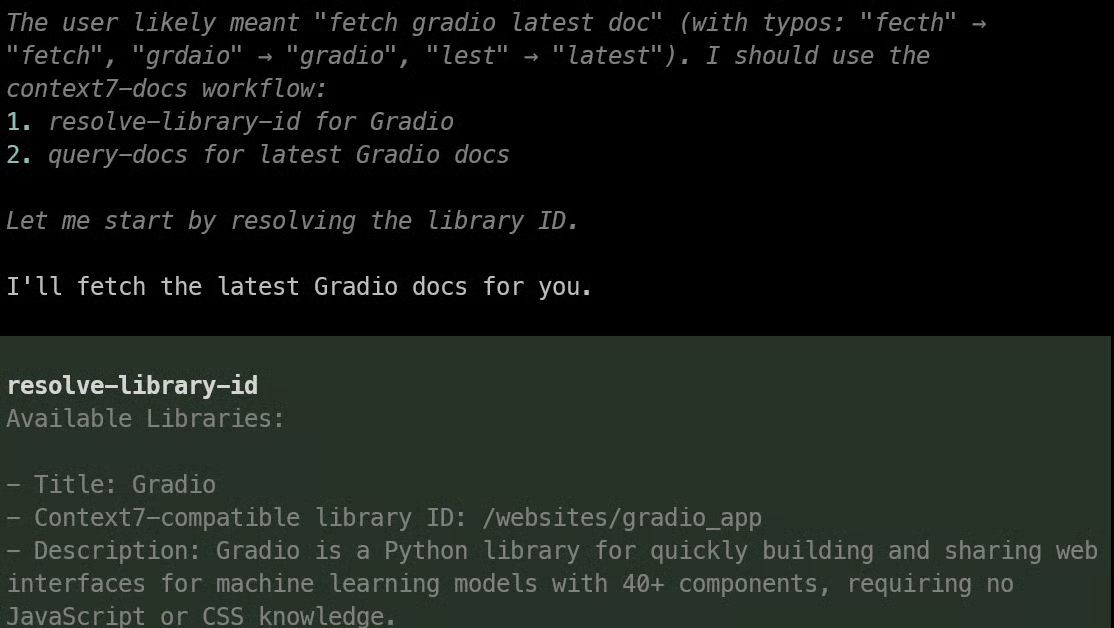
pi install npm:@upstash/context7-piDit voegt Context7-documentatietools toe, een skill die Pi aanstuurt ze te gebruiken wanneer nodig, en het /c7-docs-commando voor handmatige opzoekingen.
Na het herstarten van Pi kan het relevante documentatie ophalen voordat het code schrijft die afhankelijk is van externe bibliotheken.
Pi ondersteunt thema-pakketten van derden, waardoor je de terminalinterface eenvoudig kunt verbeteren zonder het gedrag van de agent te veranderen.
Het pakket @spences10/pi-themes bevat verschillende verzorgde donkere thema’s, waaronder Catppuccin Mocha, Dracula, Gruvbox Dark, Nord, One Dark en Tokyo Night.
Installeer het communitythema-pakket:
pi install npm:@spences10/pi-themesOpen daarna Pi:
piOpen het instellingenmenu:
/settings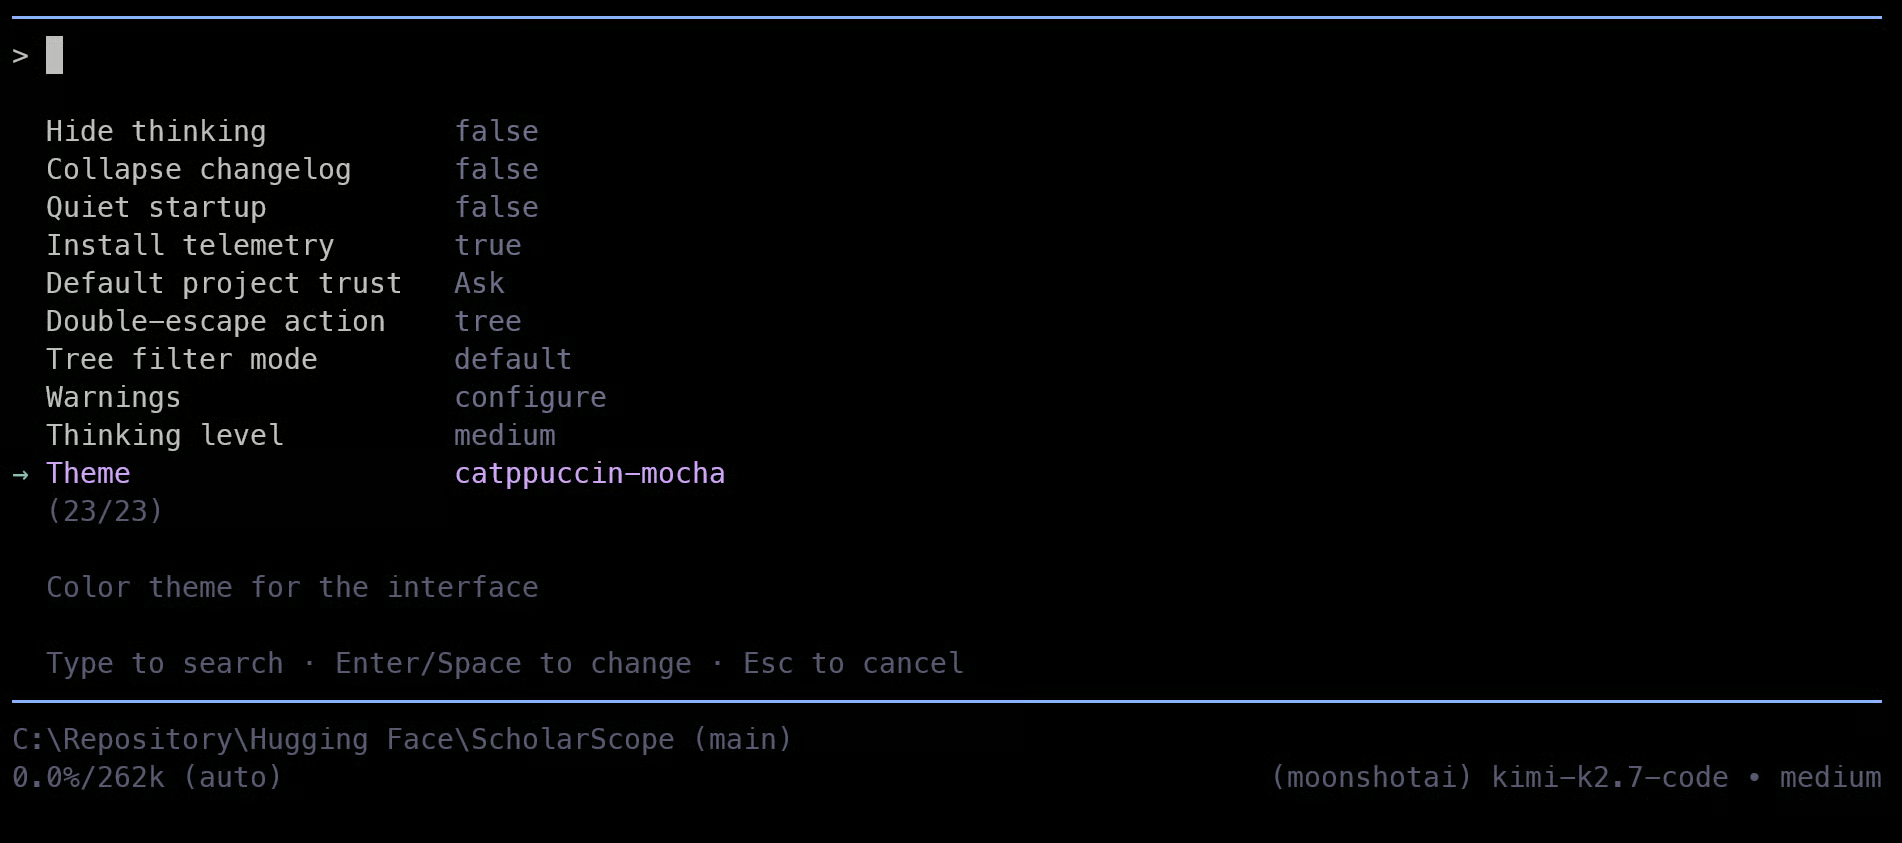
Selecteer Catppuccin Mocha uit de beschikbare thema’s. Het is een strak, donker thema met sterk contrast en een goede standaardkeuze voor langere codingsessies.
Je kunt op elk moment van thema wisselen via /settings. Pi ondersteunt ook lokaal opgeslagen thema’s en pakketgebaseerde thema’s, zodat je de interface later kunt aanpassen zonder je model, tools of projectsetup te wijzigen.
Pi is uit te breiden met herbruikbare engineeringworkflows die het consistenter maken bij plannen, debuggen, testen, code reviewen, documentatie schrijven en projecten voorbereiden voor overdracht of release.
Het pakket @barlevalon/skills levert portable SKILL.md-workflows voor deze veelvoorkomende software-engineeringtaken.
Installeer het skills-pakket:
pi install npm:@barlevalon/skills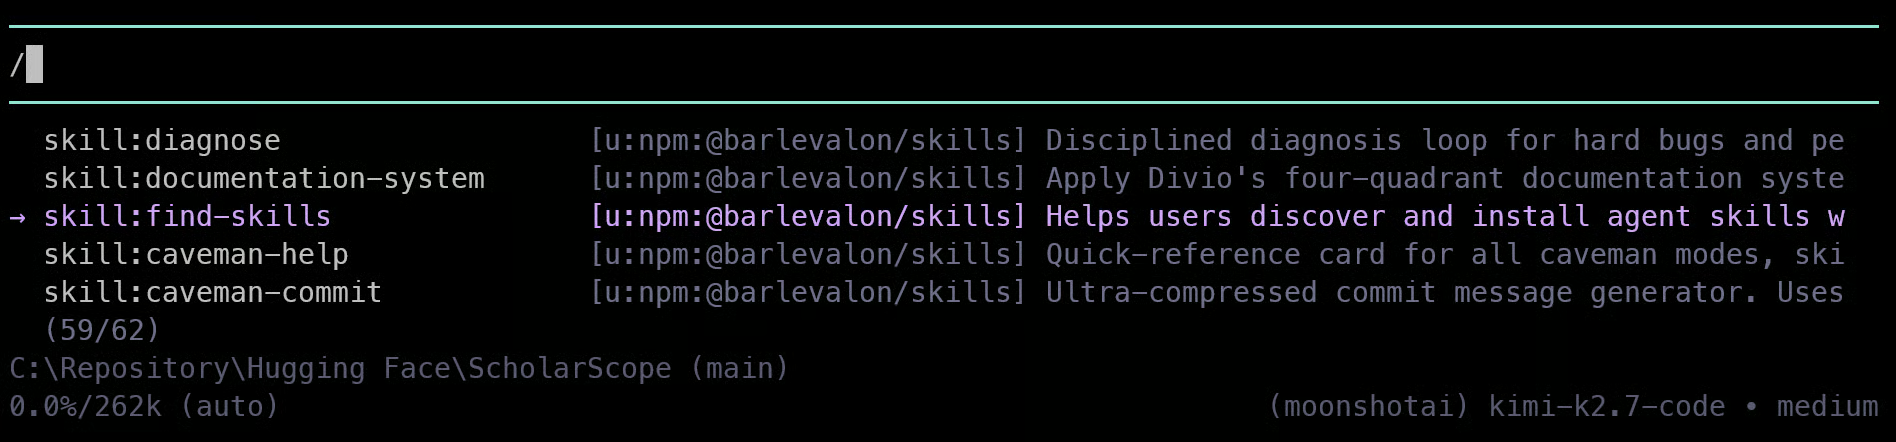
Installeer daarna Hypa om te voorkomen dat lange terminaloutput Pi’s contextvenster overneemt:
pi install npm:@hypabolic/pi-hypaHypa herschrijft ondersteunde shellcommando’s automatisch via een lokale compressielaag. Het behoudt belangrijke aanwijzingen, zoals fouten en eindresultaten, terwijl het repetitieve logs van pakketinstallaties, test suites, modelruns, builds en deployments vermindert.
Het Pi-pakket installeert Hypa ook als dependency en maakt een best-effort lokale hypa-commandoshim.
Je hebt niet voor elke service die je gebruikt een MCP, extensie of package nodig.
Voor veelvoorkomende workflows zoals repositories beheren, een app deployen, logs controleren of een model publiceren is een geauthenticeerde commandlinetool vaak eenvoudiger, betrouwbaarder en makkelijker voor Pi om te gebruiken.
Met GitHub CLI kan Pi direct vanuit de terminal werken met repositories, pull requests, issues, releases en GitHub Actions. Installeer het op Windows met:
winget install --id GitHub.cli --source wingetLog daarna in:
gh auth loginGebruik GitHub CLI wanneer je Pi een repository wilt laten inspecteren, pull requests wilt laten maken of reviewen, workflowruns wilt checken, issues wilt beheren of een project naar GitHub wilt publiceren.
Met Vercel CLI kan Pi webapplicaties deployen, projecten inspecteren, deploymentlogs bekijken en omgevingsvariabelen beheren vanuit de terminal.
npm install -g vercel
vercel login
Gebruik Vercel CLI voor previewdeployments, productiereleases, het troubleshooten van deployments, projectkoppeling en controles van omgevingsvariabelen.
De huidige commandlinetool van Hugging Face is hf, die is inbegrepen bij het pakket huggingface_hub. Installeer het met:
pip install -U huggingface_hubAuthenticeer daarna:
hf auth loginGebruik Hugging Face CLI om model-, dataset- en Space-repositories te maken en beheren; projectbestanden te uploaden; modellen of datasets te downloaden; en te bevestigen welk account momenteel is geauthenticeerd.
Unittests zijn handig om Pythonlogica te controleren, maar ze laten niet zien of een echte gebruiker je applicatie kan gebruiken.
Met Webwright kan Pi browsertests uitvoeren met Playwright tegen lokale of gedeployde apps, waaronder Streamlit, Gradio, FastAPI-frontends, React- of Next.js-projecten, Vercel-previews en Hugging Face Spaces.
Installeer Webwright in Pi:
pi install npm:pi-webwrightInstalleer daarna Chromium voor Playwright:
npx playwright install chromium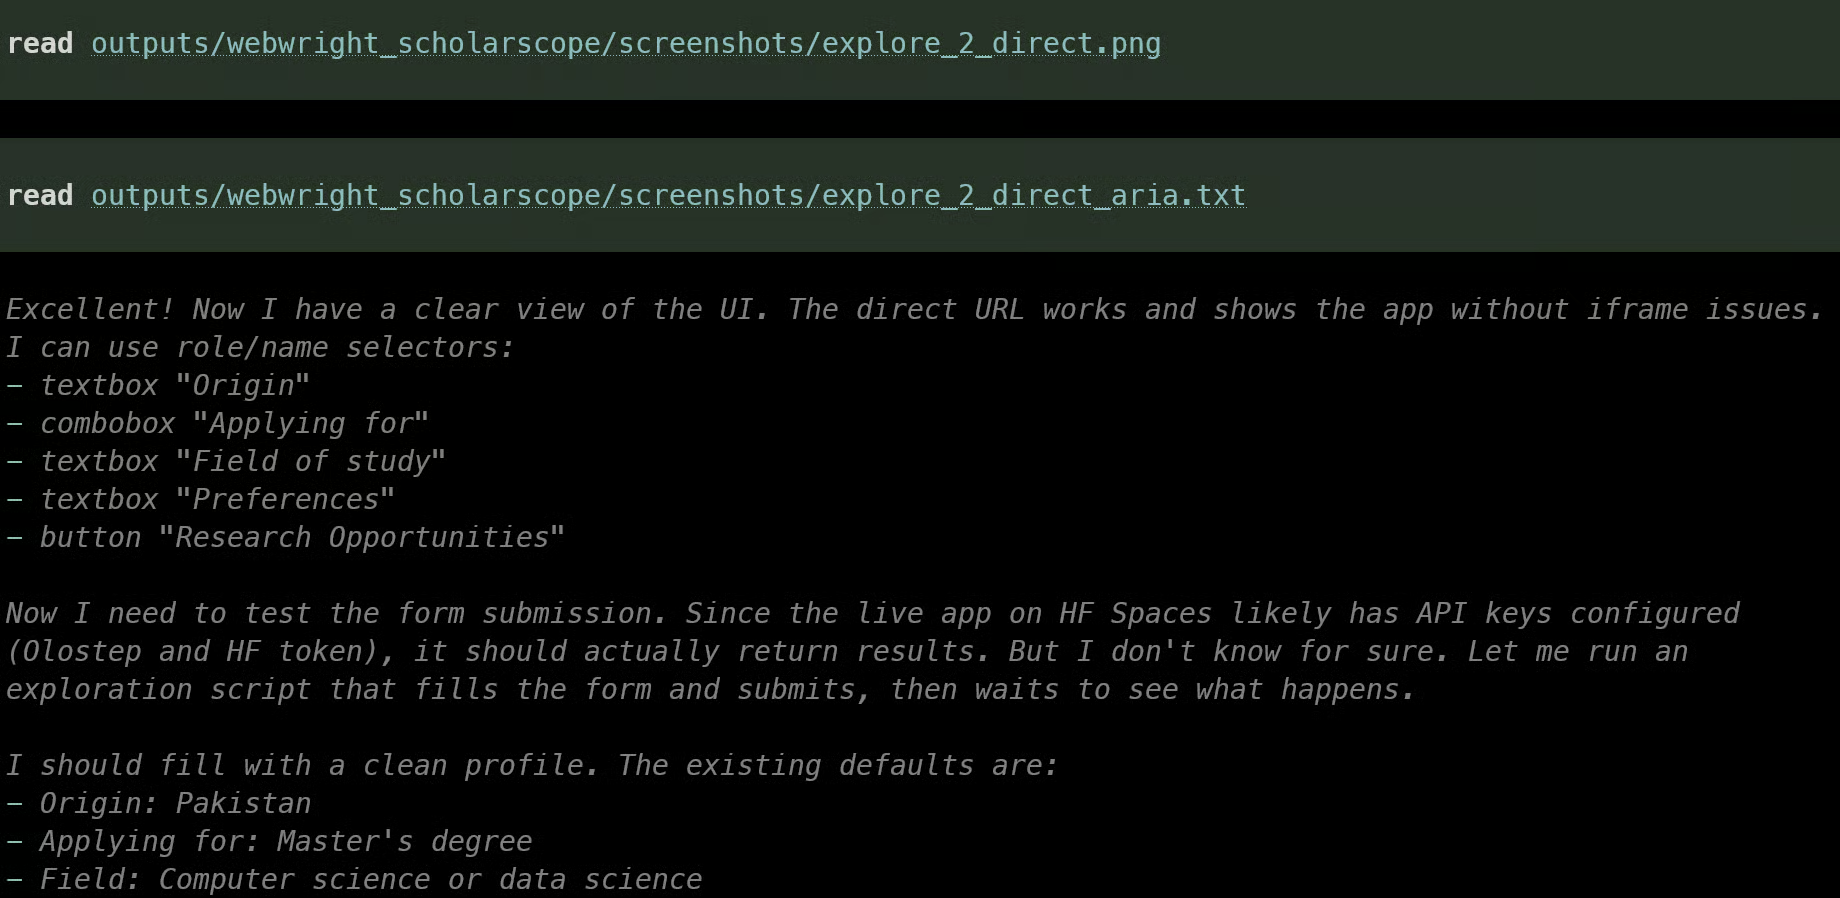
Met Webwright kan Pi de app openen in Chromium, de belangrijkste gebruikersflow testen, met formulieren of bestandsuploads interageren, controleren of resultaten correct renderen, browserfouten inspecteren en screenshots en logs opslaan.
Het pakket bevat een browsertestskill die is ontworpen voor inspecteerbare, artefactgebaseerde workflows.
Pi start elke nieuwe sessie met beperkte context uit eerder werk.
Hermes Memory voegt lokaal, persistent geheugen toe zodat Pi vorige sessies kan doorzoeken, nuttige projectcontext kan onthouden, herhaalde informatie kan consolideren en op secrets kan scannen.
Het draait lokaal, dus je hebt geen aparte hosted-memory API-sleutel nodig.
Installeer Hermes Memory:
pi install npm:pi-hermes-memoryHerstart Pi na installatie.
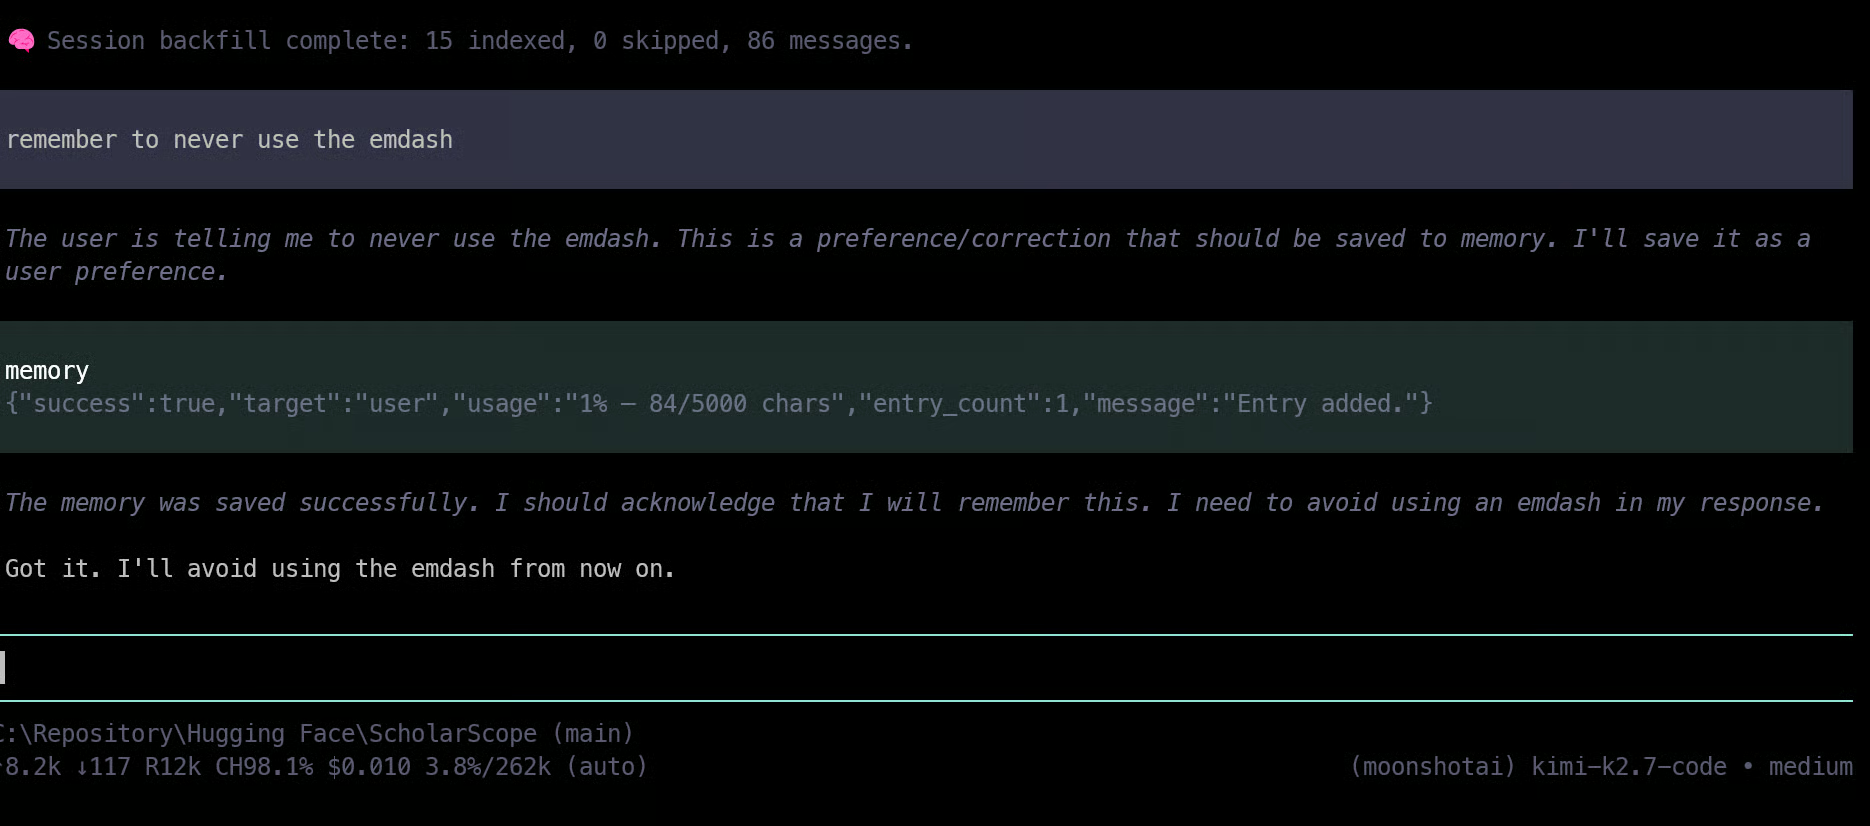
Gebruik Hermes Memory naast duidelijke projectdocumentatie:
Houd MEMORY.md en docs/decisions/ als de zichtbare bron van waarheid voor je project.
Hermes Memory helpt Pi door te werken over sessies heen, terwijl Markdownbestanden de context makkelijk te inspecteren maken voor jou of een andere bijdrager later.
Een sterke Pi-setup heeft ook een duidelijke projectstructuur nodig.
Dit houdt je experimenten, code, tests, data en resultaten georganiseerd, zodat Pi wijzigingen kan aanbrengen zonder tijdelijk notebookwerk te vermengen met herbruikbare pipelinecode.
Maak een nieuw project en initialiseer het met uv:
mkdir data-science-pi-project
cd data-science-pi-project
uv init
uv add pandas scikit-learn matplotlib pytest ruff
Gebruik deze structuur:
data-science-pi-project/
├── AGENTS.md
├── MEMORY.md
├── README.md
├── src/
│   ├── data.py
│   ├── train.py
│   └── evaluate.py
├── tests/
├── notebooks/
├── data/
│   ├── raw/
│   └── processed/
├── reports/
│   ├── figures/
│   └── metrics/
└── docs/
    └── decisions/
Bewaar herbruikbare code voor dataladen, preprocessing, training en evaluatie in src/.
Gebruik notebooks/ alleen voor verkenning en snelle experimenten.
Sla ongewijzigde bronbestanden op in data/raw/, opgeschoonde data in data/processed/, en bewaar grafieken, metriek en modeluitvoer in reports/.
Maak een AGENTS.md-bestand zodat Pi de juiste workflow volgt bij het werken in de repository:
# Project Rules

- Use Olostep for current research and Context7 for library documentation.
- Inspect the dataset, missing values, duplicates, leakage risks, class balance, and baseline before training.
- Keep reusable logic in `src/`, not notebooks.
- Add tests when changing preprocessing or evaluation behaviour.
- Run formatting, linting, and tests before declaring work complete.
- Record important decisions in `docs/decisions/`.
Dit geeft Pi een herhaalbare workflow voor het bouwen van datascienceprojecten die makkelijker te testen, onderhouden en verbeteren zijn.
Tijd om de complete Pi-setup te testen in een echt project. Voor dit voorbeeld vroeg ik Pi om een reproduceerbare binaire classificatieapplicatie te bouwen voor studentplaatsingsvoorspelling op basis van factoren zoals academische prestaties, stages, projecten, certificeringen en skills.
Start Pi vanuit je projectmap:
piGeef Pi vervolgens de volgende prompt:
Build a simple, reproducible Python machine-learning project for a binary classification problem.
First inspect the dataset for schema, missing values, duplicates, categorical columns, leakage risks, class balance, and a suitable stratified train/test split.
Use Olostep for any current research or dataset references, and Context7 before using scikit-learn APIs.

Create clear modules for data loading/preprocessing, model training, evaluation, tests, a short README, and project rules.
Use a fixed random seed, uv, pytest, and Ruff.
Als de modelworkflow werkt, bouw dan een kleine Streamlit- of Gradio-interface en test die in Chromium met Webwright, inclusief de belangrijkste gebruikersreis, weergave van resultaten, consolefouten, screenshots en logs.
Rapporteer accuracy, gewogen F1, macro F1, een baselinevergelijking en een verwarringsmatrix. Initialiseer en push de repository met GitHub CLI.
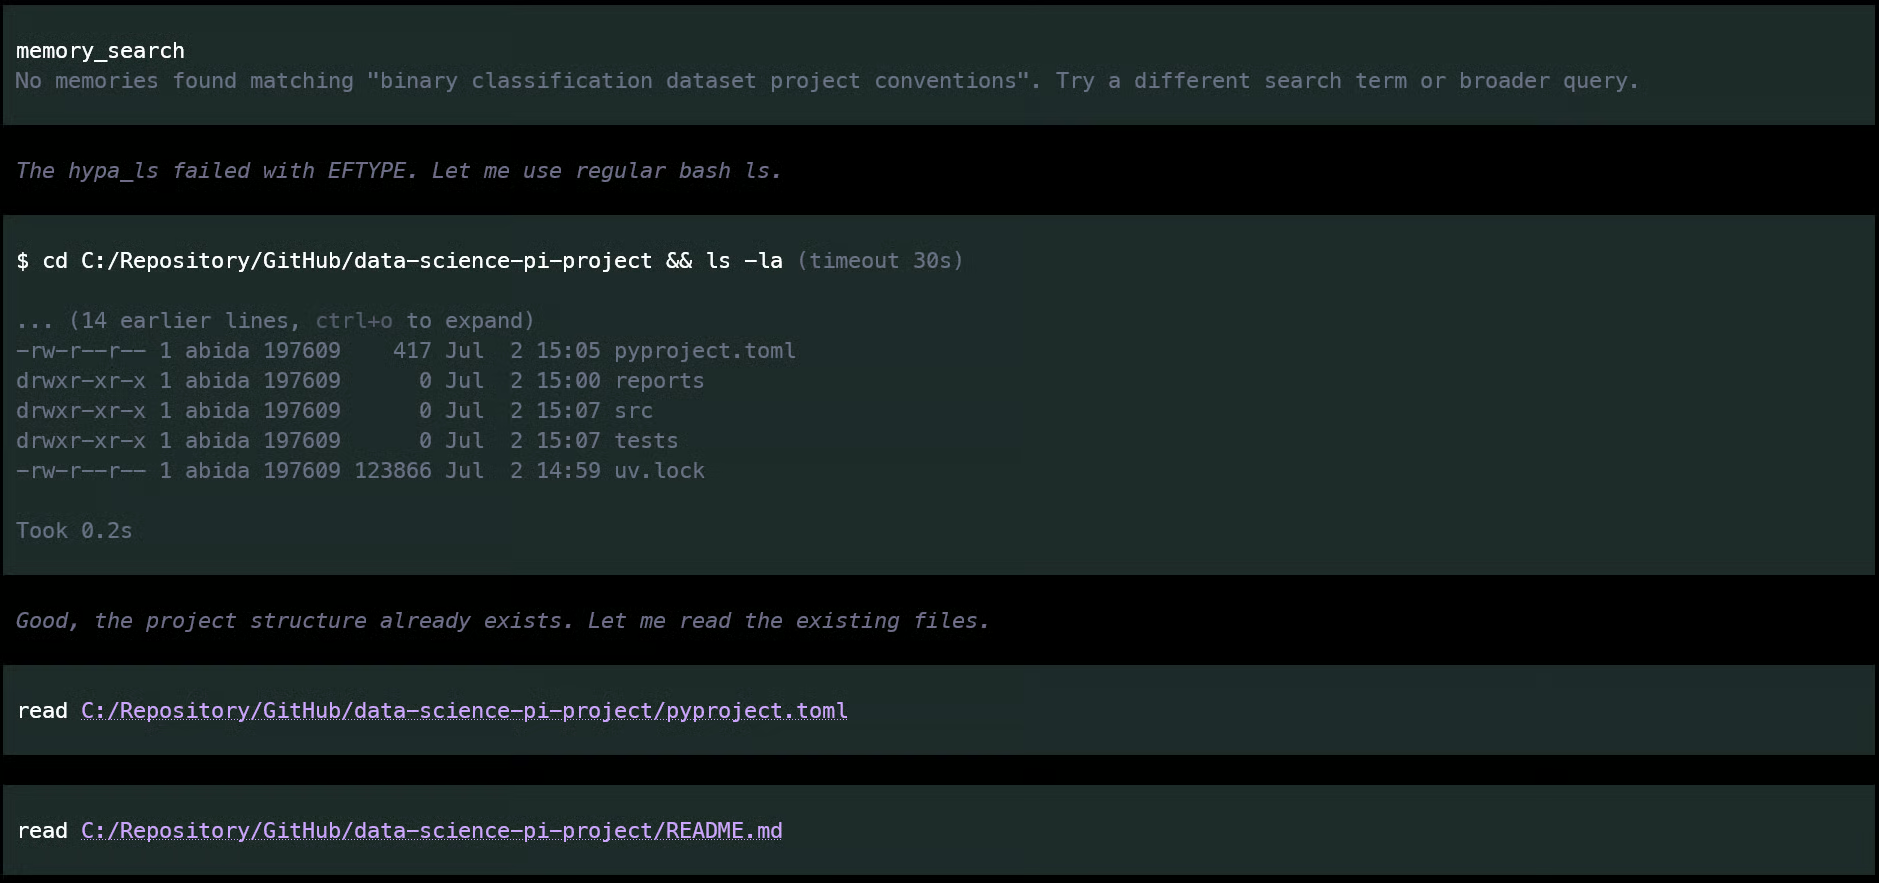
Pi controleerde eerst Hermes Memory op eerdere context die met het project te maken had.
Zoals in de screenshot te zien is, vond het niets bruikbaars, dus ging het verder met het inspecteren van de huidige projectmap.
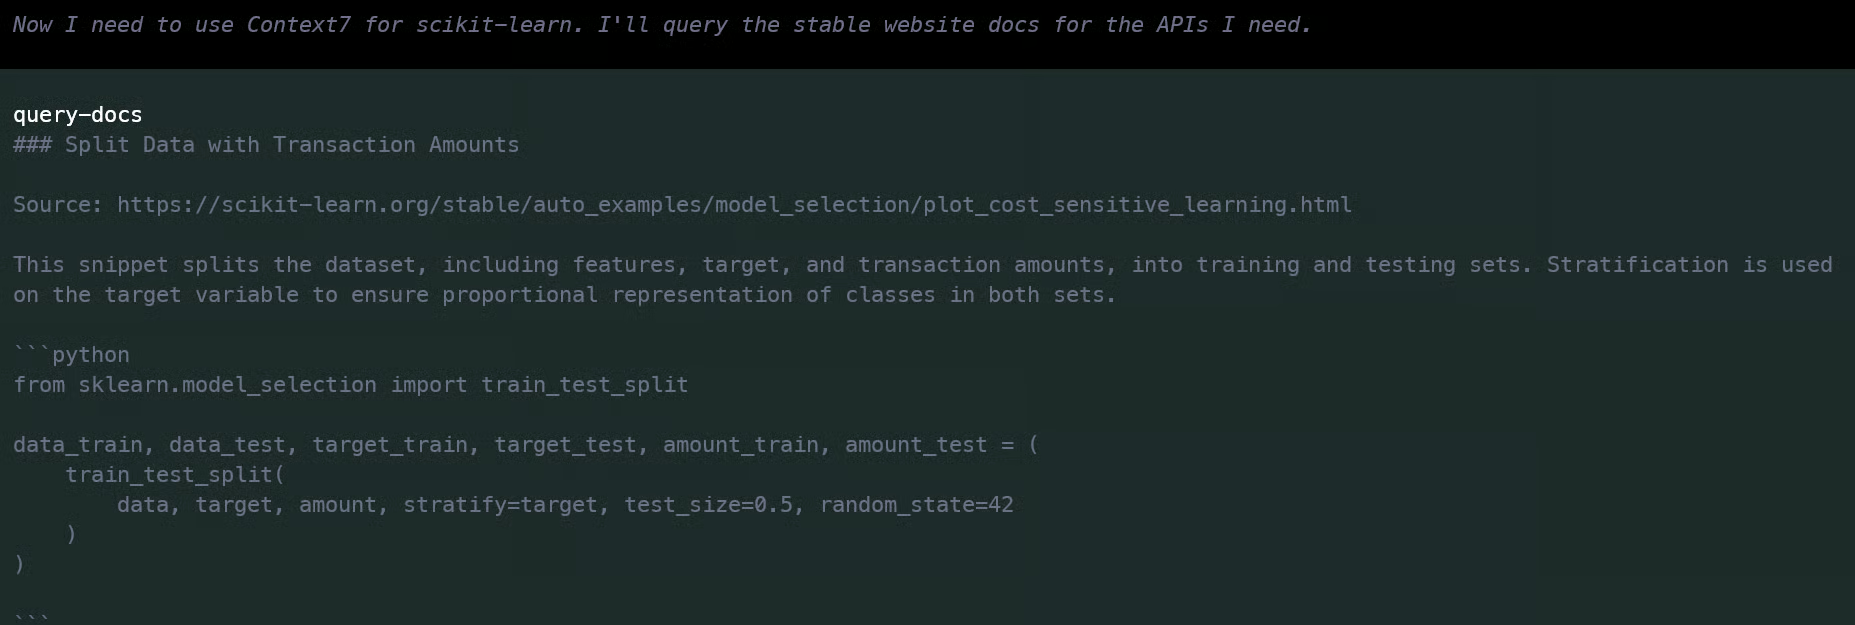
Toen Pi de mapstructuur begreep, gebruikte het Context7 om de huidige Python- en scikit-learn-documentatie te checken voordat het de projectbestanden schreef.
Dit is handig omdat het de agent helpt actuele API’s te gebruiken in plaats van te vertrouwen op verouderde voorbeelden.
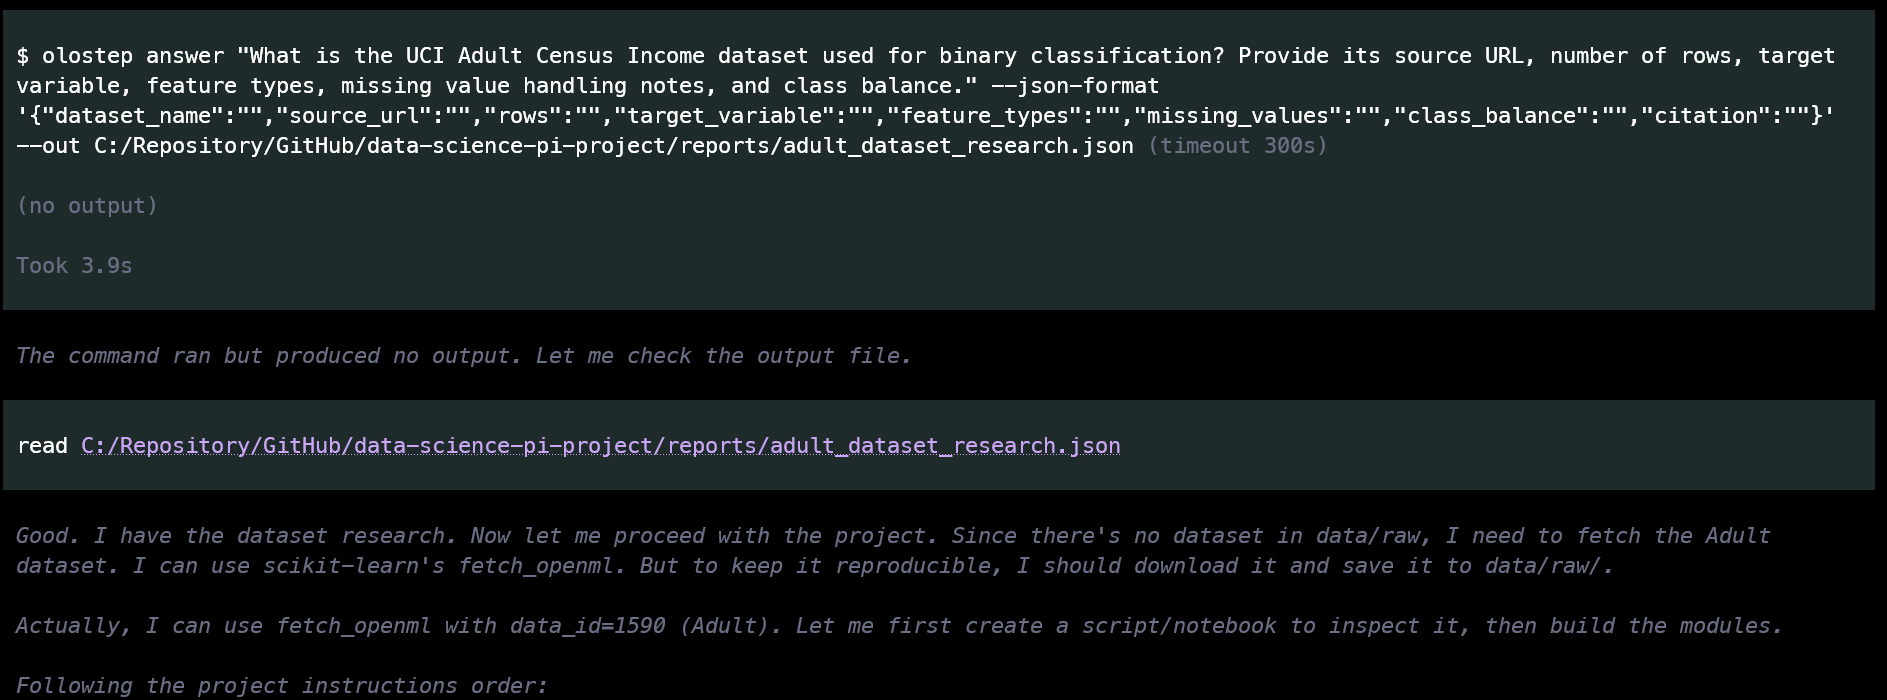
Vervolgens gebruikte Pi de Olostep-researchskill om een geschikte dataset te zoeken en relevante informatie voor het project te verzamelen.
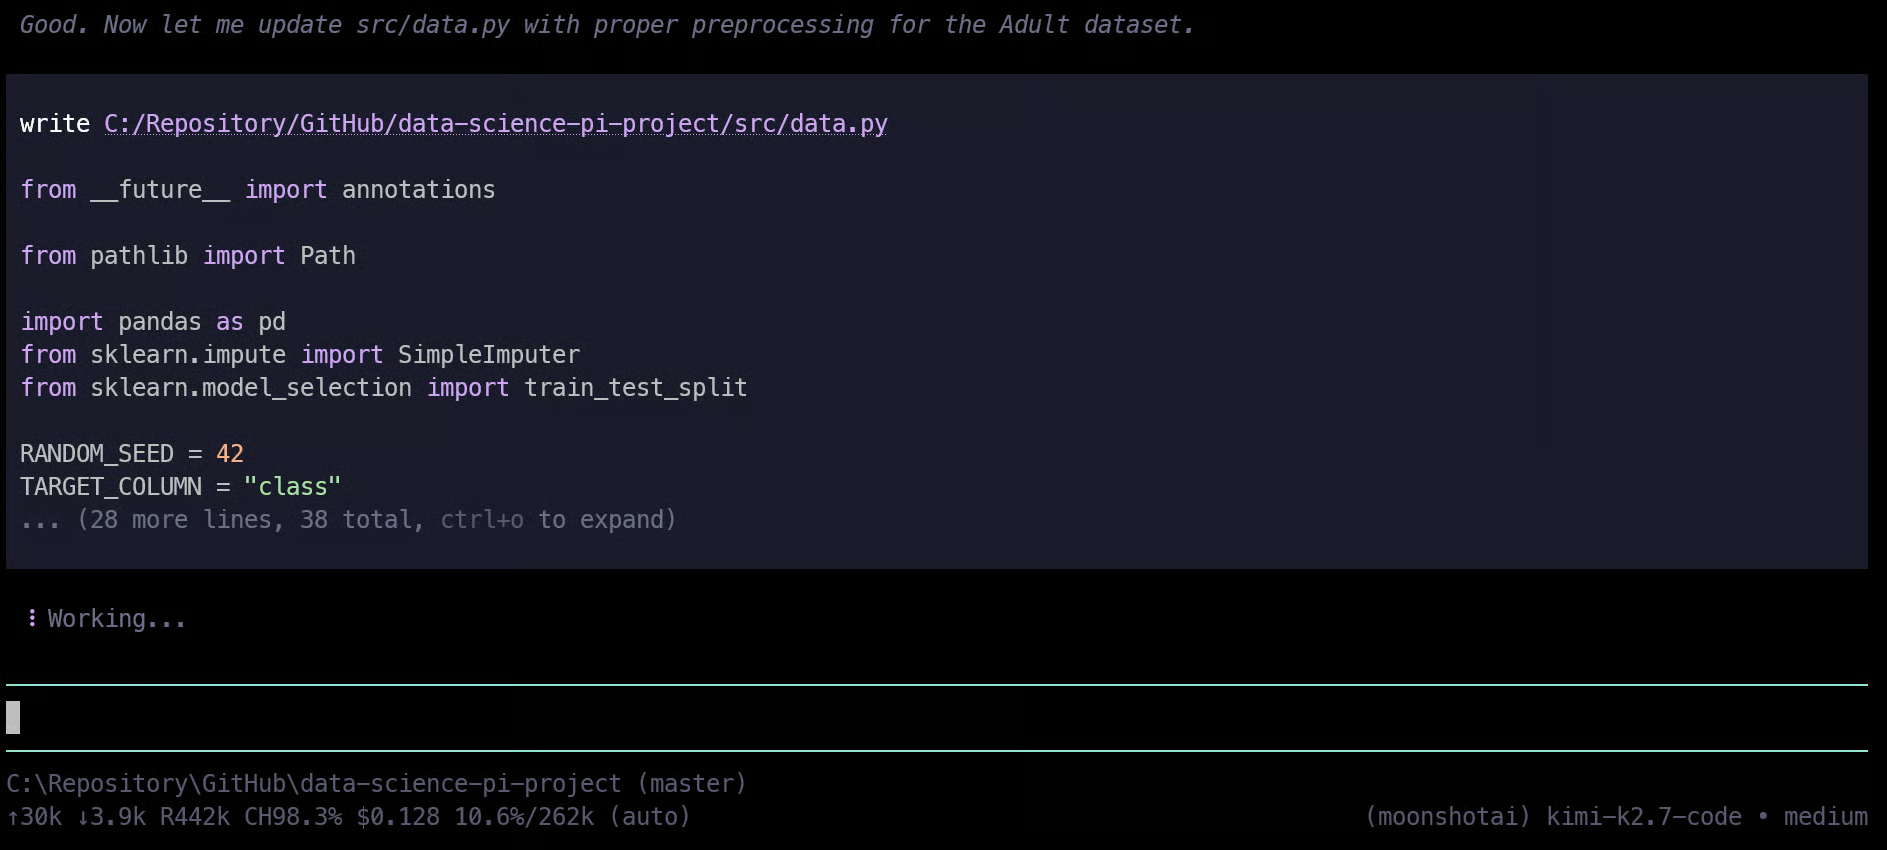
Na voldoende context te hebben verzameld, begon het de bestanden één voor één te creëren, inclusief de preprocessingpipeline, trainingscode, evaluatiescript, tests, README en projectinstructies.
Nadat de machinelearningworkflow klaar was, maakte Pi een kleine Streamlit-applicatie.
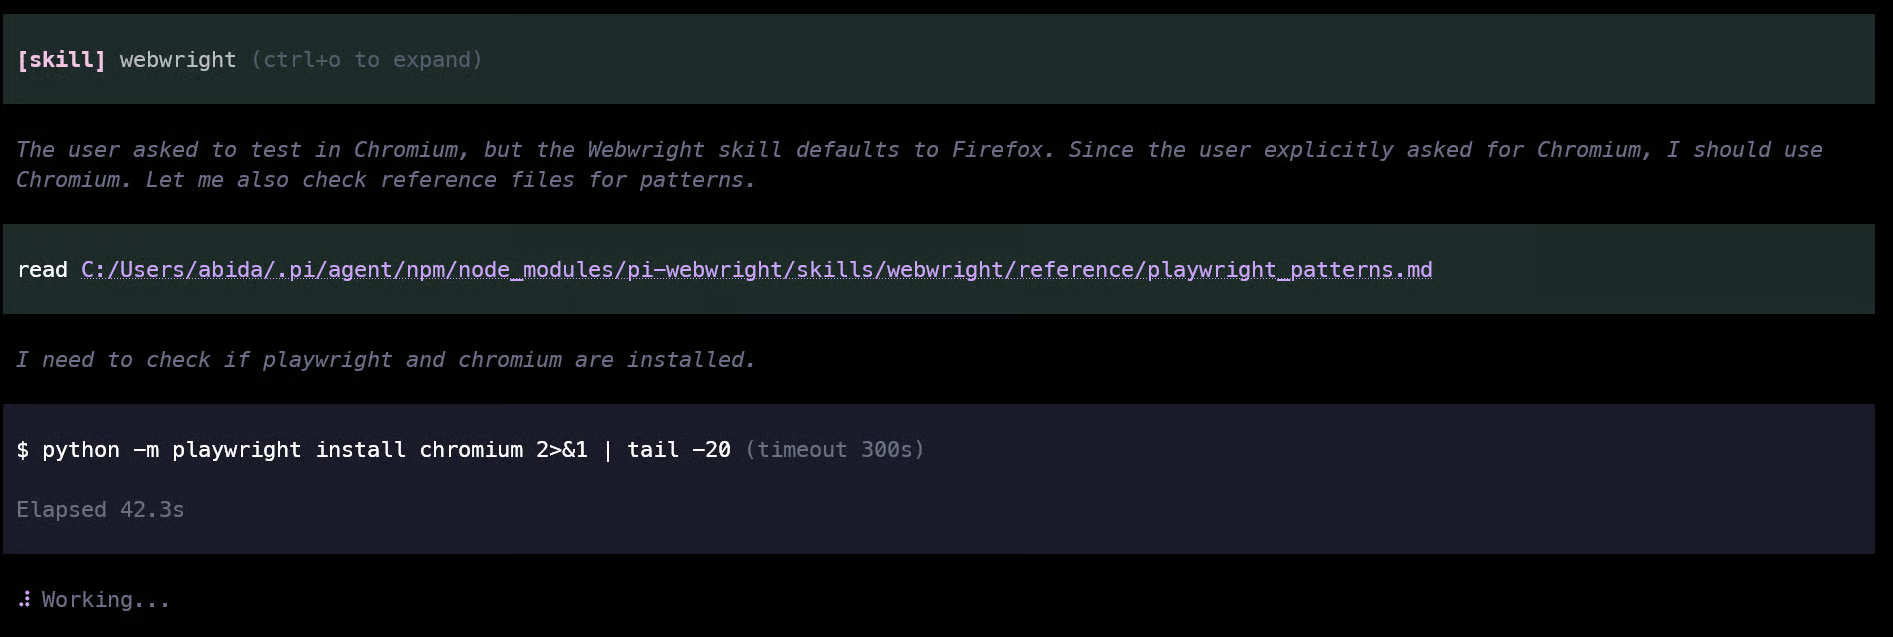
Daarna installeerde het Chromium voor Playwright en gebruikte Webwright om de interface in een echte browser te testen.
De browsertest controleerde de belangrijkste gebruikersflow, valideerde dat resultaten correct werden gerenderd, inspecteerde consolefouten en sloeg screenshots en logs op.
Pi draaide ook de Pythontests en projectchecks voordat de uiteindelijke samenvatting werd gegenereerd.
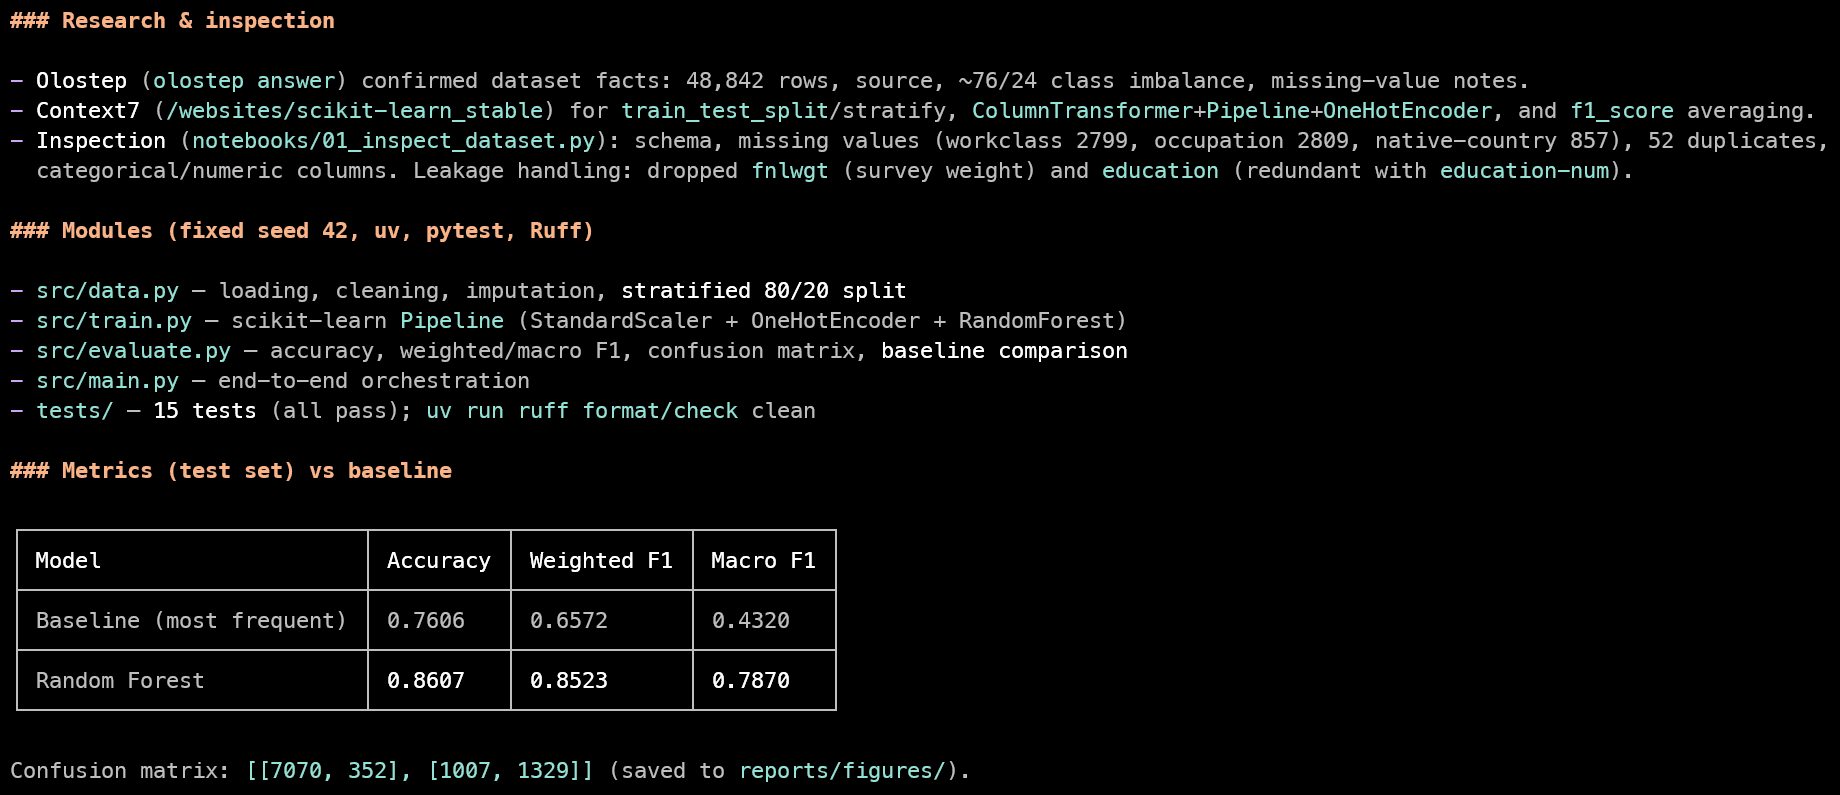
In deze test behaalde het eindmodel ongeveer 86% accuracy en een F1-score van 0,85.
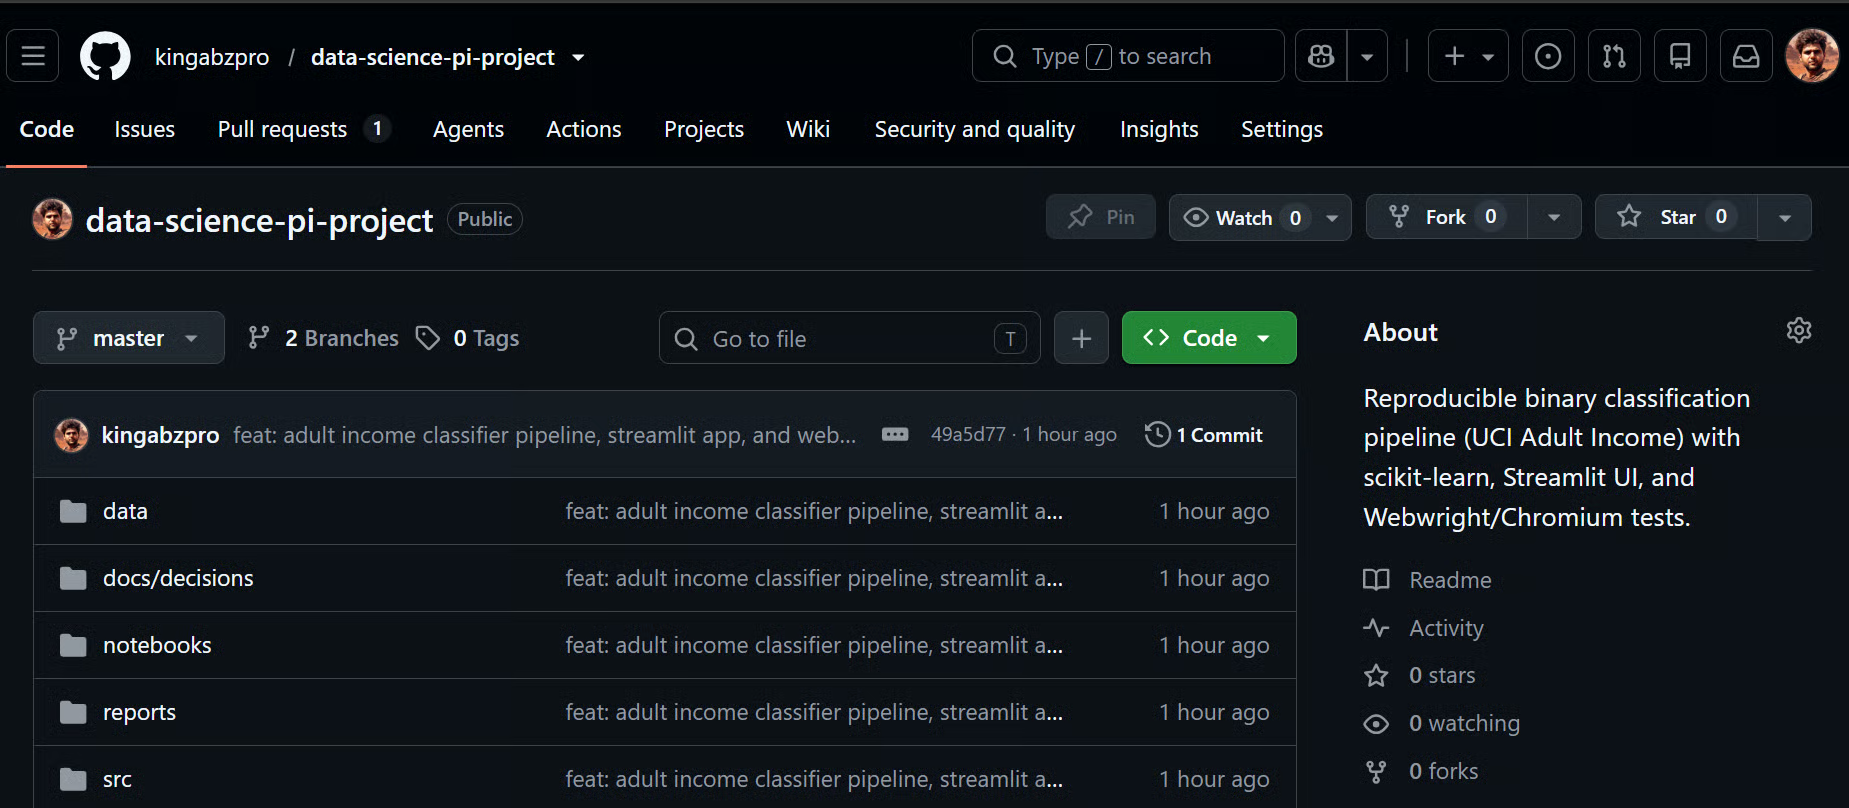
Pi committe vervolgens de wijzigingen, maakte een GitHub-repository en pushte het complete project naar GitHub.
De repository bevat de README, projectstructuur, broncode, tests, modelevaluatiebestanden en de Streamlit-applicatie:
Bron: kingabzpro/data-science-pi-project
Je kunt de applicatie lokaal draaien met:
streamlit run app.py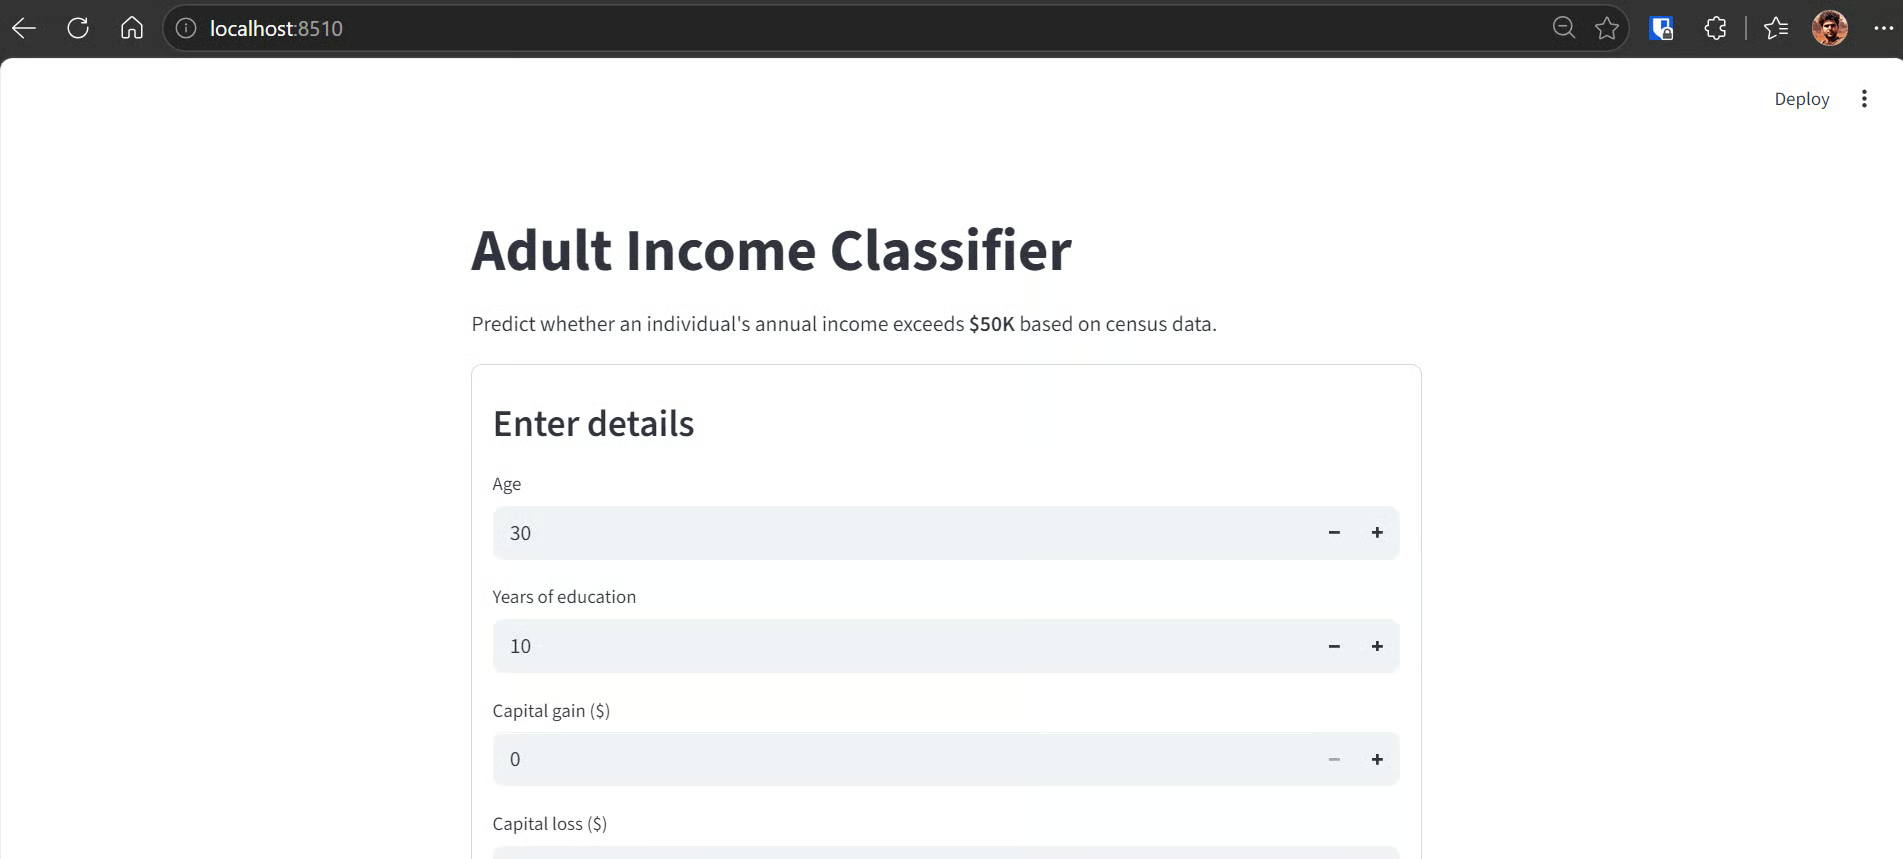
De interface is overzichtelijk en makkelijk te navigeren, en het model geeft snel voorspellingen terug.
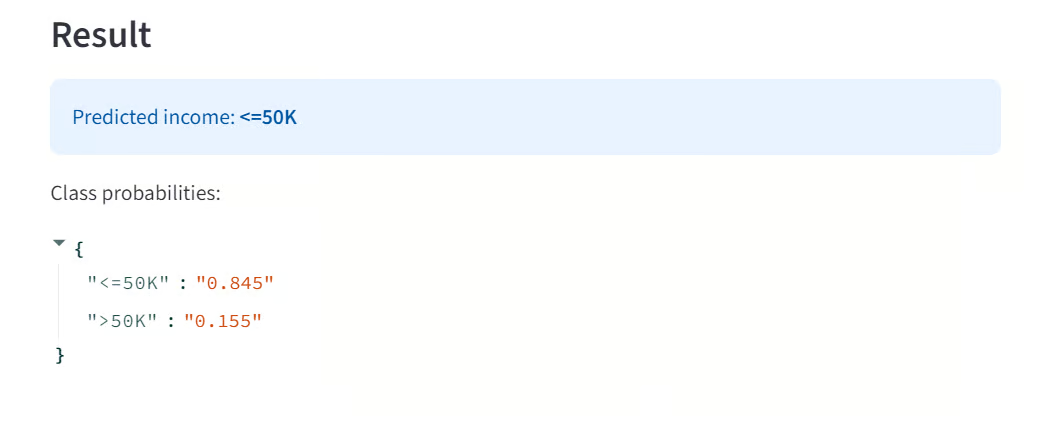
Belangrijker nog, deze test laat de waarde van de volledige setup zien: Pi kan de taak onderzoeken, de data inspecteren, actuele documentatie gebruiken, de pipeline bouwen, een interface maken, de browserervaring testen, het model valideren en het voltooide project vanuit één workflow publiceren.
Kimi K2.7 Code en Pi bleken een krachtige combinatie voor praktisch codeerwerk.
Kimi is snel, capabel en kan meerstaps engineeringtaken goed aan zonder eenvoudige beslissingen te overcompliceren.
Als je de API gebruikt in plaats van een codingsubscriptie, is het het overwegen waard om minstens $10 aan credits toe te voegen om toegang te krijgen tot de hogere gebruikstier en te voorkomen dat je te snel de daglimieten bereikt.
Wat me het meest opviel, was hoe weinig handmatige coördinatie de workflow nodig had zodra alles was ingesteld.
Met één gedetailleerde prompt checkte Pi Hermes Memory op relevante projectcontext, bekeek het de projectmap, gebruikte het Context7 om de huidige Streamlit- en scikit-learn-documentatie te verifiëren en gebruikte het Olostep om de dataset en probleemopzet te onderzoeken.
Vandaar maakte het de projectbestanden, bouwde het de machinelearningpipeline, ontwikkelde het de Streamlit-app en testte het de interface met Webwright en Playwright.
Pi draaide ook de Pythontests, controleerde de modelmetriek, bekeek het browsergedrag, genereerde een eindrapport, committe de wijzigingen en pushte de voltooide repository naar GitHub.
Al met al voelde de setup minder als het handmatig aansturen van een codingassistent en meer als het geven van duidelijke richting aan een geautomatiseerde ontwikkelworkflow.
Zodra de juiste tools waren gekoppeld, deed Pi het meeste zware werk terwijl Kimi de snelheid en het redeneren leverde om het proces gaande te houden.
Wil je dieper duiken in hoe AI-agents onder de motorkap werken? Ik raad DataCamp’s Building Scalable Agentic Systems-cursus aan om de ontwerpprincipes, testframeworks en protocollen (zoals MCP) te leren die nodig zijn om AI-agents van proof-of-concept naar productie te brengen.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

