Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
11.1K
Kimi K2.7 Code est le modèle de codage phare de Moonshot, conçu pour des tâches de développement logiciel concrètes : écriture et débogage de code, navigation dans de larges bases de code et gestion de travaux d’ingénierie en plusieurs étapes.
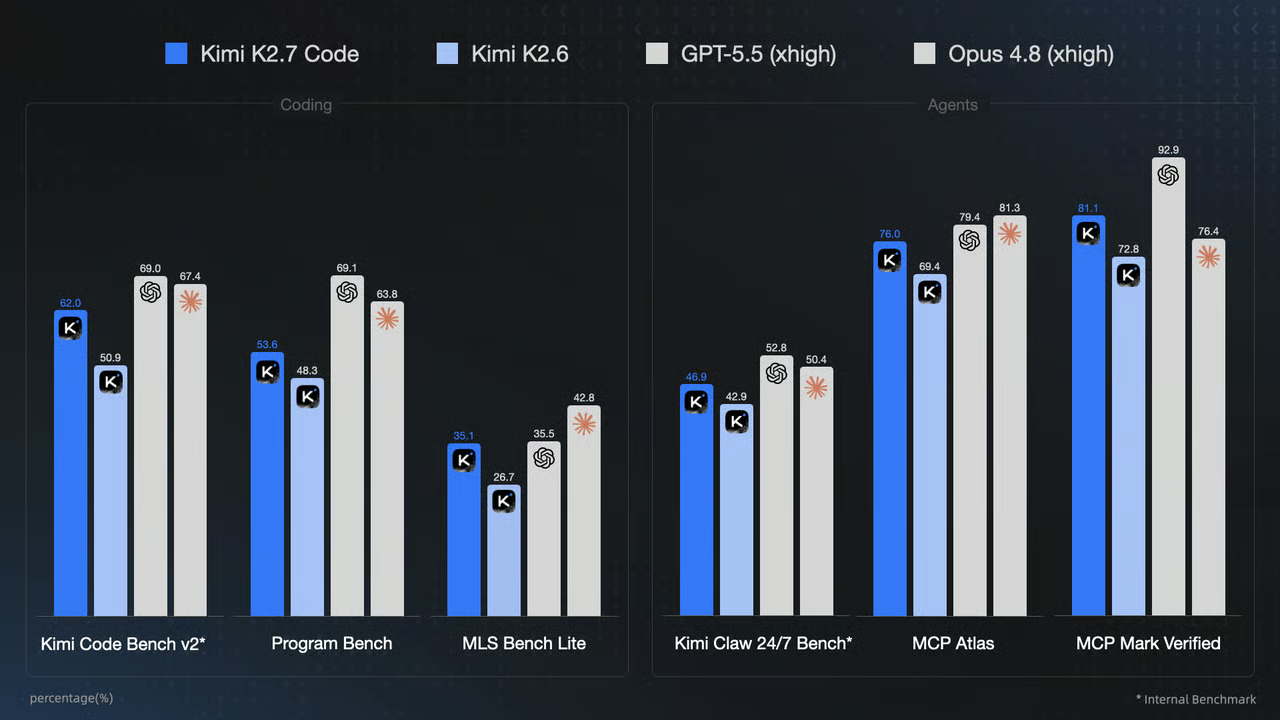
Source : Kimi K2.7 Code : Open-Source Agentic Coding Model
Associé à Pi, un agent de codage léger et très extensible, il crée un environnement de développement local flexible qui gère des skills, des packages, des outils en ligne de commande, une mémoire persistante et des tests navigateur, sans complexité superflue.
Plutôt que d’installer un MCP pour chaque tâche, Pi combine le raisonnement de Kimi avec des outils développeur fiables comme GitHub CLI, Vercel CLI, Hugging Face CLI, pytest, Ruff et uv.
Vous pouvez ainsi rechercher, construire, tester, déployer et maintenir de vrais projets depuis un flux de travail unique piloté par un agent de codage.
Dans ce guide, je vous montre comment configurer Kimi K2.7 Code avec Pi de A à Z.
Vous allez configurer votre clé d’API Moonshot, ajouter Olostep pour la recherche, Context7 pour une documentation à jour, Webwright pour les tests navigateur et Hermes Memory pour un contexte persistant entre les sessions.
Vous installerez aussi des thèmes utiles et des compétences d’ingénierie, connecterez des CLIs pratiques pour GitHub, Vercel et Hugging Face, créerez un projet data science Python reproductible, puis testerez le flux complet en construisant, validant et publiant une petite application de machine learning.
Je vous recommande également mon guide sur l’exécution locale de Kimi K2.7 Code.
Pi est un agent de codage léger qui s’exécute directement dans votre terminal.
Il peut travailler avec vos fichiers locaux, exécuter des commandes, utiliser des skills et packages installés, et se connecter à votre modèle de codage préféré.
Choisissez la commande d’installation pour votre système d’exploitation.
Windows PowerShell
powershell -c "irm https://pi.dev/install.ps1 | iex"macOS ou Linux
curl -fsSL https://pi.dev/install.sh | shVous pouvez aussi installer Pi via npm :
npm install -g --ignore-scripts @earendil-works/pi-coding-agentAvant d’utiliser Kimi K2.7 Code dans Pi, ajoutez votre clé d’API Moonshot comme variable d’environnement.
Pi pourra alors y accéder automatiquement lorsque vous sélectionnerez Moonshot comme fournisseur de modèle.
Windows PowerShell
setx MOONSHOT_API_KEY "your_moonshot_api_key"Fermez puis rouvrez PowerShell après avoir exécuté cette commande. La nouvelle variable d’environnement ne sera disponible que dans les sessions de terminal nouvellement ouvertes.
Git Bash, macOS ou Linux
export MOONSHOT_API_KEY="your_moonshot_api_key"Cette commande ne s’applique qu’à la session de terminal en cours. Pour conserver la clé après redémarrage du terminal, ajoutez la même ligne à votre profil de shell, par exemple ~/.bashrc ou ~/.zshrc.
Gardez votre clé d’API privée. Ne l’ajoutez pas à des dépôts Git, notebooks publics, captures d’écran, fichiers .env.example ou AGENTS.md.
Une fois la clé définie, lancez Pi :
piPuis ouvrez le sélecteur de modèles :
/model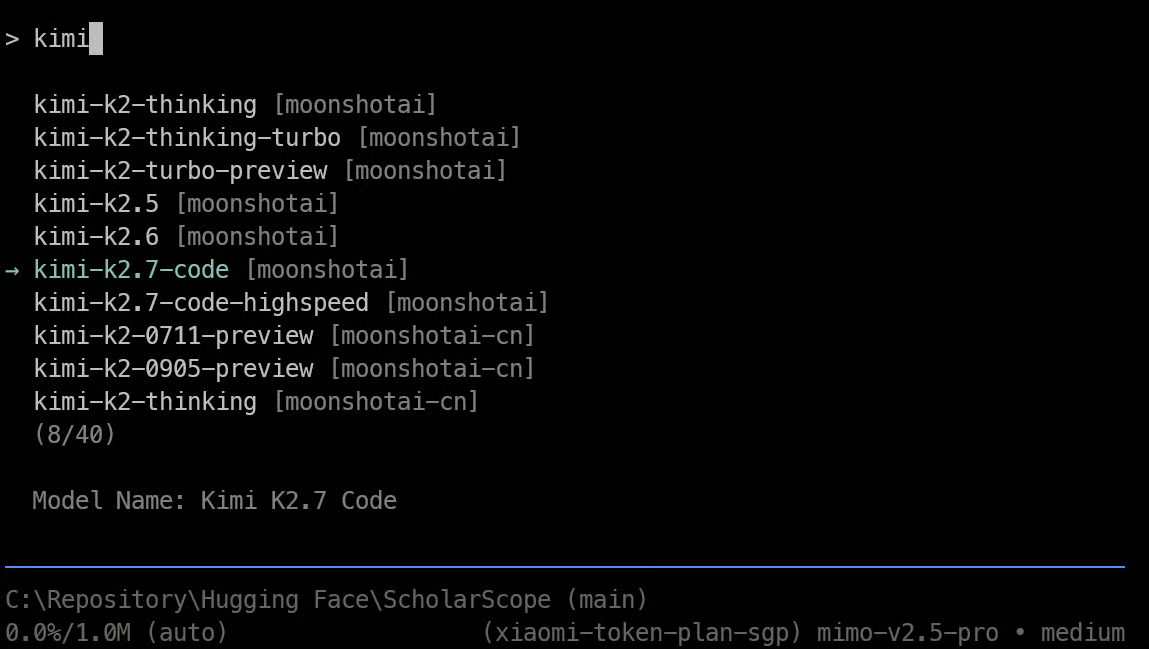
Choisissez moonshotai comme fournisseur et sélectionnez kimi-k2.7-code.
Pi devrait détecter automatiquement la variable d’environnement MOONSHOT_API_KEY et l’utiliser pour l’authentification.
Olostep donne à Pi l’accès à des workflows de recherche : recherche web, scraping, exploration de documentation, débogage et extraction de données structurées.
Il aide Pi à trouver des informations récentes lorsque la tâche exige plus que la connaissance embarquée du modèle.
Avant de poursuivre, créez un compte Olostep, générez une clé d’API et enregistrez-la localement comme variable d’environnement nommée OLOSTEP_API_KEY.
Cela permet à Pi, et aux scripts qu’il crée, de s’authentifier auprès d’Olostep sans stocker de secrets dans vos fichiers de projet.
Ensuite, installez les skills Olostep directement dans le répertoire global des skills de Pi :
npx -y olostep-cli@latest add skills \
 --no-global \
 --agent-skills-dir ~/.pi/agent/skills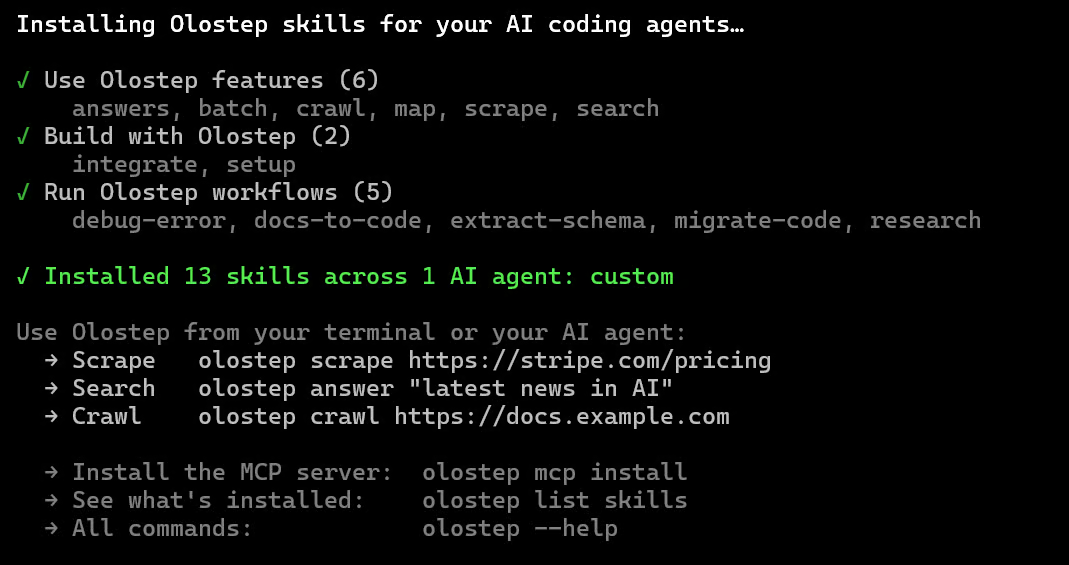
Les skills Olostep sont installés dans :
~/.pi/agent/skills/Context7 donne à Pi accès à une documentation de bibliothèques à jour, spécifique aux versions, ainsi qu’à des exemples de code. Cela évite l’utilisation d’APIs obsolètes lorsque Pi travaille avec des frameworks, SDKs et packages Python en évolution rapide.
Avant l’installation, créez un compte Context7, générez une clé d’API depuis le tableau de bord Context7 et enregistrez-la localement comme variable d’environnement nommée CONTEXT7_API_KEY.
Gardez cette clé privée : ne la validez pas dans votre dépôt et ne l’incluez pas dans des captures d’écran, notebooks ou fichiers d’instructions de projet.
Installez le package officiel Context7 pour Pi :
pi install npm:@upstash/context7-piCela ajoute les outils de documentation Context7, une skill qui guide Pi pour les utiliser au besoin, et la commande /c7-docs pour des recherches manuelles.
Après redémarrage de Pi, il peut récupérer la documentation pertinente avant d’écrire du code qui dépend de bibliothèques externes.
Pi prend en charge des packages de thèmes tiers, ce qui permet d’améliorer facilement l’interface du terminal sans changer le fonctionnement de l’agent.
Le package @spences10/pi-themes inclut plusieurs thèmes sombres soignés : Catppuccin Mocha, Dracula, Gruvbox Dark, Nord, One Dark et Tokyo Night.
Installez le package de thèmes communautaire :
pi install npm:@spences10/pi-themesOuvrez ensuite Pi :
piOuvrez le menu des réglages :
/settings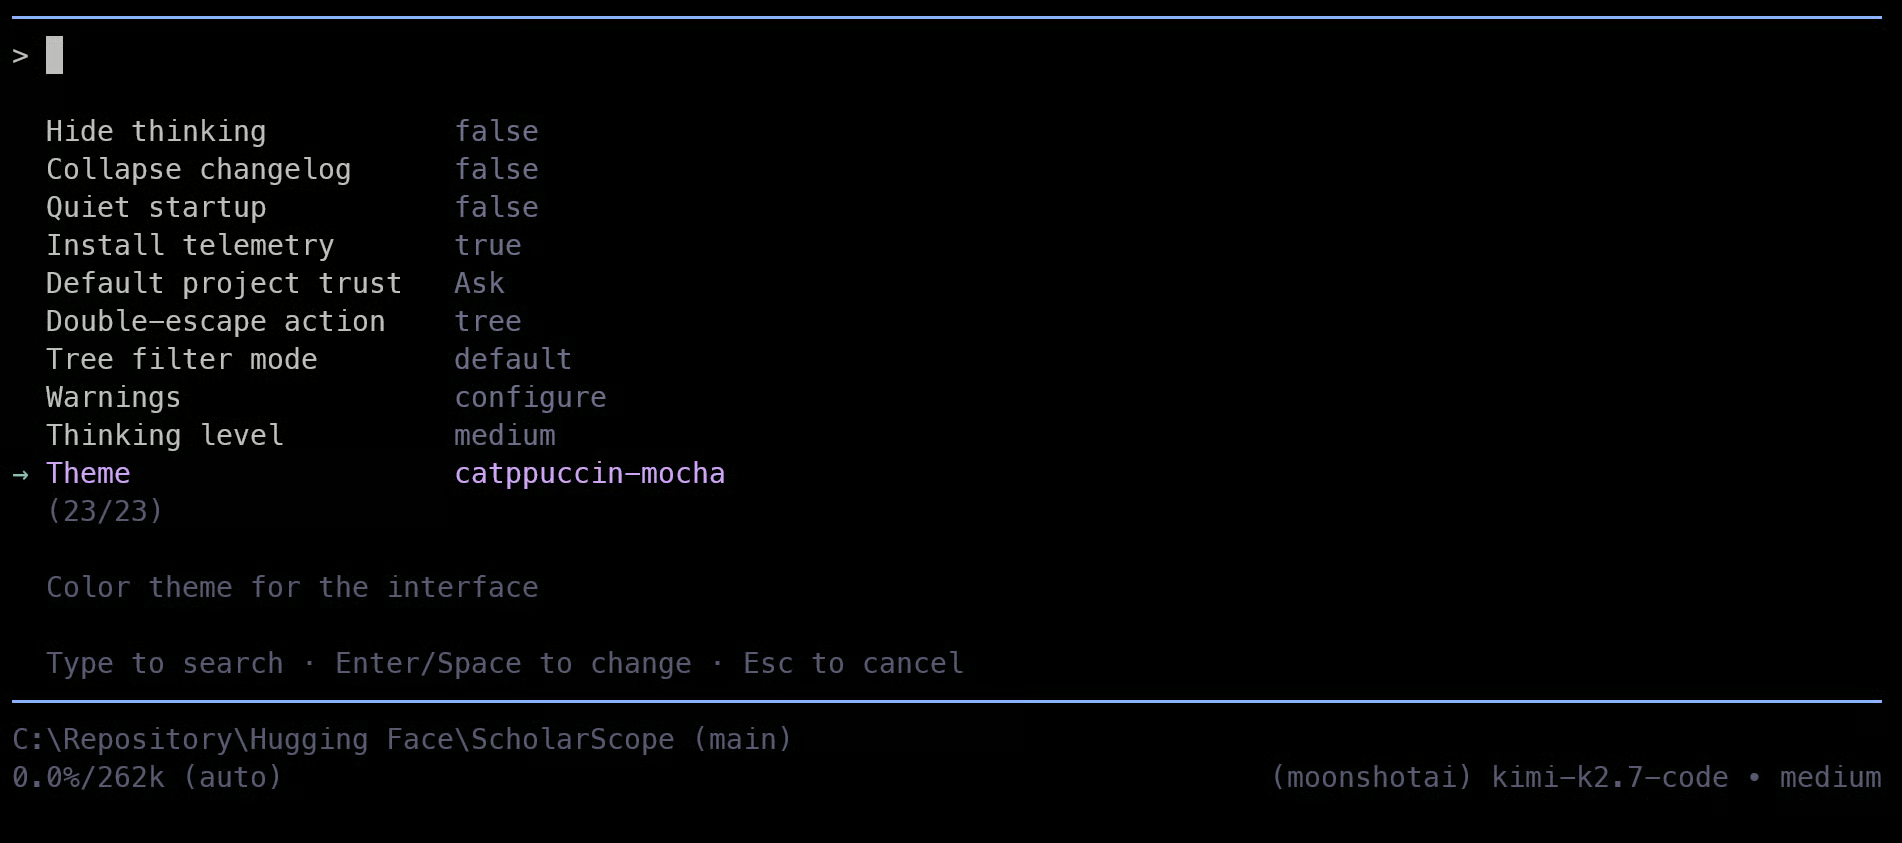
Sélectionnez Catppuccin Mocha parmi les thèmes disponibles. C’est un thème sombre, lisible et contrasté : un excellent choix par défaut pour de longues sessions de code.
Vous pouvez changer de thème à tout moment via /settings. Pi prend aussi en charge des thèmes stockés localement et des thèmes fournis par packages, pour personnaliser l’interface plus tard sans toucher au modèle, aux outils ou à la configuration du projet.
Pi peut être enrichi de workflows d’ingénierie réutilisables pour gagner en cohérence lors de la planification, du débogage, des tests, des revues de code, de la rédaction de documentation et de la préparation des livrables ou releases.
Le package @barlevalon/skills fournit des workflows portables SKILL.md pour ces tâches classiques d’ingénierie logicielle.
Installez le package de skills :
pi install npm:@barlevalon/skills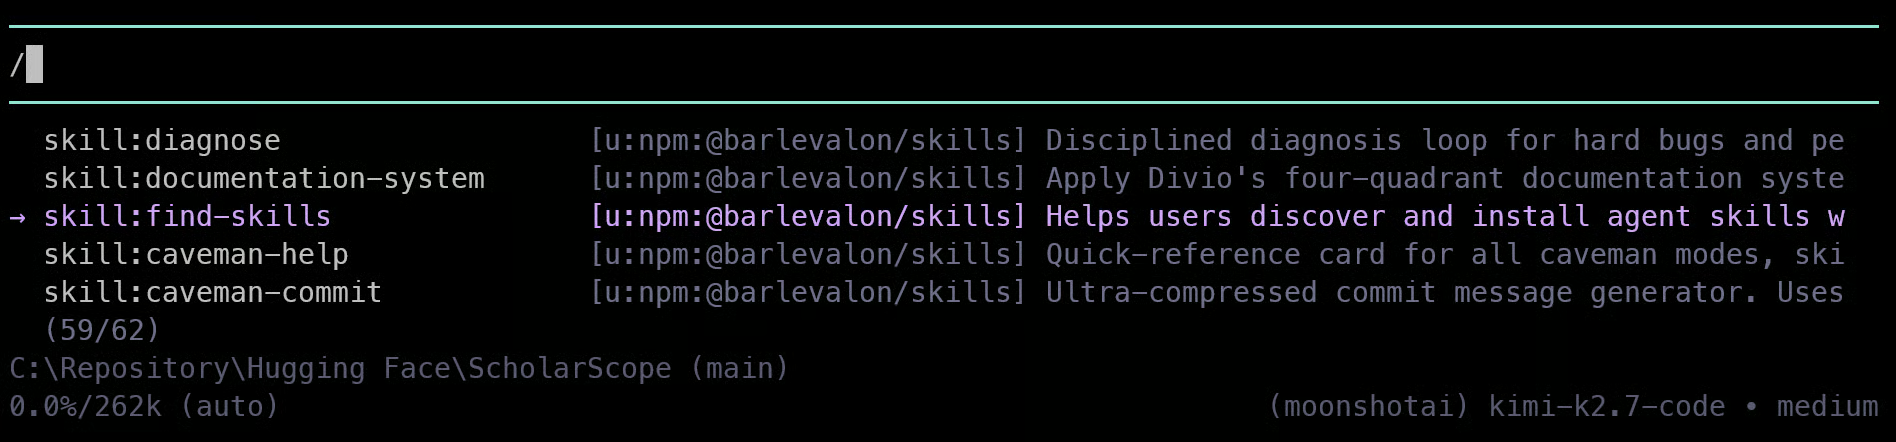
Ensuite, installez Hypa pour éviter que de longues sorties terminal n’encombrent la fenêtre de contexte de Pi :
pi install npm:@hypabolic/pi-hypaHypa réécrit automatiquement les commandes shell prises en charge via une couche de compression locale. Il conserve les éléments essentiels (erreurs, résultats finaux) tout en réduisant les logs répétitifs des installations de packages, batteries de tests, exécutions de modèles, builds et déploiements.
Le package Pi installe aussi Hypa en dépendance et crée un shim de commande locale hypa au mieux des capacités.
Vous n’avez pas besoin d’un MCP, d’une extension ou d’un package pour chaque service que vous utilisez.
Pour des workflows courants (gestion de dépôts, déploiement d’une application, consultation des logs, publication d’un modèle), un outil en ligne de commande authentifié est souvent plus simple, plus fiable et plus facile à utiliser pour Pi.
GitHub CLI permet à Pi de travailler avec les dépôts, pull requests, issues, releases et GitHub Actions directement depuis le terminal. Installez-le sous Windows avec :
winget install --id GitHub.cli --source wingetPuis connectez-vous :
gh auth loginUtilisez GitHub CLI lorsque vous souhaitez que Pi inspecte un dépôt, crée ou relise des pull requests, vérifie les workflows, gère les issues ou publie un projet sur GitHub.
Vercel CLI permet à Pi de déployer des applications web, d’inspecter des projets, de consulter les logs de déploiement et de gérer les variables d’environnement depuis le terminal.
npm install -g vercel
vercel login
Utilisez Vercel CLI pour les prévisualisations, les mises en production, le dépannage des déploiements, le lien projet et les vérifications de variables d’environnement.
L’outil en ligne de commande actuel de Hugging Face est hf, inclus avec le package huggingface_hub. Installez-le avec :
pip install -U huggingface_hubPuis authentifiez-vous :
hf auth loginUtilisez Hugging Face CLI pour créer et gérer des dépôts de modèles, de jeux de données et de Spaces ; téléverser des fichiers de projet ; télécharger des modèles ou jeux de données ; et vérifier le compte actuellement authentifié.
Les tests unitaires sont utiles pour vérifier la logique Python, mais ils ne disent pas si votre application est vraiment utilisable par un utilisateur.
Webwright permet à Pi d’exécuter des tests basés sur Playwright dans un navigateur, sur des apps locales ou déployées : Streamlit, Gradio, front-ends FastAPI, projets React ou Next.js, prévisualisations Vercel et Hugging Face Spaces.
Installez Webwright dans Pi :
pi install npm:pi-webwrightPuis installez Chromium pour Playwright :
npx playwright install chromium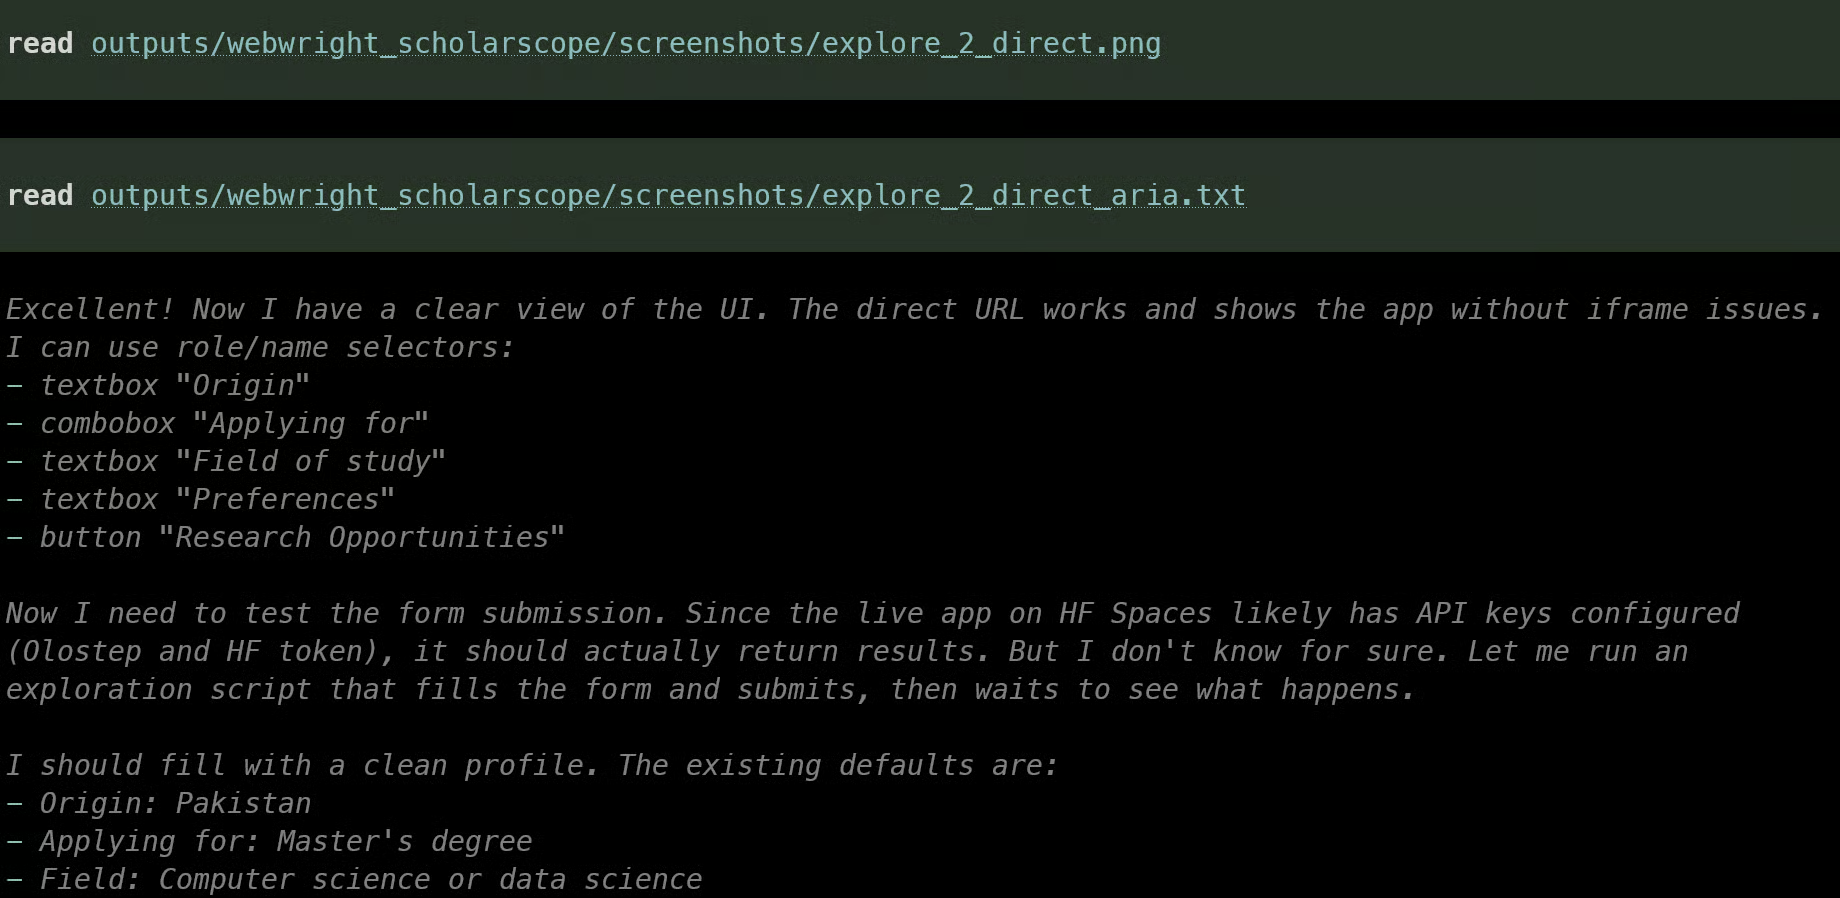
Webwright permet à Pi d’ouvrir l’app dans Chromium, de tester le parcours utilisateur principal, d’interagir avec des formulaires ou des téléversements, de vérifier le bon rendu des résultats, d’inspecter les erreurs console, et d’enregistrer captures et logs.
Le package inclut une skill de test navigateur conçue pour des workflows traçables et fondés sur des artéfacts.
Pi démarre chaque nouvelle session avec un contexte limité des travaux précédents.
Hermes Memory ajoute une mémoire locale et persistante : Pi peut rechercher dans les sessions précédentes, retenir un contexte utile de projet, consolider les informations répétées et analyser la présence de secrets.
Tout fonctionne en local : pas besoin d’une clé d’API de mémoire hébergée séparée.
Installez Hermes Memory :
pi install npm:pi-hermes-memoryRedémarrez Pi après l’installation.
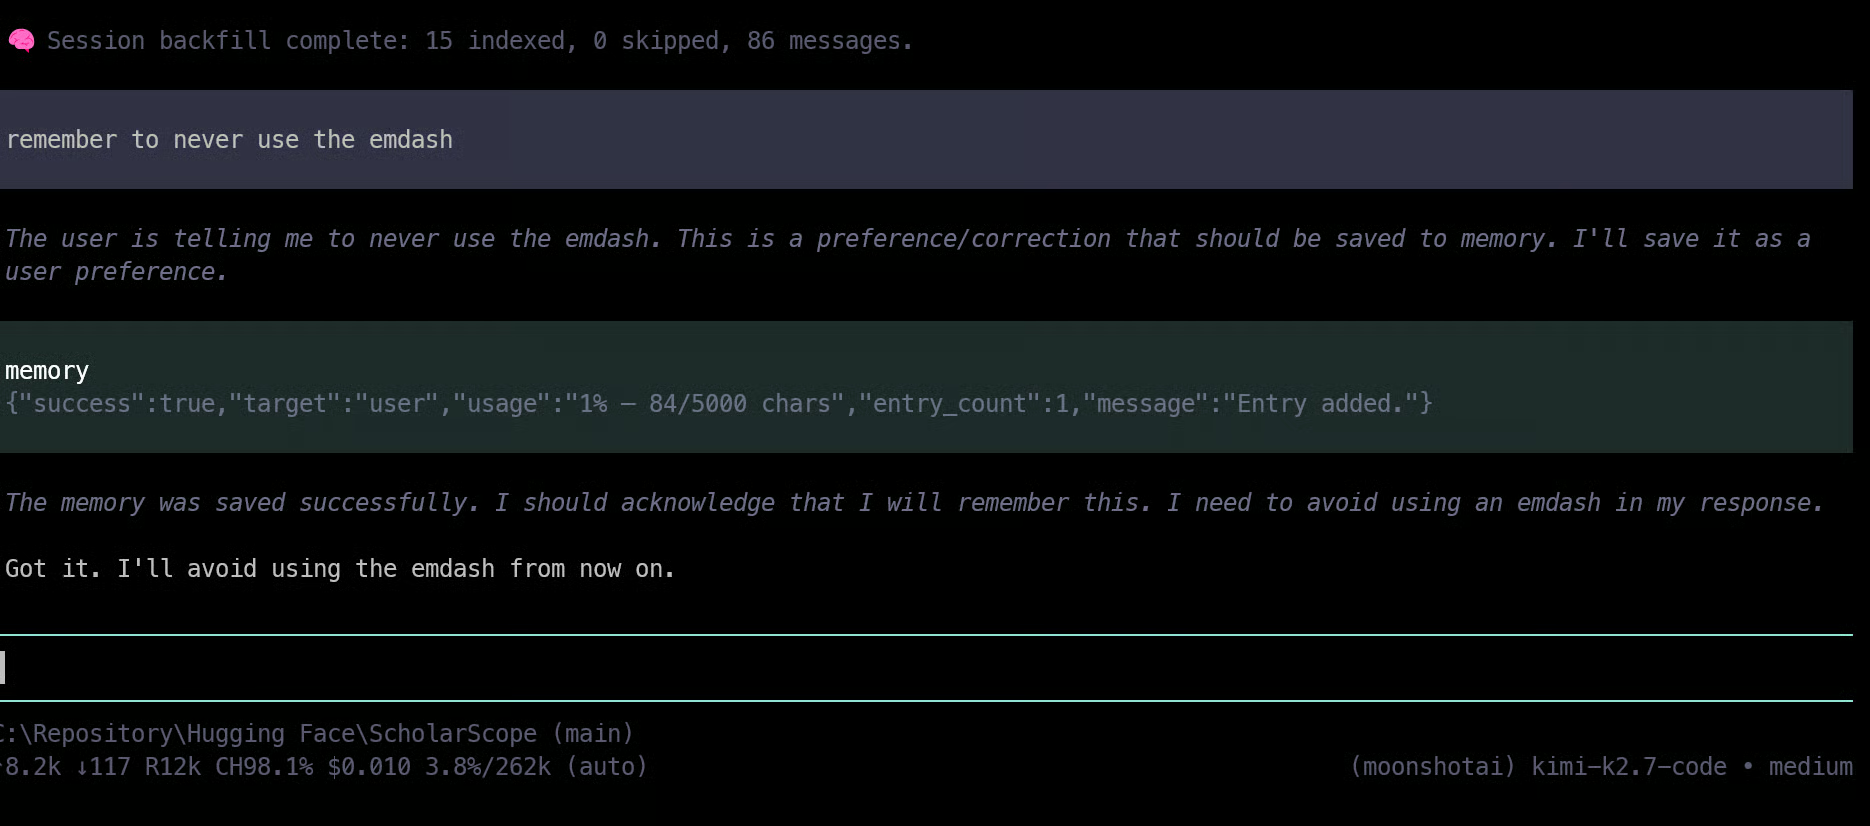
Utilisez Hermes Memory aux côtés d’une documentation de projet claire :
Conservez MEMORY.md et docs/decisions/ comme sources de référence visibles de votre projet.
Hermes Memory aide Pi à poursuivre le travail entre les sessions, tandis que les fichiers Markdown rendent le contexte facile à inspecter pour vous ou un autre contributeur.
Une bonne configuration Pi exige aussi une structure de projet claire.
Cela organise vos expériences, votre code, vos tests, vos données et vos résultats, afin que Pi puisse modifier sans mélanger le travail exploratoire en notebook avec du code de pipeline réutilisable.
Créez un nouveau projet et initialisez-le avec uv :
mkdir data-science-pi-project
cd data-science-pi-project
uv init
uv add pandas scikit-learn matplotlib pytest ruff
Utilisez cette structure :
data-science-pi-project/
├── AGENTS.md
├── MEMORY.md
├── README.md
├── src/
│   ├── data.py
│   ├── train.py
│   └── evaluate.py
├── tests/
├── notebooks/
├── data/
│   ├── raw/
│   └── processed/
├── reports/
│   ├── figures/
│   └── metrics/
└── docs/
    └── decisions/
Conservez dans src/ le code réutilisable de chargement de données, de prétraitement, d’entraînement et d’évaluation.
Réservez notebooks/ à l’exploration et aux expériences rapides.
Stockez les sources inchangées dans data/raw/, les données nettoyées dans data/processed/, et enregistrez graphiques, métriques et sorties de modèle dans reports/.
Créez un fichier AGENTS.md pour que Pi suive le bon workflow dans le dépôt :
# Règles du projet

- Utilisez Olostep pour la recherche la plus récente et Context7 pour la documentation des bibliothèques.
- Inspectez le jeu de données, les valeurs manquantes, les doublons, les risques de fuite, l'équilibre des classes et un baseline avant l'entraînement.
- Conservez la logique réutilisable dans `src/`, pas dans les notebooks.
- Ajoutez des tests en cas de changement du prétraitement ou du comportement d'évaluation.
- Exécutez le formatage, le linting et les tests avant d'estimer le travail terminé.
- consignez les décisions importantes dans `docs/decisions/`.
Cela donne à Pi un workflow reproductible pour construire des projets data science plus faciles à tester, maintenir et améliorer.
Il est temps de tester la configuration Pi complète dans un vrai projet. Pour l’exemple, j’ai demandé à Pi de construire une application de classification binaire reproductible pour prédire l’insertion des étudiants en fonction de facteurs tels que performances académiques, stages, projets, certifications et compétences.
Démarrez Pi depuis le dossier de votre projet :
piPuis fournissez à Pi l’invite suivante :
Build a simple, reproducible Python machine-learning project for a binary classification problem.
First inspect the dataset for schema, missing values, duplicates, categorical columns, leakage risks, class balance, and a suitable stratified train/test split.
Use Olostep for any current research or dataset references, and Context7 before using scikit-learn APIs.

Create clear modules for data loading/preprocessing, model training, evaluation, tests, a short README, and project rules.
Use a fixed random seed, uv, pytest, and Ruff.
Une fois le workflow modèle en place, créez une petite interface Streamlit ou Gradio et testez-la dans Chromium avec Webwright : parcours utilisateur principal, rendu des résultats, erreurs console, captures et logs.
Renseignez l’accuracy, le F1 pondéré, le F1 macro, une comparaison au baseline et une matrice de confusion. Initialisez et poussez le dépôt avec GitHub CLI.
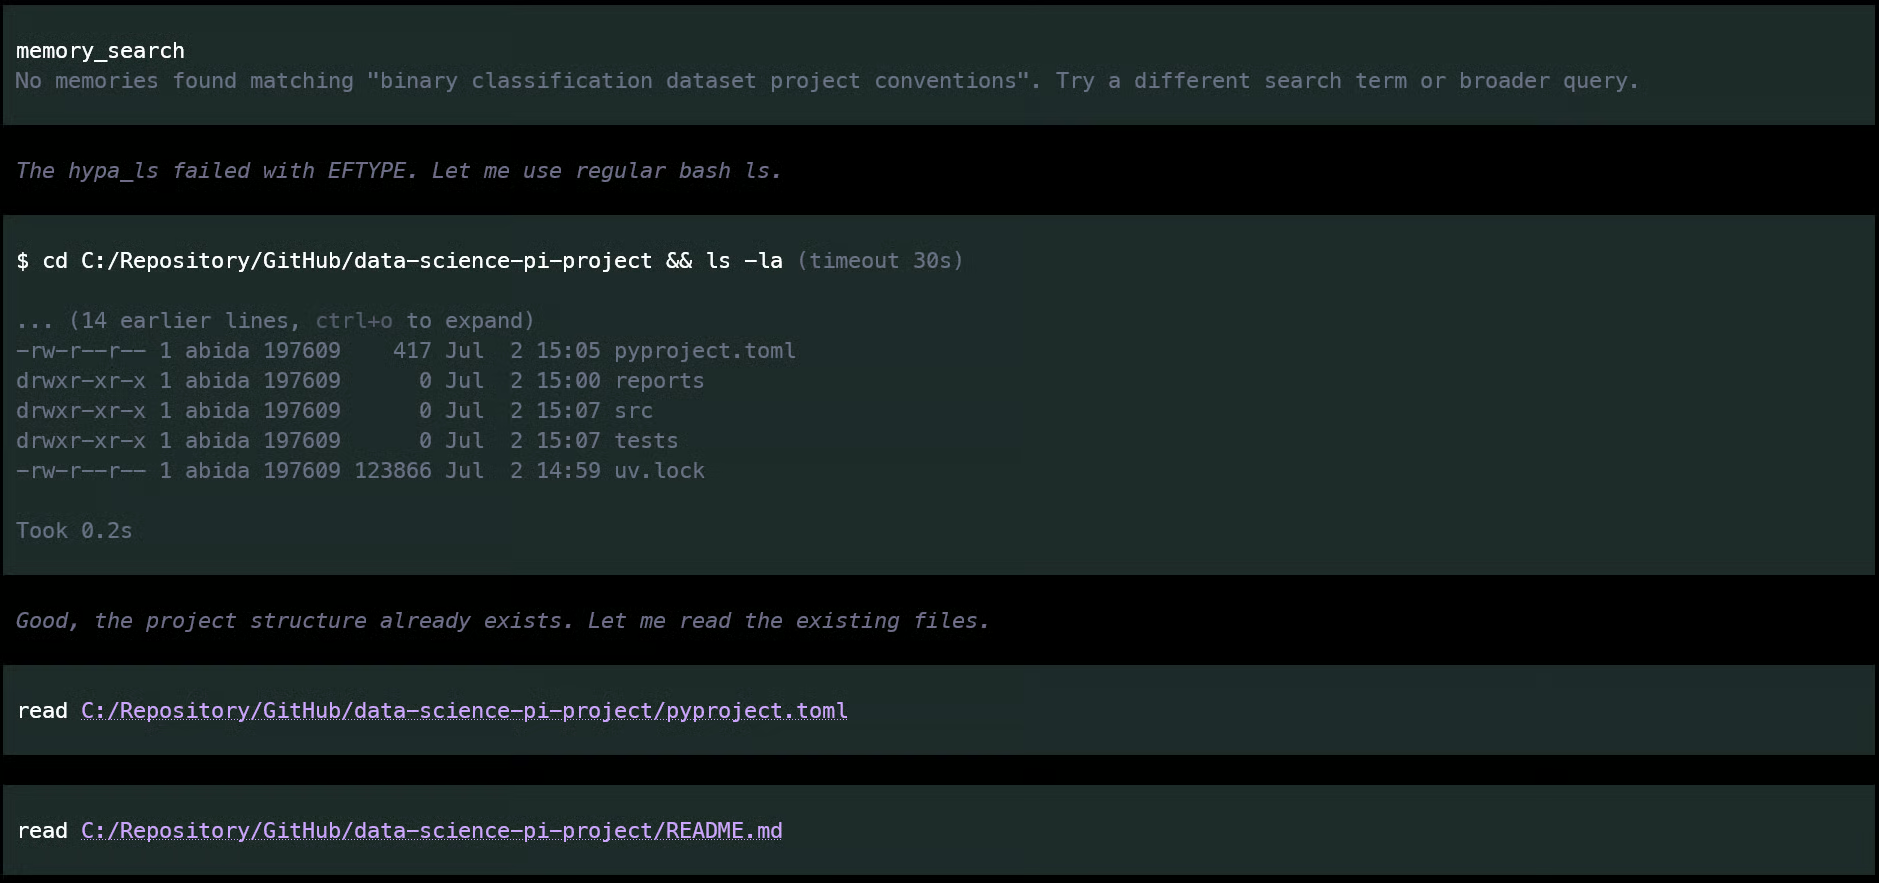
Pi a d’abord consulté Hermes Memory pour retrouver un éventuel contexte antérieur lié au projet.
Comme le montre la capture, il n’a rien trouvé d’utile, puis est passé à l’inspection du répertoire du projet.
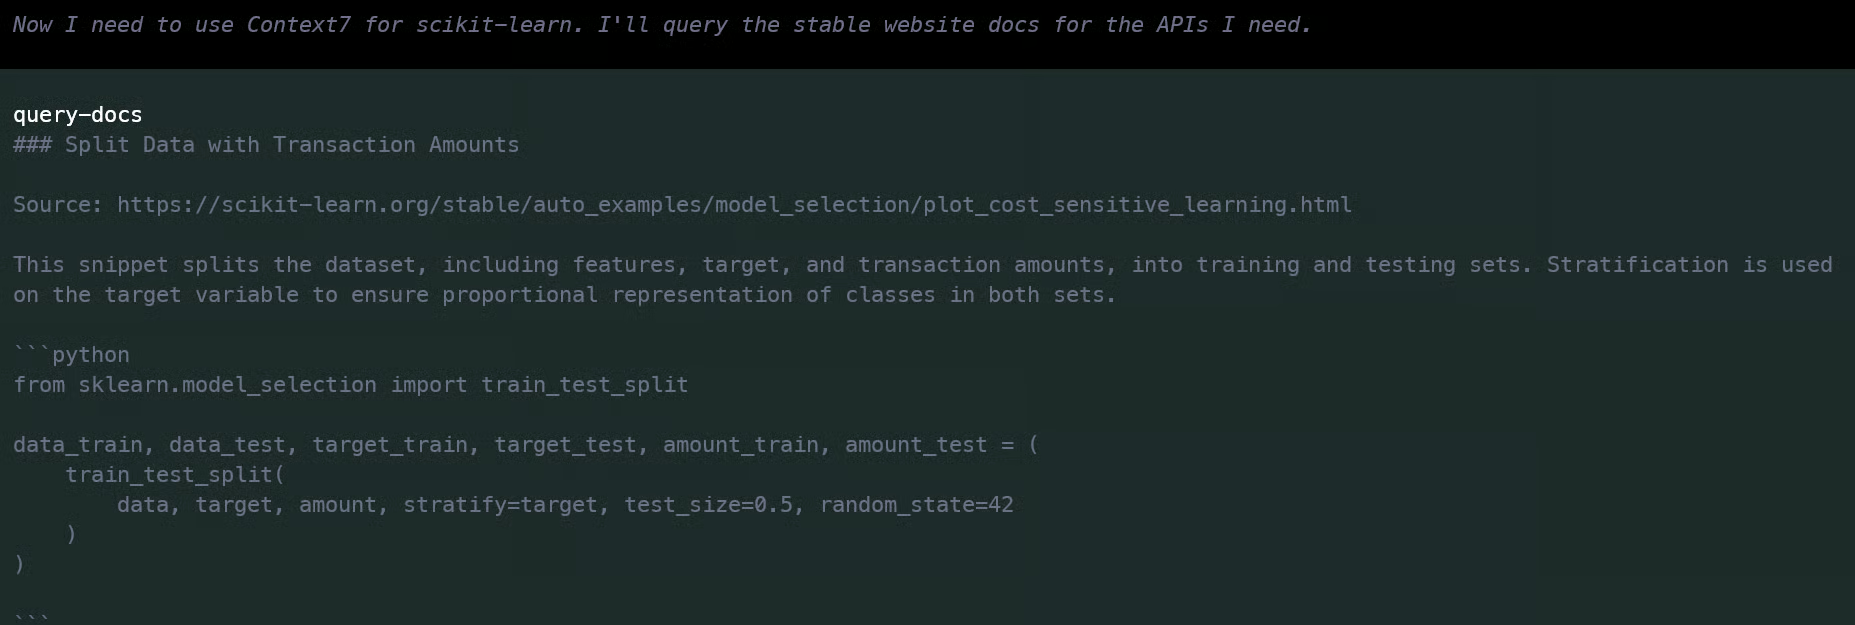
Une fois la structure comprise, Pi a utilisé Context7 pour vérifier la documentation Python et scikit-learn actuelle avant d’écrire les fichiers du projet.
C’est utile pour s’assurer d’utiliser des APIs à jour plutôt que des exemples périmés.
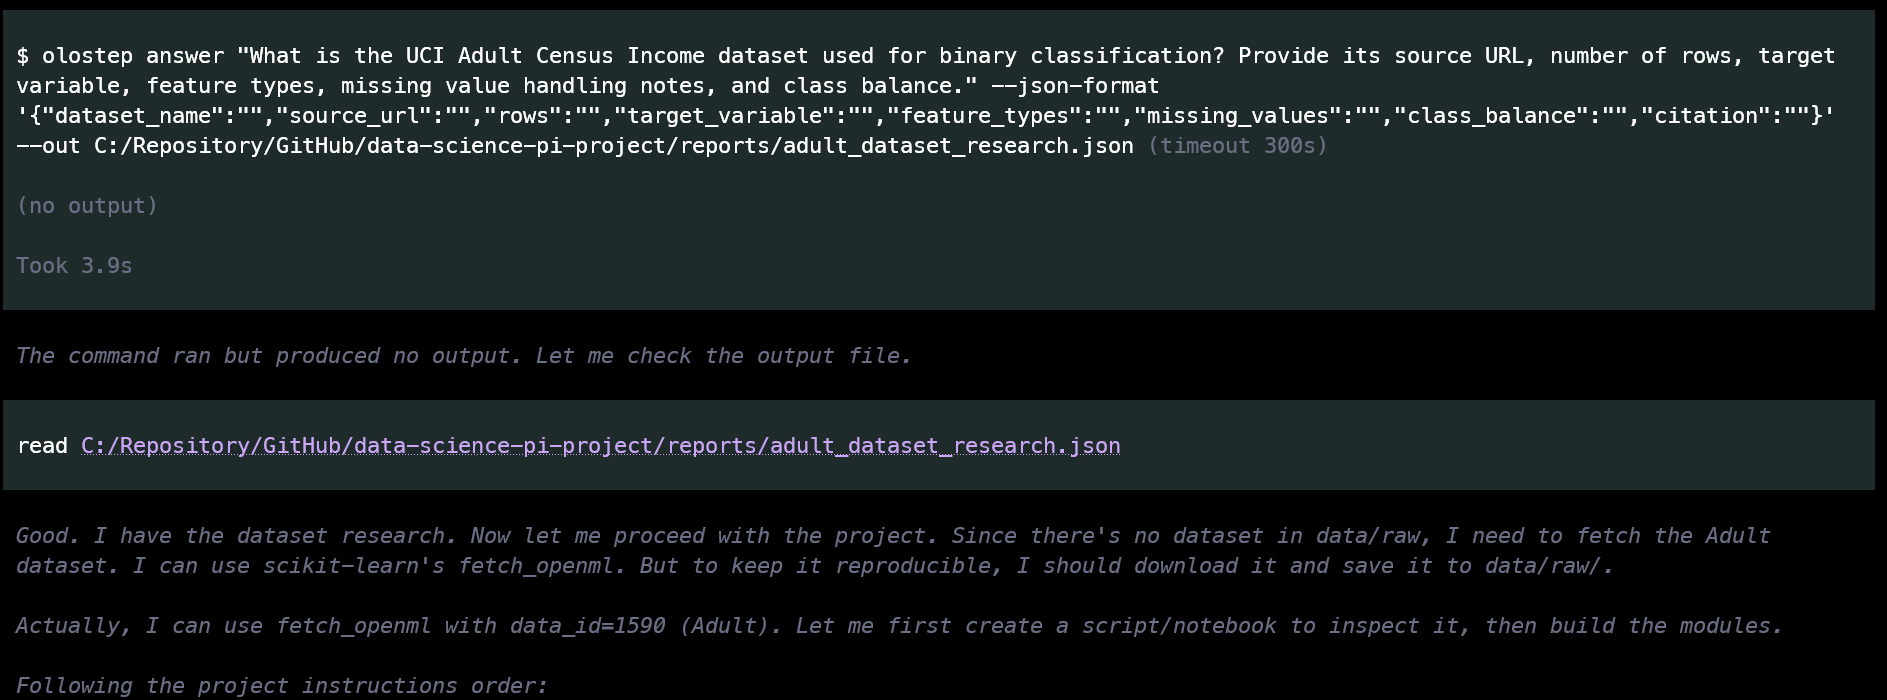
Ensuite, Pi a utilisé la skill de recherche Olostep pour trouver un jeu de données adapté et réunir les informations pertinentes pour le projet.
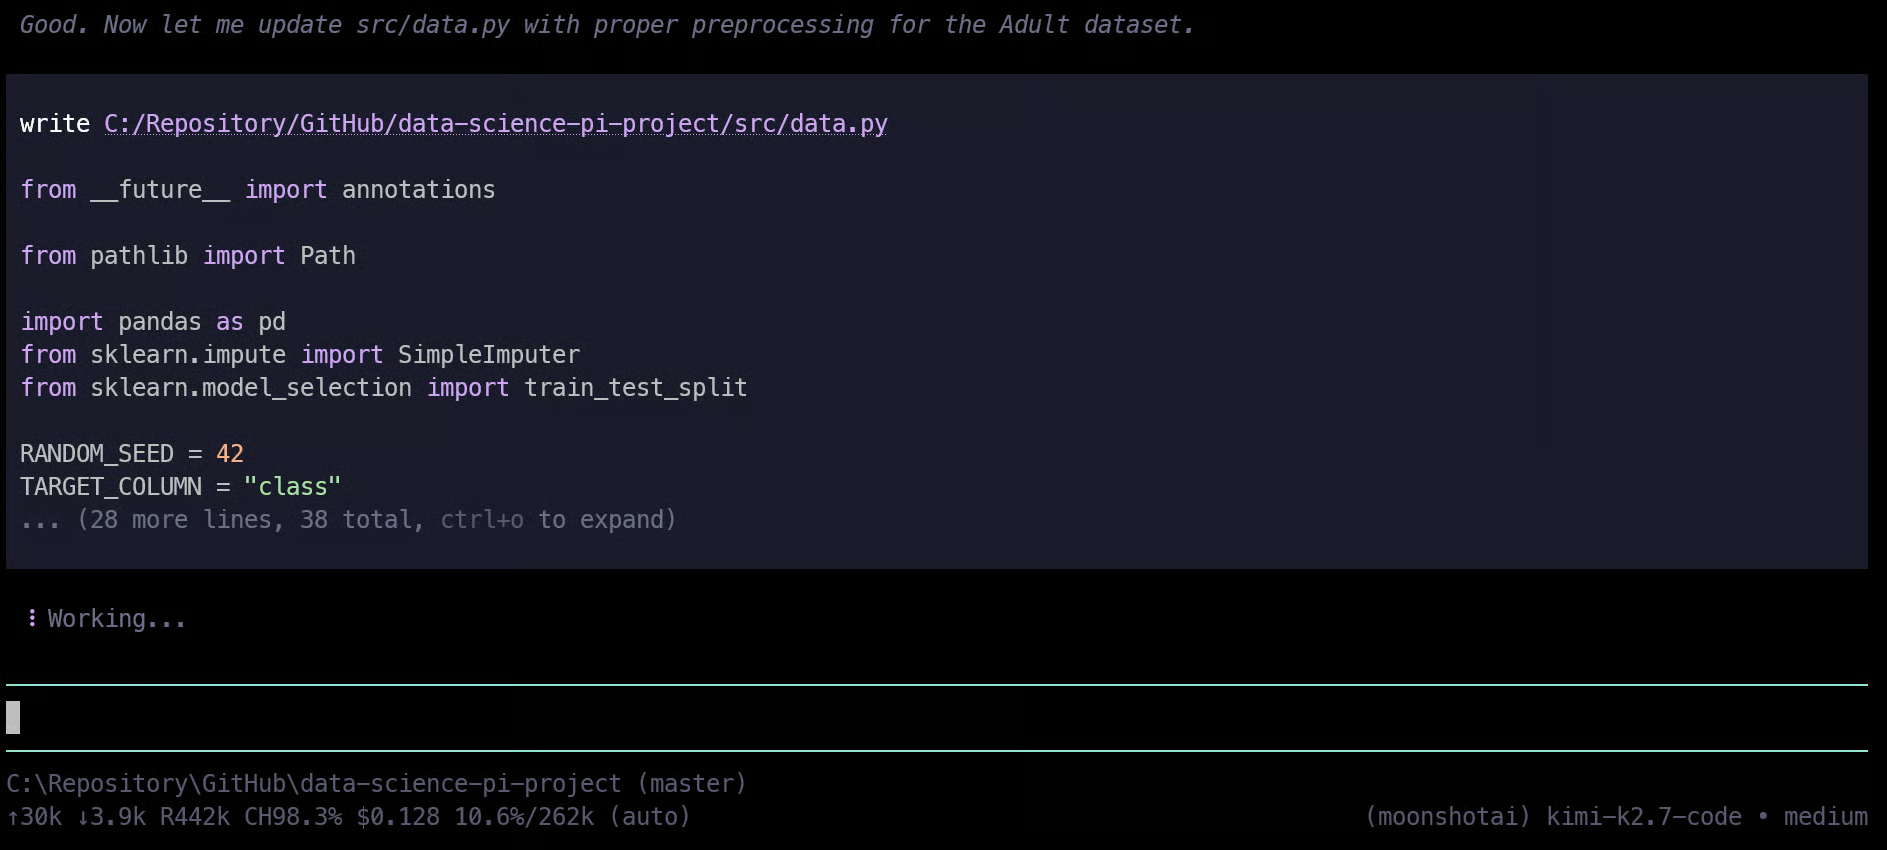
Après avoir rassemblé assez de contexte, il a commencé à créer les fichiers un à un : pipeline de prétraitement, code d’entraînement, script d’évaluation, tests, README et instructions de projet.
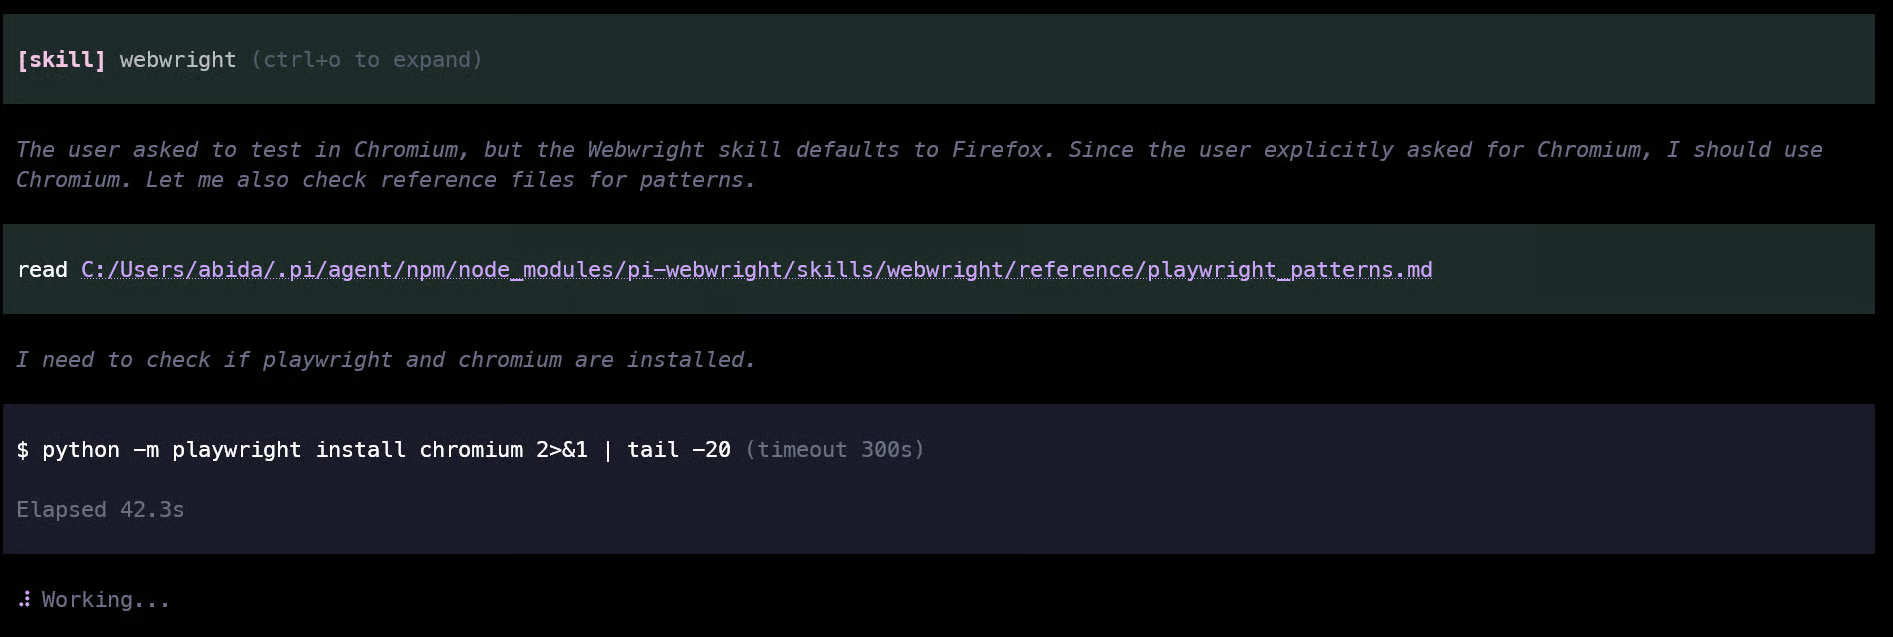
Après la mise en place du workflow de machine learning, Pi a créé une petite application Streamlit.
Il a ensuite installé Chromium pour Playwright et utilisé Webwright pour tester l’interface dans un vrai navigateur.
Le test navigateur a vérifié le parcours utilisateur principal, le bon rendu des résultats, a inspecté les erreurs console, et a enregistré captures et logs.
Pi a également exécuté les tests Python et les vérifications du projet avant de générer le récapitulatif final.
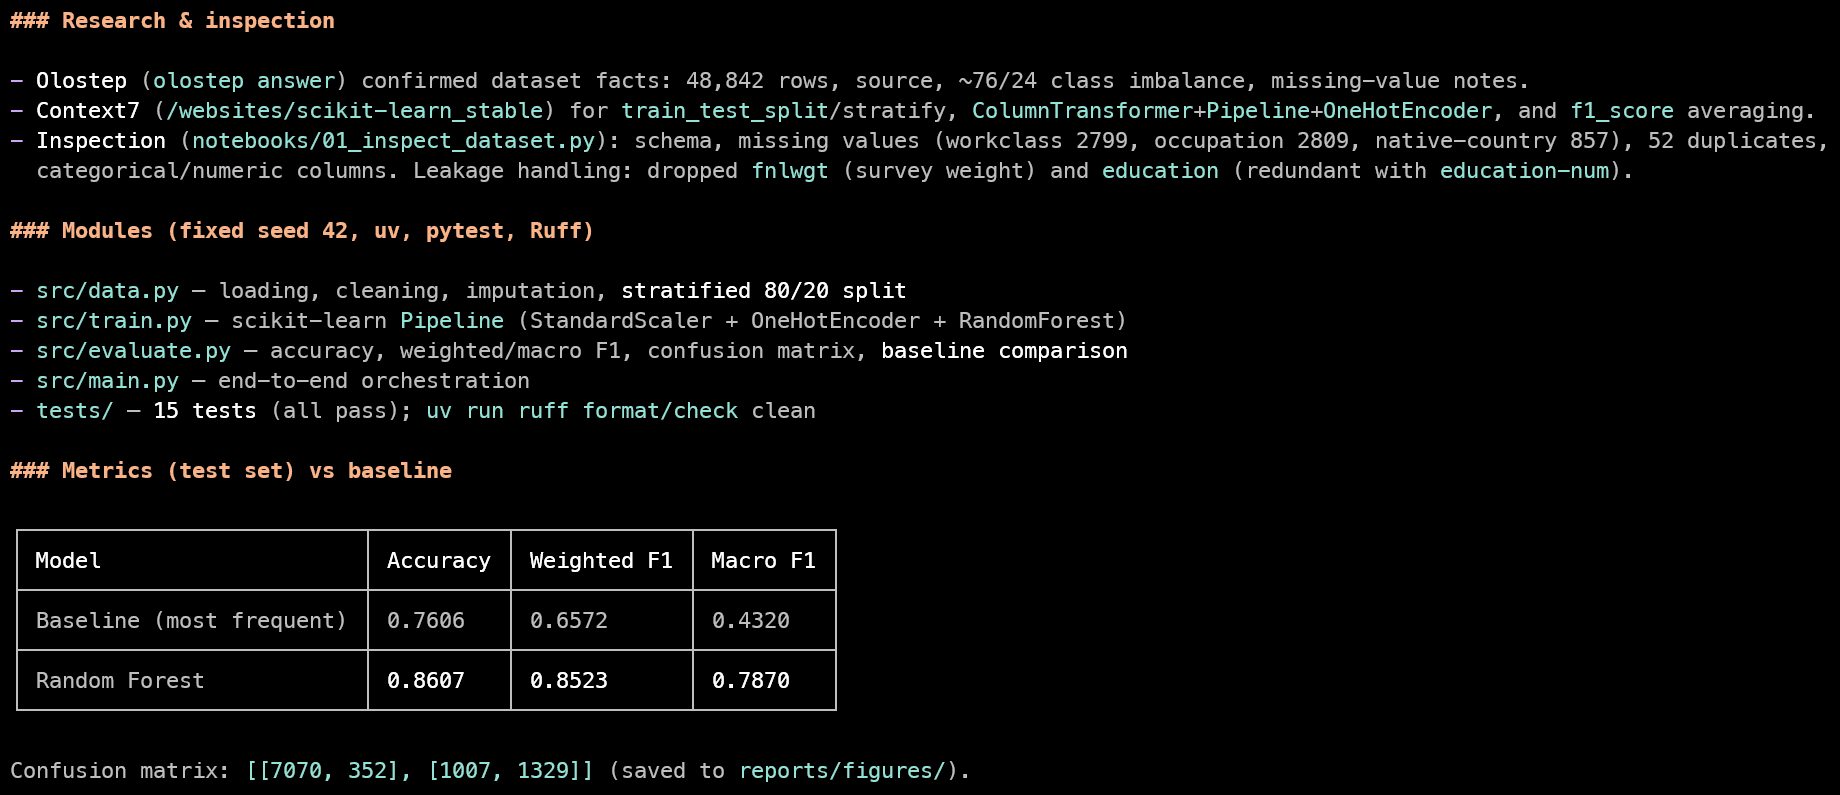
Dans ce test, le modèle final a atteint environ 86 % d’accuracy et un score F1 de 0,85.
Pi a ensuite validé les changements, créé un dépôt GitHub et poussé le projet complet sur GitHub.
Le dépôt inclut le README, la structure du projet, le code source, les tests, les fichiers d’évaluation du modèle et l’application Streamlit :
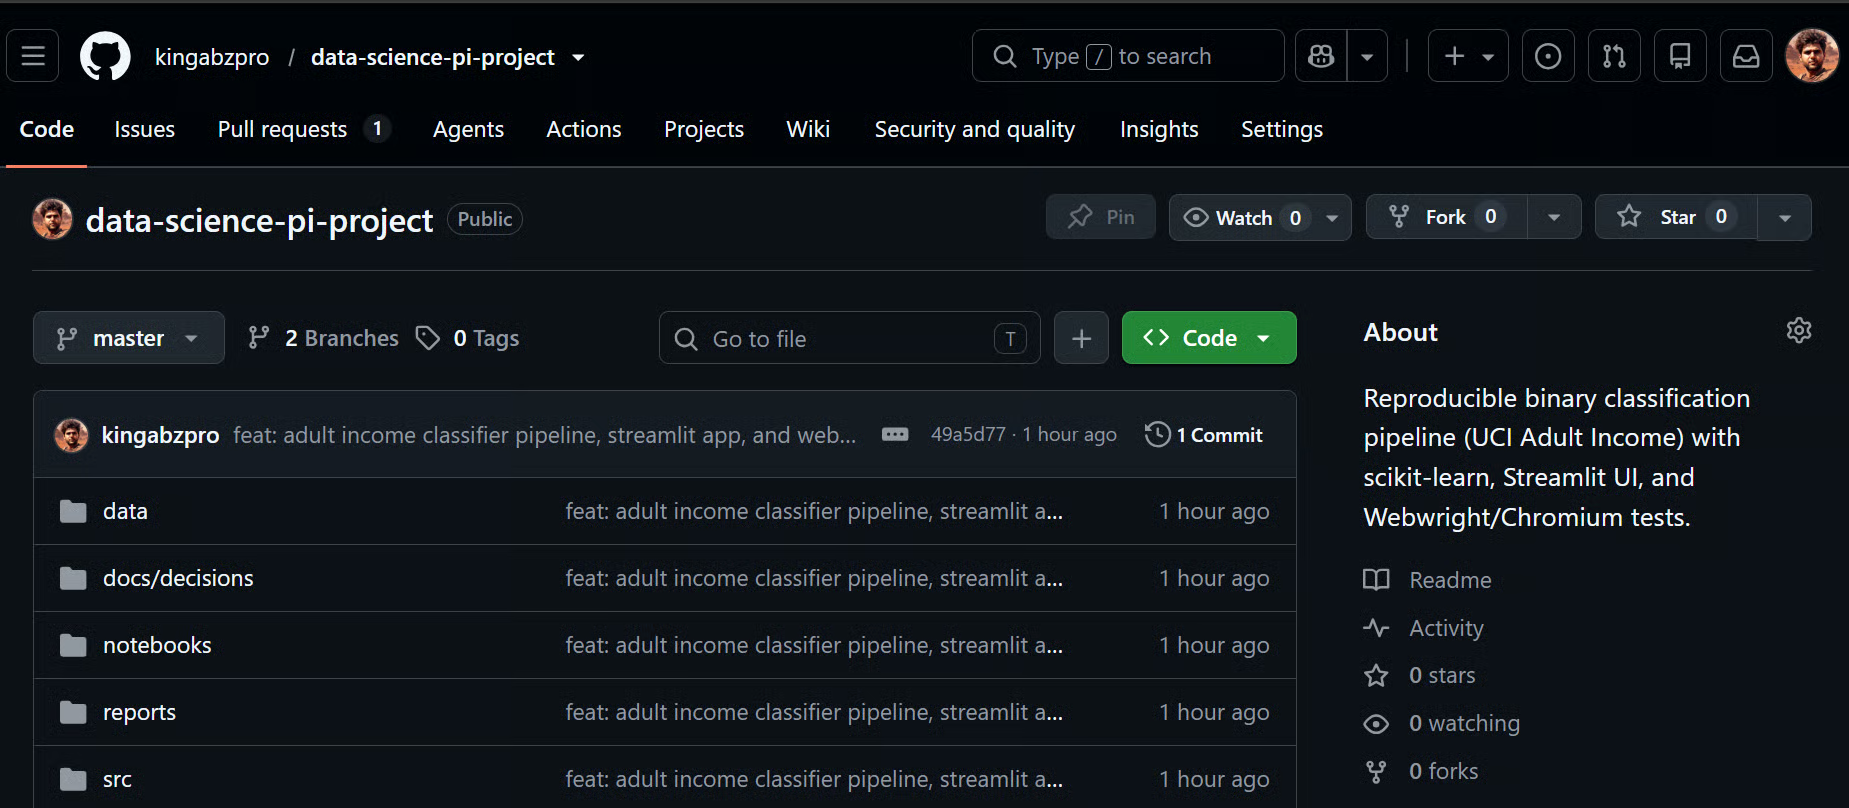
Source : kingabzpro/data-science-pi-project
Vous pouvez exécuter l’application en local avec :
streamlit run app.py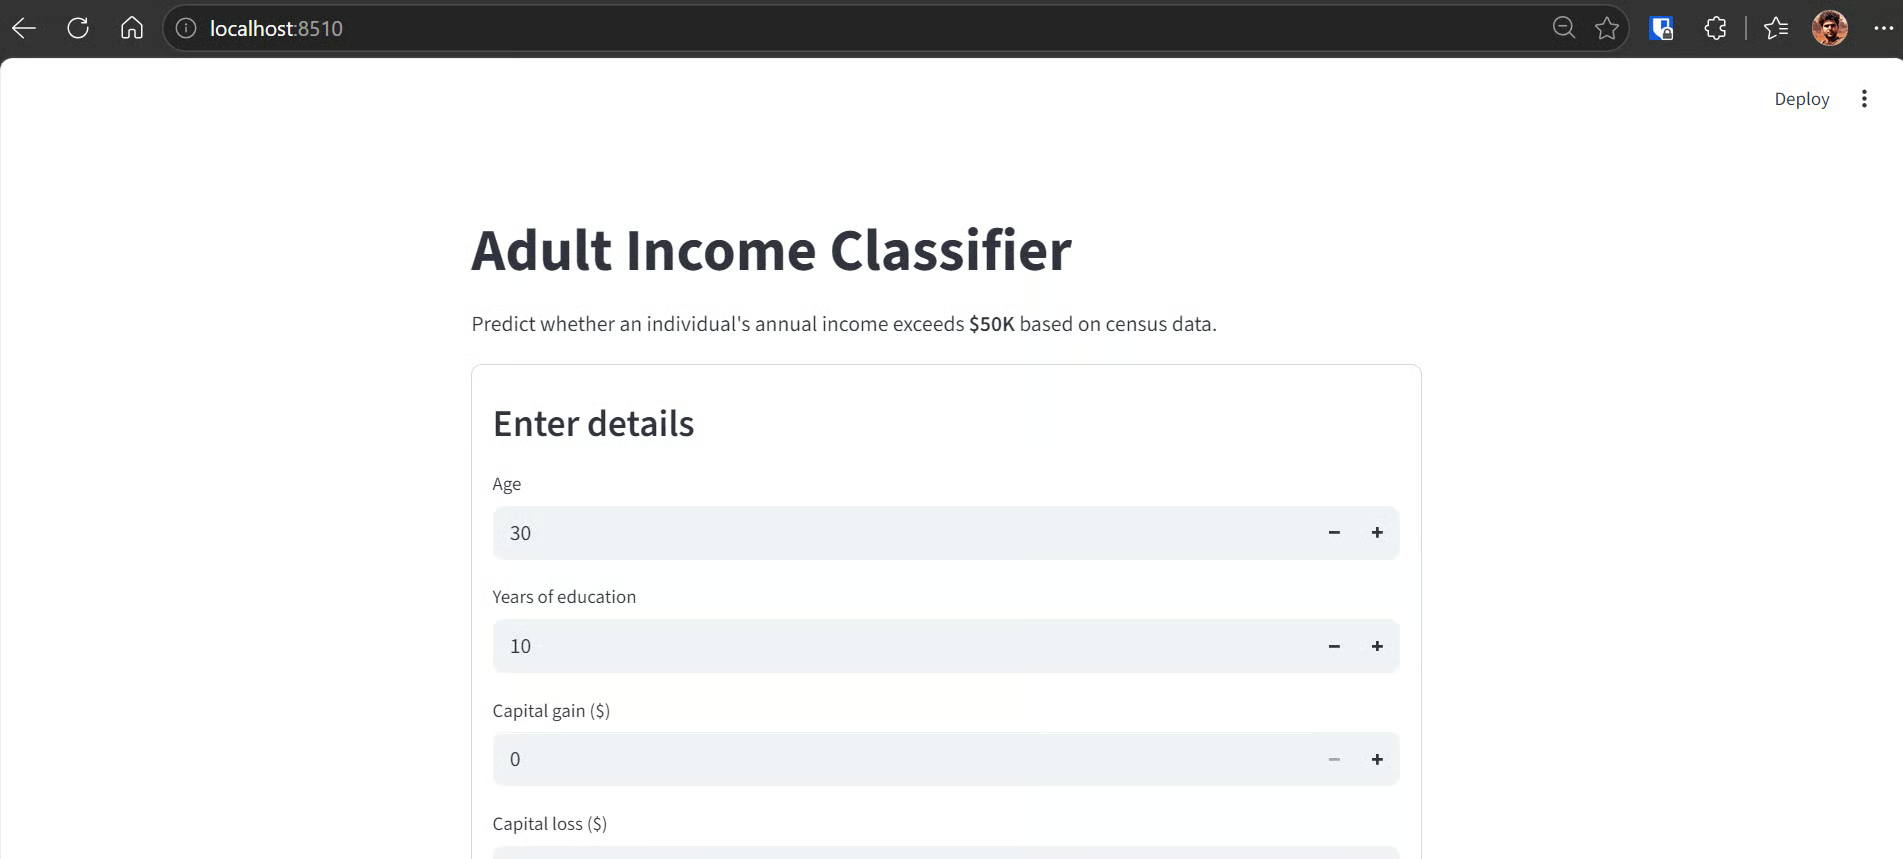
L’interface est claire et facile à parcourir, et le modèle renvoie rapidement des prédictions.
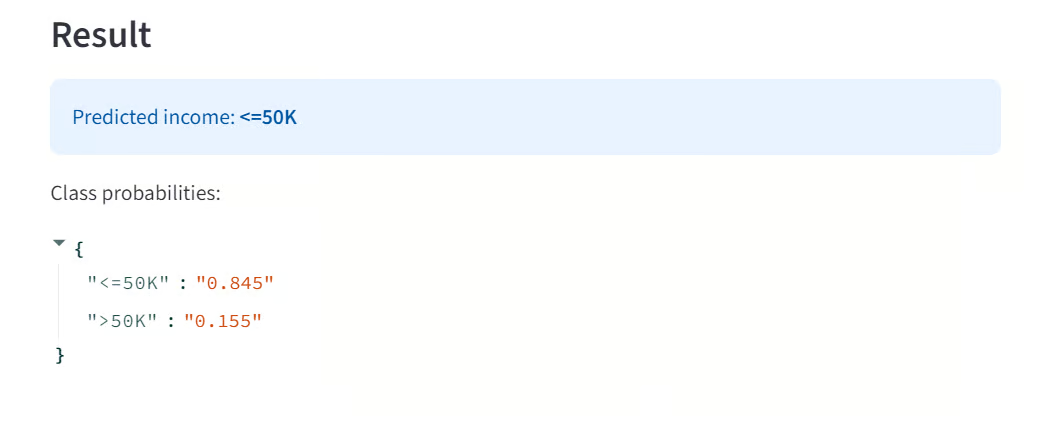
Plus important encore, ce test montre la valeur de l’ensemble : Pi peut rechercher la tâche, inspecter les données, utiliser une documentation à jour, construire le pipeline, créer une interface, tester l’expérience navigateur, valider le modèle et publier le projet final—le tout dans un seul workflow.
Kimi K2.7 Code et Pi se sont révélés être une combinaison puissante pour du codage opérationnel.
Kimi est rapide, compétent, et gère bien les tâches d’ingénierie en plusieurs étapes sans complexifier à outrance les décisions simples.
Si vous utilisez l’API au lieu d’un abonnement de codage, envisager d’ajouter au moins 10 $ de crédits vaut le coup pour accéder à un palier d’usage supérieur et éviter de heurter trop vite les limites journalières.
Ce qui m’a le plus impressionné, c’est le peu de coordination manuelle nécessaire une fois tout en place.
Avec une invite détaillée, Pi a consulté Hermes Memory pour le contexte du projet, a examiné le répertoire, utilisé Context7 pour vérifier la documentation actuelle de Streamlit et de scikit-learn, et recouru à Olostep pour rechercher le jeu de données et la formulation du problème.
De là, il a créé les fichiers du projet, construit le pipeline de machine learning, développé l’app Streamlit et testé l’interface avec Webwright et Playwright.
Pi a également exécuté les tests Python, vérifié les métriques du modèle, examiné le comportement du navigateur, généré un résumé final, validé les changements et poussé le dépôt terminé sur GitHub.
Au final, l’expérience ressemblait moins à la gestion manuelle d’un assistant de codage qu’à la direction claire d’un workflow de développement automatisé.
Une fois les bons outils connectés, Pi a assuré l’essentiel du travail, tandis que Kimi a apporté la vitesse et le raisonnement nécessaires pour garder le rythme.
Vous souhaitez aller plus loin sur le fonctionnement interne des agents IA ? Je vous recommande le cours de DataCamp Building Scalable Agentic Systems pour apprendre les principes de conception, cadres de test et protocoles (comme MCP) indispensables pour passer d’une preuve de concept à la production.
Top DataCamp Courses
Cours
Cours
Cours
blog
Kurtis Pykes
9 min
blog
blog
Lynn Heidmann
Tutoriel
Tutoriel
Kurtis Pykes
15 min
Tutoriel
DataCamp Team
3 min